本文为改编自shen 的一个笔记https://github.com/MushihimePepsi, 主要是方便自己编辑
文章目录
- [1. 导入](#1. 导入)
- [2. 网络服务器(Web Servers)](#2. 网络服务器(Web Servers))
- [3. 从APIs获取数据](#3. 从APIs获取数据)
- [4. 使用Python进行数据抓取](#4. 使用Python进行数据抓取)
-
- [4.1 robots.txt](#4.1 robots.txt)
- [4.2 教程步骤](#4.2 教程步骤)
-
- [4.2.1 检查数据源](#4.2.1 检查数据源)
- [4.2.2 从网页中抓取HTML内容](#4.2.2 从网页中抓取HTML内容)
- [4.2.3 解析从网页中抓取的HTML代码](#4.2.3 解析从网页中抓取的HTML代码)
- [4.2.4 查找元素(Find Elements)](#4.2.4 查找元素(Find Elements))
-
- [4.2.4.1 通过ID查找HTML元素](#4.2.4.1 通过ID查找HTML元素)
- [4.2.4.2 find()和findAll()](#4.2.4.2 find()和findAll())
- [4.2.4.3 通过HTML元素的类名来查找元素(Find Elements by HTML Class Name)](#4.2.4.3 通过HTML元素的类名来查找元素(Find Elements by HTML Class Name))
- [4.2.4.3 find()函数的更多使用](#4.2.4.3 find()函数的更多使用)
- [4.2.4.4 用树结构处理HTML(HTML Tree Structure)](#4.2.4.4 用树结构处理HTML(HTML Tree Structure))
- [4.2.4.5 从HTML元素中提取属性值(Extract Attributes from HTML Elements)](#4.2.4.5 从HTML元素中提取属性值(Extract Attributes from HTML Elements))
- [5. 更多例子](#5. 更多例子)
1. 导入
就像前面导论所说,数据挖掘(Data Mining)是一个跨学科领域,受到多个不同学科的影响和贡献的。数据科学(Data Science)就是数据工程(Data Engineering)、数学与统计学(Mathematics & Statistics)、实质性专业知识/商业智能这三个领域的结合。
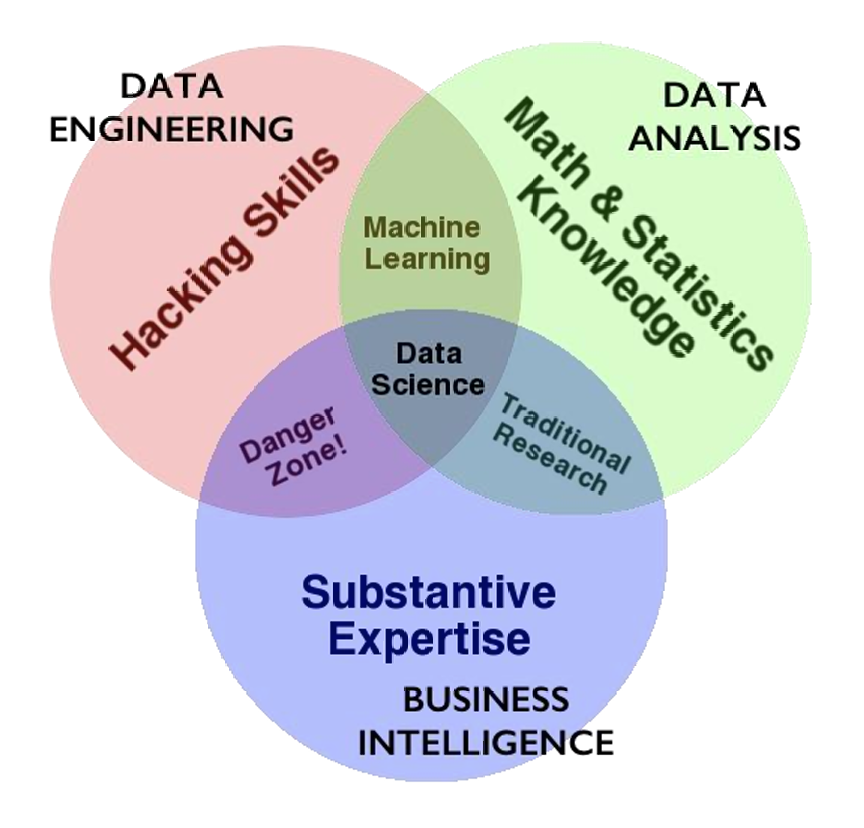
数据科学不仅需要技术能力来处理数据,还需要数学和统计学知识来分析数据,以及对特定领域的深入理解来解释数据并做出决策。
我们这章就将深入数据爬取(Web Scraping)这一块的知识。
术语补充(Terminology Supplement):网页抓取/网络爬取(Web Scraping)是**从网络中提取信息(Extracting Information from the Web)**的过程,并且通常可以通过自动化(Automation)反复执行。一个典型流程可以概括为:目标网站(Target Website) → 抓取(Scraping) → 结构化数据(Structured Data),即先确定目标网页,再提取所需信息,最后将结果保存为结构化格式(Structured Format)或数据库(Database)。
2. 网络服务器(Web Servers)
我们先回顾一遍网络服务器的相关知识。
服务器是一个长时间运行的过程(也称为守护进程),它是一种软件程序,它在计算机上运行,并且可以持续运行很长时间。在网络环境中,服务器通常被称为"守护进程"(daemon),因为它们在后台运行,不需要用户直接交互。
服务器会在计算机上监听一个特定的端口号。端口号(Port Number)是一个数字,用于标识网络通信中的特定服务。例如,HTTP(超文本传输协议)通常使用端口80,而HTTPS(安全的HTTP)使用端口443。
当客户端(Client,如网页浏览器 Browser)向服务器发送请求时,服务器会接收到这个请求(Request),并根据请求的内容生成相应的响应(Response)。这个响应可能包含网页内容、图片、视频等资源。
客户端和服务器之间的通信通常使用HTTP协议。HTTP是一种应用层协议(Application-layer Protocol),用于在Web上传输超文本。它定义了客户端如何向服务器请求资源,以及服务器如何将资源返回给客户端。
当用户在浏览器中输入一个网址(URL, Uniform Resource Locator,统一资源定位符)时,浏览器会解析这个URL,以确定需要访问的服务器地址和请求的资源路径。然后,浏览器会构建一个HTTP请求,并将其发送到服务器的指定端口。服务器接收到请求后,会根据请求的资源路径找到相应的文件或执行相应的操作,并将结果返回给浏览器。
下图展示了用户通过浏览器访问网站并查看网页内容的流程。
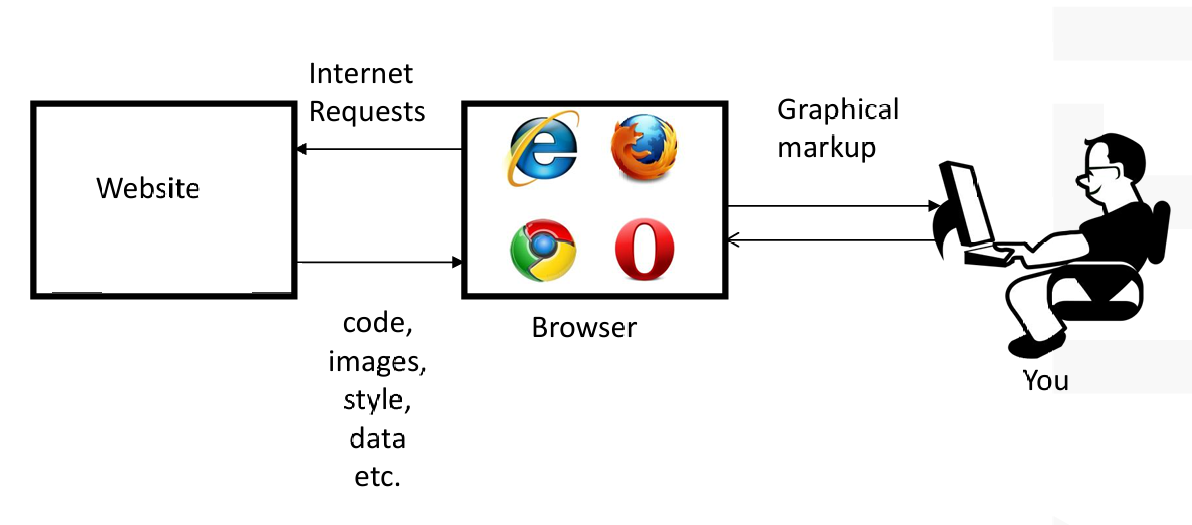
用户在浏览器中输入网址或点击链接。
浏览器向网站服务器发送请求。
网站服务器处理请求,并将网页内容(代码、图片、样式、数据等)发送给浏览器。
浏览器接收这些资源,并将其解析为用户可以看到的图形界面。
那数据抓取该怎么做呢?
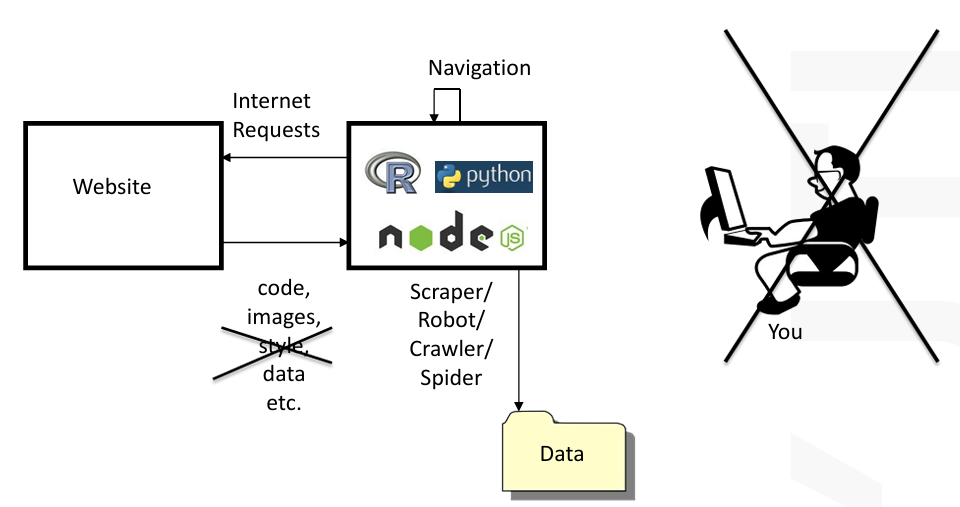
这里不再是用户向网络服务器发送请求,而是爬虫程序(Scraper / Crawler / Spider)向网站服务器发送请求,请求获取网站上的数据。
网站服务器响应请求,将网页的代码、图片、样式、数据等资源发送给爬虫程序。
爬虫程序解析(Parse)这些资源,提取所需的数据。
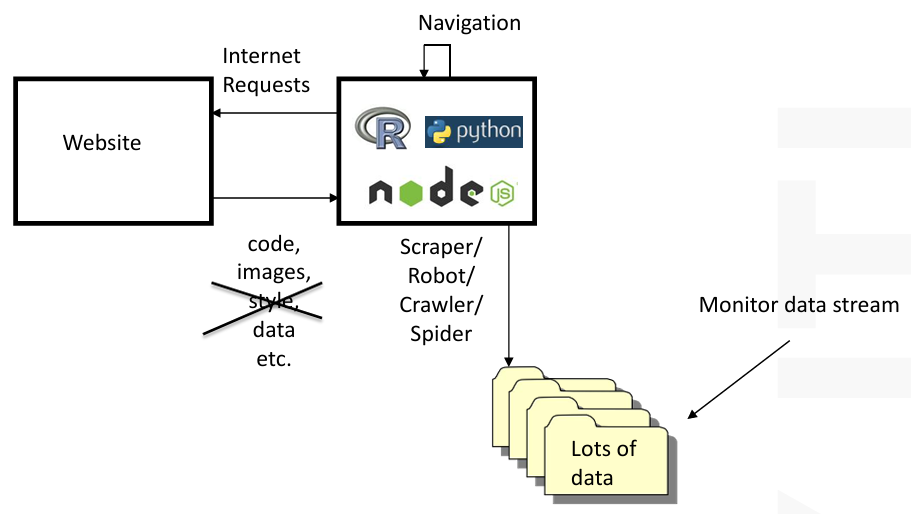
爬虫程序将提取的数据存储起来,并可以对数据流进行监控,以便在数据发生变化时进行相应的处理。
这样就是一个数据爬取的完整流程。
我们再看几个网络服务器的例子。
先是本地网络服务器访问Jupyter Notebook,通过下面的URL访问:
http://localhost:8888/Documents/cs109/BLA.ipynb#something
其中,协议(protocol):http,表示使用超文本传输协议。
主机名(hostname):localhost,表示本地计算机。
端口(port):8888,表示服务器监听的端口号。
路径(url):/Documents/cs109/BLA.ipynb,表示请求的资源路径。
片段(url fragment):#something,表示URL中的一个片段,通常用于锚点定位。
这里可以把 URL 的组成部分统一记为:协议(Protocol)、主机名(Hostname)、端口(Port)、路径(Path)和片段(Fragment)。
当用户在浏览器中输入上述URL并按下回车键时,浏览器会向本地服务器发送一个HTTP请求。
请求的格式如下:
Request: GET /request-URI HTTP/version
GET:表示请求方法,GET方法用于请求访问指定的资源。
/request-URI:请求的资源路径,在这个例子中是/Documents/cs109/BLA.ipynb。
HTTP/version:HTTP协议的版本,例如HTTP/1.1。
我们再看一个向Google发送请求并接受响应的例子。
请求行(Request Line):
请求行也可以理解为 HTTP 请求的第一行(HTTP Request Line)。
GET / HTTP/1.0
GET:HTTP方法,表示请求访问指定的资源。
/:请求的资源路径。在这个例子中,请求的是Google的主页。
HTTP/1.0:HTTP协议的版本。
请求头(Request Headers):
请求头(Headers)用于携带关于客户端、目标主机、内容类型等附加信息。
Host: www.google.com
Host:指定请求的目标主机名,这里是www.google.com。
响应部分(Response)
状态行(Status Line):
状态行(HTTP Status Line)通常包含 HTTP 版本、状态码(Status Code)和状态描述(Reason Phrase)。
HTTP/1.0 200 OK
HTTP/1.0:HTTP协议的版本。
200:状态码,表示请求成功。
OK:状态码的描述。
响应头(Response Headers):
响应头(Response Headers)描述服务器返回内容的元数据(Metadata),例如内容类型、缓存规则和 Cookie 等。
Date: Mon, 14 Nov 2016 04:49:02 GMT
Expires: -1
Cache-Control: private, max-age=0
Content-Type: text/html; charset=ISO-8859-1
P3P: CP="This is ..."
Server: gws
X-XSS-Protection: 1; mode=block
X-Frame-Options: SAMEORIGIN
Set-Cookie: NID=90=gb5q7b0...; expires=Tue, 16-May-2017 04:49:02 GMT; path=/; domain=.google.com; HttpOnly
Accept-Ranges: none
Vary: Accept-Encoding
Date:响应生成的日期和时间。
Expires:资源的过期时间,-1表示立即过期。
Cache-Control:缓存控制指令,private, max-age=0表示不允许缓存。
Content-Type:响应内容的MIME类型,这里是text/html,字符集是ISO-8859-1。
P3P:隐私政策声明。
Server:服务器软件的信息。
X-XSS-Protection:跨站脚本(XSS)保护。
X-Frame-Options:防止点击劫持的选项。
Set-Cookie:设置一个Cookie,用于会话管理。
Accept-Ranges:指示服务器是否支持范围请求。
Vary:指示代理服务器在缓存时需要考虑的请求头。
响应体(Response Body):
响应体(Response Body / Message Body)包含真正返回给客户端的资源内容,例如 HTML 文档。
<!doctype html><html itemscope="" itemtype="http://schema.org/WebPage" lang="en">
<head><meta content="Search the world's information,
这是HTML文档的开始部分,定义了文档类型、HTML元素及其属性(如itemscope和itemtype),并设置了语言为英语。
我们再回顾一下HTTP状态码:
200 OK:
表示请求已成功处理,服务器完成了客户端的请求,并且一切正常。这是最常见的成功响应状态码。
400 Bad Request:
表示客户端发送的请求存在语法错误,服务器无法理解。这通常是由于请求格式不正确或包含无效的参数。
401 Unauthorized:
表示客户端试图访问的资源需要授权,但请求中未提供有效的授权信息。如果客户端提供了正确的授权凭证(如用户名和密码),可能会获得访问权限。
403 Forbidden:
表示服务器理解了请求,但是拒绝执行此请求。这通常是由于服务器配置问题或安全策略,即使提供了授权信息,也无法访问资源。
404 Not Found:
表示服务器无法找到请求的资源。这通常意味着请求的URL不存在,或者服务器上没有相应的文件或资源。也就是常说的"死链"。
500 Internal Server Error:
表示服务器在处理请求时遇到了意外情况,导致无法完成请求。这通常是服务器内部错误,可能是代码错误、资源不足或其他问题。
501 Not Implemented:
表示服务器不支持请求中使用的方法。例如,客户端使用了服务器不支持的HTTP方法(如PUT或DELETE)。
我们在本课程使用的工具是Python,那我们如何使用Python来请求并获取网页内容呢?
我们可以使用Python的requests库(Requests Library)来完成。
代码如下。
python
import requests

req = requests.get("https://en.wikipedia.org/wiki/Harvard_University")
print(req)  # 输出: <Response [200]>
page = req.text  # 获取原始HTML(Raw HTML)
print(page[:500])  # 打印前500个字符的HTML
我们使用requests库发送请求。
requests.get("https://en.wikipedia.org/wiki/Harvard_University"):使用requests库中的get方法发送一个GET请求(HTTP GET Request),目标是哈佛大学的维基百科页面。
然后print(req)打印响应对象(Response Object),显示状态码200,表示请求成功。
page = req.text:将响应的文本内容(即网页的HTML代码)存储在变量page中。
然后print(page:500):打印HTML内容的前500个字符,以便快速查看网页的开头部分。
3. 从APIs获取数据
我们可以直接依靠API来获取数据。
再回顾一下API,API = Application Program Interface(应用程序编程接口),它是一组预定义的函数或协议,允许不同的软件应用程序之间进行通信和数据交换。
这里的 API 可以理解为软件之间约定好的"接口(Interface)"。常见的 HTTP 方法(HTTP Methods)包括 GET、POST、PUT、DELETE;其中 GET 常用于检索(Retrieve)数据,POST 常用于提交(Submit)数据。
许多网站和服务(如社交媒体、电子商务平台、地图服务等)提供了API,这些API主要用于网络与其他接口进行通信。
API通常包含一组方法(如GET、POST、PUT、DELETE等),这些方法允许开发者搜索、检索或向数据源提交数据。这些方法定义了如何与API进行交互,以及如何请求或修改数据。
许多编程语言和框架提供了库或包,这些库或包已经实现了与知名API的连接。这意味着开发者可以直接使用这些库来访问API,而无需从头开始编写代码来处理API调用的所有细节。
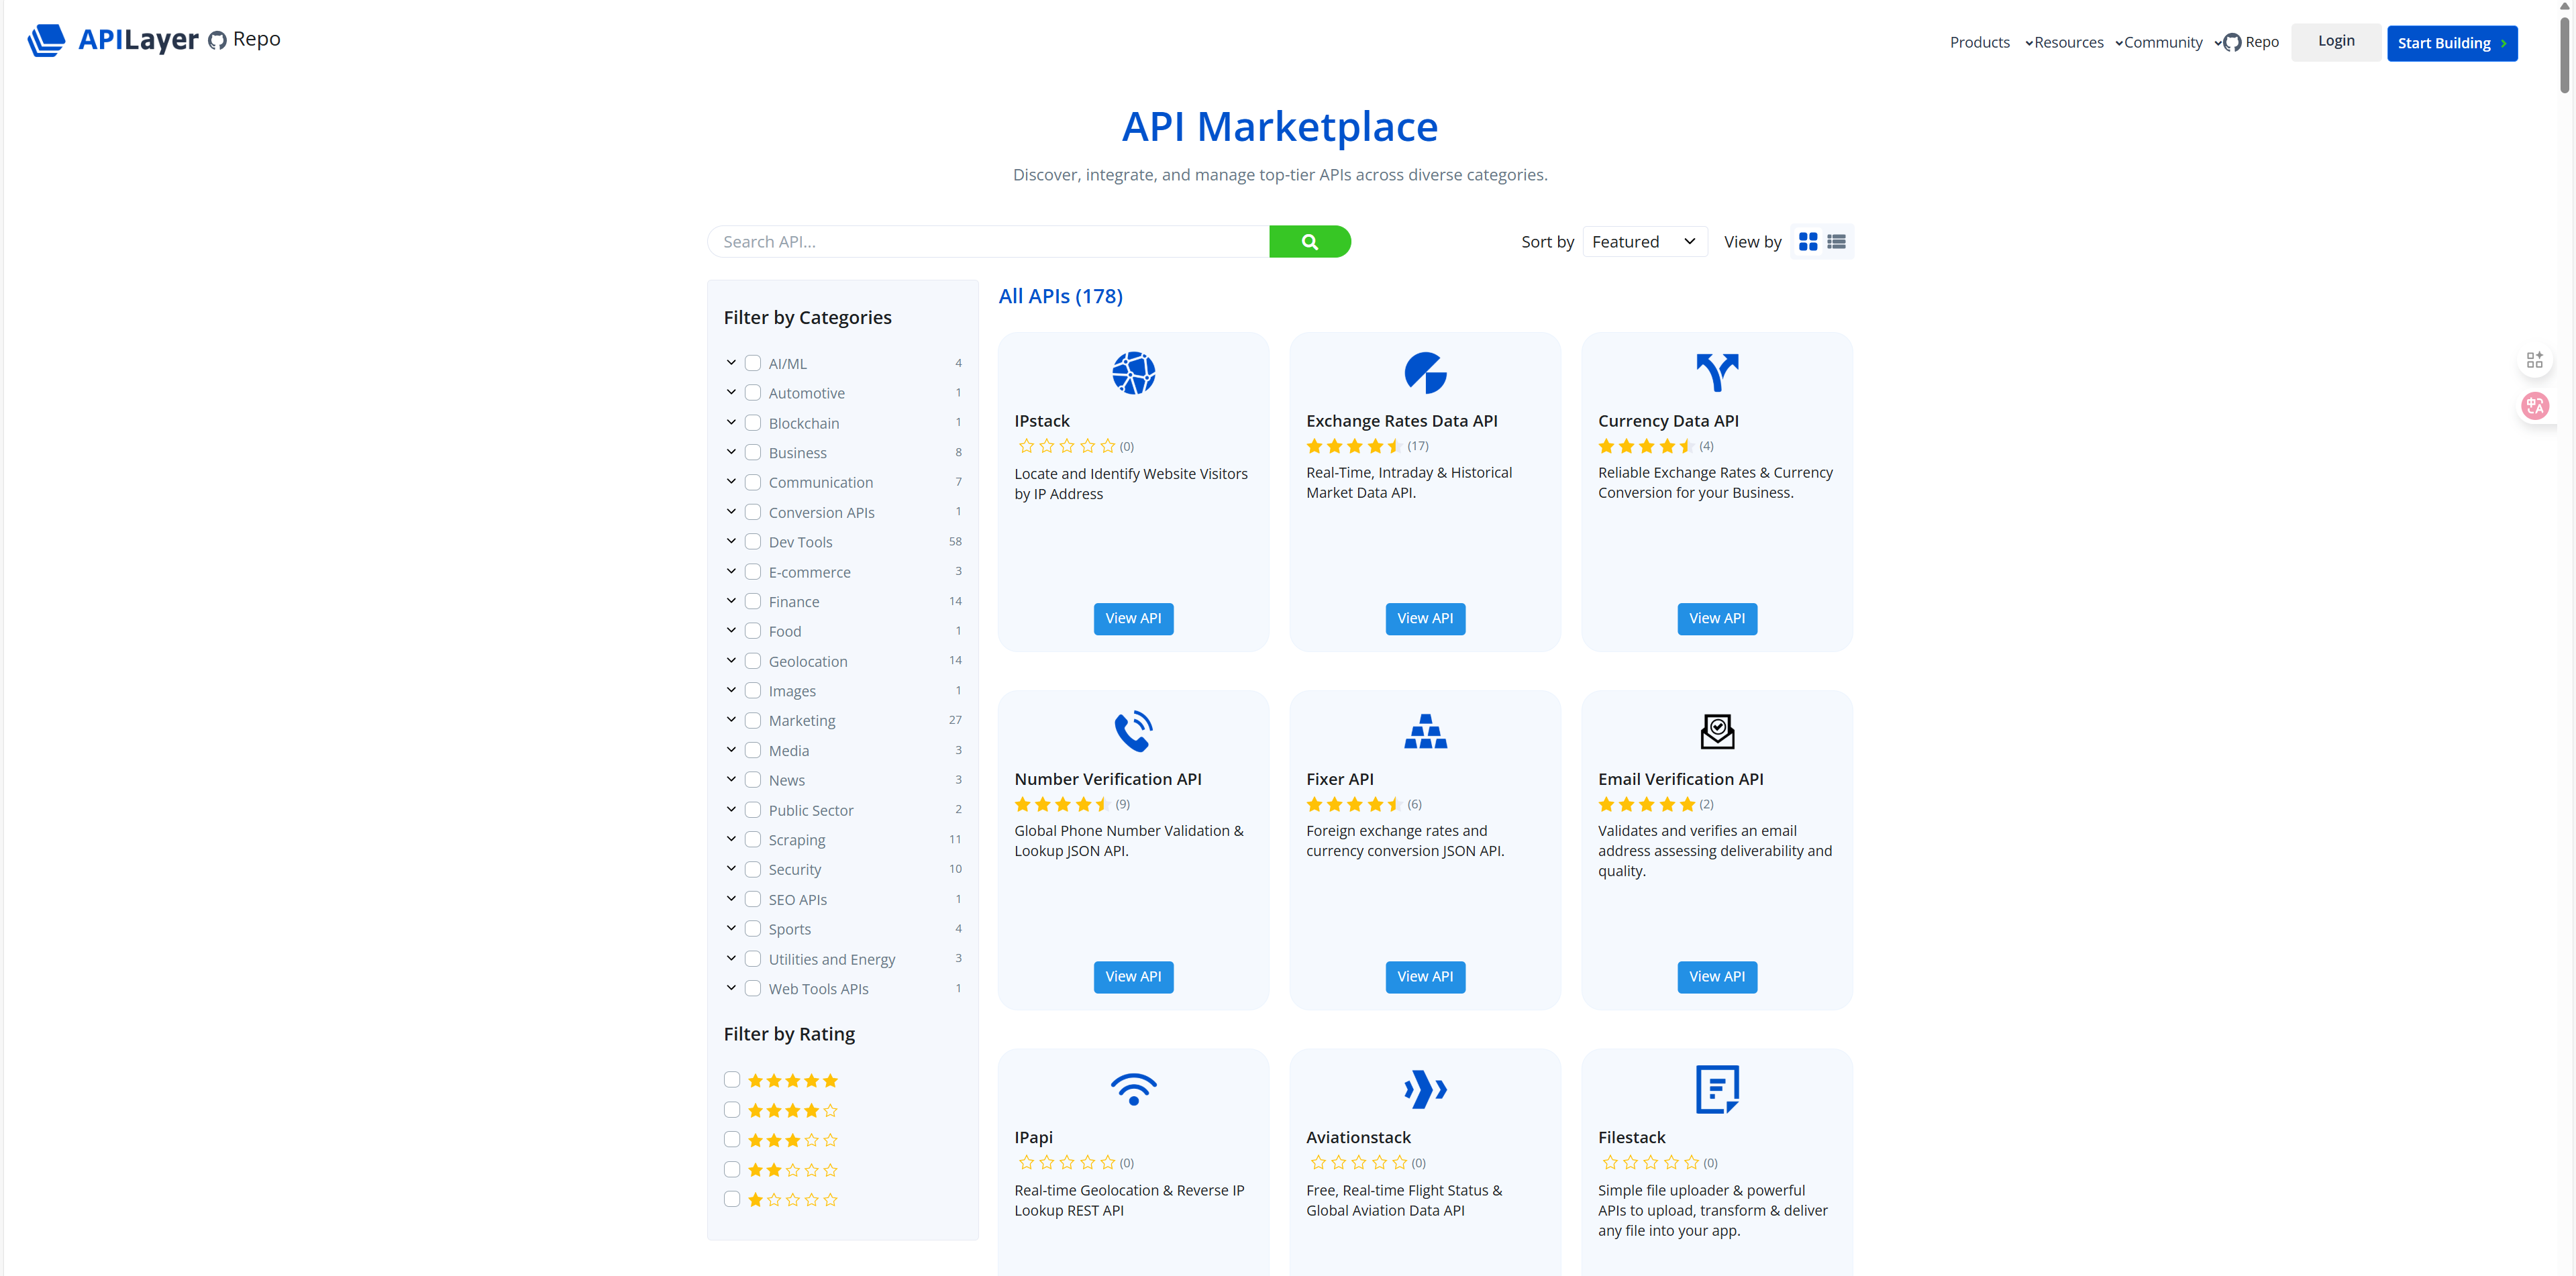
Any API的网站提供了一个平台,开发者可以在这里找到、使用和测试大量公共API。这些API由不同的服务提供商提供,涵盖了各种功能和服务。
网址是 https://any-api.com。
4. 使用Python进行数据抓取
为什么要进行网页数据爬取呢?
主要原因是公司或网站没有提供官方的API来访问他们的数据。在这种情况下,数据爬取可以作为一种替代方法来获取所需的信息。
而且数据爬取可以自动化重复性的数据收集任务,节省时间和劳动力。例如,定期从多个网站收集价格信息或新闻更新。
通过设置爬虫定期访问网站,可以及时获取最新的数据和信息,这对于需要实时或近实时数据的应用非常有用。
对于许多开发者和数据爱好者来说,数据爬取本身可以是一个有趣和有挑战性的活动。它结合了编程、数据分析和解决问题的技能,可以带来满足感和乐趣。
对于数据爬取我们需要注意以下几个问题:
- 确定要爬取的数据源和数据的相关性、时效性和可靠性。
- 应对网站结构的不断变化,这可能需要定期更新和维护爬虫。
- 处理数据模式的变化,确保爬取的数据仍然符合需求。
课程补充(Lecture Supplement):正式开始抓取前,还可以依次检查三个问题:
- 是否存在更容易的数据获取方式(Easier Data Access)?例如原始数据集(Raw Dataset)、研究数据仓库(Research Data Repository)或官方 API(Official API)。
- 技术上是否可以抓取(Technical Feasibility)?例如是否存在验证码(CAPTCHA)、请求频率限制(Request Rate Limit)或动态加载(Dynamic Loading)。
- 法律和伦理上是否允许抓取(Legal & Ethical Feasibility)?需要检查使用条款(Terms of Use)、robots.txt、版权(Copyright)、隐私(Privacy)和数据共享政策(Data Sharing Policy)。
**工具选择(Tool Selection)**可以按网页复杂度来判断:简单静态网页(Simple Static Webpage)可以优先使用 Power Query 或 Google Sheets;静态且页数较少、带分页(Pagination)的网页可使用 Web Scraper 浏览器插件(Browser Plug-in);动态网页(Dynamic Webpage)或大规模项目(Large-scale Project)通常需要编程(Programming),例如 Python、Selenium、Scrapy,或者优先寻找官方 API。
同时还要注意数据爬取时的法律和道德规范:
隐私(Privacy):
隐私保护立法(Privacy Legislation):许多国家和地区都有法律保护个人信息的隐私。在进行数据爬取时,必须遵守这些法律,确保不侵犯个人隐私。
为了遵守隐私法规,通常建议只从公开可访问的来源爬取数据,避免涉及个人隐私信息。
网络礼仪(Netiquette):
尊重机器人排除协议(Robots Exclusion Protocol):这是一种网站通过robots.txt文件来告诉爬虫哪些页面可以爬取,哪些不可以。遵守这个协议是网络礼仪的一部分。
robots.txt文件:每个网站都有一个robots.txt文件,列出了爬虫可以或不可以访问的页面。例如,Disallow: /private/表示禁止爬虫访问/private/目录下的页面。
在发送请求时,通过User-Agent头部(User-Agent Header)标识自己的身份,让网站知道是哪个爬虫在访问。
为了避免对网站服务器造成过大负担,建议在请求之间留出一些空闲时间,避免频繁请求。
选择在网站访问量较低的时段运行爬虫,以减少对服务器的影响。
如可行,在开始爬取某个网站之前,最好通知网站所有者并获得他们的许可,以示尊重和透明度。
在使用网络上的内容时,必须注意版权问题(Copyright Issues)。未经版权所有者许可,不得擅自使用受版权保护的材料。
当使用或引用他人的工作时,应适当地给予原作者或来源以信用,这通常意味着要注明出处。
了解并遵守与媒体相关的法律,如版权法、隐私法、诽谤法等,以确保你的网络活动合法。
不要进行不道德的行为,如发送垃圾邮件(spam)、过度请求导致网站过载等。
4.1 robots.txt
robots.txt 是一个由网站所有者创建的文本文件,它为网络爬虫(包括自动化的数据爬取脚本)提供了关于哪些页面可以被爬取,哪些不可以的指令。
在术语上,robots.txt 属于机器人排除协议(Robots Exclusion Protocol)的一部分,常见规则包括用户代理(User-agent)、允许(Allow)和禁止(Disallow)。它的作用是向网络爬虫(Web Crawler / Bot)声明访问规则。
网站所有者或管理员负责创建和维护这个文件,以控制爬虫对其网站的访问。
这个文件包含了一系列的规则,告诉爬虫哪些目录可以访问,哪些应该被忽略。这些规则有助于防止爬虫访问敏感或不必要的页面。
robots.txt 文件通常放置在网站的根目录下,这样爬虫在访问网站时可以轻易地找到并读取它。
例如访问http://google.com/robots.txt来查看 Google 网站的 robots.txt 文件。
在进入 Python 教程前,课程还介绍了一个无代码(No-code)流程:使用 Web Scraper 浏览器插件时,一般依次进行创建站点地图(Create a Sitemap)→ 添加选择器(Add Selectors)→ 预览数据(Preview Data)→ 开始抓取(Scrape)→ 刷新查看结果(Refresh Results)→ 导出数据(Export Data,CSV/XLSX)。站点地图(Sitemap)描述抓取路径,选择器(Selector)描述要提取的页面元素。
4.2 教程步骤
4.2.1 检查数据源
我们可以打开一个网页并进行浏览,甚至与网页交互,我们需要熟悉目标网站的结构和内容,了解数据的来源和组织方式,为后续的数据爬取工作做好准备。
例如我们访问这个网站:https://realpython.github.io/fake-jobs/
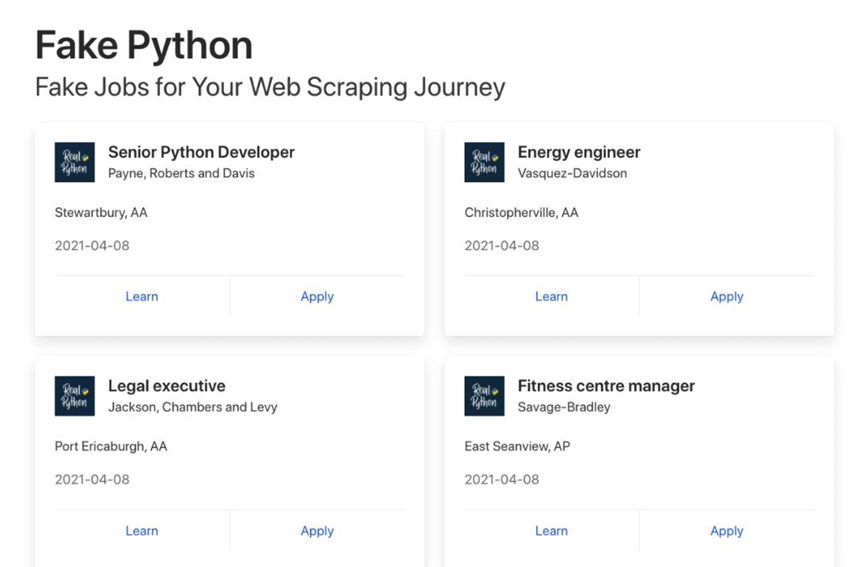
我们可以通过按下 F12 打开开发者工具(Developer Tools)来检查网页元素,下面还列举了一些浏览器打开开发者工具的方式。
Chrome/Edge浏览器:可以通过按下 Ctrl + Shift + I(Windows/Linux)或 Cmd + Option + I(Mac)来打开开发者工具。
Safari浏览器:可以通过按下 Cmd + Option + I 来打开开发者工具。
我们打开"元素"工具就可以检查、编辑和调试网页的HTML和CSS代码(HTML & CSS Code)。
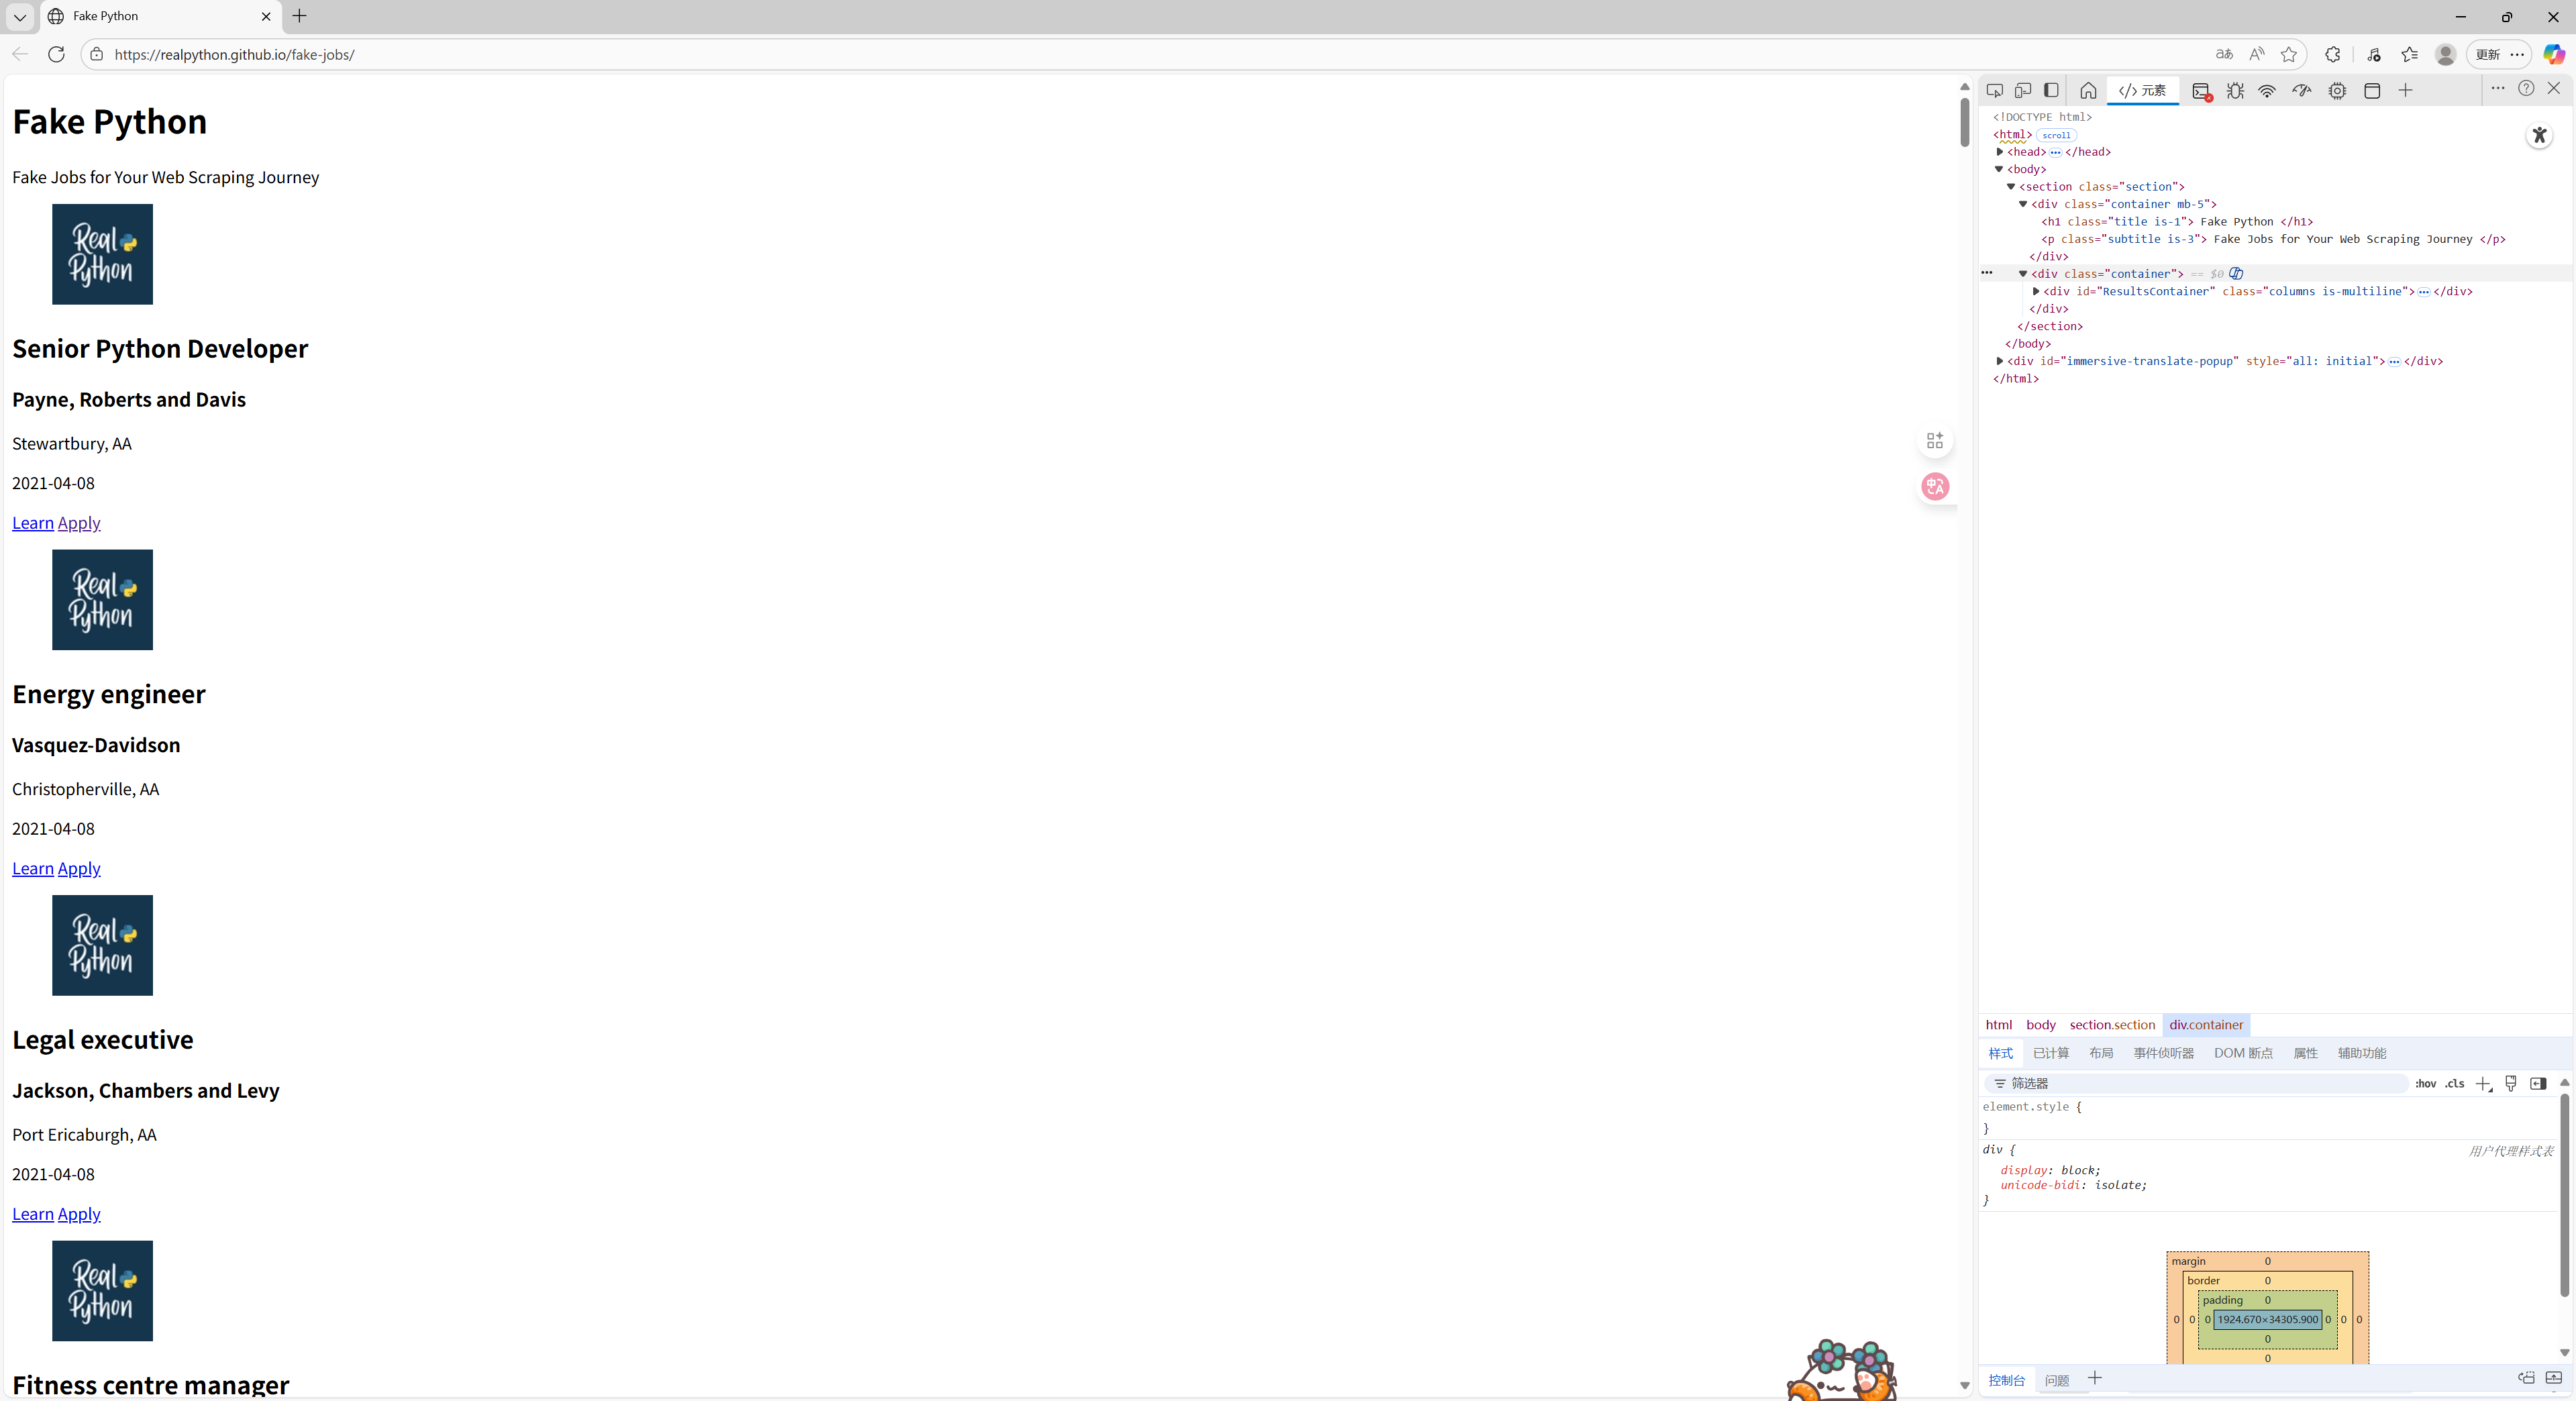
将鼠标悬停在网页上的元素上,开发者工具会高亮显示相应的HTML代码。
点击该元素,可以在开发者工具中查看和编辑其详细信息。
HTML 结构补充(HTML Structure Supplement) :HTML(HyperText Markup Language,超文本标记语言)可以看作一棵树(Tree)。常见标签(Tags)包括 <body>、<div>、<h1>、<p>、<a>;标签之间存在父元素(Parent Element)与子元素(Child Element)的层级关系(Hierarchy)。抓取时尤其常用属性(Attributes),例如 class、id 和 href,因为它们可以帮助我们更精确地定位目标元素(Target Element)。CSS(Cascading Style Sheets,层叠样式表)主要负责网页的样式(Style),而 HTML 主要负责网页的结构(Structure)。
4.2.2 从网页中抓取HTML内容
我们现在就可以使用Python的requests库进行数据抓取操作了。
python
import requests

URL = "https://realpython.github.io/fake-jobs/"
page = requests.get(URL)

print(page.text)
URL = "https://realpython.github.io/fake-jobs/":定义要抓取的网页的URL。
page = requests.get(URL):使用requests.get()方法向指定的URL发送一个HTTP GET请求,并将响应存储在变量page中。
print(page.text):打印响应的文本内容,即网页的HTML代码。
这些都与前面的知识一致。
这样我们就能从互联网上获取了静态网站内容(Static Website Content)。
4.2.3 解析从网页中抓取的HTML代码
我们已经获取了网页数据,但是我们需要解析里面的HTML代码。
python
import requests
from bs4 import BeautifulSoup

URL = "https://realpython.github.io/fake-jobs/"
page = requests.get(URL)

soup = BeautifulSoup(page.content, "html.parser")
我们使用的是Beautiful Soup库(Beautiful Soup Library),这是用于解析HTML和XML文档(HTML/XML Documents)。
soup = BeautifulSoup(page.content, "html.parser"):使用Beautiful Soup解析从服务器返回的HTML内容。page.content包含响应的二进制内容,"html.parser"指定使用Python的标准HTML解析器(HTML Parser)。
这样做就方便我们后续的很多操作,我们来一步步看。
4.2.4 查找元素(Find Elements)
当我们使用Beautiful Soup库解析HTML后,我们就方便快捷地查找到我们想要的元素。
4.2.4.1 通过ID查找HTML元素
正在寻找的元素是一个具有ID属性值(ID Attribute Value)为"ResultsContainer"的<div>标签。这个<div>标签可能还有其他属性,但主要关注的是它的ID。
html
<div id="ResultsContainer">
  <!-- all the job listings -->
</div>
Beautiful Soup允许我们通过元素的ID来查找特定的HTML元素。以下是相应的Python代码:
python
results = soup.find(id="ResultsContainer")4.2.4.2 find()和findAll()
findAll:这个方法会返回文档中所有匹配的标签,而不仅仅是第一个匹配的标签。它会将所有匹配的标签存储在一个列表中。
这里的"所有匹配项"可以理解为匹配元素集合(Collection of Matching Elements);在 Beautiful Soup 中,find_all() 与 findAll() 都用于查找多个匹配元素。
find:这个方法只会返回文档中第一个匹配的标签。如果没有找到匹配的标签,则返回None。
下面的代码可以比较两者。
python
import bs4

## get bs4 object
soup = bs4.BeautifulSoup(source)

## all a tags
soup.findAll('a')  # 使用findAll获取所有<a>标签

## first a
soup.find('a')  # 使用find获取第一个<a>标签

## get all links in the page
link_list = [l.get('href') for l in soup.findAll('a')]  # 提取每个标签的href属性,将结果存储在link_list中
4.2.4.3 通过HTML元素的类名来查找元素(Find Elements by HTML Class Name)
我们可以使用 .find_all() 方法,查找所有具有特定类名的元素。
例如这里每个工作职位的发布信息都被包裹在一个具有类名 card-content 的 <div> 元素中。
python
job_elements = results.find_all("div", class_="card-content")这行代码使用 .find_all() 方法在 results 对象中查找所有<div> 元素,这些元素具有类名 card-content。
python
for job_element in job_elements:
    print(job_element, end="\n"*2)
我们使用这里的代码将每个工作职位的HTML元素打印出来,而且每个元素之间有两行的间距。
4.2.4.3 find()函数的更多使用
我们可以进一步将这里的所需信息提取出来。
python
for job_element in job_elements:
    title_element = job_element.find("h2", class_="title")
    company_element = job_element.find("h3", class_="company")
    location_element = job_element.find("p", class_="location")
    print(title_element)
    print(company_element)
    print(location_element)
    print()
对于每个 job_element,使用 .find() 方法查找具有特定类名的元素:
title_element:查找类名为 title 的 <h2> 元素。
company_element:查找类名为 company 的 <h3> 元素。
location_element:查找类名为 location 的 <p> 元素。
这里的打印可以使用 .text 属性获取每个元素的文本内容(Text Content),并使用 .strip() 方法去除多余的空白字符。
html
<h2 class="title is-5">Senior Python Developer</h2>
<h3 class="subtitle is-6 company">Payne, Roberts and Davis</h3>
<p class="location">Stewartburg, AA</p>
我们已经知道页面中的职位标题被包含在 <h2> 元素中。为了筛选出特定的职位,例如包含"Python"的职位,可以使用 string 参数。
python
python_jobs = results.find_all("h2", string="Python")这行代码使用 find_all 方法在 results 对象中查找所有包含文本"Python"的 <h2> 元素。
我们也可以将函数传递给find_all方法,以便根据特定条件查找HTML元素。
如下所示。
python
python_jobs = results.find_all(
    "h2", string=lambda text: "python" in text.lower()
)
这里我们使用lambda函数检查每个元素的文本内容中是否包含"python",text.lower()保证了不区分大小写的搜索。
能实现传递函数是因为string参数接受一个匿名函数(lambda函数,Anonymous/Lambda Function)。
4.2.4.4 用树结构处理HTML(HTML Tree Structure)
HTML文档的结构可以被视为一棵树,其中每个标签都是一个节点。
python
tree = bs4.BeautifulSoup(source)我们用这里的代码创建了一个Beautiful Soup对象tree,它包含了解析后的HTML文档。source是HTML内容。
python
root_node = tree.html这行代码获取HTML文档的根节点,即<html>标签。
python
body = root_node.contents[1]这行代码从根节点中获取第二个子节点,即<body>标签。
我们也可以直接访问标签。
python
tree.body这行代码展示了另一种直接访问标签的方法。
当然我们也可以访问HTML元素的父元素。
python
python_jobs = results.find_all(
    "h2", string=lambda text: "python" in text.lower()
)

python_job_elements = [
    h2_element.parent.parent for h2_element in python_jobs
]
这段代码首先使用find_all方法查找所有包含文本"python"的<h2>元素,并将结果存储在python_jobs列表中。
然后,使用列表推导式遍历python_jobs列表,对于每个h2_element,获取其父元素的父元素(即曾祖父元素),并将这些元素存储在python_job_elements列表中。
补充理解:连续两次 .parent 表示沿 DOM 树向上移动两层(Move Up Two Levels in the DOM Tree);实际对应哪一级容器要以当前 HTML 结构为准。
4.2.4.5 从HTML元素中提取属性值(Extract Attributes from HTML Elements)
现在我们要尝试从HTML中提取属性值。
html
<!-- snip -->
<footer class="card-footer">
    <a href="https://www.realpython.com" target="_blank" class="card-footer-item">Learn</a>
    <a href="https://realpython.github.io/fake-jobs/jobs/senior-python-dev" target="_blank" class="card-footer-item">Apply</a>
</footer>
<div>
</div>
这个HTML示例展示了一个包含两个链接的<footer>元素,每个链接都有一个href属性,我们要提取这里的href属性(href Attribute)。
代码如下。
python
for job_element in python_job_elements:
    # -- snip --
    links = job_element.find_all("a")
    for link in links:
        link_url = link["href"]
        print(f"Apply here: {link_url}\n")
这段代码遍历python_job_elements列表(其中包含所有包含"python"关键字的工作职位的HTML元素)。
对于每个job_element,使用find_all方法查找所有<a>元素,并将结果存储在links列表中。
遍历links列表,对于每个link元素,使用link"href"提取其href属性值。
打印出每个提取的链接URL。
5. 更多例子
下面这些工具分别对应自动化抓取(Automated Scraping)、爬虫框架(Web Crawling Framework)和自动化工作流(Automated Workflow)等进一步方向。