一、前言
日常开发中,我们经常需要对列表数据进行去重处理,比如接口数据清洗、日志数据统计、数据集预处理等场景。
很多新手首选 set() 进行去重,但该方法存在致命问题:会打乱列表原有顺序,且仅支持可哈希数据。
为了兼顾顺序、性能和兼容性,本文整理6种工业级去重方案,覆盖「无需保序、需要保序、海量数据、复杂数据类型」等全场景。
二、方法一:set强制去重(最简单、不保留顺序)
2.1 实现原理
利用Python集合(set)元素唯一、自动去重的特性,将列表转为集合后再转回列表,代码极简、执行速度极快。
2.2 代码示例
# 基础列表去重(不保留原顺序) old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = list(set(old_list)) print(new_list)
2.3 优缺点分析
✅ 优点:代码最短、性能最优,适合大数据量、无需关注顺序的场景
❌ 缺点:彻底打乱原始列表顺序,不支持列表、字典等不可哈希元素去重
💡 适用场景:数据统计、临时去重、无序数据处理
三、方法二:for循环遍历去重(原生、保留顺序)
3.1 实现原理
创建空列表存储新数据,遍历原列表,判断元素未存在时追加,完全保留原始数据顺序,兼容性极强。
3.2 代码示例
# 遍历去重(保留原始顺序) old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = [] for item in old_list: if item not in new_list: new_list.append(item) print(new_list)
3.3 优缺点分析
✅ 优点:100%保留原顺序、逻辑简单、新手易懂、兼容所有数据类型
❌ 缺点:数据量超大时,item not in list 查询效率低,耗时较长
💡 适用场景:小批量数据、需要严格保留数据顺序的业务场景
四、方法三:字典fromkeys去重(高效保序、Python3.7+)
4.1 实现原理
Python3.7及以上版本,字典默认保留键的插入顺序 ,且字典键天然唯一。通过 dict.fromkeys() 快速去重,兼顾性能与顺序。
4.2 代码示例
# 字典去重(高效保序) old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = list(dict.fromkeys(old_list)) print(new_list)
4.3 优缺点分析
✅ 优点:保留顺序 + 性能优异,代码简洁,是中小数据量最优解
❌ 缺点:仅支持可哈希数据,低版本Python(3.6及以下)无法保序
💡 适用场景:绝大多数日常开发场景(Python3.7+环境)
五、方法四:列表推导式去重(简洁优雅、保序)
5.1 实现原理
基于遍历思路优化,用列表推导式简化代码,通过索引判断元素首次出现位置,实现去重保序。
5.2 代码示例
# 列表推导式去重 old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = [old_list[i] for i in range(len(old_list)) if old_list[i] not in old_list[:i]] print(new_list)
5.3 优缺点分析
✅ 优点:代码极简优雅、保留顺序、无需额外变量
❌ 缺点:底层仍是遍历查询,大数据量性能较差
💡 适用场景:代码精简要求高、小数据量业务
六、方法五:OrderedDict去重(兼容低版本、保序)
6.1 实现原理
利用有序字典 OrderedDict 的键唯一且有序特性,适配Python3.6及以下低版本环境。
6.2 代码示例
# 有序字典去重(兼容低版本) from collections import OrderedDict old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = list(OrderedDict.fromkeys(old_list)) print(new_list)
6.3 优缺点分析
✅ 优点:全版本Python兼容、稳定保序、性能优于普通遍历
❌ 缺点:需要导入模块,高版本Python性价比低于普通字典
💡 适用场景:老旧项目、低版本Python环境适配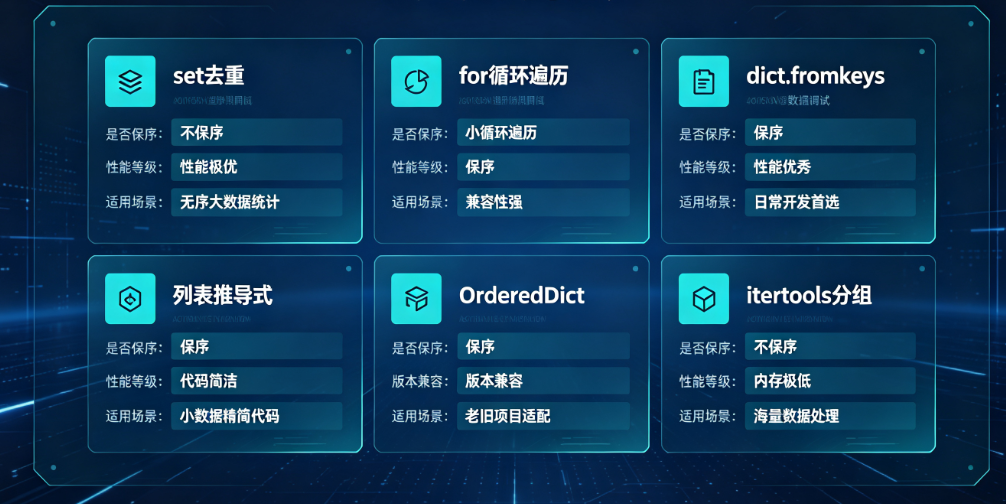
七、方法六:itertools高效去重(海量数据最优解)
7.1 实现原理
借助 itertools.groupby 对可迭代对象分组去重,迭代器处理数据,内存占用极低,适合百万级海量数据。
7.2 代码示例
# 海量数据高效去重 import itertools old_list = [2, 3, 1, 2, 3, 4, 5, 4, 6] new_list = [key for key, _ in itertools.groupby(sorted(old_list))] print(new_list)
7.3 优缺点分析
✅ 优点:内存占用极小、海量数据性能碾压其他方法
❌ 缺点:需先排序,会打乱原始顺序
💡 适用场景:大数据量批量去重、日志清洗、数据集处理
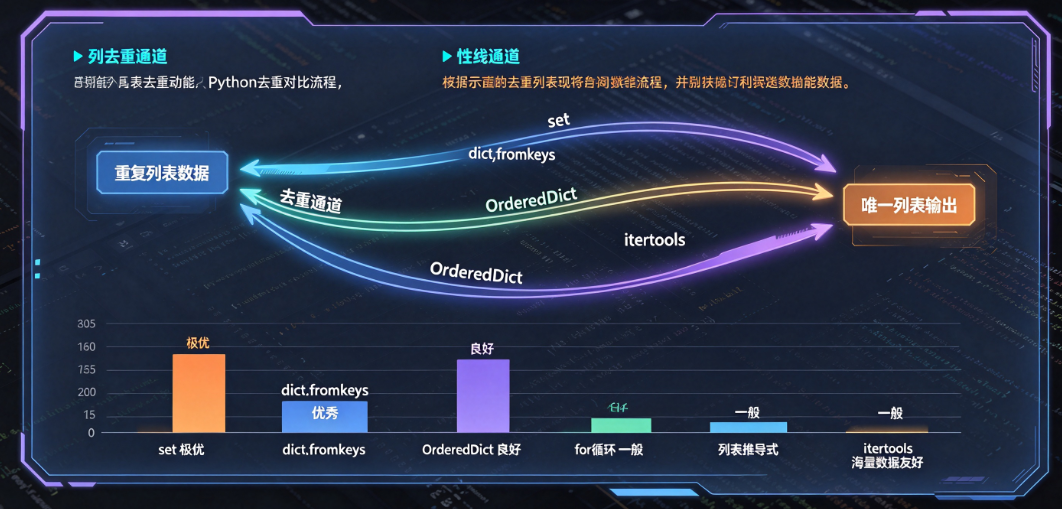
八、六种方法性能&场景终极对比
| 去重方法 | 是否保序 | 大数据性能 | 兼容性 | 推荐场景 |
|---|---|---|---|---|
| set去重 | 否 | 极优 | 可哈希数据 | 无序大数据统计 |
| for循环遍历 | 是 | 较差 | 全类型兼容 | 小数据、新手调试 |
| dict.fromkeys | 是(3.7+) | 优秀 | 可哈希数据 | 日常开发首选 |
| 列表推导式 | 是 | 较差 | 全类型兼容 | 精简代码、小数据 |
| OrderedDict | 是 | 良好 | 全Python版本 | 老旧项目适配 |
| itertools分组 | 否 | 极致优秀 | 可排序数据 | 海量数据处理 |
九、总结(开发首选方案)
-
日常开发通用方案 :优先使用
list(dict.fromkeys(list)),兼顾保序、简洁、性能,适配90%业务场景 -
无序大数据场景 :直接使用
set(),性能最优、代码最短 -
海量数据清洗 :使用
itertools.groupby,低内存、高效率 -
特殊复杂数据(列表/字典元素) :使用for循环遍历,兼容性拉满
十、拓展思考
本文所有方法均针对一维列表,实际开发中还会遇到二维列表、嵌套字典列表去重场景。后续会更新复杂数据结构的高阶去重方案,以及基于numpy、pandas的数据分析极速去重方法。
版权声明:本文为原创技术文章,仅供学习交流,禁止未经授权转载。如有错误或优化建议,欢迎评论区留言讨论!
点赞+收藏+关注,持续更新Python实用开发技巧!