一、不同平台的UAC之间的差异
1.Android
安卓平台的UAC,是基于对PCM数据本身进行衰减后下发到Device的,枚举的时候会下发一个0db给Device(即最大音量),所以Device端获取不到Host端的音量,从而无法同步,做不了相应的UI显示。
2.PC&IOS
PC与IOS平台的UAC,与安卓存在差异,下发数据时,PCM不会随着Host端的音量改变而改变,下发的永远是音频的原始增益,他们的同步机制是利用Feature Unit Control与Android的Host Digital Gain存在明显差异,这也是UAC最标准的做法,如果手机端提前衰减会导致后级处理失去一定的调整空间。
二、不同平台UAC的数据通路
1.Android(国产)
Android Framework
|
↓
AudioFlinger
|
↓
Audio HAL
|
↓
USB Audio HAL
|
↓
USB PCM
|
↓
UAC Device
很多Android设备把USB Audio当普通播放设备:
Host负责最终音量控制,USB设备只是播放器。
所以它不会依赖UAC Feature Unit。
2.Samsung
三星经过RMS测试比较特殊。
它也是Android,但是USB Audio实现比很多国产机更接近标准。
Android Audio Framework
|
↓
数字衰减
|
↓
USB PCM
和国产安卓类似。
三星可能存在:
- 不同OneUI版本
- 不同USB模式
- UAC1/UAC2差异
导致行为变化。
3.IOS
苹果是最标准的一类。
链路:
iOS Audio HAL
|
↓
USB Audio Class
|
↓
USB PCM
|
↓
Device Feature Unit
iOS更倾向:
如果设备声明支持Volume Control,就交给设备处理。
所以:
系统音量:
100%
↓
50%
发送:
SET_CUR
Feature Unit
Volume = -xx dB
Device端根据db值进行对应的音量调整
4.Windows PC
Windows最复杂。
正常UAC设备:
Application
       |
Windows Audio Engine
       |
Endpoint Volume
       |
USB Audio Driver
       |
SET_CUR Volume
       |
Device
如果设备支持Feature Unit Volume
Windows会:
- 保持PCM
- 发控制命令来同步音量
三、实际RMS测试
测试步骤
1.首先用audicity生成一个振幅为0.1的1khz正弦波,它的RMS为-23.01dBFS
2.关闭Device端的UAC音量同步功能,不响应Host端的音量调节指令,保证I2S输出USB下发的Raw data
3.Device连接不同平台,将音量调到最大,并分别播放第一步生成的正弦波
3.使用逻辑分析仪抓I2S包,并且配置好解码参数,导出CSV文件
4.调用python转化脚本(附在文末),将CSV转化为PCM或者WAV文件
5.audicity打开测试音频,可以看到是逐级递减的,打开RMS分析即可获取各段音量的RMS
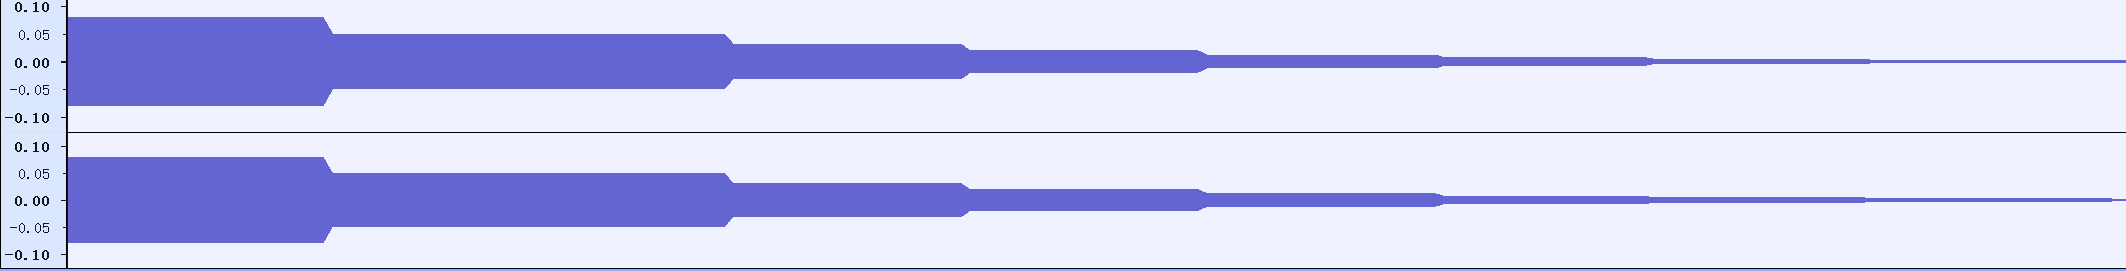
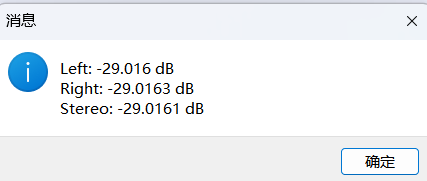
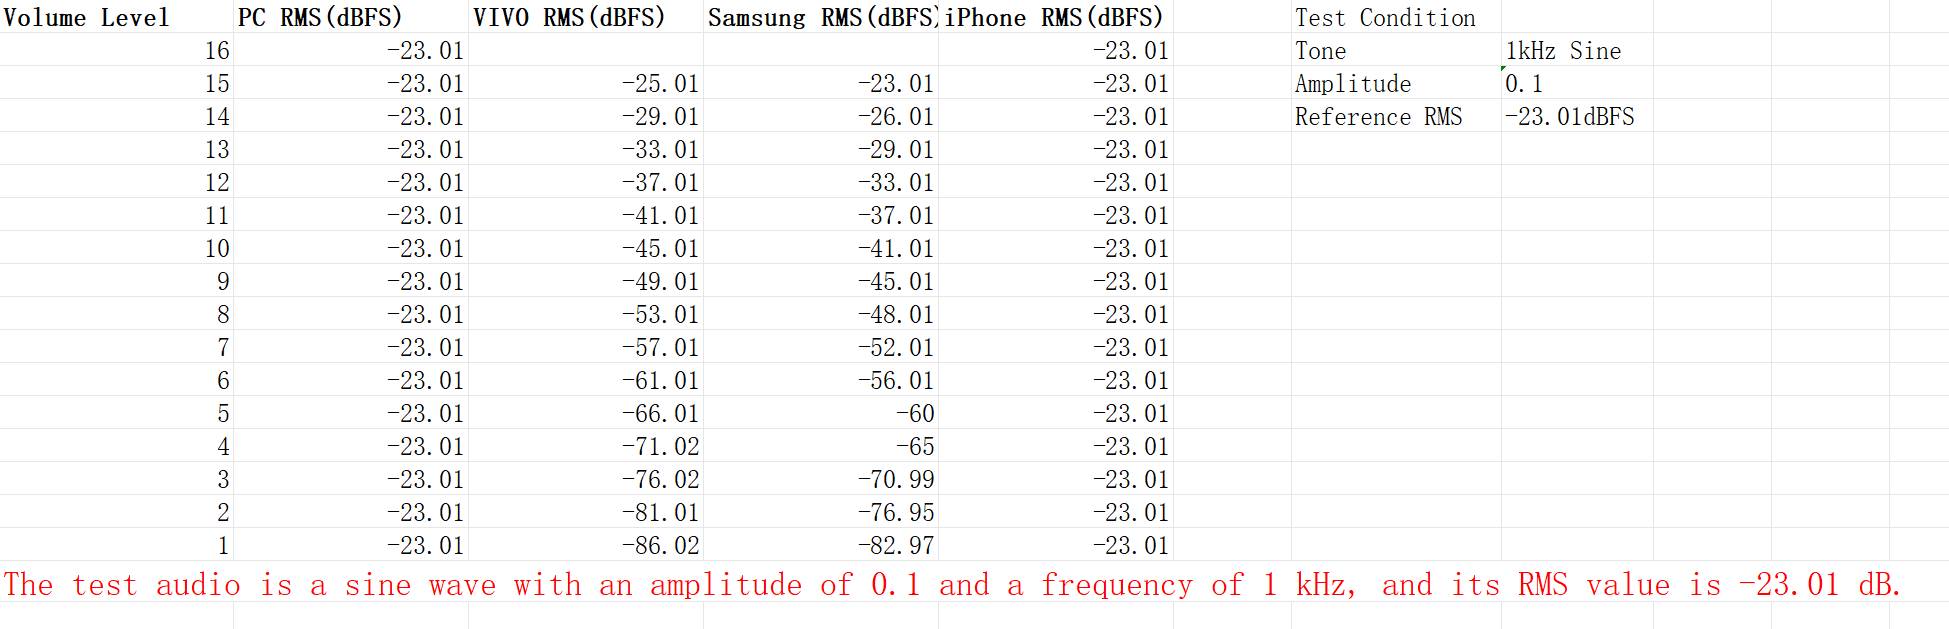
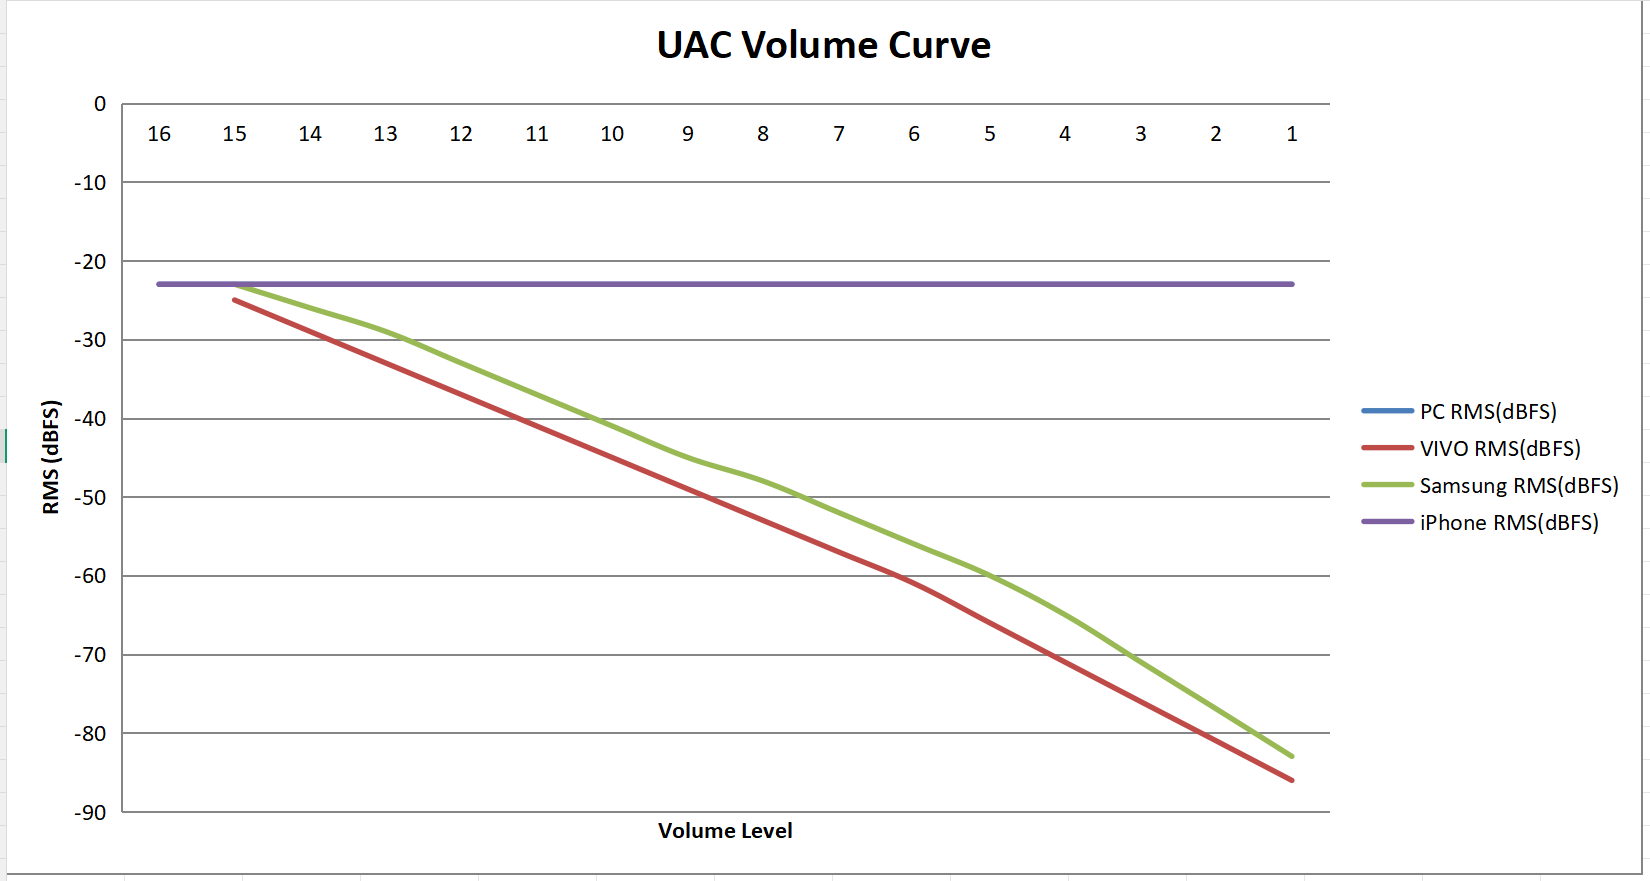
测试结果
四、总结
基于以上测试,可得知:Android对于UAC的Feature Unit Voiume 没有强制要求,基本上是采取软增益的方式调整的音频音量,这种方式简单,但是会导致丢失数字动态范围以及各个平台的音量曲线不同,且Device端无法根据手机音量做对应的UI显示,不利于产品推广,在评估UI时需要考虑到这一点
五、CSV转化脚本
python
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
I2S CSV 转 24bit PCM 工具(自动识别两种 CSV 格式)

支持格式 1(Saleae 逻辑分析仪标准格式):
    name,type,start_time,duration,channel,data
    "I2S / PCM","data",0.0000147,0.00000748,0x0000000000000001,0x0000000000F80F46

支持格式 2(国产逻辑分析仪 / 简化导出格式):
    Time [s],Channel,Value
    0.000010420000000,2,0xFFFE71

用法:
    python i2s_to_pcm.py input.csv output.pcm
    python i2s_to_pcm.py input.csv output.wav --wav
"""

import csv
import struct
import sys
import argparse
import wave


def parse_hex(val: str) -> int:
    """解析十六进制字符串为整数"""
    return int(val.strip(), 16)


def i2s_data_to_int24(raw: int) -> int:
    """
    将原始数据转为 24bit 有符号整数
    自动判断:低24位有效
    """
    val = raw & 0xFFFFFF  # 取低 24 位
    # 24bit 有符号:最高位为符号位
    if val & 0x800000:
        val -= 0x1000000
    return val


def int24_to_bytes_le(val: int) -> bytes:
    """24bit 有符号整数 → 3 字节小端格式"""
    if val < 0:
        val += 0x1000000
    return struct.pack('<I', val)[:3]


def detect_csv_format(csv_path: str):
    """自动识别 CSV 格式,返回格式类型和表头"""
    with open(csv_path, 'r', encoding='utf-8') as f:
        reader = csv.reader(f)
        header = next(reader)

    header_lower = [h.strip().lower() for h in header]

    # 格式 1: Saleae 标准格式(有 name, type, channel, data 列)
    if 'name' in header_lower and 'type' in header_lower and 'channel' in header_lower and 'data' in header_lower:
        return 'saleae', header

    # 格式 2: 简化格式(有 Time, Channel, Value 列)
    if any('time' in h for h in header_lower) and 'channel' in header_lower and 'value' in header_lower:
        return 'simple', header

    raise ValueError(f"无法识别的 CSV 格式,表头: {header}")


def convert_csv_to_pcm(csv_path: str, pcm_path: str,
                       sample_rate: int = 48000,
                       bits_per_sample: int = 24,
                       channels: int = 2,
                       swap_channels: bool = False):
    """
    读取 I2S CSV,输出交错立体声 PCM 文件

    输出格式:
        24bit 小端,立体声,左声道在前,右声道在后(L R L R ...)
    """
    # 自动识别格式
    fmt, header = detect_csv_format(csv_path)
    print(f"[信息] 检测到 CSV 格式: {fmt}")

    left_samples = []   # 左声道样本列表
    right_samples = []  # 右声道样本列表

    total_rows = 0
    data_rows = 0

    with open(csv_path, 'r', encoding='utf-8') as f:
        reader = csv.DictReader(f)

        for row in reader:
            total_rows += 1

            if fmt == 'saleae':
                # 格式1: Saleae 标准格式
                if row.get('type', '').strip() != 'data':
                    continue
                try:
                    ch = parse_hex(row['channel'])
                    data = parse_hex(row['data'])
                except (KeyError, ValueError):
                    continue

                # Saleae: channel=0 → 左声道,channel=1 → 右声道
                # (I2S 标准: WS=0 左声道, WS=1 右声道)
                is_left = (ch == 0)

            elif fmt == 'simple':
                # 格式2: 简化格式
                try:
                    ch = int(row['Channel'].strip())
                    data = parse_hex(row['Value'])
                except (KeyError, ValueError):
                    continue

                # 简化格式: Channel=1 → 左声道,Channel=2 → 右声道
                is_left = (ch == 1)

            else:
                continue

            sample = i2s_data_to_int24(data)
            data_rows += 1

            if swap_channels:
                is_left = not is_left

            if is_left:
                left_samples.append(sample)
            else:
                right_samples.append(sample)

    # 对齐左右声道长度(取较短的)
    min_len = min(len(left_samples), len(right_samples))
    left_samples = left_samples[:min_len]
    right_samples = right_samples[:min_len]

    # 写入 PCM 文件(交错立体声)
    with open(pcm_path, 'wb') as f:
        for i in range(min_len):
            f.write(int24_to_bytes_le(left_samples[i]))
            f.write(int24_to_bytes_le(right_samples[i]))

    # 统计信息
    duration_sec = min_len / sample_rate if sample_rate > 0 else 0
    print(f"[完成] 转换结果:")
    print(f"  CSV 总行数:       {total_rows}")
    print(f"  有效数据行:       {data_rows}")
    print(f"  左声道样本数:     {len(left_samples)}")
    print(f"  右声道样本数:     {len(right_samples)}")
    print(f"  采样率:           {sample_rate} Hz")
    print(f"  位深:             {bits_per_sample} bit")
    print(f"  声道数:           {channels} (立体声)")
    print(f"  音频时长:         {duration_sec:.2f} 秒")
    print(f"  PCM 文件大小:     {min_len * channels * bits_per_sample // 8} 字节")
    print(f"  输出文件:         {pcm_path}")

    return min_len


def pcm_to_wav(pcm_path: str, wav_path: str,
               sample_rate: int = 48000,
               bits_per_sample: int = 24,
               channels: int = 2):
    """PCM 裸流加 WAV 头"""
    with open(pcm_path, 'rb') as f:
        pcm_data = f.read()

    with wave.open(wav_path, 'wb') as wf:
        wf.setnchannels(channels)
        wf.setsampwidth(bits_per_sample // 8)
        wf.setframerate(sample_rate)
        wf.writeframes(pcm_data)

    print(f"  WAV 文件:         {wav_path}")


def main():
    parser = argparse.ArgumentParser(description='I2S CSV 转 24bit PCM / WAV(自动识别格式)')
    parser.add_argument('input_csv', help='输入 CSV 文件路径')
    parser.add_argument('output', help='输出 PCM 文件路径')
    parser.add_argument('--rate', type=int, default=48000,
                        help='采样率 (默认 48000)')
    parser.add_argument('--bits', type=int, default=24,
                        help='位深 (默认 24)')
    parser.add_argument('--wav', action='store_true',
                        help='同时输出 WAV 格式(带文件头)')
    parser.add_argument('--swap-channels', action='store_true',
                        help='交换左右声道')

    args = parser.parse_args()

    print(f"[信息] 输入: {args.input_csv}")
    print(f"[信息] 输出: {args.output}")
    print(f"[信息] 采样率: {args.rate} Hz, 位深: {args.bits} bit")
    print()

    # 转换
    num_samples = convert_csv_to_pcm(
        args.input_csv, args.output,
        sample_rate=args.rate,
        bits_per_sample=args.bits,
        swap_channels=args.swap_channels
    )

    # 可选输出 WAV
    if args.wav:
        wav_path = args.output.rsplit('.', 1)[0] + '.wav'
        pcm_to_wav(args.output, wav_path,
                   sample_rate=args.rate,
                   bits_per_sample=args.bits)

    print()
    print("[提示] 播放 PCM 文件:")
    print(f"  ffplay -f s24le -ac 2 -ar {args.rate} {args.output}")
    print(f"  Audacity → 导入 → 原始数据 → 24bit 有符号 小端 立体声 {args.rate}Hz")


if __name__ == '__main__':
    main()