内容参考于:图灵AI大模型全栈
时间排序
比如新闻,今天的新闻和昨天的新闻,我们肯定是要今天的新闻,昨天新闻的分数就要比今天的新闻分数低,就是确保以最新的数据为准,让大模型获得最新最有时效性的信息
时间排序就是处理这个情况的,它使用了一个时间衰减的算法
如下图:
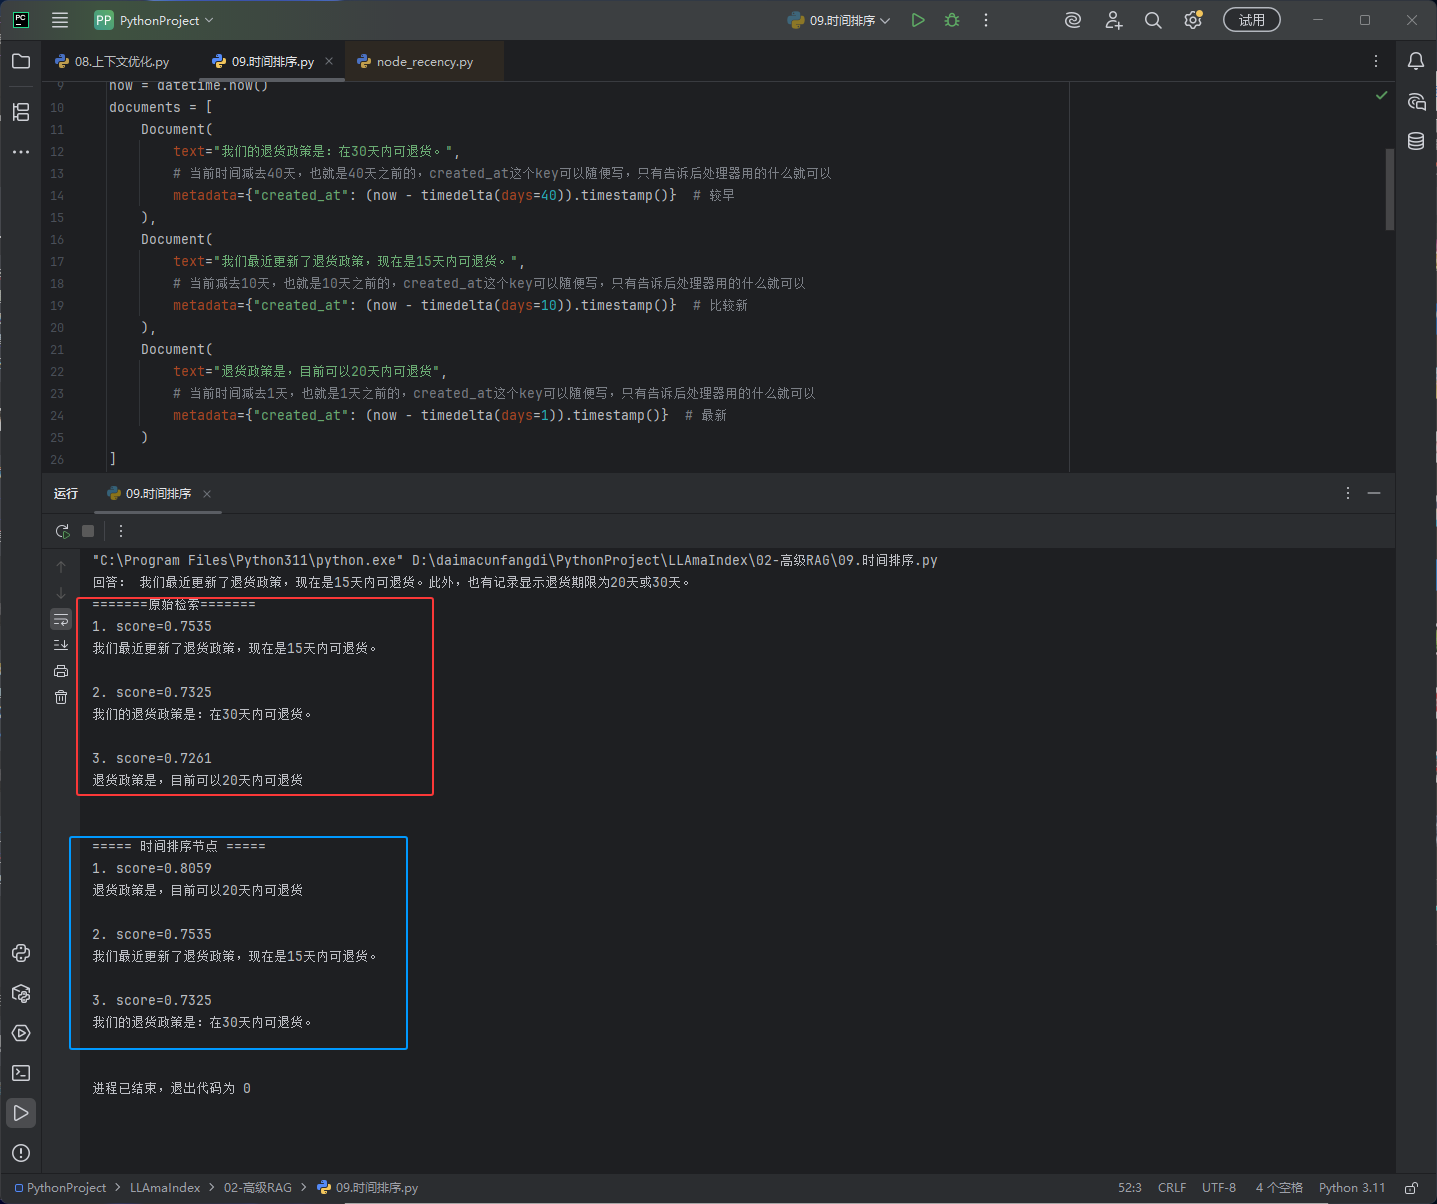
下图红框是时间排序之前的分数,这时的分数都差不多,下图蓝框是时间排序之后的,它的分数就差很多
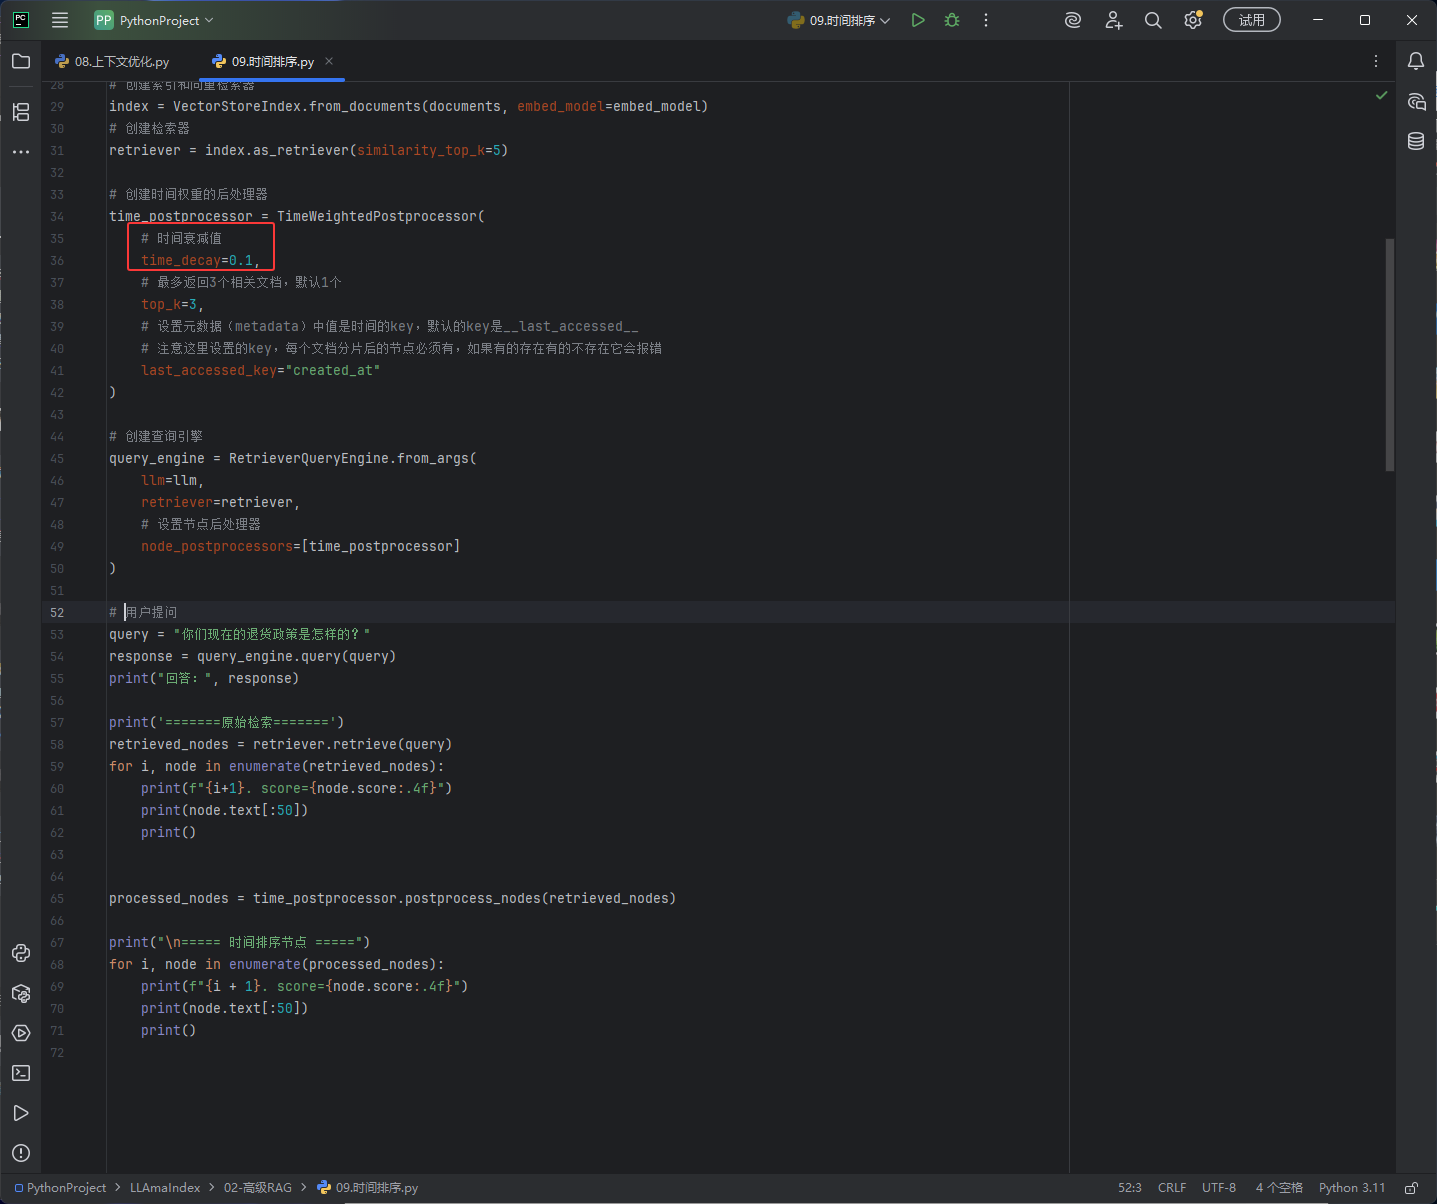
下图红框是时间排序后处理中的时间衰减值
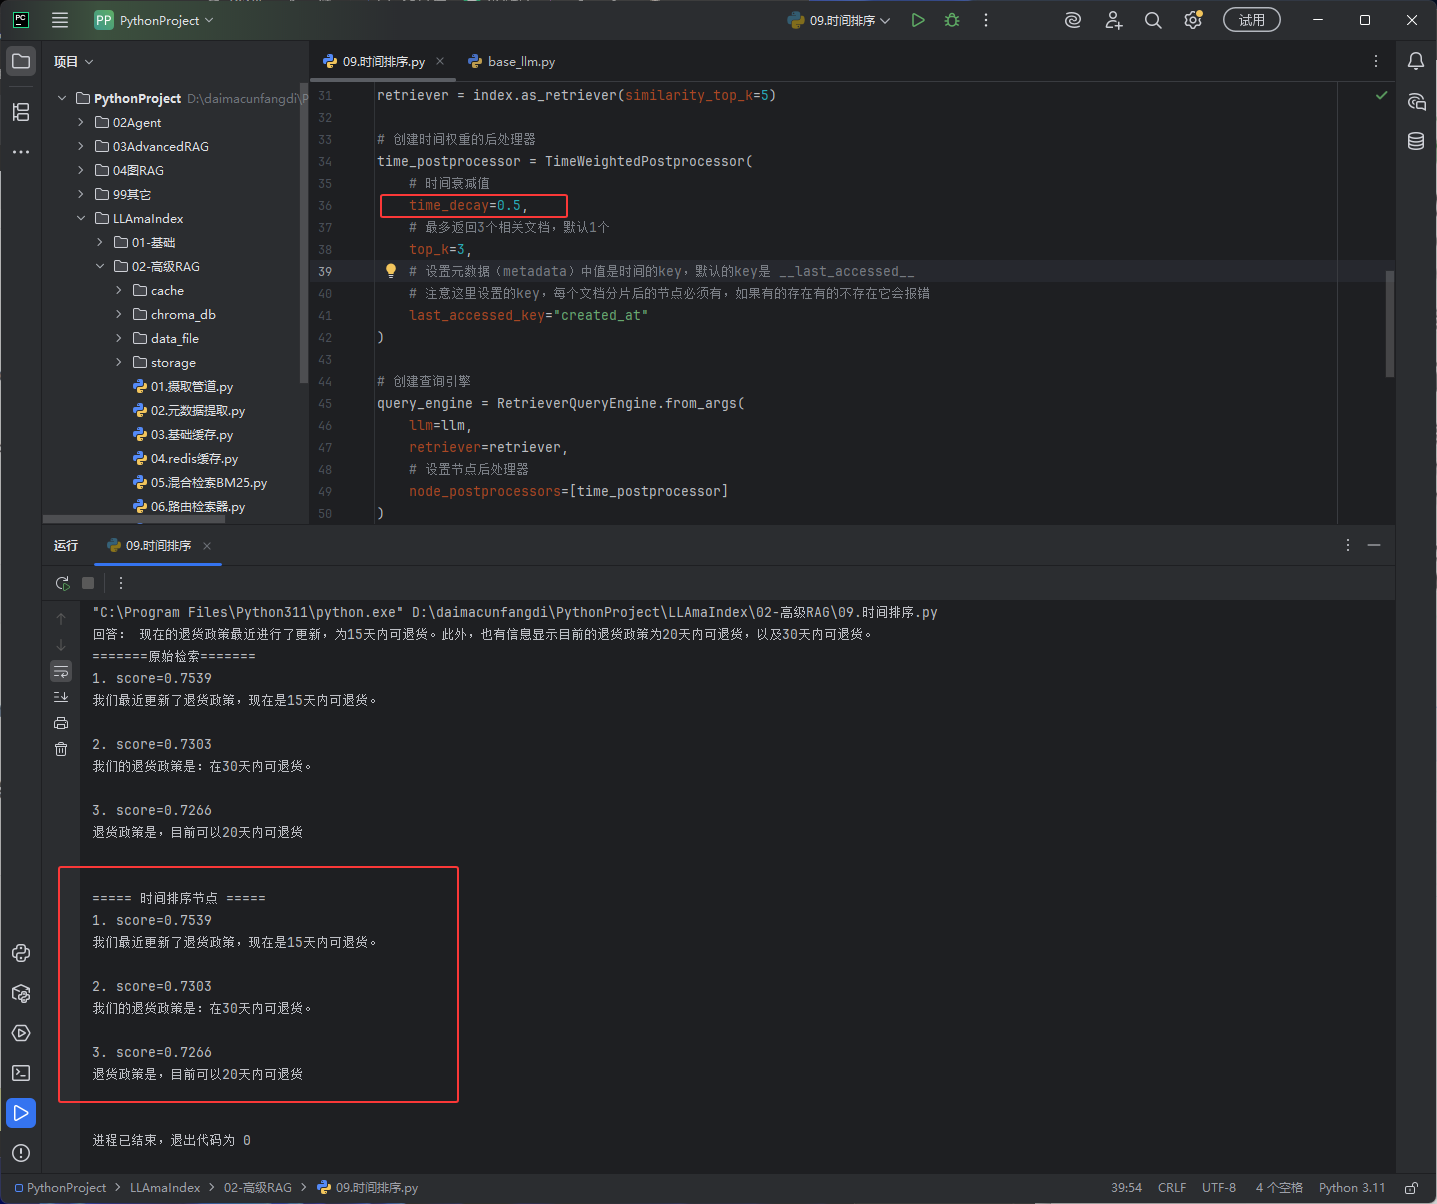
如下图红框衰减值增大
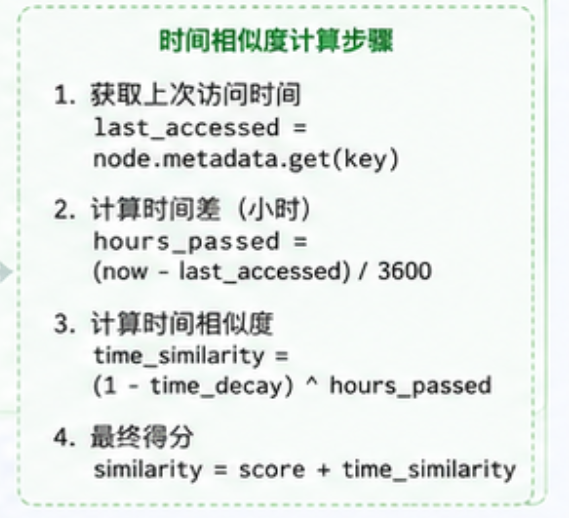
时间衰减的逻辑,下方是一个逻辑图
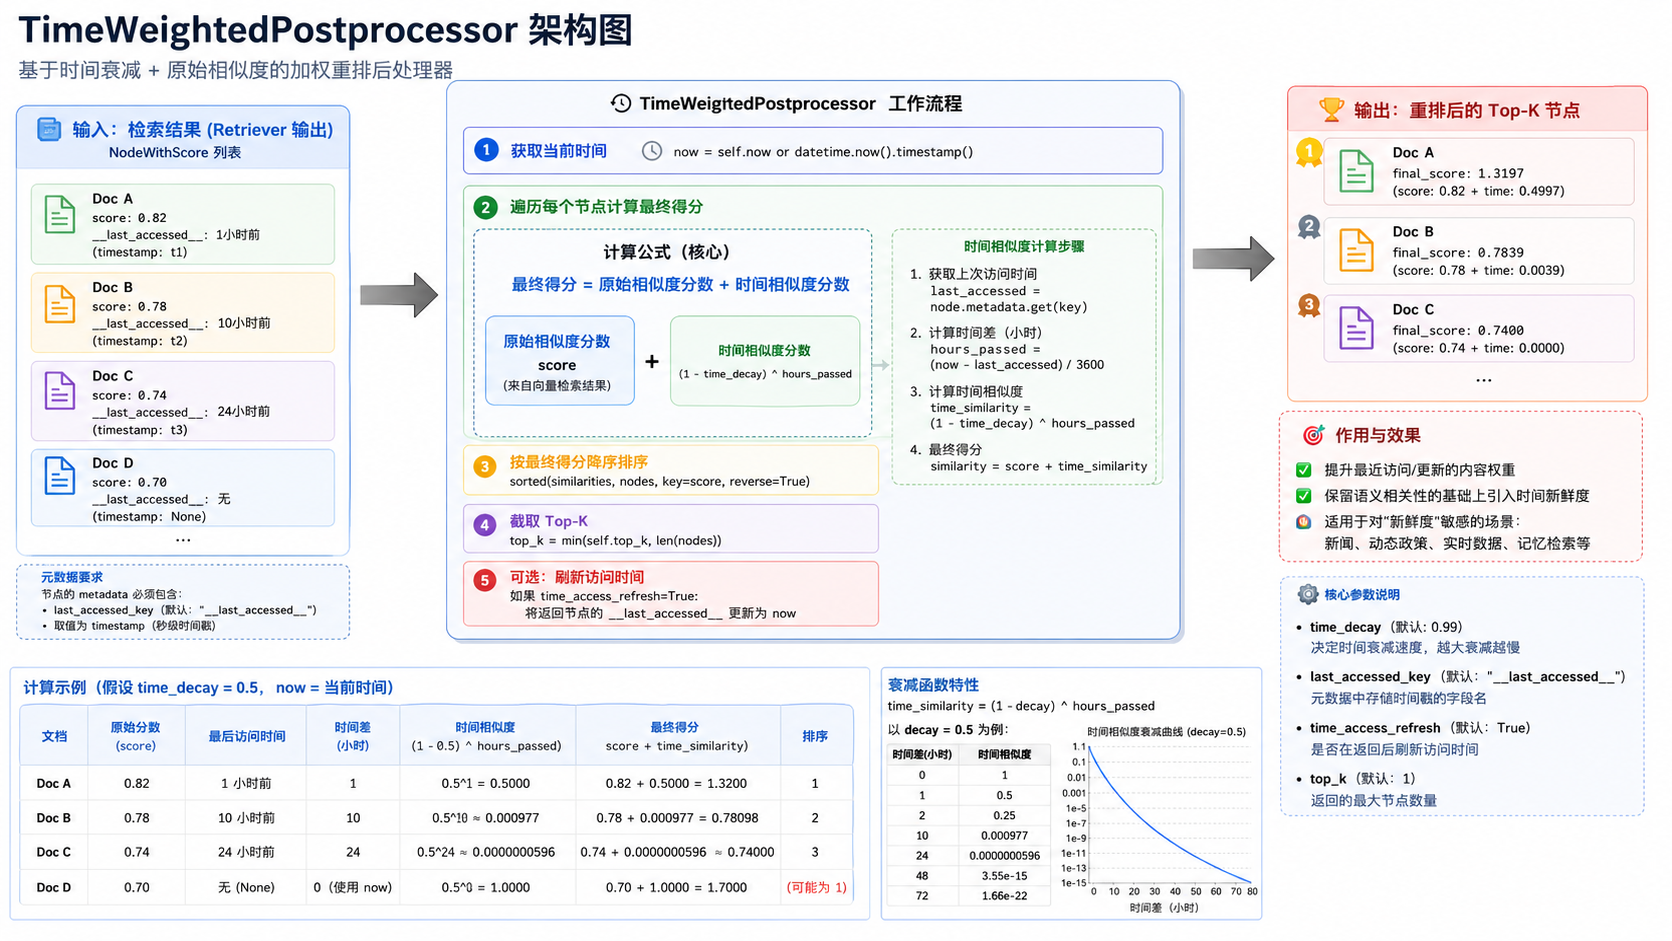
如下图红框,文档的信息,score是分数,__last_accessed__是LLamaIndex默认的文档时间key,__last_accessed__就是说当前文档是多久之前的
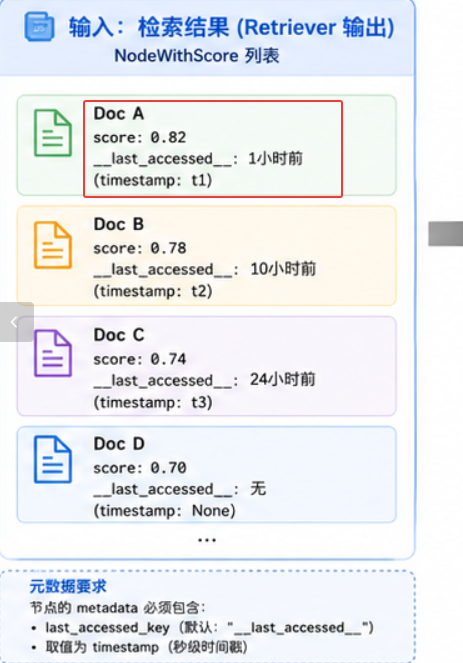
如下图红框,它会获取当前时间
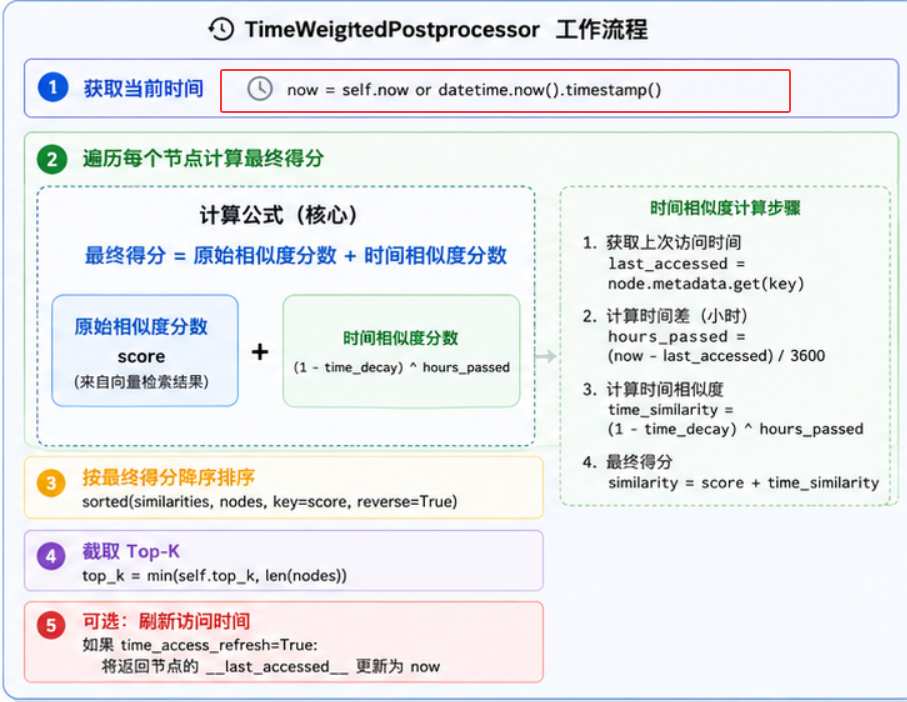
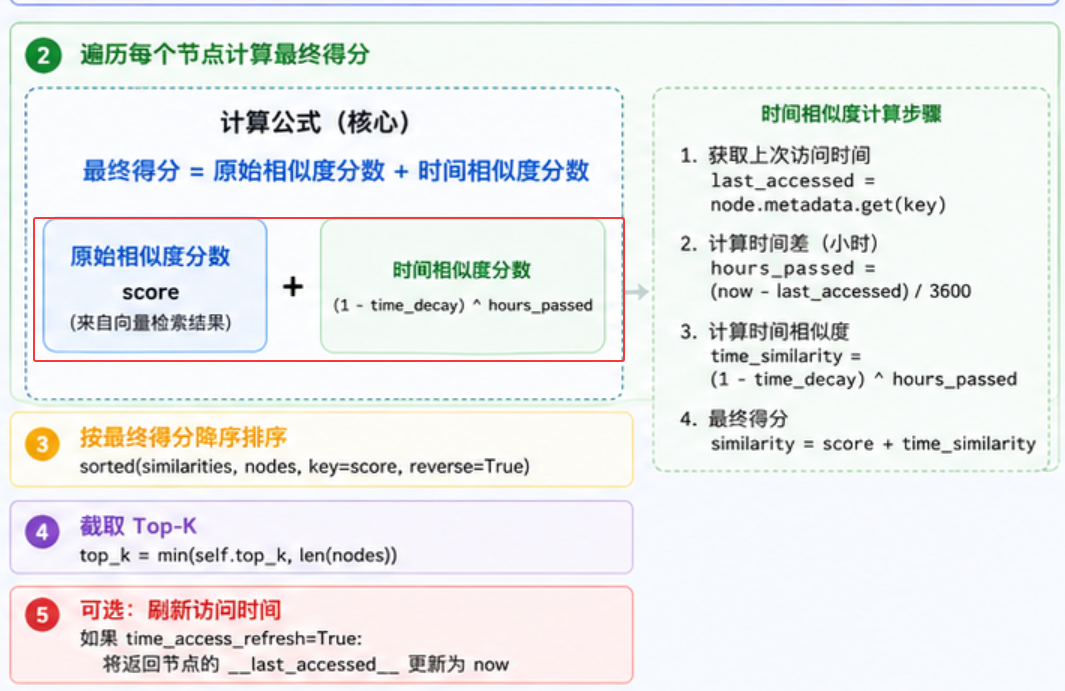
然后把文档的相似度分数 加上 时间的相似度分数,时间相似度的计算如下图红框, 1 减去 time_decay(时间衰减值) ,hours_passed是时间的差值(相差10小时它的值就是10),然后开方,比如 1 减去 time_decay的值是2,hours_passed的值是3,开方就是 2 乘以 2 乘以 2 这样
hours_passed是流逝的小时数,它的计算方式,last_accessed是我们给文档设定的时间,也就是相当于新闻时间,now是当前时间,当前时间 减去 我们给文档设定的时间
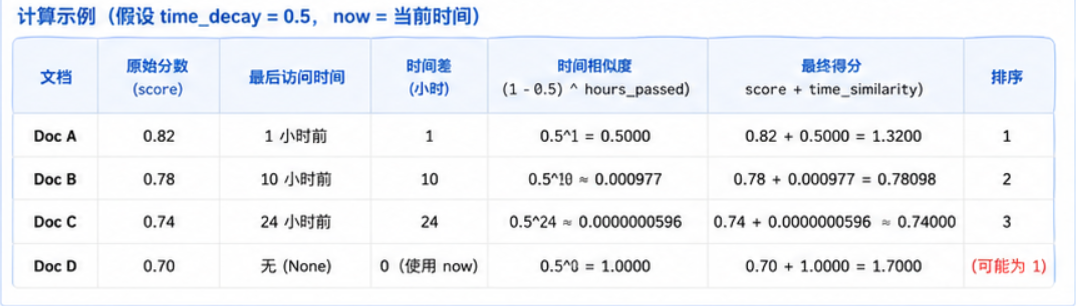
如下图实例,就是说如果我们给的time_decay(衰减值)越小,时间相似度就会越大,也就导致时间相似度的权重就会变高
代码
python
from datetime import datetime, timedelta
from llama_index.core import VectorStoreIndex, Document
from llama_index.core.query_engine import RetrieverQueryEngine
from llama_index.core.postprocessor import TimeWeightedPostprocessor
from base_llm import llm, embed_model

# 获取当前时间
now = datetime.now()
documents = [
    Document(
        text="我们的退货政策是:在30天内可退货。",
        # 当前时间减去40天,也就是40天之前的,created_at这个key可以随便写,只有告诉后处理器用的什么就可以
        metadata={"created_at": (now - timedelta(days=40)).timestamp()}  # 较早
    ),
    Document(
        text="我们最近更新了退货政策,现在是15天内可退货。",
        # 当前减去10天,也就是10天之前的,created_at这个key可以随便写,只有告诉后处理器用的什么就可以
        metadata={"created_at": (now - timedelta(days=10)).timestamp()}  # 比较新
    ),
    Document(
        text="退货政策是,目前可以20天内可退货",
        # 当前时间减去1天,也就是1天之前的,created_at这个key可以随便写,只有告诉后处理器用的什么就可以
        metadata={"created_at": (now - timedelta(days=1)).timestamp()}  # 最新
    )
]

# 创建索引和向量检索器
index = VectorStoreIndex.from_documents(documents, embed_model=embed_model)
# 创建检索器
retriever = index.as_retriever(similarity_top_k=5)

# 创建时间权重的后处理器
time_postprocessor = TimeWeightedPostprocessor(
    # 时间衰减值
    time_decay=0.5,
    # 最多返回3个相关文档,默认1个
    top_k=3,
    # 设置元数据(metadata)中值是时间的key,默认的key是 __last_accessed__
    # 注意这里设置的key,每个文档分片后的节点必须有,如果有的存在有的不存在它会报错
    last_accessed_key="created_at"
)

# 创建查询引擎
query_engine = RetrieverQueryEngine.from_args(
    llm=llm,
    retriever=retriever,
    # 设置节点后处理器
    node_postprocessors=[time_postprocessor]
)

# 用户提问
query = "你们现在的退货政策是怎样的?"
response = query_engine.query(query)
print("回答:", response)

print('=======原始检索=======')
retrieved_nodes = retriever.retrieve(query)
for i, node in enumerate(retrieved_nodes):
    print(f"{i+1}. score={node.score:.4f}")
    print(node.text[:50])
    print()

# 时间排序
processed_nodes = time_postprocessor.postprocess_nodes(retrieved_nodes)

print("\n===== 时间排序节点 =====")
for i, node in enumerate(processed_nodes):
    print(f"{i + 1}. score={node.score:.4f}")
    print(node.text[:50])
    print()