视频链接: https://www.bilibili.com/video/BV1feum6oEzh/?vd_source=5ba34935b7845cd15c65ef62c64ba82f
ollama的并发和tps太慢,最近在尝试vllm或sglang的框架进行加载,如下为vllm部署及使用过程的记录和一些可能大家会碰到的问题,选择https://huggingface.co/Sehyo/Qwen3.5-122B-A10B-NVFP4,参考https://docs.vllm.com.cn/en/latest/getting_started/quickstart/#installation
使用python本地部署方式
mkdir vllm && cd vllm
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=cu130

vllm serve Sehyo/Qwen3.5-35B-A3B-NVFP4 --gpu-memory-utilization 0.5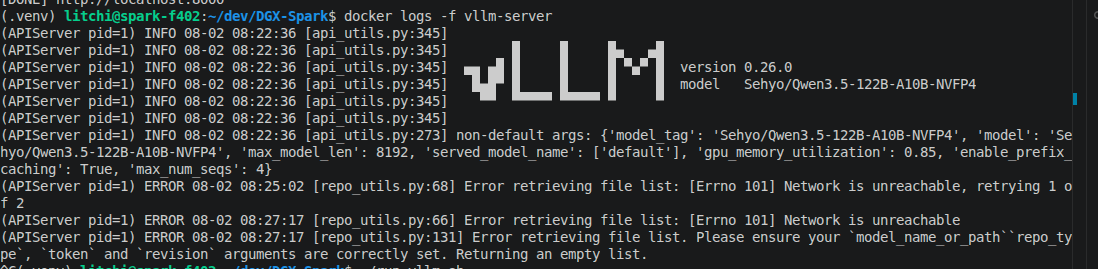
一直尝试联网失败,所以还是网络的问题,加上如下的启动指令,禁止进行hub链接,使用本地缓存的模型
HF_HUB_OFFLINE=1 vllm serve Sehyo/Qwen3.5-35B-A3B-NVFP4 --gpu-memory-utilization 0.5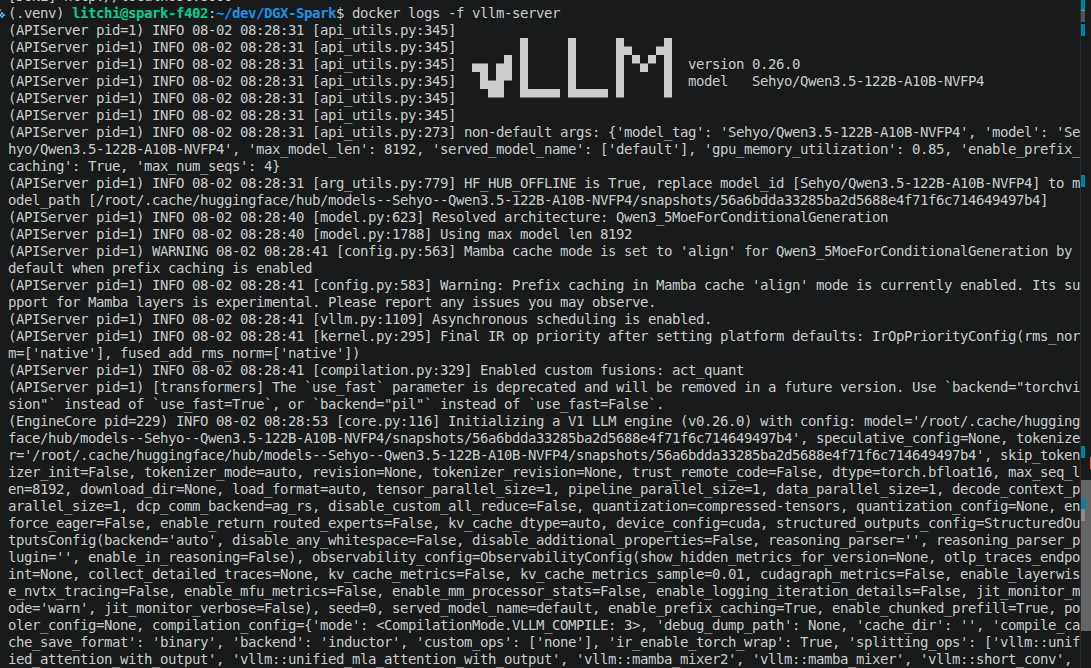
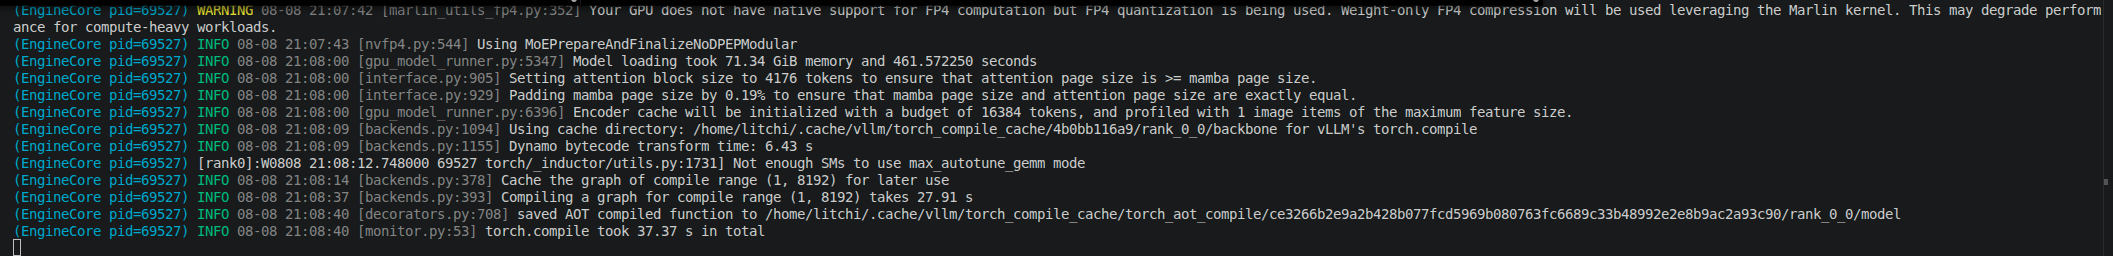
运行122b会出现加载显存爆炸,是因为模型虽然限制了使用,但是比如首次编译如下图,基本上会耗尽显存,所以需要增加swap,过了编译和其他的阶段就会释放
sudo fallocate -l 64G /swapfile2
sudo chmod 600 /swapfile2
sudo mkswap /swapfile2
sudo swapon /swapfile2
echo '/swapfile2 none swap sw 0 0' | sudo tee -a /etc/fstab 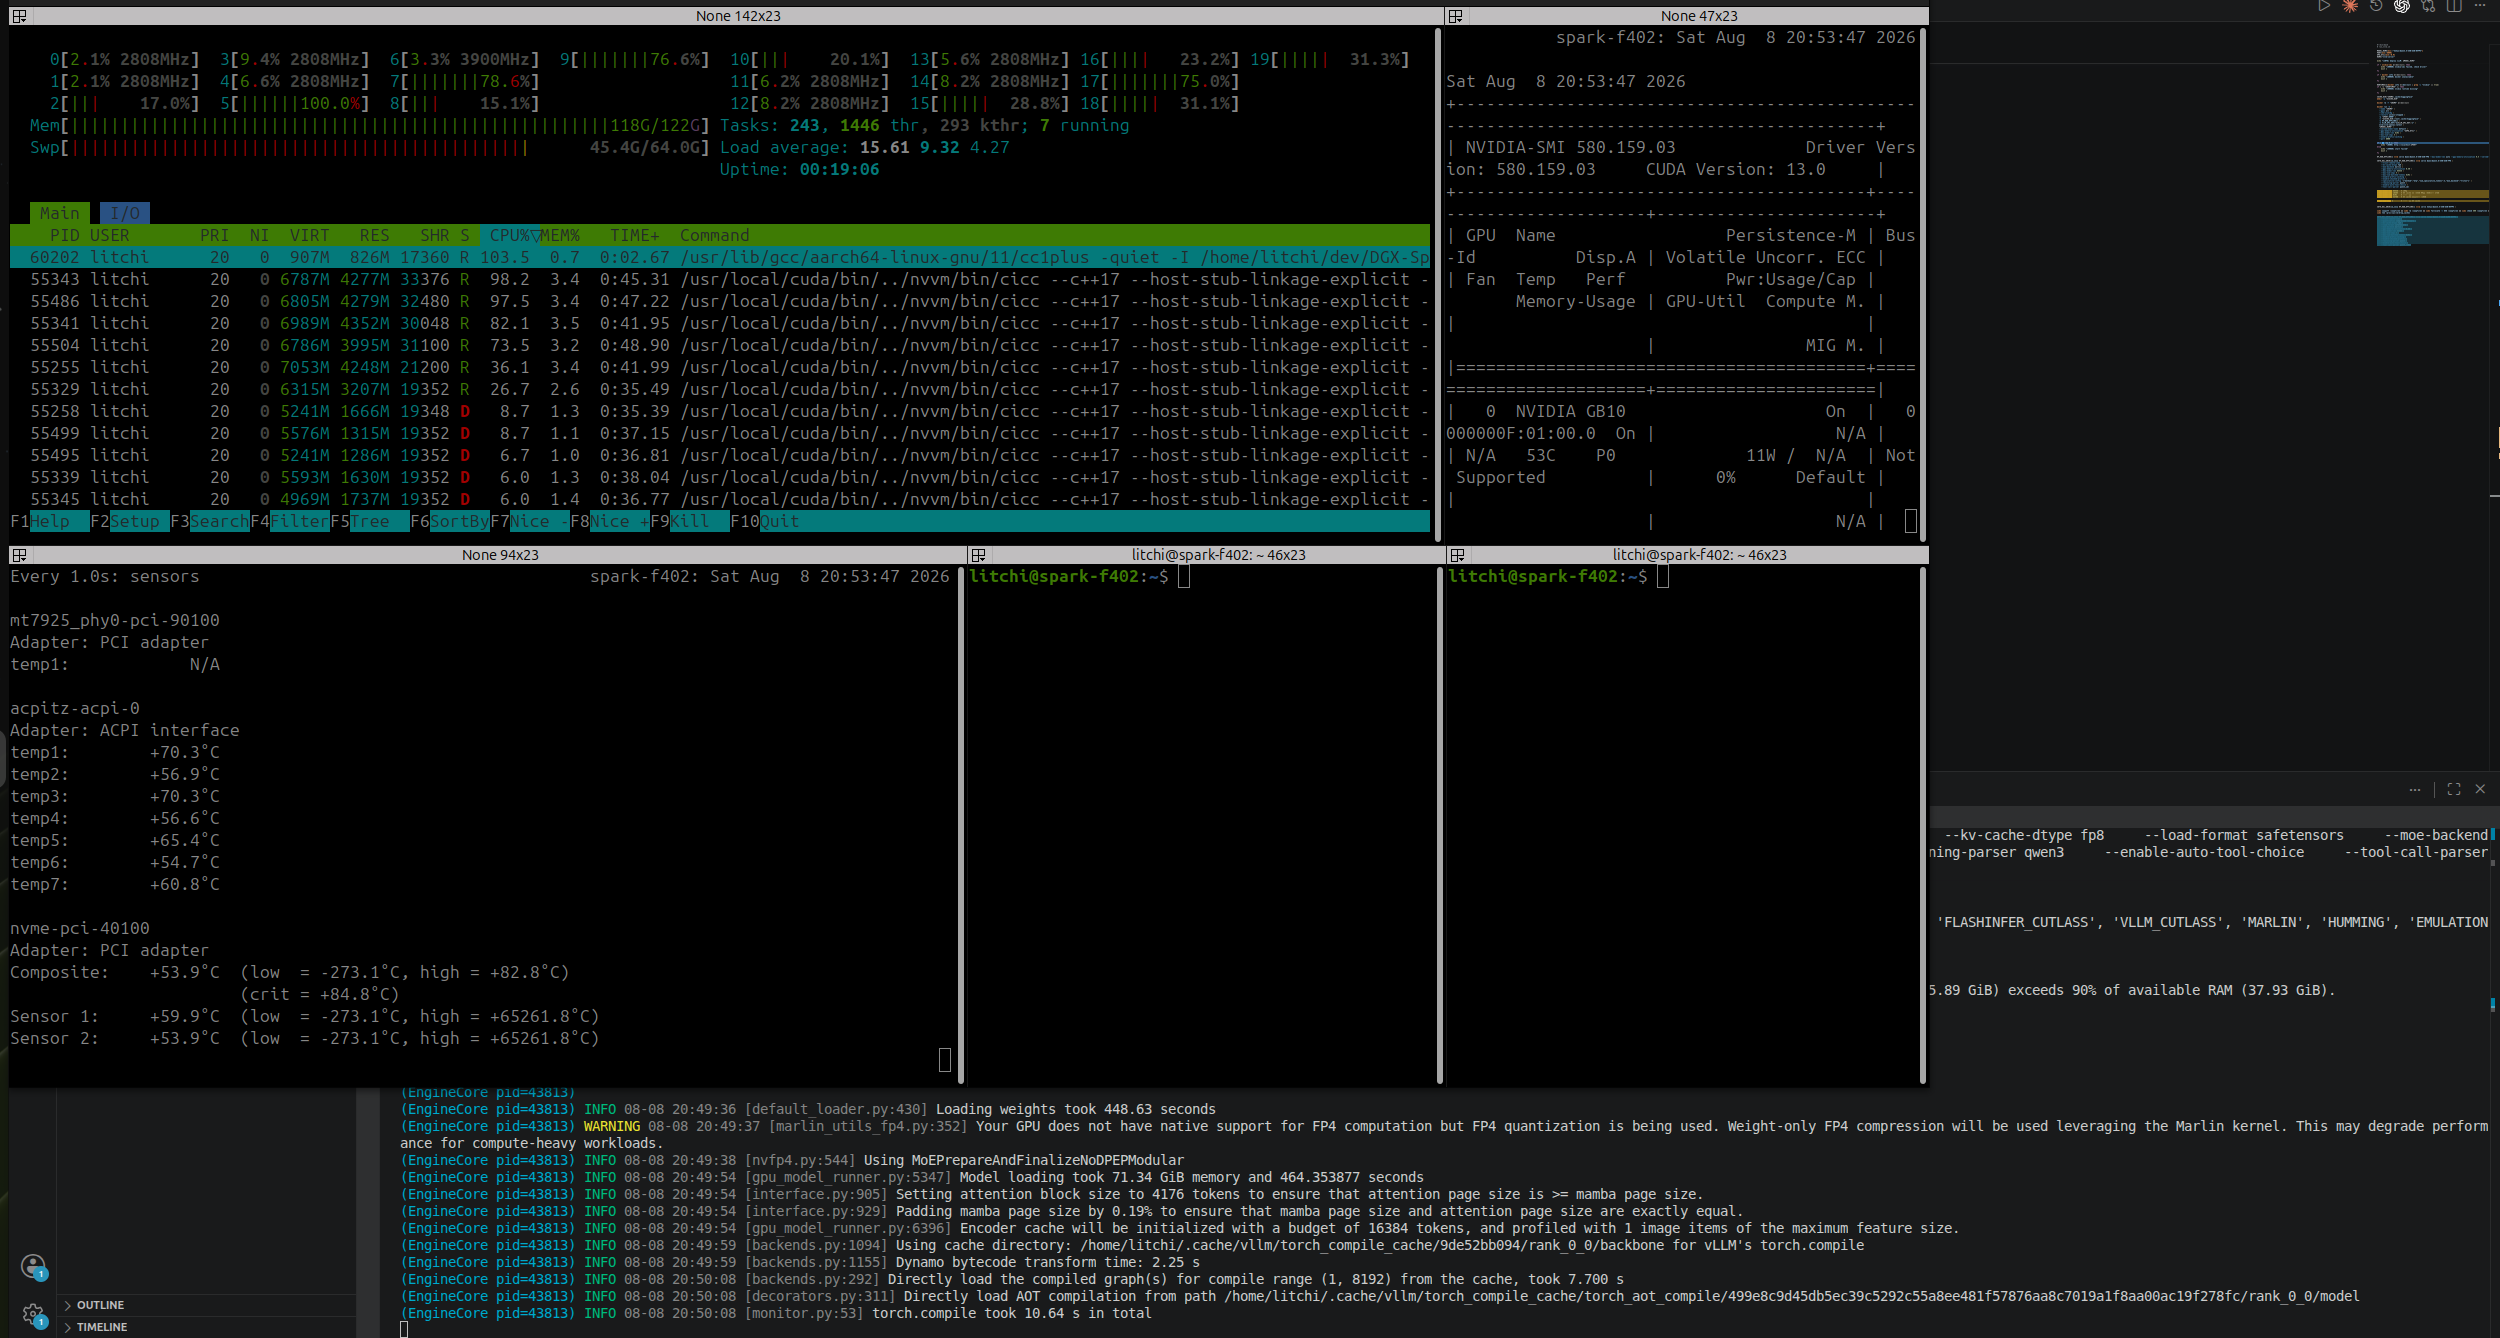
加载权重就花了8分钟左右,由于选择了cuda graph,所以这部分也会有耗时,总耗时接近10分钟左右
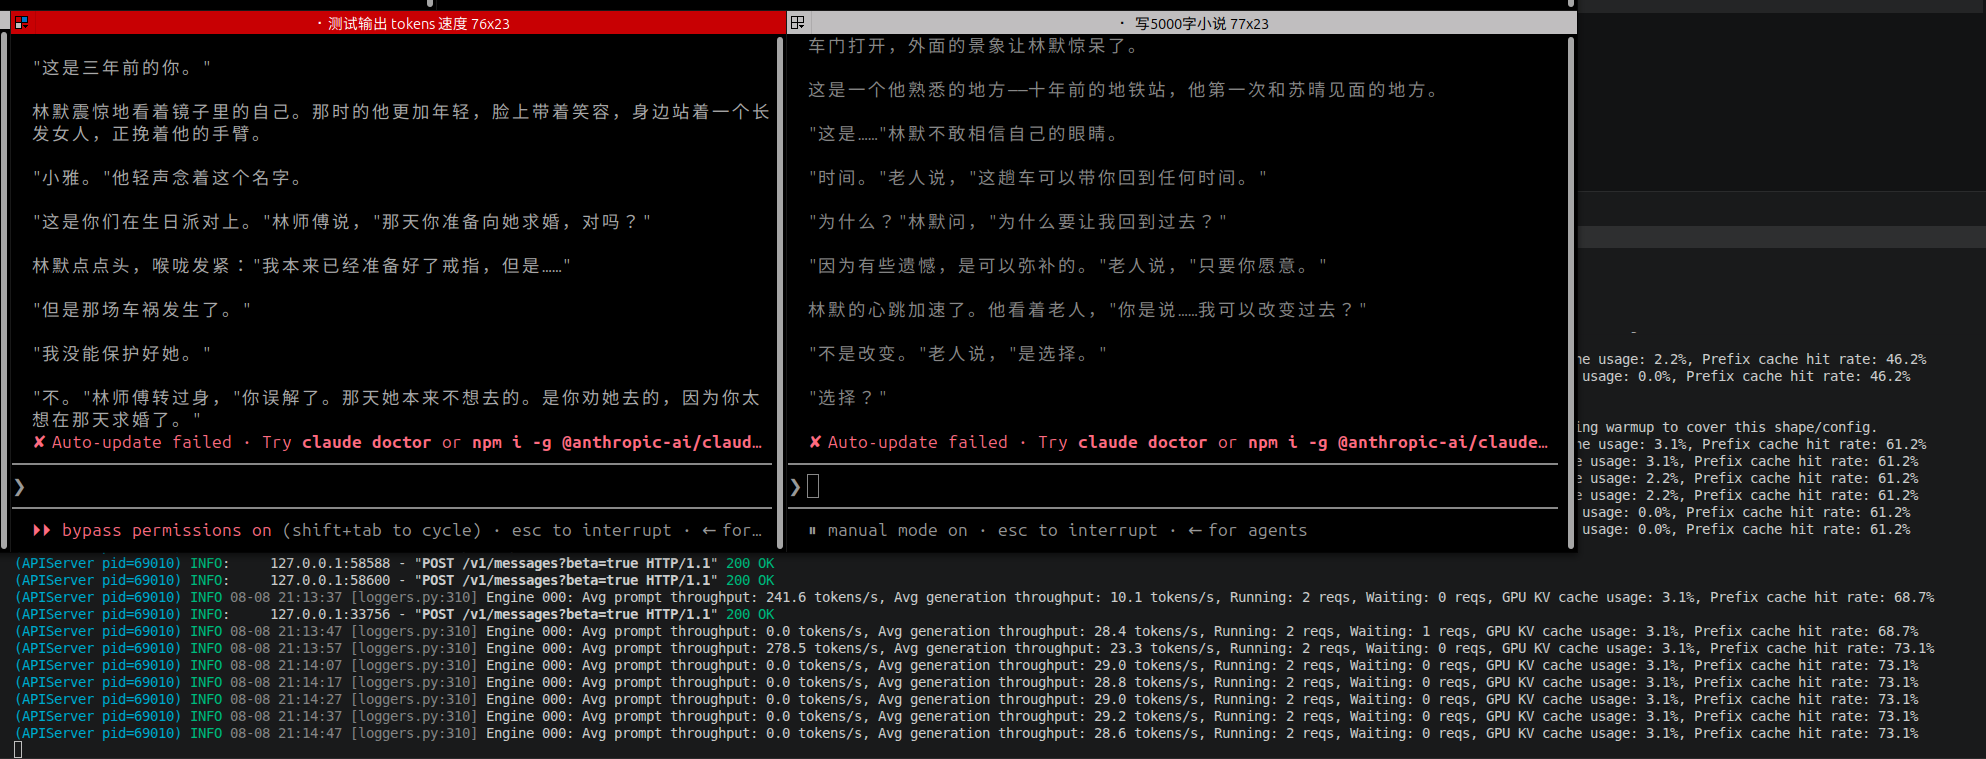
测试下,两个claude code并发同时写5000字小说
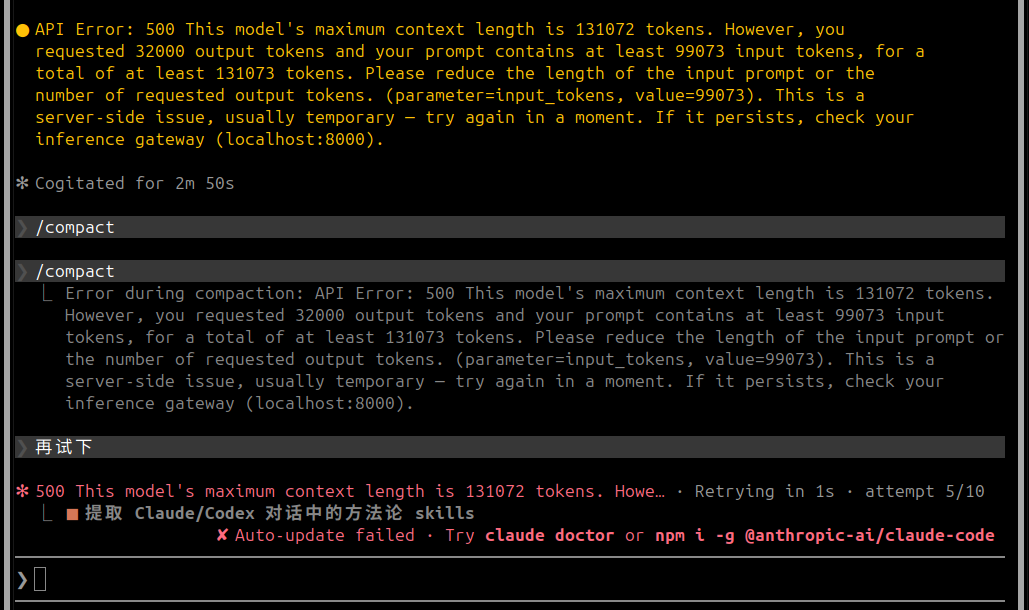
其他的测试过程中也出现如下,上下文的问题
API Error: 500 This model's maximum context length is 131072 tokens. However, you requested 32000 output tokens and your prompt contains at least 99073 input tokens, for a total of at least 131073 tokens. Please reduce the length of the input prompt or the number of requested output tokens. (parameter=input_tokens, value=99073). This is a server-side issue, usually temporary --- try again in a moment. If it persists, check your inference gateway (localhost:8000).
最后使用了hf上sjug的参数,其中提到推荐Spark使用Marlin,约比CUTLASS快2%。
CUTE_DSL_ARCH=sm_121a HF_HUB_OFFLINE=1 vllm serve Sehyo/Qwen3.5-122B-A10B-NVFP4 \
    --trust-remote-code \
    --quantization compressed-tensors \
    --kv-cache-dtype fp8 \
    --load-format safetensors \
    --moe-backend marlin \
    --gpu-memory-utilization 0.70 \
    --max-model-len 262144 \
    --max-num-seqs 2 \
    --max-num-batched-tokens 8192 \
    --enable-prefix-caching \
    --enable-chunked-prefill \
    --reasoning-parser qwen3 \
    --enable-auto-tool-choice \
    --tool-call-parser qwen3_coder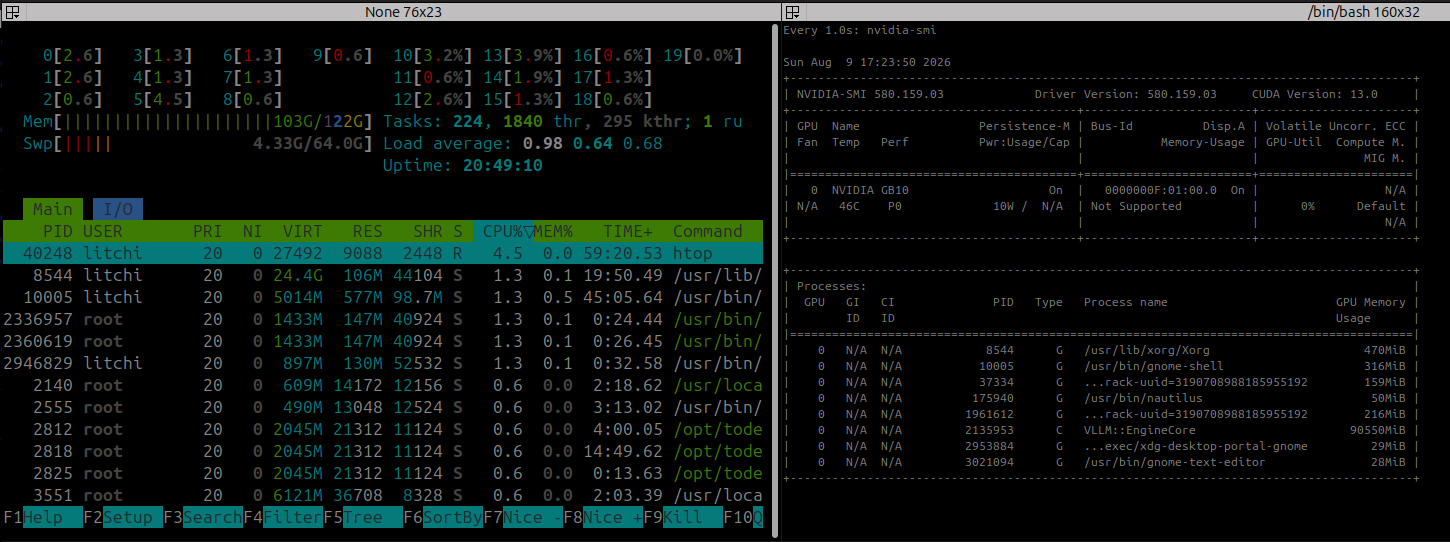
大约可以到30tps