做 AI 项目时,我有一个习惯:只要效果不好,就先怀疑模型。
是不是模型太小?
是不是参数没调好?
是不是 prompt 不够细?
是不是需要换一个更复杂的方案?
后来做过几个分类、推荐和问答相关的小项目之后,我慢慢发现,很多问题其实不是模型造成的,而是数据集本身就不够好。
模型只是把数据里的规律学出来。
如果数据里全是噪声,它学到的也只能是噪声。
一个内容分类项目让我印象很深
之前有个项目,需要把一批文章自动分到不同栏目里,比如科技、财经、教育、健康、生活方式等。
我们一开始拿客户已有的历史数据做训练。数据量不算小,看起来也有标签,所以大家觉得这个项目应该比较顺。
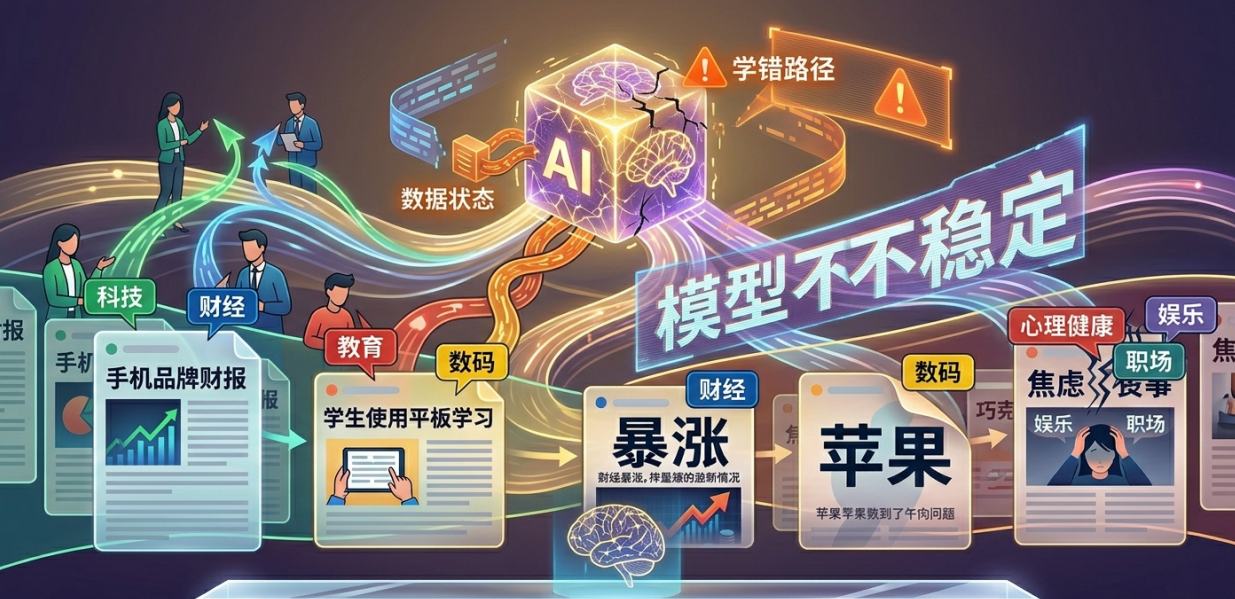
但第一版结果出来后,效果很不稳定。
有些科技新闻被分到了生活栏目。
有些消费类文章被分到了财经栏目。
有些教育规定文章又被分到了社会新闻。
最开始我们以为是模型能力不够,于是不断调参数、改特征、调整关键词权重。结果折腾了几轮,提升并不明显。
后来我们抽样检查训练数据,才发现问题出在源头。
坏数据会把模型带偏
客户提供的历史数据里,有不少标签本来就是错的。
比如一篇讲"手机品牌财报"的文章,有人把它标成科技,有人标成财经;一篇讲"学生使用平板学习"的文章,有人标成教育,有人标成数码。
这些边界模糊的内容本来就需要统一规则,但历史数据里并没有一致标准。
更麻烦的是,还有一些标题党内容。
标题里出现"暴涨",不一定是财经文章;
标题里出现"苹果",不一定是数码文章;
标题里出现"焦虑",也不一定是心理健康文章。
如果只看表面关键词,模型很容易学错。
那次项目让我意识到,高质量数据集不是锦上添花,而是很多 AI 项目的地基。地基歪了,后面模型再复杂也很难稳定。
我后来会把数据集检查放到第一步
现在再遇到类似项目,我不会马上开始调模型,而是先看数据集。
我通常会先问几个问题:
第一,标签体系是否清楚?
比如"科技"和"数码"是不是同一类?"财经"和"商业"边界在哪里?
第二,样本是否足够干净?
有没有大量错标、重复、过期或明显无关的数据?
第三,类别是否均衡?
是不是某些类别有几万条样本,某些类别只有几十条?
第四,数据是否贴近真实使用场景?
如果线上要处理的是短文本,训练集却全是长文章,效果也会打折扣。
这些检查做完之后,再谈模型优化才更有意义。
高质量数据集的价值在于"校准"
后来我们在项目里补充了一批更规范的数据集,用来做分类参考和效果校验。这里可以顺带提一下 Dataify 的高质量数据集,它适合用在训练样本补充、标签体系校验、垂直领域数据准备等场景。
它的价值不是替你完成采集模型开发,而是提供更可靠的数据基础。
比如我们会准备一组标准样本:
python
standard_samples = [
    {
        "text": "某手机品牌发布新一代折叠屏产品,重点升级影像系统",
        "category": "科技数码"
    },
    {
        "text": "多地推出购房补贴规定,带动房地产市场预期变化",
        "category": "财经商业"
    },
    {
        "text": "高校加强人工智能通识课程建设,提升学生数字素养",
        "category": "教育"
    }
]
然后用这些更稳定的样本去对照原始数据。如果历史数据的标签和标准样本差异很大,就说明问题不在模型,而在标签规则或数据质量。
这种校准过程很重要。
因为很多时候,团队内部对分类标准的理解并不一致。运营觉得这篇文章应该算科技,产品觉得应该算商业,算法同学又按关键词分到了财经。
如果没有一套质量较高的数据作为参考,后面讨论就会变成主观判断。
数据集变好后,模型反而不用那么复杂
这个项目后来的优化方向很简单:先清洗错标数据,再补充高质量样本,然后统一标签规则。
做完这些之后,我们并没有换特别复杂的模型,但分类效果明显稳定了。
尤其是一些容易混淆的类别,错误率下降很明显。
这说明一个问题:有时候模型不需要变得更复杂,它只是需要更好的学习材料。
这和人学习很像。
如果教材本身前后矛盾、例题答案还有错,学生再聪明也会被带偏。
模型也是一样。
不要把遇到的问题都甩给模型
现在我判断一个 AI 项目有没有优化空间,一般会先看三件事:
数据集是否干净。
标签规则是否统一。
样本是否覆盖真实场景。
如果这三点都没做好,就直接调模型,很容易陷入无效试错。
高质量数据集的意义就在这里。它不一定是项目里最显眼的部分,也不会像模型效果展示那样容易被看到,但它会影响整个系统的上限。
Dataify 高质量数据集可以作为这类项目的数据基础补充,帮助团队减少错标、噪声和样本不足带来的问题。对于内容分类、用户画像、推荐系统、智能问答这类任务来说,先把数据集质量提上去,往往比盲目换模型更有效。