空值、日期、字符串:业务 SQL 里的函数先跑一遍
写业务 SQL 时,select * 很快就不够用了。列表字段要有显示名,金额要扣掉优惠,状态要转成中文,时间要格式化,备注里的空字符串要当成没有备注处理。真正进到接口里,很多字段都不是原样查出来的,而是经过一层表达式加工。
从 MySQL 切到金仓数据库 KingbaseES 后,这一块不能只靠记忆。coalesce、case when、to_char、round 这些写法本身不复杂,但一旦混上 NULL、空字符串、类型转换和 MySQL 习惯函数,结果就不一定按老经验走。比如三参数 concat 在当前环境里没有直接跑通,date_format 也没有匹配到函数。它们不是概念题,放到终端里跑一下,答案就很清楚。
这次不整理函数大全,只挑业务 SQL 里最容易碰到的几类:空值、条件表达式、字符串、日期时间、数值、类型转换,再把 MySQL 习惯写法单独拿出来试一下。
先确认环境
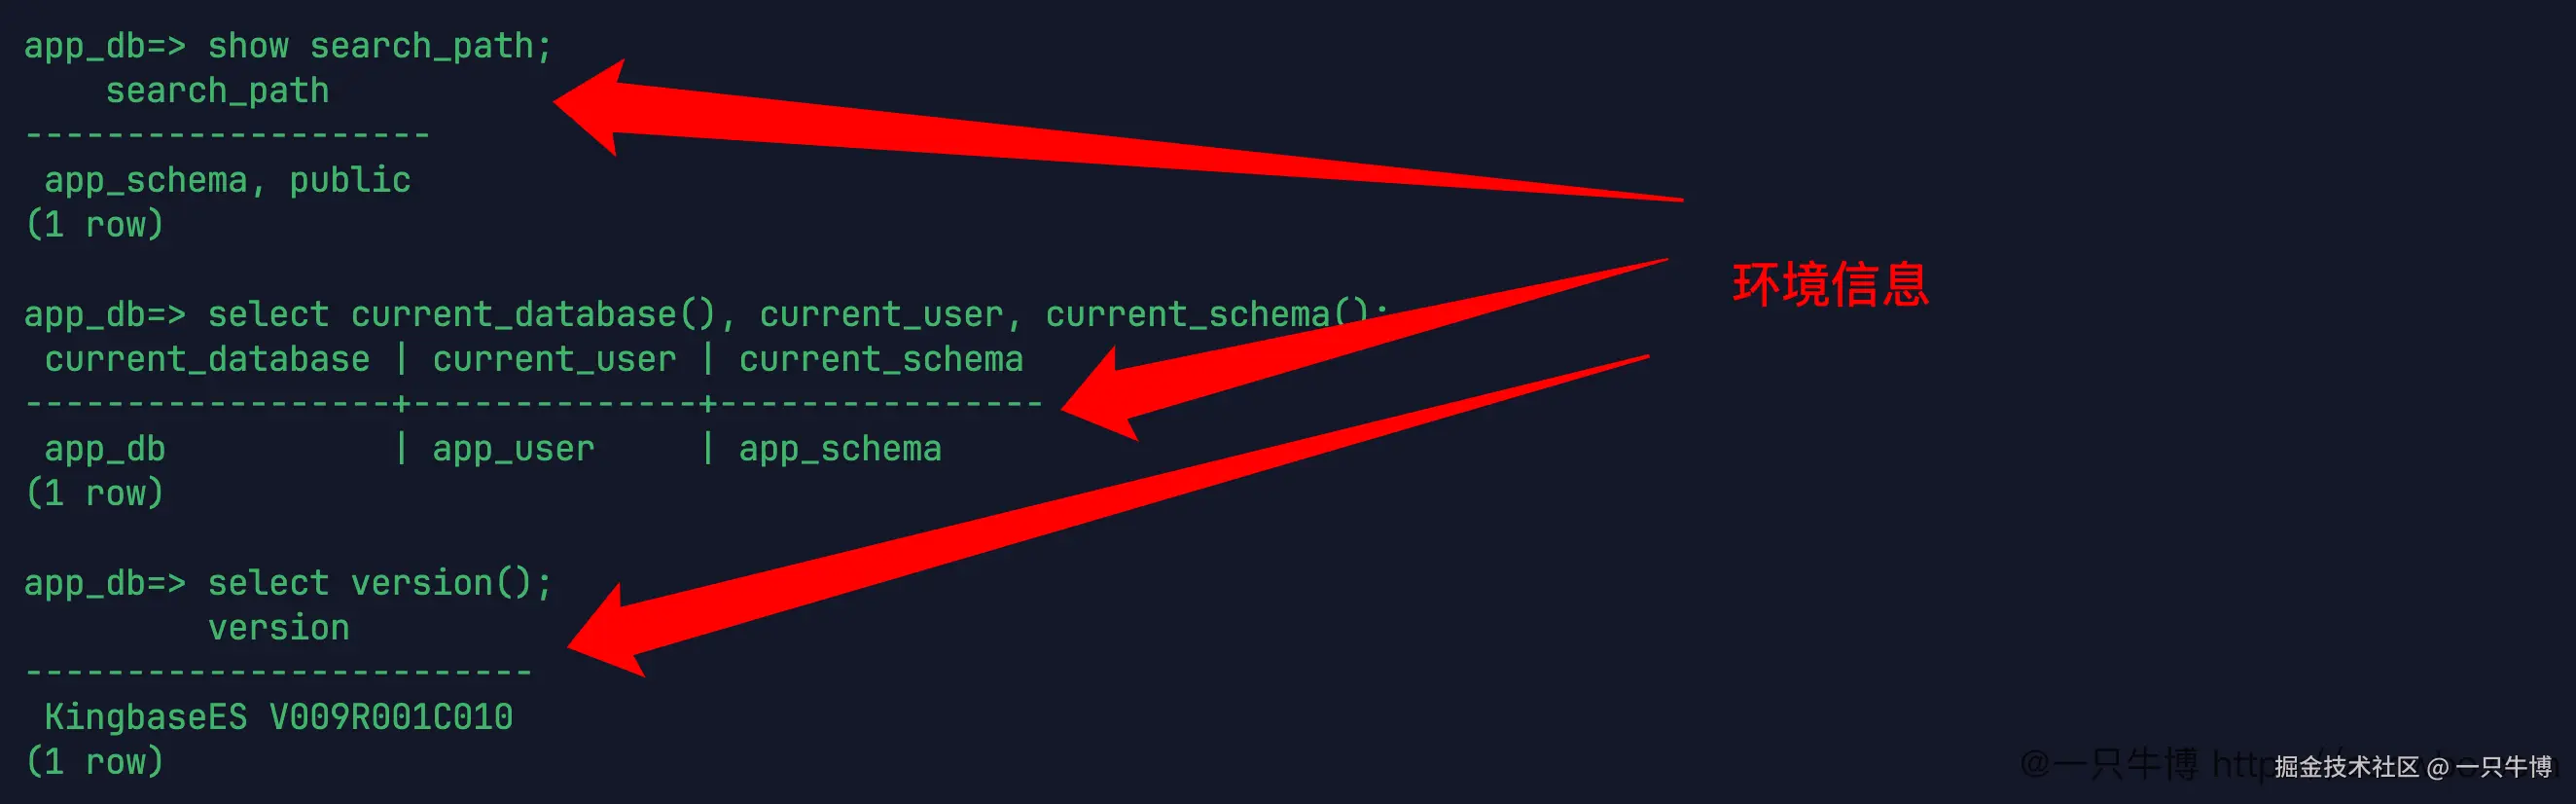
当前连接还是 app_db,用户是 app_user,默认 schema 是 app_schema。版本返回 KingbaseES V009R001C010。函数行为和兼容模式、版本都有关系,先把环境固定下来,后面结果才有讨论价值。
这类小实验不适合只写 select coalesce(null, 'x')。那样能证明函数能跑,但离业务字段太远。下面准备一张测试表,专门放几种常见情况:有 NULL、有空字符串、有前后空格、有未支付时间,也有金额和优惠金额。
准备一张测试表
表名是 t_expr_demo,字段不多,但覆盖了后面要用的几类表达式:姓名、昵称、手机号、城市、订单状态、金额、优惠、创建时间、支付时间、备注。
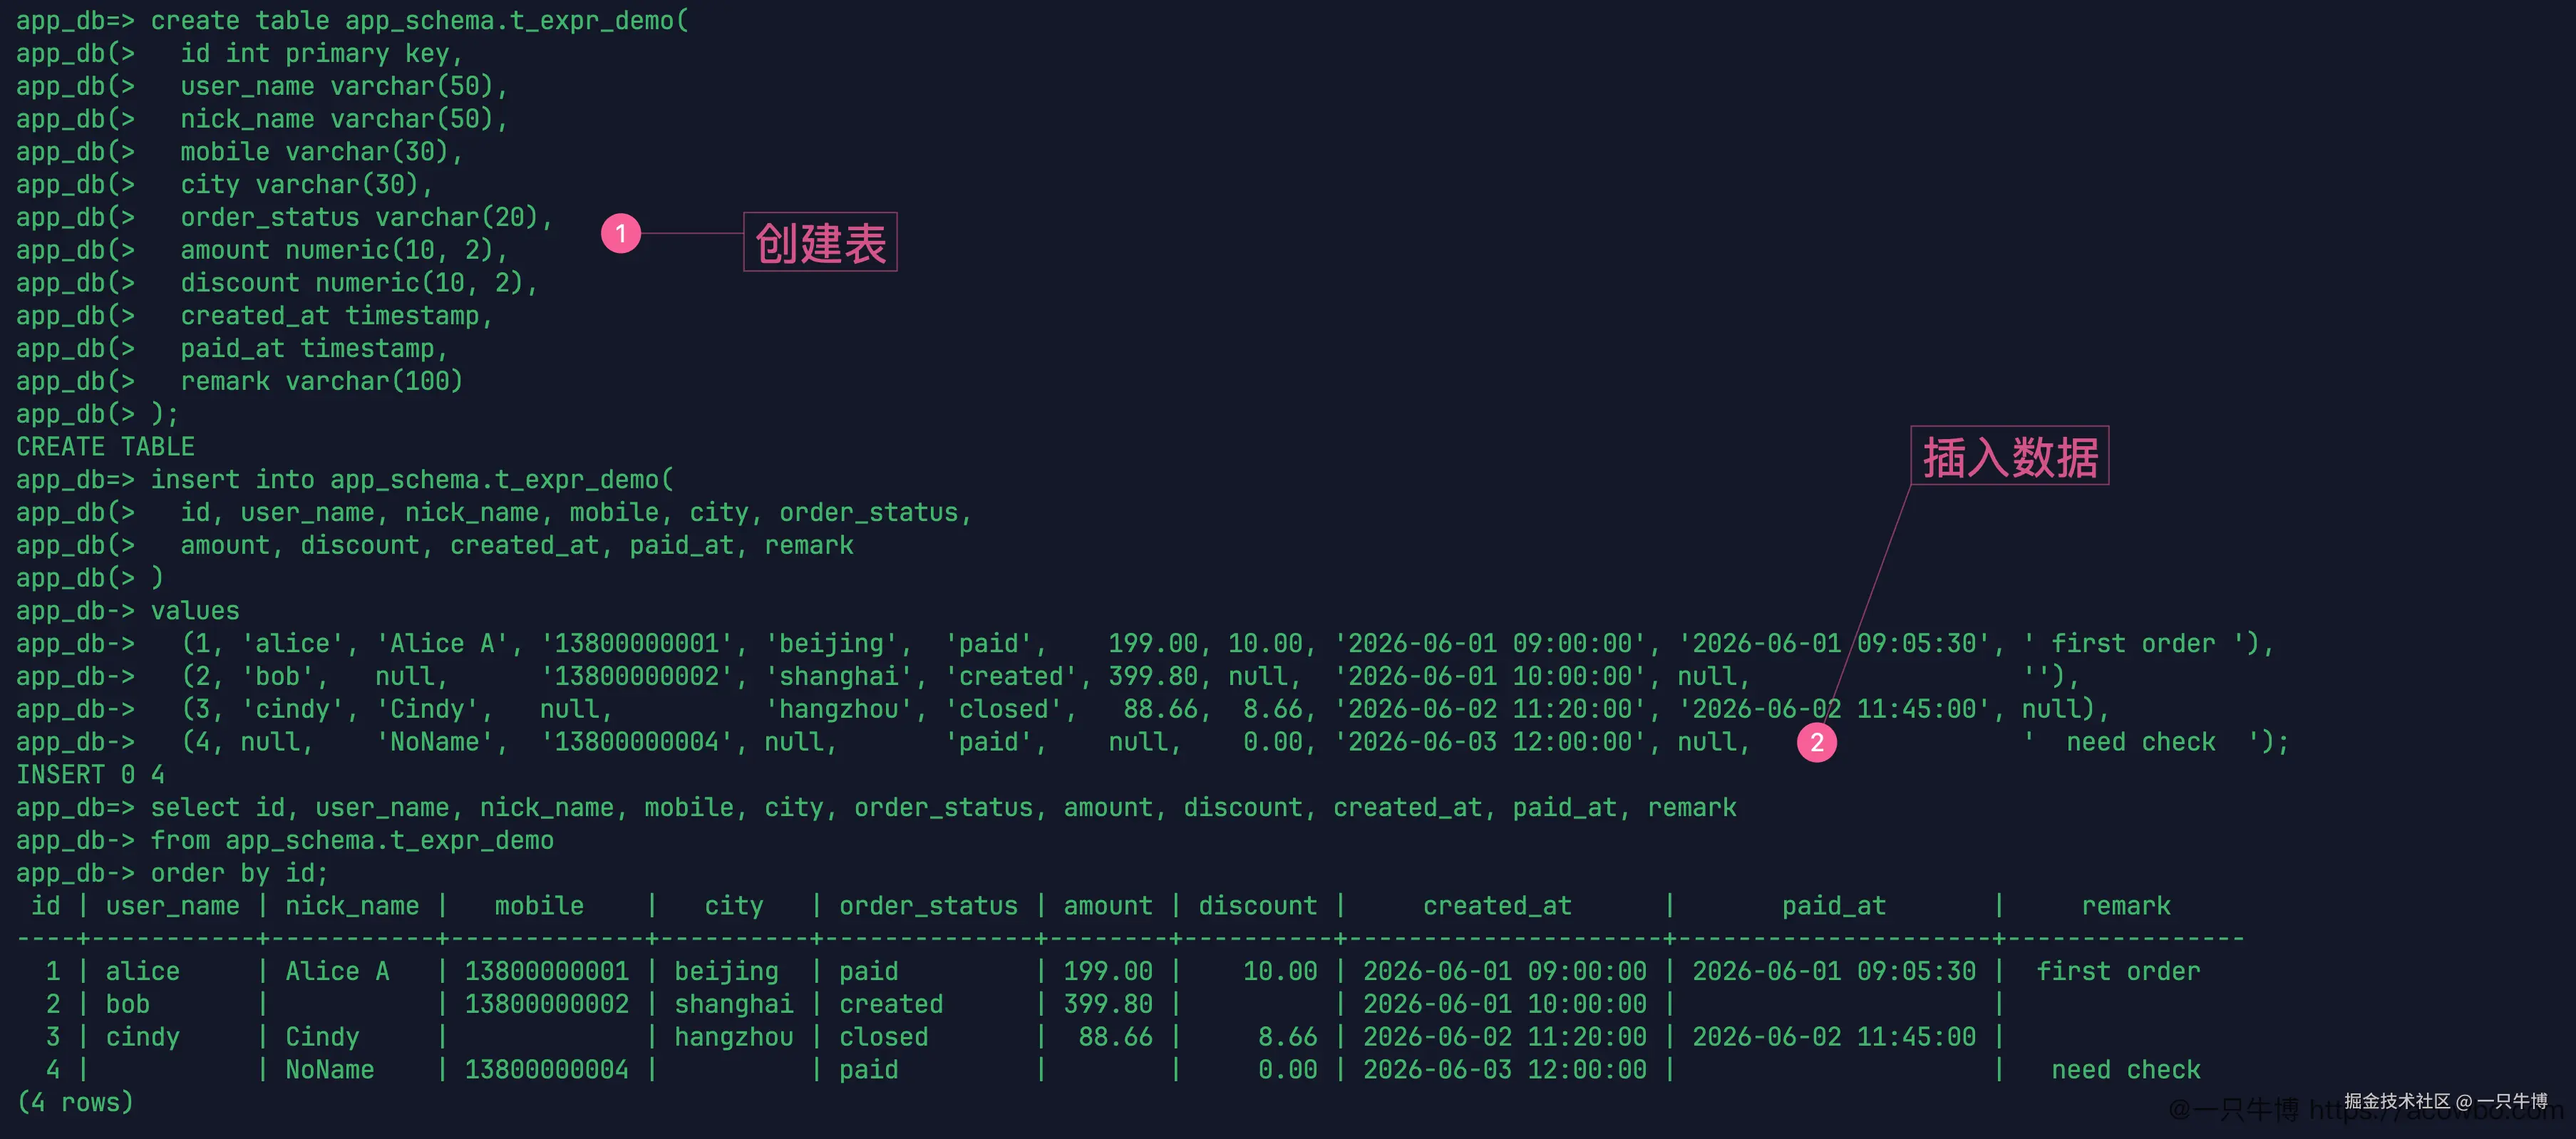
数据里有几处需要先记住。bob 没有昵称,cindy 没有手机号和备注,第 4 行没有用户名、城市、金额和支付时间,但有昵称 NoName。remark 里也有差异:第 2 行是空字符串,第 3 行是 NULL,第 1 行和第 4 行带了前后空格。
这些数据看起来像小问题,实际写接口时经常会遇到。空字符串和 NULL 要不要合并处理,金额为 NULL 时能不能直接参与计算,支付时间为空时要显示什么,都需要在 SQL 里讲清楚。
COALESCE 先解决"取哪个值"
显示名通常不会只取一个字段。昵称有值就用昵称,没有昵称就用用户名,再没有就给一个兜底值。coalesce 正好适合这种场景:
sql
coalesce(nick_name, user_name, 'unknown') as display_name金额计算也类似。amount - discount 看起来简单,但 discount 为 NULL 时,直接相减会得到 NULL。这里把金额和优惠都先做兜底:
sql
coalesce(amount, 0) - coalesce(discount, 0) as real_amount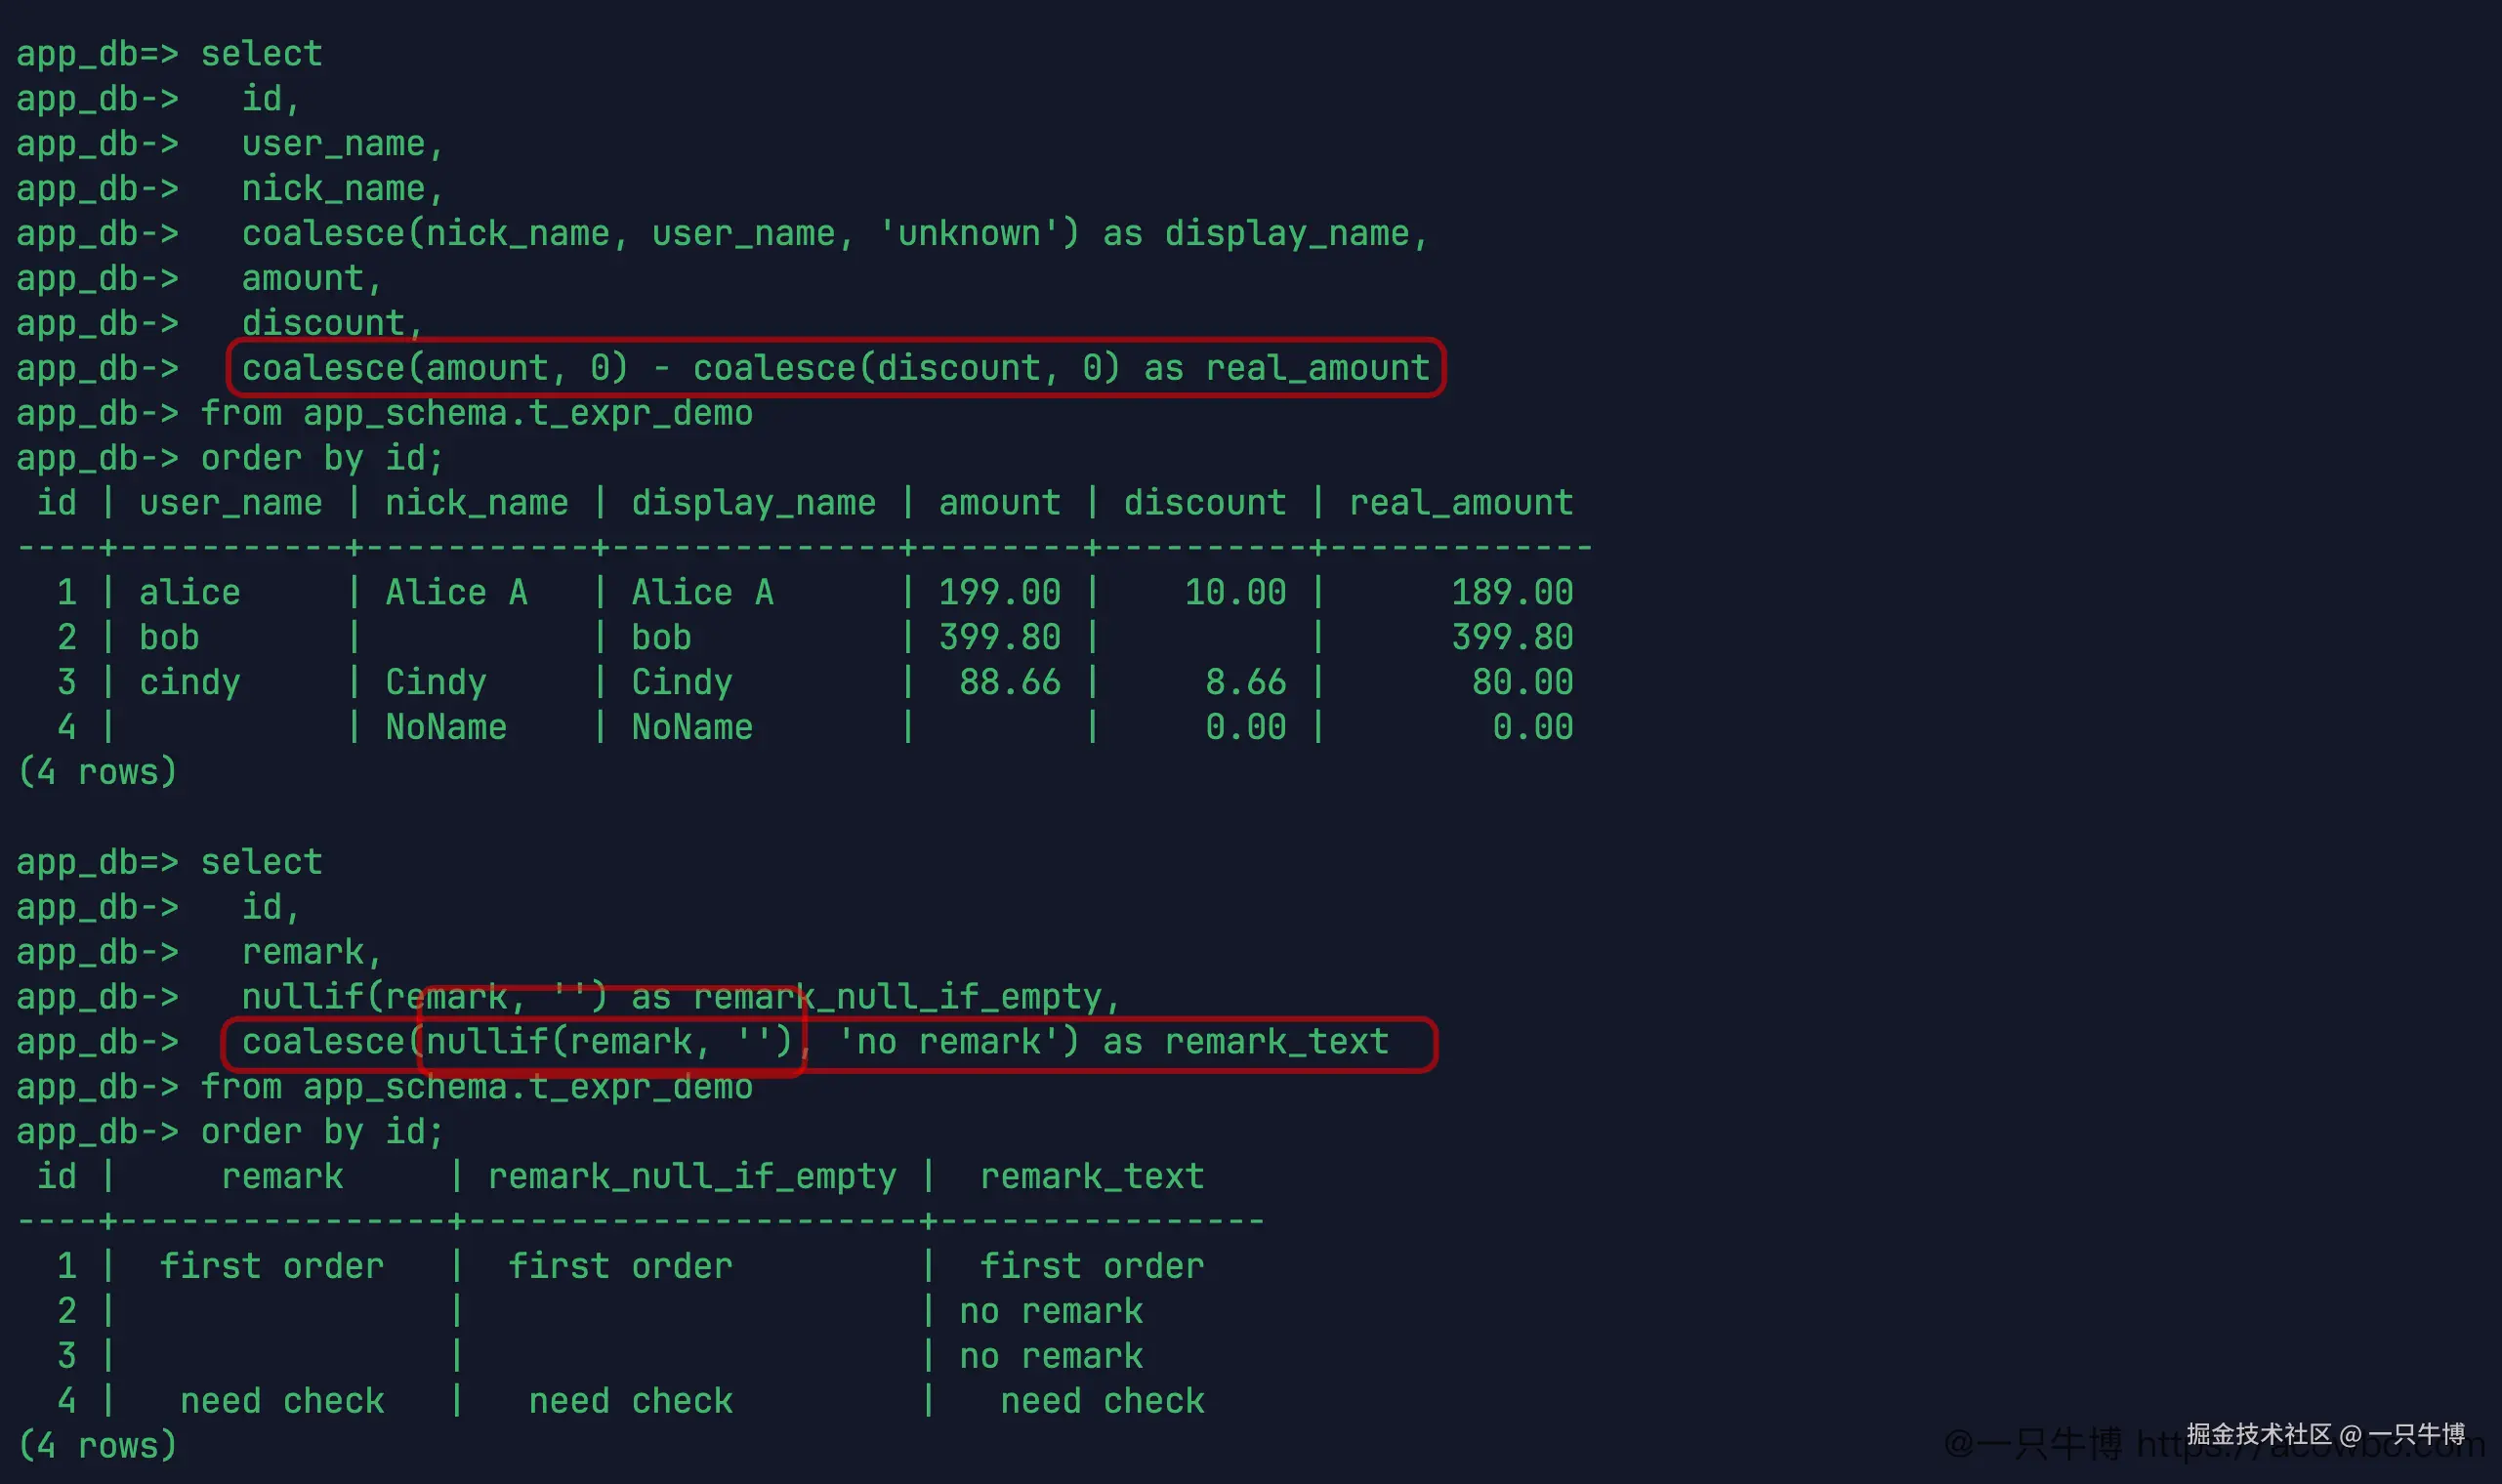
结果里,alice 的显示名取 Alice A,bob 没有昵称,显示名回退到 bob,第 4 行没有用户名但有昵称,所以显示 NoName。金额部分也能看到,bob 的优惠为空,实付仍然算出 399.80;第 4 行金额为空,按 0 处理后实付为 0.00。
nullif 处理的是另一类问题:字段不是 NULL,但值已经没有业务意义。第 2 行 remark 是空字符串,如果直接显示,它不是 NULL,却也不适合当正常备注。nullif(remark, '') 会把空字符串转成 NULL,再交给 coalesce 统一兜底成 no remark。
这里有个细节很实用:nullif 不会把带空格的字符串变成 NULL。第 4 行 remark 原始值是 need check 前后带空格,前面建数据时就留了这个情况。要处理空格,要先 trim;要处理空字符串,再用 nullif。
空值处理最好不要省。应用层看到空字符串、NULL、unknown 这三种值时,通常会走不同分支。数据库里如果没有先定好规则,接口字段就会一会儿是空白,一会儿是 NULL,一会儿又是兜底文案。这里先把 remark 的空字符串和 NULL 统一处理掉,后面展示字段会稳定很多。
CASE WHEN 适合做状态和分层
订单状态如果直接返回 paid、created、closed,接口当然能用,但页面上通常要显示成业务文案。case when 可以在 SQL 里完成这种轻量转换:
sql
case order_status
  when 'paid' then '已支付'
  when 'created' then '待支付'
  when 'closed' then '已关闭'
  else '未知'
end as status_text
同一条 SQL 里也可以按金额分层。金额为空时先单独处理,再判断高金额、中金额、低金额。
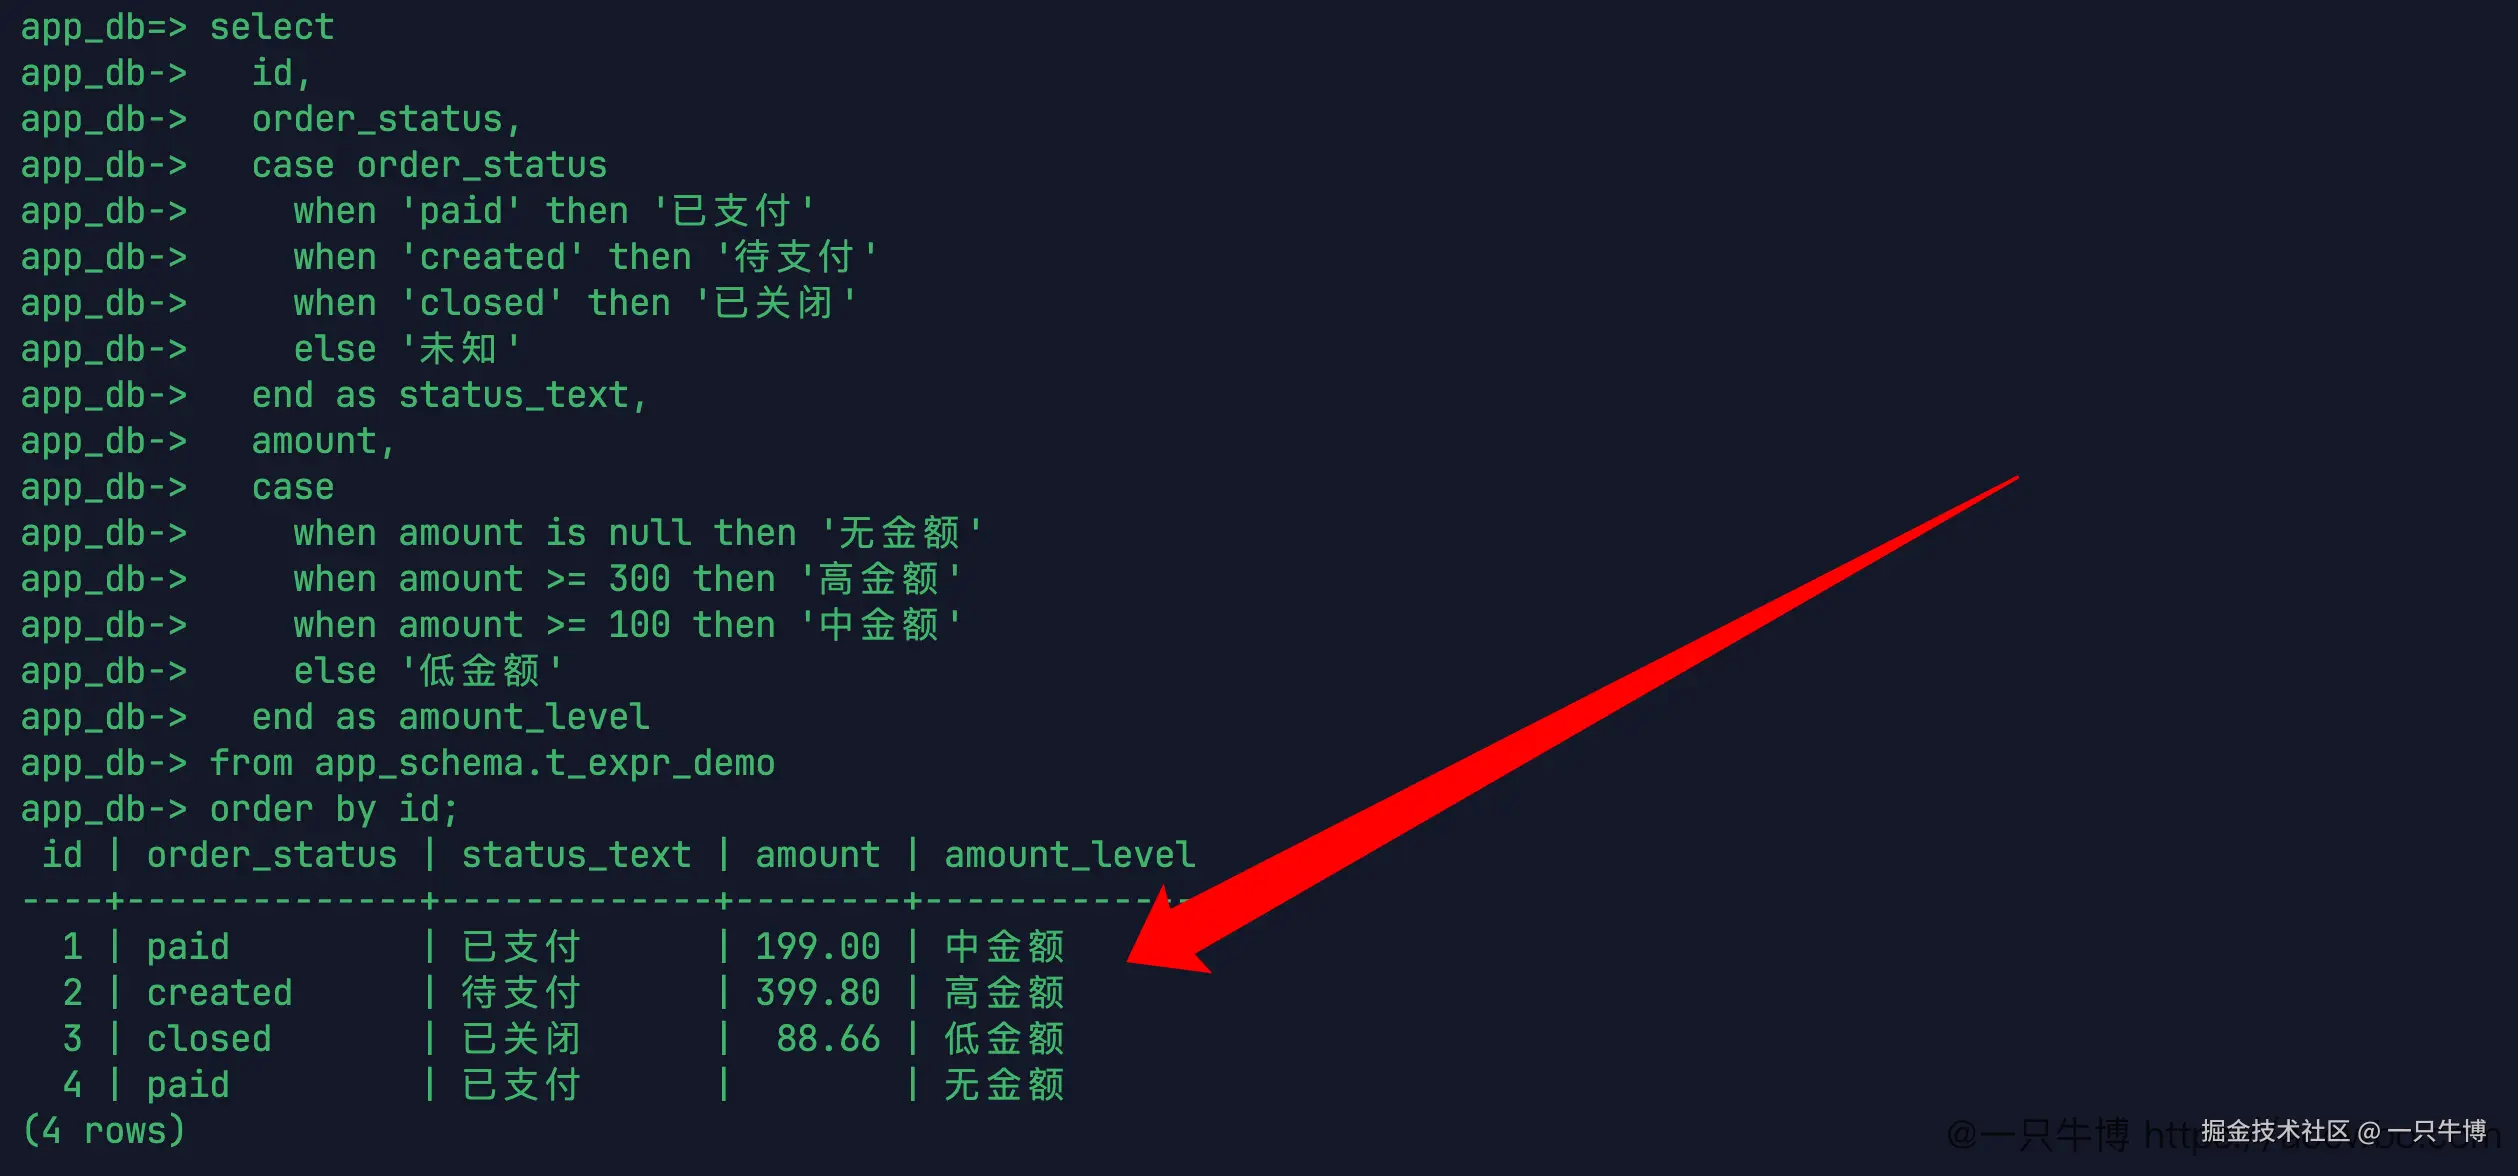
结果很直观:paid 转成已支付,created 转成待支付,closed 转成已关闭。金额分层里,399.80 进入高金额,199.00 进入中金额,88.66 进入低金额,第 4 行金额为空,返回无金额。
这种写法适合小范围展示字段,不适合把复杂业务字典全部塞进 SQL。状态很多、文案经常变、还涉及多语言时,还是应该回到字典表或应用层。这里只验证一个常见场景:查询结果里临时补一个可读状态。
三参数 concat 没有直接跑通
字符串拼接最容易让 MySQL 用户先入为主。按 MySQL 习惯,可能会写:
sql
concat(coalesce(user_name, 'unknown'), '-', coalesce(city, 'unknown')) as user_city当前 KingbaseES 环境里,这条 SQL 没有通过,报错信息是 function sys.concat(varchar, unknown, varchar) does not exist,并提示没有匹配的函数和参数类型。
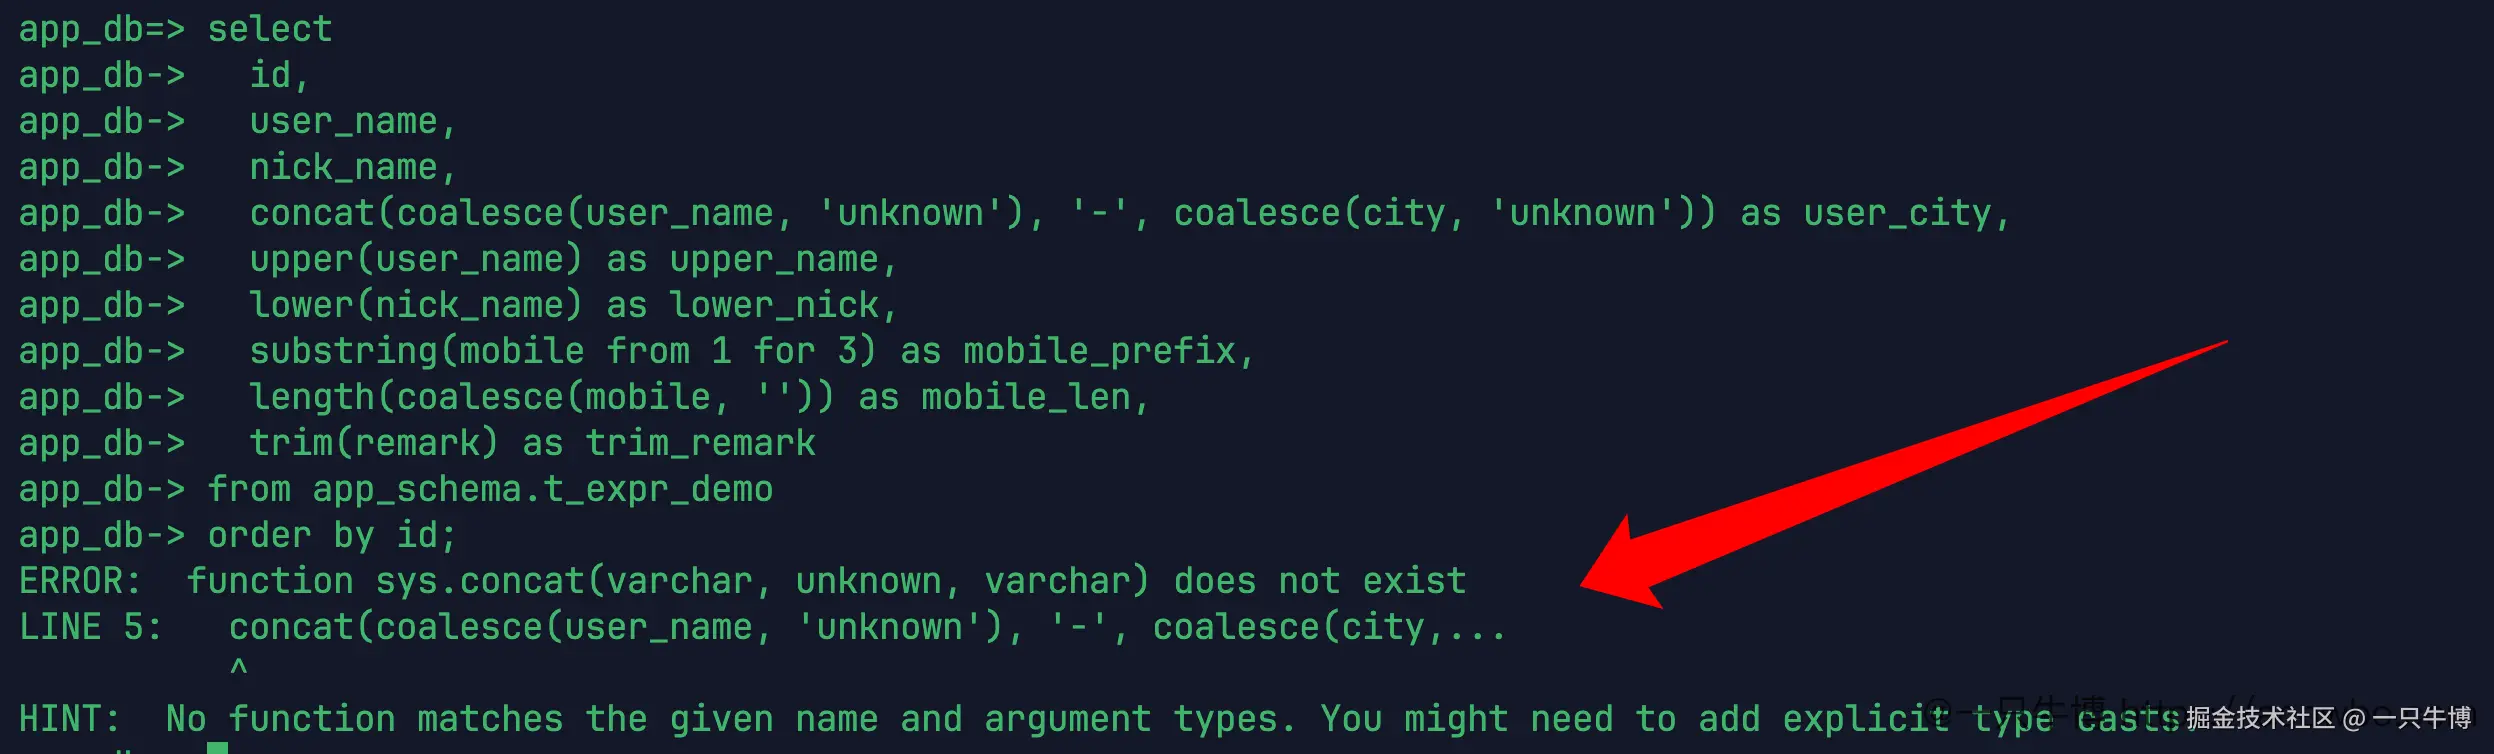
这个结果比单纯说"某函数能不能用"更有价值。问题不是字符串不能拼,而是当前环境下这种三参数 concat 写法没有匹配到函数。迁移 SQL 时,如果老项目里大量使用 concat(a, '-', b),不能想当然直接搬过来。
这里也不用把问题扩大成"函数不兼容"。先落到具体事实:当前测试里,三参数 concat 没跑通;后面采用 || 做字符串拼接。
这个小报错也提醒了一件事:同名函数不等于同样的参数签名。迁移 SQL 时,很多问题不是关键字完全不存在,而是参数个数、参数类型、隐式转换规则对不上。看到 unknown 这种提示时,先不要急着改业务逻辑,应该先确认函数签名和字面量类型。
字符串拼接改用 ||
改成 || 后,字符串处理这组 SQL 可以正常执行:
sql
coalesce(user_name, 'unknown') || '-' || coalesce(city, 'unknown') as user_city同一条 SQL 里顺手验证了几个常用字符串函数:upper、lower、substring、length、trim。
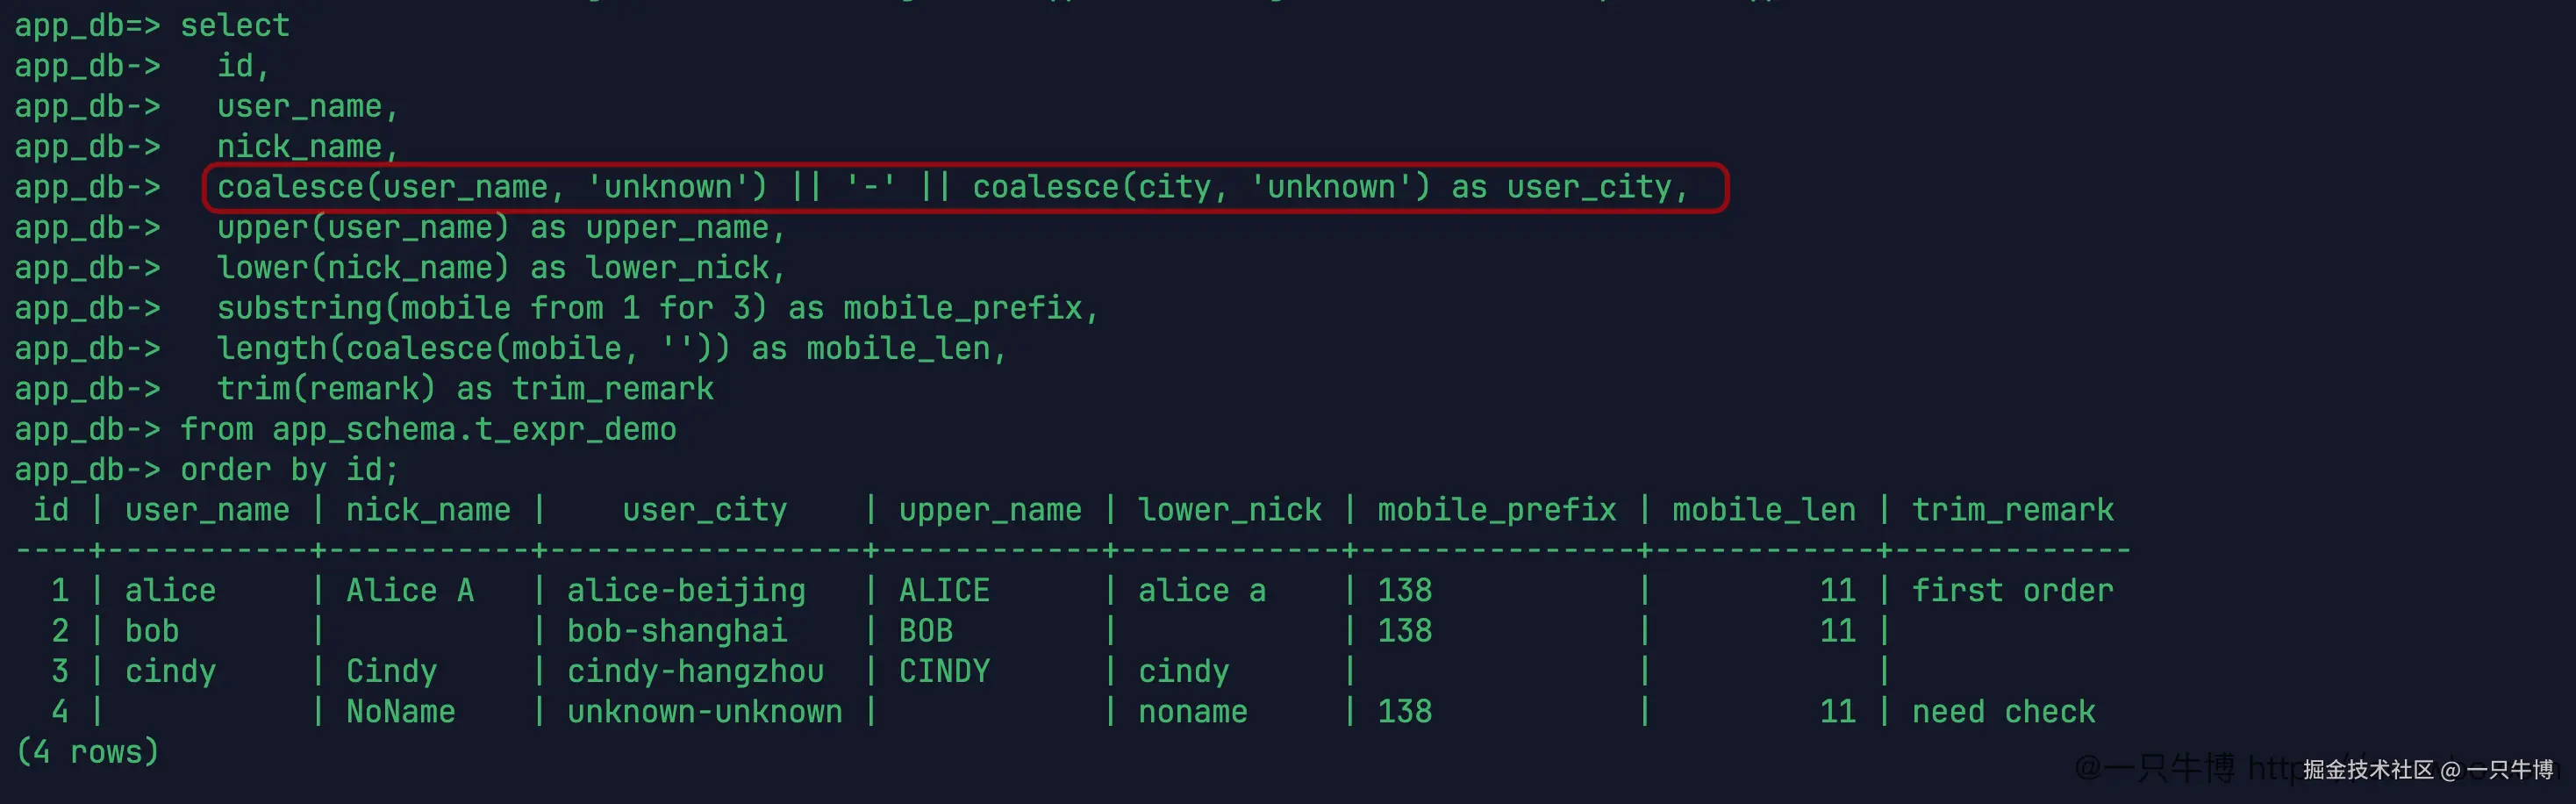
alice 变成 alice-beijing,bob 变成 bob-shanghai,第 4 行用户名和城市都为空,拼出来的是 unknown-unknown。upper(user_name) 把用户名转成大写,lower(nick_name) 把昵称转成小写,手机号前三位用 substring(mobile from 1 for 3) 取出来。
第 3 行手机号为空,所以 mobile_prefix 为空,length(coalesce(mobile, '')) 返回 0。trim(remark) 把第 1 行和第 4 行前后空格去掉,但对 NULL 没有变出一个默认值。字符串处理里,拼接、截取、去空格和空值兜底通常要配合使用。
如果要做手机号脱敏,这里还不够。这里只验证了截取前三位和长度计算,真正脱敏还要拼接中间星号、保留后四位,并且先处理手机号为空或长度不足的情况。函数本身能跑是一层,能不能变成可靠的展示字段,还要看异常值怎么处理。
日期时间先用 to_char 和 interval
日期时间这一块也很容易带着 MySQL 习惯写。当前先用已经验证通过的 KingbaseES 写法:to_char 做格式化,interval 做日期加减,两个 timestamp 相减得到时间间隔。
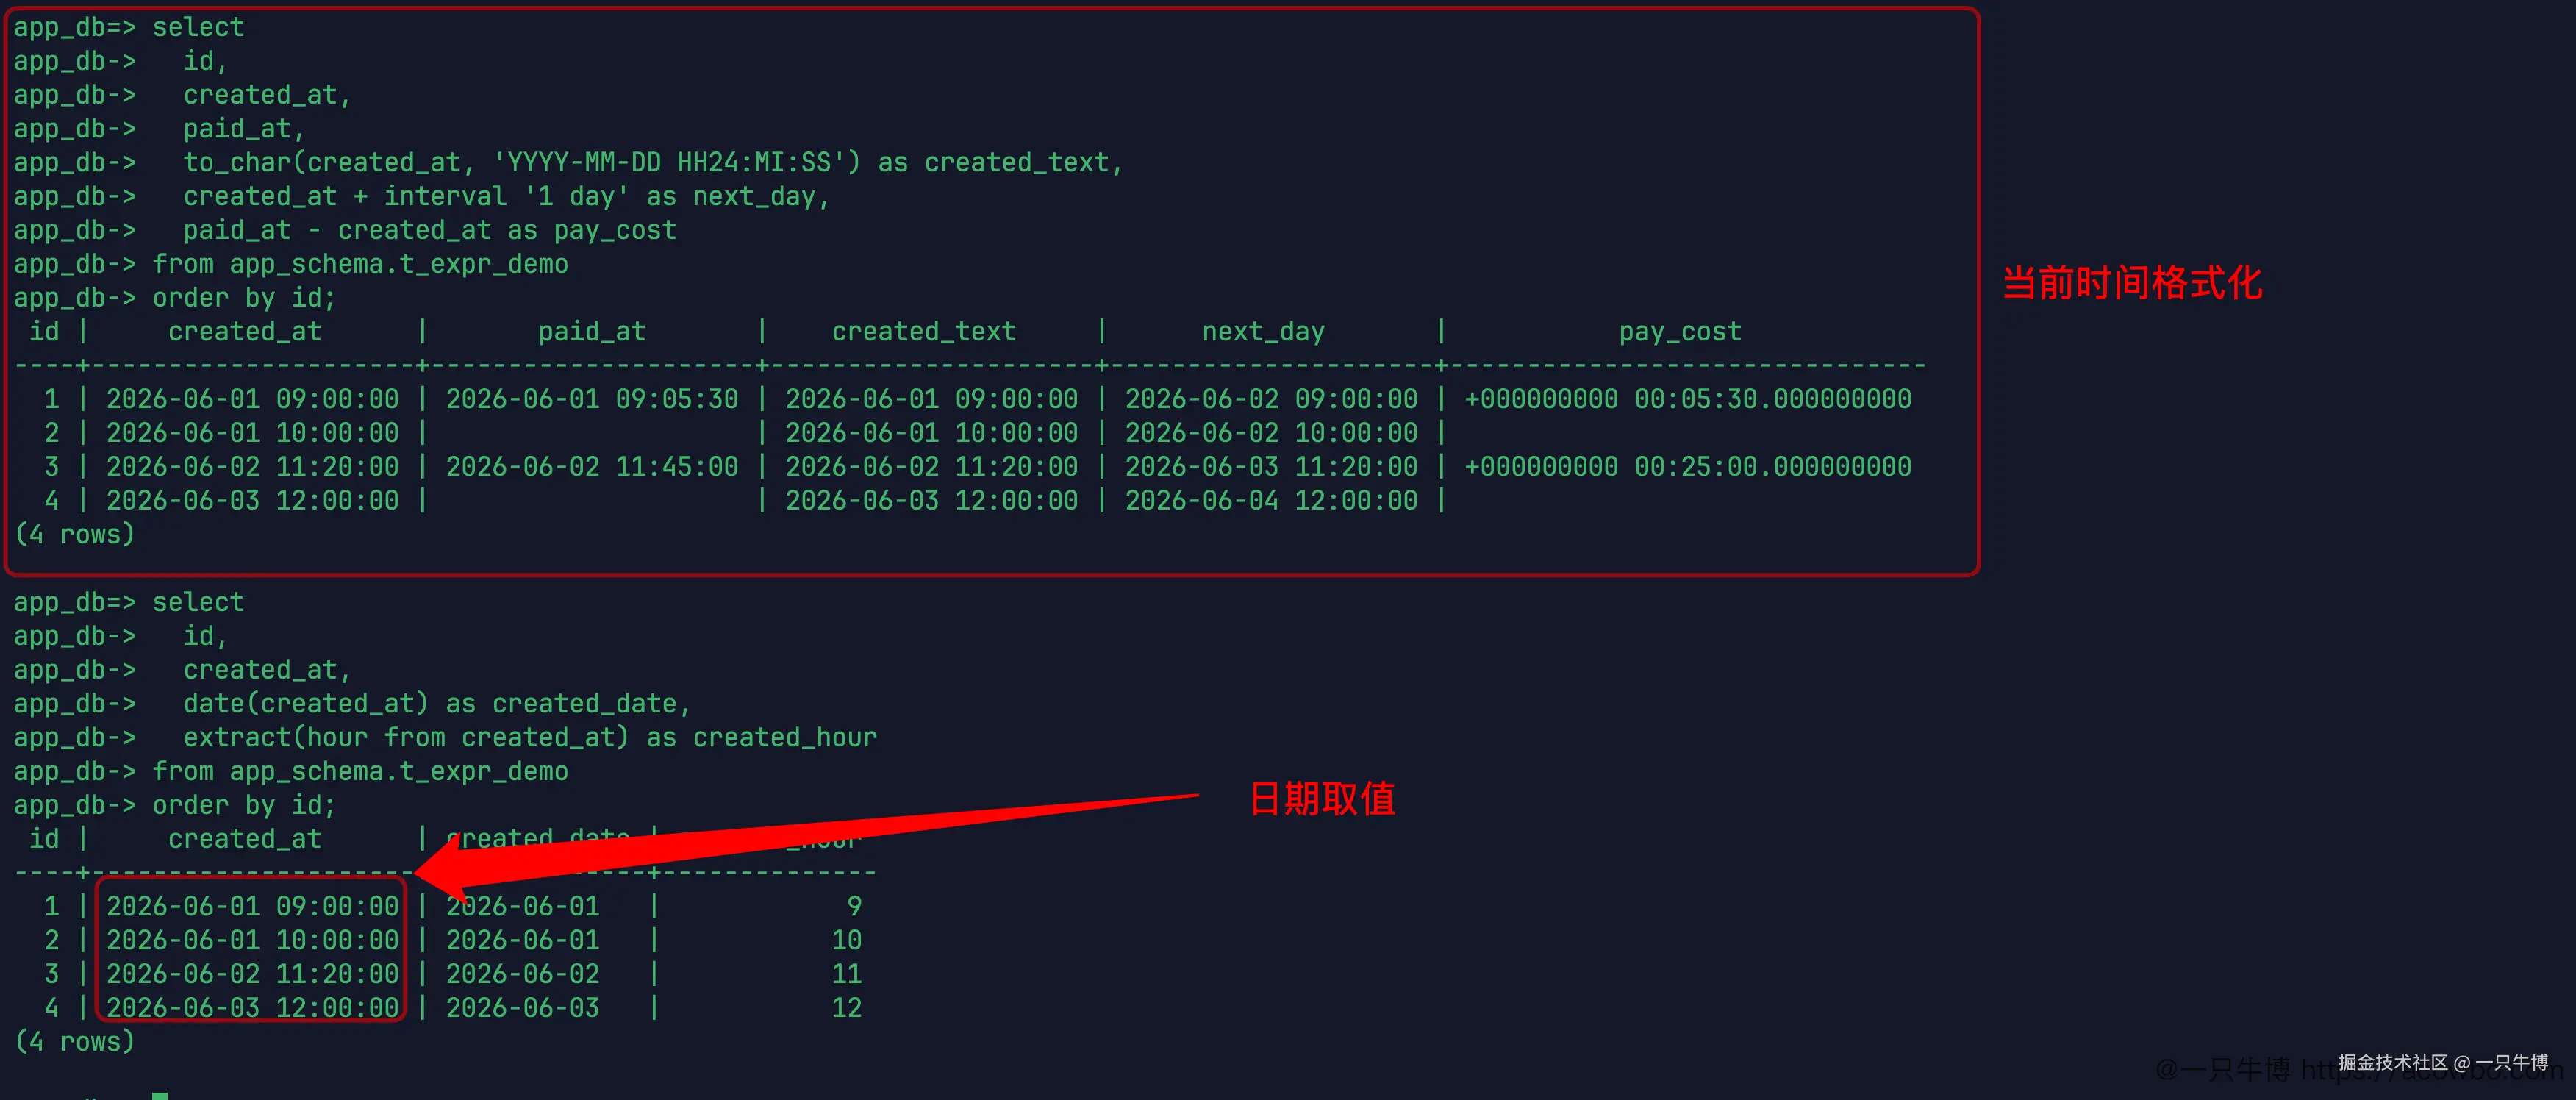
第 1 行创建时间是 2026-06-01 09:00:00,支付时间是 2026-06-01 09:05:30,paid_at - created_at 返回 5 分 30 秒。第 3 行返回 25 分钟。第 2 行和第 4 行没有支付时间,支付耗时为空。
created_at + interval '1 day' 也很明确:创建时间加一天,时间部分保持原样。下面的查询又用 date(created_at) 取日期,用 extract(hour from created_at) 取小时。第 1 行小时是 9,第 2 行是 10,第 3 行是 11,第 4 行是 12。
这里没有展开时区。当前表字段是 timestamp,测试目标是格式化、日期加减和取值。时区、夏令时、跨地区展示要单独设计,不适合混在这次的小实验里。
日期字段还有一个习惯要提前固定:如果只是给页面展示,可以转成字符串;如果后面还要继续排序、比较、按范围筛选,最好保留时间类型,不要太早格式化。to_char 适合最后一层展示,不适合替代所有时间计算。
数值表达式里,NULL 会继续影响结果
金额计算先看不完全兜底的写法:
sql
amount - coalesce(discount, 0) as raw_real_amount优惠为空时可以用 0 兜底,所以 bob 的实付金额是 399.80。第 4 行金额本身为空,即使 discount 兜底了,amount - 0 仍然是 NULL。
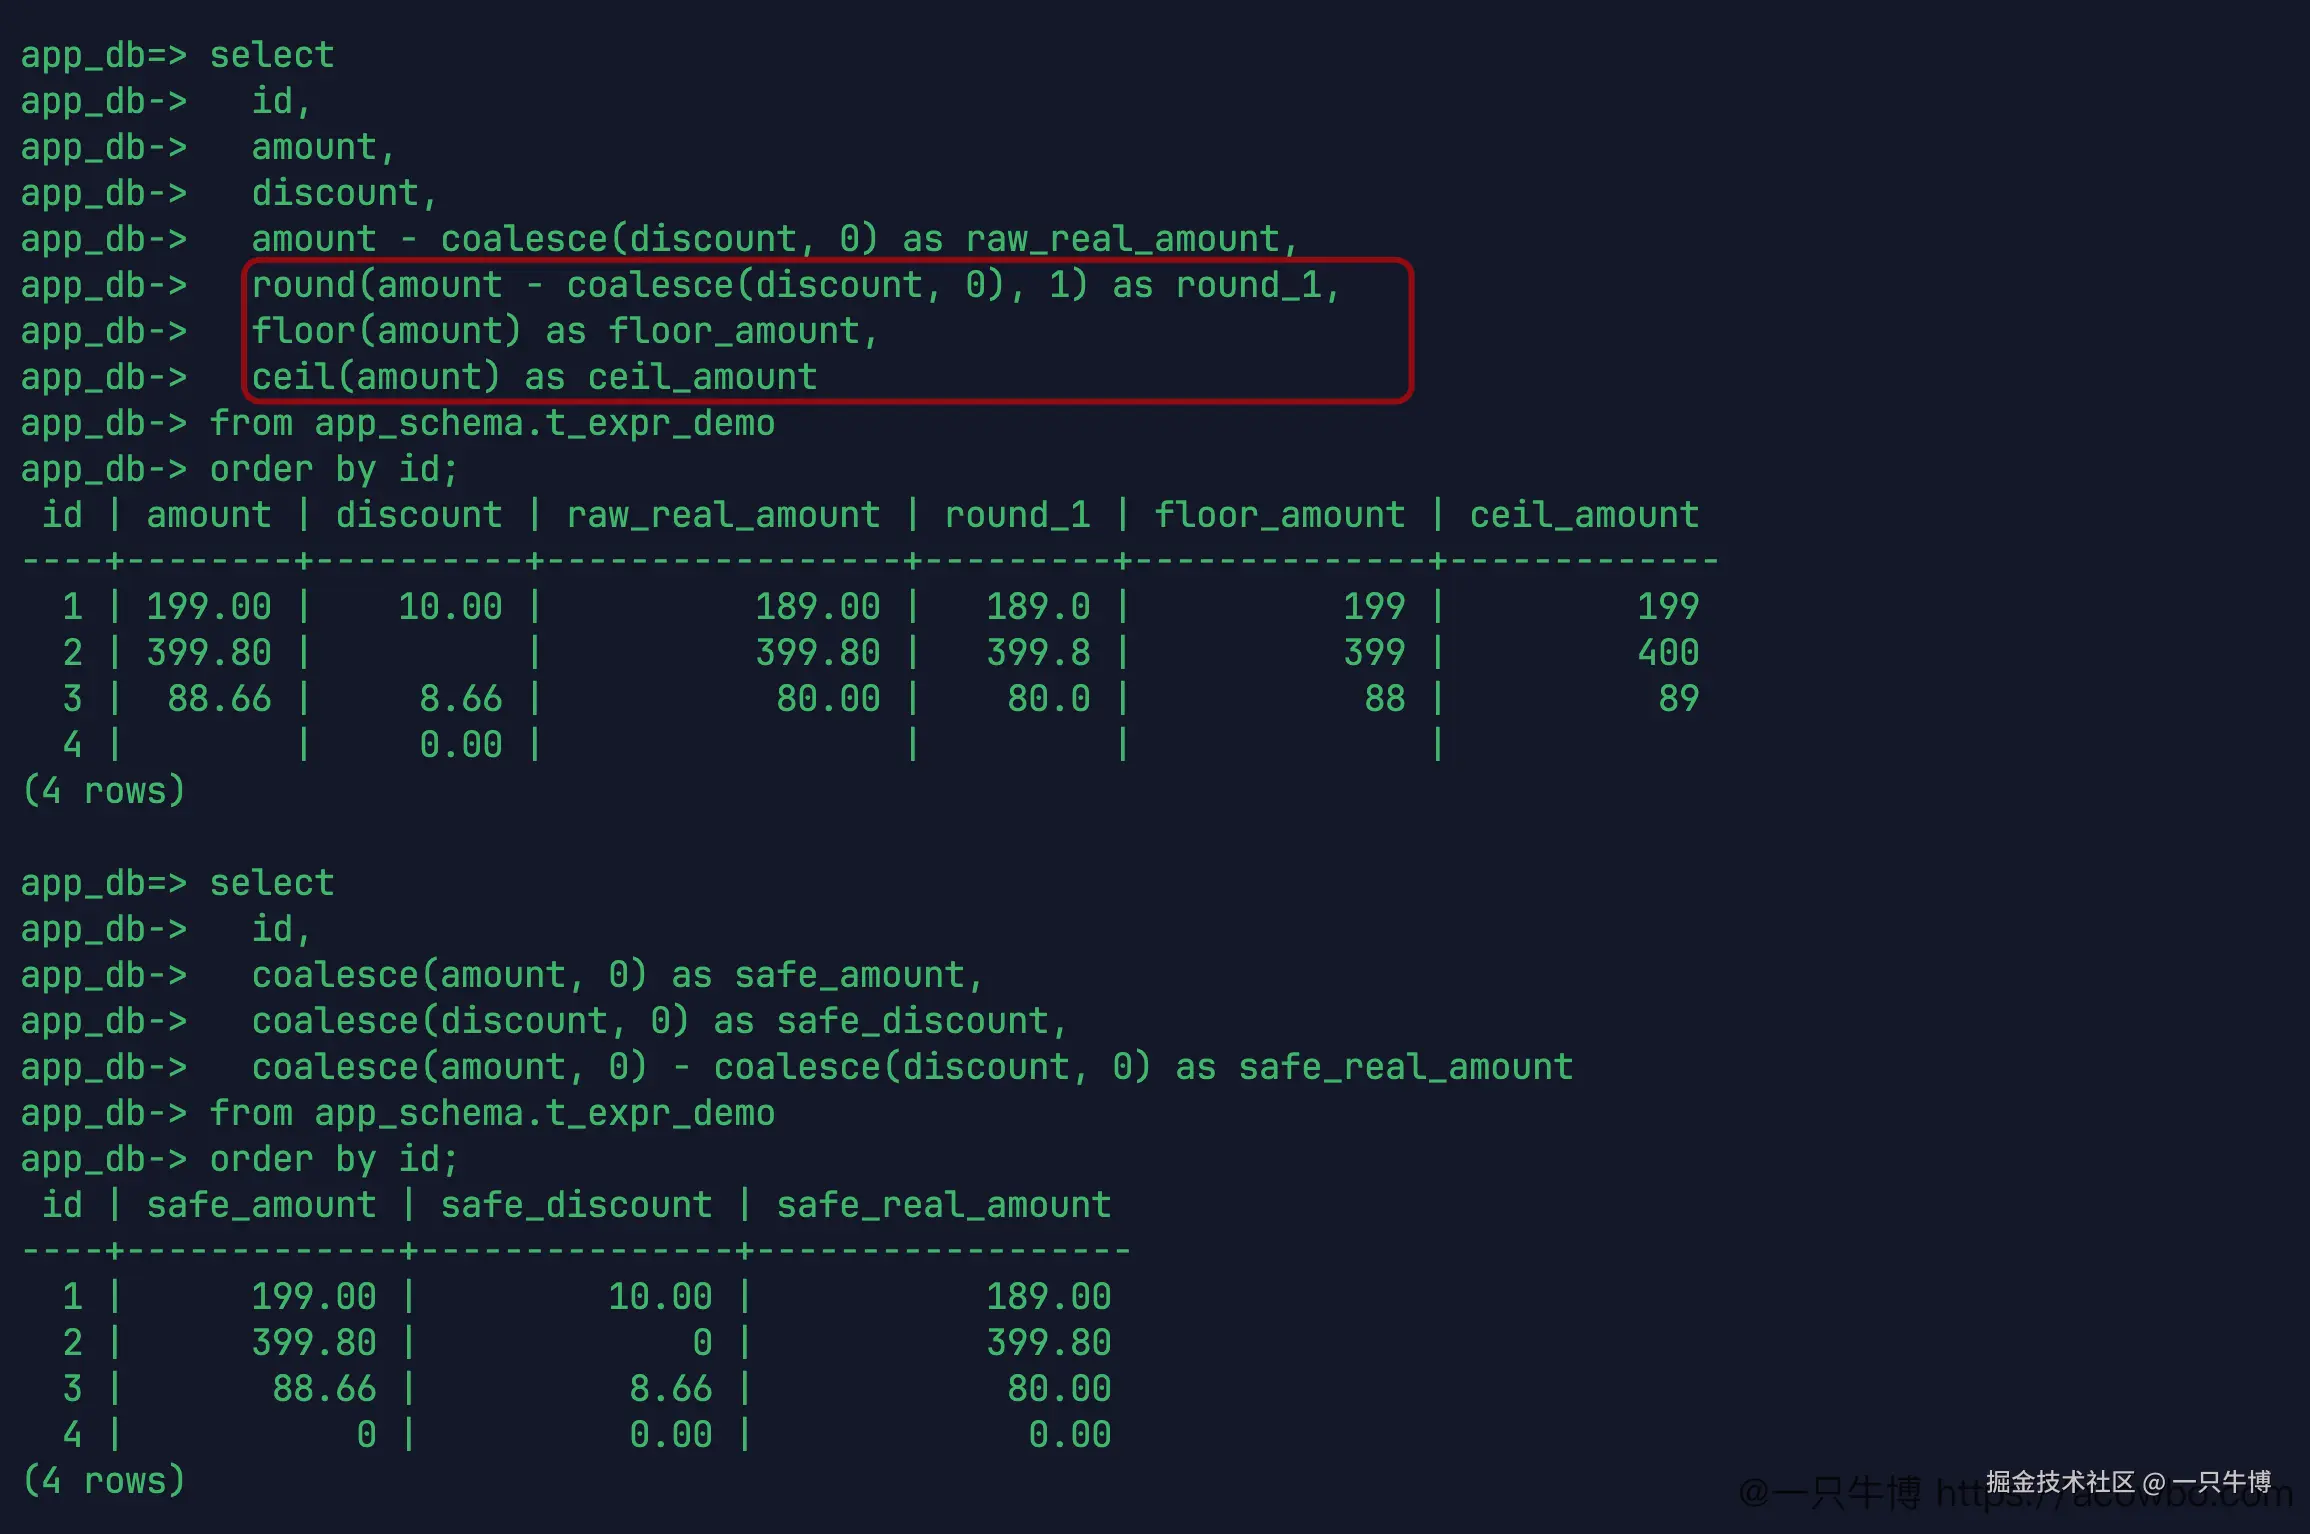
round、floor、ceil 的结果也能看出来。399.80 四舍五入保留一位是 399.8,向下取整是 399,向上取整是 400。88.66 向下取整是 88,向上取整是 89。
下面那条完全兜底的计算,把 amount 和 discount 都用 coalesce 处理:
sql
coalesce(amount, 0) - coalesce(discount, 0) as safe_real_amount这样第 4 行实付金额就变成 0.00。是否应该这样写,要看业务语义。金额为空可能代表未录入,也可能代表确实没有金额。SQL 能给出默认值,但默认值是不是合理,不能只靠函数决定。
类型转换要让错误暴露出来
类型转换这里验证了两种写法:标准 cast(...),以及 :: 形式。
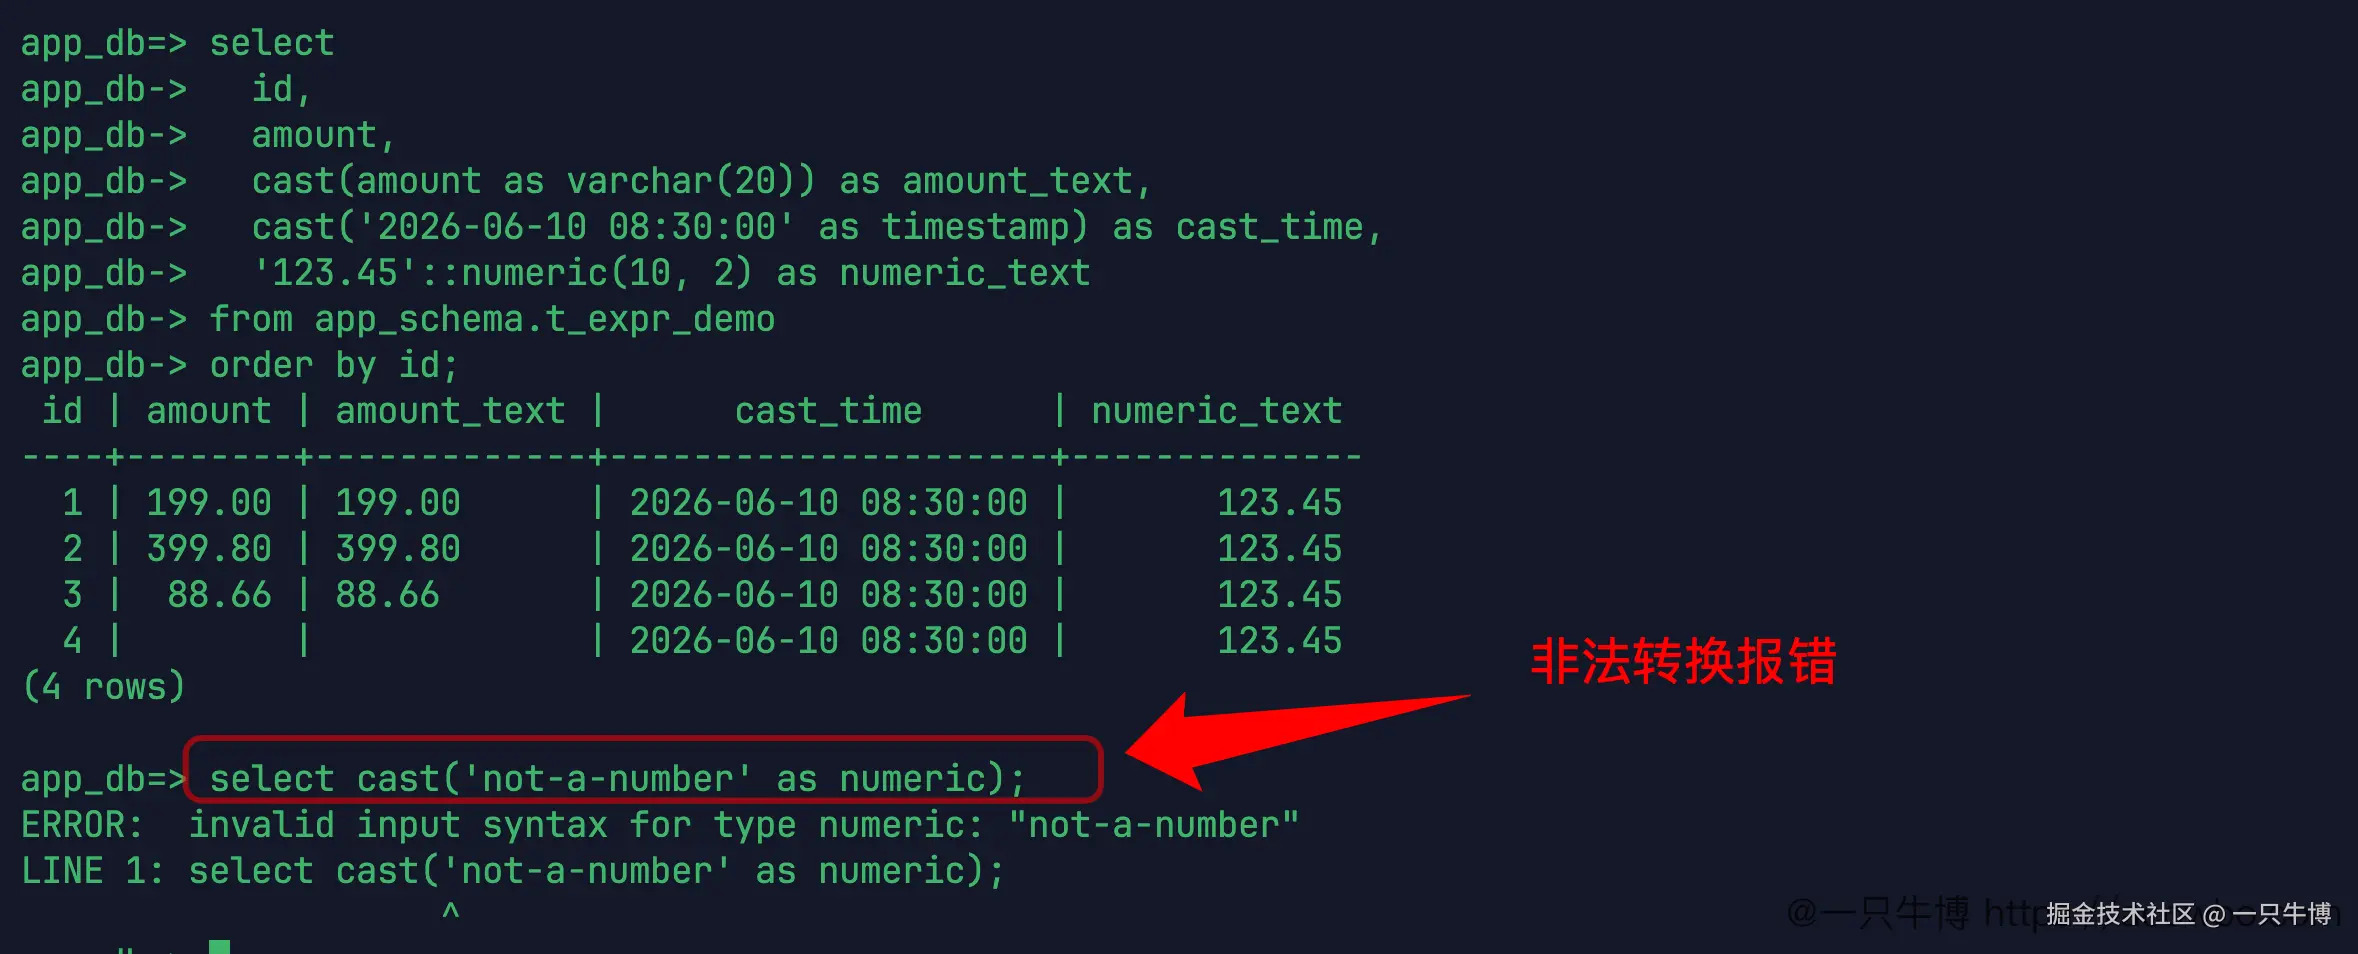
cast(amount as varchar(20)) 能把金额转成字符串,cast('2026-06-10 08:30:00' as timestamp) 能把合法字符串转成时间,'123.45'::numeric(10, 2) 能转成数值。
接着把 'not-a-number' 转成 numeric,KingbaseES 直接报错:invalid input syntax for type numeric。这个报错很正常,也应该保留。迁移或清洗数据时,隐式转换最怕悄悄吞掉脏值;明确报错至少能告诉人,哪一类数据不能按数字处理。
写业务 SQL 时,类型转换不要靠猜。字符串日期、字符数字、金额字段混用时,最好把转换写出来。能转换的值和不能转换的值分开处理,后面排查会省很多时间。
尤其是导入历史数据时,表面看都是数字的字段,里面可能混着空格、中文、横线或者其他占位符。直接 cast 会报错,反而能逼着先清洗数据;如果在应用层随便吞掉异常,最后查账或统计时会更难定位。
date_format 也没有直接跑通
MySQL 里常见的 date_format 在当前环境里也没有直接通过:
sql
date_format(created_at, '%Y-%m-%d %H:%i:%s')报错信息是 function date_format(timestamp without time zone, unknown) does not exist。
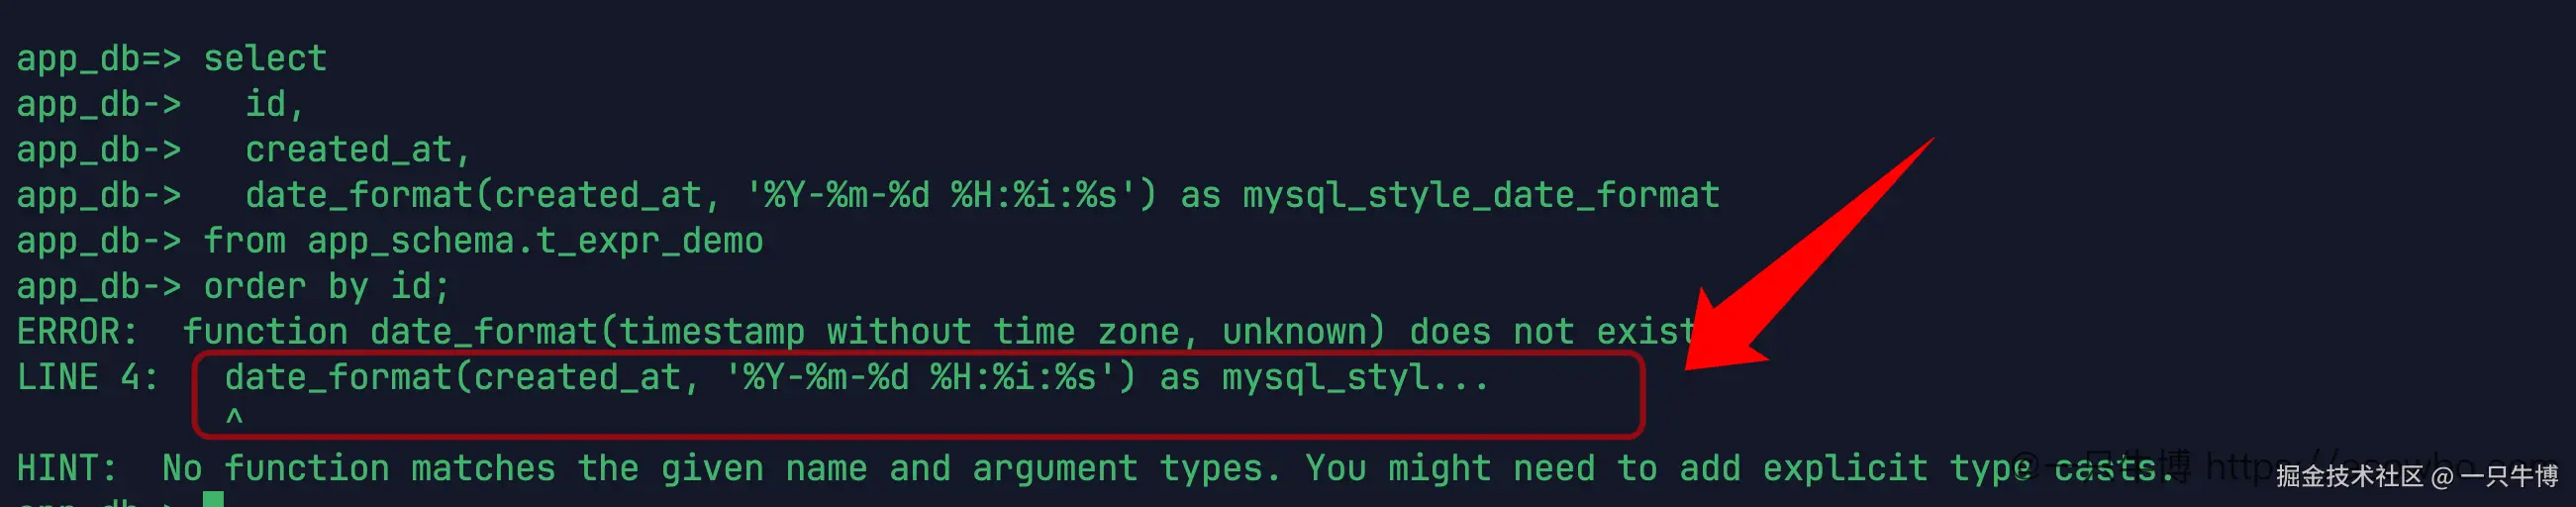
这和前面的 concat 类似,不能从印象里判断。当前实测结果就是:这条 MySQL 风格写法没有匹配到函数。已经跑通的替代写法是:
sql
to_char(created_at, 'YYYY-MM-DD HH24:MI:SS')这里也要注意格式串差异。MySQL 里 %Y-%m-%d %H:%i:%s 是常见写法;to_char 用的是 YYYY-MM-DD HH24:MI:SS。两者都能表达"年月日时分秒",但格式模板不是一套。
最后组合成接口字段
单个函数跑通以后,还要看组合起来像不像真实查询。最后这条 SQL 把显示名、城市状态、状态文案、实付金额、创建日期、支付耗时放到一起:
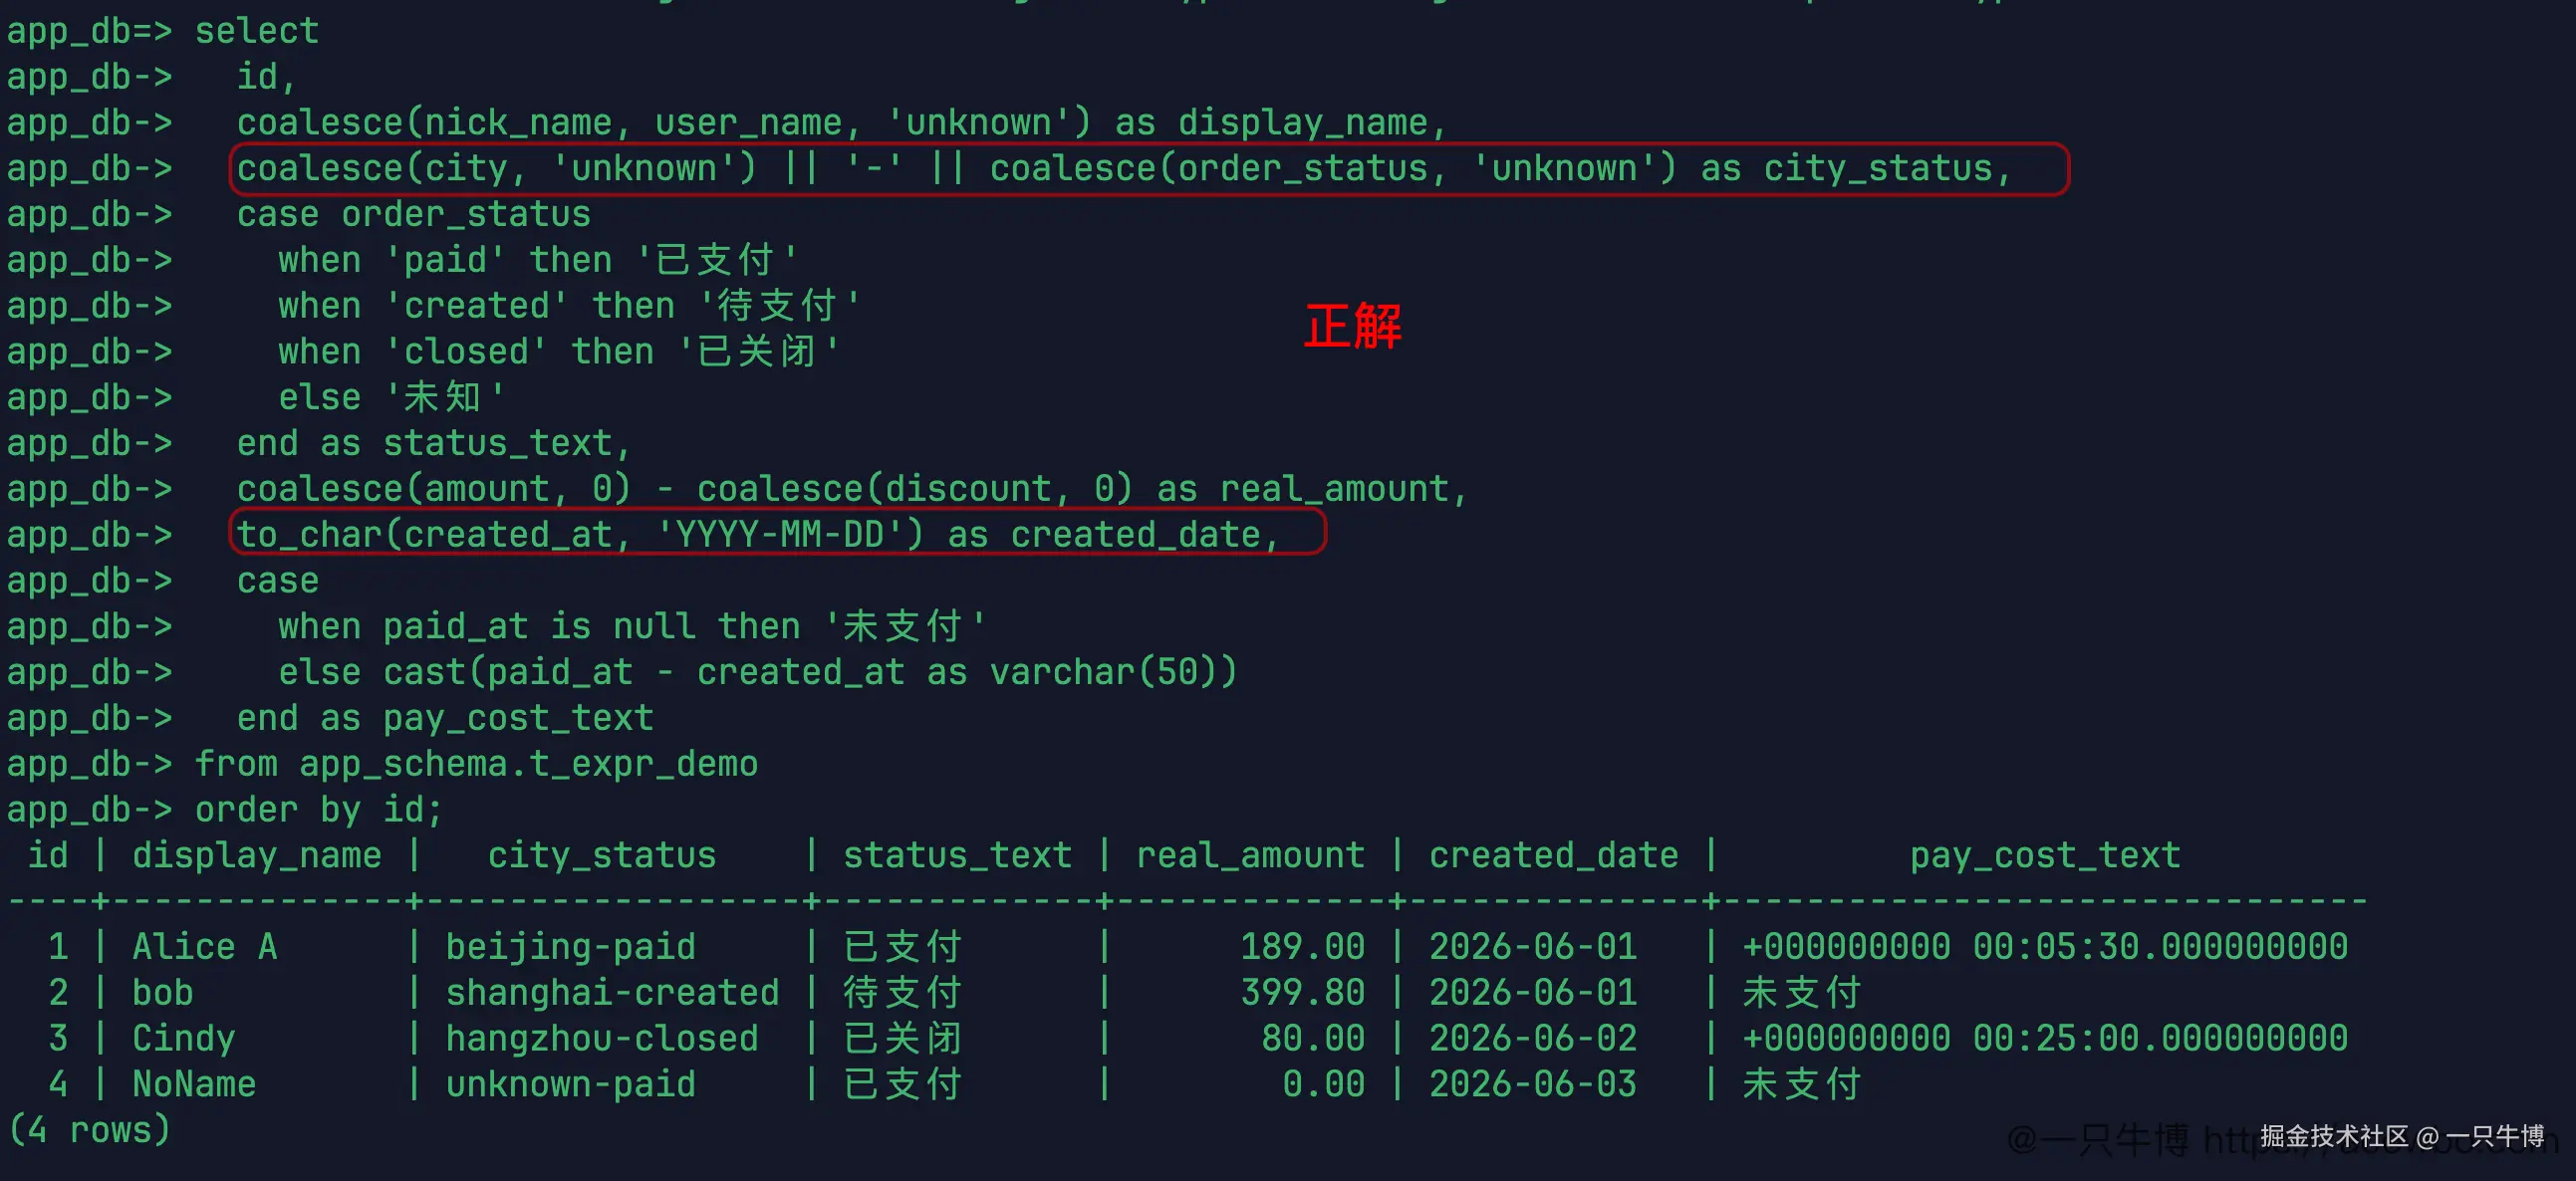
display_name 仍然用 coalesce(nick_name, user_name, 'unknown')。第 4 行因为有昵称 NoName,显示名就是 NoName。city_status 用 || 拼接城市和状态,第 4 行城市为空,结果是 unknown-paid。
状态文案由 case when 生成:paid 是已支付,created 是待支付,closed 是已关闭。实付金额用 coalesce(amount, 0) - coalesce(discount, 0) 算出来,alice 是 189.00,bob 是 399.80,cindy 是 80.00,第 4 行是 0.00。
创建日期用 to_char(created_at, 'YYYY-MM-DD') 生成。支付耗时这里也做了兜底:有支付时间就显示时间差,没有支付时间就显示未支付。这样一条 SQL 已经接近接口里常见的字段加工方式。
函数要跟字段含义一起看
函数和表达式不是越多越好。真正要确认的是字段含义:显示名从哪些字段兜底,空字符串要不要当成 NULL,金额为空时能不能按 0 算,支付时间为空时显示什么,日期格式要给前端字符串还是保留 timestamp。
这轮实测里,coalesce、nullif、case when、||、upper/lower、substring、length、trim、to_char、interval、extract、round/floor/ceil、cast 都跑出了明确结果。MySQL 习惯里的三参数 concat 和 date_format 在当前 KingbaseES 环境里没有直接跑通,替代路径也已经验证:字符串拼接用 ||,时间格式化用 to_char。
从 MySQL 切过来时,业务 SQL 里的函数最好一组一组跑。先处理 NULL,再确认类型,再决定用哪个函数。这样写出来的 SQL 不只是能执行,字段含义也更清楚。