一次 Binder 调用会在多个进程和线程上产生记录。调用进程中可以看到 binder transaction,目标进程的 Binder 线程中有对应的 binder reply;系统开启 AIDL tracing 后,服务端 Slice 还会显示接口名和方法名。结合两端线程的 Running、Runnable、Sleeping 状态,可以确认事务由谁发起、在哪个线程执行,以及调用方等待了多久。
本文从一次真实的 IWindowSession.relayout 开始。App 主线程请求 system_server 重新布局窗口,服务端执行期间又访问 SurfaceFlinger,并向 SystemUI 发送异步通知。调用的两端、同步等待、嵌套事务都能在同一个时间窗口里找到证据。
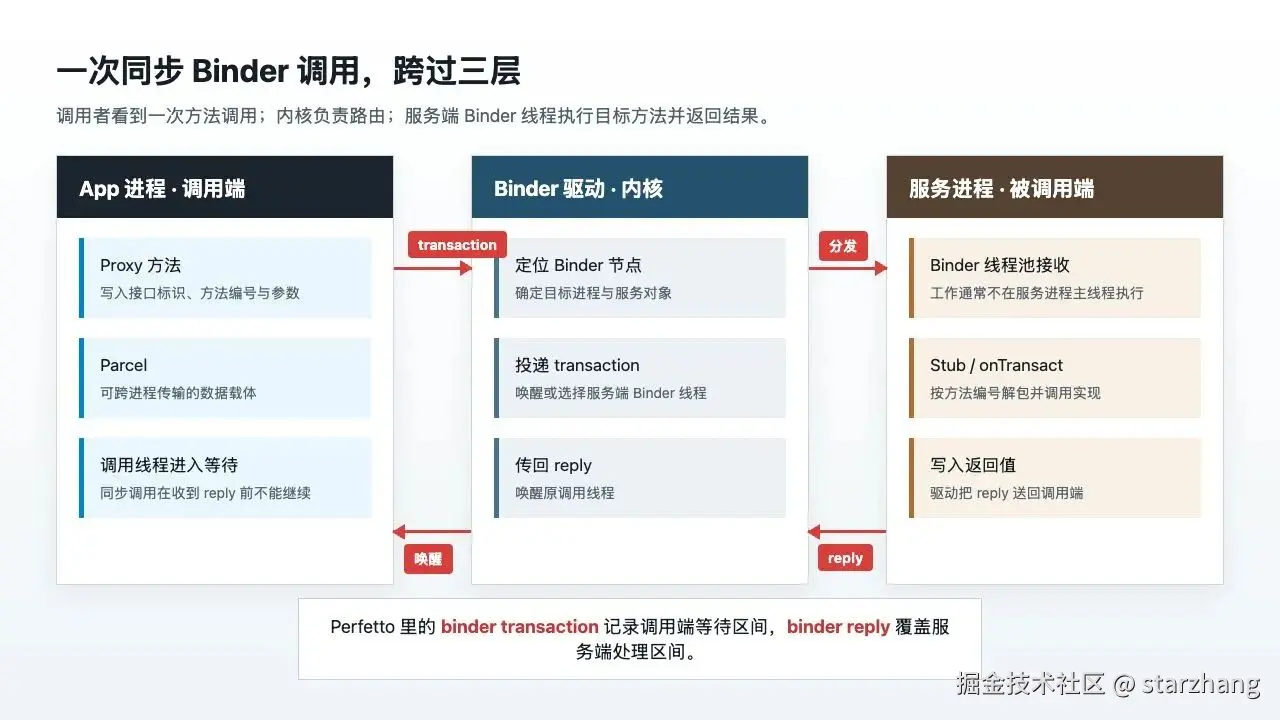
代码里的一次调用,系统里经历了什么
客户端拿到的通常是 Binder Proxy,远端对象仍在服务进程。调用 Proxy 方法时,参数会写入 Parcel,其中还包含接口标识和方法编号。Binder 驱动根据句柄找到目标 Binder 节点,把事务投递到目标进程;服务端 Binder 线程从线程池取到事务,经 Stub / onTransact 解包,调用真正的服务实现。同步方法执行完后,返回值再经 reply 送回客户端,原调用线程由此被唤醒。
这条链路解释了 Perfetto 中几种对象的含义:
binder transaction位于调用端,覆盖从发起事务到收到返回的墙上时间。binder reply位于服务端,覆盖服务端接收、执行和返回这笔事务的区间。名字里虽然有 reply,它记录的并非只有"写回结果"那一小段。AIDL::...::server给出服务端接口和方法。能否看到完整名称,取决于系统版本、采集配置和对应 AIDL 插桩。- Flow 把调用端事务与服务端处理关联起来。分析跨进程耗时时,它比依靠时间位置猜测可靠。
- Thread State 用于区分 CPU 执行、等待调度和睡眠。Binder Slice 的宽度不能替代线程状态。
Perfetto 怎样确认事务的两端
Binder 驱动在发送和接收事务时会产生 binder_transaction、binder_transaction_received 等内核事件,事件中包含事务标识、发送线程、目标节点和 flags。Trace Processor 解析这些事件后,把发送端与接收端关联成 Flow,并向 UI 暴露 binder transaction、binder reply 等 Slice。
AIDL 方法名来自另一组用户态插桩。AIDL::java::IWindowSession::relayout::server 能说明服务端执行了哪个接口,调用两端的对应关系仍以 Binder 驱动事件为准。因此,Trace 中即使没有 AIDL 名称,也不影响沿 Flow 找到目标进程和 Binder 线程。
这几类数据各自回答不同问题:
| 数据 | 能确认的内容 | 不能直接确认的内容 |
|---|---|---|
| Binder Flow | 发送线程、接收线程、事务方向 | 方法内部哪一步最慢 |
| AIDL server Slice | 接口名、方法名、服务端执行区间 | Parcel 实际大小 |
| Thread State | Running、Runnable、Sleeping 的分布 | Sleeping 的具体原因,需要继续看锁、I/O 或嵌套调用 |
| Slice 子层级 | 服务端方法内部的阶段和嵌套 Binder | 没有插桩的普通函数调用 |
一笔同步事务怎样读
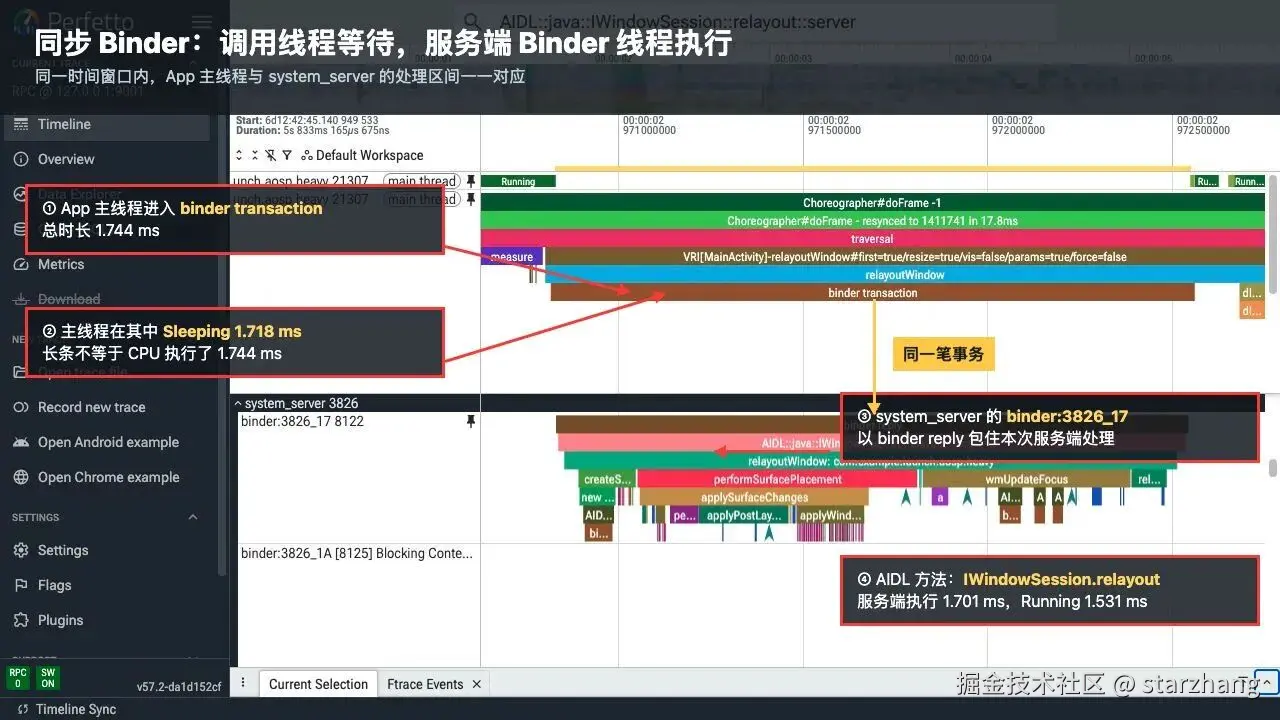
图中 App 主线程进入 binder transaction 后,约 1.744 ms 才返回。对应的服务端线程是 system_server 中的 binder:3826_17,binder reply 持续约 1.714 ms,内部的 AIDL::java::IWindowSession::relayout::server 持续约 1.701 ms。
几个时间点可以把这 1.744 ms 分开:
| 阶段 | 相对时间 | 能说明什么 |
|---|---|---|
| App 发起 transaction | 2970.818 ms | 调用端进入 Binder |
| system_server 开始处理 | 2970.831 ms | 驱动完成投递,Binder 线程接单 |
| AIDL server Slice 开始 | 2970.837 ms | 开始执行 relayout |
| 服务端处理结束 | 约 2972.545 ms | binder reply 结束 |
| App 调用返回 | 约 2972.562 ms | 主线程恢复后续执行 |
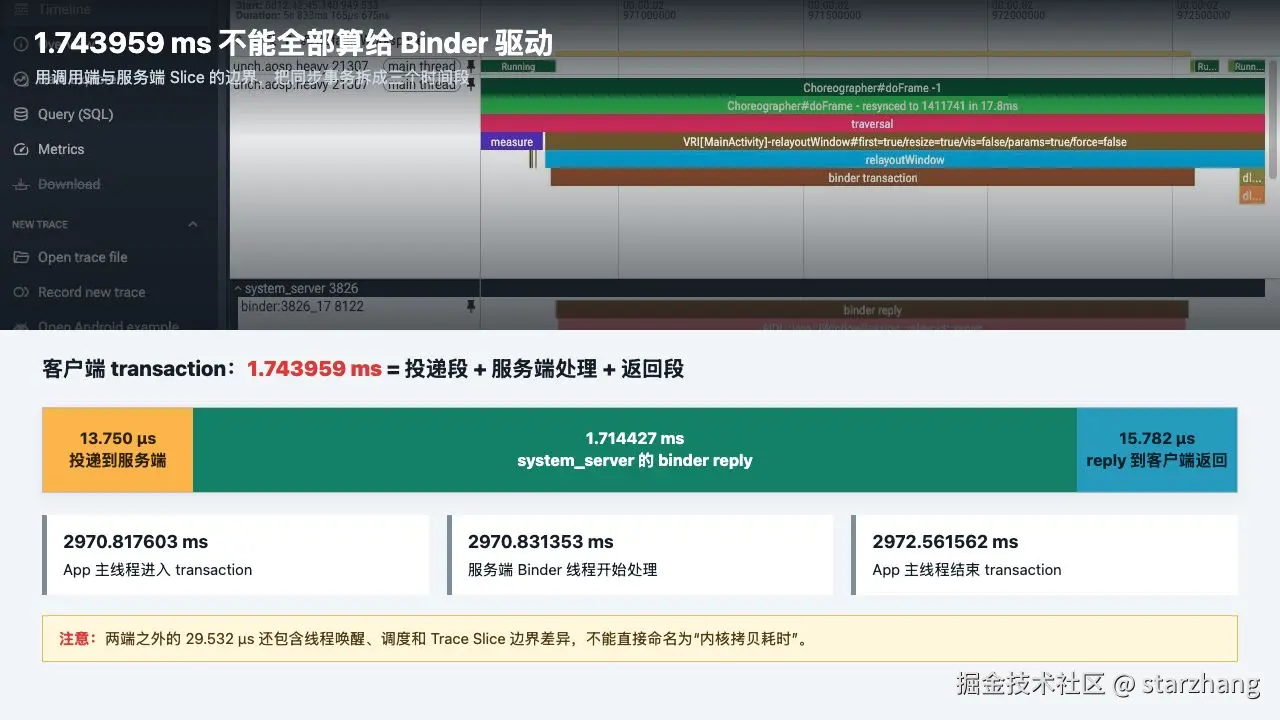
使用 Slice 的纳秒时间戳,可以得到更精确的三段数据:
- 投递段:
server_start - client_start = 13.750 μs - 服务端段:
server_end - server_start = 1.714427 ms - 返回段:
client_end - server_end = 15.782 μs
三段相加正好是调用端看到的 1.743959 ms。服务端段占 98.31%,窗口重布局是本次调用的主要耗时。投递段与返回段合计 29.532 μs,但这部分还混有线程唤醒、调度和 Trace Slice 边界差异,不能直接当作 Binder 驱动的两次拷贝耗时。
线程状态提供了第二层证据。App 主线程在这段 binder transaction 中 Sleeping 约 1.718 ms;服务端 AIDL Slice 中 Running 约 1.531 ms,占 90% 左右。主线程在等待 system_server 完成窗口重布局,服务端则以实际 CPU 运行为主。
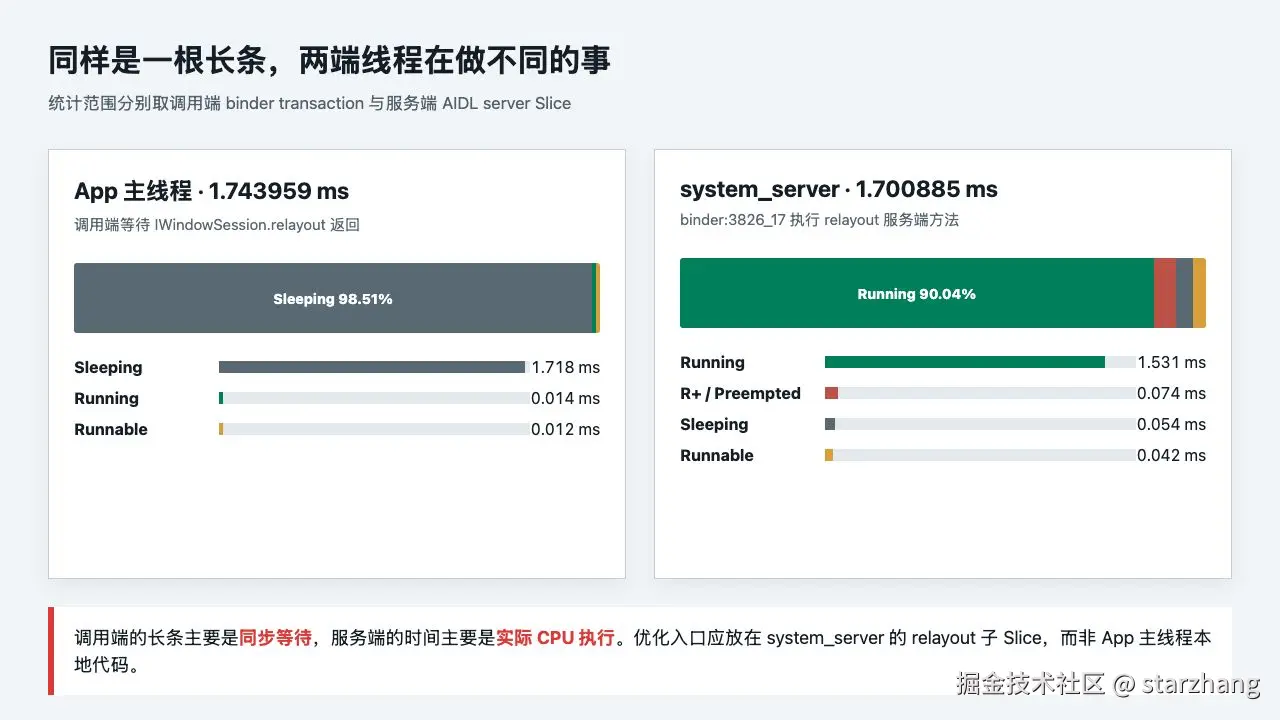
调用端剩余的时间只有约 14 μs Running 和 12 μs Runnable。若把整段 1.744 ms 都计入"主线程执行耗时",会把同步等待误算成本地 CPU 开销。服务端的 1.700885 ms 中,Running 为 1.531459 ms,Runnable 与 Runnable Preempted 合计约 115.572 μs,Sleeping 约 53.854 μs;继续优化时应先展开 relayoutWindow 的子 Slice,再检查这 53.854 μs 是否来自锁、嵌套 Binder 或其他等待。
App 主线程上的 1.744 ms 长条不能归为"主线程执行慢"。线程状态已经表明主线程主要处于同步等待,后续检查应进入服务端 Slice。
服务端还能继续跨进程
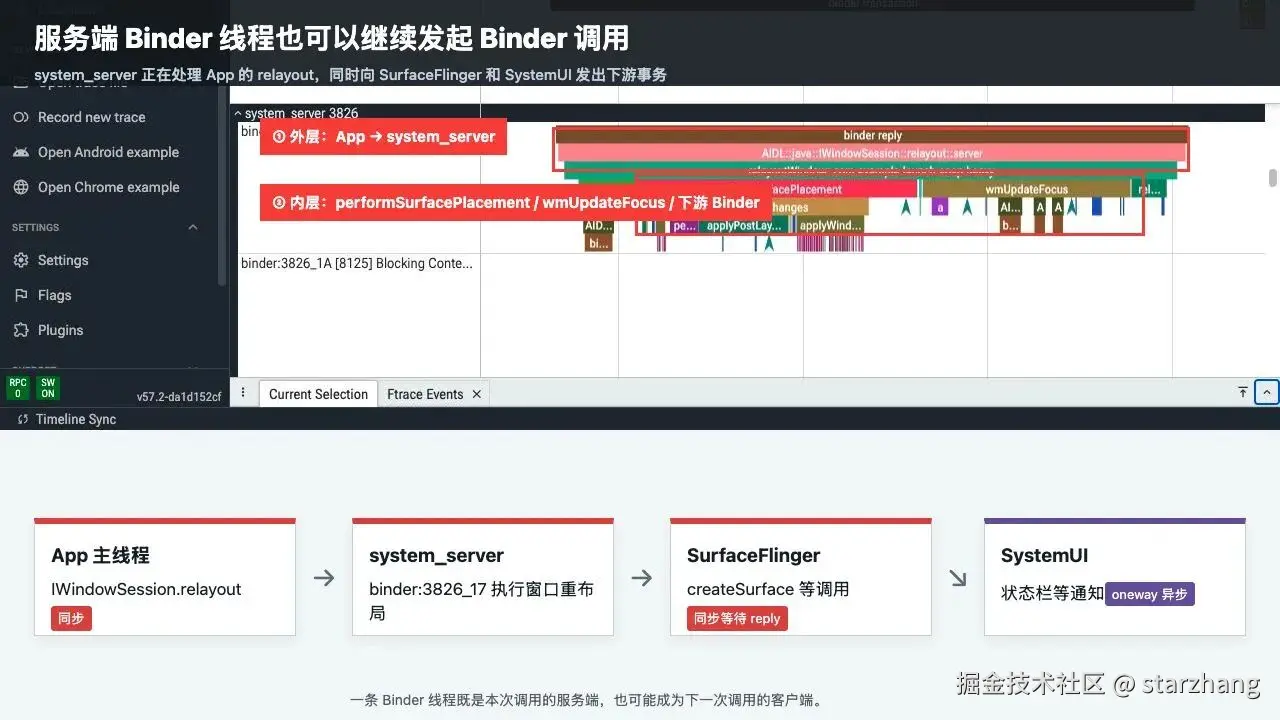
relayoutWindow 内部可以看到 createSurfaceControl、performSurfacePlacement、applySurfaceChanges 和 wmUpdateFocus。其中还有数个更短的 binder transaction:system_server 的 Binder 线程正在处理 App 请求,同时又以客户端身份调用 SurfaceFlinger,或向 SystemUI 发送通知。
这类结构称为嵌套 Binder 调用。一次调用链可能是:
App main → system_server binder thread → SurfaceFlinger binder thread
外层调用没有结束,system_server 的当前 Binder 线程便在内层同步事务上等待。内层服务慢、目标线程池繁忙、调度延迟,最后都会计入 App 主线程看到的外层 binder transaction。只盯着 App 与 system_server 两层,会把下游服务造成的时间算到窗口服务头上。
Binder 允许这种嵌套与重入。由此也带来一个工程风险:持锁状态下发起同步 Binder 调用,远端可能经另一条 Binder 链回调当前进程,再次请求同一把锁。Trace 中若出现 Binder 线程 Sleeping、锁等待 Slice 以及反向 Flow,需要优先检查锁与跨进程调用的组合。
案例中的一个内层同步事务从 system_server 发往 SurfaceFlinger:客户端 binder transaction 约 76 μs,SurfaceFlinger 服务端处理约 48 μs。外层 App 调用会包含这 76 μs。旁边还出现了发往 SystemUI 的 binder transaction async,用于状态栏等通知;这些异步事务不会等待 SystemUI 返回,但接收端仍可能在稍后排队执行。
同步调用与 oneway
同步 Binder 方法需要等待 reply。返回类型为 void 并不代表异步,是否异步由 AIDL 的 oneway 决定。同步事务通常具备这些特征:调用端 binder transaction 持续到服务端完成;调用线程大部分时间为 Sleeping;服务端有可对应的 binder reply。
oneway 事务只保证把请求排入 Binder,调用端无需等待服务端执行完成。Trace 中常见 binder transaction async,调用端 Slice 可能很短,服务端真正处理发生在稍后。短 Slice 只能说明发送动作快,不能说明接收方已经完成工作。
同一个 Binder 节点上的异步事务会按顺序处理。连续大量 oneway 调用仍可能在服务端排队,表现为客户端发送很快、接收端开始时间不断后移。分析异步链路时应比较发送时间与服务端开始时间,而不是比较客户端 Slice 宽度。
在 Perfetto 中把调用链追到底
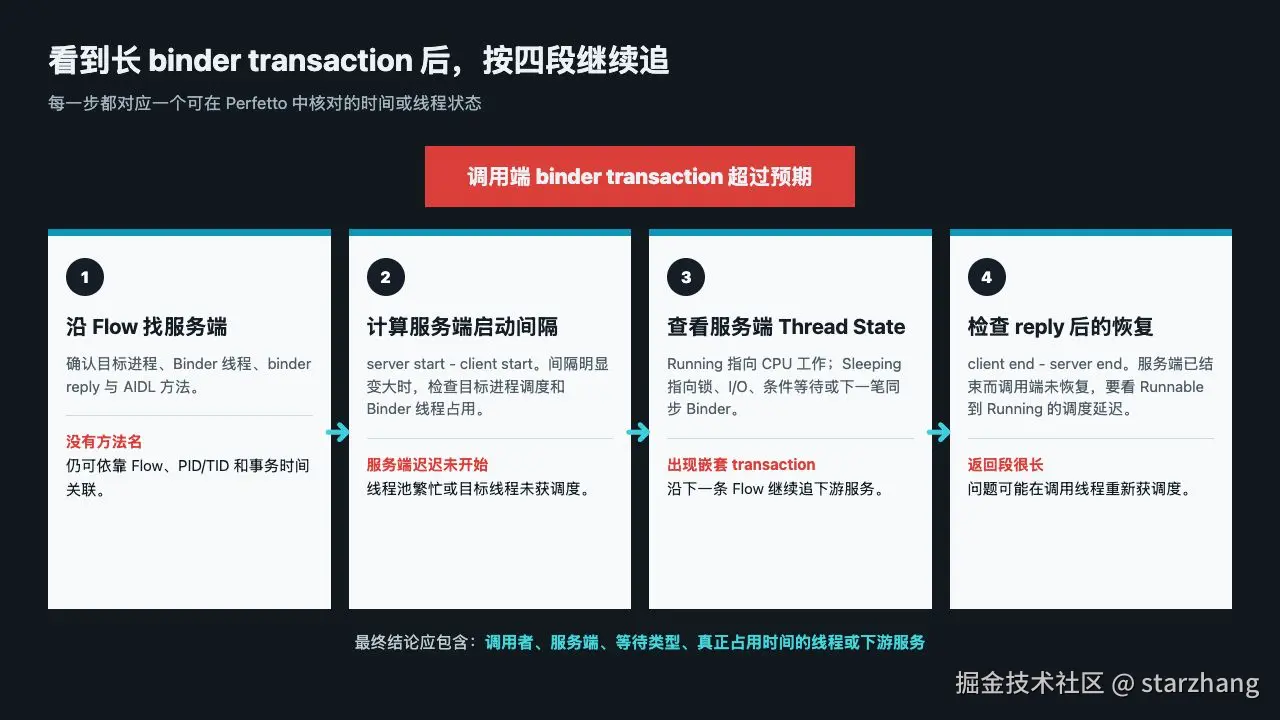
从一条较长的 binder transaction 开始,选中 Slice 后查看 Flow。同步事务会关联到目标进程的 Binder 线程;进入服务端后,先记录 binder reply 的起止时间,再展开内部的 AIDL server Slice。服务端出现新的 binder transaction 时,重复同一过程,直到某一层不再跨进程。
每一层都记录四个值:调用端开始、服务端开始、服务端结束、调用端结束。它们分别用于计算投递段、服务端段和返回段。再把服务端段与 Thread State 对齐,便能区分 CPU 执行、等待调度、睡眠和下游同步调用。
用线程状态给 Binder 耗时定性
不同的线程状态组合通常对应以下方向:
| Trace 表现 | 优先判断 | 下一步 |
|---|---|---|
| 客户端 Sleeping,服务端 Running 很长 | 服务端 CPU 工作多 | 展开服务端子 Slice,查热点方法与嵌套调用 |
| 客户端 Sleeping,服务端也 Sleeping 很长 | 服务端在等锁、I/O、条件变量或另一笔 Binder | 查看服务端 Sleeping 区间的 blocked function、锁和 Flow |
| transaction 开始后,服务端很晚才开始 | 目标进程调度延迟或 Binder 线程池繁忙 | 查看目标 Binder 线程数量、Runnable 延迟和同时在途事务 |
| 服务端很快结束,客户端很晚才恢复 | reply 返回后的唤醒或调度延迟 | 查看调用线程从 Runnable 到 Running 的时间 |
| 服务端内部出现更长的嵌套 transaction | 下游服务主导外层耗时 | 沿 Flow 继续追到下一进程 |
| async 发送很短,接收端很晚处理 | 异步队列积压或接收端调度延迟 | 对齐发送、接收时间,检查同节点 oneway 序列 |
Binder 线程池耗尽时,常能看到目标进程的多条 Binder 线程同时被占用:有的卡在锁上,有的等待 I/O,有的又同步调用下游服务。新的事务已经到达,却迟迟没有 Binder 线程开始执行。此时扩大线程池只能缓解表象;需要继续找出哪些长事务长期占住了线程,以及它们在等待什么。
判断线程池是否繁忙,不能只看单条调用的总时长。需要同时满足两类证据:发送端事务已经开始,目标 Binder 线程的处理明显晚于发送时间;同一目标进程的多条 Binder 线程在该区间都处于执行或阻塞状态。只有第一条证据时,也可能只是目标进程没有及时获得 CPU。
服务实现也可能把任务转交主线程,再等待主线程返回。此时 Binder 线程本身会进入 Sleeping,真正的工作出现在目标进程主线程。Flow、唤醒关系和两条线程轨道要一起看,不能因为服务入口位于 Binder 线程就认定所有业务都在该线程执行。
几个常见误判
把 binder transaction 的宽度当成 Binder 驱动耗时。 它包含服务端执行、服务端等待、嵌套调用、reply 返回和调用端重新获调度的时间。
把 binder reply 理解成返回值序列化。 Perfetto 用它承载服务端处理区间,真正的业务 Slice 通常嵌套在里面。
看到 void 就认为是异步。 AIDL 只有声明 oneway 才具备异步语义。
找不到 AIDL 方法名就认为没有 Binder 调用。 binder transaction 与 Flow 来自 Binder 驱动事件;接口名依赖额外插桩,缺少名称时仍可依据事务两端、线程和时间继续分析。
只查主线程。 服务端 Binder 线程、下游服务和目标主线程都可能承担真正耗时。Binder 性能分析天然是跨线程、跨进程的。
根据 transaction 时长猜 Parcel 很大。 Trace 默认不会给出本次调用的 Parcel 字节数。长事务更常见的来源是服务端执行、阻塞和嵌套调用;没有 payload 数据时,不能从 Slice 宽度反推序列化大小。
看到服务端 Sleeping 就直接判定锁竞争。 Sleeping 还可能来自 I/O、条件变量、futex、等待主线程结果或下一笔同步 Binder。需要结合 blocked function、锁 Slice、唤醒关系和嵌套 Flow 继续确认。
采集时要保留哪些数据
要还原上述关系,Trace 至少需要 Binder 驱动事件和线程调度数据。Perfetto 采集配置中应包含 binder_driver 与 sched;需要 AIDL 接口名时,还要保留系统 ATrace/AIDL 相关类别。应用侧若能在高层业务入口添加自定义 Trace,定位会更快:先找到业务动作,再向内找到 binder transaction,随后沿 Flow 进入服务端。
一笔 Binder 调用的完整结论至少要回答四个问题:谁发起、谁执行、调用端在等什么、服务端时间花在哪里。binder transaction 只回答了第一个问题的一半。Flow、binder reply、AIDL Slice 和 Thread State 合在一起,才构成可验证的调用链。