数据库进了 K8s,运维的锅甩给谁
很多团队把数据库迁到 Kubernetes 之后,会经历一个相似的阶段:一开始只是想让数据库跑在容器里,图个环境统一、资源隔离。跑通之后发现,真正难受的地方在后面------主库挂了要手动切、磁盘满了要手动扩、备份策略散落在各种脚本里、扩容一个从库要改一堆 YAML 再手动执行初始化。
Kubernetes 本身解决的是无状态应用的编排问题。Deployment 挂了会自动拉起,但它不理解"数据库主库"和"从库"的区别,也不懂什么叫"数据一致性"。StatefulSet 提供了稳定的网络标识和存储,算是往前走了一步,但它仍然只是一个更聪明的 Pod 管理器,不会替你做故障切换。
这就是 Operator 模式出现的原因。它把领域知识(这里是数据库运维知识)编码进控制器,让 K8s 能够理解"一个数据库集群"这种高层对象,并持续把实际状态往期望状态收敛。
金仓 KES-Operator 就是这个思路在 KingbaseES 上的落地。这篇文章我不打算复述官方文档,而是从"它到底解决了哪些具体问题、内部大概是怎么运转的、部署时要注意什么"这几个角度来拆。需要先说明:KES-Operator 的版本迭代比较快,下面涉及的 CRD 字段名和参数,我以公开资料和通用 Operator 设计模式为准,具体字段请以你实际使用的版本 CRD 定义为准,我没有逐一验证所有版本的差异。
Operator 到底在替谁干活
先把这个概念说清楚,不然后面看 CRD 会一头雾水。
Kubernetes 的核心机制是"声明式 + 控制器"。你写一个 YAML 描述"我要什么",控制器负责让它变成现实。内置控制器管的是 Deployment、Service 这些通用对象。Operator 做的事,是让你可以自定义一种新的对象类型,然后写一个专属控制器去管它。
用一句话概括 Operator 的调谐循环:
观察当前状态 → 和期望状态对比 → 有差异就采取动作 → 再观察这个循环不停地跑。数据库主库挂了,控制器观察到 Pod 状态异常,就会执行切换逻辑;你改了 CR 里的副本数,控制器观察到差异,就去创建新的实例。整个过程不需要人盯着。
对数据库来说,Operator 需要额外处理几件 K8s 原生对象搞不定的事:
- 角色识别:哪个实例是主、哪些是从,这个信息得持久化并且能动态变更
- 有序变更:扩容从库可以随便加,但主备切换必须按顺序来,避免脑裂
- 数据安全边界:删 Pod 和删数据是两回事,PVC 不能被随手回收
- 备份与恢复:这属于数据库领域逻辑,K8s 完全不管
理解了这些,再看 KES-Operator 的 CRD 设计,就能明白每个字段为什么存在。
从 CRD 看它抽象了什么
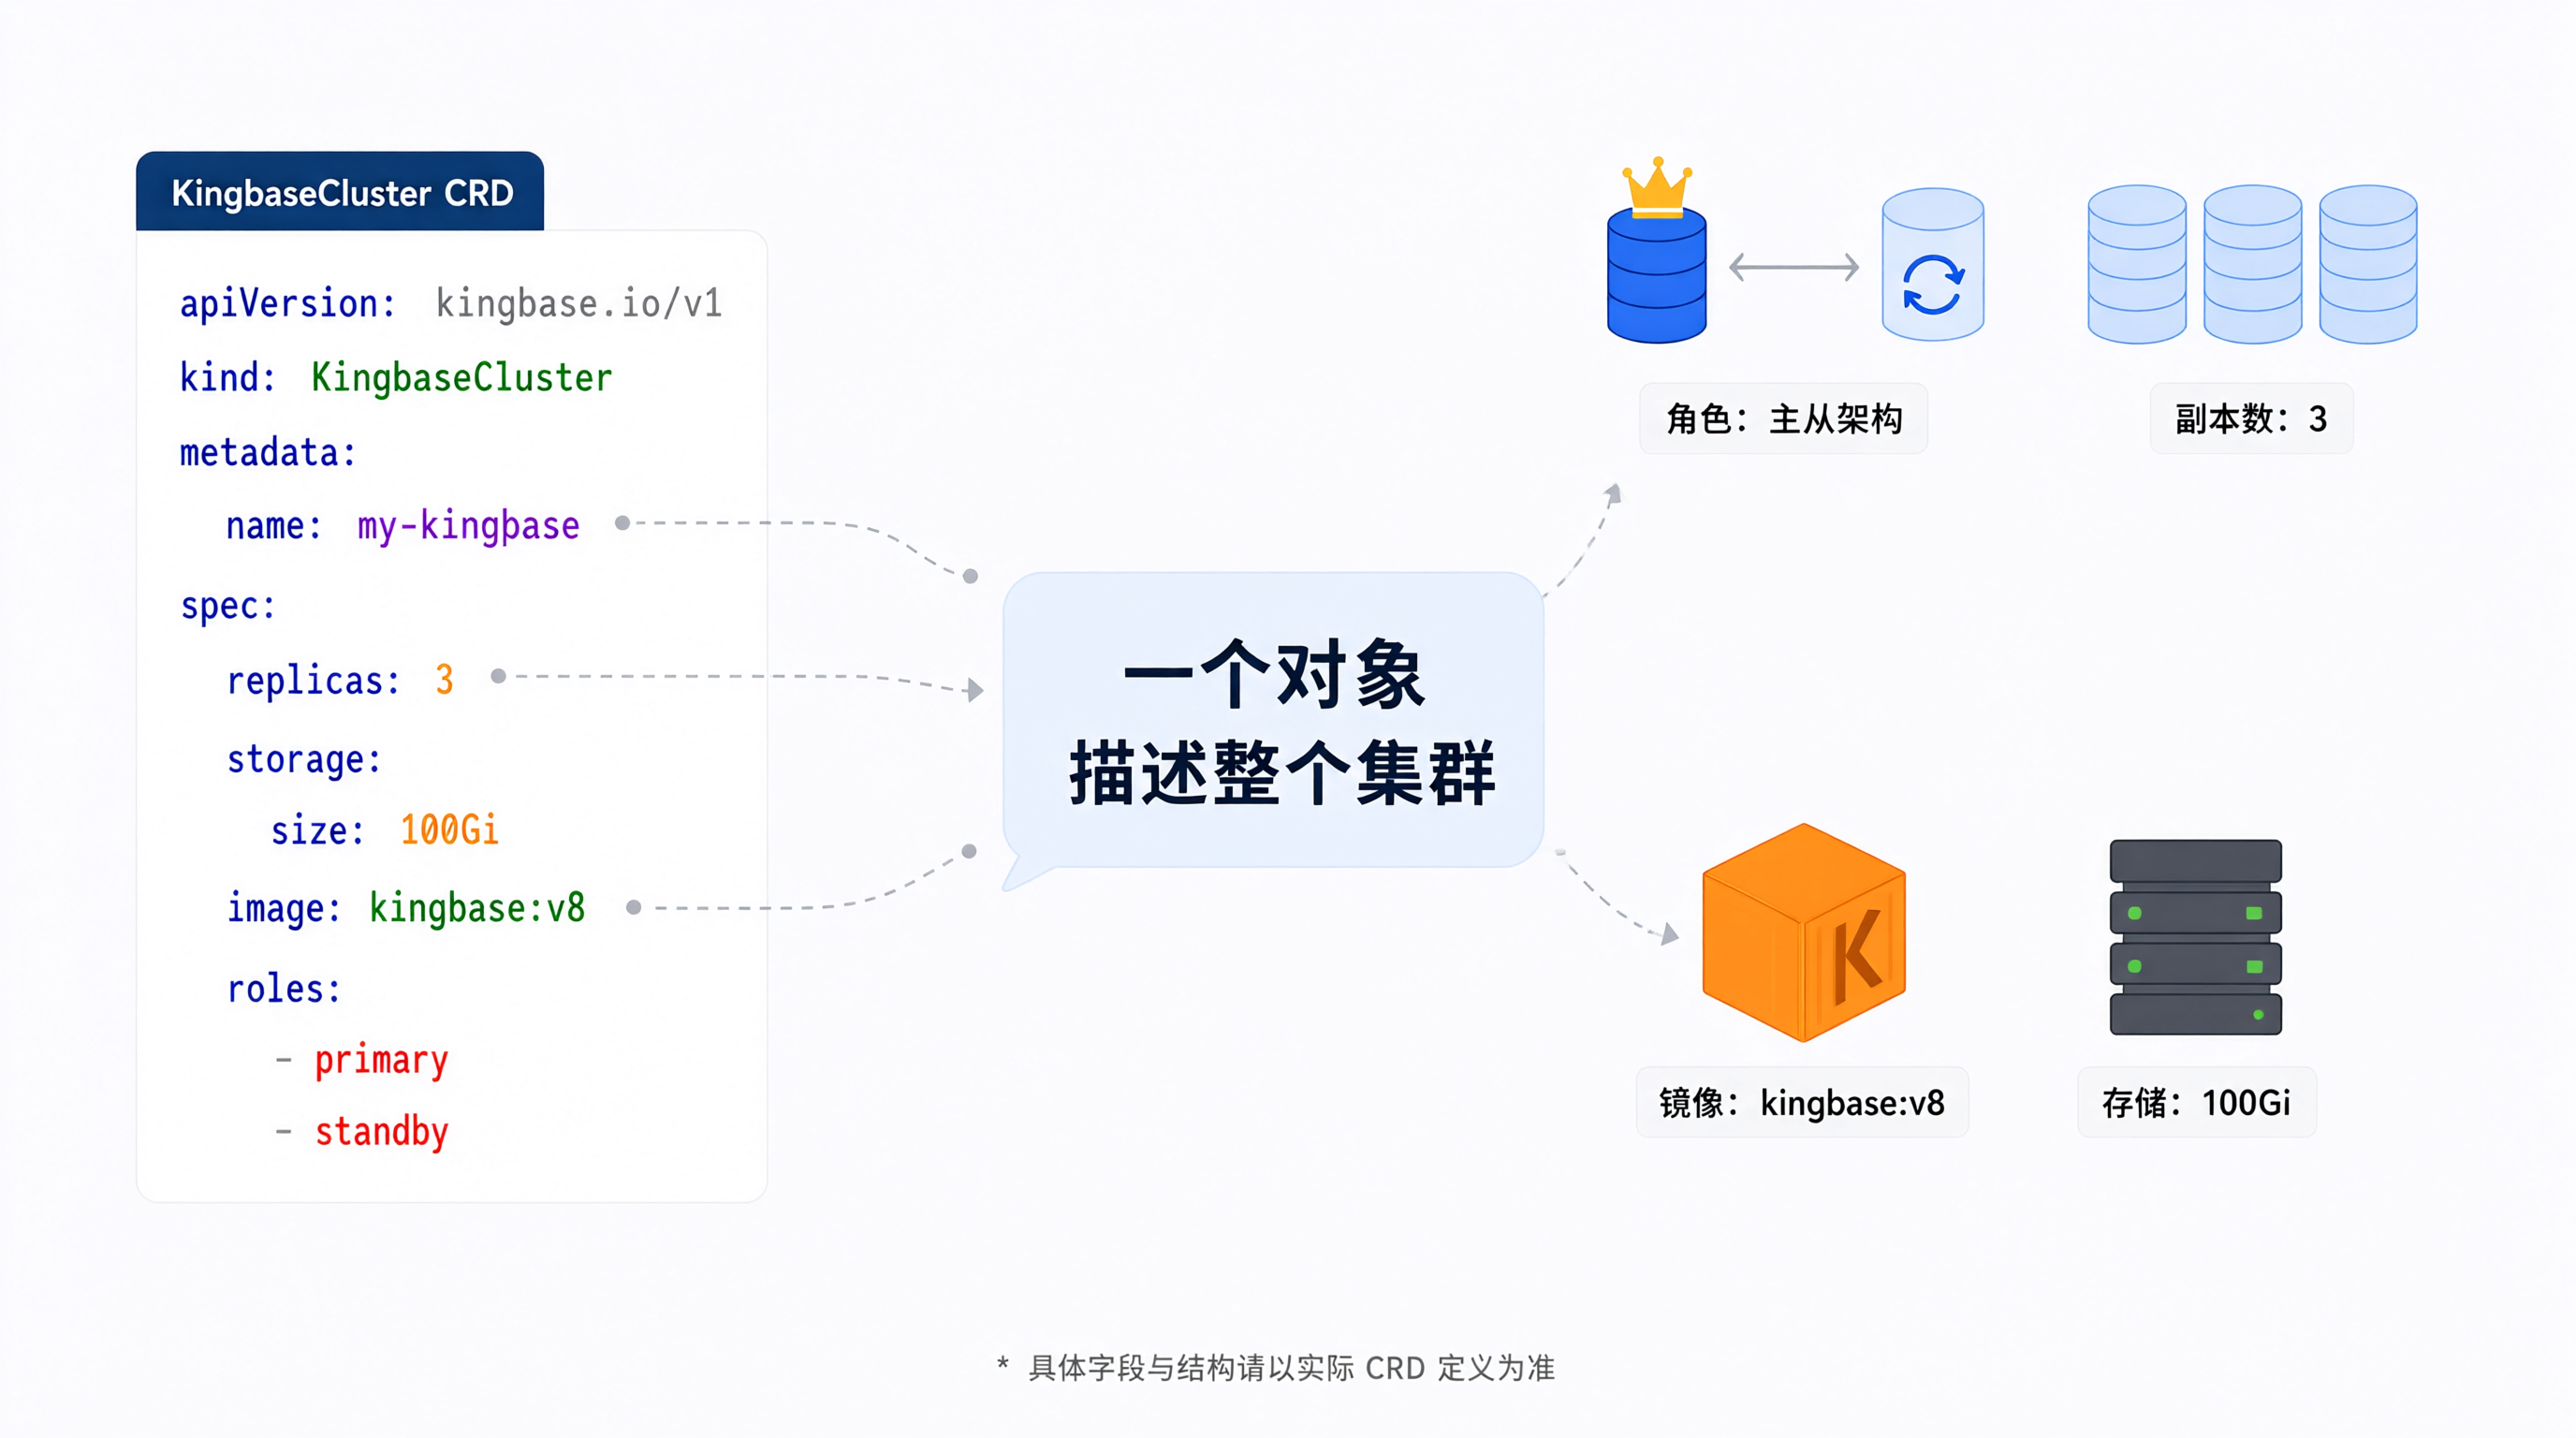
Operator 的能力边界,基本由它的 CRD 定义决定。KES-Operator 的核心对象是描述一个 KingbaseES 集群的自定义资源。虽然不同版本字段有差异,但抽象层次大致是这样的:
yaml
apiVersion: apps.kingsware.cn/v1
kind: KingbaseCluster
metadata:
  name: kes-cluster
  namespace: database
spec:
  # 实例数量,通常 1 主 + N 从
  replicas: 3
  # 镜像版本,对应具体的 KingbaseES 版本
  image: <kes-image>:<tag>
  # 资源规格
  resources:
    requests:
      cpu: "2"
      memory: "4Gi"
    limits:
      cpu: "4"
      memory: "8Gi"
  # 存储配置
  storage:
    size: 50Gi
    storageClassName: local-ssd
  # 数据库初始化参数
  config:
    port: 54321
【注意】上面这段 YAML 是结构示意,apiVersion、字段名和层级请务必以你部署的 KES-Operator 版本自带的 CRD 为准。不同 Operator 项目对同一个概念的字段命名习惯差别很大,直接照抄很容易 apply 失败。
从这份抽象里能读出几个设计取向:
第一,它把"集群"当成一个整体对象,而不是三个独立的 Pod。你声明的是"我要一个三副本的 KingbaseES 集群",而不是"我要启动三个容器"。这个粒度差异很关键,因为主从关系是集群级别的语义。
第二,存储和计算分离描述。storage 和 resources 分开配置,意味着扩存储和扩计算是两条独立路径。实际运维里这两个动作的时机和风险完全不同,扩存储通常需要底层 StorageClass 支持在线扩容,扩计算则涉及数据重新分布。
第三,配置通过 CR 下发。数据库参数、端口这些放进 spec,变更时由控制器负责滚动生效,而不是让你进容器改配置文件。
控制器是怎么把状态收敛过去的
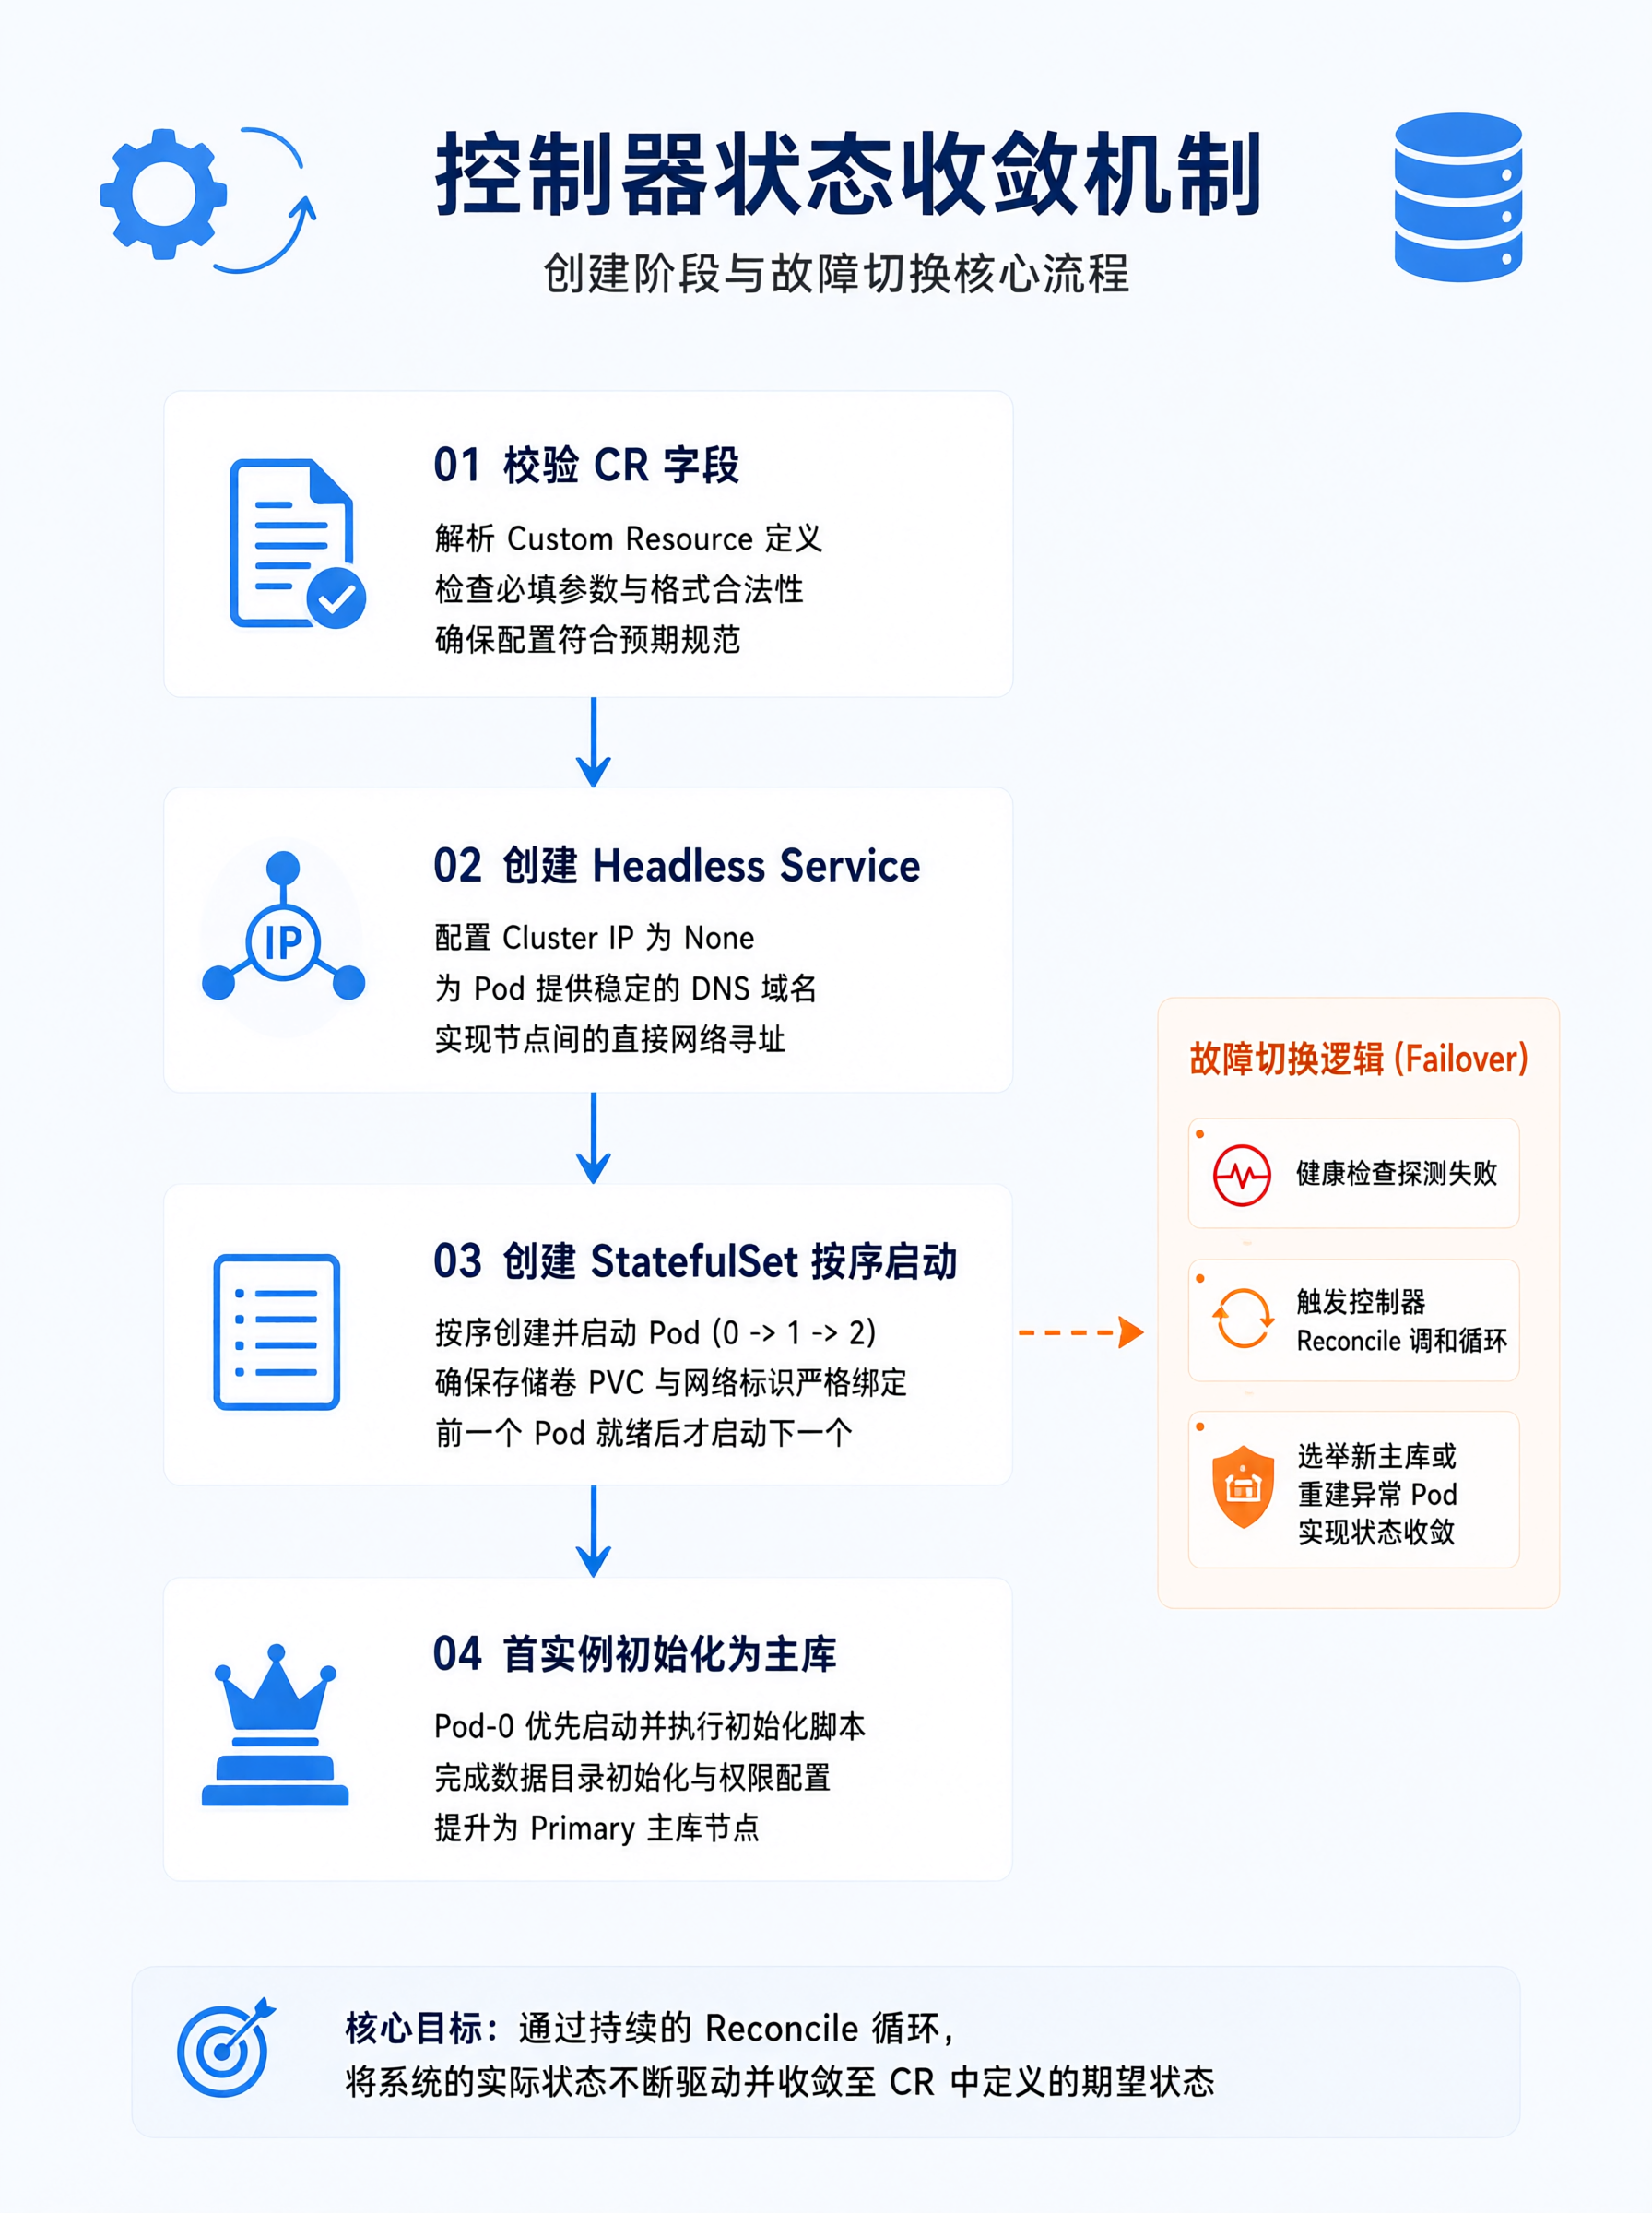
理解了 CRD 描述"要什么",接下来看控制器怎么"做到"。
创建阶段
当你 apply 一个 KingbaseCluster 之后,控制器的处理顺序大致是:
- 校验 CR 字段合法性,比如副本数不能为 0、存储大小不能小于某个下限
- 创建 Headless Service,给每个实例固定 DNS 名称,这是 StatefulSet 稳定网络标识的基础
- 创建 StatefulSet 或直接管理 Pod,按序号依次启动
- 第一个实例以主库身份初始化,执行
initdb类似的初始化流程 - 后续实例以从库身份加入,通过流复制从主库同步数据
- 更新 CR 的 status 字段,记录当前主库是谁、集群是否就绪
这个顺序不能乱。从库必须在主库就绪之后才能加入,否则同步会失败。这也是为什么数据库 Operator 通常基于 StatefulSet 而不是 Deployment------StatefulSet 保证 Pod 按序号顺序创建和终止。
运行阶段
集群跑起来之后,控制器进入持续观察状态。它会周期性检查:
- 每个 Pod 是否 Ready
- 主库是否可写
- 从库复制延迟是否在阈值内
- PVC 使用率是否接近上限
- 有没有实例反复重启
这些检查的结果会反映到 CR 的 status 里。你可以用 kubectl get kingbasecluster 看到类似这样的输出(字段名以实际为准):
NAME          READY   PRIMARY      AGE
kes-cluster   3/3     kes-0        2d
故障处理阶段
主库挂掉是最能体现 Operator 价值的场景。手工运维时,你得先确认主库真的挂了(而不是网络抖动),然后选一个复制延迟最小的从库提升为主,再让其他从库指向新主,最后处理旧主恢复后如何重新加入。这一串操作任何一步出错都可能导致数据不一致。
Operator 把这个流程固化成代码。控制器检测到主库异常后,会按预设策略触发切换。这里有个关键设计点:切换决策必须由单一权威做出,不能每个实例自己判断。通常的做法是通过 K8s 的 Lease 对象或类似机制做领导者选举,保证同一时刻只有一个控制器实例在执行切换逻辑。
【关键结论】Operator 处理故障切换的核心不是"自动化"三个字,而是把决策权收敛到单点,避免多个组件同时对集群状态做判断而产生冲突。
部署与验证:一个可操作的流程
下面给一个从零开始验证 KES-Operator 的流程。因为具体镜像和 Helm Chart 地址随版本变化,这里只写通用步骤,你需要替换成自己环境里的实际地址。
1. 确认集群前置条件
bash
kubectl version --short
kubectl get storageclass
数据库对存储 IO 比较敏感,建议用支持 ReadWriteOnce 的本地 SSD 或高性能块存储。网络存储延迟高的话,主从复制延迟会很明显。
2. 部署 Operator
如果项目提供 Helm Chart:
bash
helm repo add <repo-name> <repo-url>
helm repo update
helm install kes-operator <repo-name>/kes-operator \
  --namespace kes-system \
  --create-namespace
如果没有 Helm,通常也支持直接 apply 官方提供的部署清单:
bash
kubectl apply -f <operator-deploy-manifest>.yaml3. 检查 Operator 是否就绪
bash
kubectl get pods -n kes-system
kubectl logs -n kes-system deploy/kes-operator --tail=50
日志里应该能看到控制器启动、开始 watch CR 的信息。如果一直报权限错误,多半是 RBAC 没配好,检查 ClusterRole 和 ServiceAccount 绑定。
4. 创建数据库集群
准备好前面那样的 CR YAML,然后:
bash
kubectl apply -f kes-cluster.yaml
kubectl get kingbasecluster -n database -w
-w 会持续输出状态变化,你能直观看到集群从创建到就绪的过程。
5. 验证主从关系
连到主库确认可写:
bash
kubectl exec -it kes-cluster-0 -n database -- ksql -U system -p 54321 -c "SELECT pg_is_in_recovery();"返回 f 说明是主库,返回 t 说明是从库。这个函数是 PostgreSQL 系的通用判断方式,KingbaseES 兼容这套接口。
6. 模拟一次故障
删掉主库 Pod,观察控制器行为:
bash
kubectl delete pod kes-cluster-0 -n database
kubectl get kingbasecluster -n database -w
【踩坑提醒】在生产环境做这个测试之前,务必在测试集群先跑一遍。故障切换涉及数据,即使 Operator 逻辑正确,如果存储或网络配置有问题,也可能出现切换后数据不一致。测试时最好先灌一批数据并记录校验值,切换后对比。
Operator、手工运维、StatefulSet 怎么选
这三种方式不是互斥的,但适用场景差别明显。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 手工运维 | 完全可控,出问题能直接介入 | 依赖人的经验,故障响应慢,容易操作失误 | 单实例、低频变更、对自动化不信任的核心库 |
| 纯 StatefulSet | 配置简单,K8s 原生,无额外组件 | 不理解主从语义,无自动切换,备份要自己写 | 开发测试环境、无高可用要求的场景 |
| KES-Operator | 声明式管理,自动故障切换,运维动作标准化 | 引入额外组件,需要理解 CRD,调试链路变长 | 生产环境、多集群、需要高可用和自动化运维 |
我的判断是:如果你的数据库只有单实例、几乎不变更,上 Operator 属于过度设计,多一层抽象反而增加排查成本。但只要涉及主从高可用、需要定期扩缩容或者多环境统一管理,Operator 带来的收益就很明显了。
【注意】Operator 自动化程度越高,出问题时你越需要理解它内部在做什么。完全黑盒地用它,一旦控制器判断失误,你可能连从哪下手排查都不知道。建议至少把它的调谐逻辑和状态字段含义搞清楚。
哪些事 Operator 也替你做不了
最后说点务实的。Operator 不是银弹,有几类事情它通常管不了或者管不好:
跨集群容灾。Operator 一般只管自己所在 K8s 集群内的实例。跨机房、跨集群的容灾需要额外的数据同步方案,这超出了单个 Operator 的职责范围。
数据层面的逻辑错误。控制器能发现 Pod 挂了、复制断了,但发现不了"业务误删了一张表"。这类问题得靠备份和 PITR(时间点恢复),而备份策略的正确性、恢复演练,仍然需要人来设计和验证。
性能调优。资源规格可以声明,但具体某个查询为什么慢、索引怎么建、参数怎么调,这些是 DBA 的活,Operator 不碰。
存储底层的坑。如果 StorageClass 本身有问题,比如扩容失败、快照不可用,Operator 也只能把错误报出来,解决还得靠存储团队。
所以更准确的说法是:Operator 把重复性的、有明确规则的运维动作 自动化了,把工程师从"盯着集群做机械操作"里解放出来,但判断和决策这部分依然需要人。
写在最后
KES-Operator 的价值不在于它用了多新的技术,而在于它把数据库运维里那些"每次都要小心操作、容易出错"的流程,变成了可版本化、可复现的代码。声明式运维的核心是让期望状态成为唯一事实来源,控制器负责消除偏差。
如果你正在评估要不要上 Operator,我的建议是先列出你们现在数据库运维里最高频、最容易出错的三个动作,看看 Operator 能不能覆盖。如果覆盖了,收益是实打实的;如果你们的主要痛点是跨机房容灾或者业务层数据问题,那 Operator 帮不上太多忙,别指望它解决所有问题。
至于 KES-Operator 具体版本的字段细节和最新能力,建议直接查对应版本的 CRD 定义和官方发布说明,那是最准的。我上面提到的结构是通用设计层面的理解,具体实现请以你手上的版本为准。
=TAGS=
python,后端,性能优化,人工智能
=BODY=