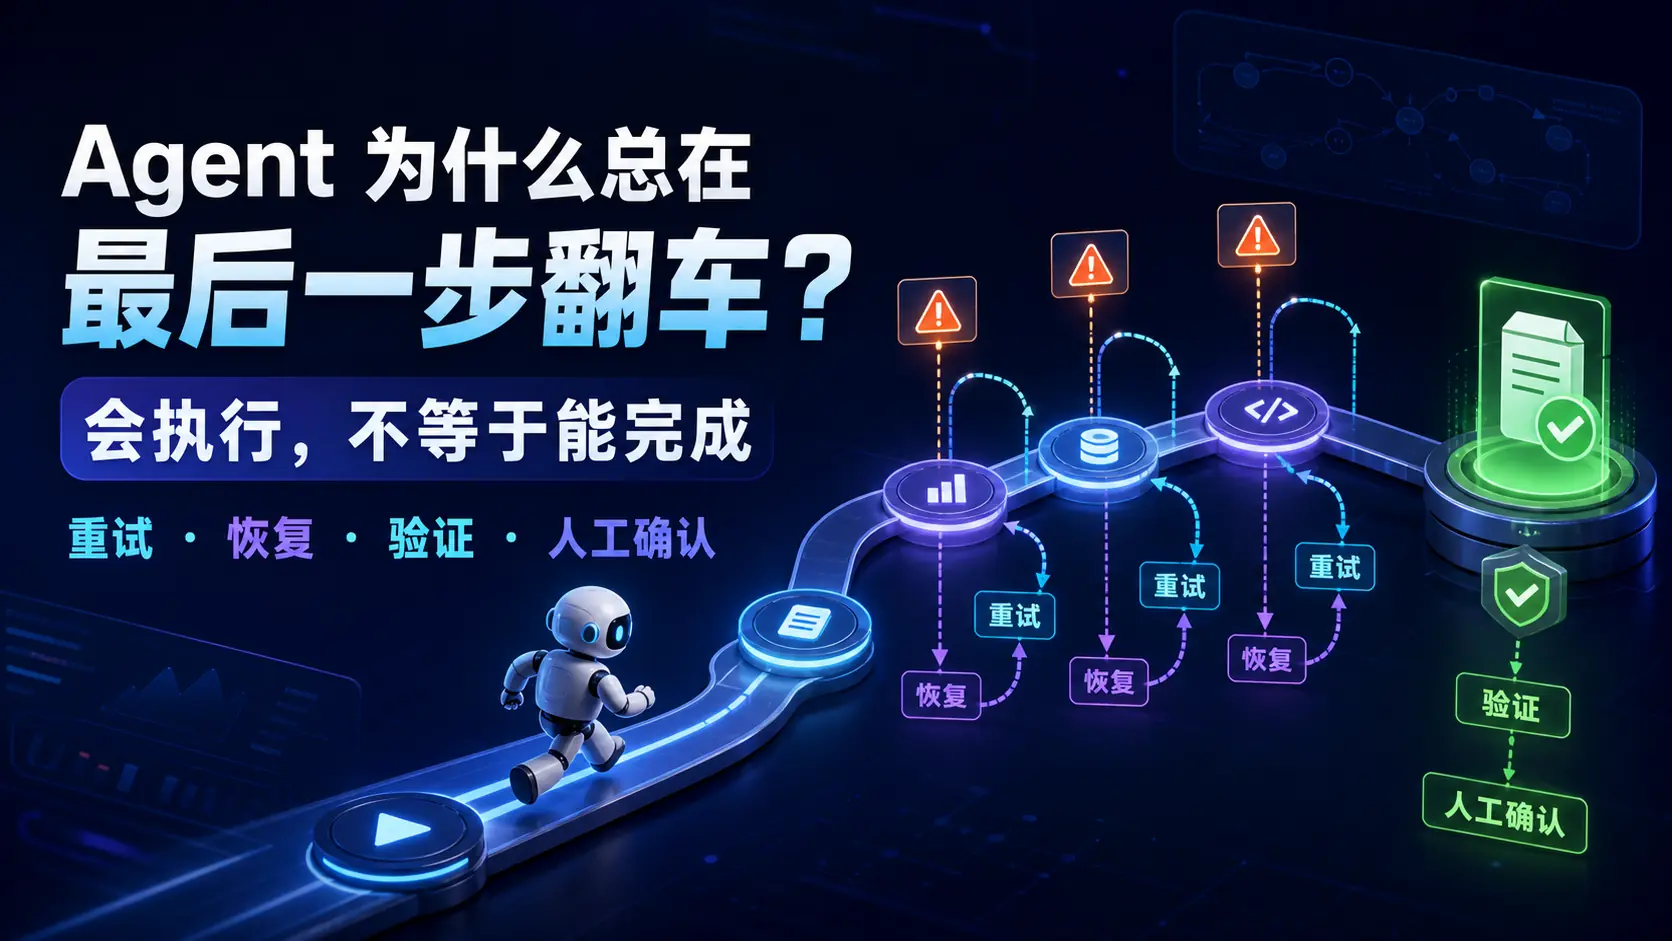
Agent 从 Demo 进入 Production 后,真正棘手的通常不是模型不会规划,而是 Runtime 无法回答三个问题:执行到哪了?失败后从哪继续?凭什么确认任务完成?
最常见的错误建模是:
ts
const result = await tool.call(input)
if (result.success) task.status = 'completed'
这里把 tool success 直接等同于 goal completion。对于有真实副作用的任务,这个假设并不成立。浏览器点击成功、HTTP 200、消息进入队列,都不能保证最终业务状态符合预期。
一、把任务建模为持久化状态机
一个可恢复的 Agent Runtime,至少需要持久化以下实体:
ts
type TaskState = {
  taskId: string
  goal: string
  status: 'running' | 'waiting_approval' | 'failed' | 'completed'
  currentStep: string
  completedSteps: string[]
  attempts: Record<string, number>
  artifacts: Record<string, string>
  lastObservation?: unknown
  lastError?: ClassifiedError
}
模型负责提出下一步,Runtime 负责保证状态转换合法。这样即使模型上下文丢失、进程重启或任务迁移到另一个 Worker,也不会失去真实执行进度。
二、Checkpoint 不是简单保存上下文
Checkpoint 应该保存"可恢复的业务事实",例如远端 draftId、上传后的 assetId、最后一次验证证据和待确认动作。
恢复流程应该遵循 read-before-write:先查询远端状态,再决定是否重放。否则一次网络超时就可能制造重复发布。
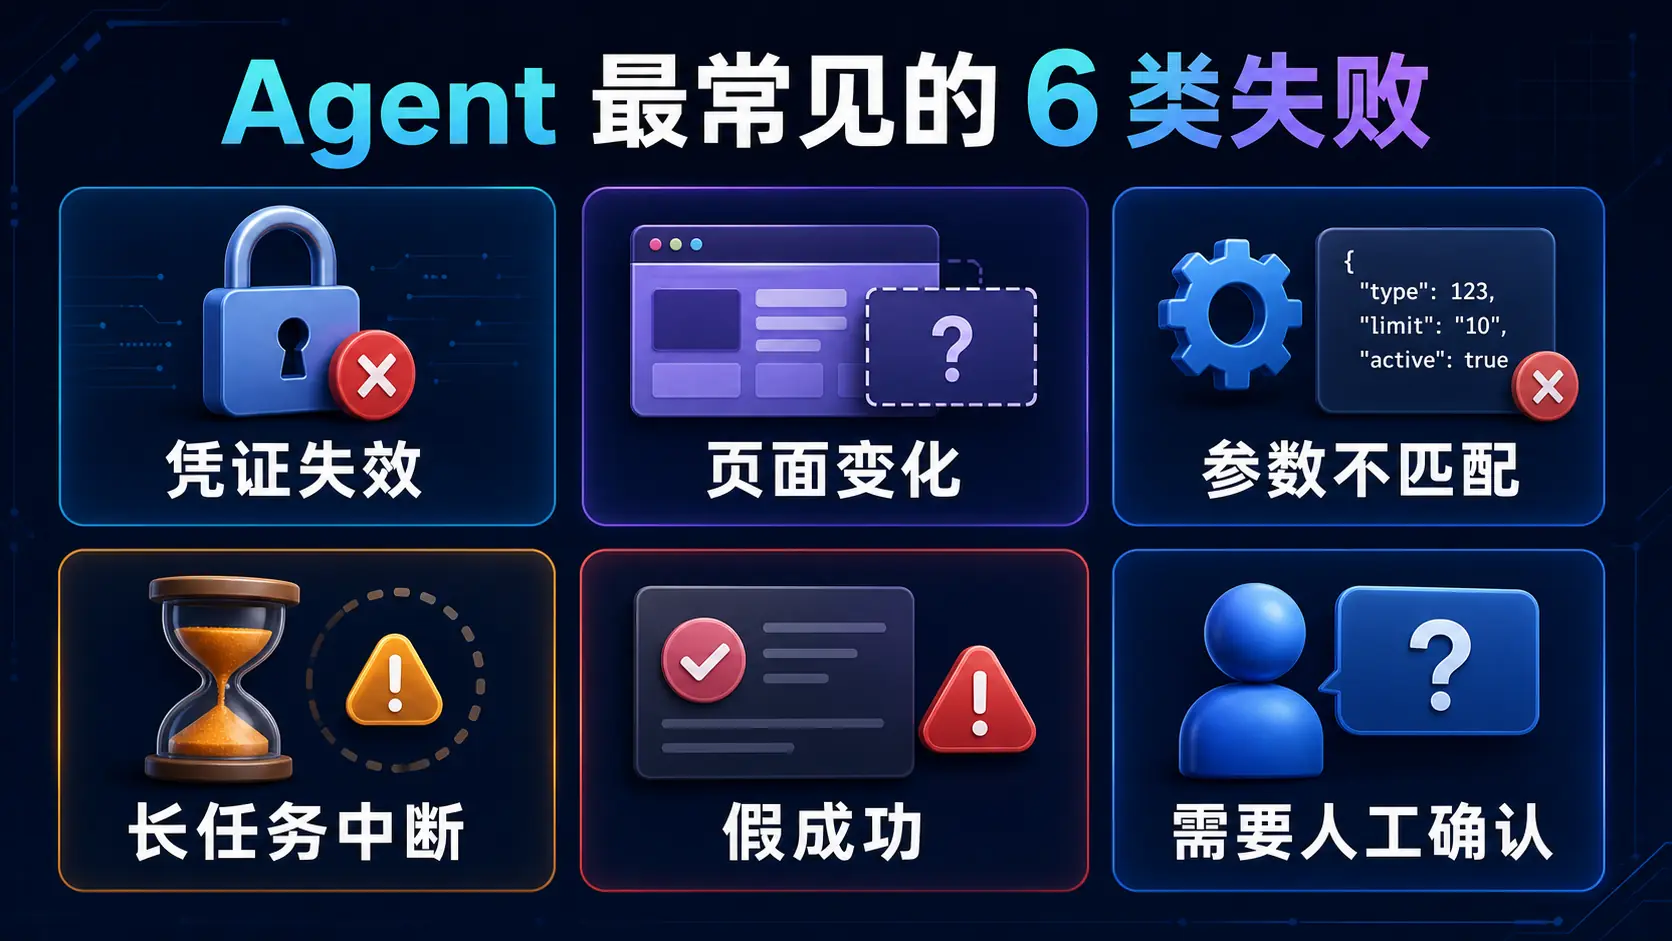
三、重试需要错误分类器
ts
switch (error.kind) {
  case 'transient':
    return retryWithBackoff()
  case 'auth':
    return refreshCredential()
  case 'invalid_input':
    return reviseArguments()
  case 'environment_changed':
    return observeAndReplan()
  case 'uncertain_outcome':
    return queryRemoteState()
  case 'high_risk':
    return requestHumanApproval()
}
需要特别警惕 uncertain_outcome:请求超时不代表请求失败。如果直接重试,可能产生二次副作用。正确顺序是先查,再决定是否补偿或继续。
四、用幂等保护真实副作用
除了 API 级 idempotency key,还应建立任务级唯一标识和资源映射:
text
task_id -> step_id -> external_resource_id -> verified_state每个产生副作用的步骤都先执行 precondition check,完成后写入 external_resource_id,再由 Verifier 查询真实状态。重启后如果资源已经存在且一致,直接跳过执行阶段。
五、Planner、Executor、Verifier 分离
Planner 的输出是"怎么做",Executor 的输出是"调用发生了什么",Verifier 的输出才是"目标是否满足"。
Verifier 可以分三层:
- 结构化验证:状态码、字段、数量、唯一 ID;
- 业务验证:草稿是否存在、发布时间是否正确、权限是否符合预期;
- 语义与视觉验证:正文是否完整、图片是否错位、输出是否符合用户要求。
能用确定性规则解决的,不要全部交给 LLM。LLM-as-a-judge 更适合承担语义判断,而不是替代所有硬约束。
六、Human-in-the-loop 要成为一等状态
等待人工确认不是异常,而是正常状态:
text
running -> waiting_approval -> approved -> executing
                            -> rejected -> repairing / cancelled
确认界面应该展示 diff、目标资源、关键参数和副作用。用户拒绝后,系统还要能带着反馈回到修复路径。
七、完整闭环
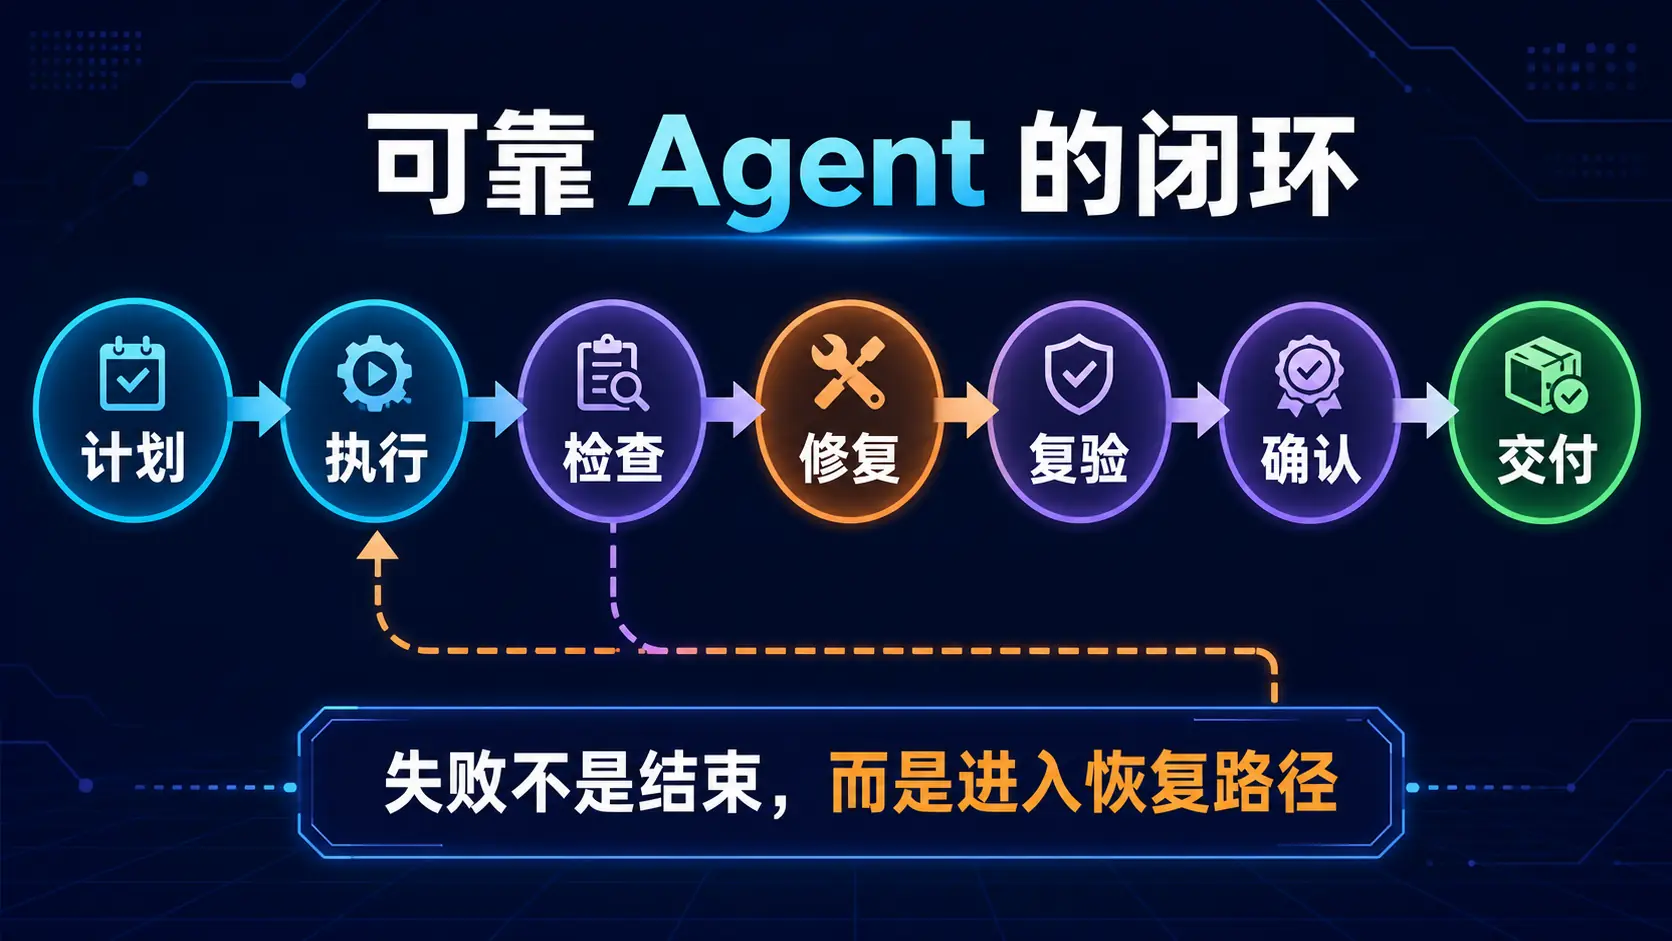
生产级链路可以概括为:
text
Plan -> Execute -> Observe -> Verify
                    |          |
                    |          +-> pass -> Approve -> Deliver
                    +-> fail -> Classify -> Repair -> Re-verify
对应的可观测性至少包括 taskId、stepId、模型决策摘要、工具调用耗时、错误类别、重试次数、远端资源 ID、验证结果和人工决策。
2026 年 Agent 基础设施的演进方向已经很清楚:后台长任务、自动刷新凭证、审批节点、遥测、远程 MCP 和多工作区协作逐渐成为默认能力。模型决定上限,Runtime 决定它能否稳定落地。
Agent 可靠性不是多写一句"请仔细检查"的 Prompt,而是系统设计问题。把失败当作正常分支,把验证当作完成条件,把人工确认当作权限边界,才有机会从一次性 Demo 走到真正可托付的生产系统。
参考: