🔥 本文专栏:机器学习
🌸作者主页:努力努力再努力wz


💪 今日博客励志语录:
所谓前途,并不是远处有一条已经铺好的路,而是你每解决一个眼前的问题,脚下就多出一块路。
思维导图
text
机器学习:从有限样本中学习规律,并预测未知数据
    │
    ├── 为什么需要概率论?
    │     ├── 训练样本是有限的,未知数据是不确定的
    │     └── 希望描述随机性、泛化能力与预测不确定性
    │
    ▼
随机试验:一次试验的结果事先无法确定
    │
    ├── 样本空间 Ω:所有可能的基本结果
    │     └── 样本点 ω:其中一个具体结果
    │
    └── 随机事件 A:样本空间的一个子集
          │
          ├── 频率:重复试验中实际发生的比例
          ├── 概率:事件发生可能性的数学描述
          ├── 互斥 → 概率相加
          └── 独立 → 交集概率相乘
                    │
                    ▼
               条件概率
                    │
          已知 B 发生,计算 A 的概率
                    │
             P(A|B) = P(A∩B)/P(B)
                    │
             ┌──────┴──────┐
             ▼             ▼
         一般乘法公式    全概率公式
             │             │
             └──────┬──────┘
                    ▼
                贝叶斯公式
                    │
           先验概率 → 新证据 → 后验概率
                    │
                    ▼
随机变量 X:将样本点映射到实数
                    │
                    ▼
概率分布:X 的取值按照什么概率规律出现?
    │
    ├── 离散型:PMF,逐个数值的概率
    │
    ├── 连续型:PDF,曲线下区间面积是概率
    │
    └── 统一描述:CDF,累计到 x 的概率
                    │
                    ▼
概率分布的数字特征
    │
    ├── 数学期望:平均处于什么水平
    ├── 方差:围绕期望有多分散
    └── 标准差:与原变量同单位的离散程度
                    │
                    ▼
常见概率模型
    │
    ├── 伯努利分布:一次试验是否成功
    ├── 二项分布:n 次独立试验成功几次
    └── 正态分布:对称钟形的连续概率密度
                    │
                    ▼
返回机器学习:概率分类、数据建模、损失与参数估计
引入:机器学习为什么需要概率论?
在正式学习概率论之前,我们得先回答一个问题:既然机器学习已经可以通过损失函数和梯度下降训练模型,为什么还需要概率论?
我们之前对机器学习已经有了一个基本认识:对于某些无法人工准确描述规则的问题,可以根据已有样本选择一种模型形式,再通过训练调整模型参数。
例如:
y ^ = f θ ( x ) \hat y=f_\theta(x) y^=fθ(x)
这里的 x x x 表示输入, y ^ \hat y y^ 表示模型预测输出, θ \theta θ 表示需要学习的参数。
典型训练过程可以理解为:
text
收集训练样本 (x₁,y₁), (x₂,y₂), ..., (xₙ,yₙ)
                   ↓
             选择模型 fθ(x)
                   ↓
            使用当前参数预测
                   ↓
          损失函数衡量预测误差
                   ↓
         根据梯度等信息更新参数
                   ↓
           重复优化,得到模型
                   ↓
             预测新的输入
但是这里存在两个重要问题。
第一个问题:有限样本能否代表未知数据?
假设模型训练时见过 1000 封邮件,在这些邮件上的分类准确率很高。但是,未来可能遇到的邮件远不止这 1000 封。训练数据上的效果,并不必然等于未知数据上的效果。这就是模型的泛化问题。
第二个问题:模型输出为什么会存在不确定性?
假设一个概率分类模型认为某封邮件属于垃圾邮件的概率为 80%。那么,这个 80% 在数学上究竟表示什么?又应该如何判断模型的概率预测是否可靠?
因此,概率论与机器学习的联系并不仅发生在预测阶段。在训练阶段,我们也经常需要研究样本从什么分布产生、随机误差如何描述、如何根据数据估计未知参数。
这里需要先建立一个认知:
机器学习希望从有限数据中学习可以推广的规律,而概率论为描述数据的随机性、事件发生的可能性以及预测不确定性提供了数学工具。
注意,并不是每个机器学习模型都会直接输出概率,也不是每个模型都必须以概率形式训练。但是概率论和统计学是理解很多机器学习方法的重要基础。
一、从抛硬币开始:随机试验、样本空间与随机事件
1. 我们为什么会需要概率?
假设现在抛一枚硬币。在抛出去之前,我们无法预先确定它是正面还是反面。
但是,在理想化的硬币模型下,我们能够事先描述所有可能的结果:
text
                  抛一次硬币
                      │
              ┌───────┴───────┐
              ↓               ↓
            正面              反面
这说明两件事情:
- 试验有事先可以描述的可能结果。
- 一次试验究竟出现哪个结果,事先无法确定。
我们把这样的试验称为随机试验。
随机试验并不要求必须实际重复很多次;抛一次硬币本身就是一次随机试验。大量重复试验是后面估计未知概率时可能采用的方法。
2. 样本空间与样本点
一次抛硬币的全部可能结果组成集合:
Ω = { 正 , 反 } \Omega=\{\text{正},\text{反}\} Ω={正,反}
这个集合就叫作样本空间(Sample Space)。
其中每个基本结果都叫作样本点(Sample Point) ,通常记作 ω \omega ω。
如果我们连续抛两次硬币,并且记录两次结果的顺序,那么:
Ω = { ( 正 , 正 ) , ( 正 , 反 ) , ( 反 , 正 ) , ( 反 , 反 ) } \Omega=\{(正,正),(正,反),(反,正),(反,反)\} Ω={(正,正),(正,反),(反,正),(反,反)}
注意,这里的"样本空间确定"不是说本次试验的结果已经确定,而是说:试验开始前,我们能够明确描述可能出现哪些结果,但不知道实际会出现哪个。
另外,样本空间不要求一定有限。只不过抛硬币的样本空间比较容易列举出来。
3. 随机事件:对样本空间进行筛选
现在我们提出一个问题:连续抛两次硬币,至少出现一次正面的概率是多少?
首先,我们并不是研究所有样本点,而是从中筛选符合条件的部分:
A = { ( 正 , 正 ) , ( 正 , 反 ) , ( 反 , 正 ) } A=\{(正,正),(正,反),(反,正)\} A={(正,正),(正,反),(反,正)}
这个 A A A 就是一个随机事件(Event)。
所以,在我们目前讨论的有限样本空间中,可以建立这样的认知:
随机事件就是样本空间的一个子集。实际试验得到的样本点属于这个子集,就表示事件发生。
概率论研究的一个核心问题,正是如何计算事件 A A A 发生的概率 P ( A ) P(A) P(A)。
二、概率与频率:为什么抛 100 次硬币还不能得到绝对准确的概率?
1. 频率不等于理论概率
假设我们不知道某枚硬币正面朝上的真实概率,于是把它抛了 100 次,发现正面出现了 53 次。
那么正面的频率为:
频率 = 正面出现次数 试验总次数 = 53 100 = 0.53 \text{频率}=\frac{\text{正面出现次数}}{\text{试验总次数}}=\frac{53}{100}=0.53 频率=试验总次数正面出现次数=10053=0.53
这里的 53% 是实际统计出的频率,可以用来估计正面出现的概率,却不能直接断定硬币真实的正面概率必然是 53%。
如果重新做 100 次实验,结果可能是 48%、51% 或其他数值。
2. 为什么强调大量重复试验?
假设重复抛掷相互独立,而且每次都遵循相同的概率规律。随着试验次数增加,事件发生的频率通常会更加稳定,并趋近于真实概率。
这背后涉及大数定律。对我们目前的学习而言,只需要认识:
在独立、同分布等适当条件下,可以通过大量重复试验的频率估计一个未知概率;但并不保证频率每增加一次试验就一定更接近真实概率。
因此,进行重复试验估计概率时,通常需要特别关注:
- 概率规律相同:不能把正面概率不同的硬币混起来,却直接认为在估计其中一枚硬币的概率。
- 独立性:在经典的独立重复试验模型中,前一次结果不会改变后一次的概率。
- 样本量:样本过少可能带来较大的随机波动,但大样本不能自动修复系统性偏差。
这里经常提到的 i.i.d.(独立同分布),就是"各次试验相互独立,并且遵循相同概率分布"的意思。
3. 不要混淆两种计算思路
假设我们研究的是一枚理想公平硬币,那么可以在理论模型中直接给出:
P ( 正 ) = P ( 反 ) = 1 2 P(正)=P(反)=\frac12 P(正)=P(反)=21
这里的 1 2 \frac12 21 来自模型中的等可能性假设,并不是必须先抛 100 次才计算得出。
因此,我们要区分:
text
方式一:模型已知
已知基本结果等可能 / 已知各结果概率
              ↓
         理论计算事件概率

方式二:概率未知
实际重复试验并记录结果
              ↓
         通过频率估计概率
前者属于依据概率模型进行计算;后者已经涉及统计估计的思想。
三、从样本点到概率加法、乘法:什么时候能直接算数量?
1. 所有样本点等可能:可以计算数量占比
继续考虑连续抛两次理想公平硬币:
Ω = { ( 正 , 正 ) , ( 正 , 反 ) , ( 反 , 正 ) , ( 反 , 反 ) } \Omega=\{(正,正),(正,反),(反,正),(反,反)\} Ω={(正,正),(正,反),(反,正),(反,反)}
假设两次抛掷相互独立,则四个基本结果各有 1 4 \frac14 41 的概率。
对于事件:
A = { ( 正 , 正 ) , ( 正 , 反 ) , ( 反 , 正 ) } A=\{(正,正),(正,反),(反,正)\} A={(正,正),(正,反),(反,正)}
我们可以直接得到:
P ( A ) = ∣ A ∣ ∣ Ω ∣ = 3 4 P(A)=\frac{|A|}{|\Omega|}=\frac34 P(A)=∣Ω∣∣A∣=43
这里 ∣ A ∣ |A| ∣A∣ 表示事件 A A A 所包含的样本点数量, ∣ Ω ∣ |\Omega| ∣Ω∣ 表示整个样本空间的样本点数量。
但要注意,这个公式只适用于有限样本空间且各个样本点等可能的情况。
2. 样本点不等可能:需要计算各自的概率
现在把硬币改成:
P ( 正 ) = 0.6 , P ( 反 ) = 0.4 P(正)=0.6,\qquad P(反)=0.4 P(正)=0.6,P(反)=0.4
仍然独立地抛两次,那么四个样本点的概率变为:
| 样本点 | 计算过程 | 概率 |
|---|---|---|
| 正正 | 0.6 × 0.6 0.6\times0.6 0.6×0.6 | 0.36 |
| 正反 | 0.6 × 0.4 0.6\times0.4 0.6×0.4 | 0.24 |
| 反正 | 0.4 × 0.6 0.4\times0.6 0.4×0.6 | 0.24 |
| 反反 | 0.4 × 0.4 0.4\times0.4 0.4×0.4 | 0.16 |
对于至少出现一次正面的事件 A A A,此时:
P ( A ) = 0.36 + 0.24 + 0.24 = 0.84 P(A)=0.36+0.24+0.24=\boxed{0.84} P(A)=0.36+0.24+0.24=0.84
为什么这里会出现乘法与加法?
- 乘法:两次抛掷相互独立,所以可以把沿着某个结果路径的概率相乘。
- 加法:不同样本点彼此互斥,一次完整试验最终只能出现一个基本结果,因此可以把符合条件的样本点概率相加。
这里最重要的是理解条件,而不是记住"遇到多个事件就乘、遇到多个结果就加"这样的口令。
3. 独立和互斥并不是同一个概念
这里先区分两个词:
互斥 :事件 A A A 和 B B B 不可能同时发生。
A ∩ B = ∅ A\cap B=\varnothing A∩B=∅
独立 :知道 A A A 是否发生,不会改变 B B B 发生的概率。对于 P ( A ) > 0 P(A)>0 P(A)>0,可以写成:
P ( B ∣ A ) = P ( B ) P(B\mid A)=P(B) P(B∣A)=P(B)
它们的区别在于:
| 概念 | 关注的问题 |
|---|---|
| 互斥 | 两个事件能不能同时发生? |
| 独立 | 一个事件的发生会不会改变另一个事件的概率? |
例如第一次抛出正面与第二次抛出正面,在独立抛掷的假设下相互独立,却可以同时发生,因此并不互斥。
4. 不互斥时,为什么需要减去交集?
对于两个可能重叠的事件:
P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) P(A\cup B)=P(A)+P(B)-P(A\cap B) P(A∪B)=P(A)+P(B)−P(A∩B)
这里:
- A ∪ B A\cup B A∪B:A 或 B 至少一个发生,即并集。
- A ∩ B A\cap B A∩B:A 和 B 同时发生,即交集。
之所以减去交集,是因为直接把 P ( A ) P(A) P(A) 和 P ( B ) P(B) P(B) 相加,会把共同部分计算两遍。
如果两个事件互斥,则交集概率为 0,公式自然简化为:
P ( A ∪ B ) = P ( A ) + P ( B ) P(A\cup B)=P(A)+P(B) P(A∪B)=P(A)+P(B)
如果事件独立,则可以计算:
P ( A ∩ B ) = P ( A ) P ( B ) P(A\cap B)=P(A)P(B) P(A∩B)=P(A)P(B)
但仅仅知道两个事件存在交集,并不意味着交集概率可以直接相乘。一般的交集概率计算,需要用到接下来要学习的条件概率。
5. 顺便认识概率的几个基本性质
之前我们一直把样本空间理解为所有可能结果的集合,那么整个样本空间发生的概率自然是 1:
P ( Ω ) = 1 P(\Omega)=1 P(Ω)=1
不可能事件(空集)发生的概率为 0:
P ( ∅ ) = 0 P(\varnothing)=0 P(∅)=0
任意事件的概率都位于 0 到 1 之间:
0 ≤ P ( A ) ≤ 1 0\le P(A)\le1 0≤P(A)≤1
如果用 A c A^c Ac 表示事件 A 不发生,那么:
P ( A c ) = 1 − P ( A ) P(A^c)=1-P(A) P(Ac)=1−P(A)
例如连续抛两次硬币,"至少一次正面"的反面事件就是"两次全部反面"。在前面不公平硬币的例子中:
P ( A ) = 1 − P ( 反 , 反 ) = 1 − 0.16 = 0.84 P(A)=1-P(反,反)=1-0.16=0.84 P(A)=1−P(反,反)=1−0.16=0.84
有时候,直接计算事件的反面再用 1 减去,会比枚举所有符合条件的样本点更方便。
四、条件概率:得到新信息以后,研究范围发生了什么变化?
1. 条件概率的核心并不复杂
以前我们计算 P ( A ) P(A) P(A),研究范围是整个样本空间 Ω \Omega Ω。
现在,假设已经知道事件 B B B 发生了。那么那些不属于 B B B 的结果就可以排除,研究范围实际上已经缩小为 B B B。
如果此时希望知道 A A A 发生的概率,就应该寻找在 B B B 中同时属于 A A A 的部分:
A ∩ B A\cap B A∩B
于是:
P ( A ∣ B ) = P ( A ∩ B ) P ( B ) P ( B ) > 0 \boxed{P(A\mid B)=\frac{P(A\cap B)}{P(B)}}\qquad P(B)>0 P(A∣B)=P(B)P(A∩B)P(B)>0
这里 P ( A ∣ B ) P(A\mid B) P(A∣B) 的意思就是:已经知道 B 发生的情况下,A 发生的概率。
你可以把它理解为,原来我们使用整个矩形作为概率计算的参照,现在改为使用矩形中的 B B B 区域作为参照。
2. 继续使用不公平硬币验证
仍然独立抛两次,每次正面的概率为 60%。定义:
A = { ( 正 , 正 ) , ( 反 , 反 ) } (两次相同) A=\{(正,正),(反,反)\}\quad\text{(两次相同)} A={(正,正),(反,反)}(两次相同)
B = { ( 正 , 正 ) , ( 正 , 反 ) , ( 反 , 正 ) } (至少一次正面) B=\{(正,正),(正,反),(反,正)\}\quad\text{(至少一次正面)} B={(正,正),(正,反),(反,正)}(至少一次正面)
那么:
A ∩ B = { ( 正 , 正 ) } A\cap B=\{(正,正)\} A∩B={(正,正)}
因此:
P ( A ∩ B ) = 0.36 , P ( B ) = 0.84 P(A\cap B)=0.36,\qquad P(B)=0.84 P(A∩B)=0.36,P(B)=0.84
于是:
P ( A ∣ B ) = 0.36 0.84 ≈ 0.4286 P(A\mid B)=\frac{0.36}{0.84}\approx\boxed{0.4286} P(A∣B)=0.840.36≈0.4286
这里一定要区分:
- P ( A ∩ B ) = 0.36 P(A\cap B)=0.36 P(A∩B)=0.36:交集占整个样本空间的概率。
- P ( A ∣ B ) ≈ 0.4286 P(A\mid B)\approx0.4286 P(A∣B)≈0.4286:交集占已知事件 B 的概率。
3. 一般乘法公式,其实只是条件概率公式的变形
既然:
P ( A ∣ B ) = P ( A ∩ B ) P ( B ) P(A\mid B)=\frac{P(A\cap B)}{P(B)} P(A∣B)=P(B)P(A∩B)
那么,两边同时乘以 P ( B ) P(B) P(B):
P ( A ∩ B ) = P ( B ) P ( A ∣ B ) \boxed{P(A\cap B)=P(B)P(A\mid B)} P(A∩B)=P(B)P(A∣B)
这就是一般乘法公式。它不要求 A、B 相互独立。
如果 A、B 相互独立,那么 P ( A ∣ B ) = P ( A ) P(A\mid B)=P(A) P(A∣B)=P(A),自然得到:
P ( A ∩ B ) = P ( A ) P ( B ) P(A\cap B)=P(A)P(B) P(A∩B)=P(A)P(B)
所以,我们之前学习的独立事件乘法公式,其实是一般乘法公式的特殊情况。
五、全概率公式:将整个事件拆成几块,再分别计算
1. 为什么我们需要全概率公式?
假设整个样本空间 Ω \Omega Ω 是一个矩形,它被划分为三个场景:
R 1 , R 2 , R 3 R_1,R_2,R_3 R1,R2,R3
要求:
R i ∩ R j = ∅ ( i ≠ j ) , R 1 ∪ R 2 ∪ R 3 = Ω R_i\cap R_j=\varnothing\quad(i\ne j),\qquad R_1\cup R_2\cup R_3=\Omega Ri∩Rj=∅(i=j),R1∪R2∪R3=Ω
也就是说:三个场景两两互斥,且合在一起覆盖整个样本空间。
现在,存在一个随机事件 A,它与三个场景都可能产生交集。
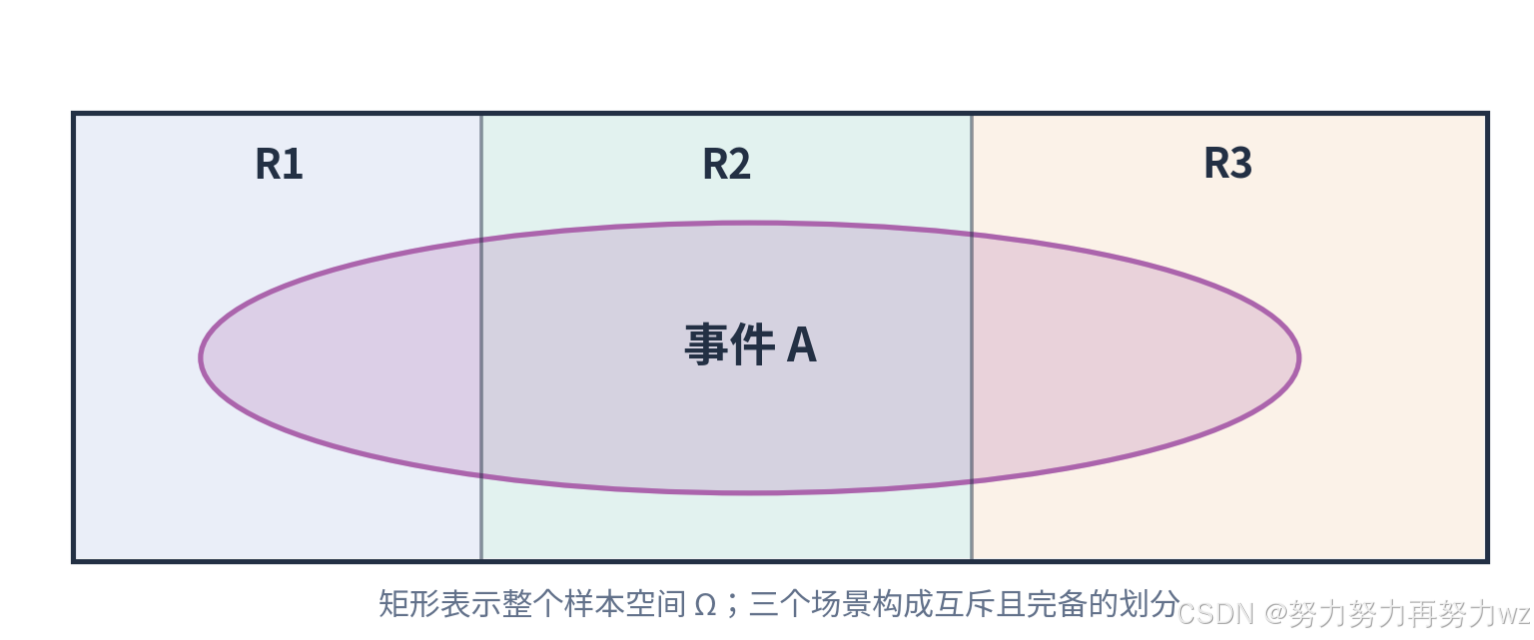
那么,我们希望计算整个事件 A 的概率,就可以先拆开:
A = ( A ∩ R 1 ) ∪ ( A ∩ R 2 ) ∪ ( A ∩ R 3 ) A=(A\cap R_1)\cup(A\cap R_2)\cup(A\cap R_3) A=(A∩R1)∪(A∩R2)∪(A∩R3)
由于这些交集互斥,因此:
P ( A ) = P ( A ∩ R 1 ) + P ( A ∩ R 2 ) + P ( A ∩ R 3 ) P(A)=P(A\cap R_1)+P(A\cap R_2)+P(A\cap R_3) P(A)=P(A∩R1)+P(A∩R2)+P(A∩R3)
2. 每一块交集如何计算?
我们之前已经学习了条件概率的一般乘法公式:
P ( A ∩ R i ) = P ( R i ) P ( A ∣ R i ) P(A\cap R_i)=P(R_i)P(A\mid R_i) P(A∩Ri)=P(Ri)P(A∣Ri)
它非常适合用几何思想来理解:
text
场景 Ri 占整个样本空间的概率
                  ×
事件 A 在场景 Ri 内部发生的条件概率
                  ↓
A∩Ri 占整个样本空间的概率
最后把每块交集对应的概率相加:
P ( A ) = ∑ i = 1 3 P ( R i ) P ( A ∣ R i ) \boxed{P(A)=\sum_{i=1}^{3}P(R_i)P(A\mid R_i)} P(A)=i=1∑3P(Ri)P(A∣Ri)
这就是三个场景下的全概率公式。
3. 一个具体的数值例子
假设我们已知:
| 场景 | 场景发生的概率 | 场景内部 A 发生的条件概率 | 交集对总概率的贡献 |
|---|---|---|---|
| R 1 R_1 R1 | 20% | 80% | 0.2 × 0.8 = 0.16 0.2\times0.8=0.16 0.2×0.8=0.16 |
| R 2 R_2 R2 | 30% | 50% | 0.3 × 0.5 = 0.15 0.3\times0.5=0.15 0.3×0.5=0.15 |
| R 3 R_3 R3 | 50% | 10% | 0.5 × 0.1 = 0.05 0.5\times0.1=0.05 0.5×0.1=0.05 |
因此:
P ( A ) = 0.16 + 0.15 + 0.05 = 0.36 P(A)=0.16+0.15+0.05=\boxed{0.36} P(A)=0.16+0.15+0.05=0.36
到这里,我们可以建立一个非常直观的认知:
全概率公式的本质,就是把事件按互斥且完备的场景拆分,在每个场景中用条件概率求出交集,再将所有交集的概率相加。
它没有引入新的概率运算规则,只是把"条件概率乘法"和"互斥事件概率加法"组合起来。
六、贝叶斯公式:既然已经知道 A 发生,反过来判断它来自哪个场景
1. 从全概率的问题反过来思考
全概率公式计算的是:
已经知道每个场景发生的概率,以及 A 在每个场景中发生的概率,求 A 在整个样本空间中发生的概率。
现在我们反过来:
如果已经知道 A 发生了,那么这次试验来自场景 R 1 R_1 R1 的概率是多少?
其实,我们之前学习的条件概率就能够回答:
P ( R 1 ∣ A ) = P ( R 1 ∩ A ) P ( A ) P(R_1\mid A)=\frac{P(R_1\cap A)}{P(A)} P(R1∣A)=P(A)P(R1∩A)
它的几何意义就是:交集 R 1 ∩ A R_1\cap A R1∩A 占整个事件 A 的概率比例。
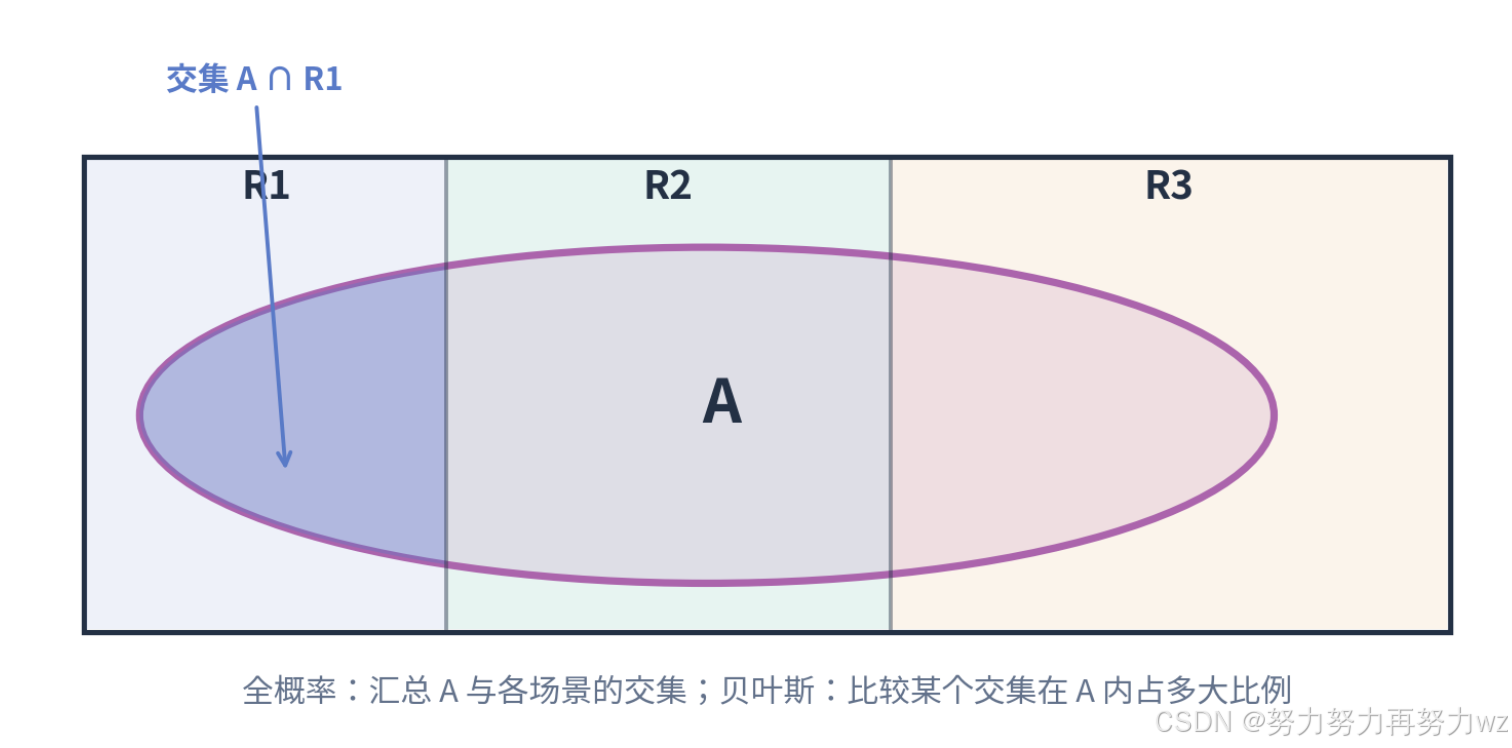
这里尤其需要注意参照范围的区别:
text
P(R₁∩A):交集占整个样本空间 Ω 的概率
P(A):事件 A 占整个样本空间 Ω 的概率

          P(R₁∩A)
P(R₁|A) = ─────────
            P(A)

得到:交集占 A 本身的概率
2. 贝叶斯公式是如何推导出来的?
由于:
P ( R 1 ∩ A ) = P ( R 1 ) P ( A ∣ R 1 ) P(R_1\cap A)=P(R_1)P(A\mid R_1) P(R1∩A)=P(R1)P(A∣R1)
所以:
P ( R 1 ∣ A ) = P ( A ∣ R 1 ) P ( R 1 ) P ( A ) \boxed{P(R_1\mid A)=\frac{P(A\mid R_1)P(R_1)}{P(A)}} P(R1∣A)=P(A)P(A∣R1)P(R1)
如果分母 P ( A ) P(A) P(A) 还不知道,就再用前面的全概率公式展开:
P ( R 1 ∣ A ) = P ( A ∣ R 1 ) P ( R 1 ) ∑ i = 1 3 P ( R i ) P ( A ∣ R i ) \boxed{P(R_1\mid A)=\frac{P(A\mid R_1)P(R_1)}{\displaystyle\sum_{i=1}^{3}P(R_i)P(A\mid R_i)}} P(R1∣A)=i=1∑3P(Ri)P(A∣Ri)P(A∣R1)P(R1)
这里没有什么神秘的新运算:分子是一个交集概率,分母是 A 的总概率,然后相除。
3. 先验概率、似然、后验概率是什么?
我们继续使用刚才的三个场景:
P ( R 1 ) = 0.2 , P ( R 2 ) = 0.3 , P ( R 3 ) = 0.5 P(R_1)=0.2,\quad P(R_2)=0.3,\quad P(R_3)=0.5 P(R1)=0.2,P(R2)=0.3,P(R3)=0.5
在观察到新证据 A 之前,这些场景对应的概率可以称为先验概率(Prior)。
现在观察到 A 已经发生。结合前面计算出的 P ( A ) = 0.36 P(A)=0.36 P(A)=0.36,可以求出:
P ( R 1 ∣ A ) = 0.16 0.36 ≈ 0.4444 P(R_1\mid A)=\frac{0.16}{0.36}\approx0.4444 P(R1∣A)=0.360.16≈0.4444
P ( R 2 ∣ A ) = 0.15 0.36 ≈ 0.4167 P(R_2\mid A)=\frac{0.15}{0.36}\approx0.4167 P(R2∣A)=0.360.15≈0.4167
P ( R 3 ∣ A ) = 0.05 0.36 ≈ 0.1389 P(R_3\mid A)=\frac{0.05}{0.36}\approx0.1389 P(R3∣A)=0.360.05≈0.1389
这些已经考虑证据 A 的新概率,称为后验概率(Posterior)。
| 场景 | 观察 A 之前(先验) | 观察 A 之后(后验) |
|---|---|---|
| R 1 R_1 R1 | 20% | 约 44.44% |
| R 2 R_2 R2 | 30% | 约 41.67% |
| R 3 R_3 R3 | 50% | 约 13.89% |
你可以建立这样的认知:
先验和后验描述的不是两个不同事件,而是同一个假设在获得新证据前后对应的概率。
注意,先验并不一定是主观猜测,也可以来自历史统计或已有模型;后验也不是"获得了绝对正确的真相",它仍然依赖模型和证据的可靠性。
七、从随机事件到随机变量:为什么要给样本点定义一个数值映射?
1. 仅仅研究事件还不够
到目前为止,我们主要在计算随机事件的概率。
但是,如果我们希望进一步研究:
连续抛两次硬币,平均出现多少次正面?
那么,原来的"正正""正反"等文字结果,并没有直接表达我们关心的正面次数。
因此,我们可以人为定义一个函数:
X ( ω ) = 样本点 ω 中正面的次数 X(\omega)=\text{样本点 }\omega\text{ 中正面的次数} X(ω)=样本点 ω 中正面的次数
映射关系如下:
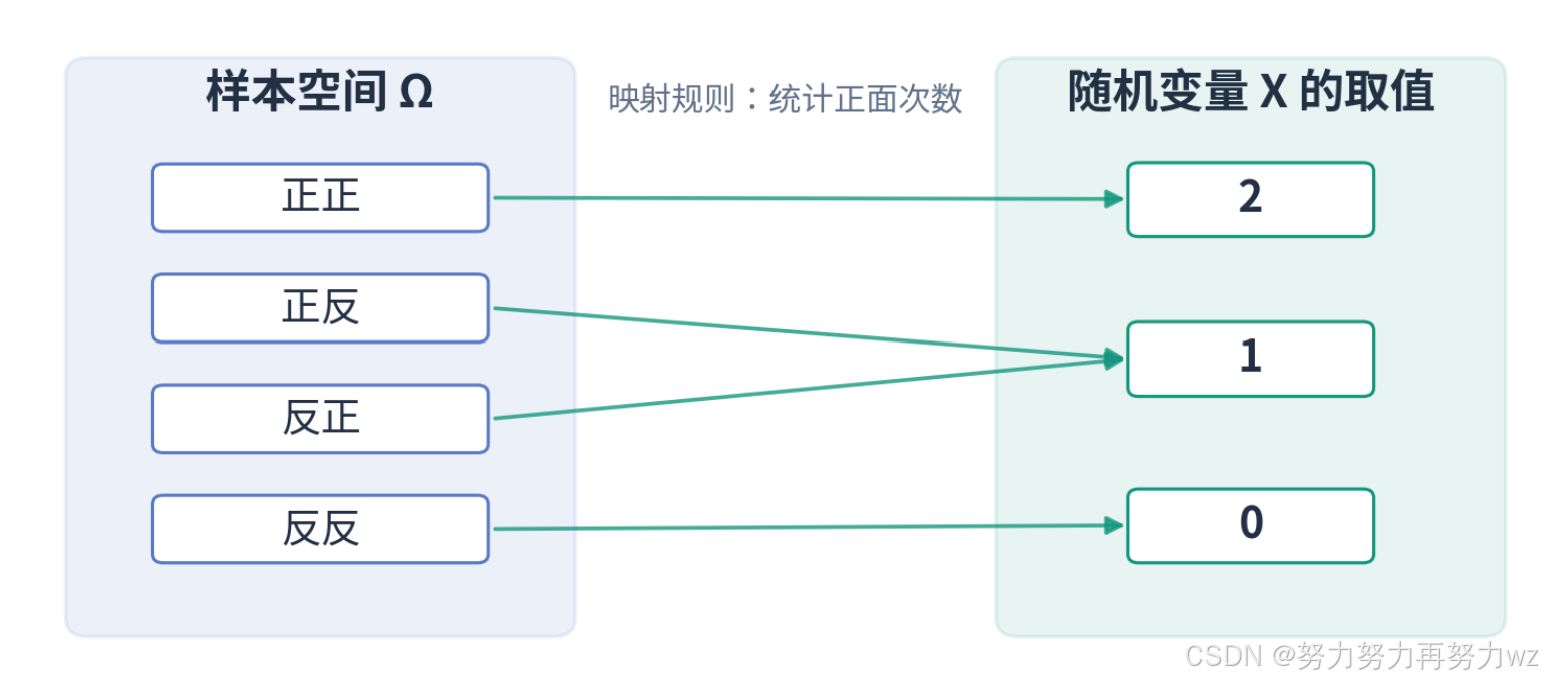
对应的表格为:
| 样本点 ω \omega ω | X ( ω ) X(\omega) X(ω) |
|---|---|
| 正正 | 2 |
| 正反 | 1 |
| 反正 | 1 |
| 反反 | 0 |
因此,随机变量的数学表达形式是:
X : Ω → R \boxed{X:\Omega\to\mathbb R} X:Ω→R
随机变量本质上是一个从样本空间到实数的函数。
它并不是"映射以后得到的某个数值"------函数 X X X 是随机变量, X ( ω ) X(\omega) X(ω) 才是在样本点 ω \omega ω 下得到的函数值。
2. 为什么它带有"随机"两个字?
这里有一个特别容易混淆的地方:
并不是因为我们不知道样本空间里面有哪些样本点,而是因为我们不知道一次随机试验最终会出现哪个样本点。
样本空间与映射规则都可以预先确定。
text
试验开始之前
    │
    ├── 已知:Ω 中有哪些可能结果
    ├── 已知:映射规则 X(ω)
    └── 未知:这次究竟出现哪个 ω
                   │
                   ▼
            因此 X 的实际取值未知
例如, X ( 正 , 反 ) = 1 X(正,反)=1 X(正,反)=1 是确定的;但抛硬币之前不知道最终会不会出现"正反"。
这就是随机变量的随机性来源。
3. 随机变量取到某个数值,本身仍然对应随机事件
比如:
{ X = 1 } = { ( 正 , 反 ) , ( 反 , 正 ) } \{X=1\}=\{(正,反),(反,正)\} {X=1}={(正,反),(反,正)}
所以:
P ( X = 1 ) = P ( 正 , 反 ) + P ( 反 , 正 ) = 0.24 + 0.24 = 0.48 P(X=1)=P(正,反)+P(反,正)=0.24+0.24=0.48 P(X=1)=P(正,反)+P(反,正)=0.24+0.24=0.48
你看,引入随机变量没有改变之前的概率计算规则,它只是让我们能够用数值来描述随机试验中感兴趣的特征。
八、概率分布:随机变量的不同取值,概率是如何分配的?
1. 从一个随机变量的取值出发
继续考虑:
X = 连续两次抛硬币出现正面的次数 X=\text{连续两次抛硬币出现正面的次数} X=连续两次抛硬币出现正面的次数
它只能取 0、1、2。根据之前的计算:
| X X X 的取值 | 对应样本点 | 概率 |
|---|---|---|
| 0 | 反反 | 0.16 |
| 1 | 正反、反正 | 0.48 |
| 2 | 正正 | 0.36 |
那么,这张表不只是几个概率,而是完整地描述了 X 的取值按照什么规律分配概率。
这就叫作概率分布(Probability Distribution)。
概率分布可以用表格、数学函数或图像表示;概率分布本身并不等于图像。
2. 离散型随机变量与 PMF
离散型随机变量的取值可以是有限个,也可以是可数无穷多个。
例如抛硬币出现正面的次数,可以取 0、1、2;而"直到第一次出现正面一共抛了几次",可以取 1、2、3、......,虽然无限,却仍然是离散型。
对于离散型随机变量,可以定义概率质量函数(PMF):
p X ( x ) = P ( X = x ) \boxed{p_X(x)=P(X=x)} pX(x)=P(X=x)
它表示输入某个数值 x x x,得到随机变量 X 恰好取这个值的概率。
例如:
p X ( x ) = { 0.16 , x = 0 0.48 , x = 1 0.36 , x = 2 0 , 其他 p_X(x)=\begin{cases} 0.16,&x=0\\ 0.48,&x=1\\ 0.36,&x=2\\ 0,&\text{其他} \end{cases} pX(x)=⎩ ⎨ ⎧0.16,0.48,0.36,0,x=0x=1x=2其他
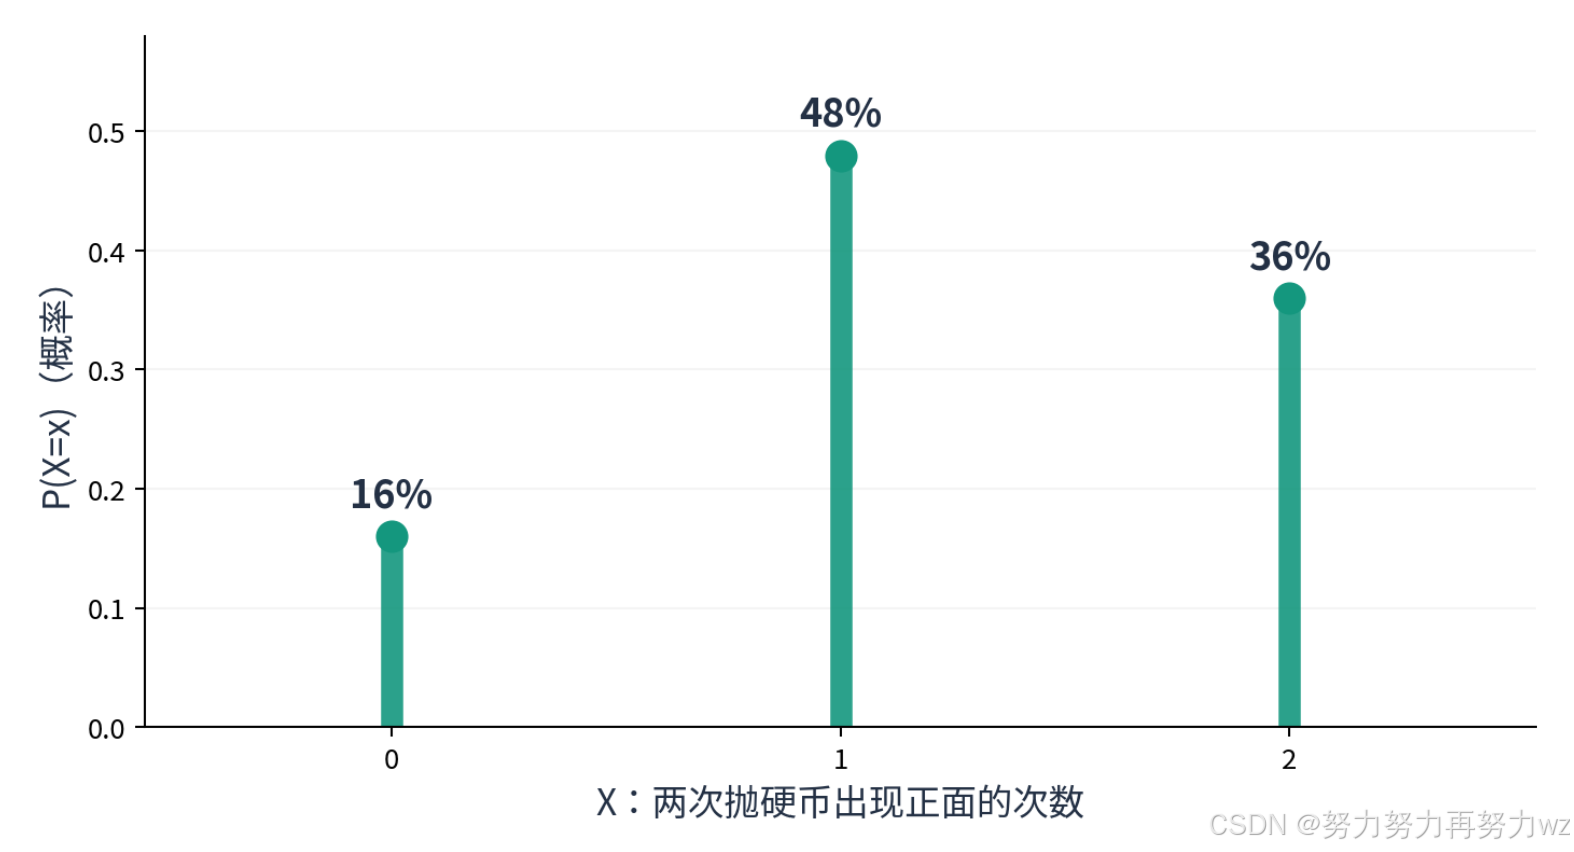
这里:横坐标是随机变量的可能取值,纵坐标就是该数值对应的概率。
因此,离散型随机变量满足:
∑ x p X ( x ) = 1 \sum_x p_X(x)=1 x∑pX(x)=1
3 进一步理解:概率密度函数与累积分布函数的区别
认识了概率密度函数(PDF)以及累积分布函数(CDF)之后,这里我们还需要明确一个非常关键的问题:计算某个区间的概率,与计算累积分布函数,究竟有什么区别?
首先,我们已经知道,对于连续型随机变量,概率密度函数描述的是概率在不同位置附近的分布密集程度,而我们可以通过定积分,计算概率密度曲线在某个区间内所围成的面积,从而得到该区间对应的概率。
例如,假设服务器响应时间 (T) 在 0~10 秒之间服从均匀分布,其概率密度函数为:
f T ( t ) = { 0.1 , 0 ≤ t ≤ 10 0 , 其他 f_T(t)= \begin{cases} 0.1,&0\le t\le10\\ 0,&\text{其他} \end{cases} fT(t)={0.1,0,0≤t≤10其他
那么,如果我们希望计算响应时间落在 3~5 秒之间的概率,只需要对这个区间进行积分:
P ( 3 ≤ T ≤ 5 ) = ∫ 3 5 0.1 d t = 0.2 P(3\le T\le5)=\int_3^5 0.1\,dt=0.2 P(3≤T≤5)=∫350.1dt=0.2
这里计算的是概率密度曲线在 3~5 秒之间的面积,因此得到的概率为 20%。
但是,对于累积分布函数,情况就有所不同了。
我们知道,累积分布函数的定义为:
F T ( t ) = P ( T ≤ t ) \boxed{F_T(t)=P(T\le t)} FT(t)=P(T≤t)
注意,这里的关键就在于
T ≤ t T\le t\ T≤t
累积分布函数并不是只计算当前 (t) 所在区间的面积,而是计算随机变量从所有可能取值的最左侧,一直累积到当前 (t) 为止的全部概率。
因此,对于具有概率密度函数的连续型随机变量:
F T ( t ) = ∫ − ∞ t f T ( x ) d x \boxed{F_T(t)=\int_{-\infty}^{t}f_T(x)\,dx} FT(t)=∫−∞tfT(x)dx
这里的积分下限始终是负无穷,而积分上限则是当前的 (t)。
例如,当 (t=5) 时:
F T ( 5 ) = P ( T ≤ 5 ) = ∫ 0 5 0.1 d x = 0.5 F_T(5)=P(T\le5)=\int_0^5 0.1\,dx=0.5 FT(5)=P(T≤5)=∫050.1dx=0.5
也就是说,响应时间不超过 5 秒的概率为 50%。
那么,这里我们再来思考一个问题:假设 (t>10),此时累积分布函数是否应该等于 0?
答案是否定的。
因为对于概率密度函数来说,当 (t>10) 时,确实有:
f T ( t ) = 0 f_T(t)=0 fT(t)=0
但是,对于累积分布函数来说,我们计算的是此前已经累计的全部概率。
例如,当 (t=12) 时:
F T ( 12 ) = P ( T ≤ 12 ) = ∫ − ∞ 12 f T ( x ) d x = ∫ 0 10 0.1 d x + ∫ 10 12 0 d x = 1 \begin{aligned} F_T(12) &=P(T\le12)\\ &=\int_{-\infty}^{12}f_T(x)\,dx\\ &=\int_0^{10}0.1\,dx+\int_{10}^{12}0\,dx\\ &=1 \end{aligned} FT(12)=P(T≤12)=∫−∞12fT(x)dx=∫0100.1dx+∫10120dx=1
这里我们就会发现,虽然 10~12 秒之间的概率密度为 0,但是此前 0~10 秒所累计的概率并不会消失。
因此,最终得到的累积分布函数为:
F T ( t ) = { 0 , t < 0 0.1 t , 0 ≤ t ≤ 10 1 , t > 10 F_T(t)= \begin{cases} 0,&t<0\\ 0.1t,&0\le t\le10\\ 1,&t>10 \end{cases} FT(t)=⎩ ⎨ ⎧0,0.1t,1,t<00≤t≤10t>10
所以,到这里,我们可以建立一个更加清晰的认知:
- 概率密度函数(PDF):描述随机变量在各个位置附近的概率密度,计算某个区间的概率时,需要对对应区间进行积分。
- 累积分布函数(CDF):描述随机变量小于或等于某个数值的累计概率,本质上就是从负无穷一直积分到当前数值所得到的结果。
也就是说,PDF 关注概率如何分布,而 CDF 关注概率已经累计了多少。
正是由于累计概率不会因为自变量继续增大而消失,因此累积分布函数只可能保持不变或者增大,而不会下降。
此外,如果我们已经知道累积分布函数,那么对于连续型随机变量,还可以直接通过两个累计概率的差值计算区间概率:
P ( a ≤ T ≤ b ) = F T ( b ) − F T ( a ) \boxed{P(a\le T\le b)=F_T(b)-F_T(a)} P(a≤T≤b)=FT(b)−FT(a)
这样一来,我们就将之前学习的概率密度、定积分、区间概率以及累积分布函数联系起来了。
4. PDF:纵坐标是概率密度,面积才是概率
对于连续型随机变量,我们使用概率密度函数(PDF) f T ( t ) f_T(t) fT(t) 描述它的概率如何沿着数轴分布。
概率密度可以直观理解为:某个位置附近,单位长度内的概率有多集中。
取一个很窄的小区间 t , t + Δ t t,t+\\Delta t t,t+Δt,如果密度在附近比较平滑,就可以近似写为:
P ( t ≤ T ≤ t + Δ t ) ≈ f T ( t ) Δ t P(t\le T\le t+\Delta t)\approx f_T(t)\Delta t P(t≤T≤t+Δt)≈fT(t)Δt
当我们将很多小区间累积起来、让区间宽度趋近于 0 时,就得到了定积分:
P ( a ≤ T ≤ b ) = ∫ a b f T ( t ) d t \boxed{P(a\le T\le b)=\int_a^b f_T(t)\,dt} P(a≤T≤b)=∫abfT(t)dt
!
例如,假设 T 在 0~10 秒之间均匀分布:
f T ( t ) = { 0.1 , 0 ≤ t ≤ 10 0 , 其他 f_T(t)=\begin{cases} 0.1,&0\le t\le10\\ 0,&\text{其他} \end{cases} fT(t)={0.1,0,0≤t≤10其他
那么:
P ( 2 ≤ T ≤ 4 ) = ∫ 2 4 0.1 d t = ( 4 − 2 ) × 0.1 = 0.2 P(2\le T\le4)=\int_2^4 0.1\,dt=(4-2)\times0.1=0.2 P(2≤T≤4)=∫240.1dt=(4−2)×0.1=0.2
也就是 20%。
这里一定要记住:
对于离散型随机变量,概率质量函数图像的高度是概率;对于连续型随机变量,概率密度函数图像的高度是密度,某个区间下方的面积才是概率。
所以,概率密度函数的某个数值甚至可以大于 1,只要它处处非负、曲线下方的总面积为 1 即可。
5. CDF:把从左到当前 x 的概率全部累计起来
在理解 PDF 之后,我们接下来认识累积分布函数(CDF)。
它的定义其实非常简单:
F X ( x ) = P ( X ≤ x ) \boxed{F_X(x)=P(X\le x)} FX(x)=P(X≤x)
也就是说:随机变量小于或等于当前数值 x 的概率是多少?
如果 X 具有概率密度函数,则:
F X ( x ) = ∫ − ∞ x f X ( t ) d t F_X(x)=\int_{-\infty}^{x}f_X(t)\,dt FX(x)=∫−∞xfX(t)dt
对于前面的 0~10 秒均匀分布例子,CDF 就是:
F T ( t ) = { 0 , t < 0 0.1 t , 0 ≤ t ≤ 10 1 , t > 10 F_T(t)=\begin{cases} 0,&t<0\\ 0.1t,&0\le t\le10\\ 1,&t>10 \end{cases} FT(t)=⎩ ⎨ ⎧0,0.1t,1,t<00≤t≤10t>10
例如:
F T ( 3 ) = 0.3 F_T(3)=0.3 FT(3)=0.3
表示响应时间不超过 3 秒的概率为 30%。
如果已知 CDF,计算连续型随机变量的区间概率,就可以直接求:
P ( a ≤ T ≤ b ) = F T ( b ) − F T ( a ) P(a\le T\le b)=F_T(b)-F_T(a) P(a≤T≤b)=FT(b)−FT(a)
这里和我们之前学习的积分思想一致:右端累计面积减去左端累计面积,就得到中间的区间面积。
6. 如果 PDF 是分段函数,CDF 要怎么求?
概率密度函数可以是分段函数,但不是所有 PDF 都必须用分段形式表示。
假设:
f X ( x ) = { 0.2 , 0 ≤ x < 2 0.1 , 2 ≤ x ≤ 8 0 , 其他 f_X(x)=\begin{cases} 0.2,&0\le x<2\\ 0.1,&2\le x\le8\\ 0,&\text{其他} \end{cases} fX(x)=⎩ ⎨ ⎧0.2,0.1,0,0≤x<22≤x≤8其他
可以检查全部面积:
0.2 × 2 + 0.1 × 6 = 1 0.2\times2+0.1\times6=1 0.2×2+0.1×6=1
那么,计算 F X ( 5 ) F_X(5) FX(5) 时,我们不能只积分 2~5 这一段。
因为 CDF 要从左边一直累积到 5,因此:
F X ( 5 ) = ∫ 0 2 0.2 d t + ∫ 2 5 0.1 d t = 0.4 + 0.3 = 0.7 F_X(5)=\int_0^2 0.2\,dt+\int_2^5 0.1\,dt=0.4+0.3=0.7 FX(5)=∫020.2dt+∫250.1dt=0.4+0.3=0.7
完整写成分段函数:
F X ( x ) = { 0 , x < 0 0.2 x , 0 ≤ x < 2 0.4 + 0.1 ( x − 2 ) , 2 ≤ x ≤ 8 1 , x > 8 F_X(x)=\begin{cases} 0,&x<0\\ 0.2x,&0\le x<2\\ 0.4+0.1(x-2),&2\le x\le8\\ 1,&x>8 \end{cases} FX(x)=⎩ ⎨ ⎧0,0.2x,0.4+0.1(x−2),1,x<00≤x<22≤x≤8x>8
这就说明:PDF 负责描述密度,CDF 负责把这些密度从左到右累积成概率。
7. CDF 并不只适用于连续型随机变量
对于离散型随机变量,CDF 也成立:
F X ( x ) = P ( X ≤ x ) F_X(x)=P(X\le x) FX(x)=P(X≤x)
只不过在离散情形下,它通常表现为一个阶梯函数。
例如前面 P ( X = 0 ) = 0.16 P(X=0)=0.16 P(X=0)=0.16、 P ( X = 1 ) = 0.48 P(X=1)=0.48 P(X=1)=0.48、 P ( X = 2 ) = 0.36 P(X=2)=0.36 P(X=2)=0.36,那么:
F X ( x ) = { 0 , x < 0 0.16 , 0 ≤ x < 1 0.64 , 1 ≤ x < 2 1 , x ≥ 2 F_X(x)=\begin{cases} 0,&x<0\\ 0.16,&0\le x<1\\ 0.64,&1\le x<2\\ 1,&x\ge2 \end{cases} FX(x)=⎩ ⎨ ⎧0,0.16,0.64,1,x<00≤x<11≤x<2x≥2
因此,CDF 是一种可以统一描述离散型与连续型随机变量的分布函数。
九、期望、方差与标准差:我们能否用几个数概括整个分布?
1. 为什么要引入数学期望?
我们已经知道随机变量 X 可以取 0、1、2,对应概率为 0.16、0.48、0.36。
那么,一个自然的问题是:如果大量重复这个随机试验,平均每次会出现多少次正面?
这里就引出了数学期望(Expected Value)。
对于离散型随机变量:
E ( X ) = ∑ i x i P ( X = x i ) \boxed{E(X)=\sum_i x_iP(X=x_i)} E(X)=i∑xiP(X=xi)
它的含义就是:每个可能取值乘以对应的概率,然后求和。
例如:
E ( X ) = 0 × 0.16 + 1 × 0.48 + 2 × 0.36 = 1.2 E(X)=0\times0.16+1\times0.48+2\times0.36=\boxed{1.2} E(X)=0×0.16+1×0.48+2×0.36=1.2
这里的 1.2 表示长期重复试验的理论平均水平,不代表某次试验真的能够出现 1.2 次正面。
对于期望存在的连续型随机变量,只需要将离散求和转换为积分:
E ( X ) = ∫ − ∞ + ∞ x f X ( x ) d x E(X)=\int_{-\infty}^{+\infty}x f_X(x)\,dx E(X)=∫−∞+∞xfX(x)dx
它们都是按概率对可能取值进行加权平均。
2. 只有平均水平,为什么还不够?
假设有两个随机变量:
- X 只可能取 9 或 11,各占 50%。
- Y 只可能取 0 或 20,各占 50%。
那么:
E ( X ) = 10 , E ( Y ) = 10 E(X)=10,\qquad E(Y)=10 E(X)=10,E(Y)=10
但是两个分布显然不同:X 总是在 10 附近,而 Y 离 10 非常远。
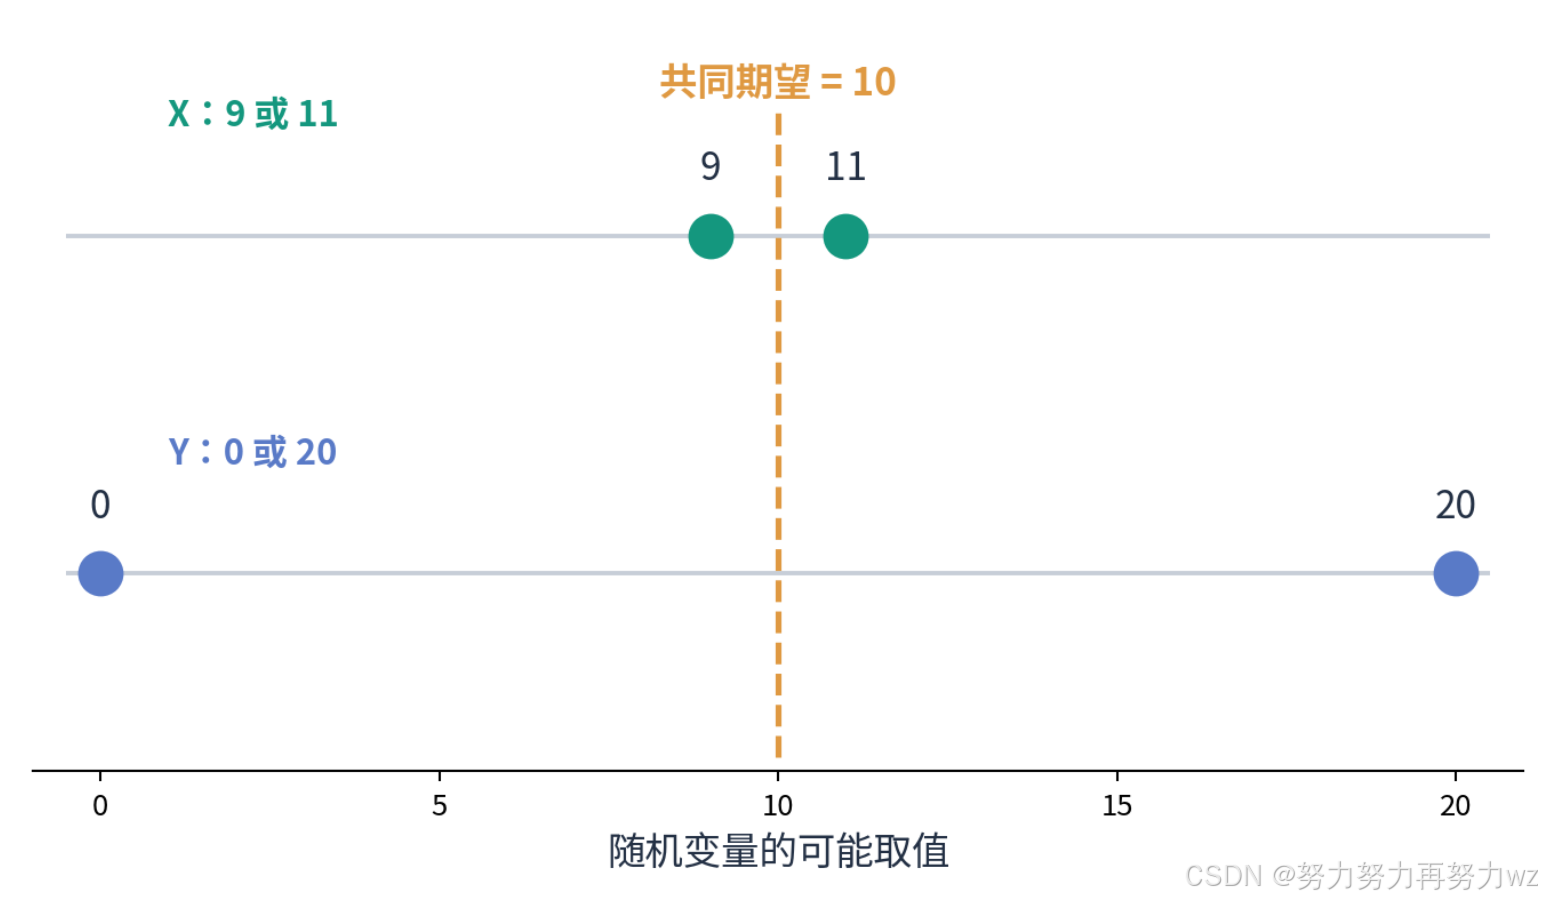
因此,数学期望只能反映平均位置,不能反映围绕平均值有多分散。
3. 方差为什么要先减去期望,再平方?
我们很自然会想到:既然想衡量波动,那就计算每个取值与数学期望的偏差。
但是,如果直接对偏差加权平均:
E X − E ( X ) = 0 EX-E(X)=0 EX−E(X)=0
正偏差与负偏差会相互抵消。
所以,我们将偏差平方,再计算这些平方偏差的期望:
Var ( X ) = E ( X − E ( X ) ) 2 \boxed{\operatorname{Var}(X)=E(X-E(X))\^2} Var(X)=E(X−E(X))2
对于离散型随机变量:
Var ( X ) = ∑ i ( x i − E ( X ) ) 2 P ( X = x i ) \operatorname{Var}(X)=\sum_i(x_i-E(X))^2P(X=x_i) Var(X)=i∑(xi−E(X))2P(X=xi)
对于刚才两个期望都为 10 的随机变量:
Var ( X ) = ( 9 − 10 ) 2 × 0.5 + ( 11 − 10 ) 2 × 0.5 = 1 \operatorname{Var}(X)=(9-10)^2\times0.5+(11-10)^2\times0.5=1 Var(X)=(9−10)2×0.5+(11−10)2×0.5=1
Var ( Y ) = ( 0 − 10 ) 2 × 0.5 + ( 20 − 10 ) 2 × 0.5 = 100 \operatorname{Var}(Y)=(0-10)^2\times0.5+(20-10)^2\times0.5=100 Var(Y)=(0−10)2×0.5+(20−10)2×0.5=100
你看,方差就能区分它们的离散程度。
另外,将平方展开可得一个便于计算的等价公式(要求相关期望存在):
Var ( X ) = E ( X 2 ) − E ( X ) 2 \boxed{\operatorname{Var}(X)=E(X^2)-E(X)^2} Var(X)=E(X2)−E(X)2
4. 什么是标准差?
方差存在一个问题:它的单位是原始随机变量单位的平方。
例如响应时间是"秒",那么方差的单位就是"平方秒"。
因此,可以对方差开平方,得到标准差(Standard Deviation):
σ X = Var ( X ) \boxed{\sigma_X=\sqrt{\operatorname{Var}(X)}} σX=Var(X)
标准差与随机变量的单位一致,通常更方便直观理解。
到这里,可以把这三个概念简单整理为:
| 概念 | 解决什么问题? |
|---|---|
| 数学期望 | 随机变量平均处于什么水平? |
| 方差 | 随机变量围绕期望有多分散? |
| 标准差 | 用与原变量相同的单位描述离散程度 |
十、常见概率分布:为什么不同随机试验可以使用同一套数学模型?
我们之前学习的概率分布,都根据具体试验一步步计算出来。
但在实际问题中,我们会发现:很多看起来不同的随机试验,其实具有相同的概率结构。
因此,可以用一些统一的概率模型来描述它们。
1. 伯努利分布:一次试验,只有 0 和 1
假设某次试验只有"成功"与"失败"两种结果,我们定义:
X = { 1 , 成功 0 , 失败 X=\begin{cases} 1,&\text{成功}\\ 0,&\text{失败} \end{cases} X={1,0,成功失败
并且:
P ( X = 1 ) = p , P ( X = 0 ) = 1 − p P(X=1)=p,\qquad P(X=0)=1-p P(X=1)=p,P(X=0)=1−p
这种概率分布称为伯努利分布(Bernoulli Distribution),记作:
X ∼ Bernoulli ( p ) X\sim\operatorname{Bernoulli}(p) X∼Bernoulli(p)
它的 PMF 也可以写为:
P ( X = x ) = p x ( 1 − p ) 1 − x , x ∈ { 0 , 1 } P(X=x)=p^x(1-p)^{1-x},\qquad x\in\{0,1\} P(X=x)=px(1−p)1−x,x∈{0,1}
数学期望与方差分别为:
E ( X ) = p , Var ( X ) = p ( 1 − p ) E(X)=p,\qquad\operatorname{Var}(X)=p(1-p) E(X)=p,Var(X)=p(1−p)
注意,伯努利分布不要求原始样本空间只有两个样本点。例如掷骰子有 6 个结果,但我们可以定义"是否出现 6",映射成 0、1,仍然得到伯努利随机变量。
2. 二项分布:独立重复 n 次,统计成功次数
那么,如果我们不只进行一次试验,而是独立重复 n n n 次,而且每次成功的概率都为 p p p,这时候应该如何研究成功了多少次?
定义:
X = n 次独立试验中成功的次数 X=\text{n 次独立试验中成功的次数} X=n 次独立试验中成功的次数
那么:
X ∼ Binomial ( n , p ) X\sim\operatorname{Binomial}(n,p) X∼Binomial(n,p)
若恰好成功 k k k 次,则某一种具体排列的概率为:
p k ( 1 − p ) n − k p^k(1-p)^{n-k} pk(1−p)n−k
但是"恰好成功 k 次"可以有不同的排列方式,排列数量由组合数给出:
( n k ) = n ! k ! ( n − k ) ! \binom nk=\frac{n!}{k!(n-k)!} (kn)=k!(n−k)!n!
因此,二项分布的 PMF 为:
P ( X = k ) = ( n k ) p k ( 1 − p ) n − k , k = 0 , 1 , ... , n \boxed{P(X=k)=\binom nkp^k(1-p)^{n-k}},\qquad k=0,1,\ldots,n P(X=k)=(kn)pk(1−p)n−k,k=0,1,...,n
比如独立抛三次硬币,正面概率 p = 0.6 p=0.6 p=0.6,恰好两次正面:
P ( X = 2 ) = ( 3 2 ) ( 0.6 ) 2 ( 0.4 ) = 3 × 0.144 = 0.432 P(X=2)=\binom32(0.6)^2(0.4)=3\times0.144=\boxed{0.432} P(X=2)=(23)(0.6)2(0.4)=3×0.144=0.432
二项分布的期望与方差为:
E ( X ) = n p , Var ( X ) = n p ( 1 − p ) E(X)=np,\qquad\operatorname{Var}(X)=np(1-p) E(X)=np,Var(X)=np(1−p)
这里伯努利和二项分布的联系也就很清楚了:**伯努利描述一次试验,二项分布描述多次独立伯努利试验的成功总次数。**当 n = 1 n=1 n=1 时,二项分布就退化为伯努利分布。
3. 正态分布:期望决定中心,方差决定宽窄
现在,我们从离散型分布过渡到连续型分布。
假设有一种随机测量误差,它的概率密度集中在某个中心附近,并且左右对称、越远离中心密度越低。
如果这种密度具有正态分布的具体数学形式,那么就称为正态分布(Normal Distribution)。
它的图像是对称的钟形曲线。
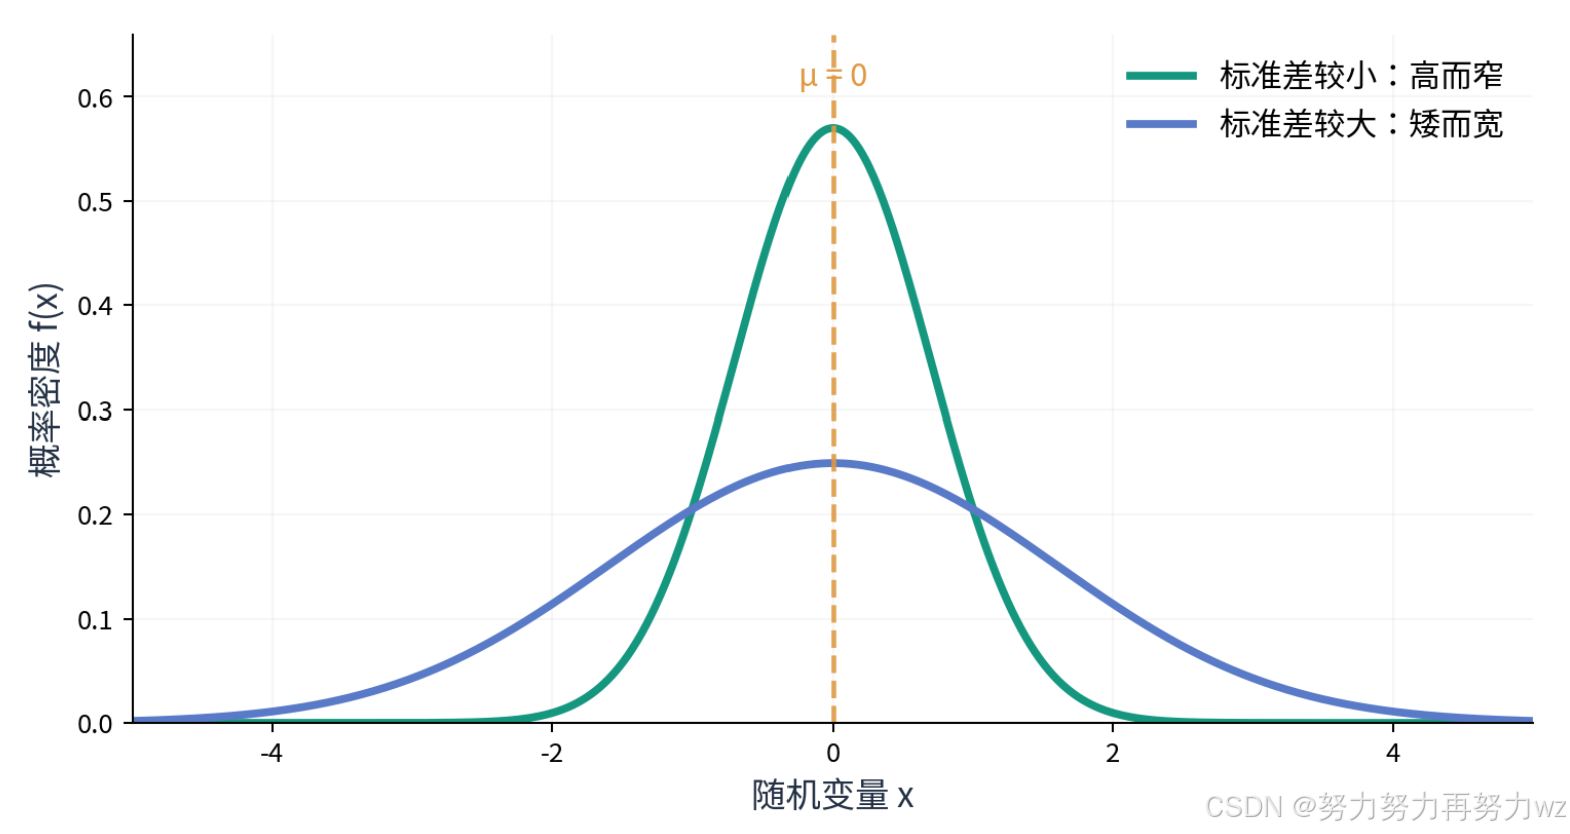
正态分布由两个参数决定:
X ∼ N ( μ , σ 2 ) \boxed{X\sim N(\mu,\sigma^2)} X∼N(μ,σ2)
这里:
- μ \mu μ 是数学期望,决定曲线的对称中心与最高点的横坐标。
- σ 2 \sigma^2 σ2 是方差,决定曲线的分散程度。
- 标准差 σ \sigma σ 越小,曲线越高、越窄;越大,曲线越矮、越宽。
它的概率密度函数为:
f X ( x ) = 1 σ 2 π exp ( − ( x − μ ) 2 2 σ 2 ) , σ > 0 f_X(x)=\frac{1}{\sigma\sqrt{2\pi}}\exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right),\qquad \sigma>0 fX(x)=σ2π 1exp(−2σ2(x−μ)2),σ>0
这里暂时不需要推导表达式,重点是理解参数对应的几何意义。
**需要强调,正态分布的最高点表示概率密度最大,而不是单个数值的概率最大。**连续型随机变量在单个点的概率仍然为 0。
对于正态分布,还存在一个经常遇到的近似规律:
| 围绕期望的区间 | 区间内的概率(约) |
|---|---|
| μ − σ , μ + σ \\mu-\\sigma,\\mu+\\sigma μ−σ,μ+σ | 68.27% |
| μ − 2 σ , μ + 2 σ \\mu-2\\sigma,\\mu+2\\sigma μ−2σ,μ+2σ | 95.45% |
| μ − 3 σ , μ + 3 σ \\mu-3\\sigma,\\mu+3\\sigma μ−3σ,μ+3σ | 99.73% |
这个规律只针对正态分布,不是任意概率分布都满足。
另外,在适当条件下,多个独立随机因素叠加得到的结果可能近似服从正态分布;满足相应条件时,二项分布也可以进行正态近似。但这不意味着生活中所有连续随机变量都服从正态分布。
4. 三种分布之间的区别
| 分布 | 类型 | 研究的问题 | 关键参数 |
|---|---|---|---|
| 伯努利分布 | 离散型 | 一次试验是否成功 | p p p |
| 二项分布 | 离散型 | n 次独立试验中成功多少次 | n , p n,p n,p |
| 正态分布 | 连续型 | 对称钟形的连续概率密度如何分布 | μ , σ 2 \mu,\sigma^2 μ,σ2 |
到这里,三种常见概率分布的基本认知就建立起来了。
十一、几个容易混淆的问题,再集中梳理一次
1. 样本空间必须有限吗?
不需要。样本空间可以有限、可数无穷,也可以包含不可数多个基本结果。
2. 离散型随机变量是不是要求样本空间有限?
不是。离散型随机变量可以有可数无穷多个取值,更不能只根据原始样本空间是否有限来判断随机变量类型。
3. 频率是不是概率?
不完全一样。频率是有限次试验中观察到的比例;概率是概率模型对事件发生可能性的描述。重复试验的频率可以在适当条件下用于估计概率。
4. 两个事件都出现,是否直接把概率相乘?
只有独立时才能直接使用 P ( A ) P ( B ) P(A)P(B) P(A)P(B)。一般情况下应使用:
P ( A ∩ B ) = P ( A ) P ( B ∣ A ) P(A\cap B)=P(A)P(B\mid A) P(A∩B)=P(A)P(B∣A)
5. 两个事件的概率是否可以直接相加?
计算并集时,需要考虑重叠部分:
P ( A ∪ B ) = P ( A ) + P ( B ) − P ( A ∩ B ) P(A\cup B)=P(A)+P(B)-P(A\cap B) P(A∪B)=P(A)+P(B)−P(A∩B)
只有互斥时,才能直接相加。
6. 全概率和贝叶斯的区别是什么?
全概率:按场景拆分,汇总得到事件 A 的总概率。
贝叶斯:已经知道 A 发生,计算某个场景在 A 内所占的条件概率。
7. 随机变量和它的实际取值一样吗?
不一样。随机变量 X X X 是定义在样本空间上的映射函数; X ( ω ) X(\omega) X(ω) 才是某个具体样本点对应的函数值。
8. 连续型 PDF 的纵坐标是概率吗?
不是,是概率密度。区间概率由曲线下方的面积表示。
9. CDF 是否就是对某一小段 PDF 积分?
不是只积当前区间,而是从最左侧一直累计到当前 x。如果 PDF 分段,要加上前面区间已经累计的概率。
10. 正态分布的最高点是否表示这个数值概率最大?
严格来说,它表示这个位置的概率密度最大。对连续型随机变量,单个数值的概率仍为 0。
总结
现在,我们可以把整篇文章的逻辑再次串联起来。
首先,机器学习希望从有限数据中学习规律,但未来的新输入和误差具有不确定性,所以需要概率论提供数学描述。
于是,我们从随机试验开始,认识了样本空间、样本点与随机事件,并学会在互斥、独立等条件下计算概率。
接下来,当获得新的已知信息时,概率的参照范围可能发生变化,这就引出了条件概率。基于条件概率的一般乘法,再结合互斥事件的加法,就能得到全概率公式;把问题反过来,就自然得到了贝叶斯公式以及先验、后验的概念。
然后,为了能够用数值研究随机试验,我们定义随机变量,将样本点映射为实数。进一步研究数值取值的概率规律,就得到了概率分布。
对于离散型随机变量,使用 PMF 描述各个数值的概率;对于连续型随机变量,使用 PDF 描述概率密度,再利用积分得到区间概率;而 CDF 则统一描述截至某个位置的累计概率。
在有了概率分布之后,我们又可以使用数学期望描述平均水平,使用方差和标准差描述离散程度,并认识了伯努利分布、二项分布以及正态分布这三种常见概率模型。
最后回到机器学习:概率论所提供的这些概念,正是我们后续理解模型概率输出、样本分布、误差建模以及参数估计的重要数学基础。
理解概率论,关键并不是把公式全部背下来,而是知道:我们在研究哪个随机试验、以哪个事件作为参照、随机变量表达什么、概率又是如何在不同取值上分布的。
至此,机器学习所需的概率论入门知识已经具备一个比较完整的基本框架。后续可以继续针对机器学习补充联合分布、条件分布、协方差和最大似然估计,再进入具体算法。