摘要:BypassMergeSortShuffle 是 SortShuffleManager 提供的最轻量 Shuffle Write 路径------它绕过排序、绕过聚合,直接为每个分区写独立文件最后合并,省去了 ExternalSorter 的全部开销。本文从触发条件、分区直写流程、Index File 生成、与 SortShuffleWriter/UnsafeShuffleWriter 的决策树对比四个维度,配合 2 张原创架构图 + 源码追踪,彻底拆解这一极速 Shuffle 路径的原理与适用边界。
关键词:BypassMergeSortShuffle, SortShuffleManager, DiskBlockObjectWriter, Index File, groupByKey, bypassMergeThreshold
一、开篇:SortShuffle 的第三条路径
SortShuffleManager 并非只有一种 Shuffle Write 方式。它内部有三条路径,根据 ShuffleDependency 的特征自动选择:
markdown
SortShuffleManager 三路分发
├── ① BypassMergeSortShuffleWriter --- 无排序直写(本文重点)
│     条件: 无 combine + 无排序 + partitions ≤ 200
├── ② SortShuffleWriter --- ExternalSorter 排序路径(通用)
│     条件: 需要 combine 或 排序要求 或 分区数过多
└── ③ UnsafeShuffleWriter --- Tungsten 堆外排序
      条件: 无 combine + 无排序 + 支持序列化重定位
二、触发条件:三条 AND 全满足
scala
// SortShuffleManager.shouldBypassMergeSort()
def shouldBypassMergeSort(conf: SparkConf, dep: ShuffleDependency): Boolean = {
  dep.mapSideCombine == false        // ① 不需要 map 端预聚合
    && dep.keyOrdering.isEmpty        // ② 不需要排序
    && dep.partitioner.numPartitions <= conf.get(config.BYPASS_MERGE_THRESHOLD)
    // ③ 分区数 ≤ bypassMergeThreshold(默认 200)
}
// 三条全满足 → BypassMergeSortShuffleHandle → BypassMergeSortShuffleWriter
为什么这么设计? 如果没有需要 combine 的聚合逻辑、没有排序要求、且分区数较少------那排序完全是个多余的步骤。BypassMerge 正是识别出这类场景后的一条"快捷通道"。
三、BypassMerge 写流程全拆解(6 步骤)
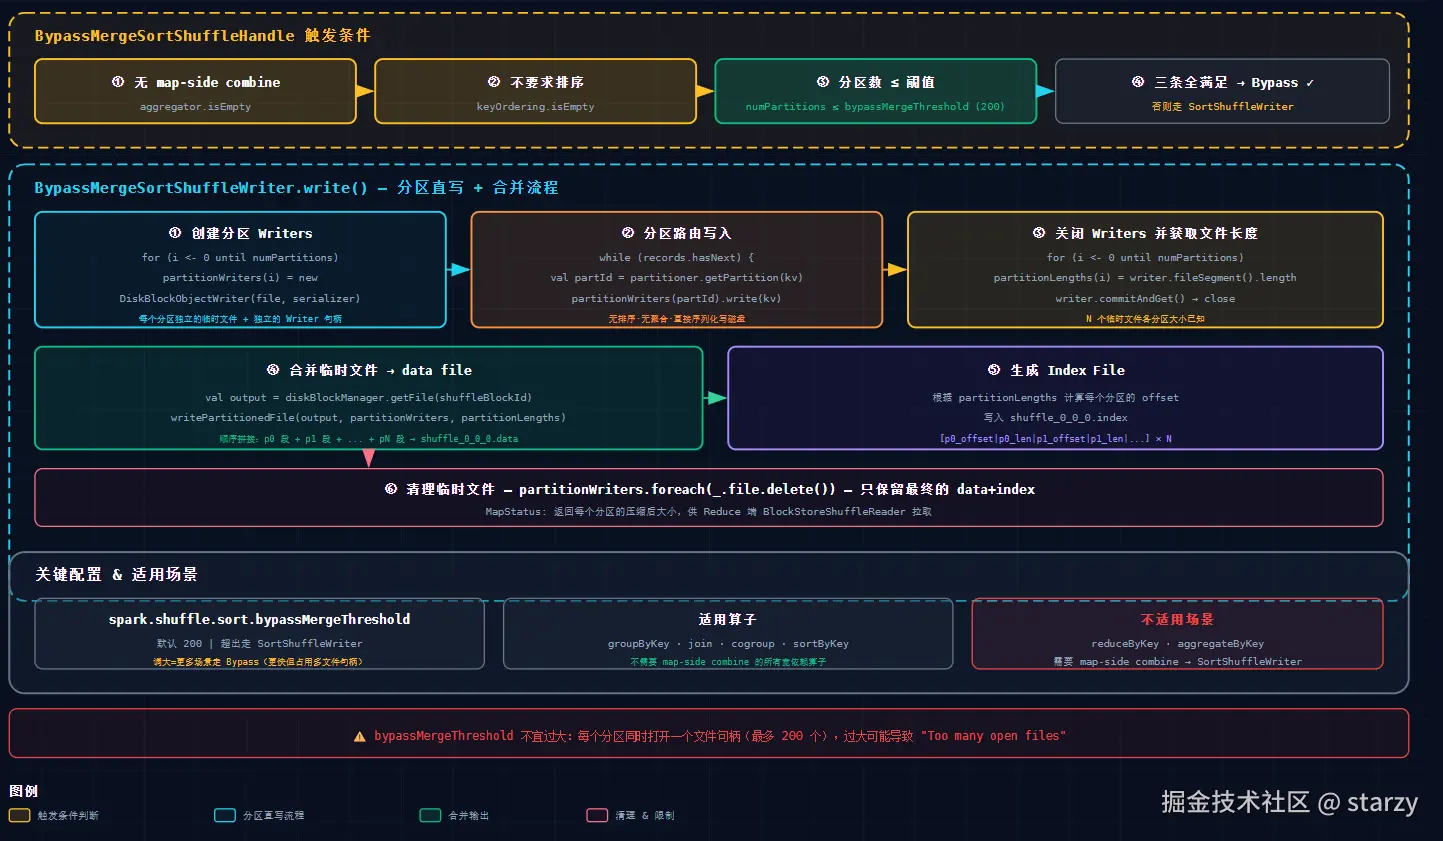
① 创建分区 Writers(N 个文件句柄)
scala
val partitionWriters = new Array[DiskBlockObjectWriter](numPartitions)
for (i <- 0 until numPartitions) {
  val file = diskBlockManager.createTempShuffleBlock()
  partitionWriters(i) = blockManager.getDiskWriter(file, serializer, bufferSize)
}
// N 个分区 = N 个临时文件 = N 个 Writer 句柄
② 分区路由写入(无排序!)
scala
while (records.hasNext) {
  val kv = records.next()
  val partitionId = partitioner.getPartition(kv._1)   // 路由到分区
  partitionWriters(partitionId).write(kv._1, kv._2)    // 直接序列化写入
}
// ⚡ 无 HashMap 插入 · 无排序比较 · 无聚合合并
③ 关闭 Writers,获取各分区文件长度
scala
val partitionLengths = partitionWriters.map { w =>
  w.commitAndGet()
  w.fileSegment().length    // 每个分区的数据大小
}
④ 合并临时文件 → 最终 data file
scala
// writePartitionedFile() --- 顺序拼接
// p0 临时文件内容 + p1 临时文件内容 + ... + pN 临时文件内容
val out = new FileOutputStream(outputFile)
for (i <- 0 until numPartitions) {
  val len = partitionLengths(i)
  Utils.copyStream(writers(i).openInputStream(), out)  // 顺序追加
  offsets(i+1) = offsets(i) + len
}
⑤ 根据 offsets + lengths → 生成 Index File
csharp
[p0_offset(8B)|p0_length(8B)|p1_offset|p1_length|...]⑥ 清理临时文件 + 返回 MapStatus
scala
partitionWriters.foreach(_.file.delete())  // 只保留最终的 data+index
MapStatus(blockManagerId, partitionLengths.map(compressSize))
四、三路决策对比
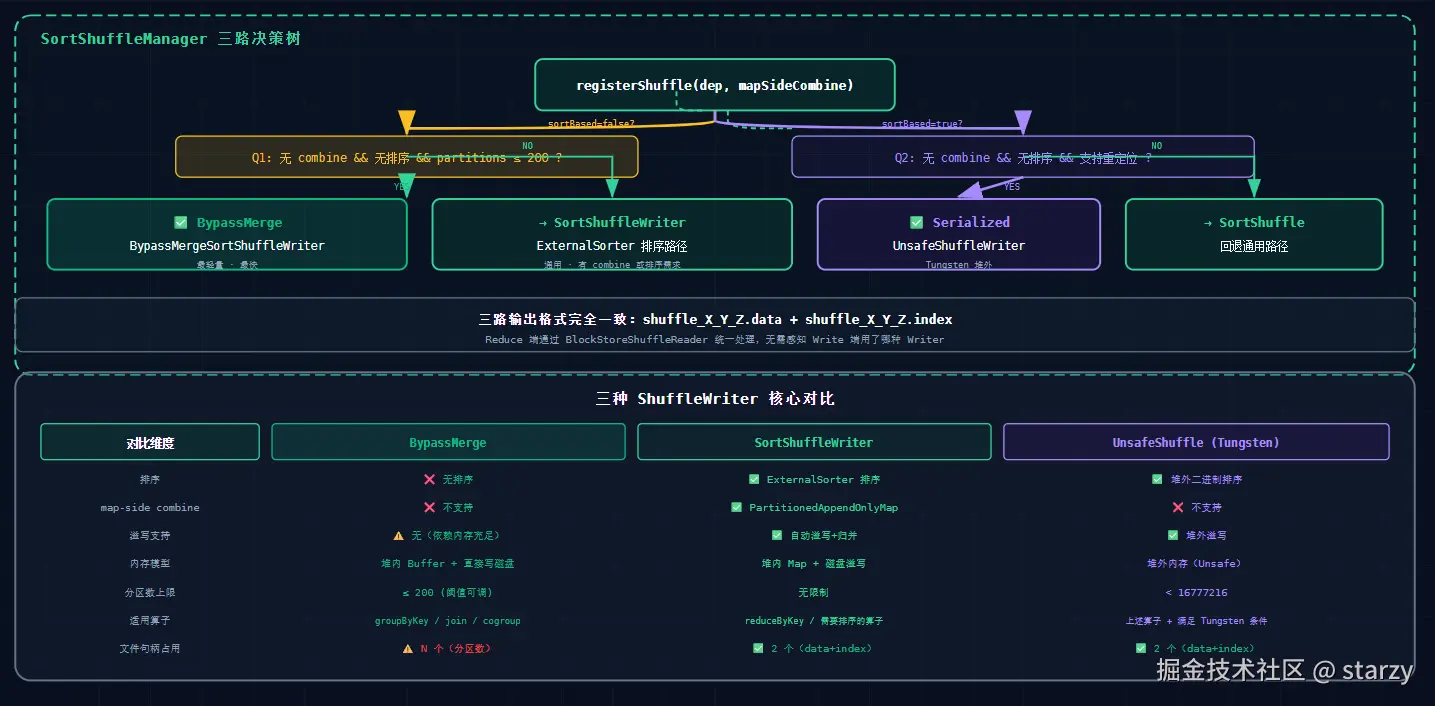
perl
                    BypassMerge       SortShuffleWriter    UnsafeShuffle
────────────────────────────────────────────────────────────────────────
排序                ❌ 无              ✅ ExternalSorter    ✅ 堆外二进制
map-side combine    ❌ 不支持           ✅ 支持              ❌ 不支持
溢写支持            ⚠️ 无              ✅ 自动溢写          ✅ 堆外溢写
内存模型            堆内Buffer+磁盘    堆内Map+磁盘        堆外Unsafe
分区数上限          ≤ 200 (可调)       无限制              < 16777216
文件句柄占用        N 个(分区数)     2 个              2 个
适用算子            groupByKey/join    reduceByKey        满足Tungsten条件
五、核心源码
scala
// BypassMergeSortShuffleWriter.write()
override def write(records: Iterator[Product2[K, V]]): Unit = {
  // ① 创建分区 Writers
  val partitionWriters = new Array[DiskBlockObjectWriter](numPartitions)
  for (i <- 0 until numPartitions) {
    partitionWriters(i) = blockManager.getDiskWriter(
      diskBlockManager.createTempShuffleBlock(), serializer, bufferSize)
  }
  // ② 分区路由写入(无排序)
  while (records.hasNext) {
    val kv = records.next()
    val partId = partitioner.getPartition(kv._1)
    partitionWriters(partId).write(kv._1, kv._2)
  }
  // ③ 关闭 + 获取长度
  val lengths = partitionWriters.map(w => { w.commitAndGet(); w.fileSegment().length })
  // ④ 合并 → data file
  writePartitionedFile(shuffleBlockResolver.getDataFile(shuffleId, mapId),
    partitionWriters, lengths)
  // ⑤ 清理临时文件
  partitionWriters.foreach(_.file.delete())
  // ⑥ 返回 MapStatus
  mapStatus = MapStatus(blockManager.shuffleServerId, lengths.map(compressSize))
}
六、调优建议
properties
# 增大 bypass 阈值 → 更多场景走极速路径
spark.shuffle.sort.bypassMergeThreshold=400  # 默认 200

# 减少分区数 → 触发 bypass
spark.sql.shuffle.partitions=100             # 默认 200
scala
// 用 groupByKey + map 替代 reduceByKey 来强制走 bypass
rdd.groupByKey().mapValues(_.sum)            // bypass ✓
// vs
rdd.reduceByKey(_ + _)                        // SortShuffleWriter ✗
⚠️ 注意事项:
- 文件句柄:每个分区同时打开一个文件,阈值不宜过大("Too many open files")
- 溢写缺失:内存不足时无自动溢写,可能导致 OOM
- groupByKey 虽然 bypass 更快,但会把所有数据拉到一个分区,网络开销可能更大
七、总结
-
BypassMerge 是 SortShuffleManager 的最轻量路径,无排序、无聚合、分区直写后合并。触发条件:无 combine + 无排序 + partitions ≤ 阈值。
-
三路决策树:Bypass(轻量)→ SortShuffle(通用)→ UnsafeShuffle(堆外),输出格式完全一致。
-
适用场景:groupByKey / join 等无 map-side combine 的低分区数算子。
作者 :starzy
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践