本文所介绍的, 乃是当今最为出色的GAN当中的一个, 它源自论文《A Style-Based for 》的 , 我们会运用 对其予以干净、简单且具备可读性的实现, 并且尝试尽可能地贴近原始论文。
倘若您未曾读过那论文, 或者不清楚它是怎样运作的, 然而您又想要知晓它, 那我极力建议您予以参考。
本博文中所运用的数据集, 是源自 的数据集, 此数据集之中存在着 16240 件女性上衣, 其分辨率为 256*192。
依赖项加载
我们先是导入torch, 接着从那儿导入nn, 这能够助力我们构建以及训练网络, 还能让我们导入optim, 一个用以实现各类优化算法(像是sgd、adam等)的包, 我们从导入数据集和转换来预备数据并施行一些转换。
我们会导入 F 函数, 该函数是从 torch.nn 里拿来的, 目的是运用插值给图像进行上采样, 还会导入一些特定内容用于其它操作以及保存少数假样本, 此外还利用对数数学展示形式, 因为所需其二倍数幂的逆表示形式, 以便依从所输出分辨率达成适配小批量大小, NumPy 是用来做线性代数的, os 用于和操作系统相互作用, 通过 tqdm 显示进度条作为最后的作用。显示结果并把它和真值做比较。
python
import torch
from torch import nn, optim
from torchvision import datasets, transforms
import torch.nn.functional as F
from torch.utils.data import DataLoader
from torchvision.utils import save_image
from math import log2
import numpy as np
import os
from tqdm import tqdm
import matplotlib.pyplot as plt
超参数
python
DATASET                 = "Women clothes"
START_TRAIN_AT_IMG_SIZE = 8 #The authors start from 8x8 images instead of 4x4
DEVICE                  = "cuda" if torch.cuda.is_available() else "cpu"
LEARNING_RATE           = 1e-3
BATCH_SIZES             = [256, 128, 64, 32, 16, 8]
CHANNELS_IMG            = 3
Z_DIM                   = 256
W_DIM                   = 256
IN_CHANNELS             = 256
LAMBDA_GP               = 10
PROGRESSIVE_EPOCHS      = [30] * len(BATCH_SIZES)
获取数据加载器
现在让我们创建一个函数来:
python
def get_loader(image_size):
    transform = transforms.Compose(
        [
            transforms.Resize((image_size, image_size)),
            transforms.ToTensor(),
            transforms.RandomHorizontalFlip(p=0.5),
            transforms.Normalize(
                [0.5 for _ in range(CHANNELS_IMG)],
                [0.5 for _ in range(CHANNELS_IMG)],
            ),
        ]
    )
    batch_size = BATCH_SIZES[int(log2(image_size / 4))]
    dataset = datasets.ImageFolder(root=DATASET, transform=transform)
    loader = DataLoader(
        dataset,
        batch_size=batch_size,
        shuffle=True,
    )
    return loader, dataset
模型实现
此时, 让我们运用论文里的关键属性去达成生成器以及鉴别器, (且生成器与鉴别器有着相同的鉴别器架构)。我们会竭尽所能令实现变得紧凑, 不过与此同时要维持其可读性以及可理解性。具体而言, 存在以下几个要点:
在这个教程里头, 我们会仅仅运用生成图像, 不去达成风格混合以及随机变化, 不过这想必不会很困难的。
我们去定义名为 的变量, 该变量当中含有与 相乘的数字, 利用这些数字去获得每个图像分辨率里我们期望的通道数。
python
factors = [1, 1, 1, 1, 1 / 2, 1 / 4, 1 / 8, 1 / 16, 1 / 32]噪声映射网络
噪声映射网络采用Z, 把Z放入八个完全连接的层, 这些层由某些激活分隔。且不要忘记像作者在中所做的那样均衡学习率, 和由同一研究人员编写。
我们首先去构建一个类, 这个类有着名为(加权缩放线性)的称呼, 该类是要从nn.进行继承的。
在init部分, 我们发送 和 这两个东西。接着创建一个线性层, 随后我们针对一个比例进行定义, 这个比例是这样的, 它等于2的平方根除以某个东西, 这里的某个东西先不明确说出。之后我们把当前列层的偏差复制到一个变量里, 原因呢是我们不企求让线性层的偏差出现缩放这一状况。这么做了之后接着是把它删除掉, 在完成复制偏差进入变量以及接着删除偏差这些操作之后, 最后, 也就是在这一系列操作的末尾, 我们对线性层实行初始化举措。
在前向的组成部分之中, 我们施行发送动作, 发送既定的 x 项目,而我们所要达成的行为, 便是把 x 同比例进行相乘运算, 并且在完成重塑操作之后, 增添偏差数值。
python
class WSLinear(nn.Module):
    def __init__(
        self, in_features, out_features,
    ):
        super(WSLinear, self).__init__()
        self.linear = nn.Linear(in_features, out_features)
        self.scale = (2 / in_features)**0.5
        self.bias = self.linear.bias
        self.linear.bias = None
        # initialize linear layer
        nn.init.normal_(self.linear.weight)
        nn.init.zeros_(self.bias)
    def forward(self, x):
        return self.linear(x * self.scale) + self.bias
现在让我们创建 类。
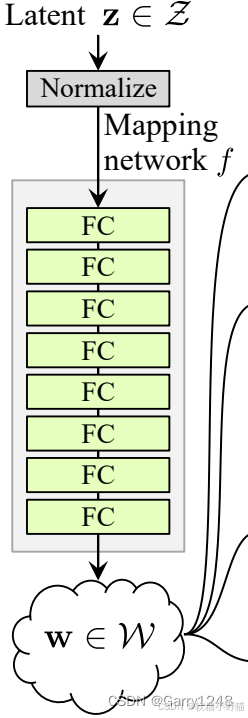
python
class MappingNetwork(nn.Module):
    def __init__(self, z_dim, w_dim):
        super().__init__()
        self.mapping = nn.Sequential(
            PixelNorm(),
            WSLinear(z_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
            nn.ReLU(),
            WSLinear(w_dim, w_dim),
        )
    def forward(self, x):
        return self.mapping(x)
自适应实例标准化 (AdaIN)
现在让我们创建 AdaIN 类:
python
class AdaIN(nn.Module):
    def __init__(self, channels, w_dim):
        super().__init_