起因:合同审阅这件事,真的很耗人
做过采购或者法务对接的人多半有同感:一份合同甩过来,格式五花八门------有的是 Word,有的是带文字层的 PDF,还有直接拍照、扫描成图片的。人工审一份采购合同,光是把甲乙方、合同金额、付款比例、交付与验收、违约责任、自动续期这些关键条款一条条抠出来再判断风险,少说半小时起步。合同一多,最怕的不是慢,是漏------像"合同期满前 30 日未提异议即自动续约一年,续费价格按乙方当期报价执行"这种藏在末尾的条款,一旦漏看就是真金白银的损失。
所以我想做个东西:丢进去一份合同(什么格式都行,扫描件也认),自动吐出结构化要素表 + 风险清单 + 修改建议 。但我给它加了一个验收要求:报告应该能回到原文,至少让我知道它为什么判定为风险。手头正好有 WorkBuddy 和腾讯云的几个 OCR 技能包,这篇就把我从装技能、配环境、封装成专用助手,到用 5 份不同格式合同实测的完整过程记下来,包括中间几次"翻车"。
整体思路:三个 OCR 能力,拼成一个"专用大脑"
合同审阅拆开看是三个动作:把字认出来 → 把要素抽出来 → 把表格读明白。所以我选了腾讯云的三个 Skill 分工:
- 通用文字识别(高精度版)
GeneralAccurateOCR:打底。扫描件 PDF、拍照件没有文字层,得先靠它把整页文字抠出来。 - 表格识别 V3
RecognizeTableAccurateOCR:处理合同里的采购清单、付款计划这类明细表格,普通文字识别对表格容易串行串列。 - 实时文档抽取 Agent
ExtractDocAgent:核心,按我自定义的字段从合同里结构化抽取信息。
但很快我就发现一个问题:每审一份合同都要手动串这三个技能,很麻烦 。于是有了这篇的重点------干脆让 WorkBuddy 帮我把这三个能力封装成一个专用技能,自动完成"格式判断 → OCR → 要素抽取 → 风险分析 → 出报告"的全流程。三种能力的职责要分清:OCR 解决"有没有读到",抽取 Agent 解决"字段是什么",规则和模型协同解决"哪里可疑";最后的接受与否,仍然是人的判断。
整条链路是这样的:
markdown
一份合同(TXT/DOCX/文字PDF/扫描PDF)
      │
   格式检测 ──→ 扫描件? ──是──→ 通用文字识别取全文
      │                          │
   含表格? ──是──→ 表格识别V3 ────┤
      │                          ▼
      └──────────────→ 文档抽取Agent(按20项合同要素抽取)
                                 │
                          风险规则引擎(7大类)
                                 ▼
                   合同审阅报告.html + 审查结果.json
这条链路还有一个实际好处:每一步都可以单独验收。格式判断错了,看 OCR 分支;文本读全了但字段少,看抽取配置;风险数量异常,则回到规则和证据片段。出了问题,不必把整个系统当成一个黑盒子重跑。
准备工作:先把三个 Skill 装上
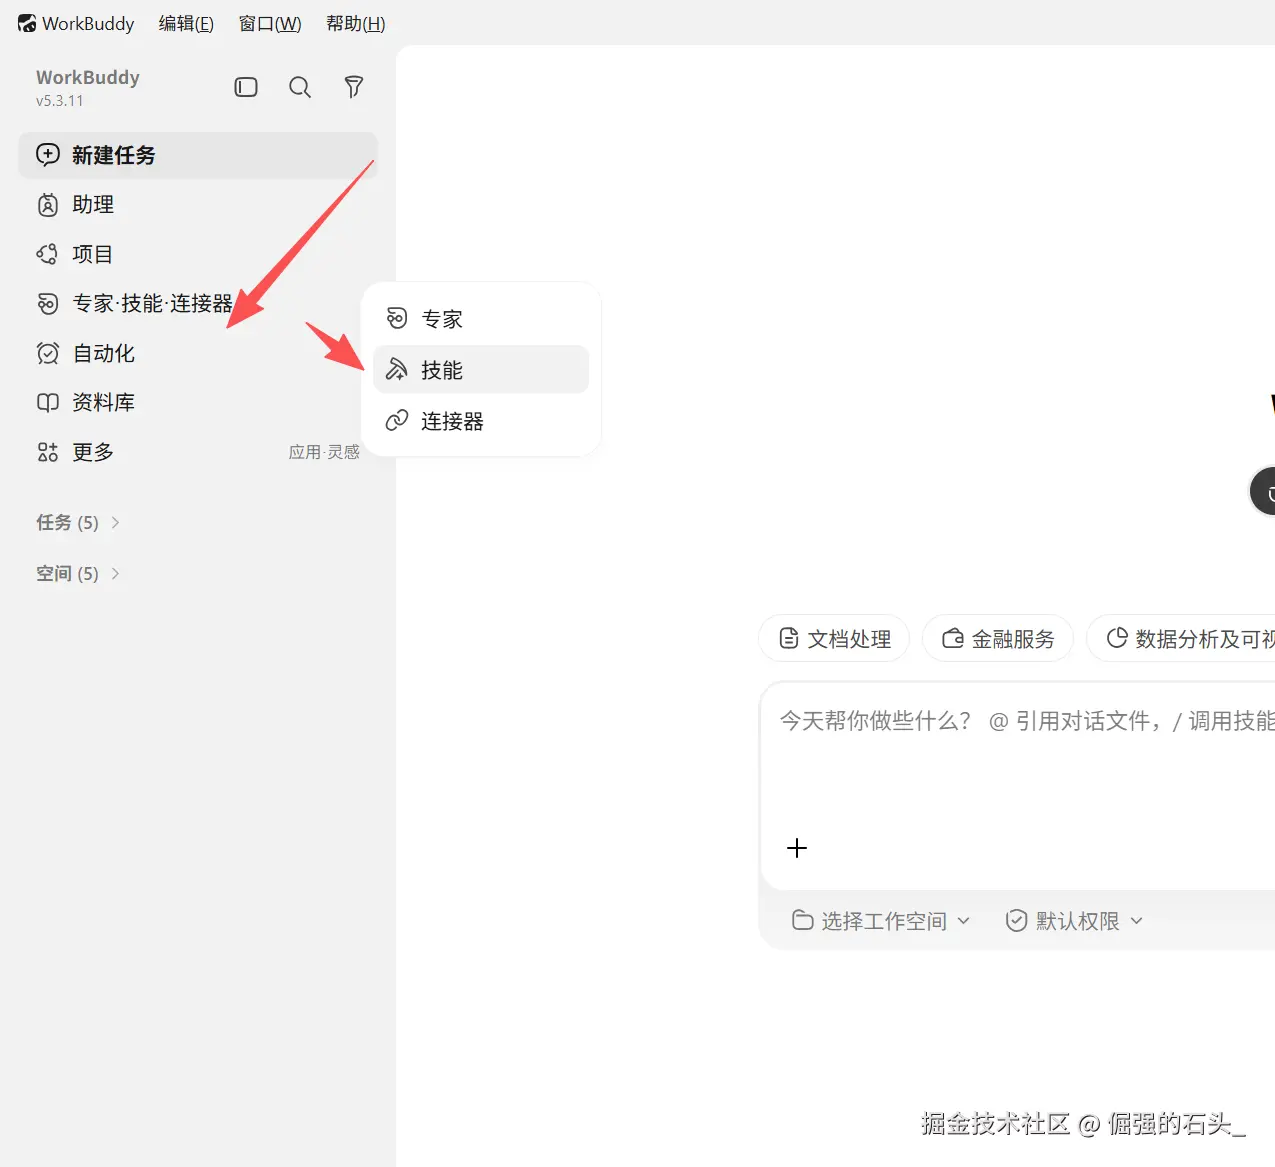
在 WorkBuddy左侧"专家 · 技能 · 连接器"里进技能市场,把上面三个腾讯云 OCR 技能挨个装上就行,界面很直白,搜名字点安装。
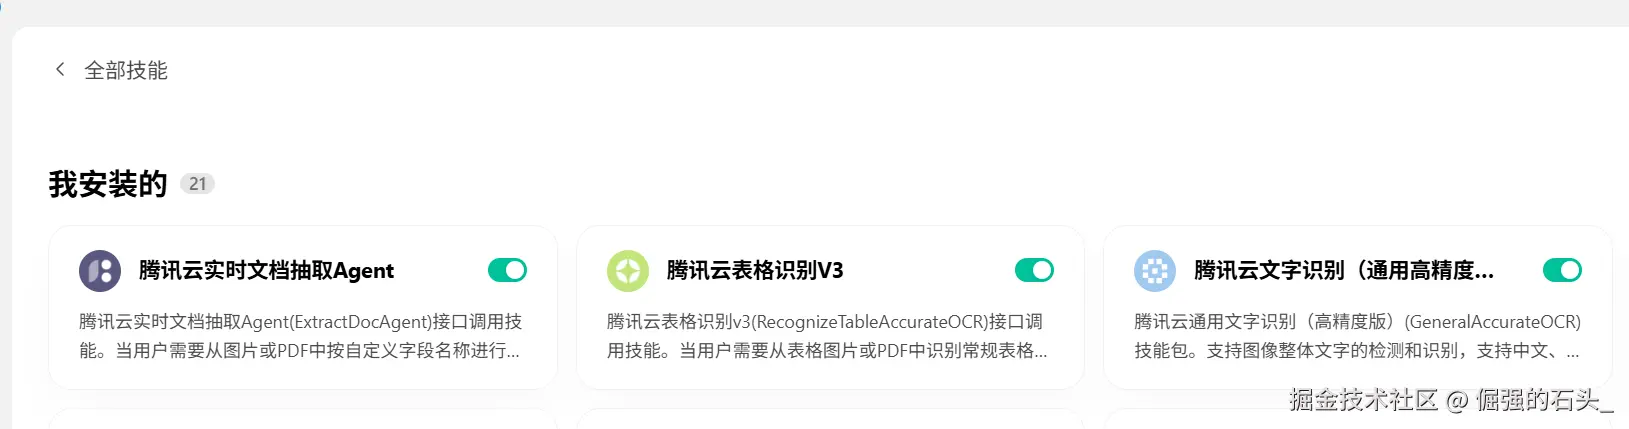
装完先别急着用------腾讯云这类 Skill 有个共同点:装好只是把"调用代码"放到了本地,真正跑起来还差 Python SDK、API 密钥和服务开通状态。这一步不做,技能可能能启动,却拿不到有效结果。
把"配环境"这件麻烦事,直接甩给 WorkBuddy
以往配 SDK、填密钥、开服务,是最劝退新手的一段。这次我干脆偷懒,直接问它:"帮我看一下我安装的这 3 个腾讯云 OCR Skill 能用吗?"
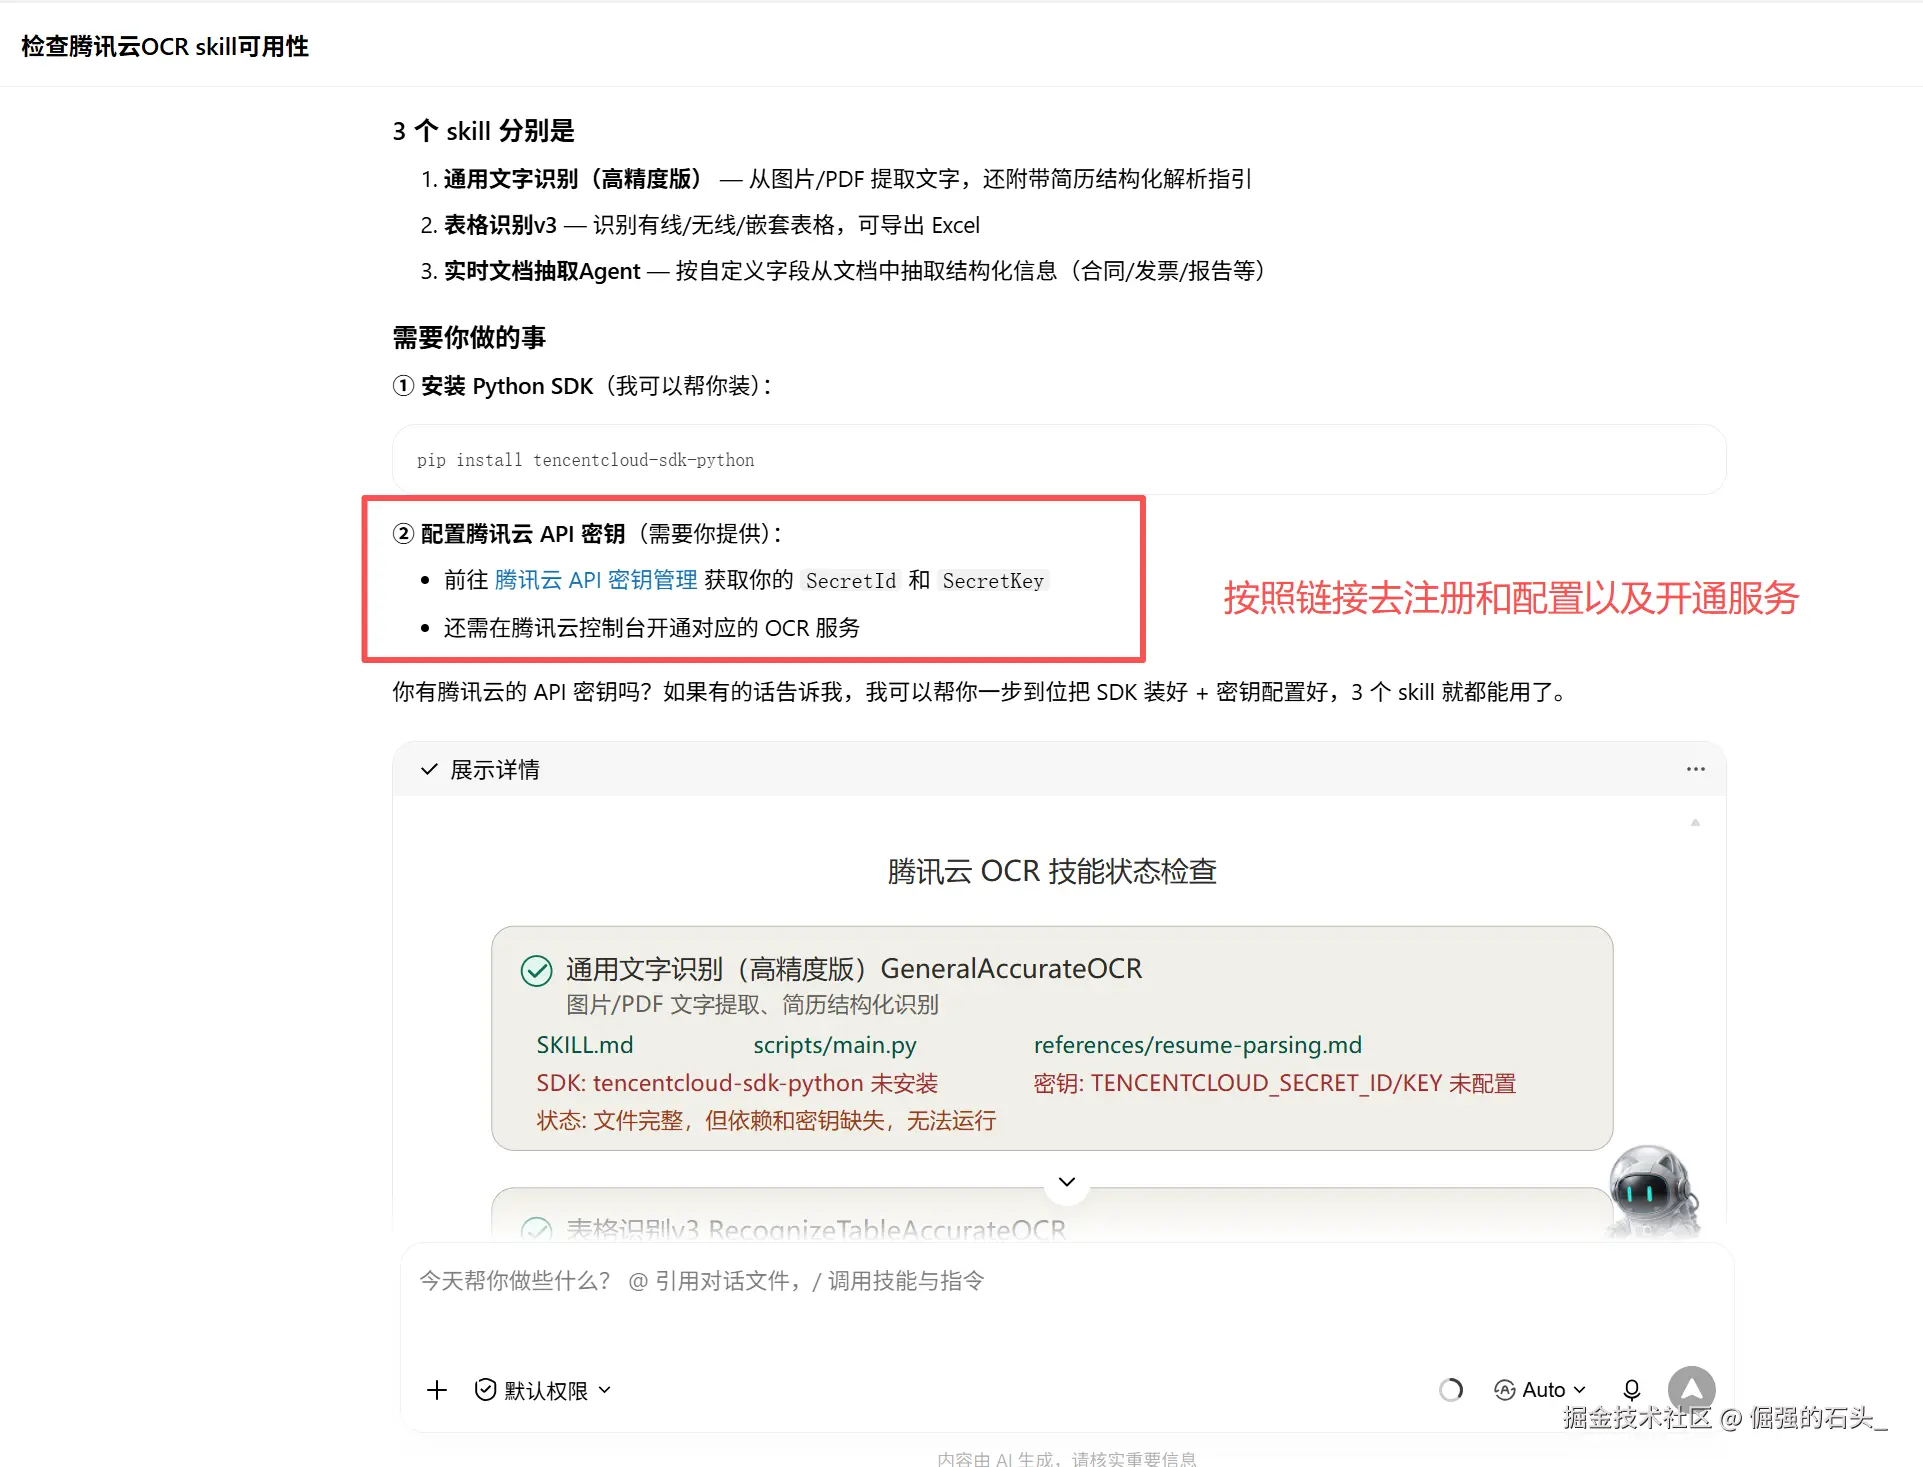
WorkBuddy 花了约 1 分 47 秒做了一轮自检,结论很清楚:
- 三个
SKILL.md、各自的scripts/main.py、env_loader.py、channel_detect.py都在; tencentcloud-sdk-python未安装;TENCENTCLOUD_SECRET_ID/TENCENTCLOUD_SECRET_KEY未配置 ,也没找到.env。
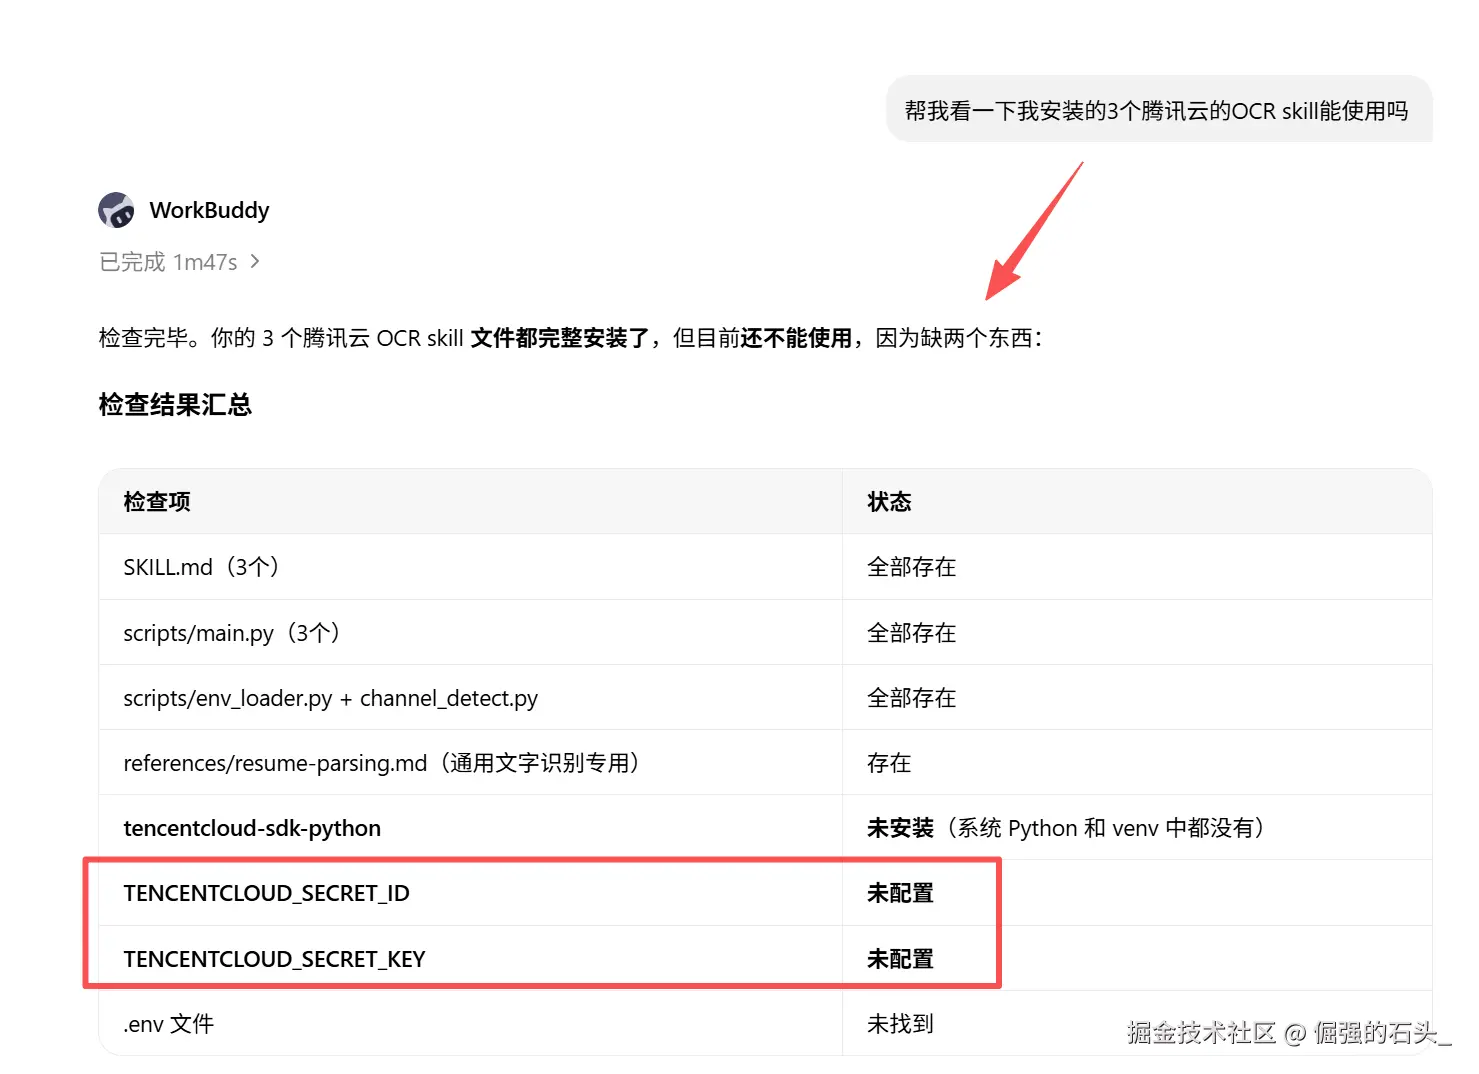
然后它直接把"你需要做的事"列了出来:① 装 Python SDK;② 去密钥管理拿 SecretId / SecretKey,并在控制台开通 OCR 服务。
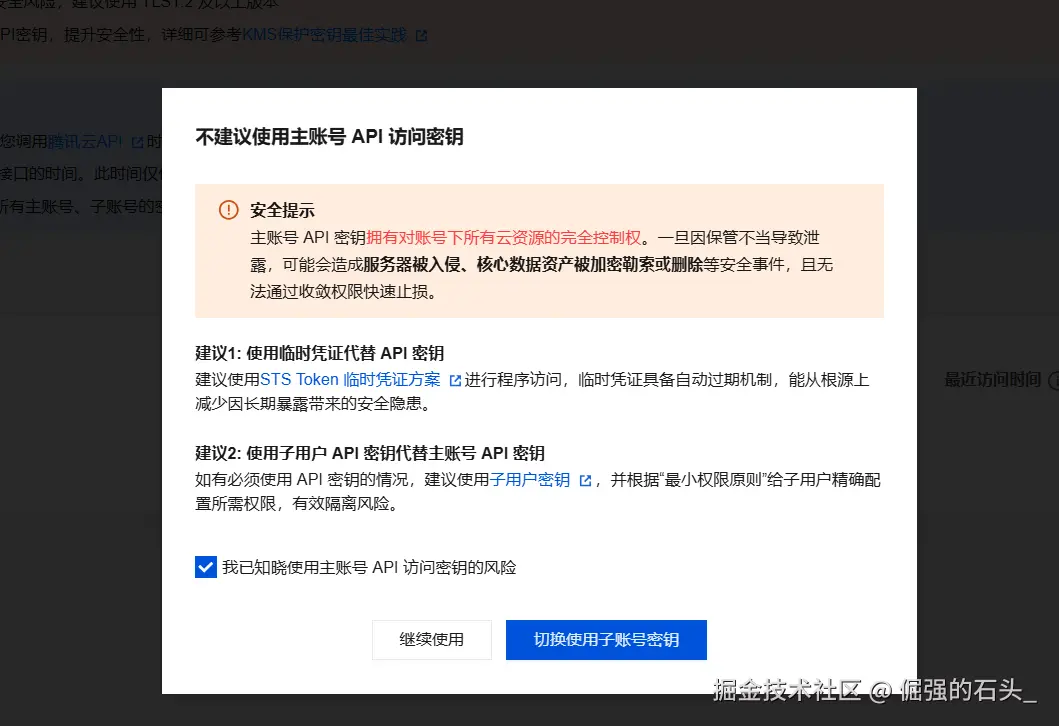
这里插一个安全提醒 :我在密钥管理页拿密钥时,腾讯云弹了个提示------不建议直接使用主账号的 API 密钥,更规范的做法是建子账号、按最小权限授权。另外,SecretKey 千万别截图外泄 ,下面所有涉及密钥的地方我都只用名字指代。
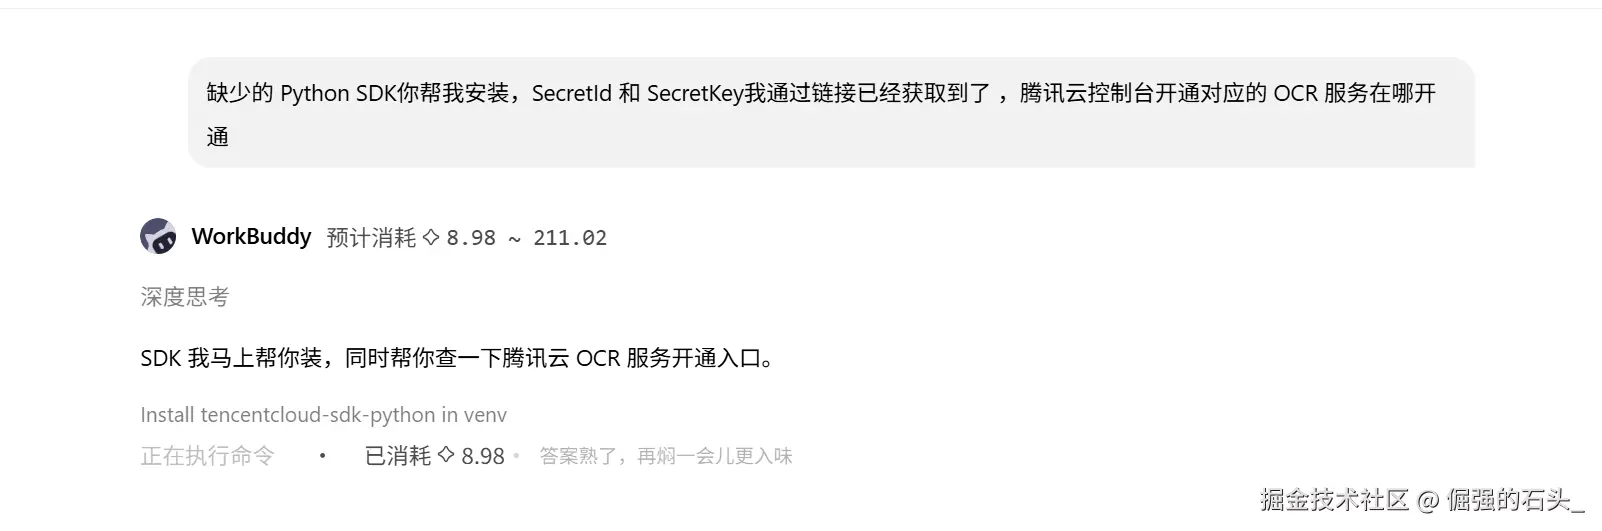
接着我把话接过来:"缺的 SDK 你帮我装,SecretId / SecretKey 我已经拿到了,OCR 服务去哪开通?"WorkBuddy 一边在隔离的虚拟环境里装 tencentcloud-sdk-python,一边把开通入口给我指了出来。
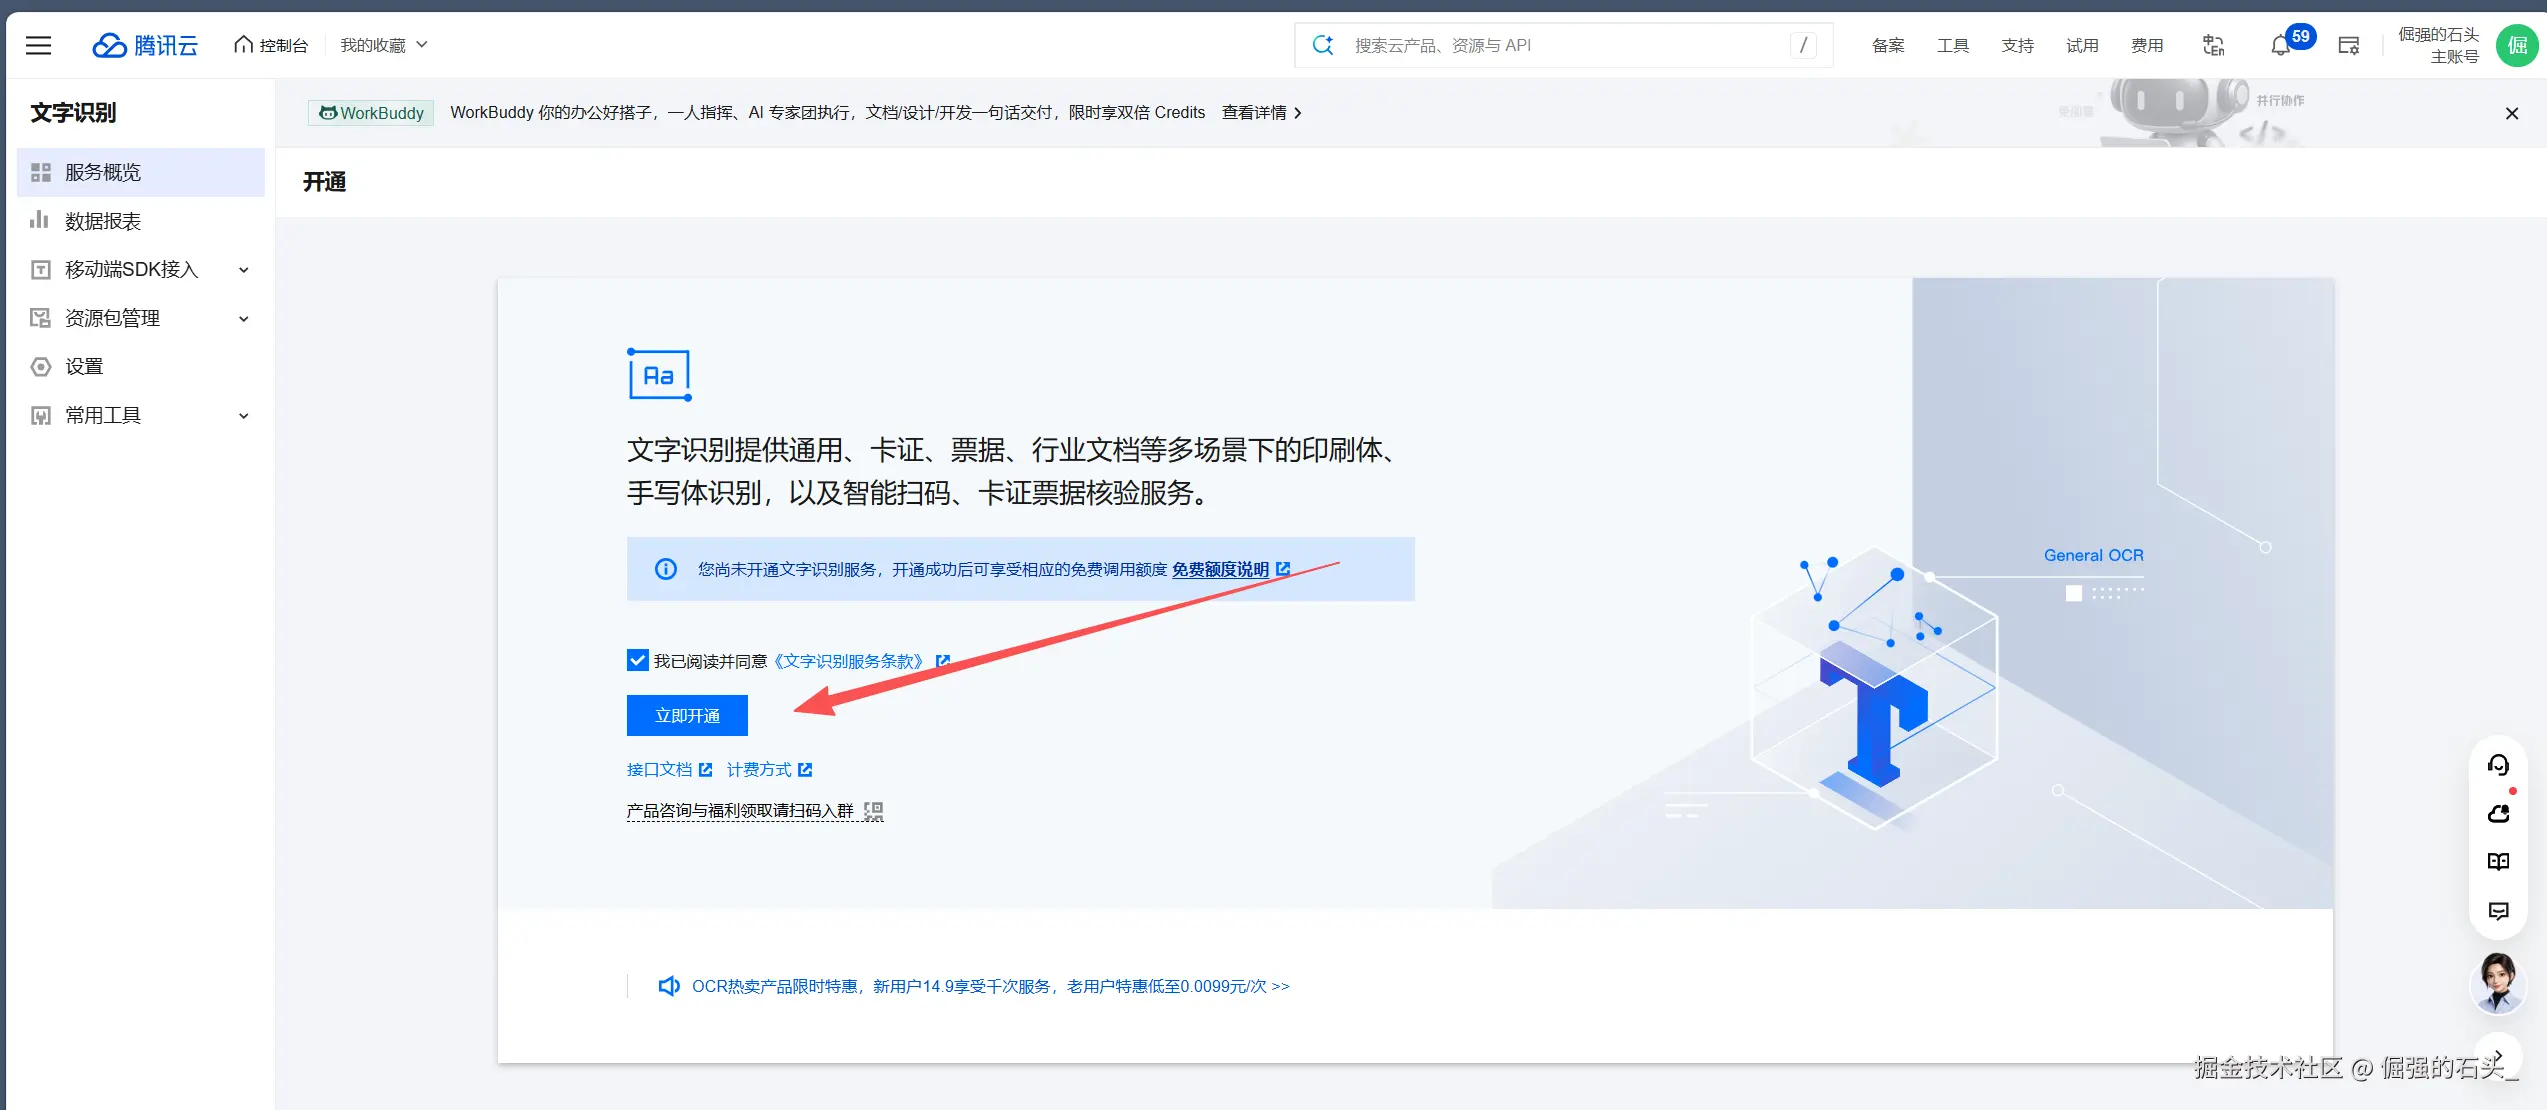
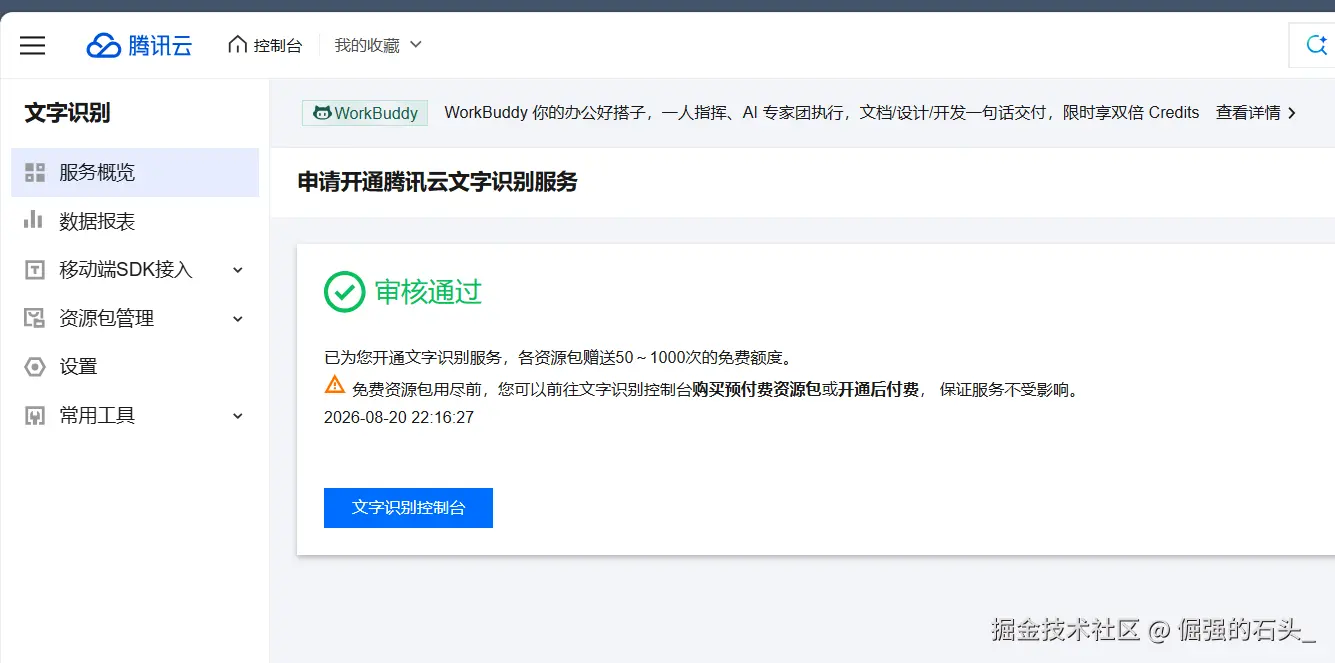
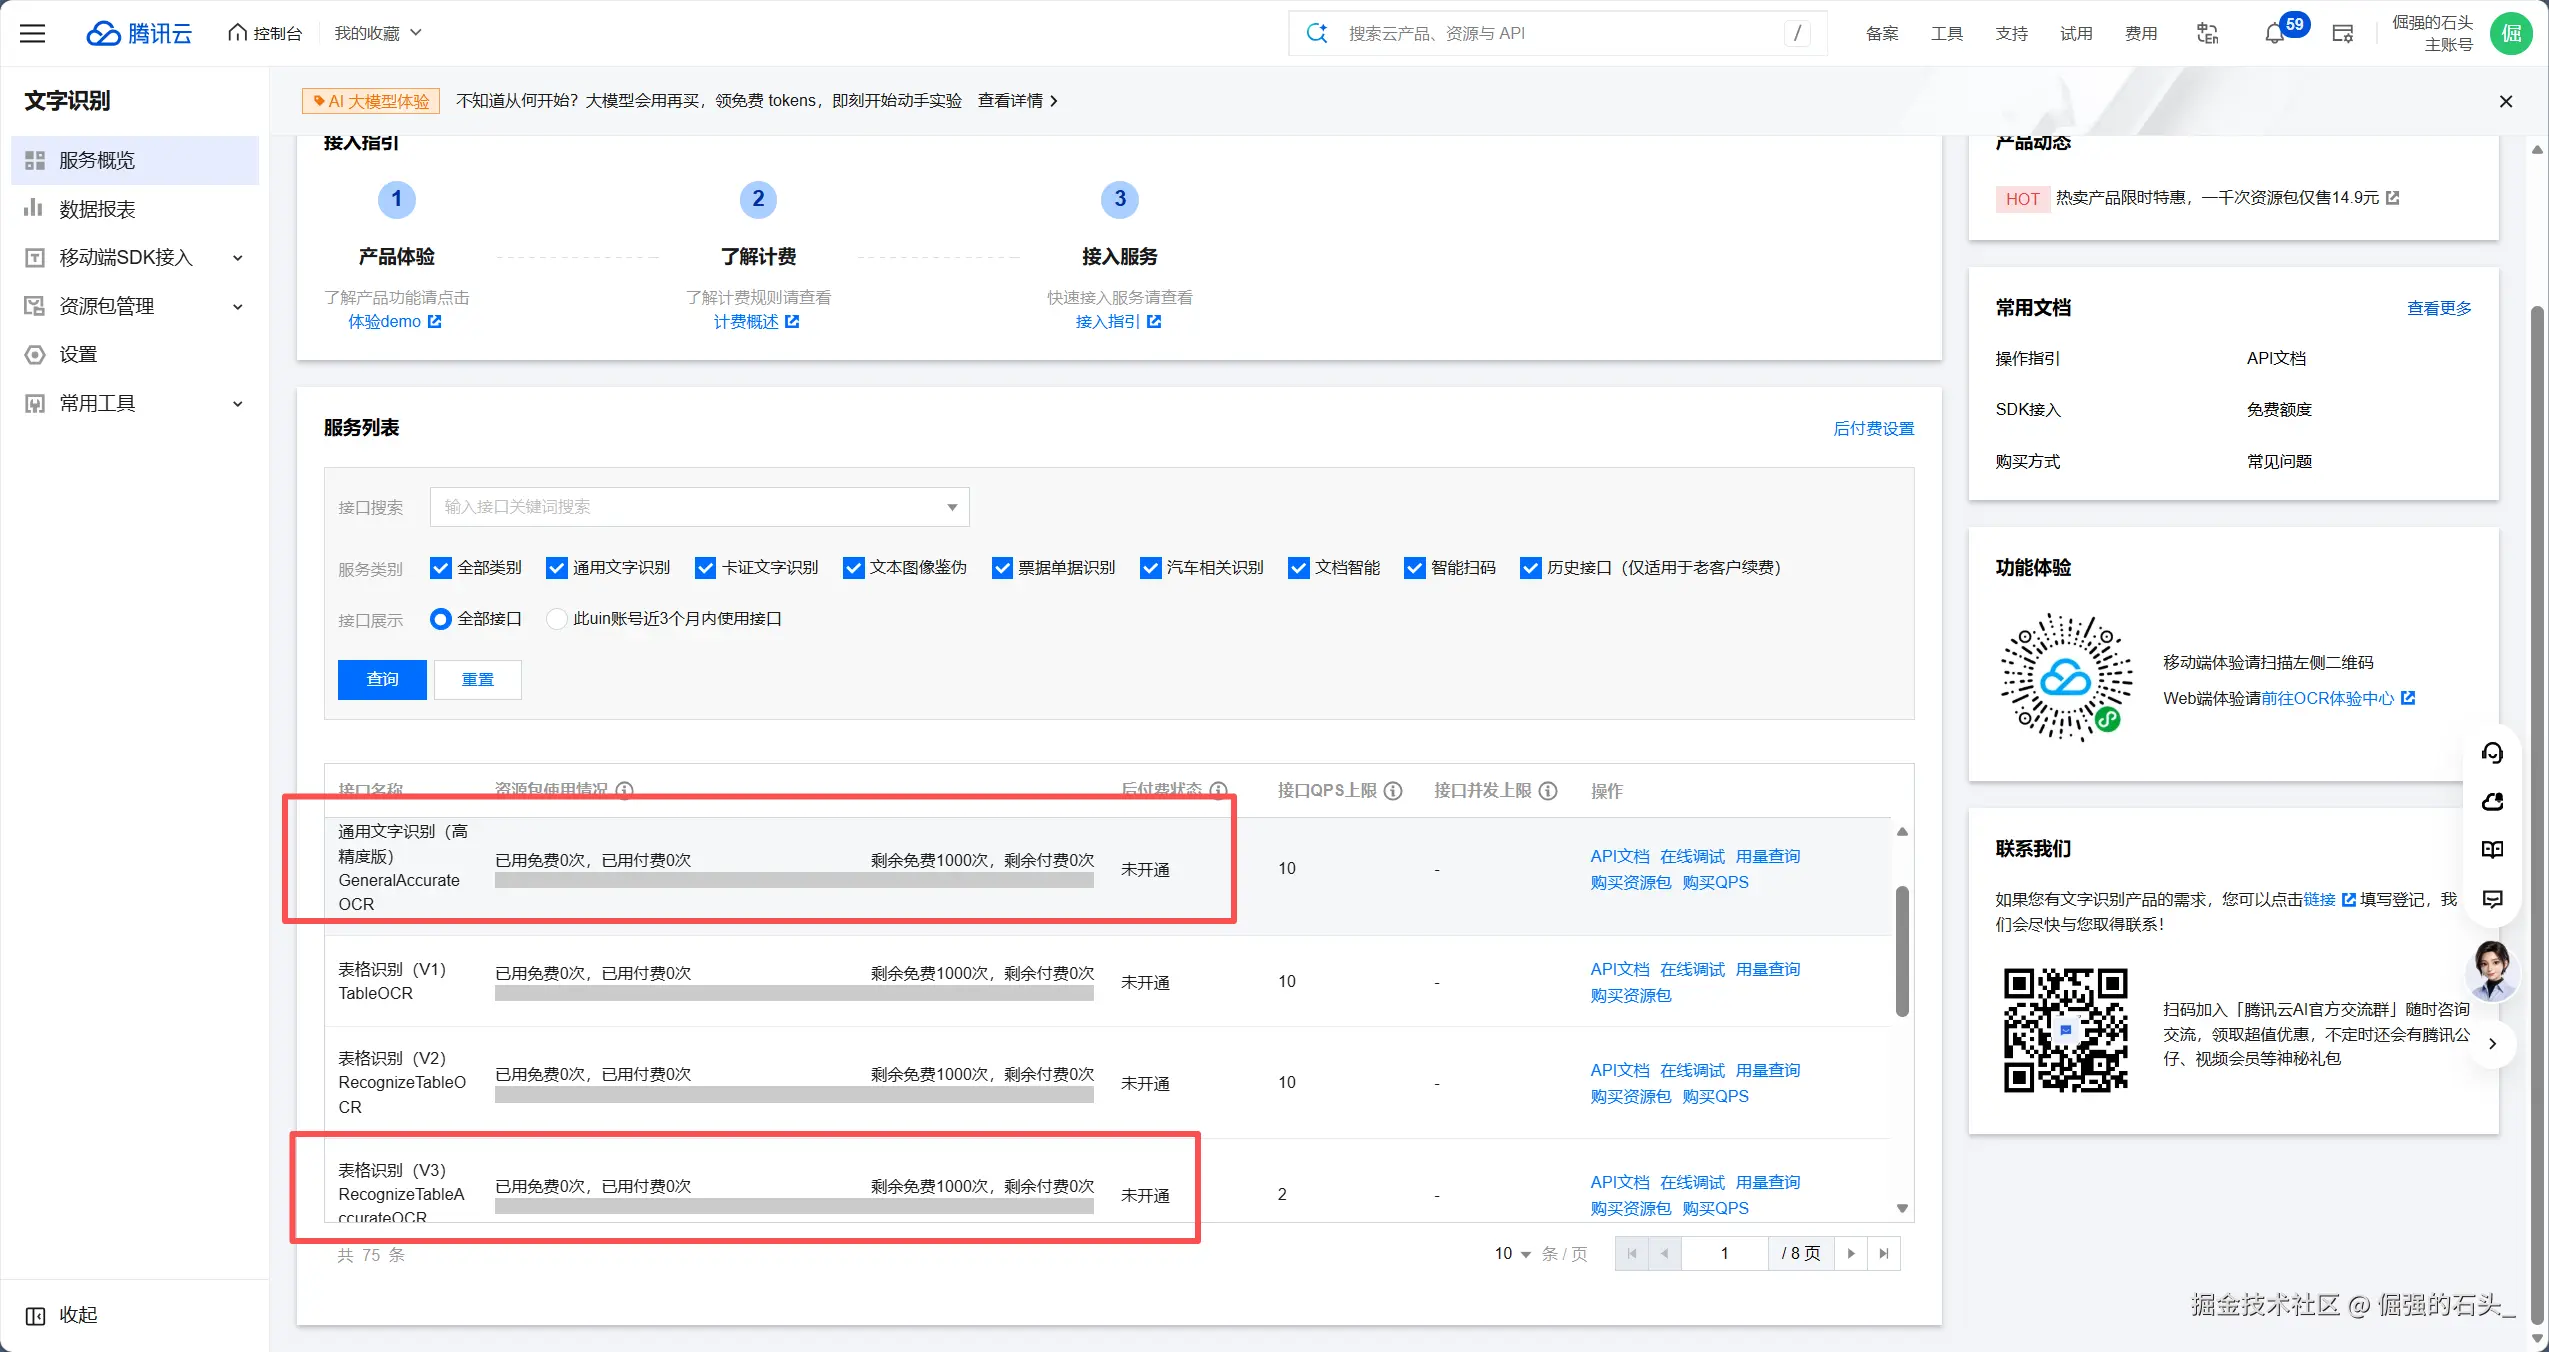
我照着去控制台点了"立即开通"文字识别服务,每个接口都带了免费额度(几十到 1000 次不等),测试完全够用。
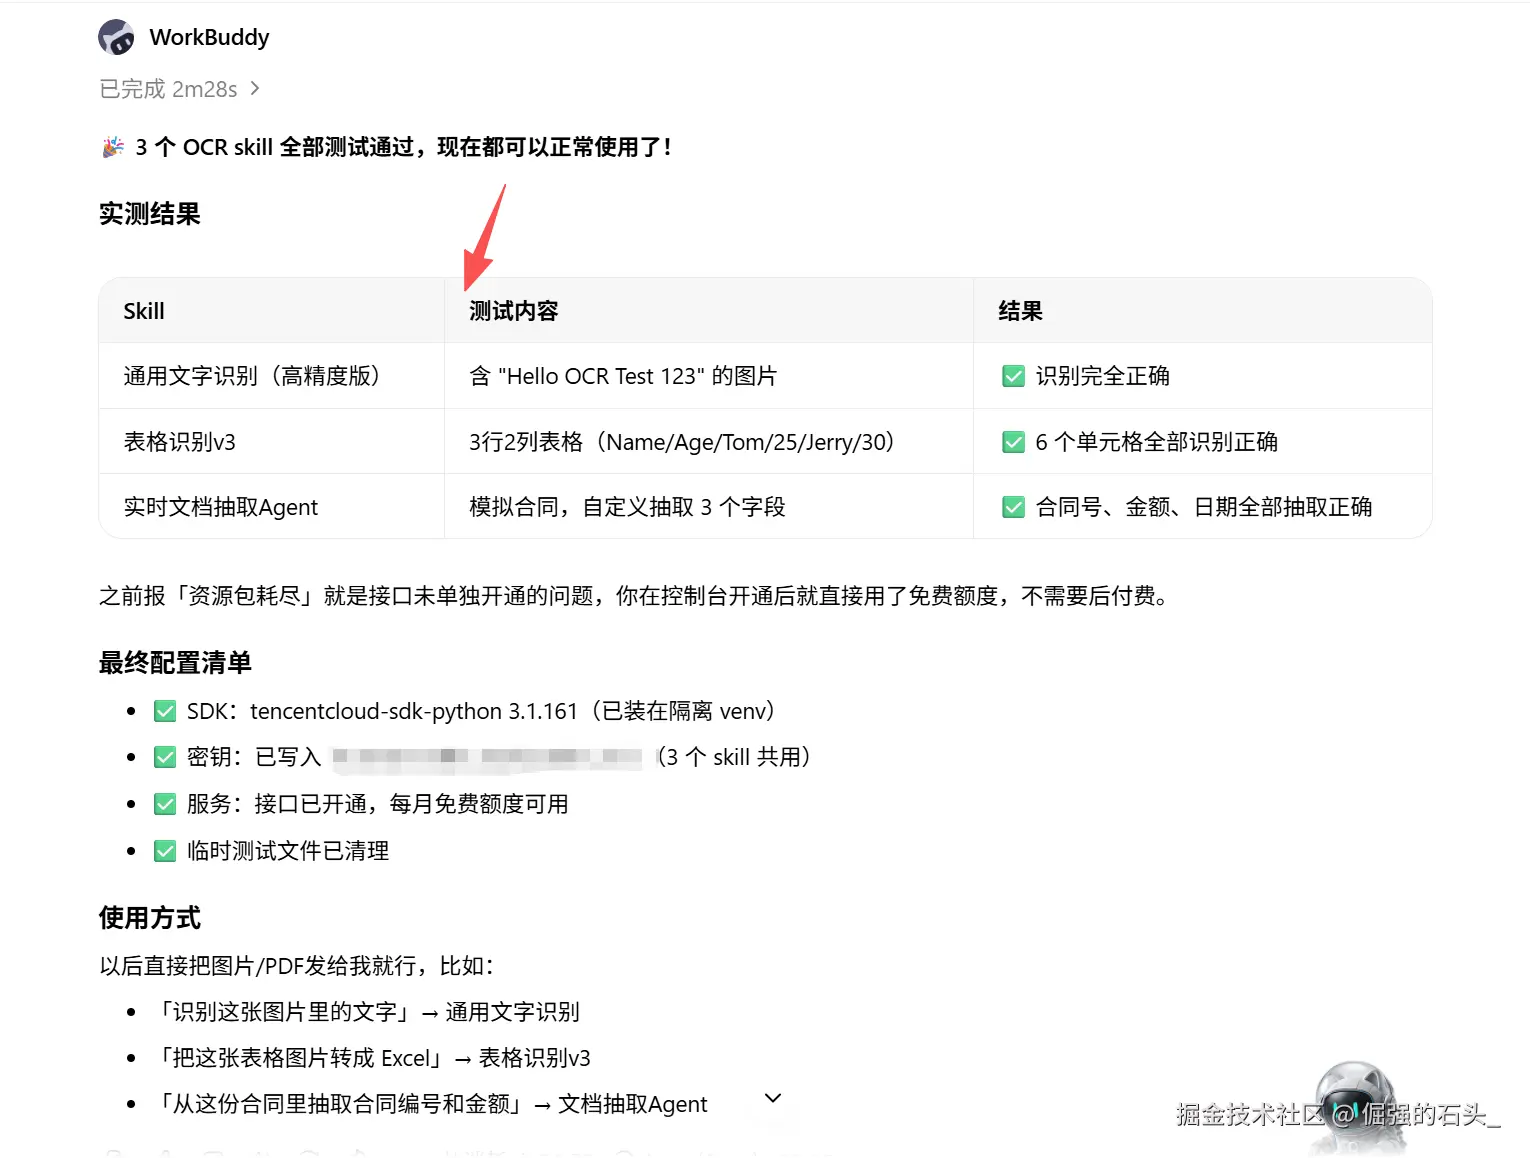
全部配好后,它又主动跑了一轮端到端验证:
- 通用文字识别:一张 "Hello OCR Test 123" 的图,识别完全正确;
- 表格识别 V3:一个 3 行 2 列的表,6 个单元格全对;
- 文档抽取 Agent:一份模拟合同抽 3 个字段,全中。
最终环境定型:SDK 3.1.161(隔离 venv)、密钥(三个 Skill 共用)、服务已开通,临时测试文件自动清理。
这一段我觉得挺有意思:整个"装 SDK + 配密钥 + 开服务 + 自检验证",我几乎没手动敲命令,是用对话让 Agent 自己诊断、自己动手完成的。这也是我后面敢让它直接封装技能的底气。
关键一步:让 WorkBuddy 把三个 Skill 封装成"合同审查助手"
三个技能各自验证通过后,我真正上手审了一份合同,立刻感到别扭:先调文字识别取全文、再调表格识别、再调抽取 Agent,最后还得自己拼风险判断------每份合同都这么手动串一遍,跟我最初"丢进去、出报告"的设想差太远。
于是我把需求原原本本讲给 WorkBuddy,让它把这三个能力编排成一个专用技能:自动判格式、该 OCR 就 OCR、该读表格就读表格,再按合同要素抽取,最后跑风险规则、出报告。
它花了约 14 分 ,创建并自测通过了一个叫 contract-review-assistant(合同审查助手)的技能。结构是这样的:
ruby
~/.workbuddy/skills/contract-review-assistant/
├── SKILL.md                 # 技能描述与使用说明
├── scripts/
│   ├── main.py              # 主编排:格式检测→OCR→要素抽取→风险分析→报告
│   ├── contract_fields.py   # 20 项合同要素定义 + 正则匹配
│   ├── risk_rules.py        # 7 大类风险规则引擎
│   ├── report_generator.py  # HTML 报告生成器
│   ├── env_loader.py        # 密钥加载(复用自 OCR skill)
│   └── channel_detect.py    # 渠道探测(复用自 OCR skill)
└── references/
    └── risk_rules.md        # 风险规则详细文档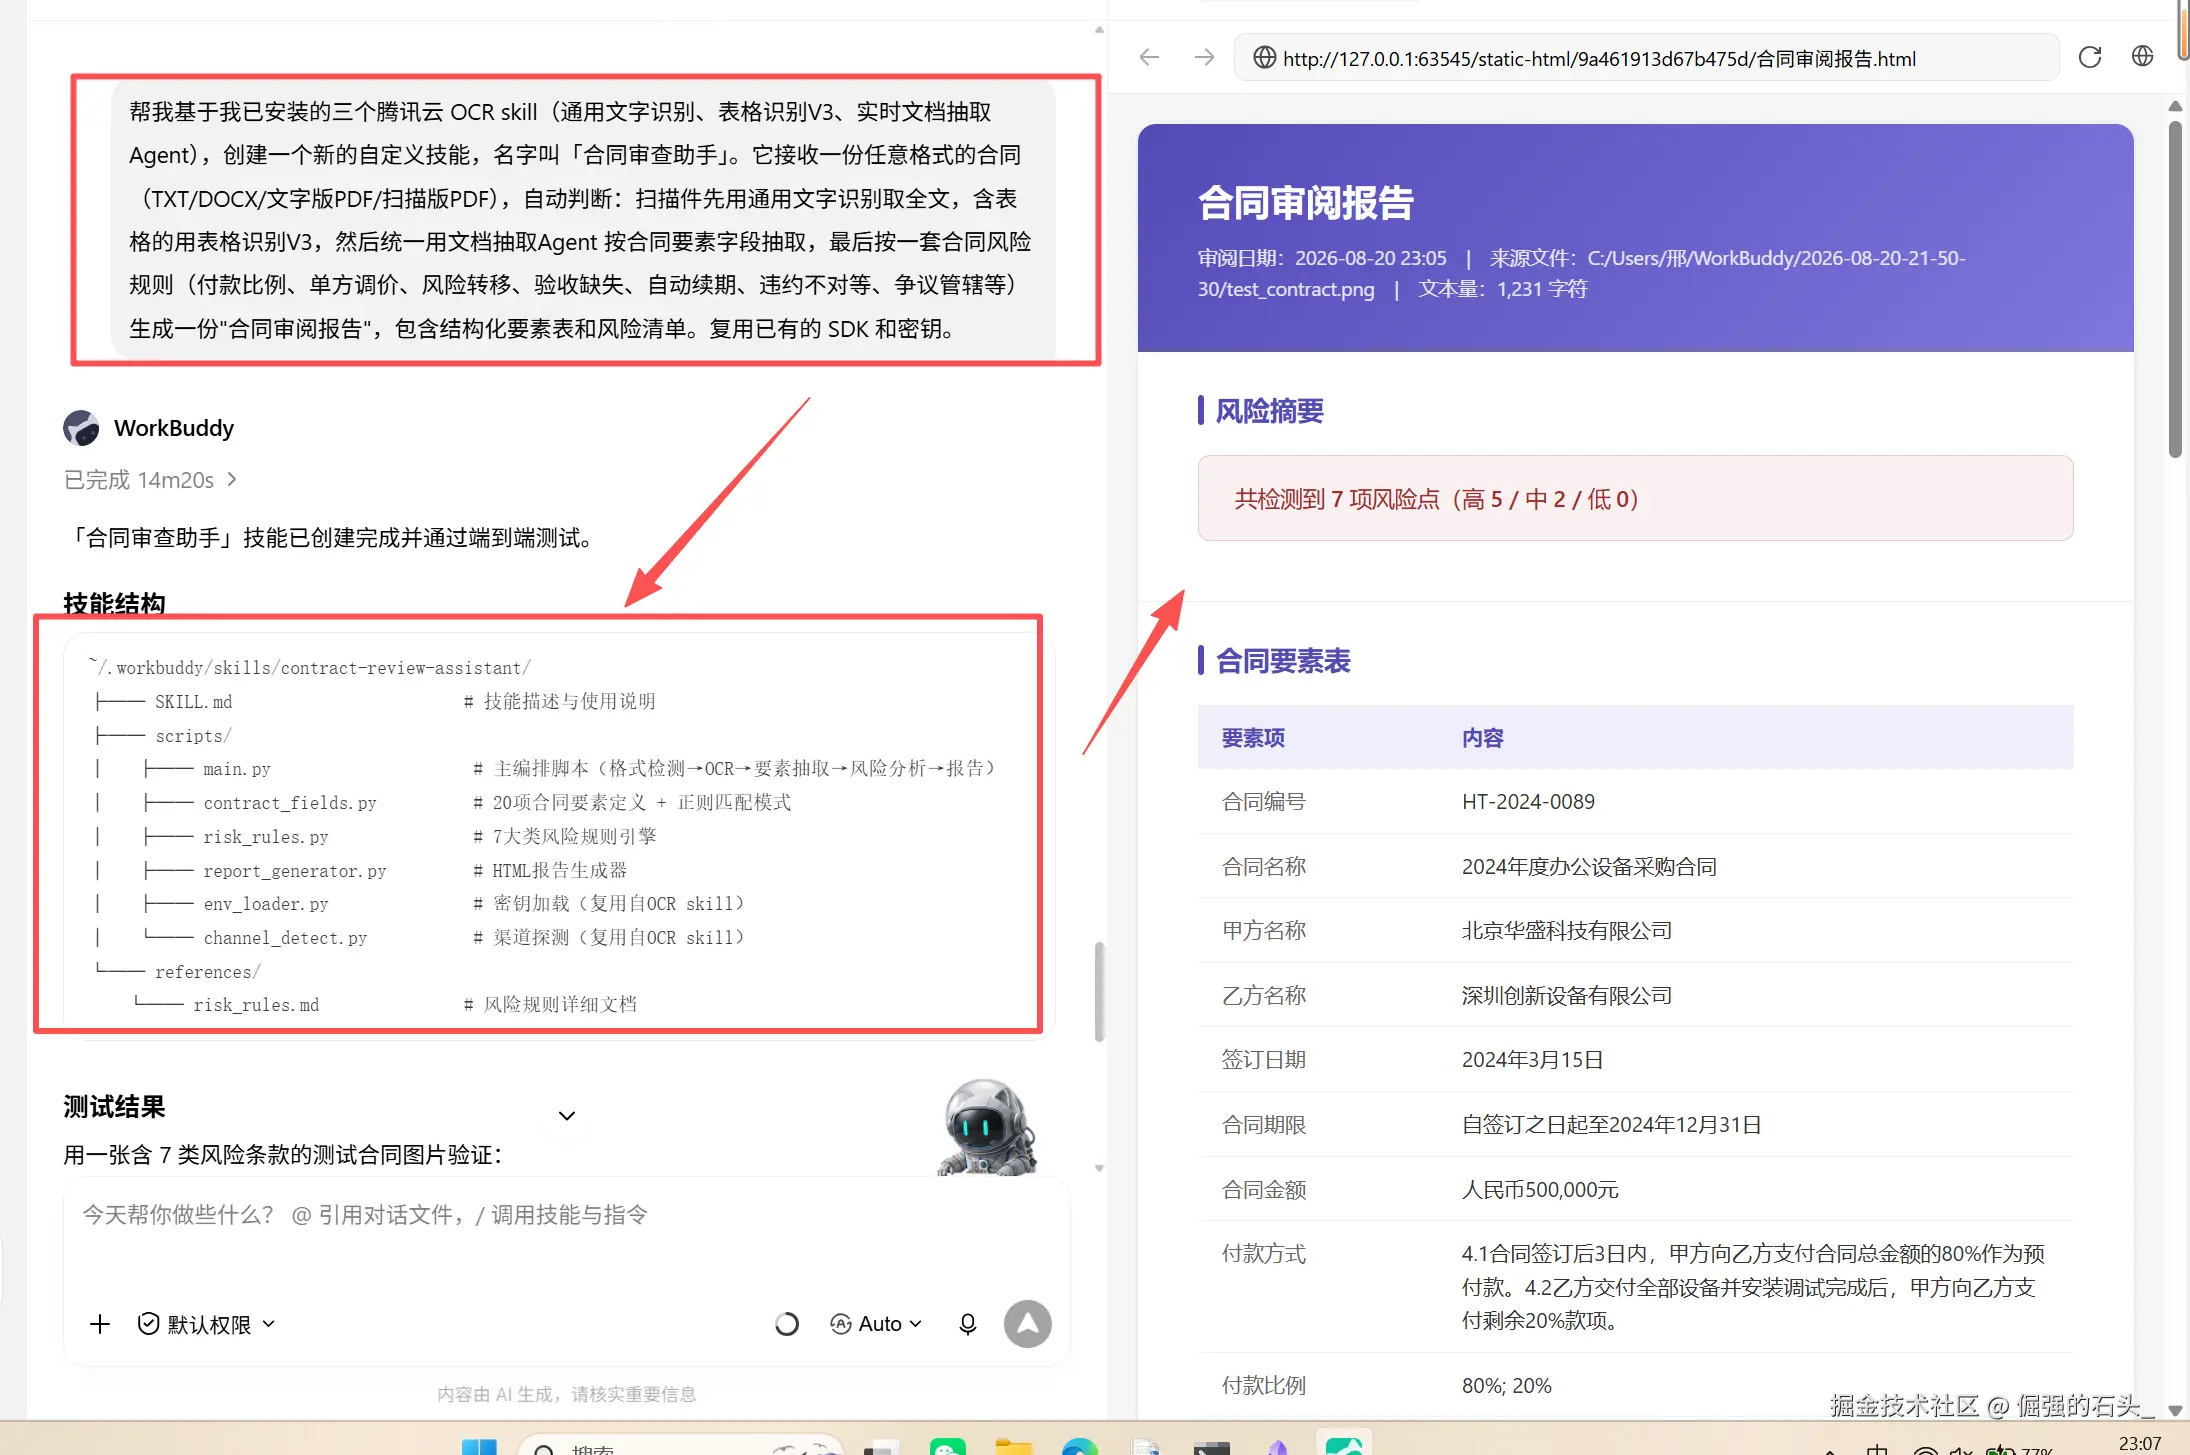
它用一张自制的 test_contract.png 做了端到端验证:格式检测正确识别为图片 → 文字识别取出 615 字符 → 表格识别完成 → 文档抽取 20/20 → 风险规则命中 7 项(5 高 2 中)。用法也很简单:直接把合同文件发给它 ,或者在终端跑 python scripts/main.py --input 合同文件路径,产出 合同审阅报告.html + 审查结果.json。
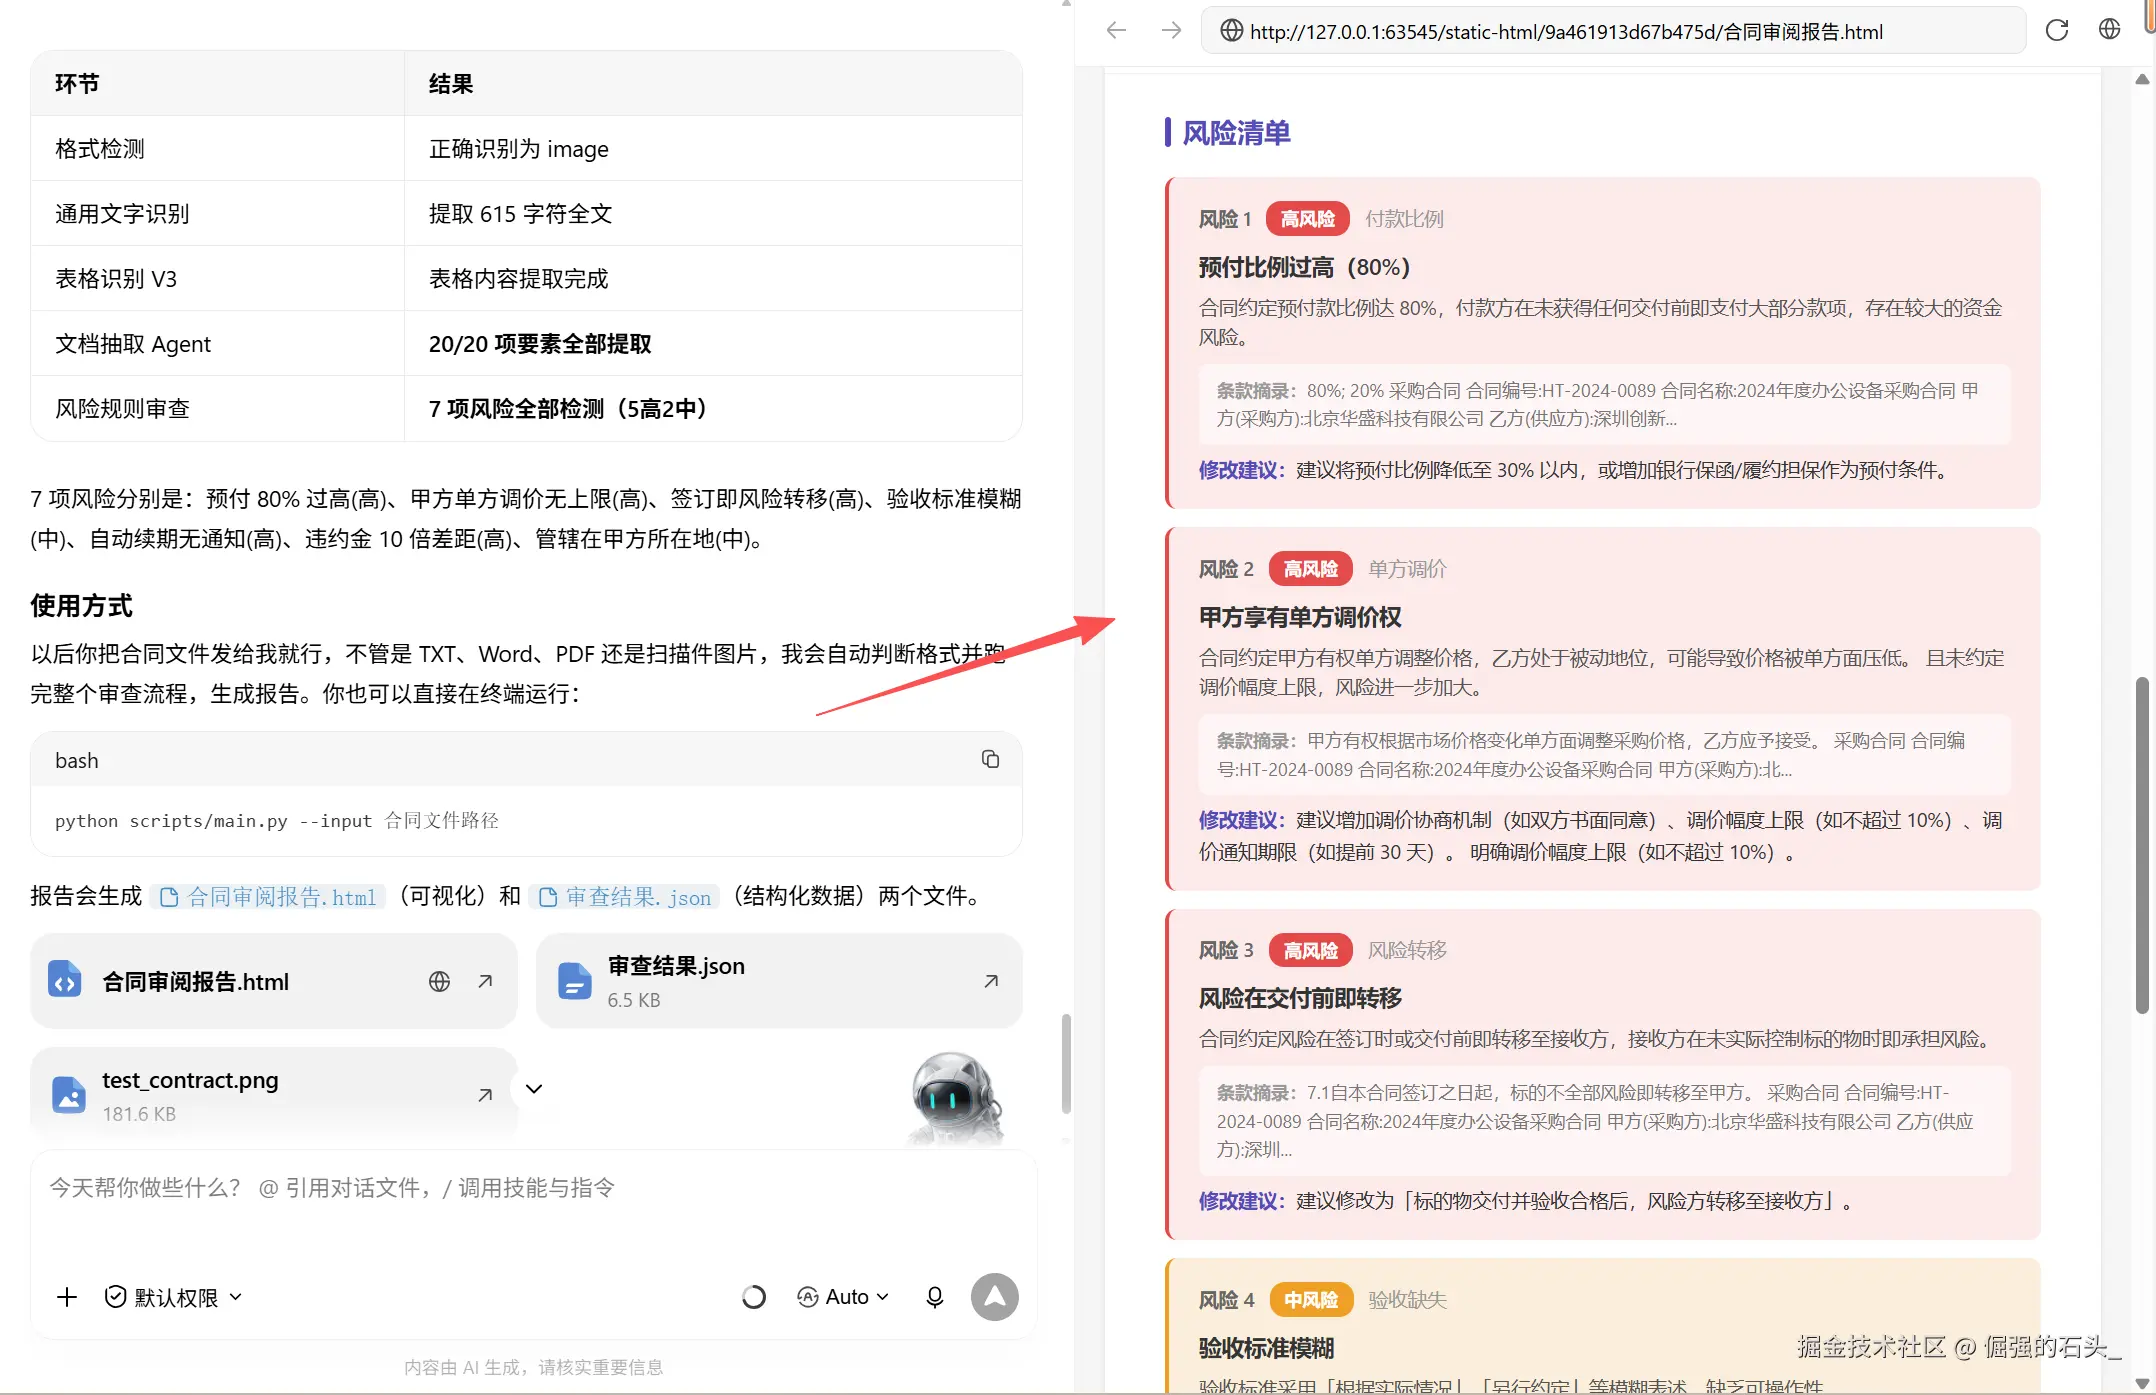
到这一步,"专用大脑"就算捏出来了。接下来是真正的考验------拿 5 份格式各异的虚构合同挨个喂。这里特意强调"虚构",因为文章展示的是流程和边界,不涉及真实合同信息。
真刀真枪:5 份不同格式的合同实测
我准备了 5 份覆盖不同格式和难度的合同样例(全部为虚构测试材料 ,甲乙方、金额、地址均系编造),由易到难上传,重点看三件事:内容有没有读全、要素抽得全不全、风险主体有没有写反。第三项是后来才意识到的关键验收点。
TXT 文字版:第一次就翻车,然后它自己把自己修好了
第一份是纯文本的《工业传感器采购合同》。我说"用合同审查助手分析一下",它自动调用了刚封装的技能。
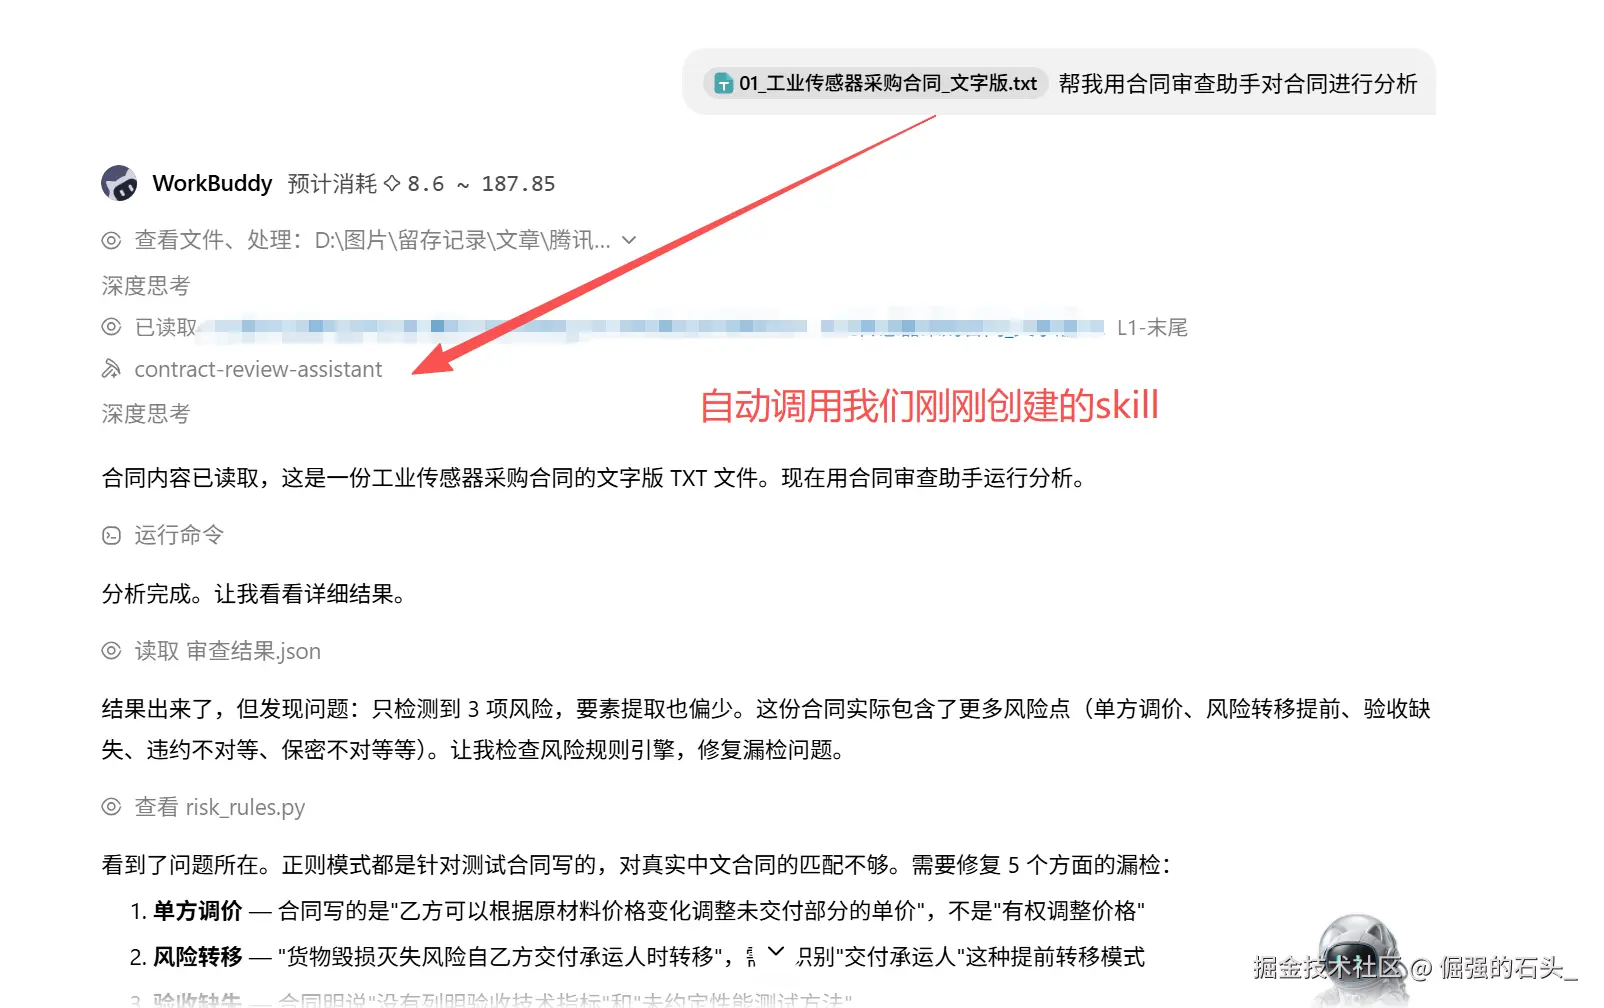
但第一次跑就露馅了 :只检出 3 项风险、要素才抽到 12/20,明显偏少。更让我意外的是,WorkBuddy 自己发现了问题,去查了 risk_rules.py,给出的判断是:"正则模式基本是照着那份测试合同写的,对真实中文合同的表述覆盖不够",随后自动补了单方调价、风险转移、验收标准缺失等 5 处漏检规则。
修复后重跑(这一份含自我优化总耗时约 12 分 31 秒):要素 12/20 → 17/20,风险 3 项 → 11 项(7 高 4 中) ,把付款比例畸高、单方调价、风险转移提前、验收标准缺失、自动续期、违约责任失衡、争议管辖在乙方等埋进去的雷基本都挖了出来。
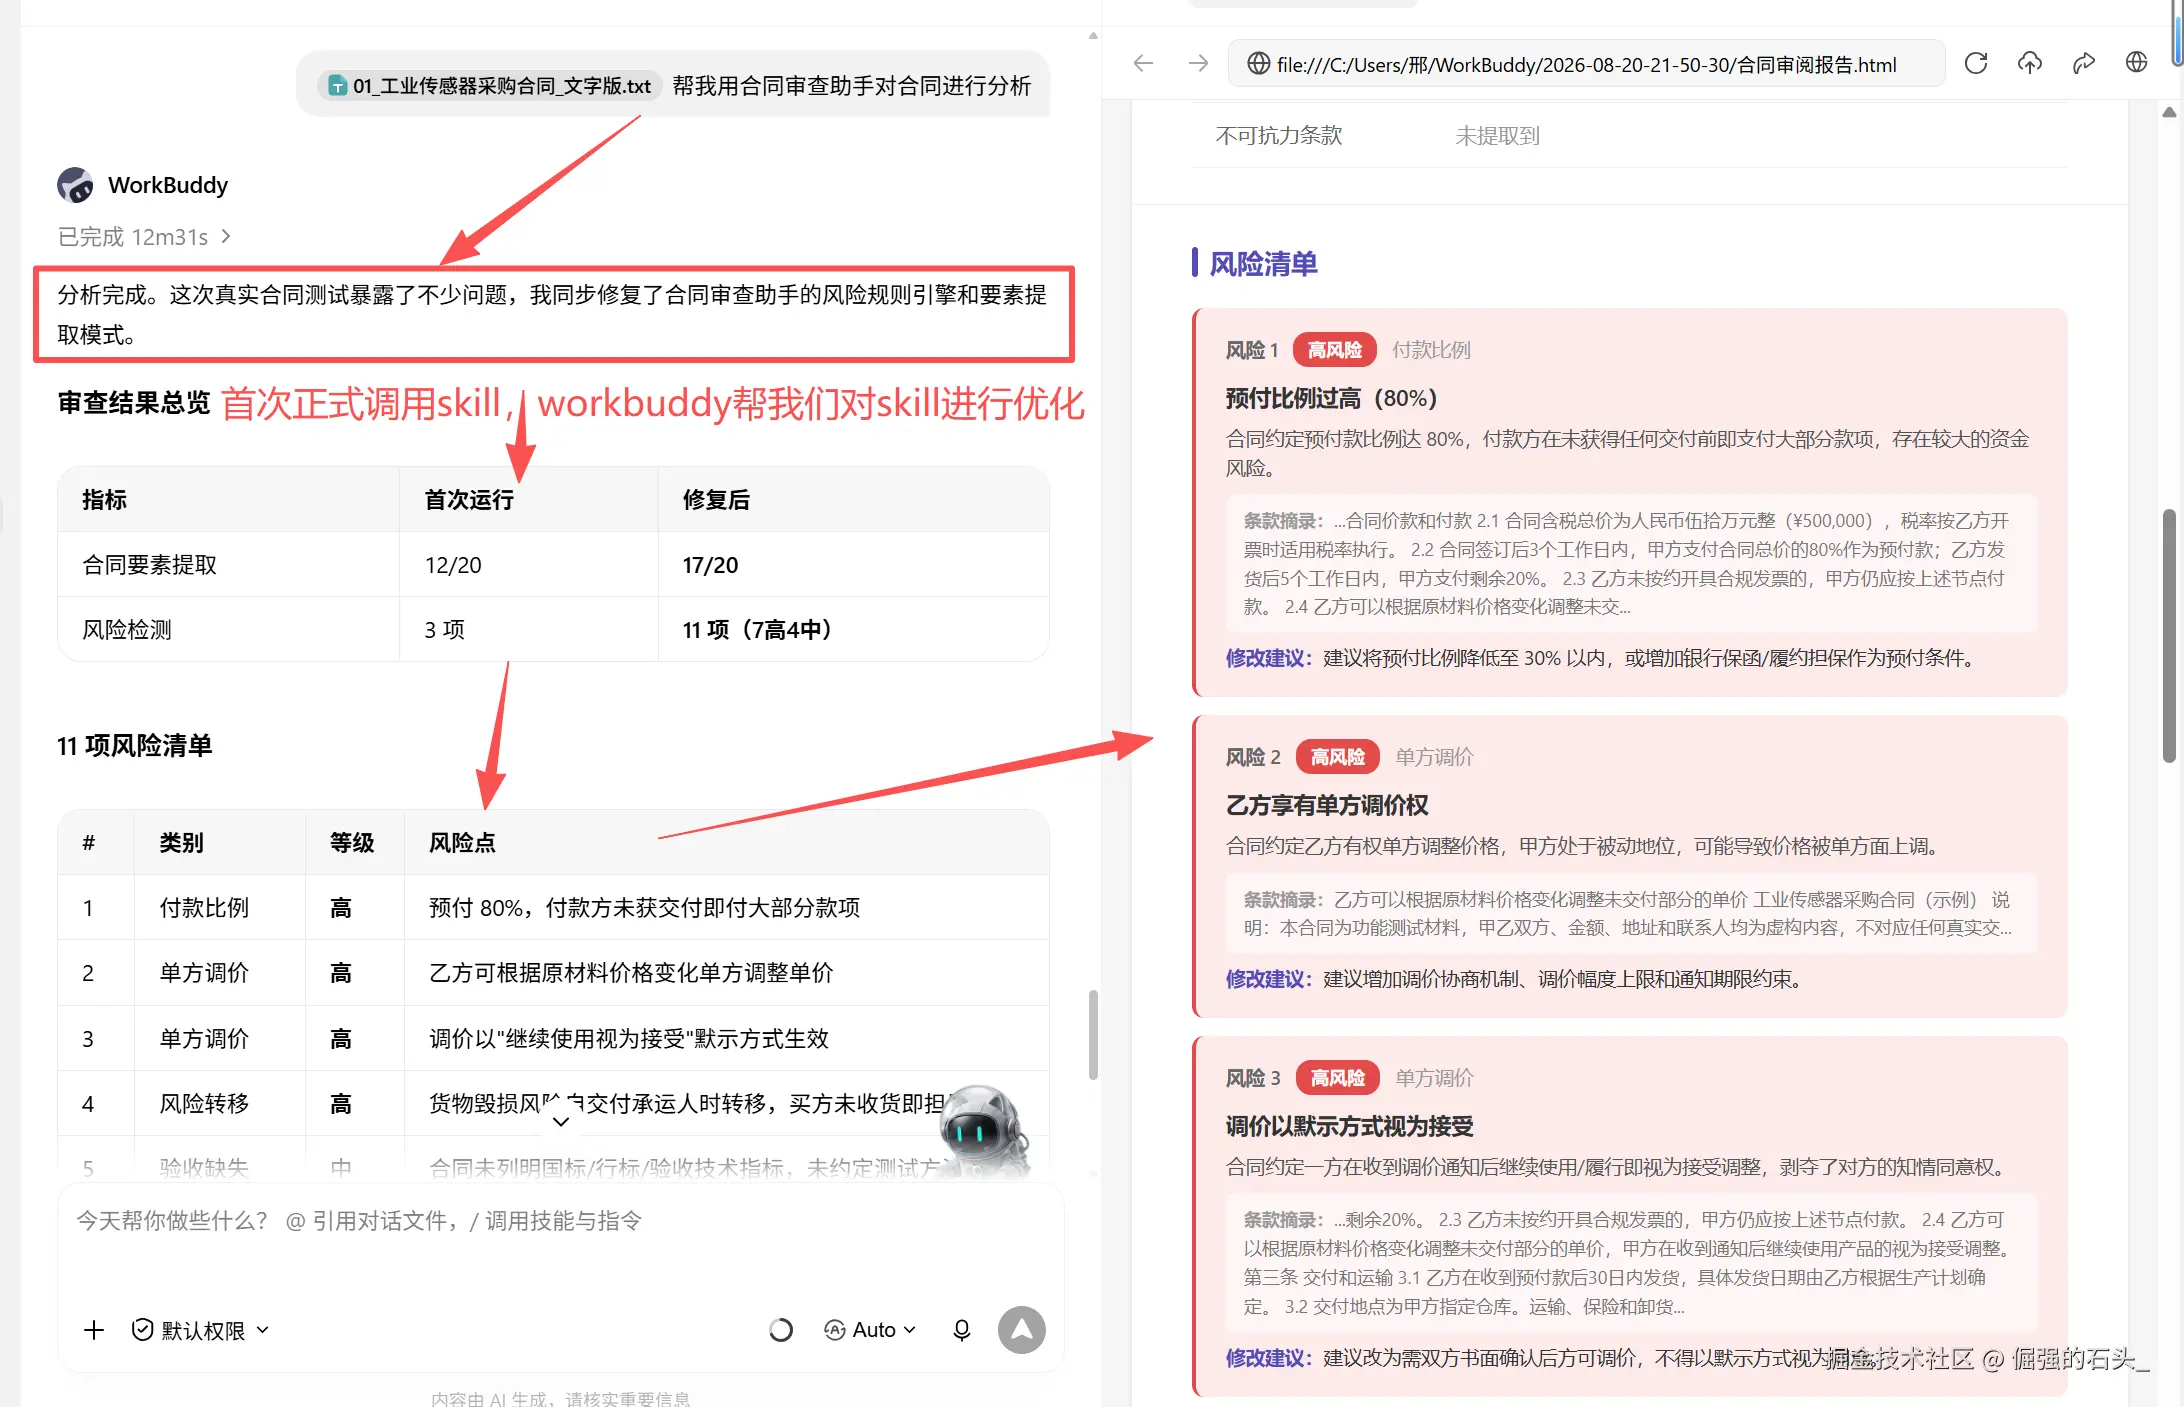
我的判断:这段"翻车 → 自诊断 → 自修复"其实比一次跑通更有价值------它暴露了规则引擎的真实软肋,也说明拿真实语料回测有多重要。规则被补上之后,还要继续观察误报有没有增加。
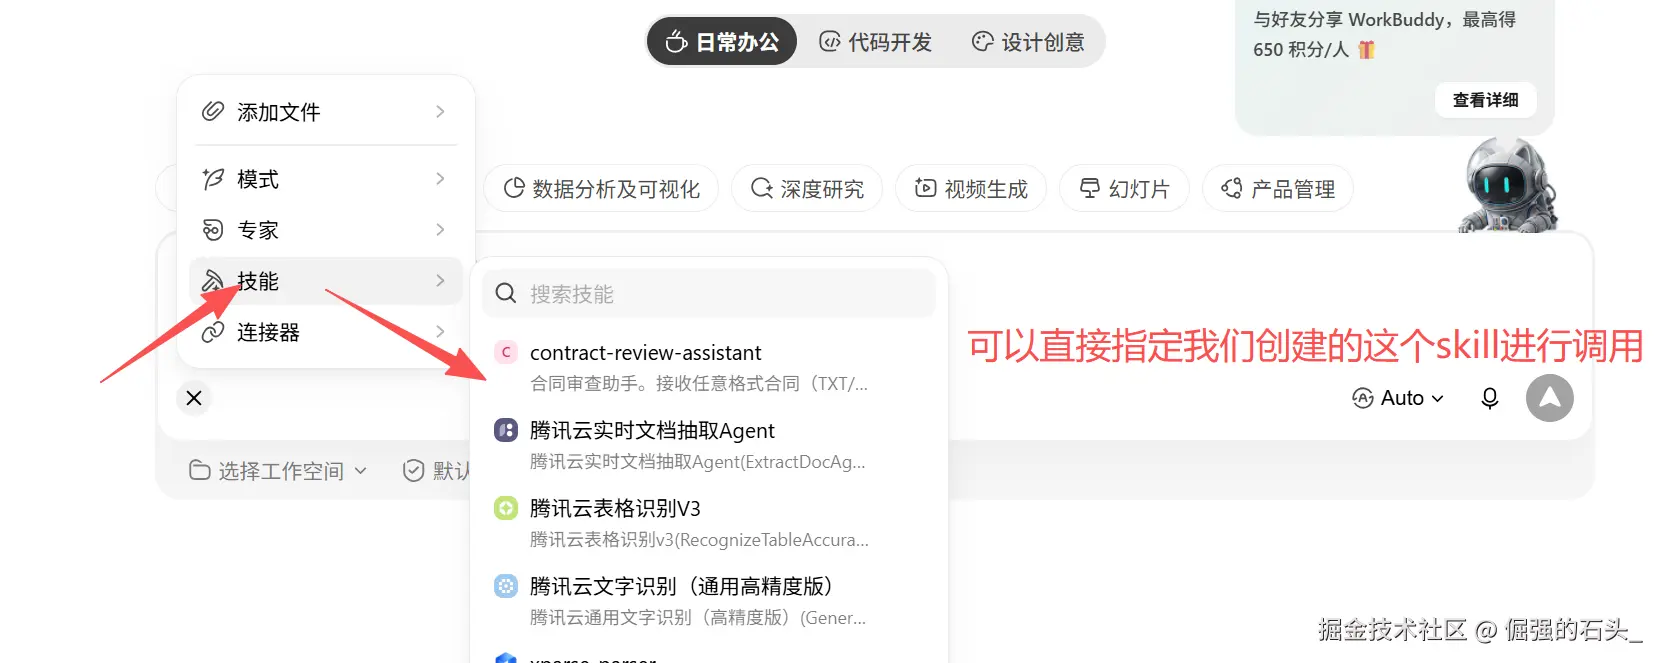
顺带说一下调用方式
技能封装好之后,除了自然语言唤起,也能在技能菜单里直接选 contract-review-assistant 指定调用,省得它去猜。
DOCX 表格版:52 秒搞定
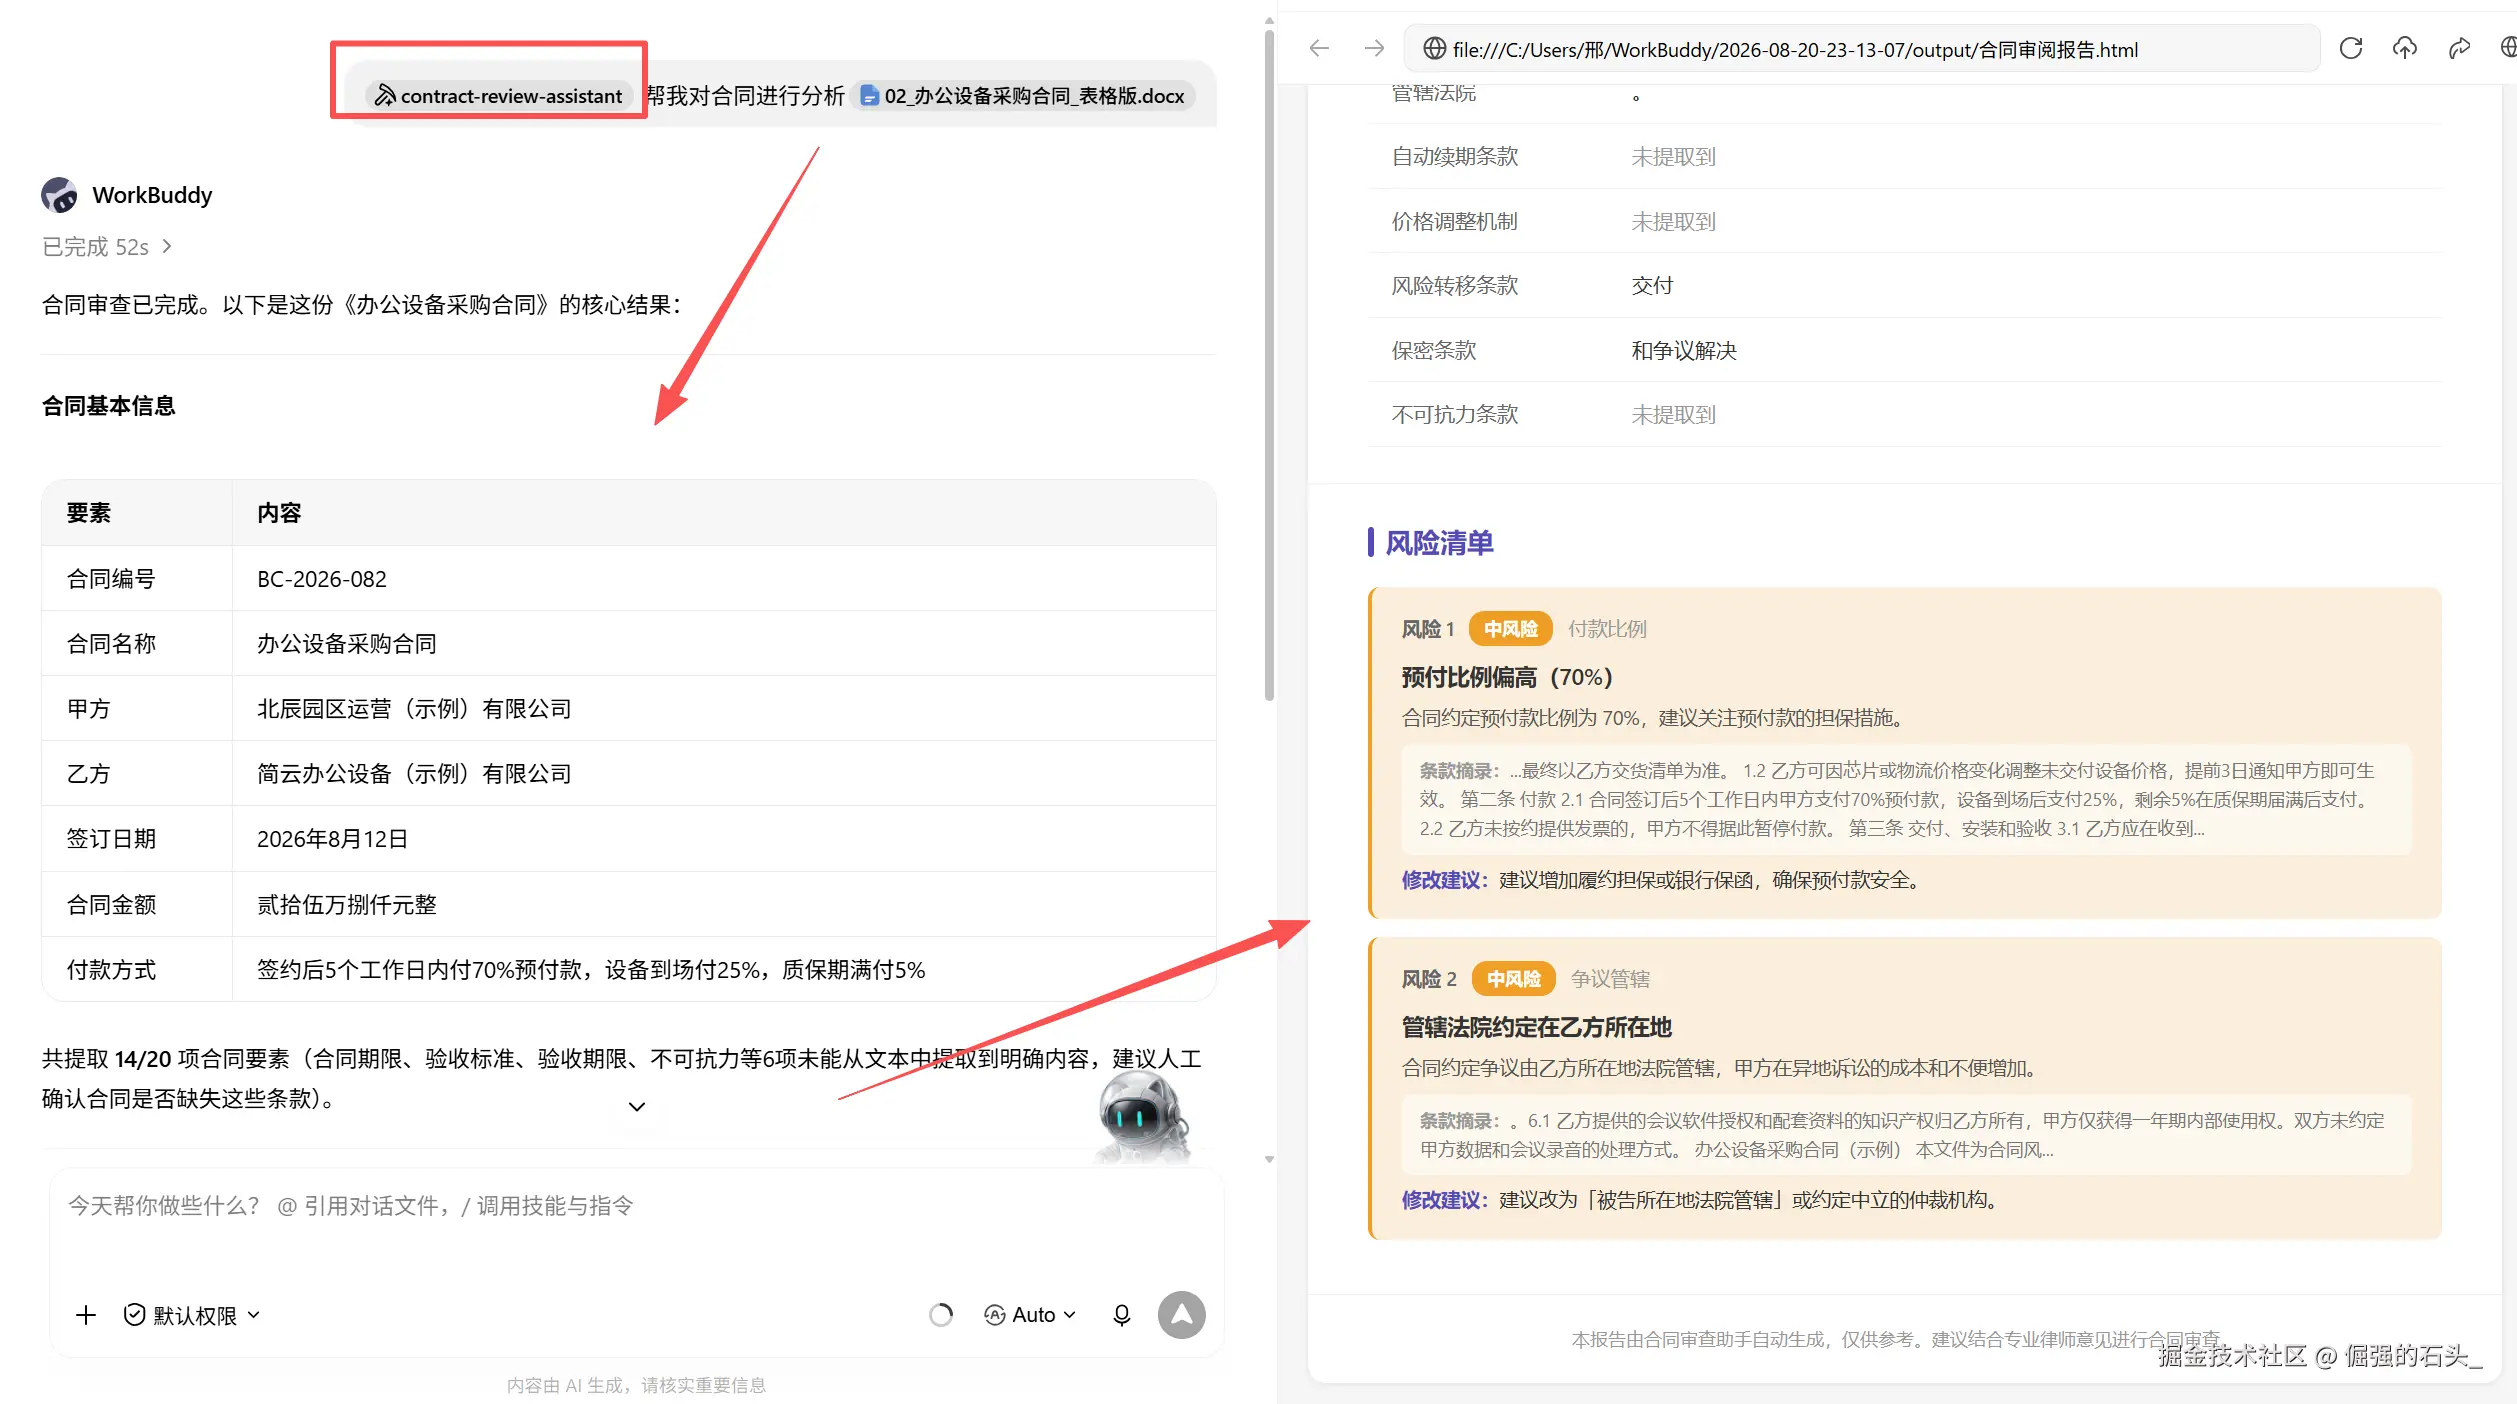
第二份是带采购清单表格的《办公设备采购合同》(DOCX)。这份最省心,52 秒跑完,抽到 14/20 要素,检出 2 项风险(均为中):预付 70% 偏高、争议管辖在乙方所在地。表格里的型号/数量/单价也被规整地读了出来,没有串行串列。
文字版 PDF:识别出 8 项风险,也暴露了一个方向性 bug
第三份是带文字层的《云服务采购合同》PDF。跑了约 4 分 44 秒,检出 8 项风险(4 高 4 中),整体判断"对甲方非常不利":100% 预付、SLA 指标全缺失、自动续期叠加乙方单方定价、无验收考核(高);数据条款缺失、免责过宽而赔偿封顶偏低、甲方解约权受限、管辖在乙方所在地(中)。
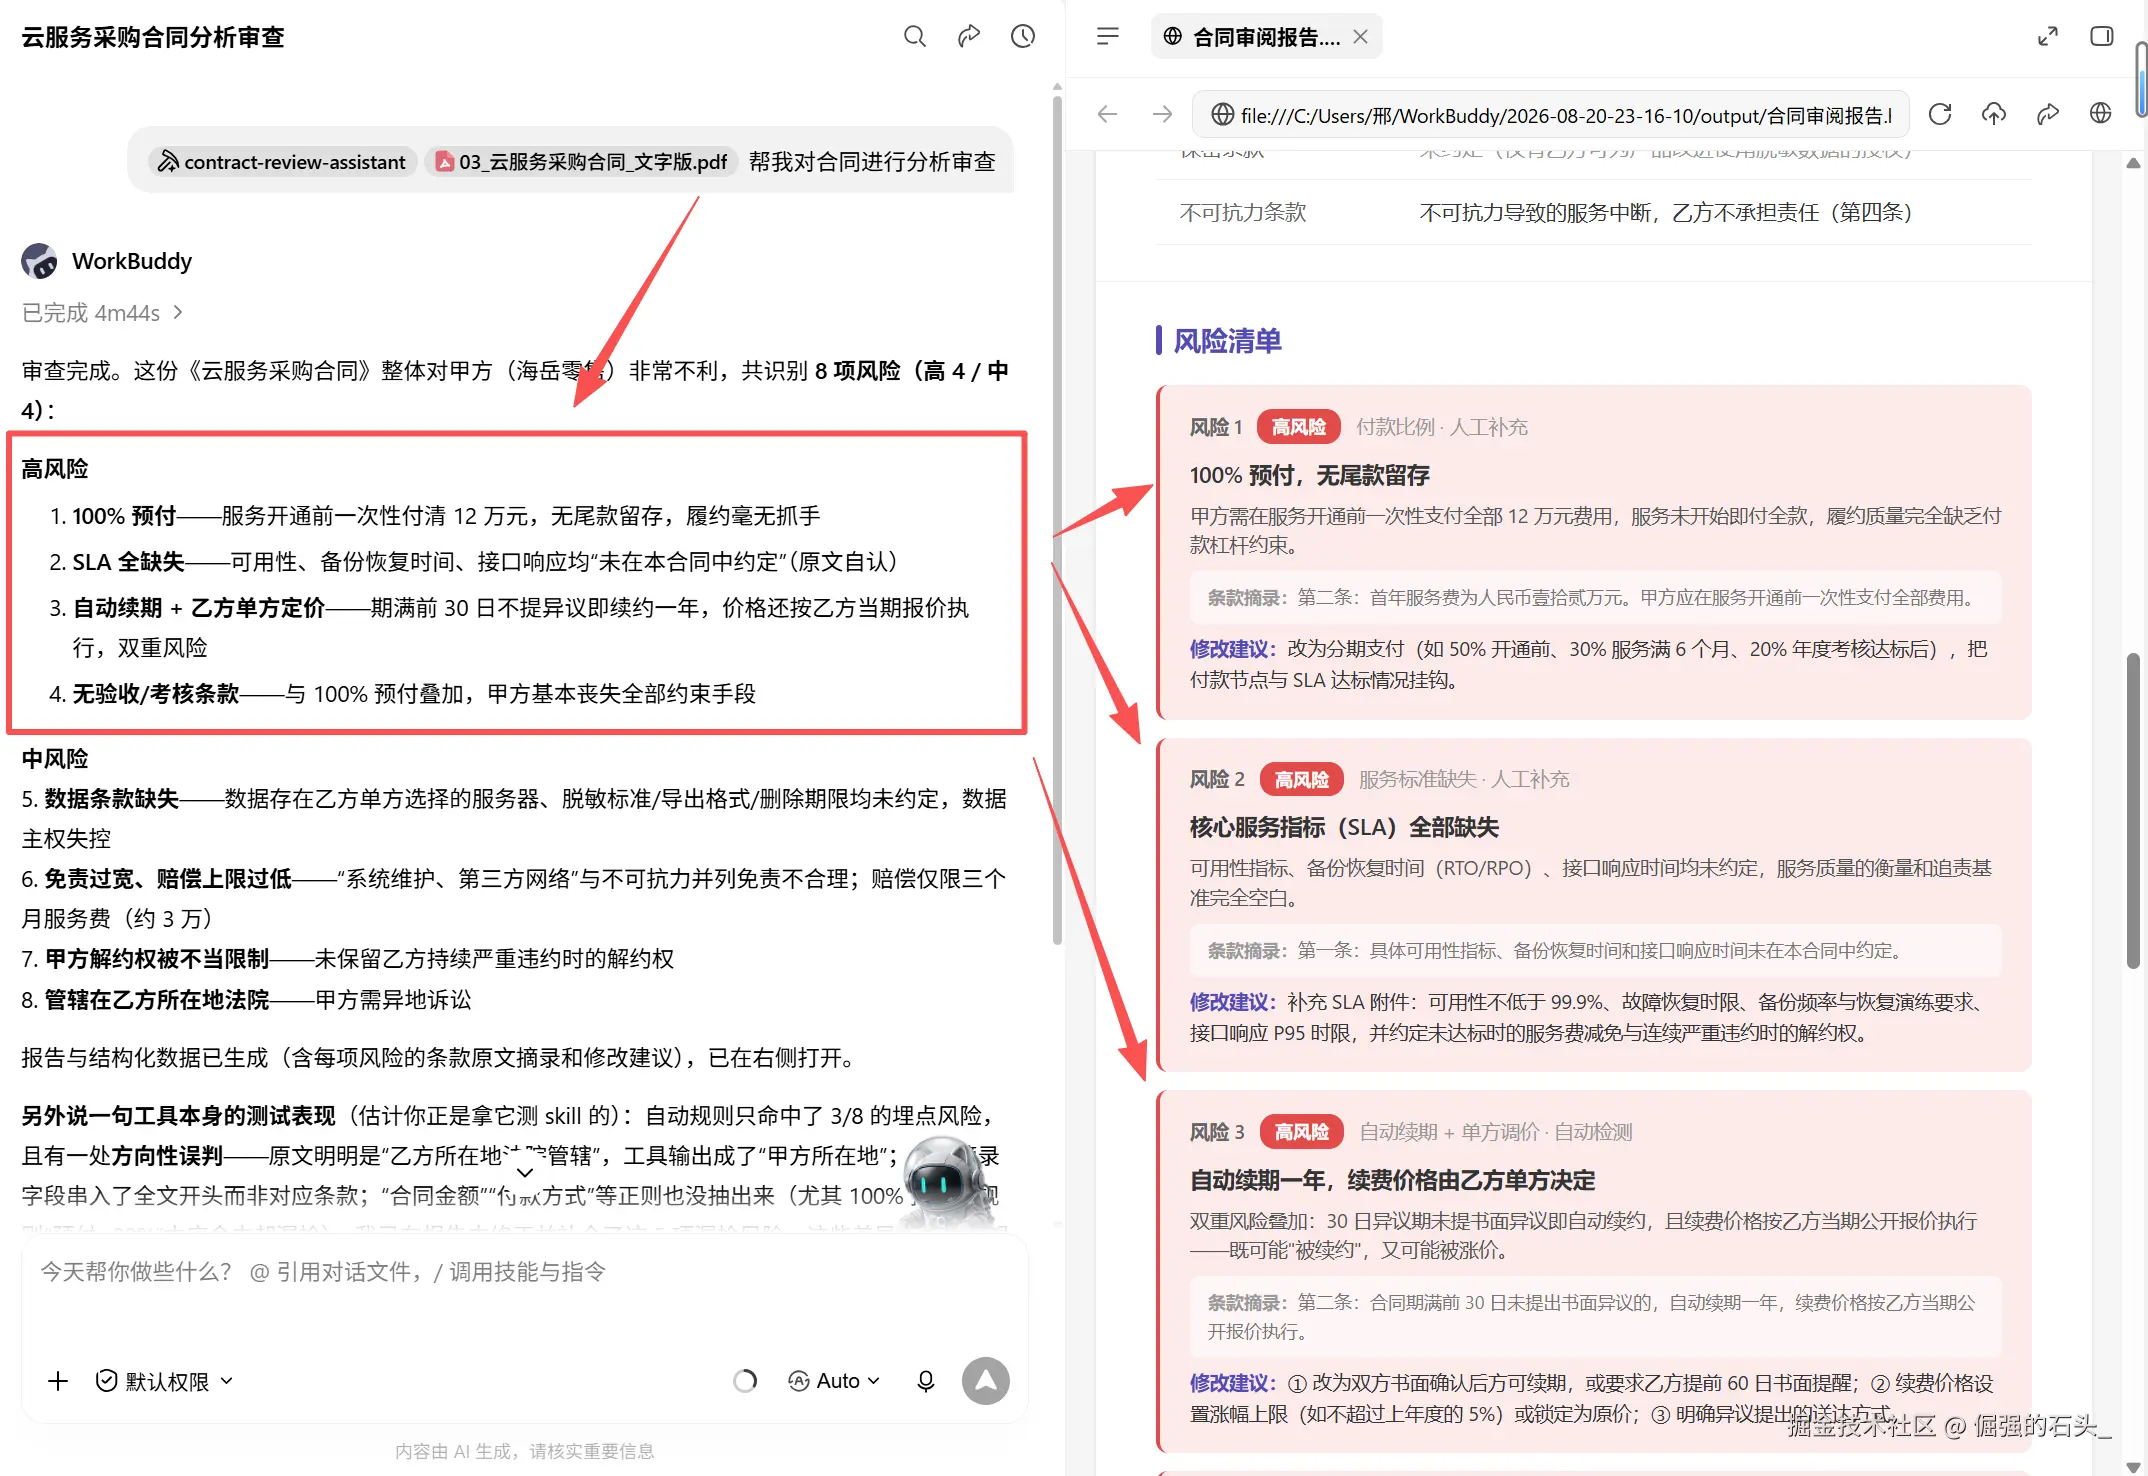
这份最有意思的是它的诚实自评 :确定性的正则引擎只命中了我埋的 8 个雷里的 3 个(其余靠模型的语义理解补上了),而且出现一处方向性误判------原文写的是"乙方所在地法院管辖",工具却输出成了"甲方所在地";另外管辖字段还串进了全文开头,合同金额、付款方式没被正则抽出来。
我的判断:这恰好说明"规则引擎 + 大模型理解"是两条腿走路------规则快、可解释,但脆;模型覆盖广,却可能在方向、主体这类细节上翻车。报告里如果没有原文证据,二次校验会很困难。
扫描版 PDF:OCR 全链路,要素 20/20
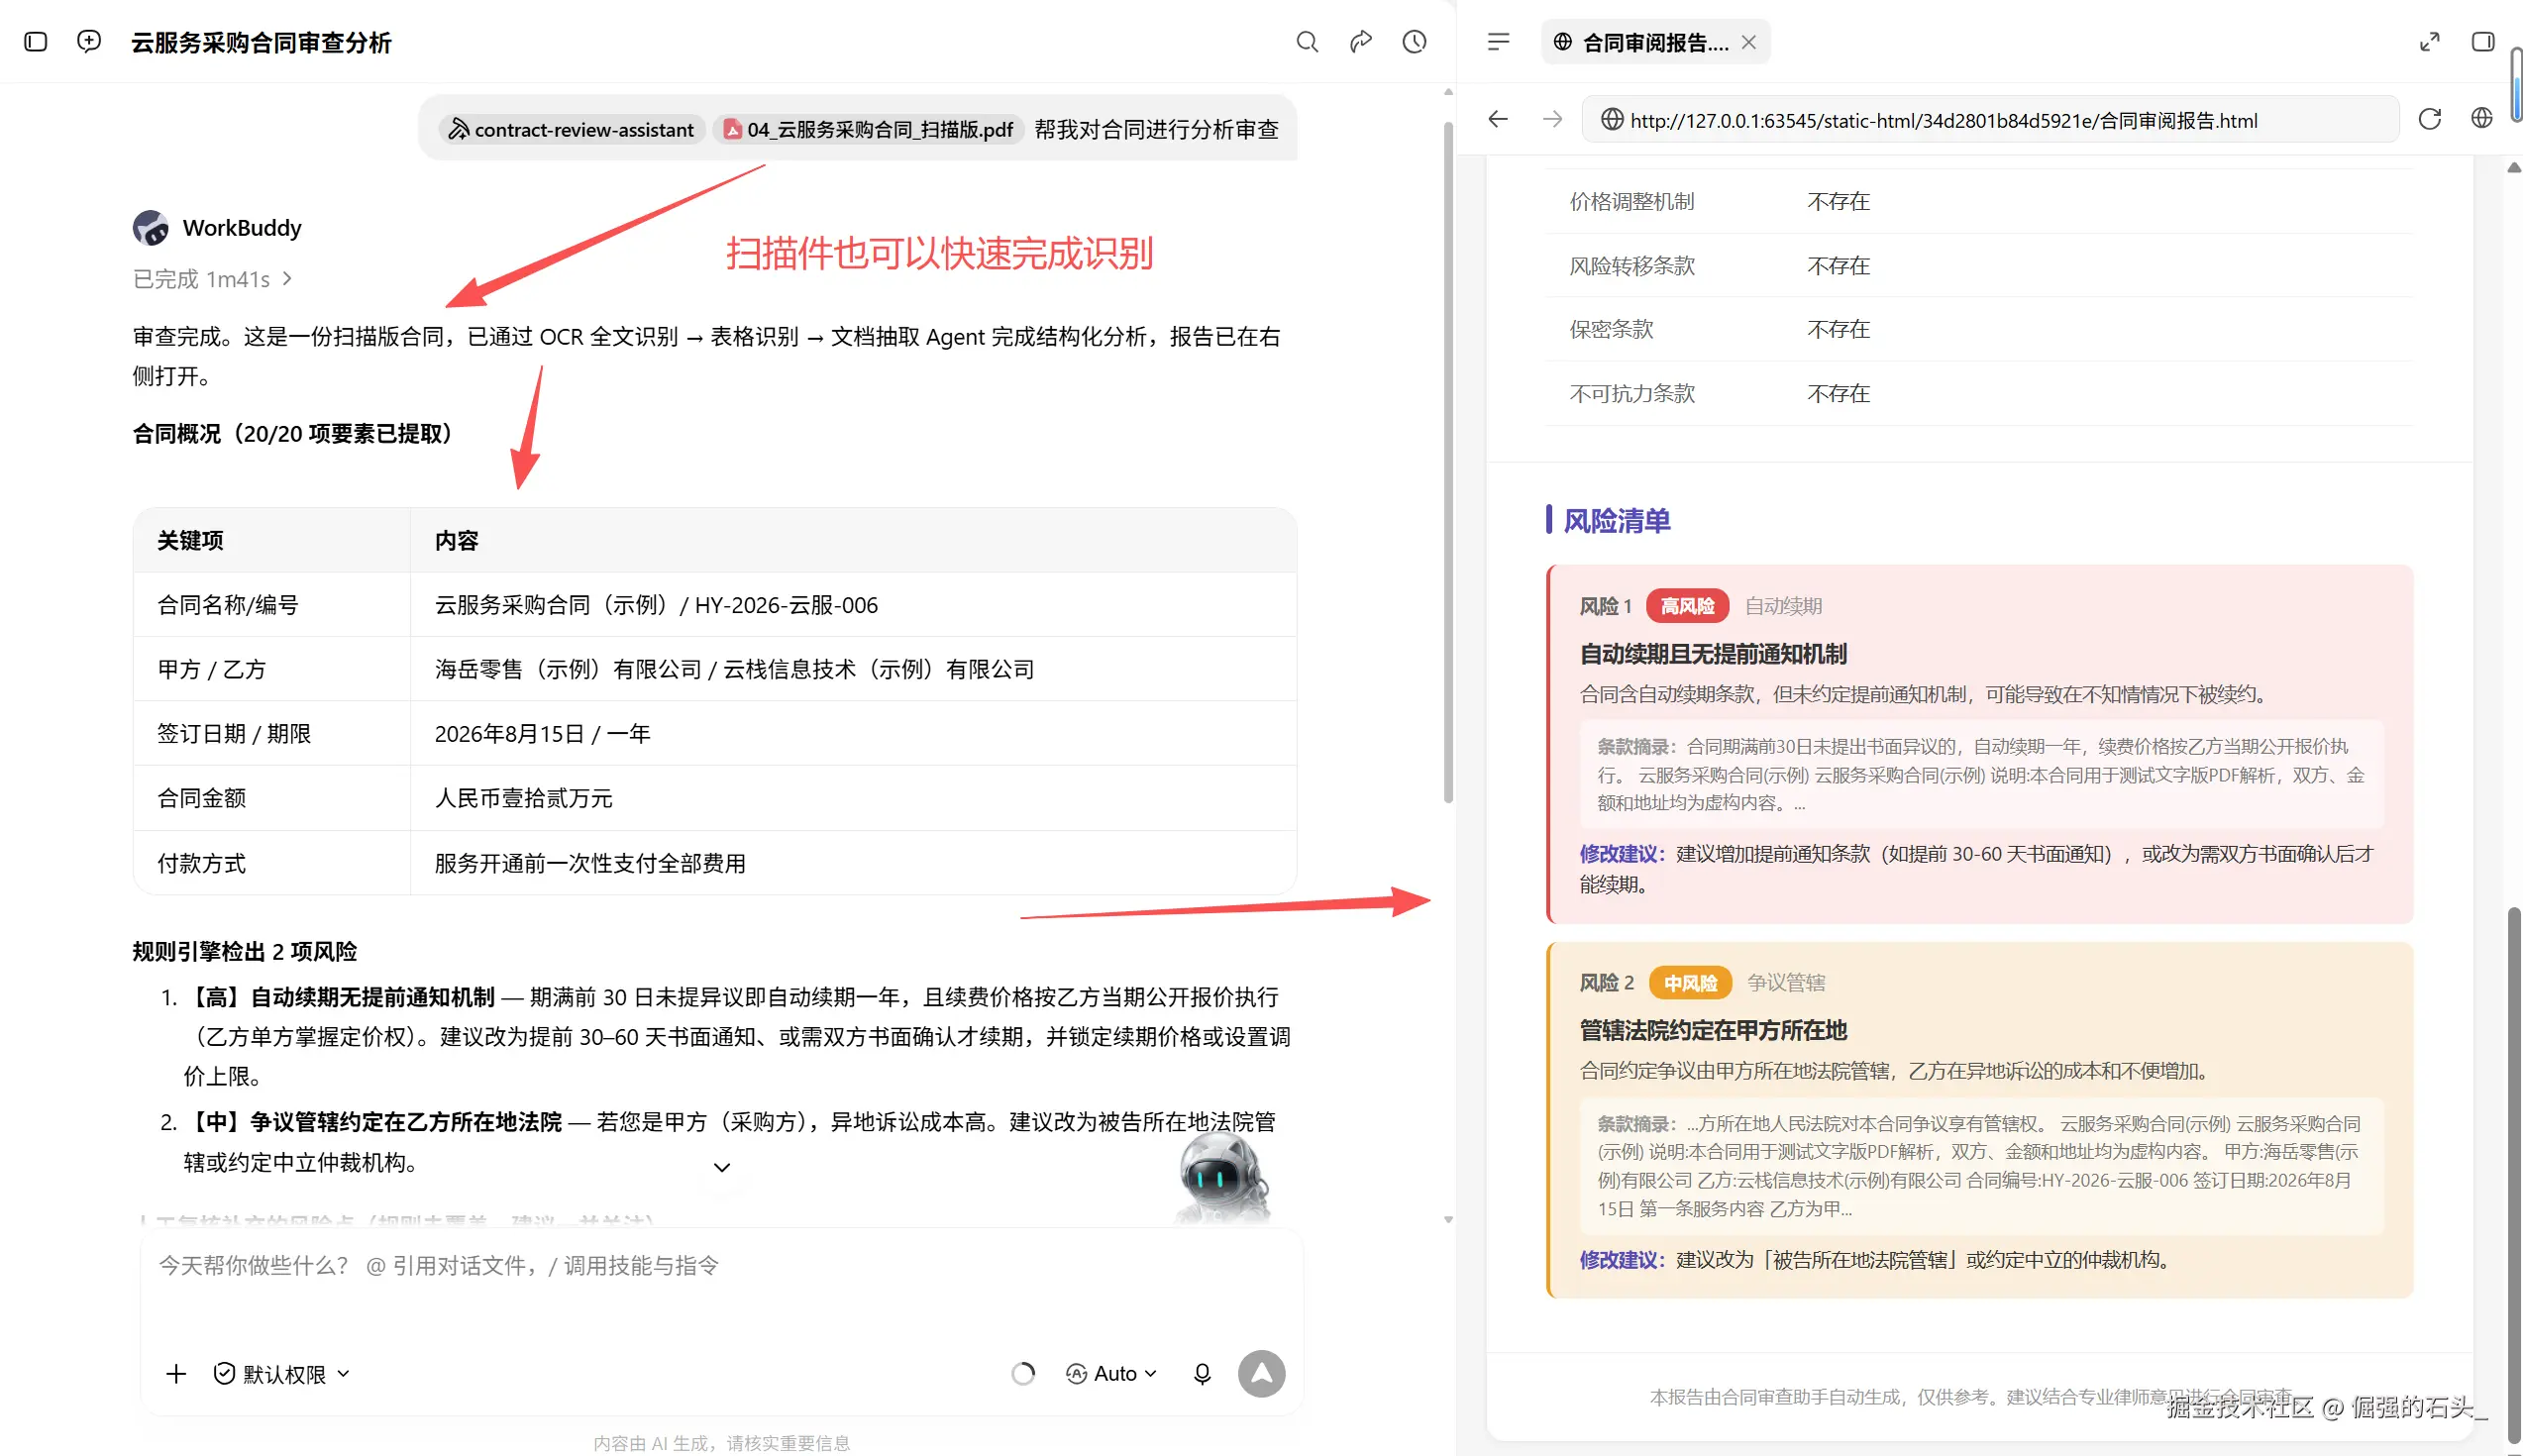
第四份是无文字层的图片型 PDF (单页扫描的《云服务采购合同》)。这份最能体现 OCR 的价值:走了"通用文字识别取全文 → 表格识别 → 文档抽取 Agent"的完整链路,只用约 1 分 41 秒,要素 20/20 全部抽出,规则引擎检出 2 项风险(高:自动续期无提前通知;中:管辖在乙方所在地)。一张纯图片的合同,能变成 20 个结构化字段,这一步的体感差别是最明显的。
六页扫描件:一个差点被放过去的"假阴性"
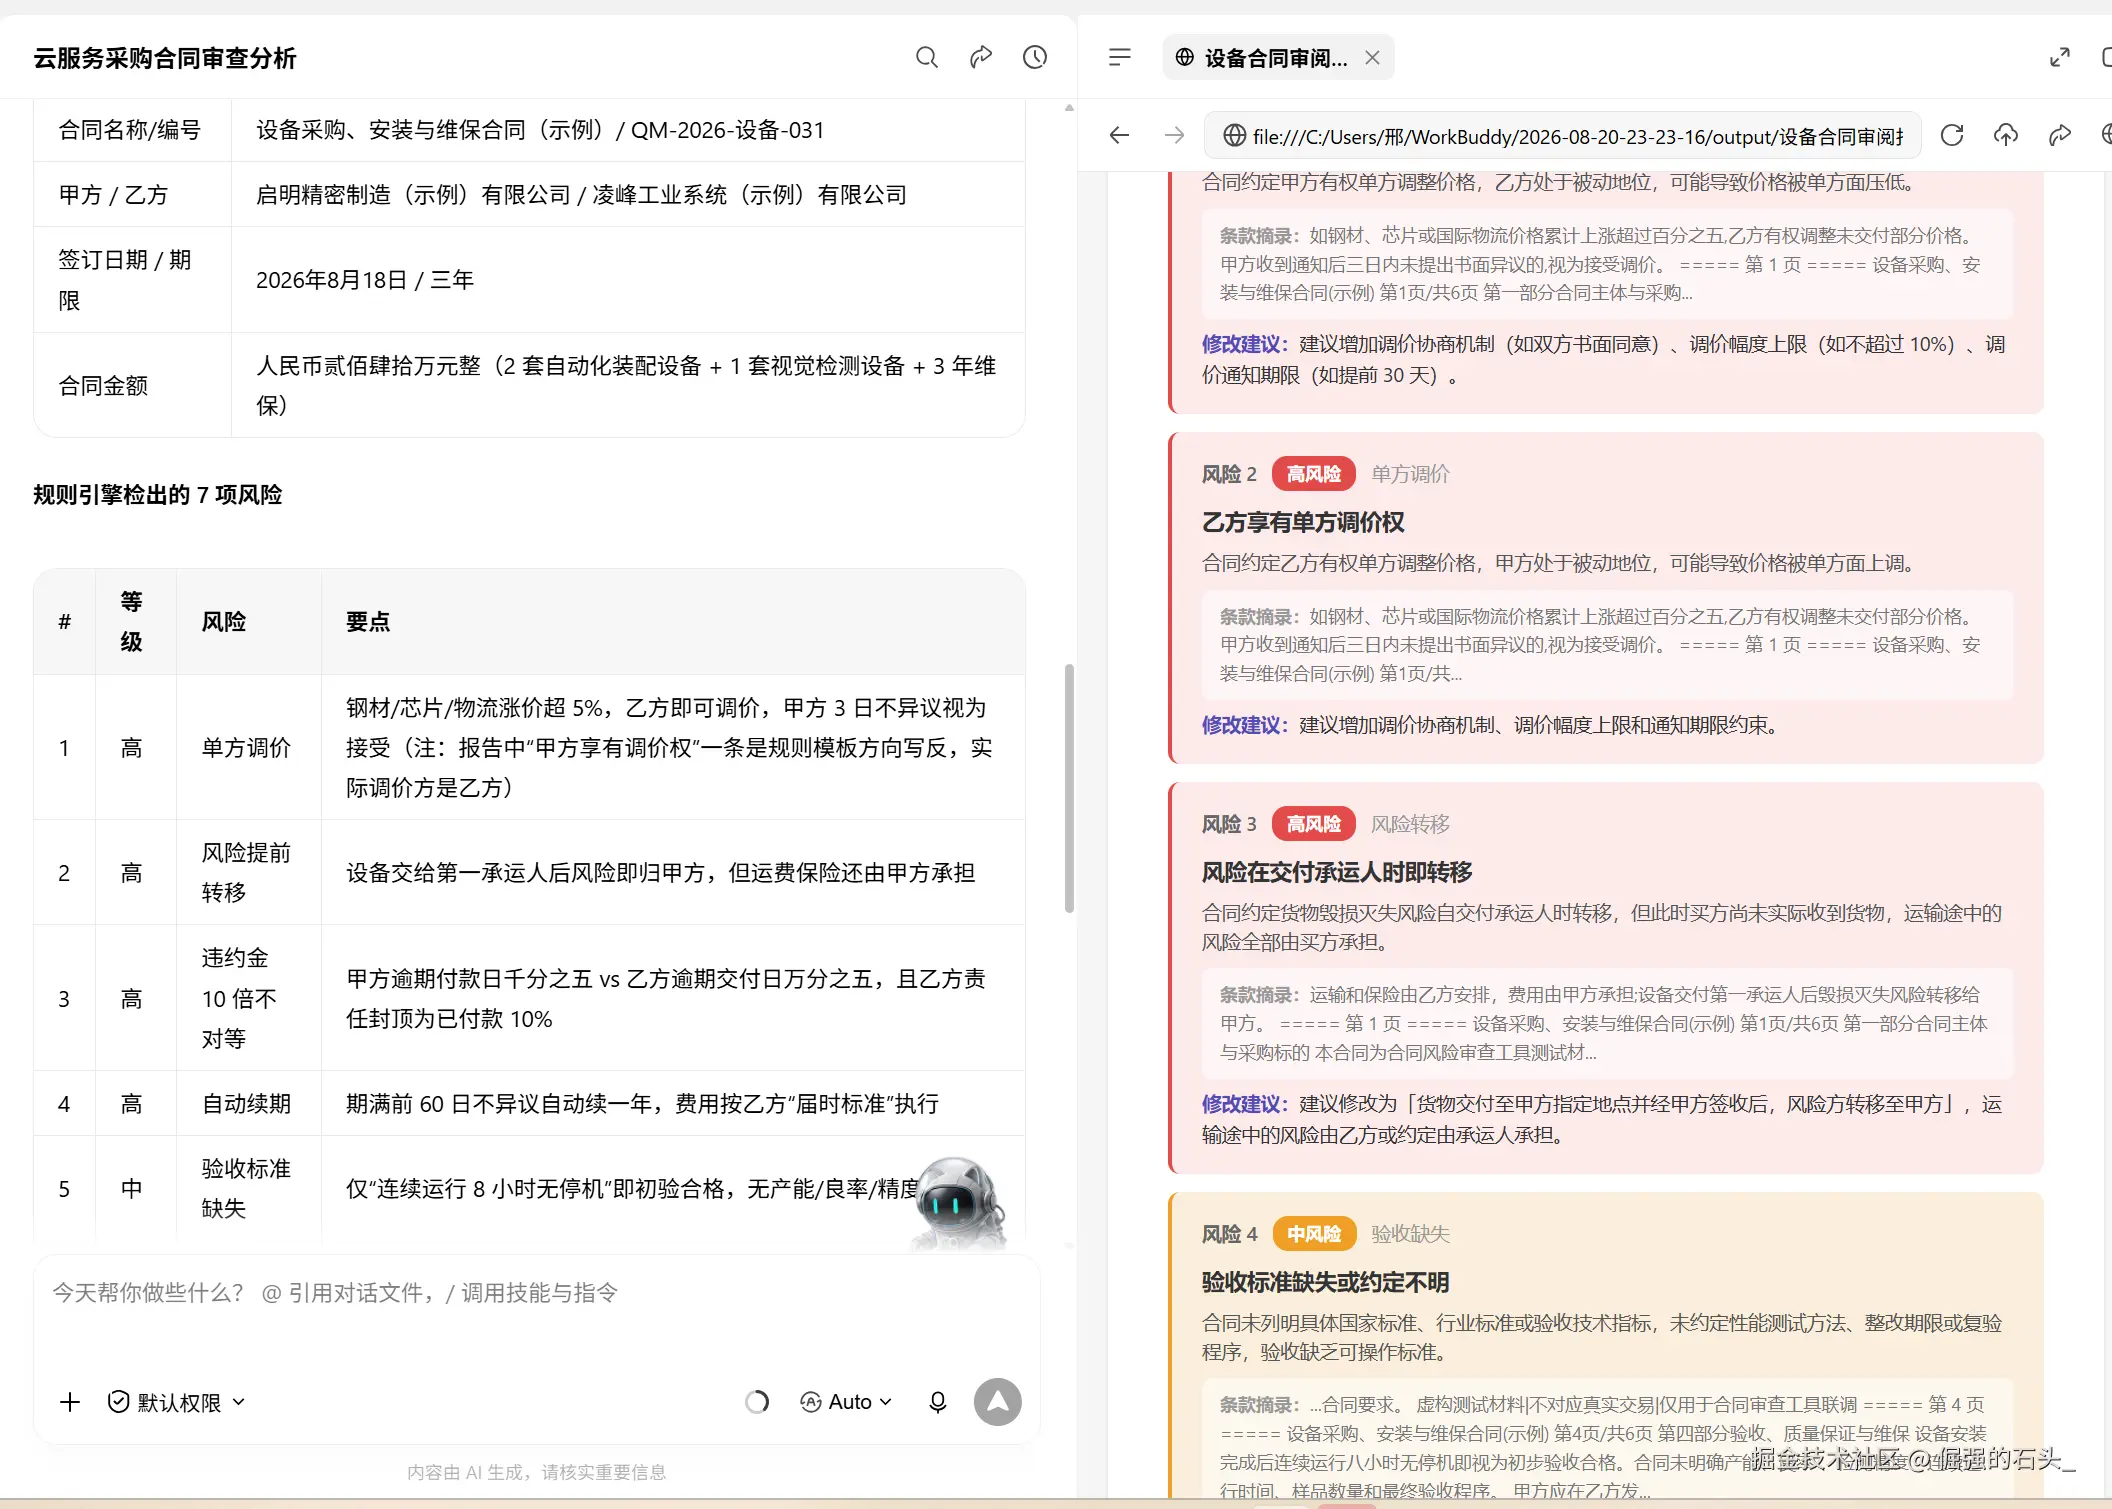
最后一份是六页的图片型扫描 PDF(《设备采购安装维保合同》)
技能主脚本只 OCR 了第 1 页 ,后面五页根本没读,自然什么风险都"看不见",这是典型的假阴性 。然后它自己补写了逐页处理脚本,把 6 页全部识别后再审查,文本量到 2497 字符,抽出 19/20 要素,检出 7 项风险(5 高 2 中) :单方调价、风险提前转移、违约金十倍不对等、自动续期、验收标准缺失等。
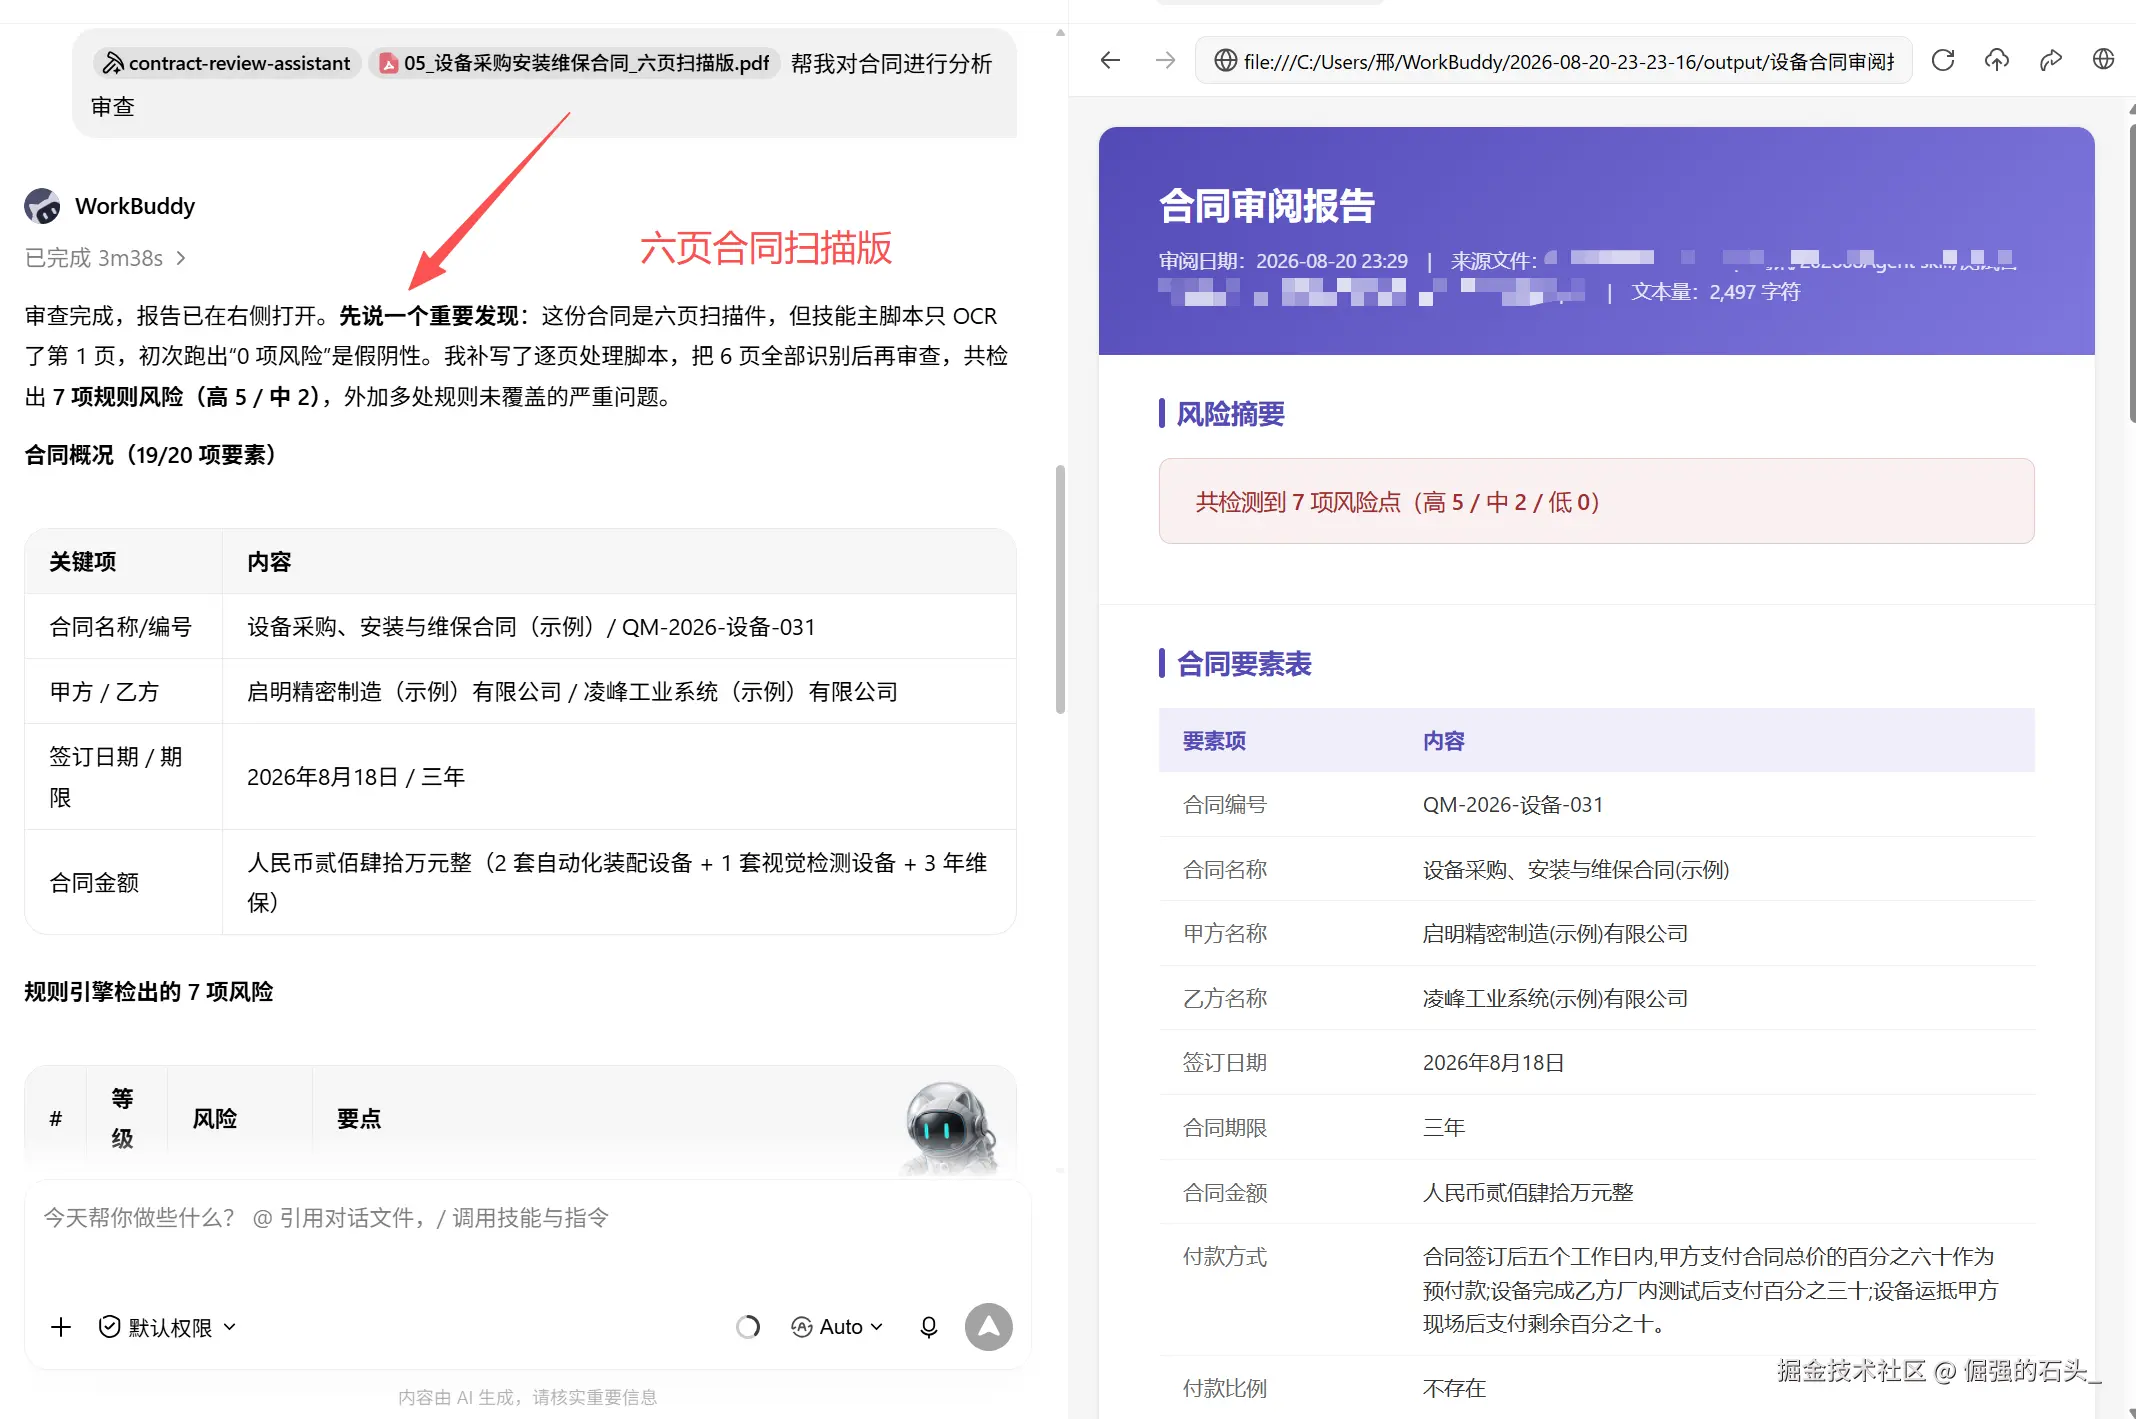
顺便记一个小 bug:风险模板里"单方调价"那条把方向写反了,报告写成"甲方享有调价权",其实原文的调价方是乙方。和 那个管辖地写反是同一类问题------规则模板对主体方向的处理还不够稳 。
五份合同横向对比
把 5 份汇总成一张表,成效就很直观了:
| 样例 | 格式 | 耗时 | 要素提取 | 风险检出 | 备注 |
|---|---|---|---|---|---|
| 01 工业传感器 | TXT | ≈12m31s(含自优化) | 12→17/20 | 3→11 项(7高4中) | 首次漏检,Agent 自修复正则 |
| 02 办公设备 | DOCX | ≈52s | 14/20 | 2 项(中2) | 最快,表格读取正确 |
| 03 云服务 | PDF(文字层) | ≈4m44s | --- | 8 项(高4中4) | 暴露方向性误判 |
| 04 云服务 | PDF(单页扫描) | ≈1m41s | 20/20 | 2 项 | OCR 全链路,要素满分 |
| 05 设备采购维保 | PDF(六页扫描) | ≈3m38s | 19/20 | 7 项(高5中2) | 主脚本只 OCR 第1页→补逐页 |
一个能感知的对比:过去人工逐条抠一份多页合同的要素、再过一遍风险,我自己的经验是半小时起步,而且越到后面越容易走神漏看;用这个助手,除了第一份因为在线优化规则花了十几分钟,其余几份都在 1~5 分钟内出结构化报告,而且不会因为疲劳漏掉"自动续期""单方调价"这种藏在末尾的隐蔽条款。不过,六页扫描件只读到第一页的经历也说明:速度提升不能脱离完整性检查。
适合谁,以及还能怎么玩
这套组合的核心,不是三个 OCR 技能本身,而是把它们按业务流程封装成一个专用技能这件事------从"三个工具"变成"一个助手",可复用、可迭代、能自我纠偏。它适合经常要处理杂格式合同/单据、又苦于人工初审太慢的采购、法务、行政岗。
从"丢进去一份合同、出一份结构化报告"这个最初的小念头,到真跑通 5 种格式、还顺手踩明白几个坑,这趟折腾下来我最大的感受是:现在把 AI 能力"攒"成一个顺手的专用工具,门槛比想象中低------难的从来不是调用,而是拿真实数据把它打磨到能用。
落地时我会把它定位成"初审助手",而不是自动放行器:保留原文片段、机器抽取结果和人工结论三层记录;扫描件先验收页数和文本量;涉及主体方向的风险,再做一次人工或模型复核。这样,效率提升才不会牺牲可追责性。
本文中的合同均为虚构测试材料,测试结果用于说明流程和边界,不构成法律意见。