MySQL 面试里有个题,单独问的时候不算多,但一问就容易露馅:
索引下推(ICP)是什么?
很多人能背出"减少回表次数"这六个字,再往下就被问住了------为什么能减少?省的是哪一步 IO?它跟覆盖索引又是什么关系?
索引下推(Index Condition Pushdown,简称 ICP)是 MySQL 5.6 引入的查询优化。
当你用二级索引查数据时,MySQL 会把本该在 server 层做的条件判断,下推到存储引擎层,在数据遍历的那一刻就顺手筛掉,少回几次表。
先看清 MySQL 的三层架构
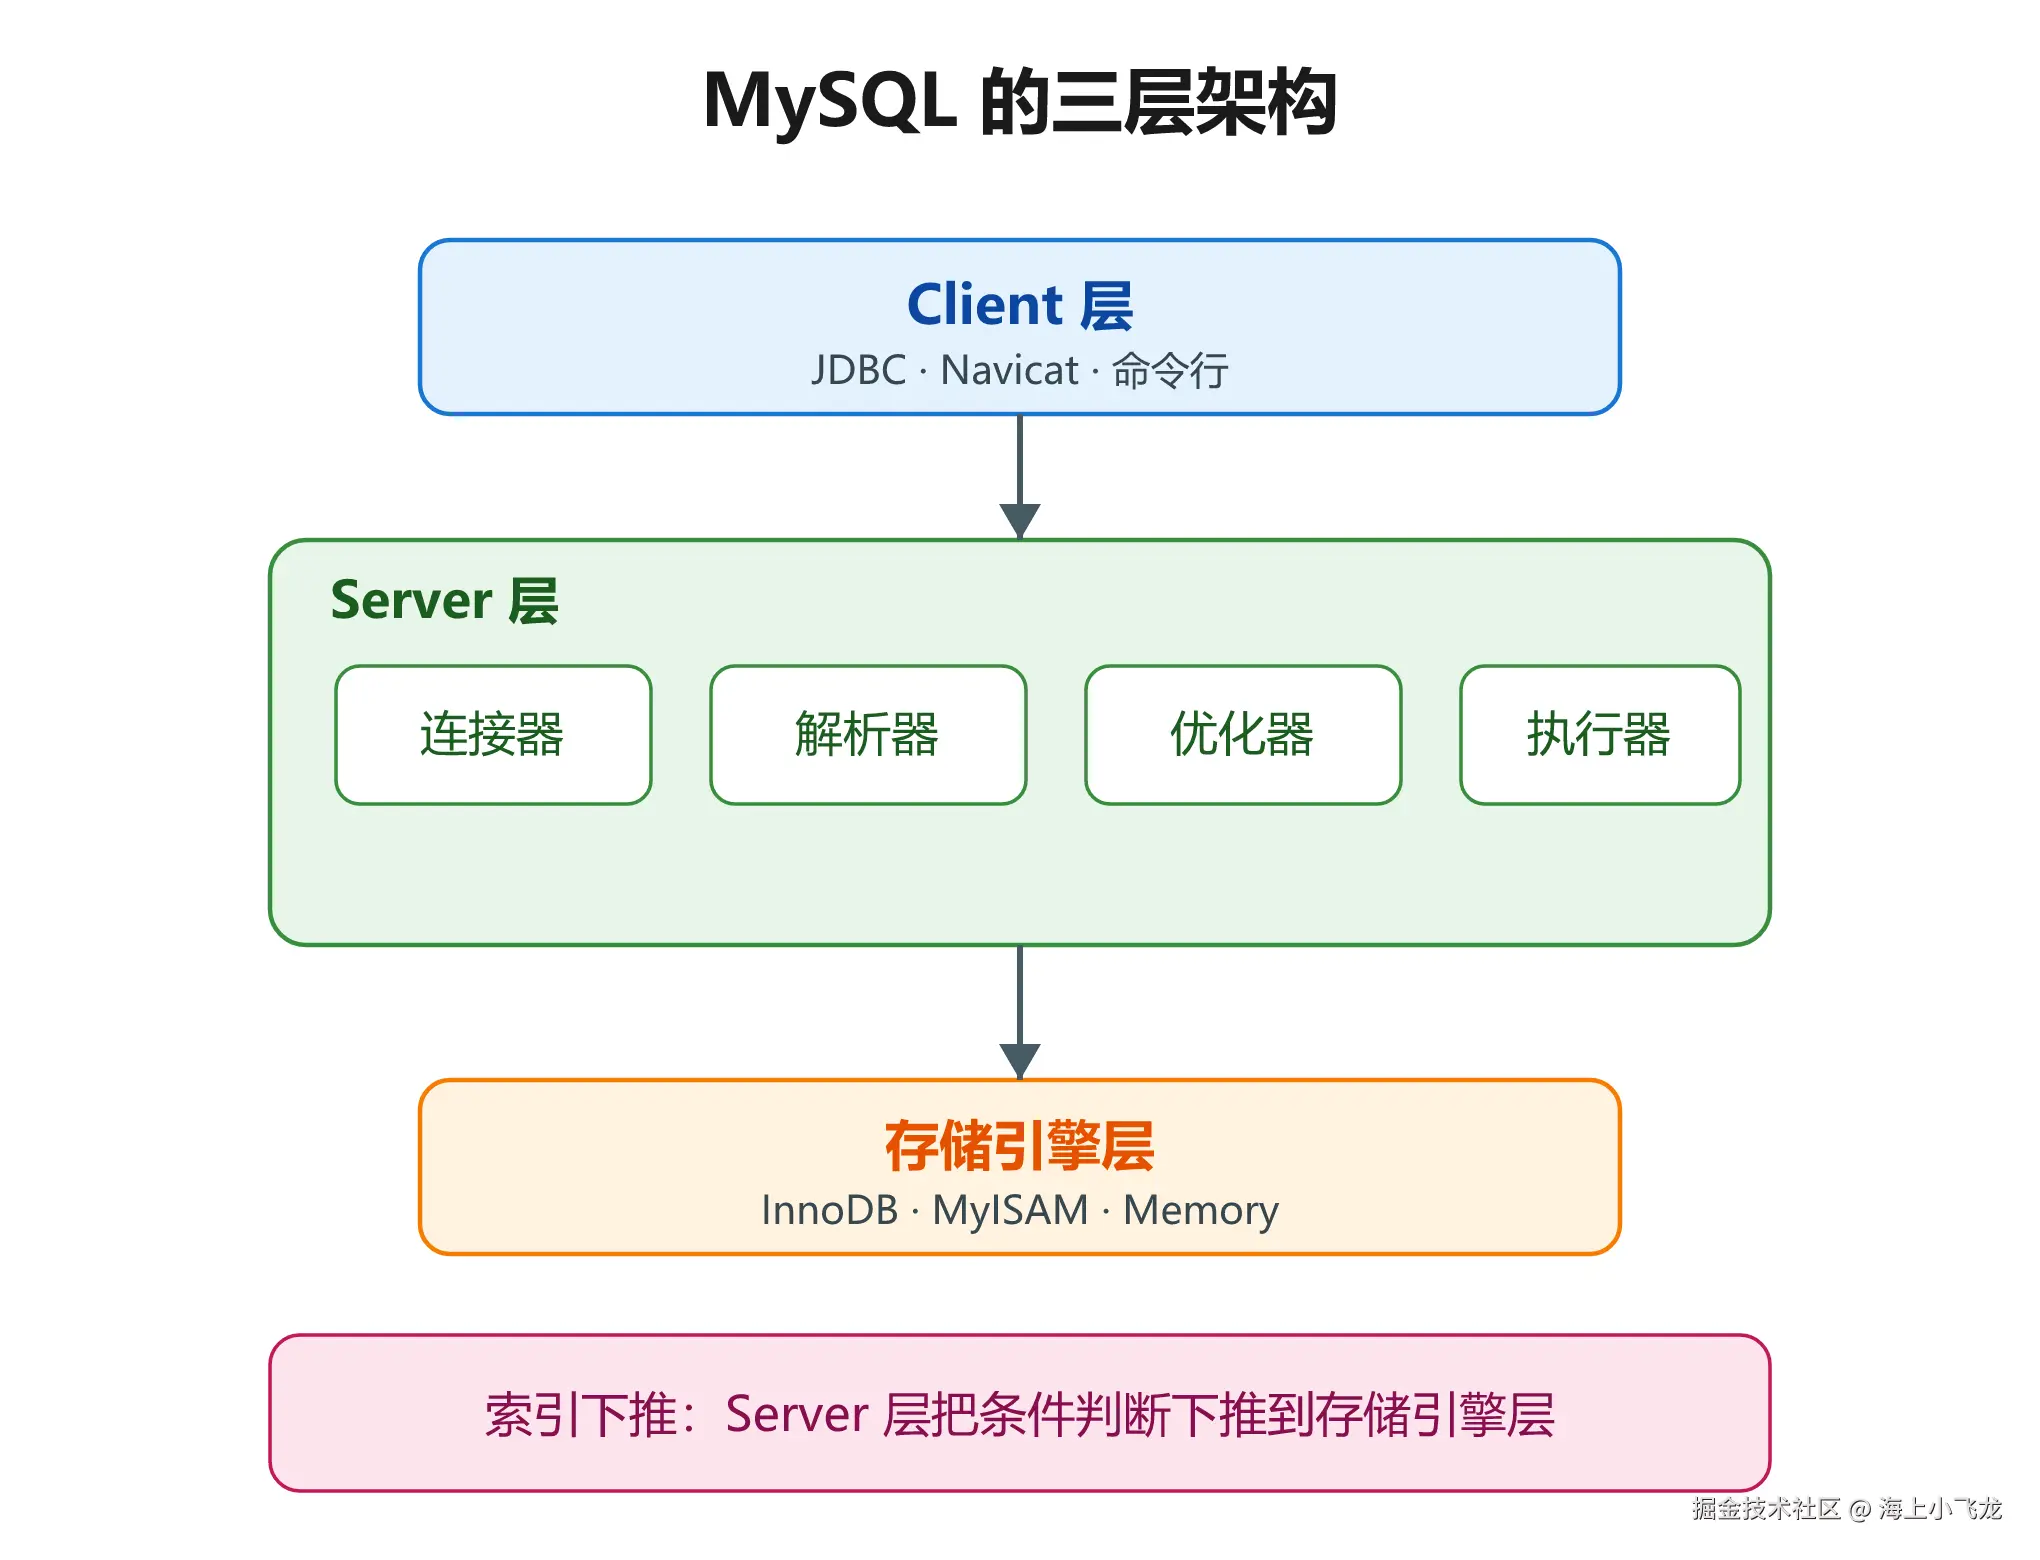
一条 SQL 从你敲下回车,到拿到结果,MySQL 内部是分三层跑的。
最上面是 Client 层,就是你接触到的那些东西:
JDBC 代码、Navicat、命令行、各种 SQL 客户端都算。
中间是 Server 层,负责 SQL 的解析、优化和执行。
这里可以重点关注几个核心组件:
连接器、解析器、优化器和执行器。
连接器管连接、验权限。
解析器负责词法分析和语法分析,把 SQL 解析成 MySQL 能理解的内部结构。
优化器负责选择执行计划,比如决定走哪个索引、采用什么访问方式。
执行器拿着计划去跟存储引擎打交道。
最底下是存储引擎层,InnoDB、MyISAM、Memory 都属于存储引擎,负责数据的实际存储和读写。
为什么特意提这个?
因为索引下推玩的就是"Server 层把活分给存储引擎层"------没有这层分工,根本谈不上"下推"两个字。
没有 ICP,回表是这样发生的
用二级索引查数据时,存储引擎会遍历那棵索引 B+ 树,把满足索引条件的记录逐条找出来。
每条二级索引记录里都带着它对应的主键值。
剩下的条件判断在哪儿做?
在 server 层。
但 server 层不会直接拿到过滤好的结果。
存储引擎得先根据这些主键值回到聚簇索引,把完整行捞出来交给 server 层,server 层才能去判断其余条件成不成立。
问题就出在这儿:
如果第一个字段匹配出了很多行,交上来的主键就很多,回表次数就跟着暴涨。
明明大部分行在后面的条件上就会被淘汰,可它们已经白白回表走了一趟。
一张 user 表,看清差距
拿一张 user 表举例,字段有 id、name、age、gender、address,id 是主键,建了一个 (age, name) 的联合索引。
sql
CREATE TABLE user (
  id      INT PRIMARY KEY,
  name    VARCHAR(50),
  age     INT,
  gender  VARCHAR(10),
  address VARCHAR(200),
  INDEX idx_age_name (age, name)
);
现在跑这条查询:
sql
SELECT * FROM user WHERE age > 10 AND name LIKE '%张%';没有 ICP 的时候,执行分两步。
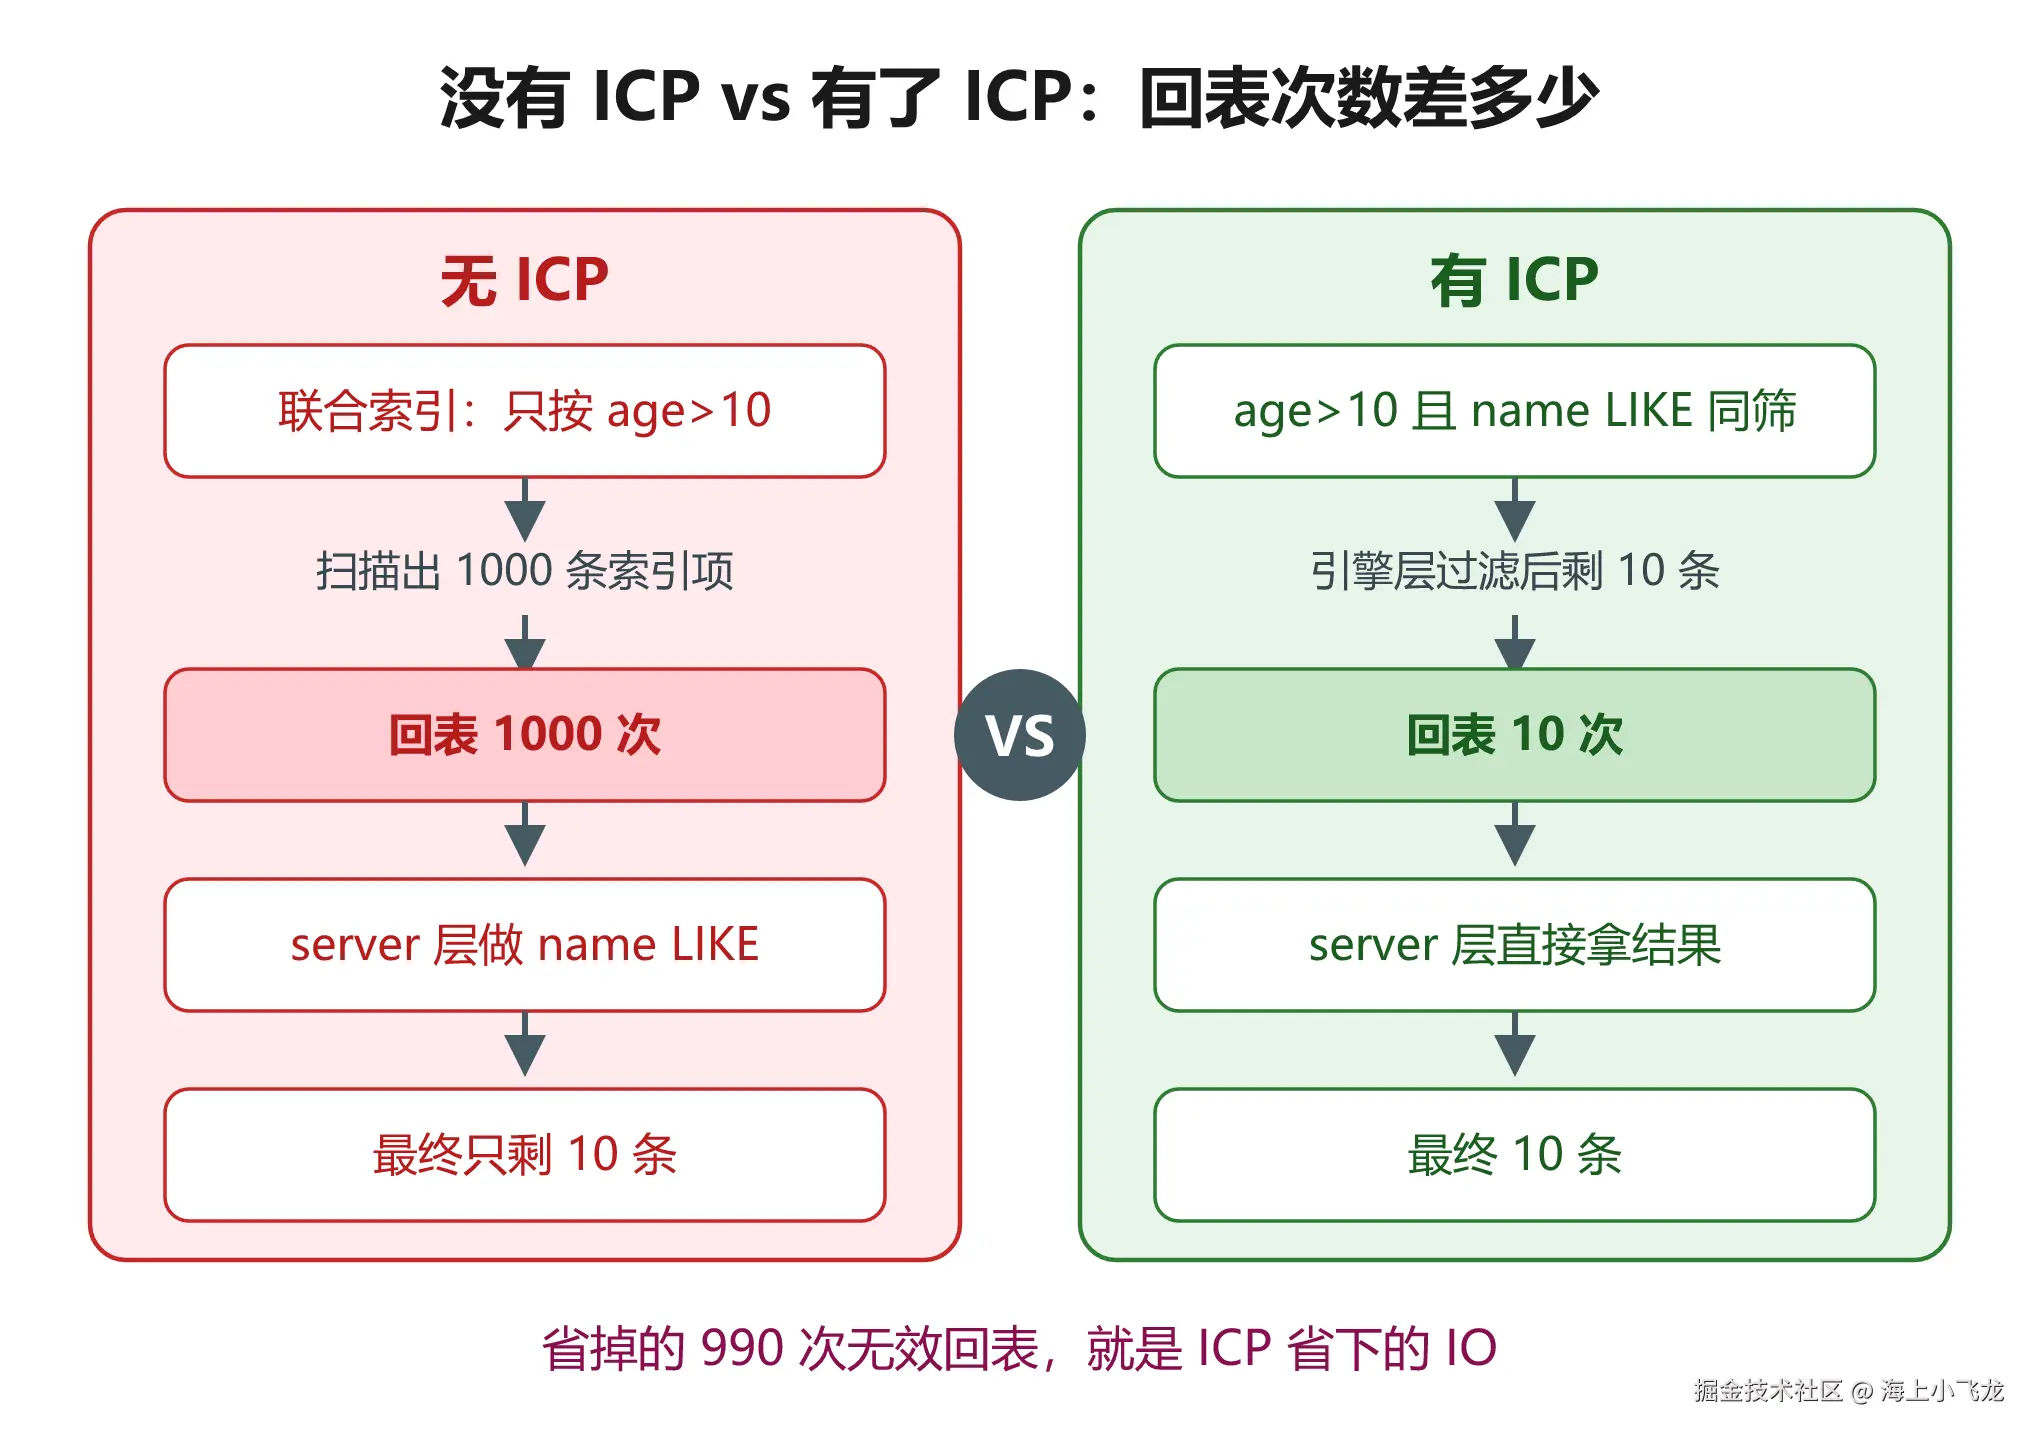
第一步,存储引擎用 age > 10 在二级索引上圈出一段扫描区间。
因为 age 是索引最左列、记录按 age 排好序,所以 age > 10 能直接定位到一段连续的范围,不必全表扫。
这段区间里假定有 1000 条索引记录。
接下来要查 name LIKE '%张%'。
name 是索引第二列,可 %张% 是前缀模糊匹配------前缀都不知道,自然没法靠索引的有序性继续往下缩范围,所以这 1000 条区间只能一条条扫过去。
但有个关键事实:
name 本身就写在每一条二级索引记录里(二级索引不只存 age 和主键,也存了 name)。
也就是说,扫到每条记录时,name 的值是现成能读到的。
可没有 ICP 时,存储引擎不会顺便拿它来过滤,而是老老实实把这 1000 条记录的主键逐个拿去聚簇索引回表、取回完整行,再交给 Server 层判断 name 是否成立。
于是出现了浪费:
这 1000 条里最终可能只有 10 条 name 带"张",剩下 990 条本该在索引层就被刷掉,却已经白白回表走了一趟。
性能开销主要就花在这些无效回表上。
有了 ICP 之后,第一步就变了。
存储引擎先根据 age > 10 确定二级索引的扫描范围。
在扫描 (age, name) 索引记录的过程中,由于 name 也保存在索引记录里,存储引擎可以直接判断 name LIKE '%张%'。
不满足条件的记录就地跳过,不再根据其中的主键去聚簇索引读取完整行;
只有同时满足条件的记录,才需要继续回表取 SELECT * 需要的其他字段。
这里也正是 ICP 和覆盖索引的分界:
如果查询改成只取索引里已有的字段,比如 SELECT age, name ...,那可能直接走覆盖索引就完成,连最后这次回表都不需要------当然,具体是否采用覆盖索引仍由优化器根据成本决定。
在这个示例里,ICP 大致可以避免 990 次无效回表。
用个比方再串一遍
还是这个场景,换个说法更好记。
你要从仓库里找出"尺寸大于 10、并且是红色"的零件。
仓库管理员手里的索引卡按尺寸排了序,每张卡上还记了这件零件的颜色和它在货架上的箱号------但卡上只有这三项,零件本身仍在货架上。
没有下推时:
管理员把所有尺寸 > 10 的零件整箱从货架搬到你办公室,你再一个个开箱看颜色,红色的留下、其他的扔掉。
1000 个候选里其实只有 10 个是红的------也就是说有 990 个箱子白搬了。
有下推时:
你提前把"红色"也写进取货单。
管理员翻索引卡时,颜色就写在卡上、不用开箱就能看到,于是他先把非红色的剔掉,只把 10 个红零件的箱子从货架搬出来。
那 990 个非红的,连箱子都没开、更没搬。
少搬出来的那 990 个零件,对应的就是 ICP 省掉的 990 次无效回表。
这里要和覆盖索引分清:
覆盖索引相当于索引卡上把查询要的所有信息都写全了,管理员连货架都不用去。
ICP 不一样------卡上只有部分字段,所以最后那 10 个红零件还是得从货架搬出来(回表),只是不用再为被淘汰的 990 个白跑一趟。
减少回表,不等于不回表
这里有个特别容易混的点,必须掰清楚。
ICP 减少了回表次数,但回表这一步并没有被彻底消灭。
上面那条查询是 SELECT *,要的是整行,存储引擎层筛完之后,照样得去聚簇索引把完整行捞出来。
它省掉的是"根据二级索引中的主键去聚簇索引读取完整行"这一步里、最终会被 WHERE 条件淘汰的那部分读取------也就是不必要的回表读取。
覆盖索引才是真正的不回表------要查的字段刚好全在索引里,连聚簇索引都不用去。
它俩经常被一起考,记住一句话就够了:
覆盖索引是"不用去",索引下推是"少去几次"。
| 维度 | 覆盖索引 | 索引下推 ICP |
|---|---|---|
| 核心作用 | 利用索引直接返回查询结果 | 在扫描索引时提前过滤记录 |
| 是否回表 | 查询被索引完全覆盖时不需要回表 | 如果还需要读取非索引字段,仍然可能回表 |
| 优化重点 | 避免回表 | 减少不必要的回表 |
| 条件 | SELECT 所需字段都能从索引获得 | WHERE 中部分条件可以直接利用当前扫描的索引记录判断 |
索引下推说到底就一件事:
在使用索引扫描数据时,原本需要拿到完整记录后再判断的一部分条件,如果所需字段本身就在当前扫描的索引里,就可以提前下推到存储引擎层进行过滤。
这样,不满足条件的记录会在索引扫描阶段被淘汰,不再触发后续的回表读取。
它减少的是不必要的回表次数,不是彻底消灭回表;
而覆盖索引解决的是查询结果完全可以从索引中获得,从而根本不需要回表。