在做会议语音转写的时候,有一个问题看起来不严重,真正到了生产环境却特别让人头疼------漏字 。
比如会议原话是:
"这个项目我们计划在下个月完成第一阶段测试,然后根据测试结果调整后面的实施计划。"
ASR 输出可能变成:
"这个项目我们计划在下个月完成第一阶段,然后根据测试结果调整后面的实施计划。"
乍一看,好像也没什么。
但是放到企业会议里就不一样了。
"测试 "两个字没了,"实施 "两个字少了,甚至有时候一个关键的人名、项目名、金额、日期被吞掉,最后生成的会议纪要就可能出现语义偏差。
熙瑾·会悟在实际做 ASR 模型接入和会议转写时,就遇到了类似问题。最开始我们的判断也比较直接:是不是模型本身识别能力不够?
后来实际排查下来发现,事情没有这么简单。
漏字并不一定完全来自模型。
音频质量、VAD、分段方式、上下文丢失、推理参数、多人同时说话,以及最后的文本合并,都可能造成最终结果"看起来像是漏字"。
本文就以这个问题为切入点,把整个排查过程拆开讲一遍。
一、先说结论:不要把"漏字"简单归因于 ASR 模型
如果把一套会议转写系统简单理解成:
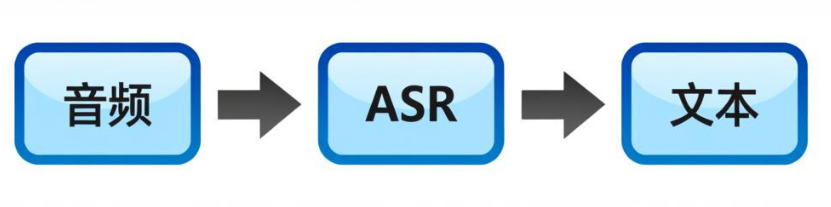
那么出了漏字问题以后,大概率第一反应就是:
换模型。
实际上生产环境中的 ASR 链路通常更接近:
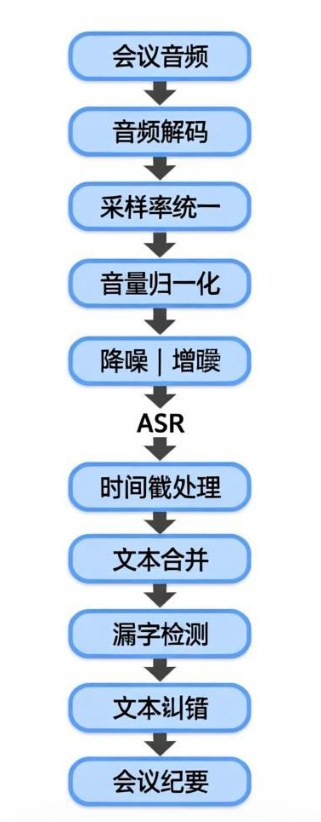
其中任何一个环节出现问题,都可能表现成"漏字"。
目前 Qwen3-ASR 已经提供 0.6B 和 1.7B 等模型版本,并支持包括中文、英文、粤语以及多种语言和中文方言在内的语音识别。官方实现同时提供了 ASR 与 Forced Aligner 相关能力。
所以,对于企业会议系统来说,真正需要解决的不是:
"Qwen-ASR 为什么会漏字?"
而应该改成:
"怎样建立一套能够发现、定位并尽量补回漏字的 ASR 工程链路?"
这个思路非常重要。
二、第一步:先把"漏字"问题分类
我们当时排查的时候,没有直接修改模型,而是先收集实际会议音频。
然后人工对照:
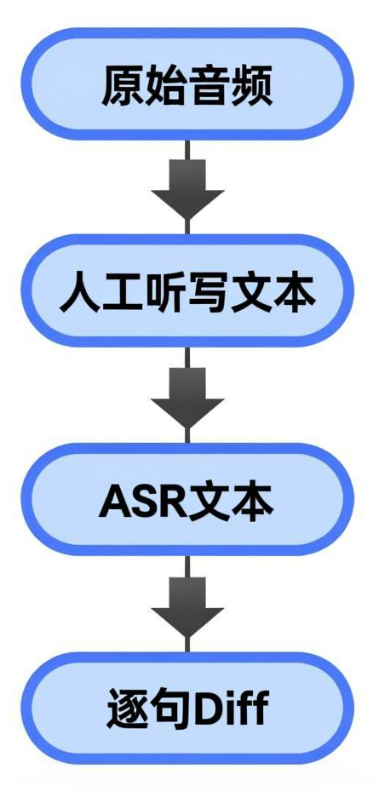
很快发现,漏字其实有几种不同情况。
1. 弱音导致的漏字
比如会议室里面有人坐得比较远:
"这个方案......我觉得......可以继续推进。"
其中"我觉得"说得特别轻。
ASR 很容易输出:
"这个方案可以继续推进。"
这种情况本质上属于声学层面的信息不足 。
2. 多人抢话导致漏字
会议场景和普通语音识别最大的区别之一,就是:
人不会排队说话。
经常出现:
A:这个方案我觉得------
B:我补充一下------
A:你先说。
B:就是前面那个预算问题......
两个声音发生重叠以后,ASR 输入的声学特征变得复杂。
如果没有做说话人分离或者音频增强,模型很容易只抓住其中一个人的内容。
3. 分段边界导致漏字
这个问题特别容易被忽略。
假设原始语音是:
......我们准备在本周五之前完成接口联调。 系统按照固定时间切成:
Chunk 1:
......我们准备在本周五之前
Chunk 2:
完成接口联调。 如果刚好:
"之前完成"
两个词被切在边界附近,模型对 Chunk 1 和 Chunk 2 分别识别时,都可能出现边界信息不足。
最终合并以后可能变成:
我们准备在本周五之前联调。 "完成"丢了。
三、VAD 不能简单粗暴地切
很多 ASR 系统都会使用 VAD,也就是 Voice Activity Detection,语音活动检测。
它的作用比较简单:
有人说话 → 保留 没有人说话 → 删除 看起来很合理。
但是实际会议里面存在一个问题:
人说话并不是连续的。
例如:
"这个项目......嗯......我的意思是......我们先把一期做好。"
如果 VAD 阈值设置得比较激进,那么:
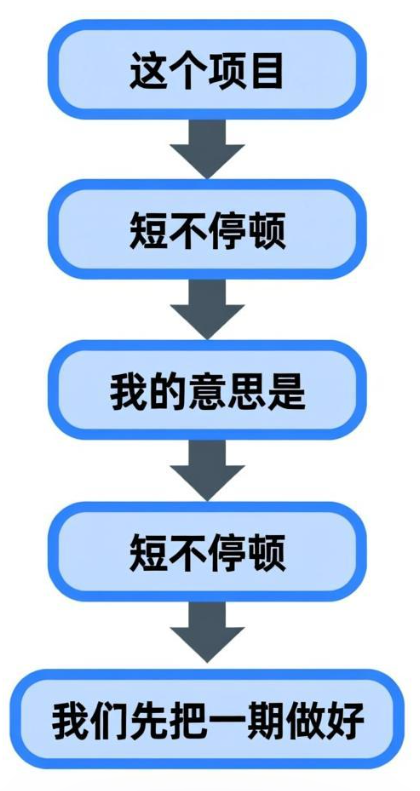
中间的停顿可能被误判成一句话结束。
于是整个语音被切得特别碎。
因此我们后来调整了思路:
VAD 负责"找边界",而不是"决定文本边界"
也就是说:
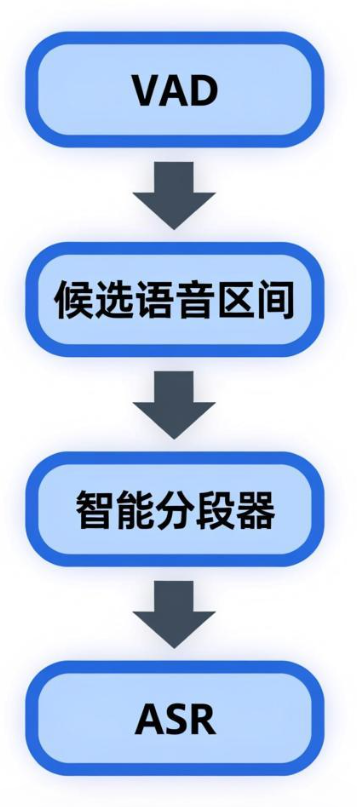
而不是:
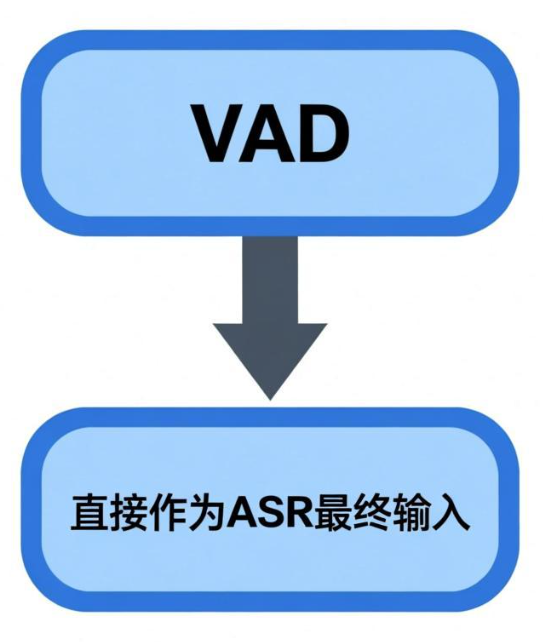
这样稳定性会好很多。
四、解决漏字的核心:音频分段必须带重叠
这是整个优化过程中比较有效的一种方式。
假设原始音频:
0s ---------------------- 60s 不要直接:
0-20s 20-40s 40-60s 而是:
0-20s
18-38s
36-56s
54-60s
也就是让相邻音频之间存在一定的 overlap。
例如:
Chunk 1:0 ~ 20s
Chunk 2:18 ~ 38s
Chunk 3:36 ~ 56s
这样做的好处是:
一个词即使刚好处于分段边界,也至少有一次机会在完整上下文中被识别出来。
当然,重叠也不能无限增加。
因为:
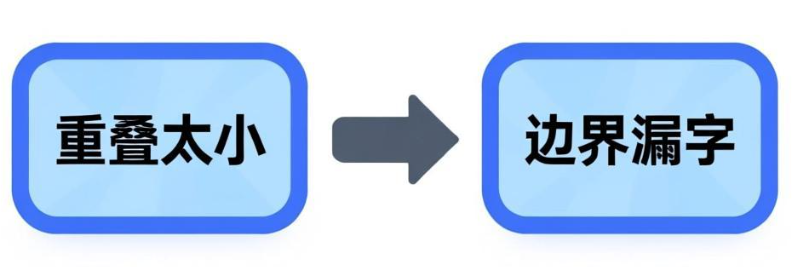
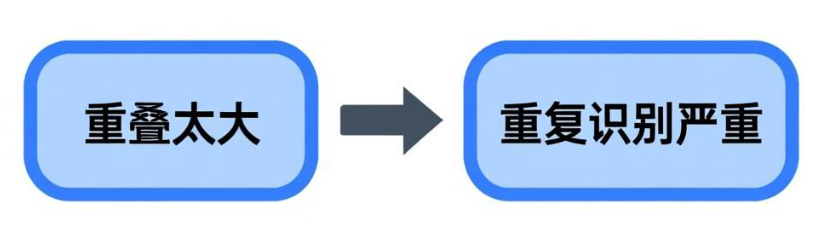
所以工程上通常需要结合会议实际语速、停顿长度和模型输入限制做测试。
五、Qwen-ASR 的上下文能力也需要利用起来
如果每个 Chunk 都完全独立识别:
Chunk 1 → ASR
Chunk 2 → ASR
Chunk 3 → ASR
那么 Chunk 2 并不知道 Chunk 1 讲了什么。
这对会议场景影响比较明显。
例如前面一直讨论:
"数据准备与预处理平台"
后面有人说:
"这个平台......"
如果上下文没有利用,模型可能对专业名词产生不同判断。
Qwen3-ASR 本身属于结合音频编码器和语言模型解码器的 ASR 架构,并支持通过上下文信息辅助识别。
所以在实际系统中,我们会维护一个轻量的上下文窗口:
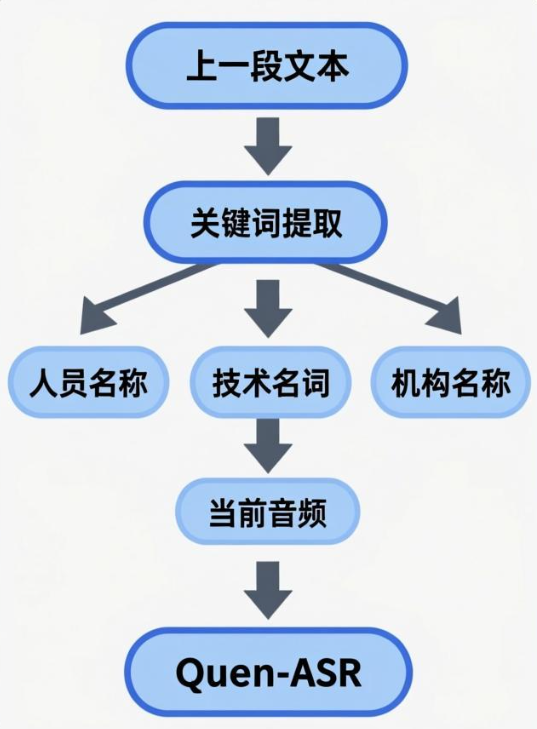
这里有一个经验:
不要把整个历史会议文本全部塞给模型。
因为上下文越长并不意味着越好。
更合理的是维护:
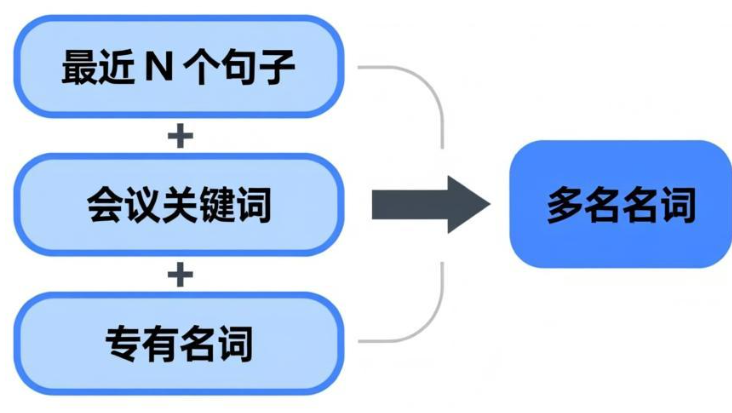
这样既能够提供上下文,又不会让推理输入膨胀得太厉害。
六、建立"疑似漏字检测器"
这一块是我们后来比较重视的地方。
因为单纯依赖 ASR:
模型说识别完成了,我们就认为完成了。
这个思路是不够的。
我们需要在 ASR 后面再增加一层:
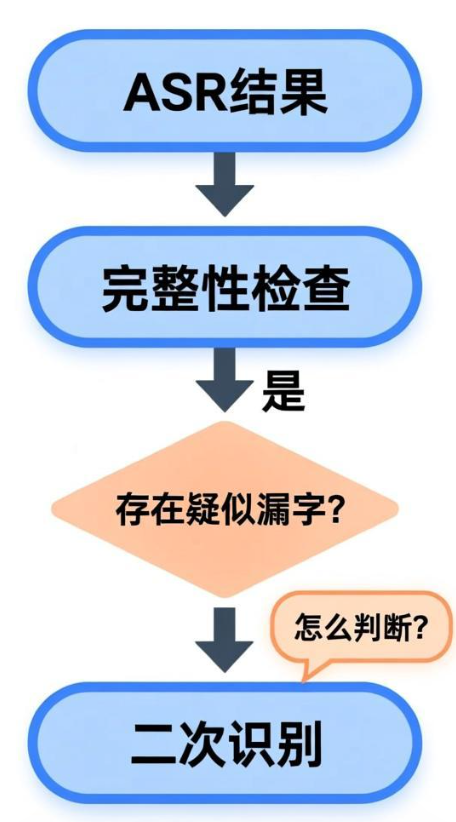
可以从几个维度做。
1. 句子长度异常
假设前后几句话平均:
25字 31字 28字 30字 突然出现:
8字 但是音频实际持续了 9 秒。
那么这句话就比较可疑。
可以定义一个简单指标:
音频时长 / 文本字数 如果明显偏离历史正常区间,就进入复检队列。
当然,这只是一个启发式规则,不应该直接当成准确率指标。
2. 时间戳异常
如果 ASR 或后处理链路能够拿到时间信息,可以观察:
start_time end_time text 例如:
00:10.2 - 00:13.8
"我们计划下周完成"
但是实际音频:
00:10.2 - 00:18.5
中间有明显的语音活动。
这种情况就值得重新检查。
Qwen3-ASR 项目同时提供 Forced Aligner 模型,可以将文本和音频进行时间对齐,这类能力对于定位文本与语音之间的异常关系比较有帮助。
七、第二路 ASR:不要让一个模型决定最终文本
这是实际系统里面一个很实用的方案。
我们可以设计:
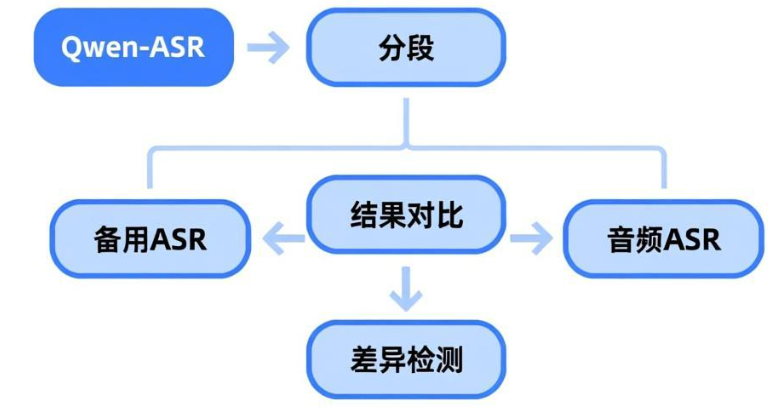
备用模型不一定需要一直跑。
只有出现:
疑似漏字 疑似异常短文本 关键词缺失 时间戳异常 的时候,再触发第二路识别。
这样可以降低整体计算成本。
例如:
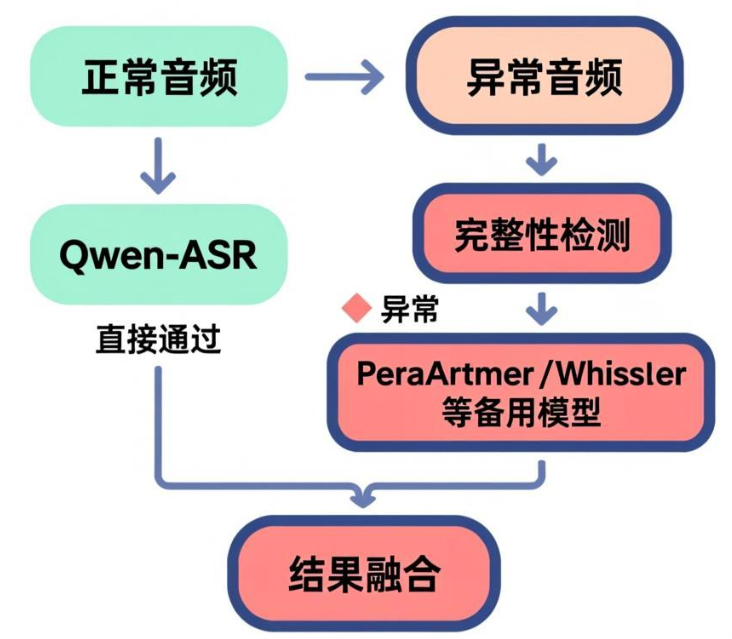
这里的重点不是"哪个模型一定比哪个模型好"。
而是:
让模型之间形成互相校验。
八、为什么推荐增加 Paraformer / Whisper 作为兜底
在会议场景中,Qwen-ASR 可以作为主模型。
另外准备:
Paraformer
Whisper / Faster-Whisper
其他企业内部 ASR
作为备用识别通道。
原因很简单:
不同模型对于不同声音、不同噪声和不同语言习惯的错误分布并不完全一致。
例如:
Qwen-ASR:
"上海熙瑾信息技术有限公司"
备用ASR:
"上海熙瑾信息技术有限公司"
→ 正常
但如果出现:
Qwen-ASR:
"熙瑾信息技术有限公司"
备用ASR:
"上海熙瑾信息技术有限公司"
那么:
差异:
上海
就可以被识别出来。
这时候不要让大模型"猜"。
而是:
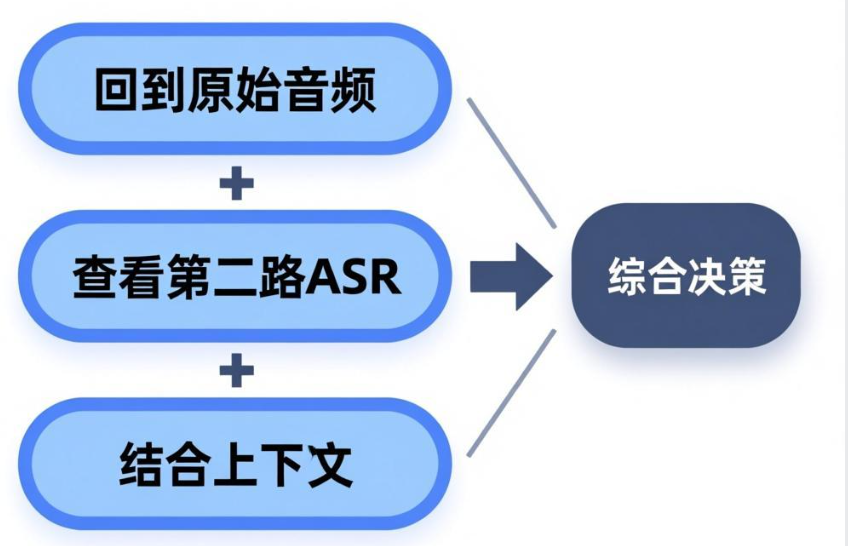
再决定最终文本。
九、专业名词是会议 ASR 最容易出问题的地方
普通聊天:
"今天下午开个会。"
错一个字影响不大。
但是企业会议:
"使用 Spring Cloud Gateway 对服务进行统一路由。"
如果识别成:
"使用 Spring Cloud 对服务进行统一路由。"
虽然句子依然通顺,但技术含义已经发生变化。
所以熙瑾·会悟这类企业会议产品,还需要增加一个:
专有词典
例如:
Spring Cloud
Spring Boot
MyBatis
Elasticsearch
Qwen-ASR
Paraformer
TiDB
MinIO
Kafka
Flink
MapLibre
企业内部还可以增加:
项目名称
部门名称
人员名称
客户名称
产品名称
机构名称
技术术语
然后对 ASR 输出进行二次检查。
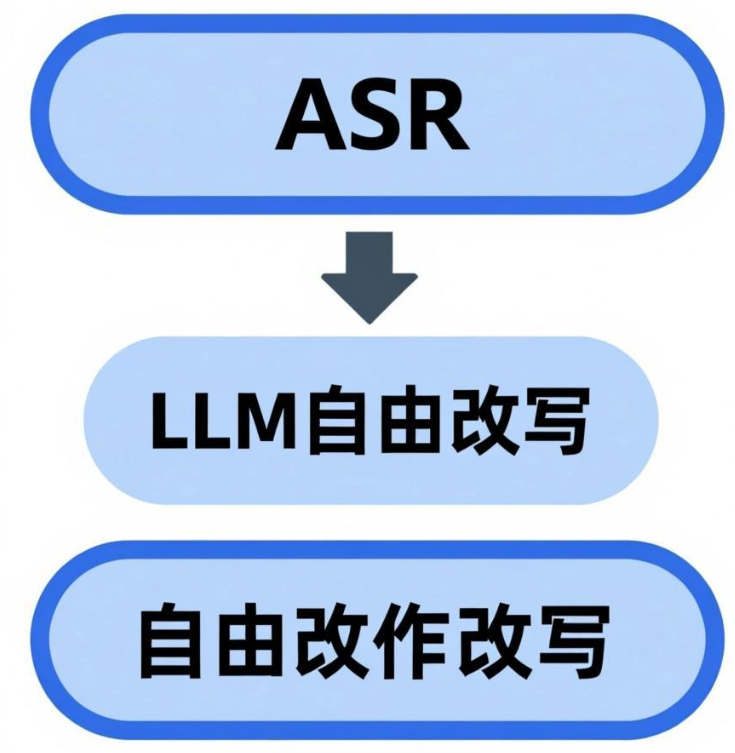
十、文本纠错不要直接"重写全文"
这里有一个坑。
ASR 出来以后,很多系统喜欢直接:
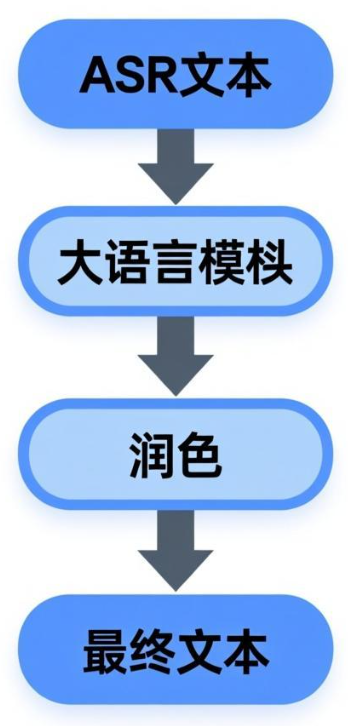
看起来很方便。
但对于会议记录,这是比较危险的。
因为 LLM 很容易把:
"可能是"
改成:
"就是"
把:
"预计下个月"
改成:
"下个月"
甚至把原本不完整的句子补成一个看起来合理、但实际上并没有说过的句子。
所以我们的处理原则应该是:
ASR负责忠实转写,LLM负责辅助整理,不负责凭空补充事实。
可以设计成:
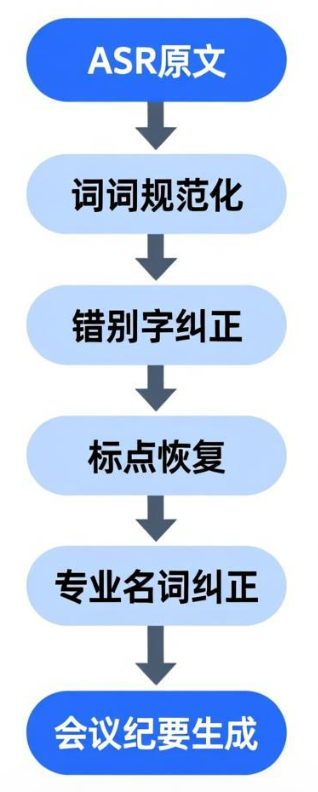
而不是:
十一、从工程角度调整 Qwen-ASR 推理参数
模型参数也值得检查。
尤其需要关注:
max_new_tokens
temperature
do_sample
batch size
audio chunk
generation config
其中 max_new_tokens 如果设置得过小,确实可能造成输出长度不足。
例如一段较长音频:
输入音频:35秒
预计文本:200字
max_new_tokens:设置过低
模型输出可能提前结束。
所以在排查漏字时,建议先检查:
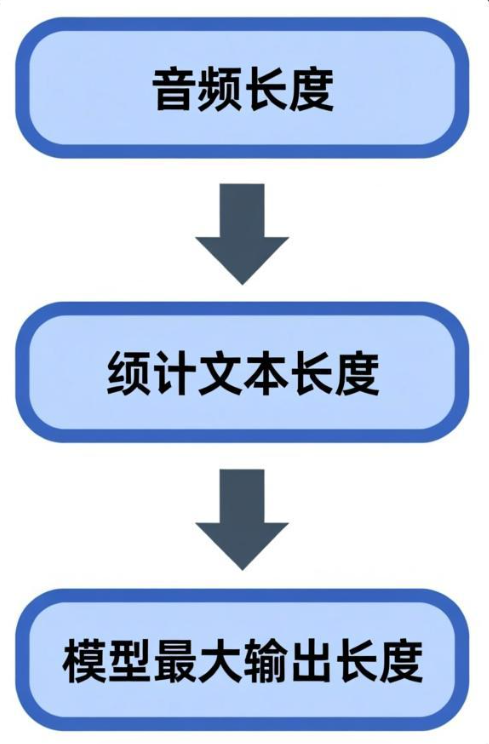
是否匹配。
Qwen3-ASR 的模型配置和推理实现可以从官方仓库及 Hugging Face 模型文件中查看,实际部署时建议以所使用版本的官方配置为准,而不要直接套用其他 ASR 项目的参数。
十二、一个比较实用的整体架构
经过前面的调整以后,熙瑾·会悟的 ASR 处理思路可以抽象成:
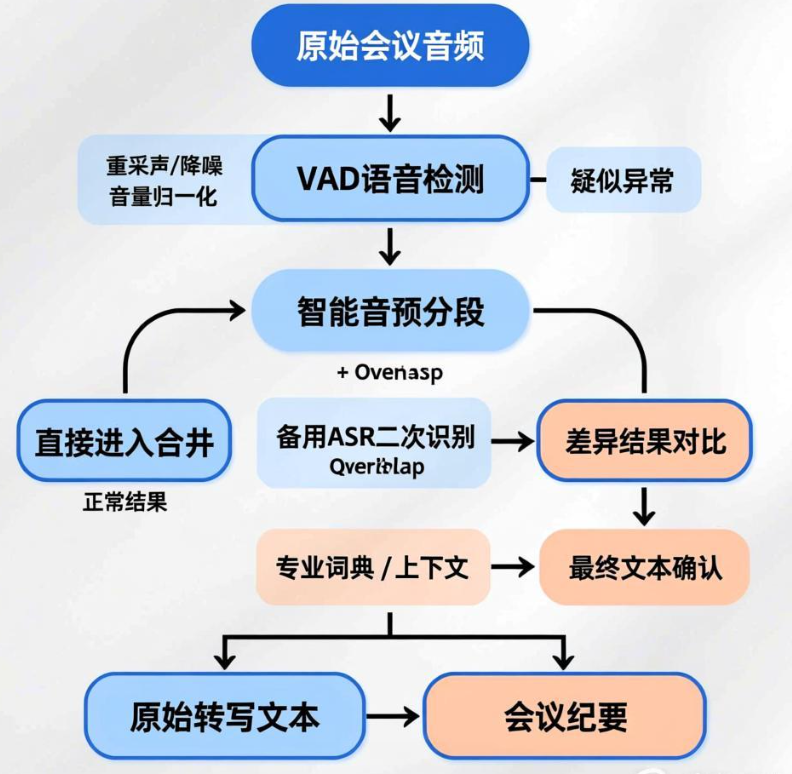
这套结构的好处是:
不会把所有问题都压在一个模型上。
十三、代码层面可以怎么实现?
下面给一个简化后的伪代码,实际项目可以根据 Python 推理服务或者 Java 后端进行调整。
def` `recognize_meeting(audio):`

    `# 1. 音频预处理`
`    audio = normalize_audio(audio)`
`    audio = denoise(audio)`

    `# 2. VAD`
`    speech_segments = vad(audio)`

    `# 3. 智能分段`
`    chunks = split_audio(`
`        speech_segments,`
`        chunk_size=20,`
`        overlap=2`
    `)`

`    results =` `[]`

`    context =` `""`

    `for chunk in chunks:`

        `# 4. Qwen-ASR 主识别`
`        text = qwen_asr(`
`            chunk,`
`            context=context`
        `)`

        `# 5. 完整性检测`
`        suspicious = check_transcript(`
`            audio=chunk,`
`            text=text`
        `)`

        `# 6. 异常才启动备用模型`
        `if suspicious:`
`            backup_text = paraformer_asr(chunk)`

`            text = merge_asr_result(`
`                text,`
`                backup_text`
            `)`

        `# 7. 更新上下文`
`        context = update_context(`
`            context,`
`            text`
        `)`

`        results.append(text)`

    `# 8. 最终合并`
`    final_text = merge_segments(results)`

    `# 9. 专业词纠错`
`    final_text = correct_terms(final_text)`

    `# 10. 标点恢复`
`    final_text = punctuation_restore(final_text)`

    `return final_text`
`
这里有一个比较关键的地方:
if suspicious:`
`    backup_text = paraformer_asr(chunk)`
`
备用模型不是每次都跑。
这样才能兼顾准确率和推理资源。
十四、不要只看"识别准确率",要建立自己的评测集
解决问题以后,还需要验证到底有没有改善。
建议建立一套企业自己的 ASR 测试集。
比如:
普通办公室会议 20条
多人会议 20条
远距离麦克风 20条
嘈杂会议室 20条
多人抢话 20条
技术讨论 20条
政企正式会议 20条
长时间会议 20条
每条音频保留:
原始音频
人工标注文本
ASR文本
修正文本
然后重点统计:
WER
Word Error Rate,词错误率。
CER
Character Error Rate,字符错误率。
对于中文会议转写,CER 往往更加直观。
还可以增加:
漏字率
错字率
专有名词错误率
数字错误率
人名错误率
时间错误率
其中我认为企业会议最应该单独关注:
数字、金额、日期、人名、项目名、专业名词。
因为这些内容一旦识别错误,影响通常比普通口语词更大。
十五、为什么"漏字率"值得单独做一个指标?
假设一段人工标注文本:
我们计划在九月底之前完成一期项目的测试工作。 ASR:
我们计划在九月底完成一期项目的测试。 从整体 CER 来看,可能并不是特别夸张。
但是从业务角度看:
"之前" "工作" 都丢了。
所以我们后来更倾向于:
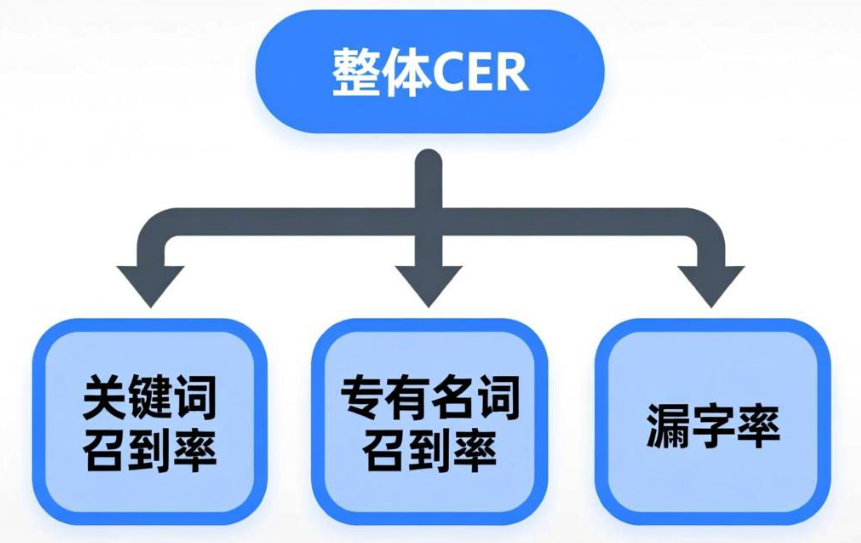
一起看。
这样才比较符合企业实际使用场景。
十六、这次问题最终让我比较有感触的一点
做 ASR 系统,很容易陷入一个误区:
模型越大,识别一定越准。
实际项目不是这么简单。
模型只是其中一个环节。
尤其是会议场景,真正复杂的是:
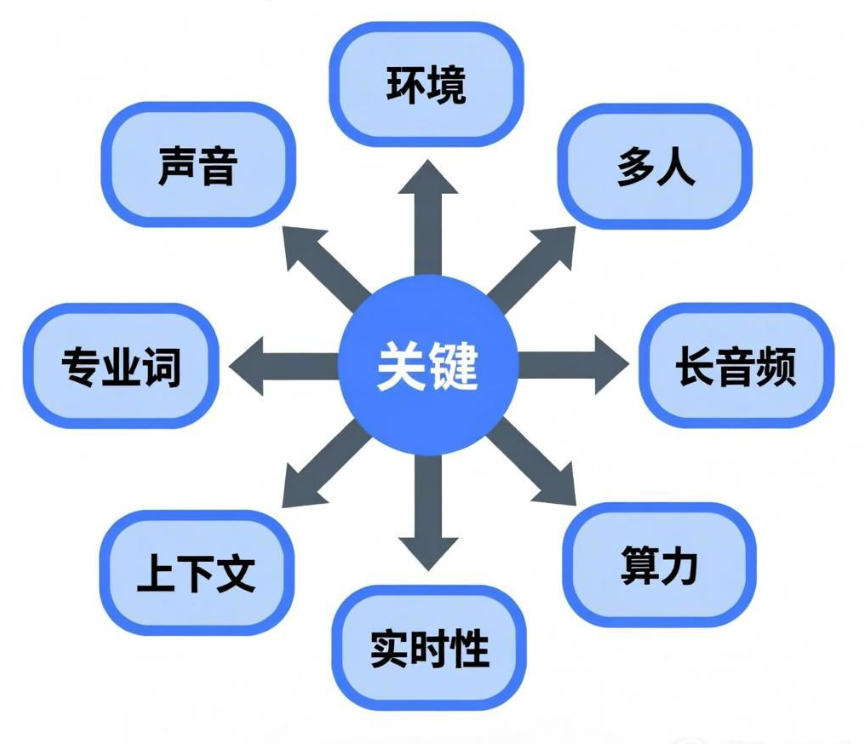
所以一个真正能用的 ASR 系统,最终拼的不是单模型,而是:
模型 + 音频处理 + 分段 + 上下文 + 纠错 + 评测 + 工程实现。
Qwen3-ASR 本身已经提供了较完整的开源 ASR 能力,同时官方也提供了 Forced Aligner 等配套模型。
对于熙瑾·会悟这样的离线会议系统而言,更现实的做法不是追求"模型一次识别百分之百正确",而是建立一套可发现、可复核、可兜底 的识别链路。
十七、最后总结一下这次漏字问题的解决方案
如果把整个排查过程压缩一下,可以归纳成下面几项。
|---------|------------------------------|
| 问题 | 处理方案 |
| 弱音漏字 | 音频增强、响度归一化、降噪 |
| VAD切断语音 | 调整VAD阈值和最小语音长度 |
| 分段边界漏字 | Chunk增加Overlap |
| 长音频识别异常 | 智能分段 + 分段上下文 |
| 专业名词错误 | 企业专业词典 |
| 多人抢话 | 说话人分离/声纹识别 |
| 输出长度不足 | 检查 max_new_tokens 等生成参数 |
| 单模型错误 | 增加 Paraformer / Whisper 备用识别 |
| 疑似漏字 | 音频时长、文本长度、时间戳联合检测 |
| 文本不完整 | 二次ASR + 差异对比 |
| 语句不通顺 | 标点恢复、轻量文本纠错 |
| 会议纪要失真 | 原始ASR与摘要模型职责分离 |
如果从架构上再总结一句,就是:
不要试图让一个ASR模型解决所有问题。 让模型负责"听懂", 让工程负责"检查", 让第二模型负责"兜底", 让文本模型负责"整理"。 这套思路放到熙瑾·会悟的离线会议转写场景中,会比单纯替换一个 ASR 模型更加实际。
而且从后续迭代来看,这套架构也比较容易扩展。
比如以后增加:
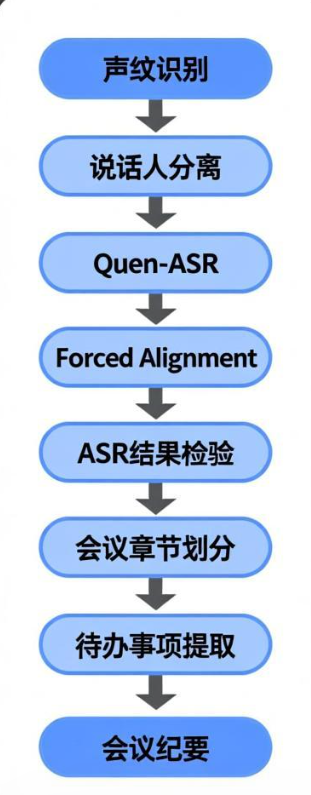
这样 ASR 就不再只是一个"把声音变成文字"的组件,而是成为整个AI会议助手的数据入口 。
这也是我们在熙瑾·会悟实际开发过程中,对 ASR 漏字问题比较深的一点体会:
语音识别的准确率很重要,但真正决定产品能不能落地的,往往是模型之外的那一整套工程链路。