一、准备工作
1.爬虫协议
爬虫协议,是每一个爬虫开发者都应该遵守的协议,但是他是一个君子协定,并不是强制协定,但为了维护网络环境,大家都应该遵守下,把环境搞臭了,还是程序员受害。
那爬虫协议怎么看呢,我们可以瞅瞅B站的爬虫协议,获取方式如下:
shell
https://www.bilibili.com/robots.txt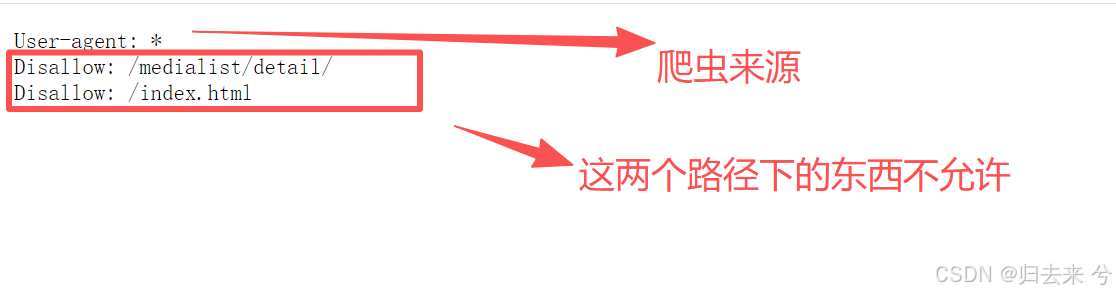
访问上面地址后,我们就可以看到B站的爬虫协议了,他的不允许爬取的内容有两个大类,第二个是首页内容,因为首页内容访问量很大,如果大家都来爬这个数据,那么对B站来说,压力会很大,一般这类TOC的网站,首页都是不允许爬取的。
下面再来看下百度的,爬虫协议
shell
https://www.baidu.com/robots.txt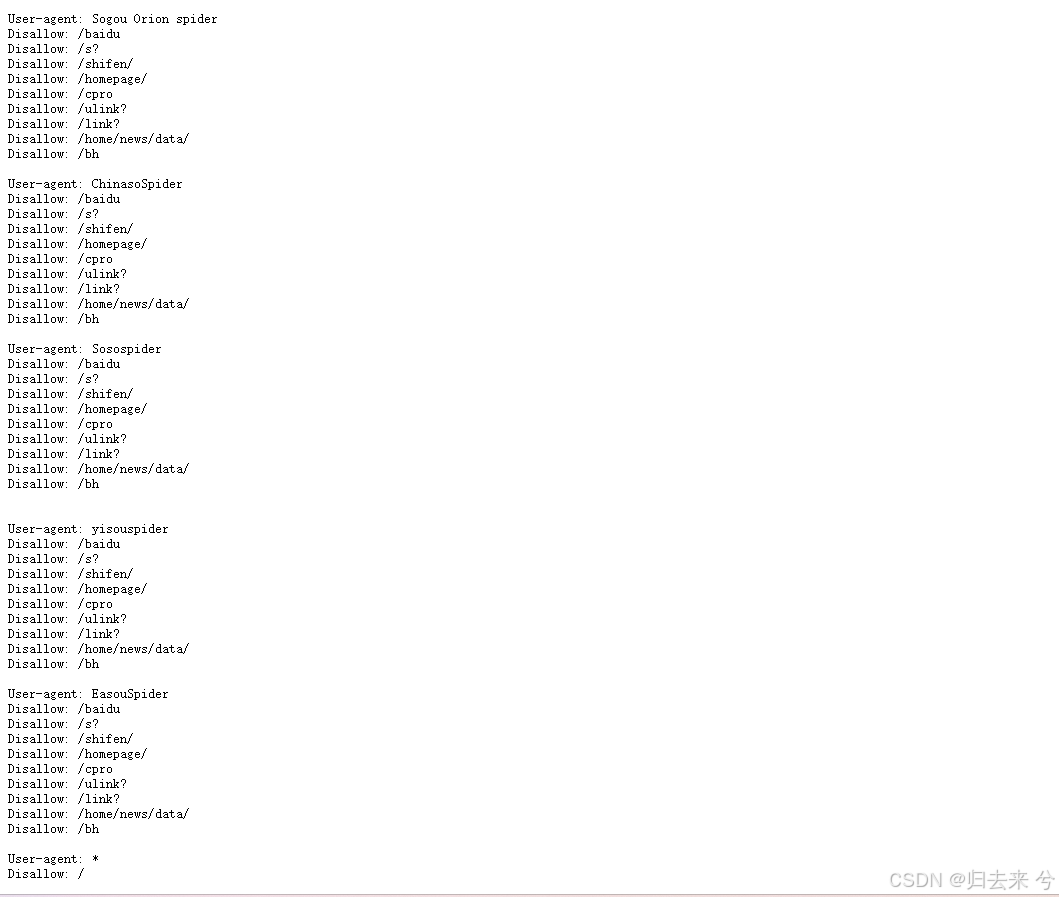
可以看到除了百度声明的一些爬虫外,百度禁止一些数据爬取行为,因为百度的访问量很大,如果大家爬取数据,对他压力确实很大,也能理解。
2.准备工作
-
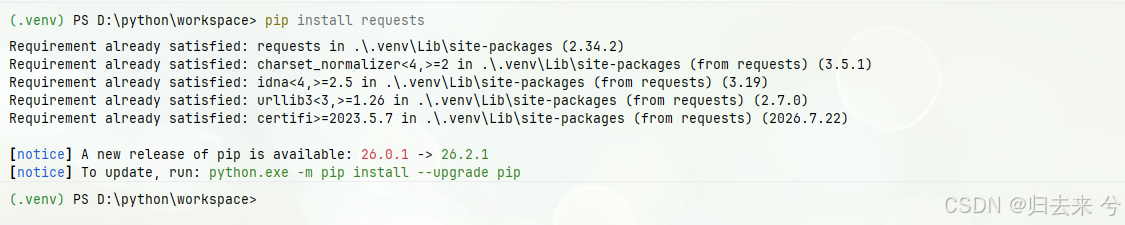
python安装 requests
pythonpip install requestsrequests被誉为python中最好用的三方http客户端包,网络请求必备
-
python安装lxml
这是一个高性能的html/xml这种标记语言的解析库,支持Xpatch语法获取前端资源和数据,Xpatch是前端根据标签获取数据的一种原始方式。对于标签语言获取数据很是方便。
shellpip install lxml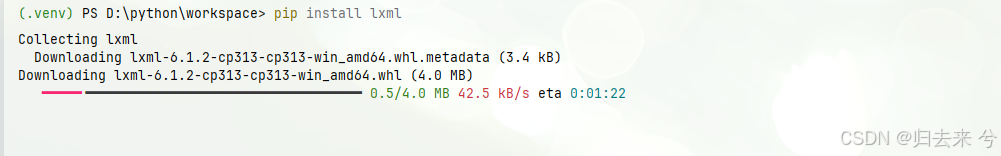
3.lxml基础语法
这里主要介绍下爬取数据时,获取数据定位元素的语法,假设有如下程序:
html
<html style="height: 100%">
	<body class="layui-layout-body" style="height:100%; overflow: auto;">
		<div class="layui-layout layui-layout-admin" style="height:100%">
			    <input type="hidden" value="false" id="commonLogin">
			    <input type="hidden" value="false" id="commonUserHasVip">
		 </div>
		 <div class="layui-layout layui-layout-admin" style="height:100%">
			    <input type="hidden" value="false" id="commonLogin">
			    <input type="hidden" value="false" id="commonUserHasVip">
		 </div>
	</body>
</html>
下面根据上面标签来进行解释语法
- / 从根节点的直接子元素查找
/html 表示从根节点开始查找所有的html标签,返回一个list,再比如 /html/body/div 则是查找所有的div标签返回一个list - // 从任意位置查找
也就是全文超找该标签,然后返回list,比如 //div,则是会返回一个拥有两个div元素的list - . 点表示从当前元素下开始查找
比如使用 //div获取到了两个div标签,但是div下的还有其他东西,我们这时候就可以基于当前元素继续查找,此时使用点 ./input 即可查找到input标签, 如果是.//input,则表示 从当前节点的任意位置查找input - n 获取查到的第n个标签
比如如果上面使用//div查到2个,如果只想要第一个,可以这么写//n1,注意这里没有下标0的场景,如果想要获取最后一个可以直接使用//divlastIO,这样就能获取到最后一个div了,
此外还可以增加别的条件,//div@style,表示查找拥有属性style的div标签,如果再细点还可以,
//div@style='height:100%',表示查找属性值为指定值的元素 -
- 表示匹配任何元素
/html/*,则表示查找html下的所有元素
- 表示匹配任何元素
- @* 匹配元素的属性
@ //div/@* 上面示例则表示匹配到了2个div - text() 获取标签内容
注意lxml获取标签后不会默认拿文本,而是拿的标签,如果想要取文本必须使用text(),
如://div/input/text(),则表示获取所有input的文本内容。
二、爬取数据
下面是爬取http://xzqh.mca.gov.cn/statistics/2022.html,行政区划网页的示例
注意:这个网站没有放爬取规范,笔者才弄得,如果有禁止爬取的声明,最好不要处理,有一定法律风险。
整体示例代码:
python
import requests as http
from lxml import html

resp = http.get("http://xzqh.mca.gov.cn/statistics/2022.html")
# 注意网页编码,有的并不是utf-8,不是的话就得指定
resp.encoding = 'gb2312'
# 获取html的格式化对象
document = html.fromstring(resp.text)
# 意思是全局找带有属性colspan='2'的td标签,在找下面的div,获取他们的内容
str_list = document.xpath("//td[@colspan='2']/div/text()")

for city in str_list:
    print(city)
可以发现使用python编写爬虫其实很简单,相当于其他语言来说很轻量
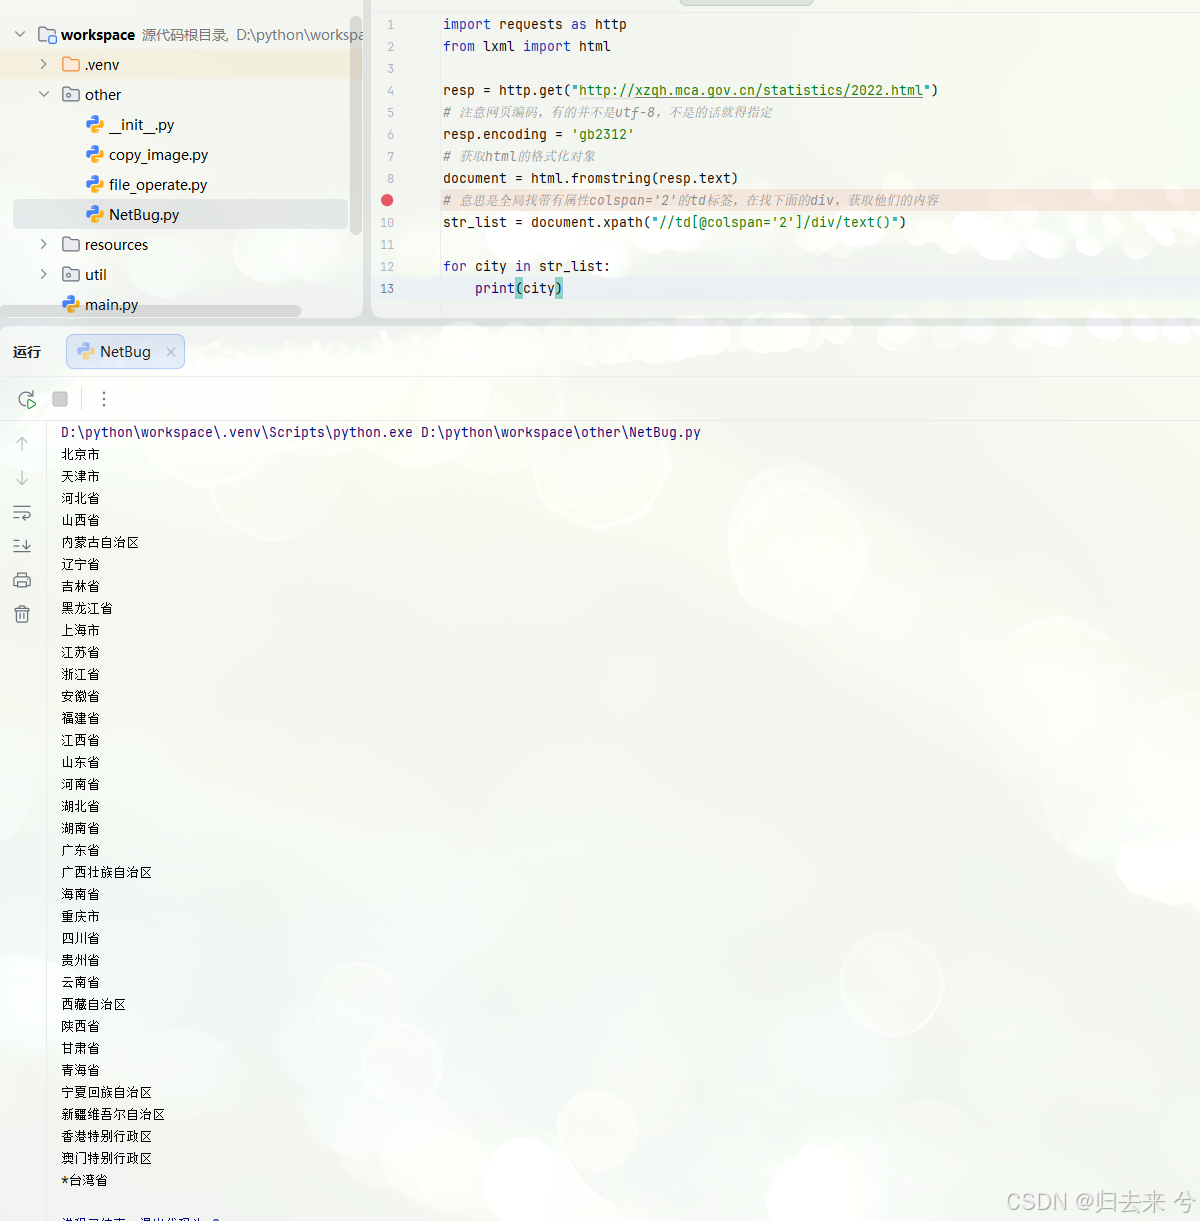
注意:
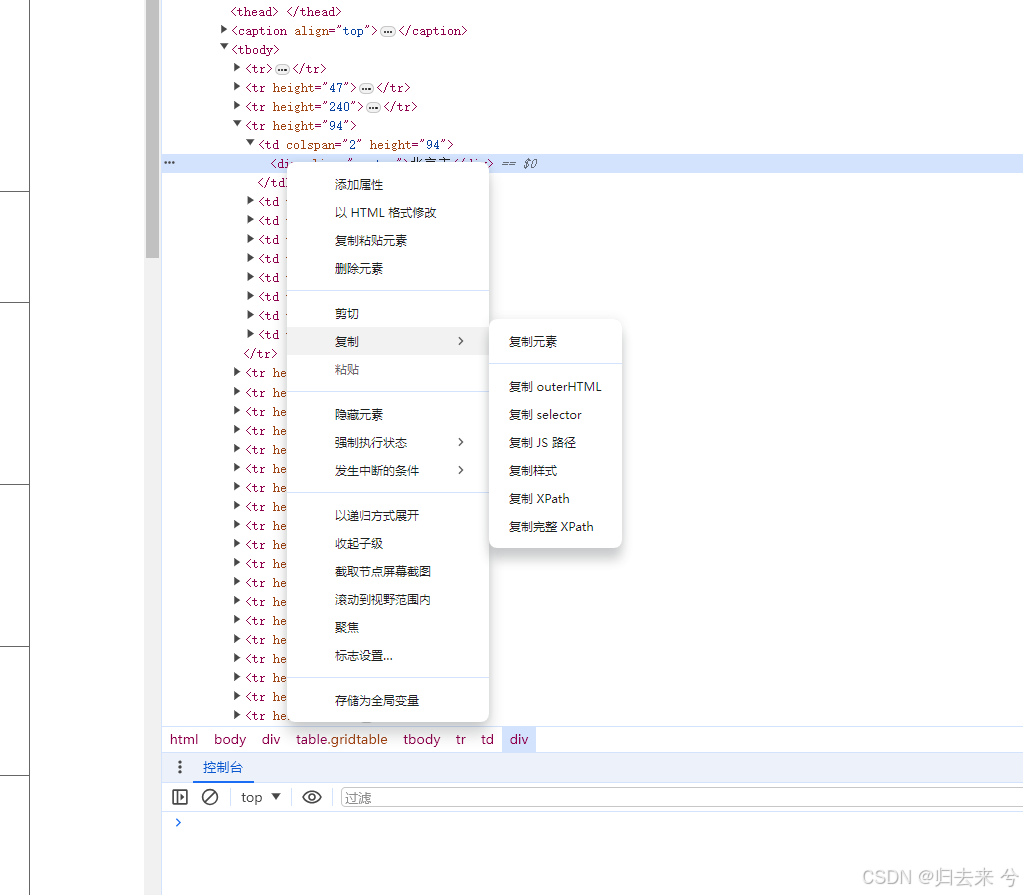
- Xpath的路径,可以通过如下方式快速获取
f12,然后选中元素,点击图中想要获取的内容
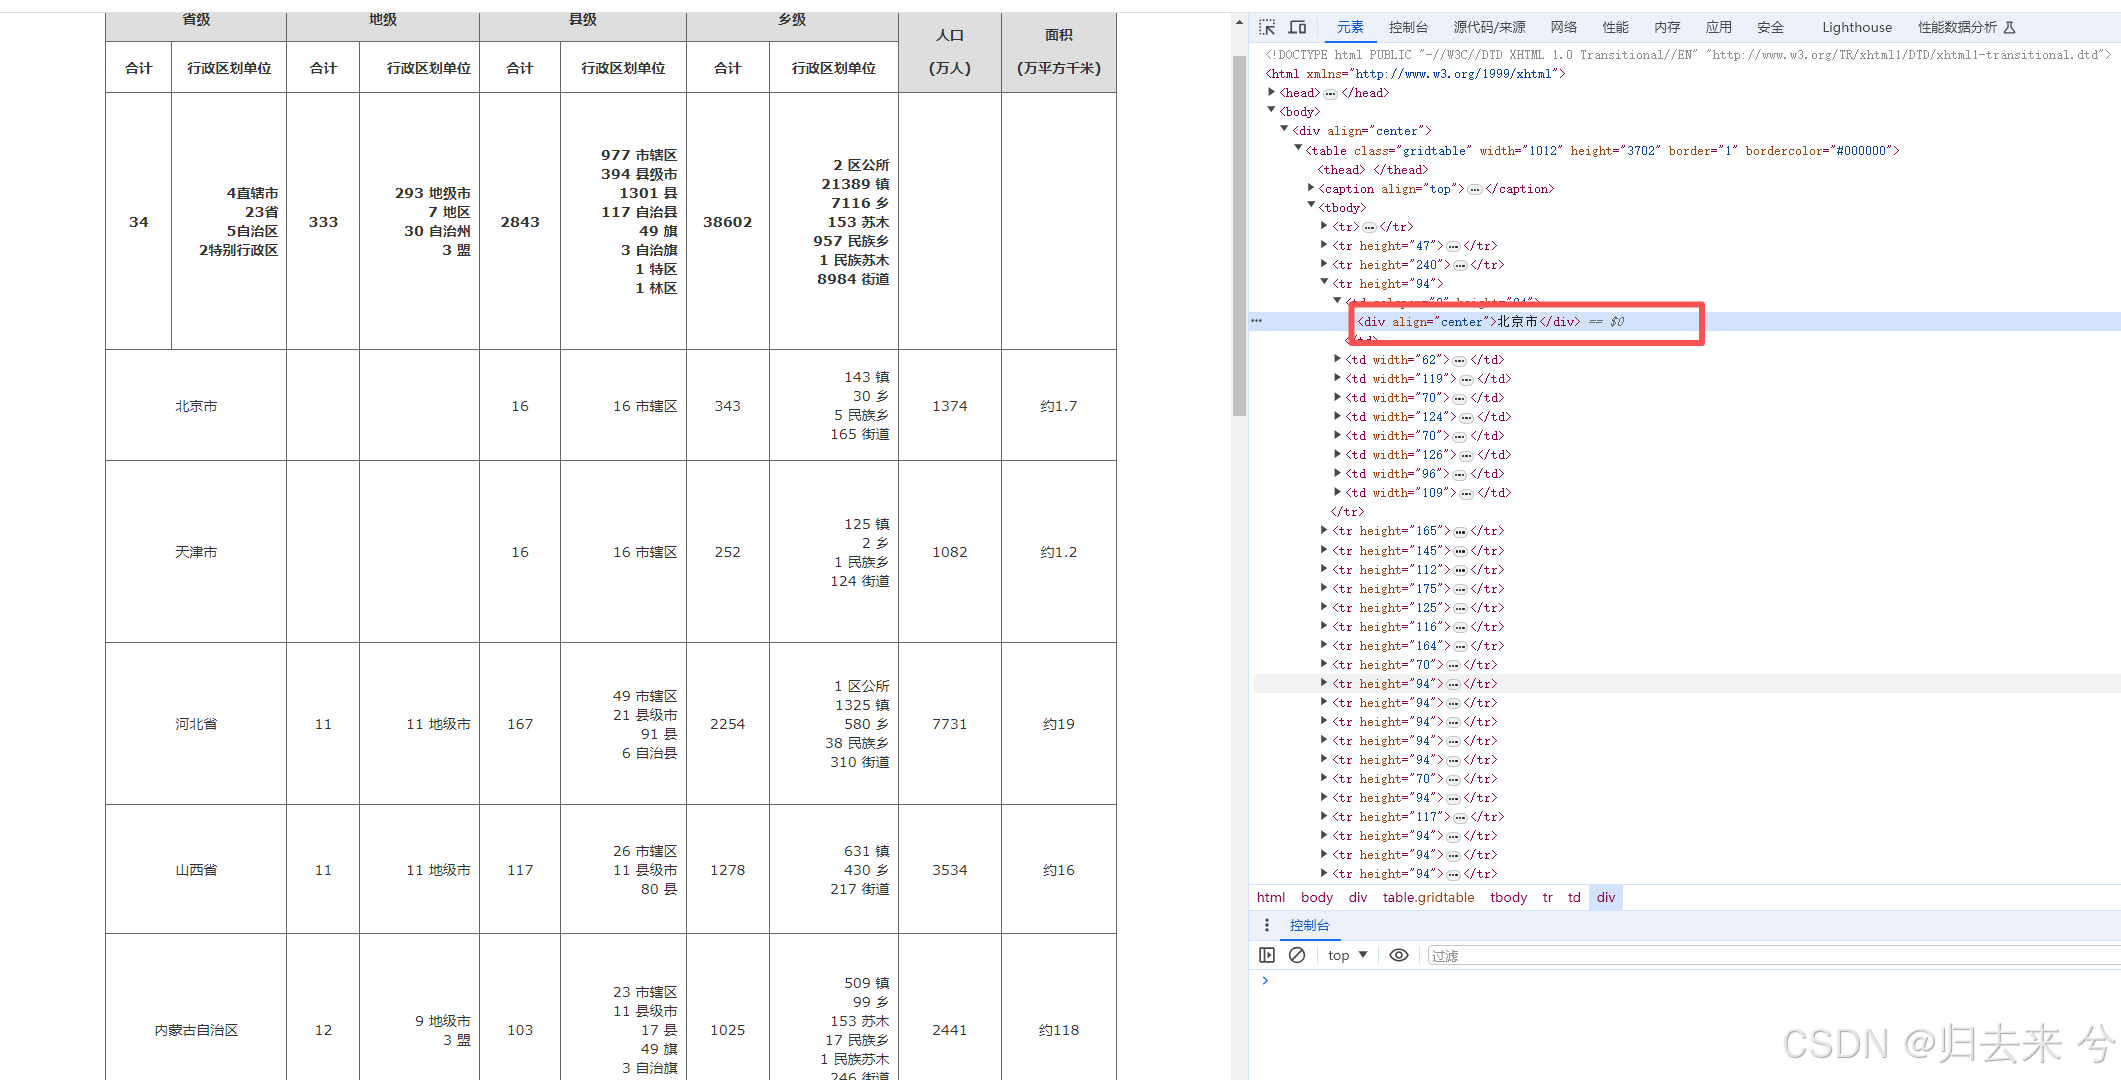
右键获取如下,选择复制XPath,或者复制完整XPath都是可以快速获取路径的