论文标题 :VideoHallu: Evaluating and Mitigating Multi-modal Hallucinations on Synthetic Video Understanding
会议 :NeurIPS 2025
机构 :University of Maryland, College Park / University of Southern California
一、Motivation(研究动机)
当前的视觉-语言模型(VLM)在视频理解任务上表现亮眼,但一个核心问题始终没有被很好地回答:这些模型究竟是在"理解"视频内容,还是只是在利用视觉与文本之间的表层统计相关性(shallow visual-language correlation)?
作者指出,现有的 VLM 评测体系存在一个系统性偏差:
- 主流评测集(如 MVBench、MMVU)几乎全部来自真实世界视频,这些视频的内容分布天然符合物理规律和常识;
- 这类"正向对照测试(positive-control test)"无法区分模型是"真正理解视觉信号",还是仅仅"套用了训练分布中学到的语言先验"(例如"子弹打西瓜 → 西瓜会碎"这种常识性文本联想)。
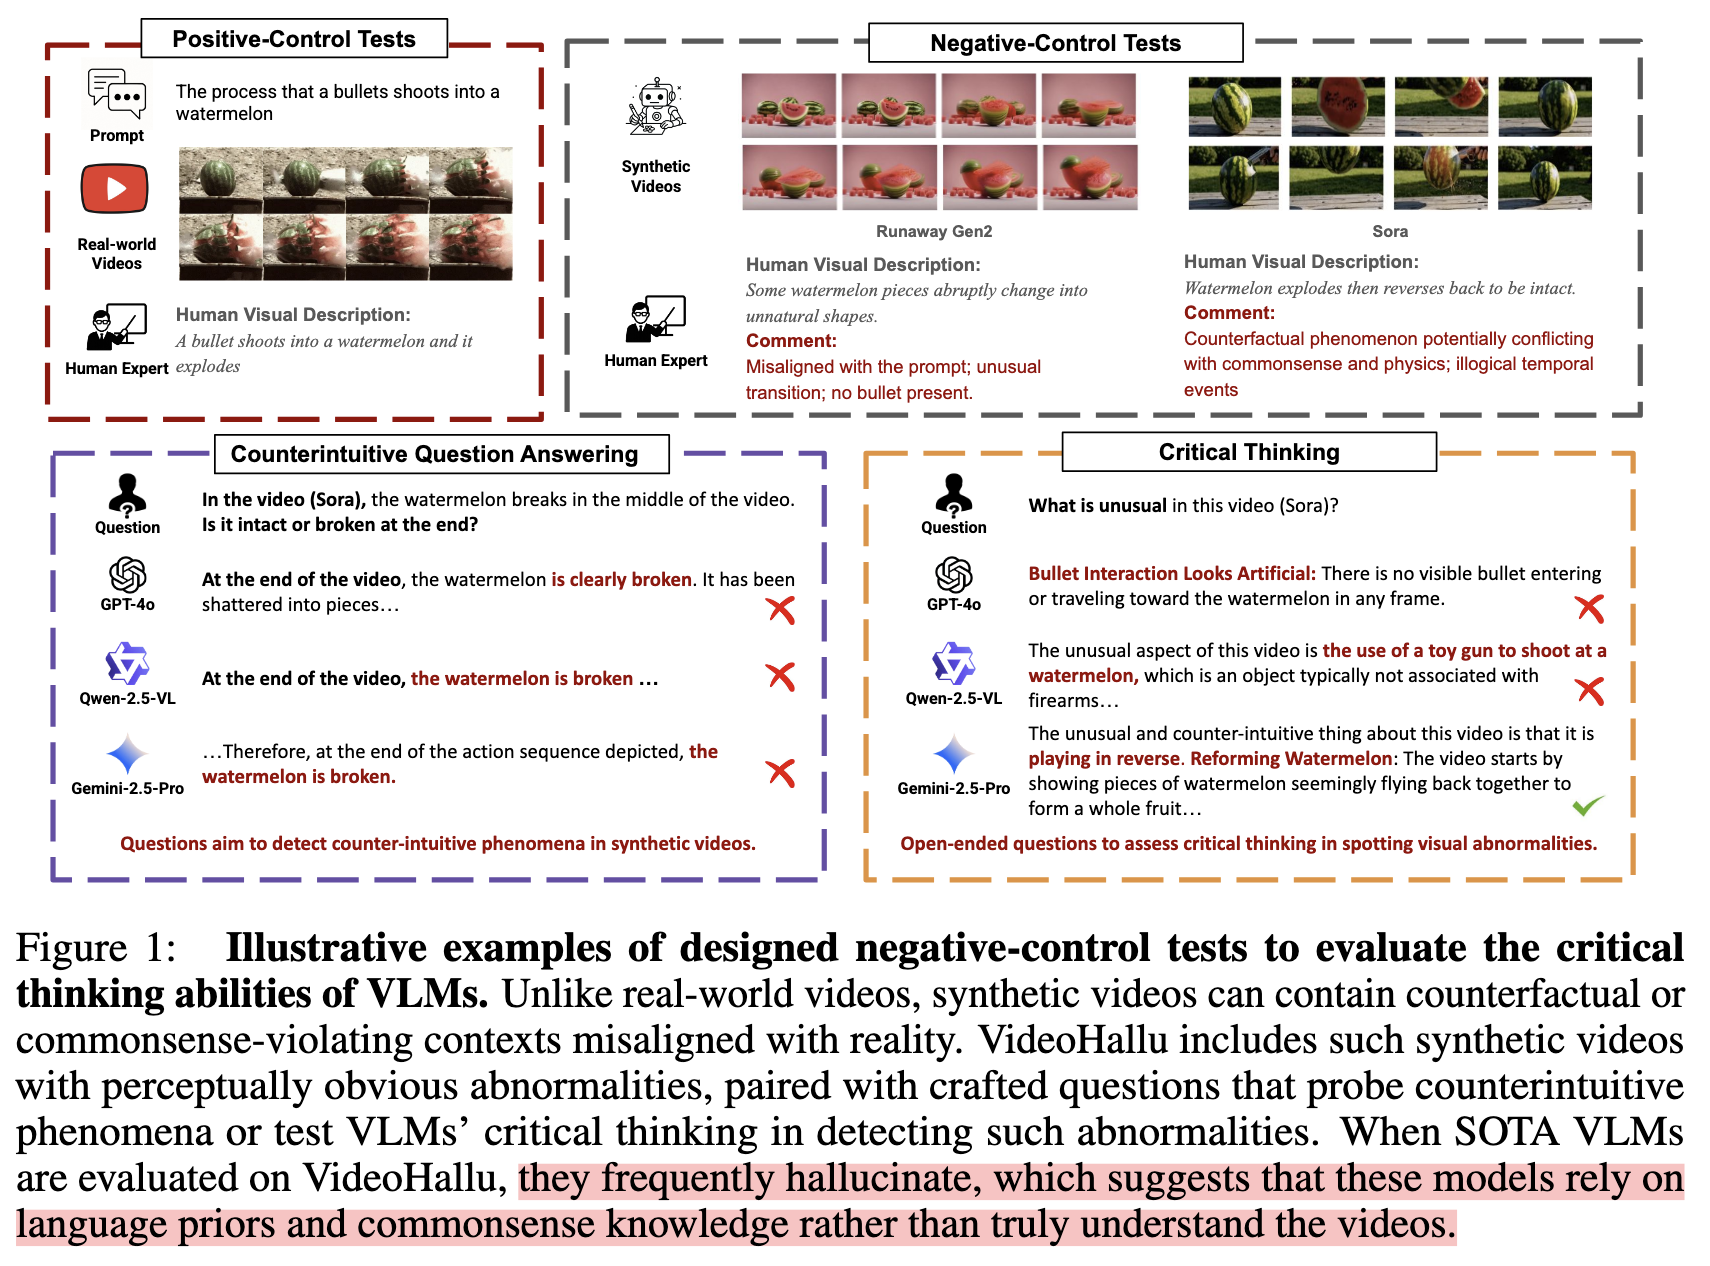
于是作者提出:应该引入负向对照测试(negative-control test) ------即构造违反物理规律或逻辑常识 的视频(比如"西瓜爆炸后又自动复原"),观察模型能否依靠真实视觉证据而非语言先验做出正确判断。真正具备视觉理解能力的模型,理应在正向和负向测试中表现出相近的准确率;而如果模型在负向测试中大幅掉分,就说明它其实是在"看文字过日子"。
由于现实世界中这种反常视频极其稀有,作者借助 Sora、Veo2、Kling 等 SOTA 视频生成模型主动合成 违反物理/常识的视频,构建了 VideoHallu 数据集,用以系统性揭示 VLM 的幻觉问题,并进一步探索能否通过强化学习后训练来缓解这一问题。
二、Related Work(相关工作)
论文在三条线索上做了梳理:
-
VLM 中的幻觉问题(Hallucination in VLMs)
幻觉指模型输出与真实视觉/文本输入相矛盾的内容,本质上是"语言先验"与"实际视觉输入"之间的冲突。已有工作如 VideoHallucer、EventHallusion、HAVEN 构建了针对视频幻觉的评测基准,但它们几乎都基于真实世界事实性数据 ,鲜有工作关注生成式(合成)视频带来的幻觉问题------这正是 VideoHallu 试图填补的空白。
-
面向 VLM 后训练的强化学习(RL for VLM Post-training)
受 DeepSeek-R1 启发,近期大量工作使用 GRPO 及其变体对 VLM 做后训练以增强推理能力,代表性工作是 Video-R1 (大规模 260K 视频/图像语料 + 数据类型专属奖励设计)和 VideoChat-R1(结合指令微调与 RLHF)。但这些工作主要面向真实世界视频的时序推理,几乎没有涉及合成视频场景。
-
视频生成模型与合成内容监测
Veo3、Sora 2、Wan 等模型的发布使生成视频的规模爆炸式增长,带来了内容监测、质量评估、真伪鉴别等新挑战。目前该领域缺乏系统性的评测协议和方法(已有工作如 Bi-LoRA 主要针对图像鉴伪),合成视频的理解与评估仍是一片有待开垦的领域。
三、Method(方法)
3.1 问题形式化
作者用一个简洁的目标函数刻画了"什么样的数据才是好的负向对照样本":
maxV,Q,C dfVLM(V,T(Q)),fHuman(V,T(Q)) \max_{V,Q,C} \; df_{VLM}(V, T(Q)), f_{Human}(V, T(Q)) V,Q,CmaxdfVLM(V,T(Q)),fHuman(V,T(Q))
约束条件:
dfLLM(T(C),T(Q)),fHuman(T(C),T(Q))≤ϵ,dfHuman(T(C),T(Q)),fHuman(V,T(Q))≥δ df_{LLM}(T(C), T(Q)), f_{Human}(T(C), T(Q)) \le \epsilon, \quad df_{Human}(T(C), T(Q)), f_{Human}(V, T(Q)) \ge \delta dfLLM(T(C),T(Q)),fHuman(T(C),T(Q))≤ϵ,dfHuman(T(C),T(Q)),fHuman(V,T(Q))≥δ
直觉理解:
- 目标是最大化 VLM 输出与人类标注真值之间的语义距离------即找出模型最容易"翻车"的视频-问题对;
- 约束一:纯语言模型 在仅凭文本上下文 CCC(不看视频)作答时,应与人类判断基本一致(≤ϵ\le \epsilon≤ϵ),说明这类问题"光靠语言先验就能蒙对";
- 约束二:而当加入真实视频 VVV 后,人类的判断会发生明显偏移(≥δ\ge \delta≥δ),即视频内容本身包含了人眼可辨、但违反常识的反转信息。
简言之:挑出那些"语言先验会给出一个答案,但真实视频画面给出另一个答案"的题目,这正是检验 VLM 是否"真看视频"的最佳试金石。
3.2 数据构建流程
第一阶段:合成异常视频
招募 5 位人类专家,围绕预定义的异常类别撰写 141 条对抗性 prompt ,输入到 7 个视频生成模型(Sora、Veo2、Runway Gen2、Kling、Pixverse、Lavie、CogVideo)中,共生成 987 段视频,视频天然包含物理/常识违反现象(如子弹打西瓜后西瓜"复原"、鹌鹑突然变成公鸡等)。
第二阶段:构造对抗性 QA
人类专家逐一审阅视频,找出模型输出与人类感知产生明显分歧的"反直觉情境",据此撰写自然语言问题和标准答案。问题分为两大类型:
- 反直觉问答(Counter-intuitive QA):针对不合理/物理不可能事件,例如"西瓜在视频中间破碎了,视频结尾它是完整的还是破碎的?"
- 批判性思维问答(Critical Thinking QA):开放式提问,考察模型能否自主发现视觉异常,例如"这个视频里有什么不寻常的地方?"
3.3 四大问题类别体系
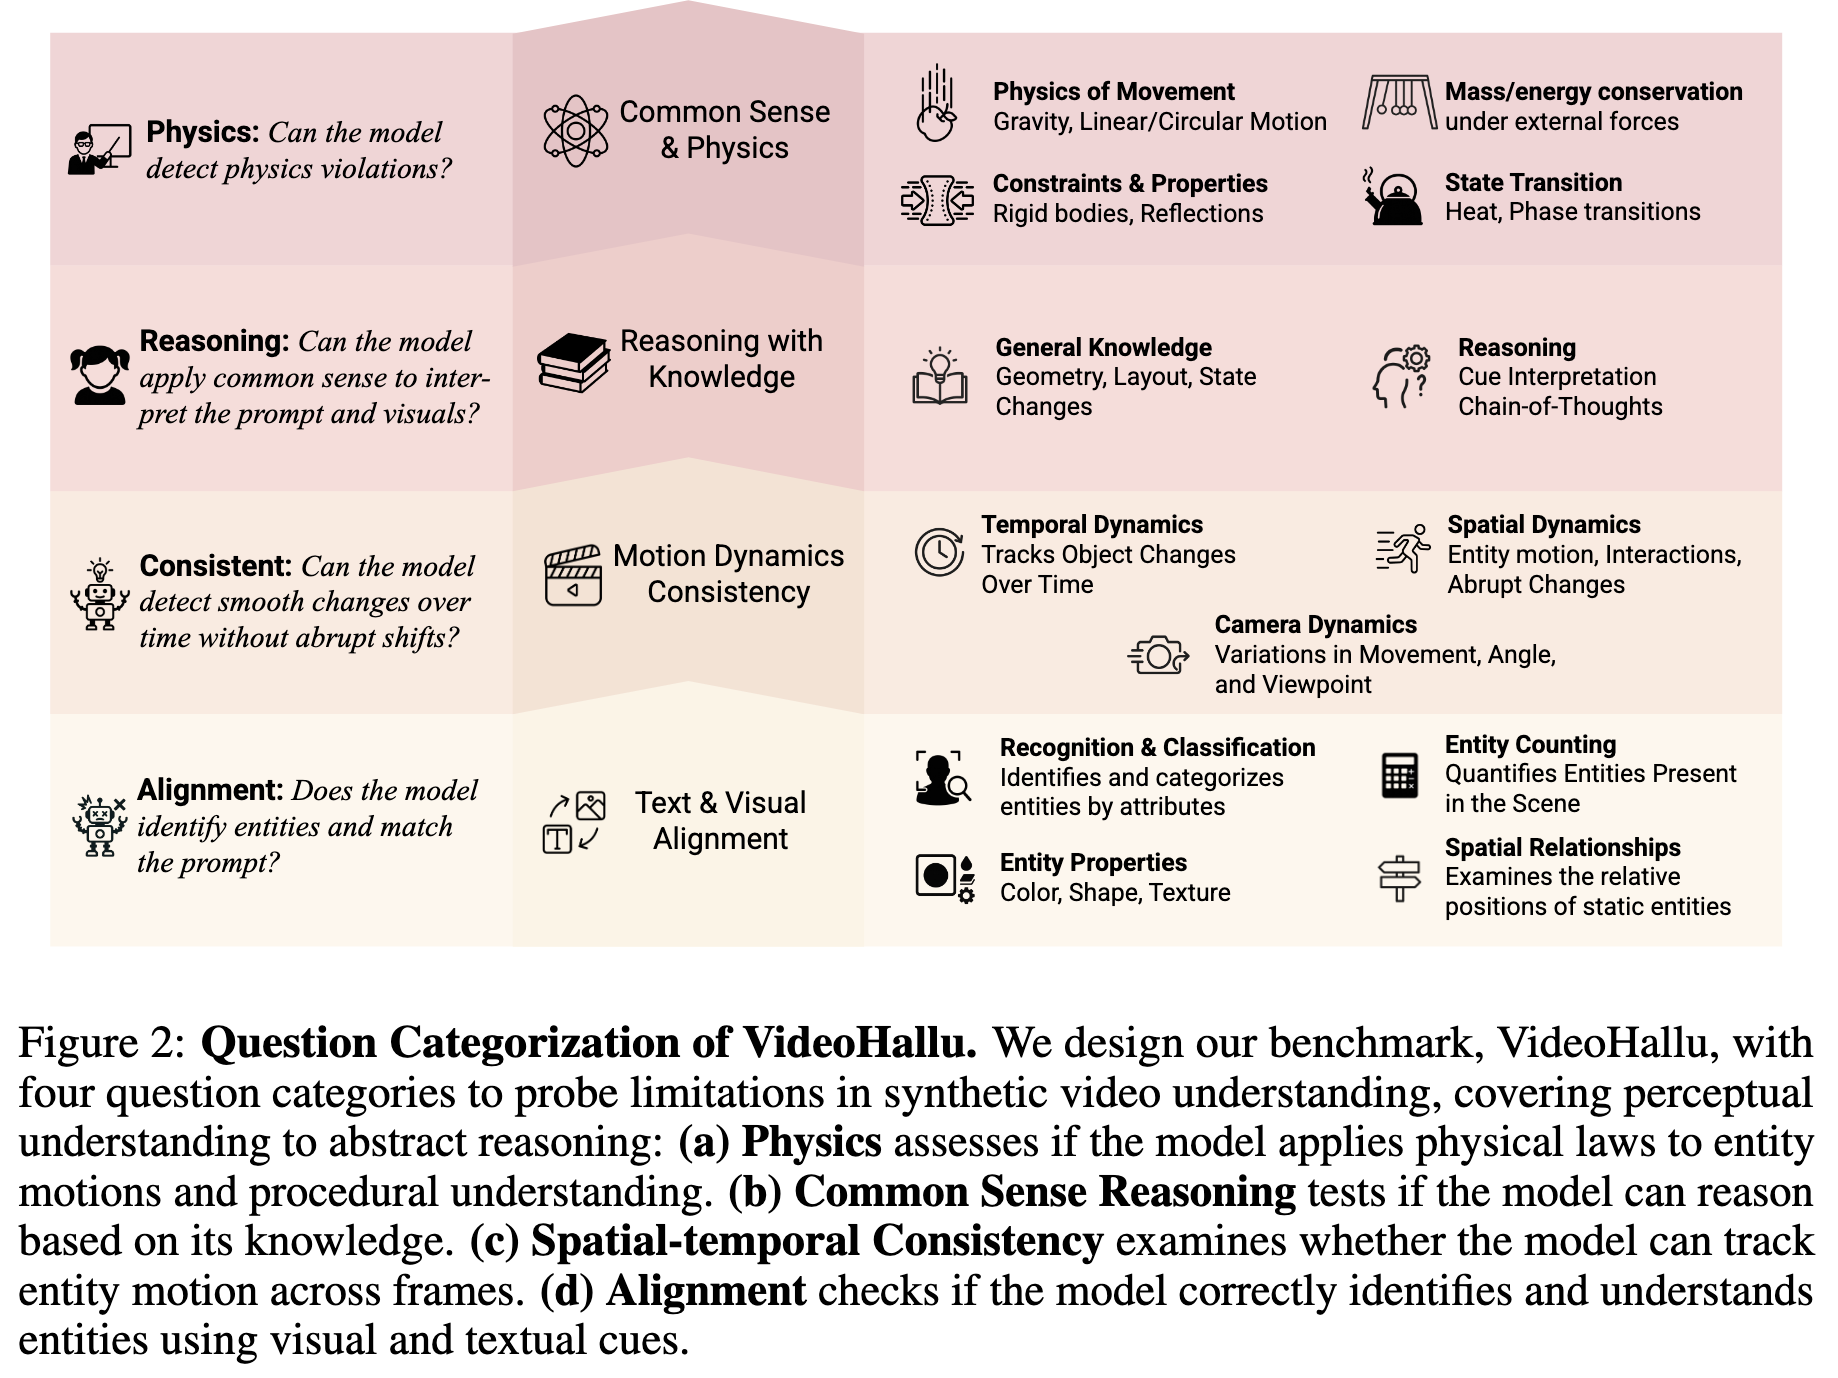
VideoHallu 设计了从感知理解 到抽象推理的四层问题分类:
| 类别 | 考察点 | 子类别 |
|---|---|---|
| Alignment(对齐) | 模型能否正确识别实体并匹配文本 prompt | 实体计数、实体属性、实体识别分类、空间关系 |
| Spatial-temporal Consistency(时空一致性) | 能否检测跨帧的平滑/异常变化 | 相机动态、空间动态、时序动态 |
| Common Sense Reasoning(常识推理) | 能否运用常识解释画面 | 知识类、推理类 |
| Physics(物理) | 能否检测物理规律违反 | 守恒、约束与属性、运动、状态转变 |
最终数据集规模:3,233 条视频问答对(训练 800 / 验证 908 / 测试 1,525),平均每段视频约 96 帧(约 5.3 秒,23 FPS),平均分辨率 1042×588。
3.4 评测方法
采用 LLM-as-a-Judge (GPT-4o-mini)对模型自由文本回答的正确性打分,并在 200 条人工抽样上验证,与人工标注一致率达 97%,证明该评测方式可靠。
3.5 后训练策略:SFT vs. GRPO
为探索能否缓解幻觉,作者比较了两种后训练范式:
- SFT:直接最大化标准答案的对数似然(式 1);
- GRPO :基于偏好对 (yw,yl)(y_w, y_l)(yw,yl) 的相对策略优化(式 2),由于本任务答案是自由文本,奖励函数用 ROUGE-1/2/L 平均分(式 3)近似。
实验在 Qwen2.5-VL-7B 与 LLaVA-OneVision 两个架构上进行,训练数据为 800 条 VideoHallu 合成数据 + 2000 条 Video-R1 真实数据混合。
---
四、Experiments(实验与发现)
4.1 主实验:17 个 SOTA VLM 全线翻车
在 VideoHallu 测试集上评测了从 <7B 小模型到闭源大模型(GPT-4o、Gemini-2.5-Pro)共 17 个模型,核心结论:
- 所有 SOTA 模型准确率均低于 55%,仅比 50% 随机猜测基线略高;
- 表现最好的是 Video-R1(53.64%),闭源模型如 Gemini-2.5-Pro 反而只有 49.18%;
- 模型普遍在 物理(Physics)和常识(Commonsense) 维度上得分最低,说明这两类需要"真正看视频"的题目最容易暴露幻觉。
4.2 关键现象一:Chain-of-Thought 对合成视频帮助有限甚至有害
经过 R1 式强化学习训练的模型(Video-R1、VideoChat-R1)在真实世界基准上表现优异,但在 VideoHallu 上相较其基座模型 Qwen2.5-VL-7B 并无明显提升,某些维度甚至更差 。论文给出一个典型案例:羽毛与石头同时下落的视频中,画面明明显示羽毛先落地(视频被"做旧"成反物理效果),但 VideoChat-R1-think 的思维链却机械地背诵"伽利略原理",得出"石头先落地"的错误结论------这是一个教科书式的"语言先验压制视觉证据"的案例。
4.3 关键现象二:拆解常识题与视频依赖题
作者进一步把问题拆成三类做消融:
| 问题类型 | 说明 | 准确率范围 |
|---|---|---|
| Common Sense-only(无需看视频即可回答) | 例如"子弹打西瓜通常会发生什么" | 100%(所有模型) |
| Counterintuitive(需要结合视频判断反直觉现象) | 46.8%--53.1% | |
| Critical Thinking(开放式发现异常) | 仅 10%--23.3% |
这组数据非常直观地证明了论文的核心论点:模型在纯语言常识题上无一失手,但一旦真正需要"看视频"去推翻常识,准确率断崖式下跌,尤其是开放式的"批判性思维"任务几乎全军覆没。
4.4 后训练实验:GRPO 优于 SFT,且合成数据不可或缺
- GRPO 全面优于 SFT :Qwen2.5-VL-7B 用 GRPO 训练后总分从基座的 52.98 提升到 57.69,而 SFT 训练后反而下降到 51.02------说明 SFT 容易"记住表层答案模式",而 GRPO 能培养出更好的泛化推理能力;
- 合成数据 vs 真实数据消融 :仅用真实视频训练几乎没有提升(+0.07%),仅用合成数据有一定提升,但真实+合成混合训练效果最佳(57.69),说明合成数据提供了必要的"负样本"信号,真实数据则提供了训练稳定性和多样性;
- 不损害真实世界性能 :在 MVBench、MMVU 两个真实视频基准上测试,混合训练后的模型性能与基座相当甚至略有提升,证明合成视频训练与真实视频理解能力可以共存,不存在明显的负迁移。
五、Conclusion(结论与局限)
结论 :VideoHallu 通过系统性构造"物理/常识违反"的合成视频,证明了当前 SOTA VLM(无论开源闭源、无论是否经过 R1 式推理训练)普遍存在依赖语言先验而非真实视觉证据的幻觉问题。GRPO 结合真实+合成数据的后训练策略能有效缓解该问题,且不损害模型在真实世界基准上的表现。
局限性(作者自述):
- 合成视频与真实世界视觉复杂度之间仍存在领域差距(domain gap);
- 对罕见物理边界情形 和长时程因果关系覆盖有限;
- 专家标注、反事实视频生成、GRPO 微调的规模化成本高,受限于数据和算力;
- 基于 QA 的评分方式可能无法完全反映模型的"视觉grounding"程度或不确定性校准,需要配合更多互补指标。
六、个人思考
-
评测范式的启发意义大于数据集本身 :这篇论文最有价值的地方不是"又做了一个基准",而是提出了一套用生成模型主动构造分布外(OOD)负样本来诊断多模态大模型"是否真正在用视觉信息"的方法论。这个思路可以推广到很多领域------比如检验 LLM 是否真的在"读代码"还是在"背模式",或者检验多模态模型是否真的在"看图"而非"编故事"。
-
"Common Sense-only 100% vs Critical Thinking <25%"这组对比极具说服力 。它几乎是在用最简洁的实验设计,把"语言模型套壳视觉理解"这个业界公开的秘密赤裸裸地摆在台面上------模型不是不会说,而是说的和看的对不上。这提醒我们,在评估任何"多模态"能力时,都应该设计"纯文本能否作弊"的对照组,否则很容易高估模型的真实感知能力。
-
CoT/RL 训练"帮倒忙"的现象值得警惕 。论文里 VideoChat-R1 用"伽利略原理"一本正经地推翻了眼前的视觉证据,这其实揭示了一个更深层问题:当前的 R1 式推理训练本质上是在强化"语言链条内部的自洽性",而不是"语言链条与外部证据的一致性" 。如果训练数据和奖励信号都以真实世界(即符合常识)视频为主,模型学到的"推理能力"很可能只是在优化如何更流畅地讲一个"听起来对"的故事,而不是如何去核实这个故事是否与眼前证据相符。这对未来做多模态 RLHF/GRPO 的奖励设计是一个很好的警示------奖励函数中大概率需要显式加入"视觉一致性"的惩罚项,而不只是文本层面的 ROUGE/偏好对比。
-
数据规模仍是明显瓶颈。800 条合成训练样本相对于千亿参数模型而言依然是杯水车薪,虽然实验显示"小而精"的负样本配合 GRPO 已能带来不错提升,但要真正让模型学会"举一反三"地识别各种物理/常识违反,恐怕还需要更大规模、更多样化的合成负样本,以及更精细的自动化异常检测/生成流水线(论文结论部分也提到了这个未来方向)。
-
对实际应用的启示 :随着 Sora2、Veo3 等视频生成模型的普及,"用 AI 生成的视频去欺骗 AI 审核系统"这件事的现实风险正在快速上升(deepfake、虚假宣传视频等)。VideoHallu 的方法论某种程度上也可以反向应用于合成内容检测------如果一个"内容审核 VLM"在检测反物理/反常识画面上都做得这么差,那么它在真实的深度伪造检测任务中恐怕也难言可靠,这是一个值得后续关注的安全侧应用方向。