Milvus 完全解析:开源向量数据库的领导者项目介绍:AI 时代的核心基础设施
随着大语言模型和生成式 AI 的爆发,向量数据库 已经成为现代 AI 应用的基础设施核心。它能够高效存储和检索非结构化数据(文本、图像、视频)的向量表示,为 RAG(检索增强生成)、推荐系统、多模态搜索等场景提供底层支撑。
Milvus 正是这一领域的佼佼者。作为一个高性能、云原生、开源 的向量数据库,Milvus 由 Go 和 C++ 编写,实现了 CPU/GPU 硬件加速,能够在毫秒级响应 下处理数十亿向量 的搜索请求。它采用存储计算分离的分布式架构,支持水平扩展,并提供了 Standalone(单机)和 Lite(轻量级)模式,满足从本地开发到大规模生产的所有需求。
Milvus 是 LF AI & Data 基金会 的毕业项目,采用 Apache 2.0 许可证,由 Zilliz 作为主要贡献者。目前 GitHub 星标超过 30k,是开源向量数据库领域的事实标准。
核心特性:为什么开发者选择 Milvus?
高性能与可扩展性
-
分布式架构:计算与存储分离,可独立扩展查询节点(处理读负载)和数据节点(处理写负载),适应动态流量模式。
-
硬件加速:支持 GPU 索引(如 NVIDIA CAGRA)和 CPU 指令集优化,实现极致性能。
-
多种索引类型:支持 HNSW、IVF、FLAT、SCANN、DiskANN 等主流索引,并针对元数据过滤和范围搜索进行优化。
灵活的多租户与存储分层
-
多租户隔离:通过数据库、集合、分区、分区键等层级实现隔离,单个集群可支持数百到数千万租户。
-
冷热数据分离:热数据可存放在内存或 SSD 中,冷数据置于低成本存储,兼顾性能与成本。
混合搜索能力
Milvus 不仅支持基于密集向量的语义搜索,还原生支持稀疏向量 (如 BM25、SPLADE、BGE-M3),可实现全文搜索。用户可以在同一集合中存储密集向量和稀疏向量,并通过 reranking 融合多路搜索结果,构建真正的混合搜索系统。
企业级安全
-
用户认证与 TLS 加密:确保数据在传输和存储中的安全。
-
基于角色的访问控制(RBAC):精细控制不同用户对数据的访问权限。
快速开始:5分钟上手 Milvus
安装 Python SDK
pip install -U pymilvus
# 如需使用 Milvus Lite(轻量级嵌入式版本)
pip install pymilvus[milvus-lite]
创建客户端
from pymilvus import MilvusClient

# 使用本地文件(Milvus Lite)
client = MilvusClient("milvus_demo.db")

# 或连接到远程 Milvus 服务器 / Zilliz Cloud
# client = MilvusClient(uri="<endpoint>", token="<api_key>")
创建集合并插入数据
# 创建集合
client.create_collection(
    collection_name="demo_collection",
    dimension=768  # 向量维度
)

# 准备数据(包含向量和标量字段)
data = [
    {"id": 0, "vector": embedding_fn.encode("文本1"), "text": "文本1"},
    {"id": 1, "vector": embedding_fn.encode("文本2"), "text": "文本2"},
]
client.insert(collection_name="demo_collection", data=data)
执行向量搜索
query_vectors = embedding_fn.encode_queries(["查询文本"])
results = client.search(
    collection_name="demo_collection",
    data=query_vectors,
    limit=2,  # 返回 top-k 结果
    output_fields=["text"]  # 返回的字段
)
应用场景:Milvus 在 AI 领域的落地
检索增强生成(RAG)
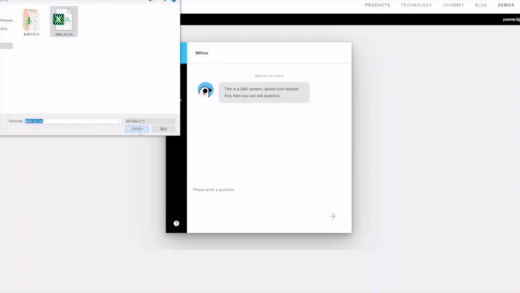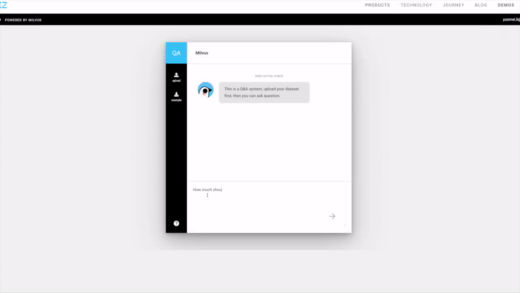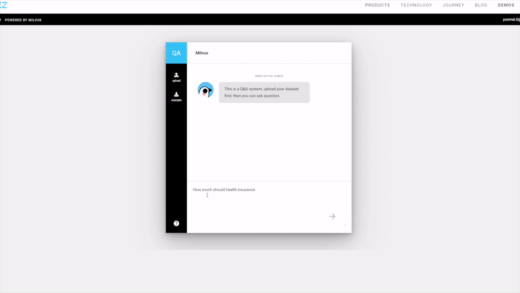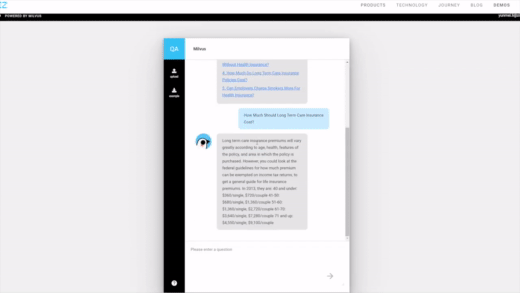
Milvus 作为知识库的向量存储,为大模型提供外部上下文。结合 LangChain、LlamaIndex 等框架,可构建高准确度的问答系统。
多模态搜索
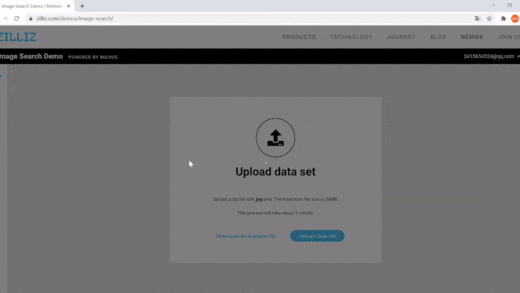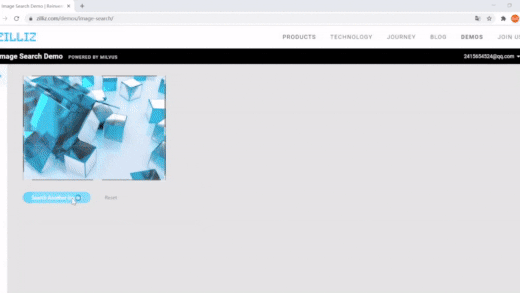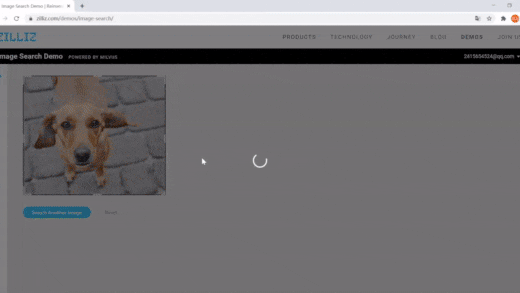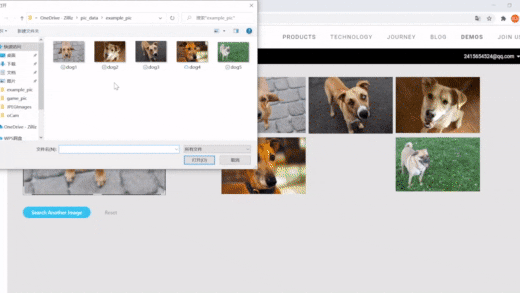
支持文本、图像、视频等多种模态的统一向量检索。例如,用户上传一张图片,返回相似的图片或相关描述。
推荐系统
通过向量化用户行为和物品特征,实时召回相似物品,实现个性化推荐。
药物发现与科学计算
在分子结构、蛋白质序列等科学数据上构建向量索引,加速相似性搜索。
生态与集成
Milvus 与主流 AI 工具链深度集成:
-
框架:LangChain、LlamaIndex、Haystack
-
嵌入模型:OpenAI、HuggingFace、Cohere
-
数据处理:Spark、Kafka、Airbyte、Fivetran
-
可视化与监控:Attu(GUI)、Prometheus/Grafana、Birdwatcher
详情见 Milvus 集成文档。
优势对比:Milvus 与其他向量数据库
| 维度 | Milvus | Pinecone | Weaviate | Qdrant |
|---|---|---|---|---|
| 开源协议 | ✅ Apache 2.0 | ❌ 商业闭源 | ✅ BSD-3 | ✅ Apache 2.0 |
| 自托管 | ✅ 完全支持 | ❌ 仅云服务 | ✅ 支持 | ✅ 支持 |
| GPU 加速 | ✅ 原生支持 | ❌ 不支持 | ❌ 不支持 | ❌ 不支持 |
| 索引类型 | 10+ 种(HNSW, IVF, DiskANN等) | 专有 | HNSW | HNSW |
| 混合搜索 | ✅ 密集+稀疏+全文搜索 | ❌ | ✅ 需额外配置 | ✅ 需额外配置 |
| 多租户 | ✅ 灵活隔离策略 | ✅ | ✅ | ✅ |
| 冷热存储 | ✅ 支持 | ❌ | ❌ | ❌ |
| K8s 原生 | ✅ 是 | 不适用 | ✅ | ✅ |
核心优势:
-
性能极致:硬件加速和丰富的索引选择,为不同场景提供最优方案。
-
开源友好:Apache 2.0 许可,可免费商用,社区活跃。
-
企业级特性:RBAC、冷热分离、多租户,满足严苛的生产需求。
总结:向量数据库的标杆
Milvus 不仅是一个向量搜索引擎,更是一个完整的、可扩展的 AI 数据基础设施。它通过云原生架构、硬件加速、混合搜索能力 和丰富的生态集成,为开发者提供了从原型到生产的一站式解决方案。无论你是在构建 RAG 应用、多模态搜索,还是推荐系统,Milvus 都值得成为你的首选。
现在就通过 pip 安装,5 分钟内搭建起你的第一个向量数据库吧!