一 定位慢SQL
1.1 配置SQLLOG
开启数据库sqllog,该参数为动态参数,可以直接修改
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> select para_name,para_value from vdm_ini where para_name='SVR_LOG'; 行号 PARA_NAME PARA_VALUE ---------- --------- ---------- 1 SVR_LOG 0 已用时间: 15.934(毫秒). 执行号:173. SQL\> SP_SET_PARA_VALUE(1,'SVR_LOG',1); DMSQL 过程已成功完成 已用时间: 7.175(毫秒). 执行号:174. SQL\> select para_name,para_value from vdm_ini where para_name='SVR_LOG'; 行号 PARA_NAME PARA_VALUE ---------- --------- ---------- 1 SVR_LOG 1 |
配置sqllog.ini文件
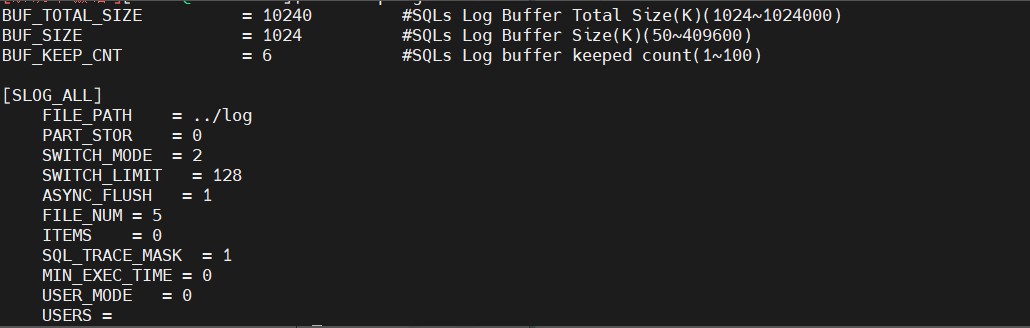
如果有修改sqllog.ini,可以调用以下函数立即生效
|------------------------------|
| SP_REFRESH_SVR_LOG_CONFIG(); |
1.2 查询慢SQL
构造一个慢SQL
|-----------------------------------------------------------------------------------------------------------------|
| SQL> SELECT SUM( SIN(LEVEL) * COS(LEVEL) * SQRT(LEVEL) ) AS RESULT FROM DUAL CONNECT BY LEVEL <= 100000000; |
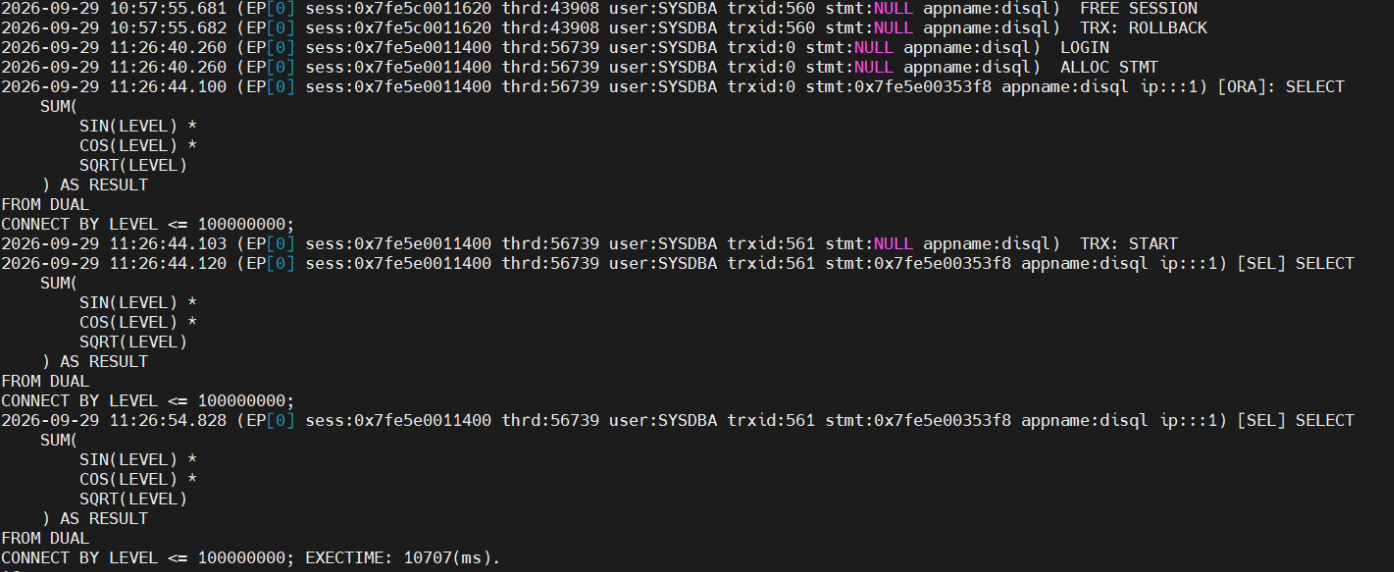
执行上述SQL后会在dmdbms/log目录下生成dmsql_AAAA_uSYSDBA_20260929_105756.log的日志文件,日志中会打印出现的慢SQL。
1.3 通过视图查看慢SQL
参数 ENABLE_MONITOR=1 打开时,显示系统最近 1000 条执行时间超过预定值的 SQL 语句,默认预定值为 1000 毫秒。动态参数,可在线修改。
|------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> SP_SET_PARA_VALUE(1,'ENABLE_MONITOR',1); DMSQL 过程已成功完成 已用时间: 5.151(毫秒). 执行号:178. SQL> select SF_GET_PARA_VALUE(1,'ENABLE_MONITOR'); 行号 SF_GET_PARA_VALUE(1,'ENABLE_MONITOR') ---------- ------------------------------------- 1 1 |
执行以下SQL查看正在执行的SQL语句
|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SELECT * FROM ( SELECT 'SP_CLOSE_SESSION('||SESS_ID||');' AS CLOSE_SESSION, DATEDIFF(SS,LAST_SEND_TIME,SYSDATE) sql_exectime, TRX_ID, CLNT_IP, B.IO_WAIT_TIME AS IO_WAIT_TIME, SF_GET_SESSION_SQL(SESS_ID) FULLSQL, A.SQL_TEXT FROM VSESSIONS a,VSQL_STAT B WHERE STATE IN ('ACTIVE','WAIT') AND A.SESS_ID = B.SESSID ); |
会话A执行慢SQL,会话B查看当前的慢SQL
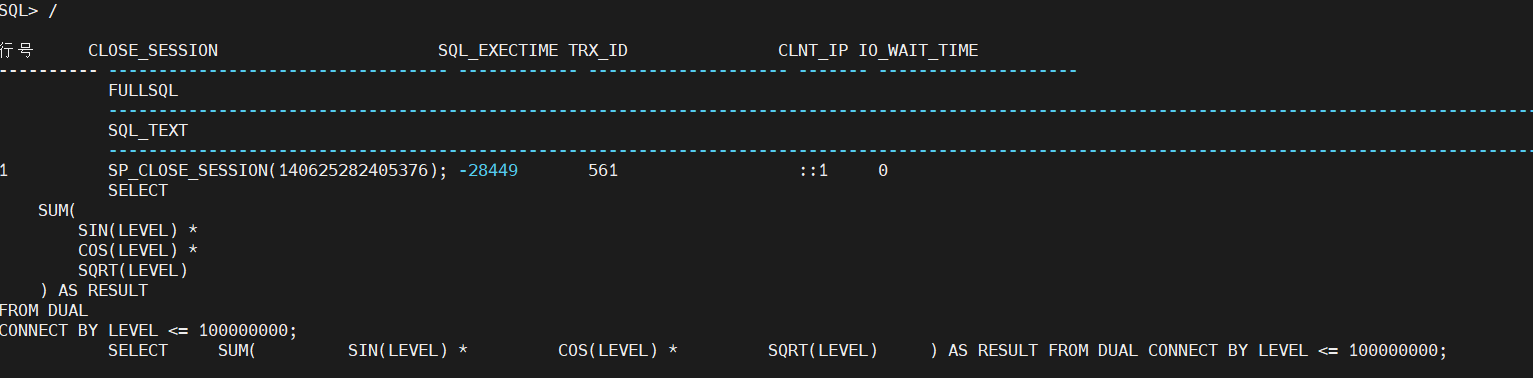
查看历史超过执行时间阈值的 SQL 语句
|----------------------------------|
| SELECT * FROM V$LONG_EXEC_SQLS; |
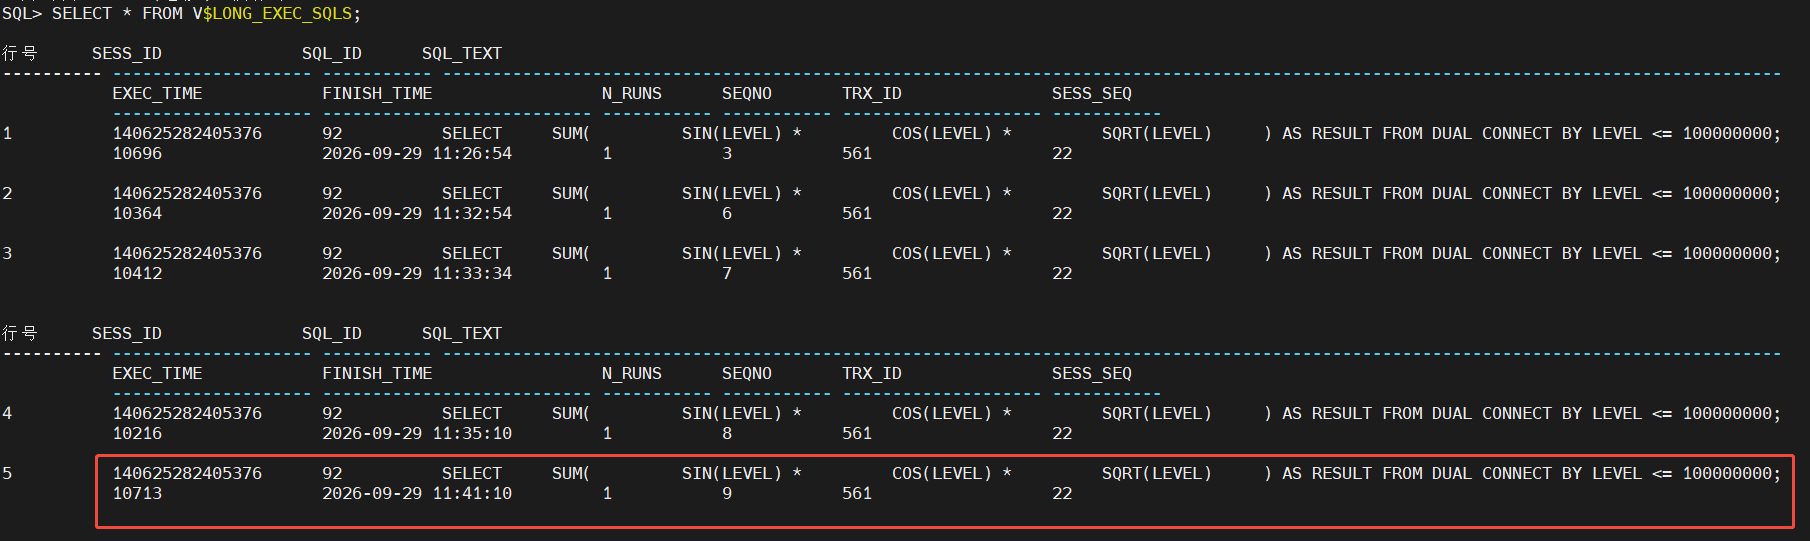
二 分析慢SQL
2.1 查看执行计划
达梦数据库可通过两种方式查看执行计划。
2.1.1 DM管理工具查看
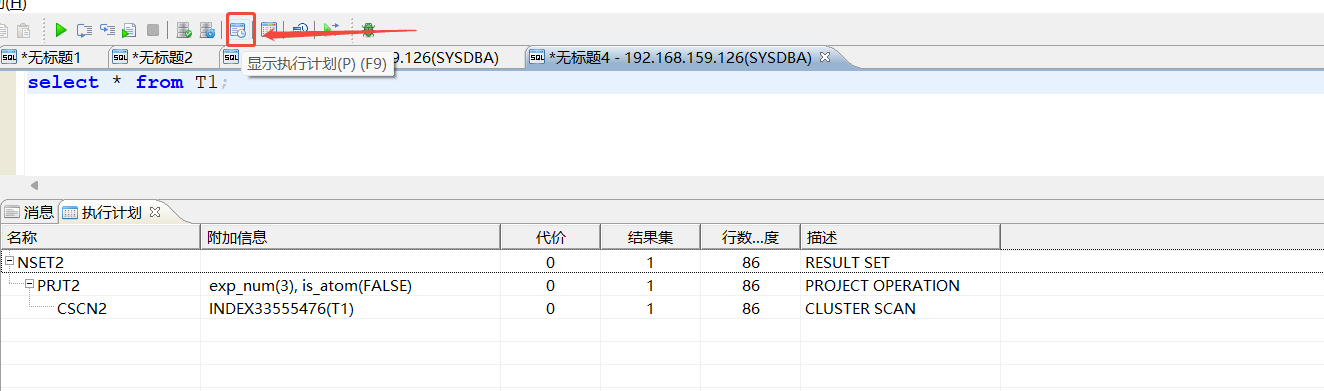
2.1.2 explain 命令查看
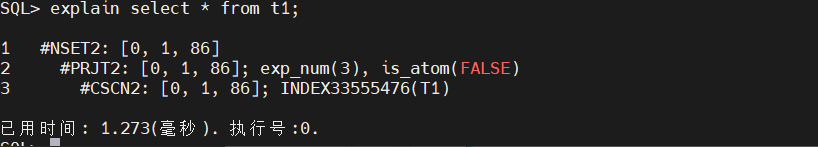
查看真实执行计划(DM8)
|--------------------------------------------|
| set autotrace traceonly select * from T1; |
重点关注 logical reads(逻辑读)和 physical reads(物理读)相应的指标值,并结合 rows processed 返回处理行数多少来分析。如果返回行数少(并且 bytes sent to client 总量不大),应尽可能减少 IO 开销,让执行计划选择正确的索引路径。
Sort(disk) 一般因排序( hash join 发生归并、order by、group by 场景)区内存不足,如果数据库服务器物理内存充足,可以适当上调排序区内存,尽量避免操作刷盘,否则会影响执行性能。
2.2 ET工具
ET 功能默认关闭,可通过配置 INI 参数中的 ENABLE_MONITOR=1、MONITOR_SQL_EXEC=1 开启该功能。
|-------------------------------------------------------------------------------------|
| SP_SET_PARA_VALUE(1,'ENABLE_MONITOR',1); SP_SET_PARA_VALUE(1,'MONITOR_SQL_EXEC',1); |
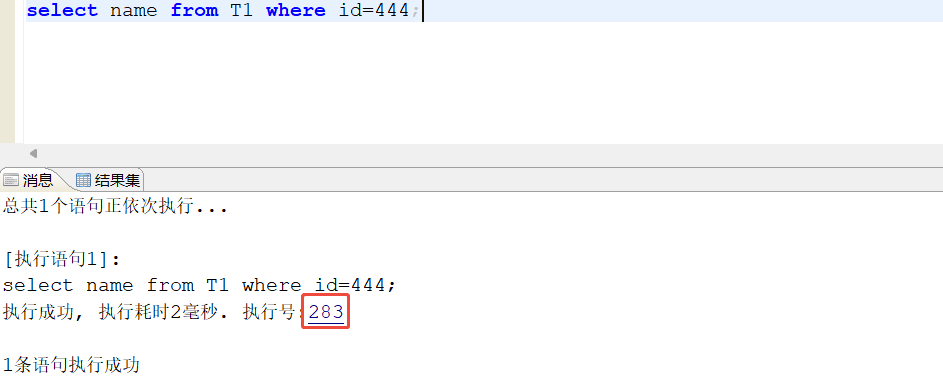
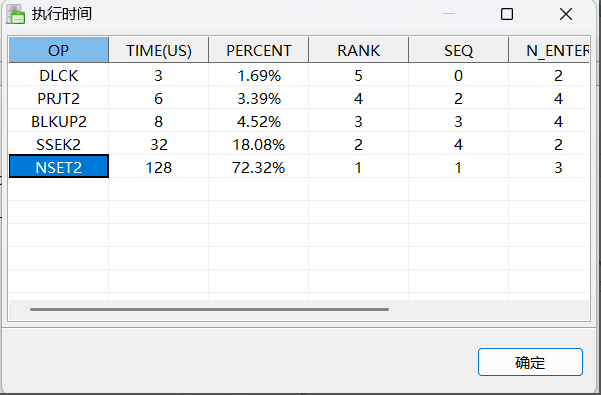
执行 SQL 语句后,客户端会返回 SQL 语句的执行号。单击执行号即可查看 SQL 语句对应的 ET 结果。
|------------------------------------------------------------------------------------------------------|
| ET 结果说明: OP: 操作符 TIME(us): 时间开销,单位为微秒 PERCENT: 执行时间占总时间百分比 RANK: 执行时间耗时排序 SEQ: 执行计划节点号 N_ENTER: 进入次数 |
2.3 dbms_sqltune
DBMS_SQLTUNE 包提供一系列实时 SQL 监控的方法。当 SQL 监控功能开启后,DBMS_SQLTUNE 包可以实时监控 SQL 执行过程中的信息,包括:执行时间、执行代价、执行用户、统计信息等情况。
使用前提:建议会话级开启参数 MONITOR_SQL_EXEC=1,而 MONITOR_SQL_EXEC 在达梦数据库中一般默认是 1,无需调整。
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| ALTER SESSION SET 'MONITOR_SQL_EXEC' = 1; SQL> select * from t1 where id=988; 行号 ID NAME ---------- --- -------- 1 988 NAME_988 已用时间: 16.590(毫秒). 执行号:902. SQL> select DBMS_SQLTUNE.REPORT_SQL_MONITOR(SQL_EXEC_ID=>902) from dual; |
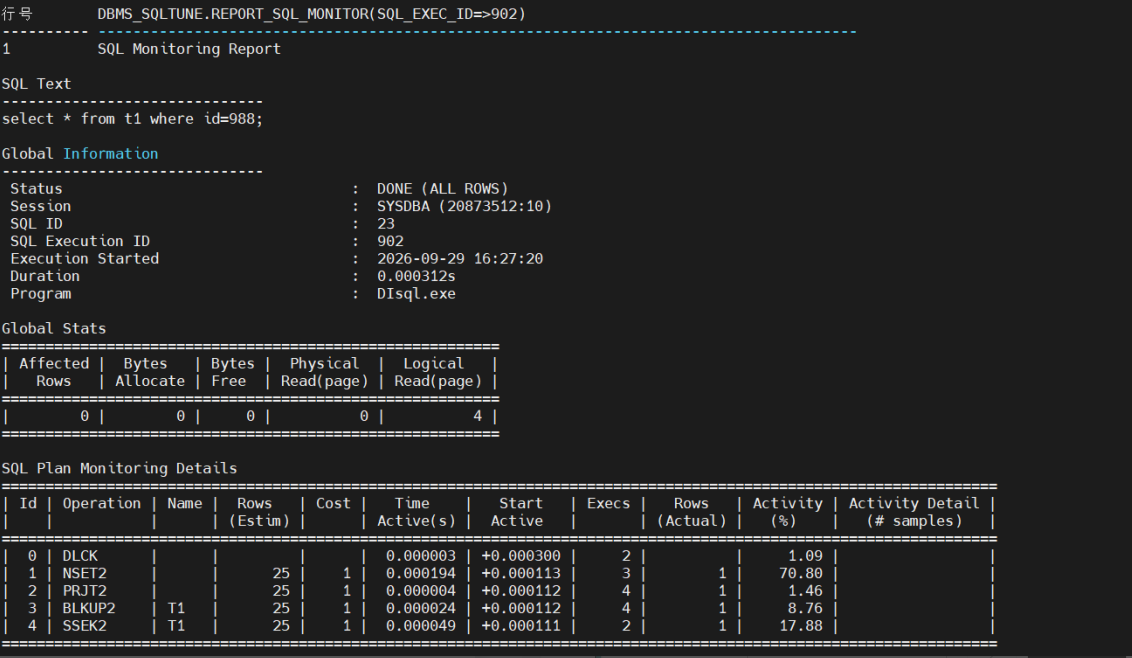
dbms_sqltune 系统包相比 ET 功能更强大,能够获取 IO 操作量,查看真实执行计划,每个操作符消耗占比和相应的花费时间,还能看出每个操作符执行的次数,非常便于了解执行计划中瓶颈位置。
三 优化SQL
3.1 索引优化
建立索引的原则:
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 建立唯一索引。唯一索引能够更快速地帮助我们进行数据定位; 为经常需要进行查询操作的字段建立索引; 对经常需要进行排序、分组以及联合操作的字段建立索引; 在建立索引的时候,要考虑索引的最左匹配原则(在使用 SQL 语句时,如果 where 部分的条件不符合最左匹配原则,可能导致索引失效,或者不能完全发挥建立的索引的功效); 不要建立过多的索引。因为索引本身会占用存储空间; 如果建立的单个索引查询数据很多,查询得到的数据的区分度不大,则考虑建立合适的联合索引; 尽量考虑字段值长度较短的字段建立索引,如果字段值太长,会降低索引的效率。 |
示例:
创建简单表,插入数据
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> desc t2; 行号 NAME TYPE$ NULLABLE ---------- ---- ----------- -------- 1 ID DEC(10) Y 2 NAME VARCHAR(20) Y 已用时间: 25.182(毫秒). 执行号:1502. SQL> select count(*) from t2; 行号 COUNT(*) ---------- -------------------- 1 1000 |
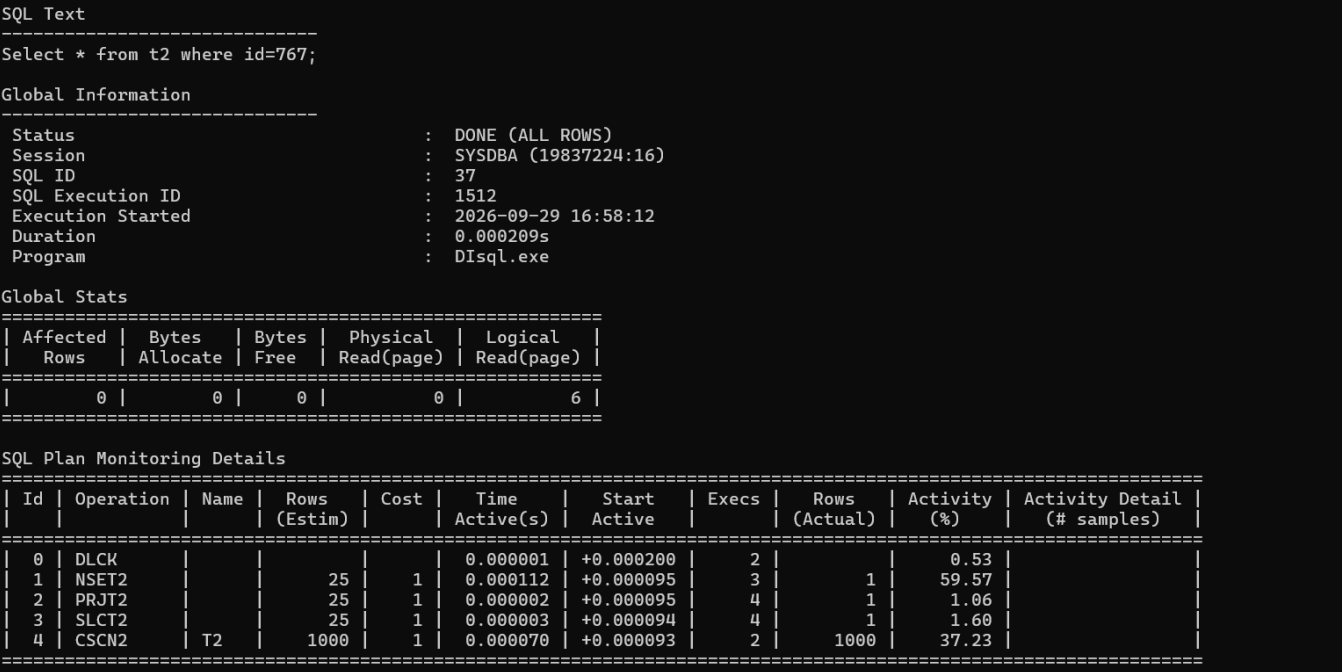
做个简单查询,查看执行计划
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> select * from t2 where id=767; 行号 ID NAME ---------- --- -------- 1 767 NAME_767 2 767 NAME_767 已用时间: 10.876(毫秒). 执行号:1505. SQL> select DBMS_SQLTUNE.REPORT_SQL_MONITOR(SQL_EXEC_ID=>1505) from dual; |
ID列创建索引,再次查询
|-------------------------------------------------------------------|
| create index idx_t2_id on t2(id); Select * from t2 where id=767; |
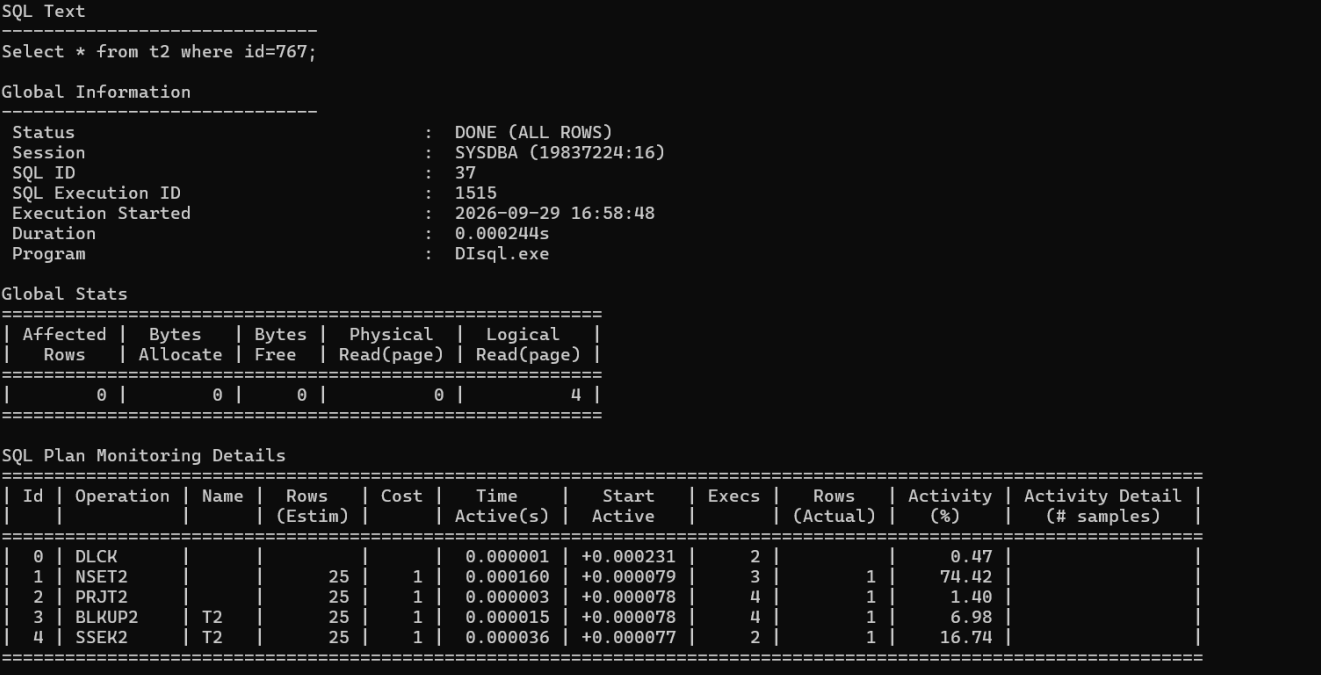
能够看到在创建索引之后查询由全表扫描变为了索引扫描。扫描行数,逻辑读都有相应减小(可能与第二次查询有关)。如果数据量更大,索引效果会更加明显,这里不做更多测试。
3.2 SQL改写
1、GROUP BY改写
提高 GROUP BY 语句的效率,可以在 GROUP BY 之前过滤掉不需要的内容。
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --优化前 SELECT JOB,AVG(AGE) FROM TEMP GROUP BY JOB HAVING JOB = 'STUDENT' OR JOB = 'MANAGER'; --优化后 SELECT JOB,AVG(AGE) FROM TEMP WHERE JOB = 'STUDENT' OR JOB = 'MANAGER' GROUP BY JOB; |
2、用 UNION ALL 替换 UNION
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --优化前 SELECT USER_ID,BILL_ID FROM USER_TAB1 WHERE AGE = '20' UNION SELECT USER_ID,BILL_ID FROM USER_TAB2 WHERE AGE = '20'; --优化后 SELECT USER_ID,BILL_ID FROM USER_TAB1 WHERE AGE = '20' UNION ALL SELECT USER_ID,BILL_ID FROM USER_TAB2 WHERE AGE = '20'; |
3、用 EXISTS 替换 DISTINCT
当 SQL 包含一对多表查询时,避免在 SELECT 子句中使用 DISTINCT,一般用 EXISTS 替换 DISTINCT 查询更为迅速。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --优化前 SELECT DISTINCT USER_ID,BILL_ID FROM USER_TAB1 D,USER_TAB2 E WHERE D.USER_ID= E.USER_ID; --优化后 SELECT USER_ID,BILL_ID FROM USER_TAB1 D WHERE EXISTS( SELECT 1 FROM USER_TAB2 E WHERE E.USER_ID= D.USER_ID); |
4、用 EXISTS 替换 IN、用 NOT EXISTS 替换 NOT IN
在基于基础表的查询中可能会需要对另一个表进行联接。在这种情况下, 使用 EXISTS (或 NOT EXISTS )通常将提高查询的效率。在子查询中,NOT IN 子句将执行一个内部的排序和合并。无论在哪种情况下,NOT IN 都是最低效的(要对子查询中的表执行一个全表遍历),所以尽量将 NOT IN 改写成外连接( Outer Joins )或 NOT EXISTS。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --优化前 SELECT A.* FROM TEMP(基础表) A WHERE AGE > 0 AND A.ID IN(SELECT ID FROM TEMP1 WHERE NAME ='TOM'); --优化后 SELECT A.* FROM TEMP(基础表) A WHERE AGE > 0 AND EXISTS(SELECT 1 FROM TEMP1 WHERE A.ID= ID AND NAME='TOM'); |
5、半连接优化
半连接也是子查询的一种,查询只返回主表数据,子查询作为条件过滤使用。exists 关注是否有返回行,取决于关联列,in 关注是否存在过滤数据,在半连接改写中理解这点很重要。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --改写前,已下两种写法特征就是执行计划出现 semi 关键字 --写法一: select EMPNO, ENAME, JOB, MGR, HIREDATE from emp2 where deptno in (select deptno from dept2) --写法二: select EMPNO, ENAME, JOB, MGR, HIREDATE from emp2 where exists (select deptno from dept2 where dept2.deptno = emp2.deptno) --改写优化 --当子查询中部门表中部门编号不存在重复改写如下: select emp2.EMPNO, emp2.ENAME, emp2.JOB, emp2.MGR, emp2.HIREDATE from emp2 inner join dept2 on dept2.deptno = emp2.deptno --若存在数据重复先根据关联列去重再关联 select dept2.* from (select distinct deptno from emp2) emp2 inner join dept2 on dept2.deptno = emp2.deptno |
6、反连接优化
同半连接一样,查询也只返回主表数据,通过 not in 和 not exists 过滤,再改写的过程中特别要注意反连接 not in 对空值敏感。
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| --ept2 deptno 列不存在空值时,以下两种写法等价,当 not in 存在空时,无数据行返回,因此 not exists 改写 not in 需要加上 not is null select * from emp2 where deptno not in (select deptno from dept2); select * from emp2 e where not exists (select * from dept2 d where d.deptno = e.deptno) --not in、 not exists 改写 left join select * from emp2 E where deptno not in (select deptno from dept2 D) --反连接驱动是 E 表,被驱动是 D 表,所以改写 left join ,not in 表示不在此范围,即 emp2 有的部门编号,dept2 没有 --左连接会将右表没有的内容用 NULL 表示,所以关联后取 d.deptno is null 过滤 select e.* from emp2 e left join dept2 d on d.deptno = e.deptno where d.deptno is null |
3.3 hint优化
当统计信息已收集,且索引也按照需求建立,sql 执行效率仍然不符合预期,可以考虑添加 hint 方式来进行优化。
创建测试表,一个小表10行数据,大表10W行
|---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| SQL> SELECT COUNT(*) FROM HINT_HA; 行号 COUNT(*) ---------- -------------------- 1 10 已用时间: 4.030(毫秒). 执行号:1560. SQL> SELECT COUNT(*) FROM HINT_HB; 行号 COUNT(*) ---------- -------------------- 1 1000000 |
给大表创建索引
|--------------------------------------------|
| CREATE INDEX IDX_HB_CODE ON HINT_HB(CODE); |
做个简单查询
|----------------------------------------------------------------------------|
| EXPLAIN SELECT COUNT(*) FROM HINT_HA A JOIN HINT_HB B ON A.CODE = B.CODE; |
看到当前SQL走的NEST LOOP
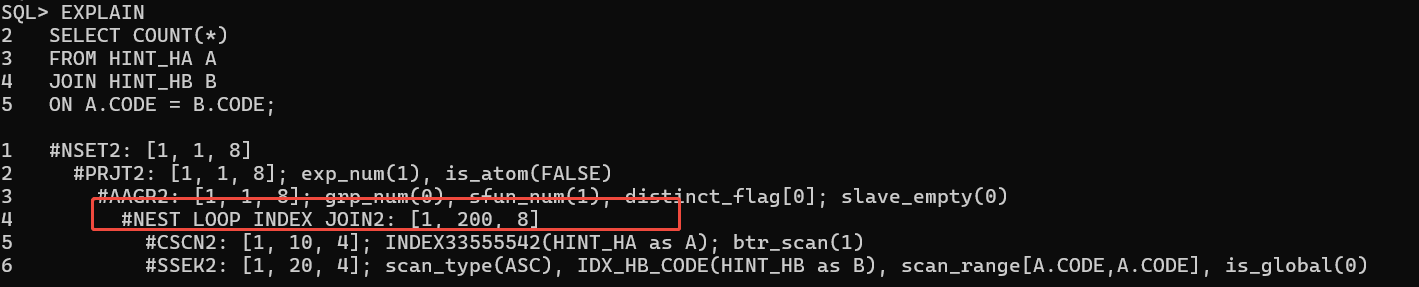
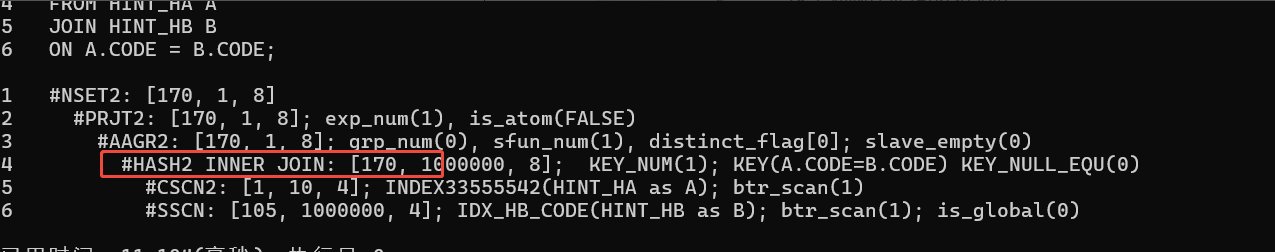
这里强制让他走hash join
|----------------------------------------------------------------------------------------------------|
| EXPLAIN SELECT /*+ USE_HASH(A, B) */ COUNT(*) FROM HINT_HA A JOIN HINT_HB B ON A.CODE = B.CODE; |