Duplicate
Duplicate命令在RMAN中执行,执行后会自动执行下列步骤:
1.为副本数据库创建控制文件(所以源端和目标端的db_name可以不一样,比如源端为A,duplicate到目标端为B)。
2.Restore数据文件到副本数据库,并通过增量备份和Archived Redo Logs进行不完全恢复。
3.重启辅助实例,以加载服务器初始化参数文件即SPFILE。
4.不完全恢复后通过Resetlogs方式Open副本数据库以重建Online Redo Logs(Duplicate ... For Standby方式除外,该操作不会打开数据库)。
5.为副本数据库产生一个新的,唯一的DBID(Duplicate ... For Standby方式除外,该方式不会创建新的唯一DBID)。
6.duplicate的过程中,会自动给目标数据库建立trace和dump等目录。
目标端启动静态监听(因为duplicate过程中会关闭再启动目标端,如果目标端使用的不是静态监听那么关闭的过程中目标端的监听不再有了,这样就会源端连接不到目标端,无法再启动目标端),目标端实例启动到nomount状态.
duplicate target database to DB1使用源库(tns不用写)的备份文件来对目标库(tns为DB1new)做复制,此时目标库必须能访问到源端的备份包(可以把主库备份文件拷贝至备库一样的存储路径,或主备共用存储),使用密码连接目标端
rman target / auxiliary sys/123456@DB1new
duplicate target database to DB1 from active database使用源库(tns为DB1)在线数据来对目标库(tns为DB1new)做复制,必须使用密码连接源端和目标端
rman target sys/123456@DB1 auxiliary sys/123456@DB1new
nofilenamecheck参数
假如duplicate的目标端和源端具有相同的数据文件路径/oracle/dbs/*,并且要在目标端数据库中使用和源端相同文件名,在这种情况下,请指定NOFILENAMECHECK选项以避免出现错误消息。因为RMAN不知道不同的主机,RMAN无法自动确定该不该检查文件名。如果不加NOFILENAMECHECK,就是表示检查,检查后发现目标端和源端具有相同文件就会报错。也就是说平时做duplicate操作时不加NOFILENAMECHECK更安全,但是如果duplicate时遇到目标端和源端具有相同数据文件路径时不加NOFILENAMECHECK又会报错,这个时候如果你知道就算目标端和源端具有相同数据文件路径但是duplicate也不会覆盖源端的数据文件时,你就加上NOFILENAMECHECK。
DB_FILE_NAME_CONVERT和LOG_FILE_NAME_CONVERT参数
db_file_name_convert和log_file_name_convert参数仅适用于physical standby和rman duplicate,对logical standby和普通rman restore无效;
实验1:duplicate源端到目标端且保持dbname一致,源端的dbname是DB1,目标端的dbname是DB1
源端:Hostname是DB1,IP是192.168.100.128,数据文件目录/u01/app/oracle/oradata/DB1
目标端:Hostname是DB2,IP是192.168.100.129,数据文件目录/u02/app/oracle/oradata/DB1
1、目标端配置静态监听配置
bash
[oracle@DB2]$ cat /u02/app/oracle/product/1930/db_2/network/admin/listener.ora
LISTENER =
  (DESCRIPTION_LIST =
    (DESCRIPTION =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
      (ADDRESS = (PROTOCOL = IPC)(KEY = EXTPROC1521))
    )
  )

SID_LIST_LISTENER =
  (SID_LIST =
    (SID_DESC =
      (GLOBAL_DBNAME = DB1)
      (ORACLE_HOME = /u02/app/oracle/product/1930/db_2)
      (SID_NAME = DB1)
    )
  )

ADR_BASE_LISTENER = /u02/app/oracle
2、目标端配置pfile参数文件信息
bash
[oracle@DB2]$ cat /tmp/pfiledb1new.ora
*.db_name='DB1'
*.remote_login_passwordfile='EXCLUSIVE'
*.control_files='/u02/app/oracle/oradata/DB1/control01.ctl','/u02/app/oracle/oradata/DB1/control02.ctl'
*.log_archive_dest_1='location=/u02/app/oracle/archivelog'
*.DB_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB1'
*.LOG_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB1'
3、源端配置tns信息
bash
DB1 =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.128)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB1)
    )
  )


DB1new =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB1)
    )
  )
4、拷贝源端的密码文件到目标端,使目标端和源端一样的密码文件名称一样都是orapwDB1
5、目标端使用pfile启动到nomount状态
SQL> startup nomount pfile='/tmp/pfiledb1new.ora';
6、源端执行duplicate命令
bash
[oracle@DB1]$ rman target sys/123456@DB1 auxiliary sys/123456@DB1new
connected to target database: DB1 (DBID=1794862737)
connected to auxiliary database: DB1 (not mounted)
RMAN> duplicate target database to DB1 from active database
Starting Duplicate Db at 04-JUN-25
using target database control file instead of recovery catalog
allocated channel: ORA_AUX_DISK_1
channel ORA_AUX_DISK_1: SID=181 device type=DISK
current log archived

contents of Memory Script:
{
   sql clone "create spfile from memory";
}
executing Memory Script

sql statement: create spfile from memory

contents of Memory Script:
{
   shutdown clone immediate;
   startup clone nomount;
}
executing Memory Script

Oracle instance shut down

connected to auxiliary database (not started)
Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

contents of Memory Script:
{
   sql clone "alter system set  db_name =''DB1'' comment=''Modified by RMAN duplicate'' scope=spfile";
   sql clone "alter system set  db_unique_name = ''DB1'' comment= ''Modified by RMAN duplicate'' scope=spfile";
   shutdown clone immediate;
   startup clone force nomount
   restore clone from service  'DB1' primary controlfile;
   alter clone database mount;
}
executing Memory Script

sql statement: alter system set  db_name =  ''DB1'' comment= ''Modified by RMAN duplicate'' scope=spfile

sql statement: alter system set  db_unique_name =  ''DB1'' comment= ''Modified by RMAN duplicate'' scope=spfile

Oracle instance shut down

Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

Starting restore at 04-JUN-25
allocated channel: ORA_AUX_DISK_1
channel ORA_AUX_DISK_1: SID=178 device type=DISK

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring control file
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:02
output file name=/u02/app/oracle/oradata/DB1/control01.ctl
output file name=/u02/app/oracle/oradata/DB1/control02.ctl
Finished restore at 04-JUN-25

database mounted

contents of Memory Script:
{
   set newname for datafile  1 to "/u02/app/oracle/oradata/DB1/system01.dbf";
   set newname for datafile  3 to "/u02/app/oracle/oradata/DB1/sysaux01.dbf";
   set newname for datafile  4 to "/u02/app/oracle/oradata/DB1/undotbs01.dbf";
   set newname for datafile  7 to "/u02/app/oracle/oradata/DB1/users01.dbf";
   restore from  nonsparse   from service 'DB1'   clone database;
   sql 'alter system archive log current';
}
executing Memory Script

executing command: SET NEWNAME

executing command: SET NEWNAME

executing command: SET NEWNAME

executing command: SET NEWNAME

Starting restore at 04-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00001 to /u02/app/oracle/oradata/DB1/system01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:47
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00003 to /u02/app/oracle/oradata/DB1/sysaux01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:36
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00004 to /u02/app/oracle/oradata/DB1/undotbs01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:16
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00007 to /u02/app/oracle/oradata/DB1/users01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:03
Finished restore at 04-JUN-25

sql statement: alter system archive log current
current log archived

contents of Memory Script:
{
   restore clone force from service  'DB1'
           archivelog from scn  16106992;
   switch clone datafile all;
}
executing Memory Script

Starting restore at 04-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting archived log restore to default destination
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring archived log
archived log thread=1 sequence=97
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:01
channel ORA_AUX_DISK_1: starting archived log restore to default destination
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring archived log
archived log thread=1 sequence=98
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:01
Finished restore at 04-JUN-25

datafile 1 switched to datafile copy
input datafile copy RECID=5 STAMP=1202927406 file name=/u02/app/oracle/oradata/DB1/system01.dbf
datafile 3 switched to datafile copy
input datafile copy RECID=6 STAMP=1202927406 file name=/u02/app/oracle/oradata/DB1/sysaux01.dbf
datafile 4 switched to datafile copy
input datafile copy RECID=7 STAMP=1202927406 file name=/u02/app/oracle/oradata/DB1/undotbs01.dbf
datafile 7 switched to datafile copy
input datafile copy RECID=8 STAMP=1202927406 file name=/u02/app/oracle/oradata/DB1/users01.dbf

contents of Memory Script:
{
   set until scn  16110683;
   recover
   clone database
    delete archivelog
   ;
}
executing Memory Script

executing command: SET until clause

Starting recover at 04-JUN-25
using channel ORA_AUX_DISK_1

starting media recovery

archived log for thread 1 with sequence 97 is already on disk as file /u02/app/oracle/archivelog/1_97_1201725133.dbf
archived log for thread 1 with sequence 98 is already on disk as file /u02/app/oracle/archivelog/1_98_1201725133.dbf
archived log file name=/u02/app/oracle/archivelog/1_97_1201725133.dbf thread=1 sequence=97
archived log file name=/u02/app/oracle/archivelog/1_98_1201725133.dbf thread=1 sequence=98
media recovery complete, elapsed time: 00:00:01
Finished recover at 04-JUN-25

contents of Memory Script:
{
   delete clone force archivelog all;
}
executing Memory Script

released channel: ORA_AUX_DISK_1
allocated channel: ORA_DISK_1
channel ORA_DISK_1: SID=276 device type=DISK
deleted archived log
archived log file name=/u02/app/oracle/archivelog/1_97_1201725133.dbf RECID=1 STAMP=1202927404
deleted archived log
archived log file name=/u02/app/oracle/archivelog/1_98_1201725133.dbf RECID=2 STAMP=1202927405
Deleted 2 objects

Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

contents of Memory Script:
{
   sql clone "alter system set  db_name =''DB1'' comment=''Reset to original value by RMAN'' scope=spfile";
   sql clone "alter system reset  db_unique_name scope=spfile";
}
executing Memory Script

sql statement: alter system set  db_name =  ''DB1'' comment= ''Reset to original value by RMAN'' scope=spfile

sql statement: alter system reset  db_unique_name scope=spfile
Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes
sql statement: CREATE CONTROLFILE REUSE SET DATABASE "DB1" RESETLOGS ARCHIVELOG
  MAXLOGFILES     16
  MAXLOGMEMBERS      3
  MAXDATAFILES      100
  MAXINSTANCES     8
  MAXLOGHISTORY      292
 LOGFILE
  GROUP     1 ( '/u02/app/oracle/oradata/DB1/redo01.log' ) SIZE 200 M  REUSE,
  GROUP     2 ( '/u02/app/oracle/oradata/DB1/redo02.log' ) SIZE 200 M  REUSE,
  GROUP     3 ( '/u02/app/oracle/oradata/DB1/redo03.log' ) SIZE 200 M  REUSE
 DATAFILE
  '/u02/app/oracle/oradata/DB1/system01.dbf'
 CHARACTER SET AL32UTF8


contents of Memory Script:
{
   set newname for tempfile  1 to "/u02/app/oracle/oradata/DB1/temp01.dbf";
   switch clone tempfile all;
   catalog clone datafilecopy  "/u02/app/oracle/oradata/DB1/sysaux01.dbf",
 "/u02/app/oracle/oradata/DB1/undotbs01.dbf",
 "/u02/app/oracle/oradata/DB1/users01.dbf";
   switch clone datafile all;
}
executing Memory Script

executing command: SET NEWNAME

renamed tempfile 1 to /u02/app/oracle/oradata/DB1/temp01.dbf in control file

cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB1/sysaux01.dbf RECID=1 STAMP=1202927431
cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB1/undotbs01.dbf RECID=2 STAMP=1202927431
cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB1/users01.dbf RECID=3 STAMP=1202927431

datafile 3 switched to datafile copy
input datafile copy RECID=1 STAMP=1202927431 file name=/u02/app/oracle/oradata/DB1/sysaux01.dbf
datafile 4 switched to datafile copy
input datafile copy RECID=2 STAMP=1202927431 file name=/u02/app/oracle/oradata/DB1/undotbs01.dbf
datafile 7 switched to datafile copy
input datafile copy RECID=3 STAMP=1202927431 file name=/u02/app/oracle/oradata/DB1/users01.dbf
Reenabling controlfile options for auxiliary database
Executing: alter database add supplemental log data
Executing: alter database force logging

contents of Memory Script:
{
   Alter clone database open resetlogs;
}
executing Memory Script

database opened
Cannot remove created server parameter file
Finished Duplicate Db at 04-JUN-25
实验2:duplicate源端到目标端但是目标端生成的dbname与源端不一致,源端的dbname是DB1,目标端的dbname是DB2
源端:Hostname是DB1,IP是192.168.100.128,数据文件目录/u01/app/oracle/oradata/DB1
目标端:Hostname是DB2,IP是192.168.100.129,数据文件目录/u02/app/oracle/oradata/DB2
1、目标端配置静态监听配置
bash
[oracle@DB2]$ cat /u02/app/oracle/product/1930/db_2/network/admin/listener.ora
LISTENER =
  (DESCRIPTION_LIST =
    (DESCRIPTION =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
      (ADDRESS = (PROTOCOL = IPC)(KEY = EXTPROC1521))
    )
  )

SID_LIST_LISTENER =
  (SID_LIST =
    (SID_DESC =
      (GLOBAL_DBNAME = DB2)
      (ORACLE_HOME = /u02/app/oracle/product/1930/db_2)
      (SID_NAME = DB2)
    )
  )

ADR_BASE_LISTENER = /u02/app/oracle
2、目标端配置pfile参数文件信息
bash
[oracle@DB2 archivelog]$ cat /tmp/pfiledb2.ora
*.db_name='DB2'
*.remote_login_passwordfile='EXCLUSIVE'
*.control_files='/u02/app/oracle/oradata/DB2/control01.ctl','/u02/app/oracle/oradata/DB2/control02.ctl'
*.log_archive_dest_1='location=/u02/app/oracle/archivelog'
*.DB_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB2'
*.LOG_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB2'
3、源端配置的tns信息
bash
DB1 =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.128)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB1)
    )
  )


DB2 =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB2)
    )
  )
4、拷贝源端的密码文件orapwDB1到目标端,并在目录端修改该密码文件名为orapwDB2
5、目标端使用pfile启动到nomount状态
SQL> startup nomount pfile='/tmp/pfiledb2.ora';
6、源端执行duplicate命令
bash
[oracle@DB1]$ rman target sys/123456@DB1 auxiliary sys/123456@DB2
connected to target database: DB1 (DBID=1794862737)
connected to auxiliary database: DB2 (not mounted)
RMAN> duplicate target database to DB2 from active database;
Starting Duplicate Db at 04-JUN-25
using target database control file instead of recovery catalog
allocated channel: ORA_AUX_DISK_1
channel ORA_AUX_DISK_1: SID=181 device type=DISK
current log archived

contents of Memory Script:
{
   sql clone "create spfile from memory";
}
executing Memory Script

sql statement: create spfile from memory

contents of Memory Script:
{
   shutdown clone immediate;
   startup clone nomount;
}
executing Memory Script

Oracle instance shut down

connected to auxiliary database (not started)
Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

contents of Memory Script:
{
   sql clone "alter system set  db_name =
 ''DB1'' comment=
 ''Modified by RMAN duplicate'' scope=spfile";
   sql clone "alter system set  db_unique_name =
 ''DB2'' comment=
 ''Modified by RMAN duplicate'' scope=spfile";
   shutdown clone immediate;
   startup clone force nomount
   restore clone from service  'DB1' primary controlfile;
   alter clone database mount;
}
executing Memory Script

sql statement: alter system set  db_name =  ''DB1'' comment= ''Modified by RMAN duplicate'' scope=spfile

sql statement: alter system set  db_unique_name =  ''DB2'' comment= ''Modified by RMAN duplicate'' scope=spfile

Oracle instance shut down

Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

Starting restore at 04-JUN-25
allocated channel: ORA_AUX_DISK_1
channel ORA_AUX_DISK_1: SID=178 device type=DISK

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring control file
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:18
output file name=/u02/app/oracle/oradata/DB2/control01.ctl
output file name=/u02/app/oracle/oradata/DB2/control02.ctl
Finished restore at 04-JUN-25

database mounted

contents of Memory Script:
{
   set newname for datafile  1 to
 "/u02/app/oracle/oradata/DB2/system01.dbf";
   set newname for datafile  3 to
 "/u02/app/oracle/oradata/DB2/sysaux01.dbf";
   set newname for datafile  4 to
 "/u02/app/oracle/oradata/DB2/undotbs01.dbf";
   set newname for datafile  7 to
 "/u02/app/oracle/oradata/DB2/users01.dbf";
   restore
   from  nonsparse   from service
 'DB1'   clone database
   ;
   sql 'alter system archive log current';
}
executing Memory Script

executing command: SET NEWNAME

executing command: SET NEWNAME

executing command: SET NEWNAME

executing command: SET NEWNAME

Starting restore at 04-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00001 to /u02/app/oracle/oradata/DB2/system01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:16:19
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00003 to /u02/app/oracle/oradata/DB2/sysaux01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:01:28
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00004 to /u02/app/oracle/oradata/DB2/undotbs01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:26
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00007 to /u02/app/oracle/oradata/DB2/users01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:03
Finished restore at 04-JUN-25

sql statement: alter system archive log current
current log archived

contents of Memory Script:
{
   restore clone force from service  'DB1'
           archivelog from scn  16363623;
   switch clone datafile all;
}
executing Memory Script

Starting restore at 04-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting archived log restore to default destination
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring archived log
archived log thread=1 sequence=101
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:03
channel ORA_AUX_DISK_1: starting archived log restore to default destination
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring archived log
archived log thread=1 sequence=102
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:02
Finished restore at 04-JUN-25

datafile 1 switched to datafile copy
input datafile copy RECID=5 STAMP=1202939796 file name=/u02/app/oracle/oradata/DB2/system01.dbf
datafile 3 switched to datafile copy
input datafile copy RECID=6 STAMP=1202939796 file name=/u02/app/oracle/oradata/DB2/sysaux01.dbf
datafile 4 switched to datafile copy
input datafile copy RECID=7 STAMP=1202939796 file name=/u02/app/oracle/oradata/DB2/undotbs01.dbf
datafile 7 switched to datafile copy
input datafile copy RECID=8 STAMP=1202939796 file name=/u02/app/oracle/oradata/DB2/users01.dbf

contents of Memory Script:
{
   set until scn  16388529;
   recover
   clone database
    delete archivelog
   ;
}
executing Memory Script

executing command: SET until clause

Starting recover at 04-JUN-25
using channel ORA_AUX_DISK_1

starting media recovery

archived log for thread 1 with sequence 101 is already on disk as file /u02/app/oracle/archivelog/1_101_1201725133.dbf
archived log for thread 1 with sequence 102 is already on disk as file /u02/app/oracle/archivelog/1_102_1201725133.dbf
archived log file name=/u02/app/oracle/archivelog/1_101_1201725133.dbf thread=1 sequence=101
archived log file name=/u02/app/oracle/archivelog/1_102_1201725133.dbf thread=1 sequence=102
media recovery complete, elapsed time: 00:00:03
Finished recover at 04-JUN-25

contents of Memory Script:
{
   delete clone force archivelog all;
}
executing Memory Script

released channel: ORA_AUX_DISK_1
allocated channel: ORA_DISK_1
channel ORA_DISK_1: SID=20 device type=DISK
deleted archived log
archived log file name=/u02/app/oracle/archivelog/1_101_1201725133.dbf RECID=1 STAMP=1202939791
deleted archived log
archived log file name=/u02/app/oracle/archivelog/1_102_1201725133.dbf RECID=2 STAMP=1202939794
Deleted 2 objects

Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes

contents of Memory Script:
{
   sql clone "alter system set  db_name =
 ''DB2'' comment=
 ''Reset to original value by RMAN'' scope=spfile";
   sql clone "alter system reset  db_unique_name scope=spfile";
}
executing Memory Script

sql statement: alter system set  db_name =  ''DB2'' comment= ''Reset to original value by RMAN'' scope=spfile

sql statement: alter system reset  db_unique_name scope=spfile
Oracle instance started

Total System Global Area     268434280 bytes

Fixed Size                     8895336 bytes
Variable Size                201326592 bytes
Database Buffers              50331648 bytes
Redo Buffers                   7880704 bytes
sql statement: CREATE CONTROLFILE REUSE SET DATABASE "DB2" RESETLOGS ARCHIVELOG
  MAXLOGFILES     16
  MAXLOGMEMBERS      3
  MAXDATAFILES      100
  MAXINSTANCES     8
  MAXLOGHISTORY      292
 LOGFILE
  GROUP     1 ( '/u02/app/oracle/oradata/DB2/redo01.log' ) SIZE 200 M  REUSE,
  GROUP     2 ( '/u02/app/oracle/oradata/DB2/redo02.log' ) SIZE 200 M  REUSE,
  GROUP     3 ( '/u02/app/oracle/oradata/DB2/redo03.log' ) SIZE 200 M  REUSE
 DATAFILE
  '/u02/app/oracle/oradata/DB2/system01.dbf'
 CHARACTER SET AL32UTF8


contents of Memory Script:
{
   set newname for tempfile  1 to
 "/u02/app/oracle/oradata/DB2/temp01.dbf";
   switch clone tempfile all;
   catalog clone datafilecopy  "/u02/app/oracle/oradata/DB2/sysaux01.dbf",
 "/u02/app/oracle/oradata/DB2/undotbs01.dbf",
 "/u02/app/oracle/oradata/DB2/users01.dbf";
   switch clone datafile all;
}
executing Memory Script

executing command: SET NEWNAME

renamed tempfile 1 to /u02/app/oracle/oradata/DB2/temp01.dbf in control file

cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB2/sysaux01.dbf RECID=1 STAMP=1202939831
cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB2/undotbs01.dbf RECID=2 STAMP=1202939831
cataloged datafile copy
datafile copy file name=/u02/app/oracle/oradata/DB2/users01.dbf RECID=3 STAMP=1202939831

datafile 3 switched to datafile copy
input datafile copy RECID=1 STAMP=1202939831 file name=/u02/app/oracle/oradata/DB2/sysaux01.dbf
datafile 4 switched to datafile copy
input datafile copy RECID=2 STAMP=1202939831 file name=/u02/app/oracle/oradata/DB2/undotbs01.dbf
datafile 7 switched to datafile copy
input datafile copy RECID=3 STAMP=1202939831 file name=/u02/app/oracle/oradata/DB2/users01.dbf
Reenabling controlfile options for auxiliary database
Executing: alter database add supplemental log data
Executing: alter database force logging

contents of Memory Script:
{
   Alter clone database open resetlogs;
}
executing Memory Script

database opened
Cannot remove created server parameter file
Finished Duplicate Db at 04-JUN-25
Dataguard
19C Dataguard流程图的理解
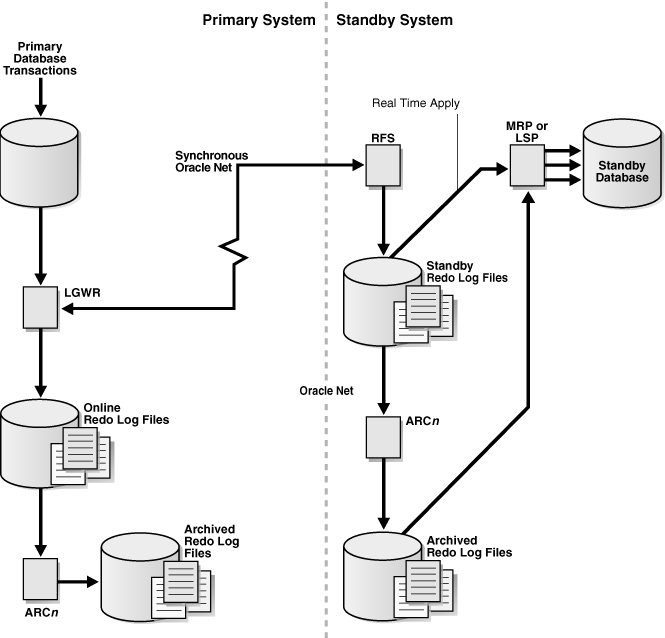
1、主库commit等触发lgwr写redo buffer到online redo logs的同时触发LNS传输redo buffer到备库的RFS
主库:online redo logs-->arch-->archived redo log
备库有standby redo log且启用real-time apply:RFS-->standby redo log-->MRP-->database
备库有standby redo log没有启用real-time apply:RFS-->standby redo log-->archvied redo log-->MRP-->database
备库没有standby redo log:RFS-->archvied redo log-->MRP-->database
2、如果主库和备库之间断开了连接,主库commitdd只触发lgwr写redo buffer到online redo logs
主库:online redo logs-->arch-->archived redo log
备库:RFS通过fal_server参数去找主库的ARCH,主库的ARCH直接传输主库的archived redo log到备库的RFS
备库有standby redo log:主库ARCH-->RFS->standby redo log-->archvied redo log-->MRP-->database
备库没有standby redo log:主库ARCH-->RFS-->archvied redo log-->MRP-->database
RFS:Remote File Server
LNS:Log Network Server
MRP:Managed Recovery Process
LSP:Logical Standby Process
Dataguard主备延迟多长时间的2种查询方法
1、
sql
备库sqlplus>select value from v$dataguard_stats where name='apply lag'2、
sql
备库sqlplus>select ceil((sysdate-next_time)*24*60) "M" from v$archived_log where applied='YES' AND SEQUENCE#=(SELECT MAX(SEQUENCE#) FROM V$ARCHIVED_LOG WHERE applied='YES');Dataguard验证主备是否正常同步的4种方法
1、
最简单的方法,主备库查看最新的归档日志是否apply,如果applied是yes则正常同步
sql
主库sqlplus>select SEQUENCE#,applied,FIRST_TIME,NEXT_TIME,name,dest_id from v$archived_log where standby_dest='YES' order by 1 desc;
备库sqlplus>select SEQUENCE#,applied,FIRST_TIME,NEXT_TIME  from v$archived_log order by 1 desc
2、
主库LNS进程的BLOCK#是否变动、备库查看RFS进程的BLOCK#是否变动,如果BLOCK#都变动,则正常同步
sql
主库sqlplus>select PROCESS,STATUS,SEQUENCE#,BLOCK# from V$MANAGED_STANDBY where process='LNS'
备库sqlplus>select PROCESS,CLIENT_PROCESS,SEQUENCE#,BLOCK# from V$MANAGED_STANDBY where PROCESS='RFS'
3、
12CR2开始已经用V$DATAGUARD_PROCESS替代了V$MANAGED_STANDBY,但是实际情况看下来V$DATAGUARD_PROCESS结果不如V$MANAGED_STANDBY直观,主库执行alter system archive log current后,主备库执行如下查看SEQUENCE#是否变化
sql
主库sqlplus>SELECT ROLE, THREAD#, SEQUENCE#, ACTION FROM V$DATAGUARD_PROCESS;
备库sqlplus>SELECT ROLE, THREAD#, SEQUENCE#, ACTION FROM V$DATAGUARD_PROCESS;
4、
主库执行checkpoint,查看APPLIED_SCN是否变化
sql
主库sqlplus>alter system checkpoint;
主库sqlplus>SELECT DEST_ID, STATUS, APPLIED_SCN, DESTINATION,DB_UNIQUE_NAME FROM V$ARCHIVE_DEST WHERE TARGET='STANDBY';
real-time apply:就是备库apply standby redo log,对应视图V$ARCHIVE_DEST_STATUS.RECOVERY_MODE=MANAGED REAL TIME APPLY
real-time query:就是备库启到open read only模式,对应视图v$database.open_mode=READ ONLY WITH APPLY
Real-Time Apply和Redo Apply(即主库数据修改并commit后备库能不能实时查询到修改了)
Redo Apply是备库默认的应用方式,即备库没有standby redo log这个时候只能应用备库的Archive log,主库数据修改并commit后备库不能实时查询到修改了的数据,只有主库归档了带动了备库的归档,这样备库才能查询到
Real-time Apply应用即应用备库的standby redo log,所以需先在备库建立standby redo log,主库数据修改并commit后备库能实时查询到修改了的数据
三种保护模式,了解到所有关系型数据库在这一点的理论上基本都一致,都是看事务需不需要等待备用数据库确认接收,就像Sqlserver的alwayson、mirror涉及的sync、async意思一样
最大可用性:log_archive_dest_n参数属性AFFIRM或NOAFFIRM或SYNC或ASYNC
在不会影响主数据库的可用性的情况下,提供最高级别的数据保护,允许主数据库在无法从备用数据库接收确认时继续处理。如果主数据库没有收到至少一个同步备用数据库的确认,则它会像在最高性能模式下一样运行,以保持主数据库的可用性,直到它能够再次将其重做流写入同步备用数据库。
最大性能:log_archive_dest_n参数属性是NOAFFIRM和ASYNC
在不会影响主数据库的性能的情况下,提供最高级别的数据保护。这是通过允许事务在这些事务生成的所有重做数据写入在线日志后立即提交来实现的。在任何情况下,均先完成主数据库上的写操作,主数据库的提交操作不等待备用数据库确认接收。
最大保护:log_archive_dest_n参数属性是AFFIRM和SYNC
事务不会提交,直到恢复这些事务所需的所有重做数据都已写入在线重做日志,并且备库已收到重做并将其写入备用的备用重做日志,并将确认发送回主库。会关闭主数据库一旦主数据库在无法从备用数据库接收确认,此数据保护模式将数据保护置于主数据库可用性之上,因此 Oracle 建议至少使用两个备用数据库来保护在最大保护模式下运行的主数据库,以防止单个备用数据库故障导致主数据库关闭。这种保护模式确保主数据库故障也不会发生数据丢失。最大保护模式下,所有备库宕机或无法连接的情况下,主库会出现hang住或宕机的情况(已经实验过的),所以这样的环境下不要随便关闭备库。
如果log_archive_dest_n参数没有指定AFFIRM或NOAFFIRM的属性,那么当指定sync属性时默认就是AFFIRM,当指定async属性时默认就是NOAFFIRM
AFFIRM---specifies that a redo transport destination acknowledges received redo data after writing it to the standby redo log.
NOAFFIRM---specifies that a redo transport destination acknowledges received redo data before writing it to the standby redo log.
修改三种保护模式的实践
sql
select dbid,name,controlfile_type,open_mode,database_role,db_unique_name,protection_mode,protection_level from v$database;
--主备数据库都是MAXIMIZE PERFORMANCE且都是open状态下(主read write,备read only),主备节点执行如下语句的结果
ALTER DATABASE SET STANDBY DATABASE TO MAXIMIZE AVAILABILITY --成功执行
ALTER DATABASE SET STANDBY DATABASE TO MAXIMIZE PERFORMANCE --成功执行
ALTER DATABASE SET STANDBY DATABASE TO MAXIMIZE PROTECTION --无法成功,执行报错ORA-01126: database must be mounted in this instance and not open in any instance

select dbid,name,controlfile_type,open_mode,database_role,db_unique_name,protection_mode,protection_level from v$database;
--主备数据库都是MAXIMIZE PERFORMANCE都是open状态下(主read write,备read only)
重启备库,启动到mount状态下,再执行如下语句
ALTER DATABASE SET STANDBY DATABASE TO MAXIMIZE PROTECTION --备库成功执行,这样的话主库是MAXIMIZE PERFORMANCE,备库变成了MAXIMIZE PROTECTION,主备的protection_mode,protection_level居然可以不一样
alter database open; --备库成功执行
ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT;--备库成功执行
log_archive_dest_n中的VALID_FOR参数
The VALID_FOR attribute specifies whether redo data gets written to a destination.
没有写VALID_FOR时,默认VALID_FOR=(all_logfiles,all_roles)
VALID_FOR=(redo_log_type, database_role)属性由2部分组成:redo_log_type(online_logfile,standby_logfile,all_logfiles)和database_role(primary_role,standby_role,all_role).
ONLINE_LOGFILE---This destination is valid only when archiving online redo log files.
STANDBY_LOGFILE---This destination is valid only when archiving standby redo log files.
ALL_LOGFILES--- This destination is valid when archiving either online redo log files or standby redo log files.
PRIMARY_ROLE---This destination is valid only when the database is running in the primary role.
STANDBY_ROLE---This destination is valid only when the database is running in the standby role.
ALL_ROLES---This destination is valid when the database is running in either the primary or the standby role.
假如主库设置如下,则主库切换为备库后,log_archive_dest_2就不生效了,因为log_archive_dest_2只有当前实例是主库(PRIMARY_ROLE)时才生效
*.log_archive_dest_1='location=/u01/app/oracle/archive_log'
--对于log_archive_dest_1的归档路径的理解:因为默认VALID_FOR=(ALL_LOGFILES,ALL_ROLES),DB_UNIQUE_NAME=当前实例的DB_UNIQUE_NAME,所以不管当前实例是主库还是备库(ALL_ROLES),不管是什么日志文件(ALL_LOGFILES),都归档到本地目录/u01/app/oracle/archive_log
*.log_archive_dest_2='service=DB1DG async VALID_FOR=(ONLINE_LOGFILES,PRIMARY_ROLE) DB_UNIQUE_NAME=DB1DG'
--对于log_archive_dest_2的归档路径的理解:当前实例是主库(PRIMARY_ROLE)时才生效,且只通过async方式传输在线日志(ONLINE_LOGFILES)到tns别名为DB1DG且DB_UNIQUE_NAME是DB1DG的RFS
假如备库设置如下,则备库切换为主库后,log_archive_dest_2开始生效了
bash
*.log_archive_dest_1='location=/u01/app/oracle/archive_log'
*.log_archive_dest_2='service=DB1 async VALID_FOR=(ONLINE_LOGFILES,PRIMARY_ROLE) DB_UNIQUE_NAME=DB1'
如果主备都把位置2设置为ALL_LOGFILES,ALL_ROLES,备库还要给主库发归档日志,那就矛盾了。
Standby redo log的理解
It is a best practice to configure the primary database to receive redo if this is the first time a standby database is added to the configuration.The primary database can then quickly transition to the standby role and begin receiving redo data, if necessary.
A standby redo log is used to store redo received from another Oracle database. Standby redo logs are structurally identical to redo logs, and are created and managed using the same SQL statements used to create and manage redo logs.
Each standby redo log file must be at least as large as the largest redo log file in the redo log of the redo source database. For administrative ease, Oracle recommends that all redo log files in the redo log at the redo source database and the standby redo log at a redo transport destination be of the same size.
The standby redo log must have at least one more redo log group than the redo log at the redo source database, for each redo thread at the redo source database.
如果这是第一次将备用数据库添加到配置中,那么最好将主数据库配置为接收重做。然后,主数据库可以快速转换为备用角色,并在必要时开始接收重做数据。
Standby redo log用于存储从另一个 Oracle 数据库接收的redo。Standby redo log在结构上与redo log相同,并且使用用于创建和管理redo log的相同 SQL 语句进行创建和管理。
每个Standby redo log文件必须至少与redo源数据库的redo log中最大的redo log文件一样大。为了便于管理,Oracle 建议redo源数据库的重redo log中的所有redo log文件和redo传输目标的Standby redo log具有相同的大小。
对于redo源数据库中的每个redo线程,Standby redo log必须至少比redo源数据库的redo log多一个redo log group。也就是说单机情况下standby redo log group=redo log group+1才合理
sql
SQL> ALTER DATABASE ADD STANDBY LOGFILE ('/oracle/dbs/slog1.rdo')size 500M;
SQL> ALTER DATABASE ADD STANDBY LOGFILE ('/oracle/dbs/slog2.rdo')size 500M;
SQL> SELECT GROUP#,BYTES FROM V$STANDBY_LOG;

ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT;
--This also automatically enables real-time apply provided the standby database is configured with a standby redo log and is in mode ARCHIVELOG
--如果备库开启redo日志应用,一旦备库配置了备用重做日志并且处于ARCHIVELOG模式,那么会自动启用实时应用
Dataguard的一些实验结论
1、主库使用参数async并设置为最大可用性行吗
可以,不会报错
2、主库使用参数sync并设置为最大可用性,但是备库不建立standby redo log行吗
可以,不会报错,主库和备库的PROTECTION_MODE、PROTECTION_LEVEL值分别是MAXIMUM AVAILABILITY、RESYNCHRONIZATION
3、主库设置参数sync/async并设置为最大性能模式,备库建立standby redo log,备库可以实时应用吗
sync下实验过可以,async下也实验过可以
4、主库设置参数sync/async并设置为最大性能模式,备库建立standby redo log,备库可以不实时应用吗
sync下实验过可以,async下实验过可以
5、主库把redo buffer传输到备库RFS后,备库应用standby redo log或archivelog的整个这个过程和备库自己创建的online redo log没有关系,因为备库的online redo log无法使用,备库也无法执行alter system switch logfile或alter system archive log current(这两者必须要在open read wirte模式下,open with read only不行)
6、主库关闭监听,备库监听还在的情况下,主库的归档日志还会正常传输到备库,也就是说dataguard同步不受影响
7、控制文件的修改信息不会同步到standby节点,所以primay修改rman信息后不会同步到standby,Dataguard只同步redo log信息。
8、主库新增redo log(standby redo log亦如此)或删除redo log(standby redo log亦如此),主库进行了归档,且归档日志同步到备库,且备库应用了归档日志,备库都不会显示已经新增或删除的redo log(standby redo log亦如此),当然备库不可以执行这样的操作alter database drop/add standby logfile group 4;
根据以上实验和理论,得出三种保护模式、同步异步传输、实时应用三者的关系
实时应用:就是主库数据修改并commit后备库能实时查询到修改了的数据,和三种保护模式无关,和同步异步传输sync/async无关,即只和standby redo log和archive模式有关
官方文档
Dataguard搭建的步骤,使用duplicate复制数据库到备库
主库:192.168.100.128
db_name是DB1,db_unique_name是DB1,
文件路径/u01/app/oracle/oradata/DB1,
归档日志路径/u01/app/oracle/archivelog
ORACLE_HOME是/u01/app/oracle/product/19.3.0/db_1
备库:192.168.100.129
db_name是DB1,db_unique_name是DB1DG,
文件路径/u02/app/oracle/oradata/DB1DG,
归档日志路径/u02/app/oracle/archivelog
ORACLE_HOME是/u02/app/oracle/product/1930/db_2
1、主库确保强制归档
sql
alter database archivelog;
alter database force logging;
select name,log_mode,force_logging from v$database
主库3组redo log,每个redo file size是210M,所以添加4组size为210MB的STANDBY LOGFILE
sql
ALTER DATABASE ADD STANDBY LOGFILE ('/u01/app/oracle/oradata/DB1/slog1.rdo') SIZE 210M;
ALTER DATABASE ADD STANDBY LOGFILE ('/u01/app/oracle/oradata/DB1/slog2.rdo') SIZE 210M;
ALTER DATABASE ADD STANDBY LOGFILE ('/u01/app/oracle/oradata/DB1/slog3.rdo') SIZE 210M;
ALTER DATABASE ADD STANDBY LOGFILE ('/u01/app/oracle/oradata/DB1/slog4.rdo') SIZE 210M;
select * from v$standby_log; --发现7组日志,3组是redo log,4组是standby redo log
2、备库创建pfile文件/tmp/pfiledb1dg.ora,以下11项前10项缺一不可,后面1项是Dataguard执行switchover后备库变成主库时才会生效
bash
*.db_name='DB1'
*.db_unique_name='DB1DG'
*.control_files='/u02/app/oracle/oradata/DB1DG/control01.ctl','/u02/app/oracle/oradata/DB1DG/control02.ctl'
*.log_archive_config='DG_CONFIG=(DB1,DB1DG)'
*.log_archive_dest_1='location=/u02/app/oracle/archivelog VALID_FOR=(ALL_LOGFILES,ALL_ROLES) DB_UNIQUE_NAME=DB1DG'
*.remote_login_passwordfile='EXCLUSIVE'
*.fal_server='DB1'
*.STANDBY_FILE_MANAGEMENT=AUTO //缺少这个参数的话,主库新建data_file后备库会报错ORA-01274
*.DB_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB1DG'
*.LOG_FILE_NAME_CONVERT='/u01/app/oracle/oradata/DB1','/u02/app/oracle/oradata/DB1DG'
*.log_archive_dest_2='service=DB1 async VALID_FOR=(ONLINE_LOGFILES,PRIMARY_ROLE) db_unique_name=DB1'
3、备库有静态监听文件、密码文件、使用pfile文件启动到nomount状态
bash
LISTENER =
  (DESCRIPTION_LIST =
    (DESCRIPTION =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
      (ADDRESS = (PROTOCOL = IPC)(KEY = EXTPROC1521))
    )
  )

SID_LIST_LISTENER =
  (SID_LIST =
    (SID_DESC =
      (GLOBAL_DBNAME = DB1DG)
      (ORACLE_HOME = /u02/app/oracle/product/1930/db_2)
      (SID_NAME = DB1)
    )
  )

ADR_BASE_LISTENER = /u02/app/oracle

SQL> startup nomount pfile='/tmp/pfiledb1dg.ora';
4、主备库的tns都有如下信息
bash
DB1 =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.128)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB1)
    )
  )


DB1DG =
  (DESCRIPTION =
    (ADDRESS_LIST =
      (ADDRESS = (PROTOCOL = TCP)(HOST = 192.168.100.129)(PORT = 1521))
    )
    (CONNECT_DATA =
      (SERVICE_NAME = DB1DG)
    )
  )
5、主库新增或修改spfile以下10项中前6项缺一不可(DG_CONFIG谁在逗号前面,谁在逗号后面不影响,DG_CONFIG值是db_unique_name,service值是tns别名,VALID_FOR=(redo_log_type, database_role)),后面4项是Dataguard执行switchover后主库变成备库时才会生效
bash
*.db_name='DB1'
*.db_unique_name='DB1'
*.log_archive_config='DG_CONFIG=(DB1,DB1DG)'
*.log_archive_dest_1='location=/u01/app/oracle/archivelog VALID_FOR=(ALL_LOGFILES,ALL_ROLES) DB_UNIQUE_NAME=DB1'
*.log_archive_dest_2='service=DB1DG async VALID_FOR=(ONLINE_LOGFILES,PRIMARY_ROLE) db_unique_name=DB1DG'
*.remote_login_passwordfile='EXCLUSIVE'
*.fal_server='DB1DG'
*.STANDBY_FILE_MANAGEMENT=AUTO
*.DB_FILE_NAME_CONVERT='/u02/app/oracle/oradata/DB1DG','/u01/app/oracle/oradata/DB1'
*.LOG_FILE_NAME_CONVERT='/u02/app/oracle/oradata/DB1DG','/u01/app/oracle/oradata/DB1'
6、主库执行duplicate命令创建备库
duplicate命令会把主库的数据文件和日志文件复制到备库,具体复制到备库的哪个目录,参考步骤1中参数DB_FILE_NAME_CONVERT和LOG_FILE_NAME_CONVERT,并且会自动给备库生成控制文件,控制文件中备库的哪个目录,参考步骤1中参数control_files
bash
rman target sys/123456@DB1 auxiliary sys/123456@DB1DG
connected to target database: DB1 (DBID=1794862737)
connected to auxiliary database: DB1 (not mounted)
RMAN> duplicate target database for standby from active database;

Starting Duplicate Db at 03-JUN-25
using target database control file instead of recovery catalog
allocated channel: ORA_AUX_DISK_1
channel ORA_AUX_DISK_1: SID=21 device type=DISK

contents of Memory Script:
{
   backup as copy reuse
   passwordfile auxiliary format  '/u02/app/oracle/product/1930/db_2/dbs/orapwDB1'   ;
}
executing Memory Script

Starting backup at 03-JUN-25
allocated channel: ORA_DISK_1
channel ORA_DISK_1: SID=56 device type=DISK
Finished backup at 03-JUN-25

contents of Memory Script:
{
   restore clone from service  'DB1' standby controlfile;
}
executing Memory Script

Starting restore at 03-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: restoring control file
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:01
output file name=/u02/app/oracle/oradata/DB1DG/control01.ctl
output file name=/u02/app/oracle/oradata/DB1DG/control02.ctl
Finished restore at 03-JUN-25

contents of Memory Script:
{
   sql clone 'alter database mount standby database';
}
executing Memory Script

sql statement: alter database mount standby database

contents of Memory Script:
{
   set newname for tempfile  1 to
 "/u02/app/oracle/oradata/DB1DG/temp01.dbf";
   switch clone tempfile all;
   set newname for datafile  1 to
 "/u02/app/oracle/oradata/DB1DG/system01.dbf";
   set newname for datafile  3 to
 "/u02/app/oracle/oradata/DB1DG/sysaux01.dbf";
   set newname for datafile  4 to
 "/u02/app/oracle/oradata/DB1DG/undotbs01.dbf";
   set newname for datafile  7 to
 "/u02/app/oracle/oradata/DB1DG/users01.dbf";
   restore from  nonsparse from service 'DB1' clone database;
   sql 'alter system archive log current';
}
executing Memory Script

executing command: SET NEWNAME
renamed tempfile 1 to /u02/app/oracle/oradata/DB1DG/temp01.dbf in control file
executing command: SET NEWNAME
executing command: SET NEWNAME
executing command: SET NEWNAME
executing command: SET NEWNAME

Starting restore at 03-JUN-25
using channel ORA_AUX_DISK_1

channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00001 to /u02/app/oracle/oradata/DB1DG/system01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:01:37
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00003 to /u02/app/oracle/oradata/DB1DG/sysaux01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:35
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00004 to /u02/app/oracle/oradata/DB1DG/undotbs01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:15
channel ORA_AUX_DISK_1: starting datafile backup set restore
channel ORA_AUX_DISK_1: using network backup set from service DB1
channel ORA_AUX_DISK_1: specifying datafile(s) to restore from backup set
channel ORA_AUX_DISK_1: restoring datafile 00007 to /u02/app/oracle/oradata/DB1DG/users01.dbf
channel ORA_AUX_DISK_1: restore complete, elapsed time: 00:00:04
Finished restore at 03-JUN-25

sql statement: alter system archive log current

contents of Memory Script:
{
   switch clone datafile all;
}
executing Memory Script

datafile 1 switched to datafile copy
input datafile copy RECID=1 STAMP=1202851747 file name=/u02/app/oracle/oradata/DB1DG/system01.dbf
datafile 3 switched to datafile copy
input datafile copy RECID=2 STAMP=1202851747 file name=/u02/app/oracle/oradata/DB1DG/sysaux01.dbf
datafile 4 switched to datafile copy
input datafile copy RECID=3 STAMP=1202851747 file name=/u02/app/oracle/oradata/DB1DG/undotbs01.dbf
datafile 7 switched to datafile copy
input datafile copy RECID=4 STAMP=1202851747 file name=/u02/app/oracle/oradata/DB1DG/users01.dbf
Finished Duplicate Db at 03-JUN-25
7、备库创建spfile并启动,并开启日志应用
sql
SQL> create spfile from pfile='/tmp/pfiledb1dg.ora';
SQL> shutdown abort;
SQL> startup mount;
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE USING CURRENT LOGFILE;
--Warning: ALTER DATABASE RECOVER MANAGED STANDBY DATABASE USING CURRENT LOGFILE has been deprecated.
这个语句从12.2版本开始已经废弃,如果执行这个语句,默认等于执行ALTER DATABASE RECOVER MANAGED STANDBY DATABASE属于foreground前台启动
sql
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT;--This also automatically enables real-time apply provided the standby database is configured with a standby redo log and is in mode ARCHIVELOG
如果备用数据库配置了备用重做日志并且处于ARCHIVELOG模式,这也会自动启用实时应用
sql
SQL> alter database open read only;
ORA-10456: cannot open standby database; media recovery session may be in progress
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE CANCEL;
SQL> alter database open read only;
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT;
以下两者的区别是,前者是foreground前台启动(ALTER语句执行后不会退出而是一直在SQL>中),后者是background后台启动(ALTER语句执行后会马上退出并且返回信息Database altered.)
sql
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE;
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT;
8、验证
主库创建一个SCHEDULER JOB每1分钟定期往test1表中插入数据库,再在备库查看test1表是否正常更新
sql
SQL> create table test1 (htime timestamp );
SQL> create or replace procedure pro_test1 as
    begin
    insert into test1 values(sysdate);
    commit;
    end;
    /

SQL> BEGIN
  DBMS_SCHEDULER.CREATE_JOB(
  job_name =>'jobtest1',
  job_type =>'STORED_PROCEDURE',
  job_action =>'pro_test1',
  start_date=>SYSTIMESTAMP,
  repeat_interval =>'FREQ=MINUTELY;INTERVAL=1',
  enabled=>true
  );
  END;
  /

SQL> select * from dba_scheduler_jobs where job_name='JOBTEST1'
9、SWITHOVER切换,SWITCHOVER是人为计划的互相切换主备,大致步骤如下
1、主库DB1切换为备库,此过程会关闭主库并且会自动更新原备库为mount状态,比如原备库为readonly open则会自动更改原备库为mount状态
2、把原备库DB1DG从mount状态修改为open模式变成新主库
3、再启动原主库DB1并应用日志使原主库变成了新备库
sql
主库
SQL> ALTER DATABASE SWITCHOVER TO DB1DG VERIFY;
SQL> ALTER DATABASE SWITCHOVER TO DB1DG;
sql
原备库修改为新主库
SQL> select DBID,NAME,DB_UNIQUE_NAME,OPEN_MODE from v$database;--主库切换后,原备库会从readonly open模式更改为mount模式
SQL> ALTER DATABASE OPEN;--变成了新的主库
SQL> select DBID,NAME,DB_UNIQUE_NAME,OPEN_MODE from v$database;--数据库是read write模式
sql
原主库
SQL> STARTUP;--主库切换后,原主库直接shutdown immediate了,所以原主库需要重启启动
SQL> select DBID,NAME,DB_UNIQUE_NAME,OPEN_MODE from v$database;--startup后自动变成readonly模式
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT FROM SESSION;--原主库变成了新备库
10、FAILOVER切换,FAILOVER是主库故障的情况下,把备库切换为主库,备库按顺序操作如下步骤
sql
SQL> SELECT THREAD#, LOW_SEQUENCE#, HIGH_SEQUENCE# FROM V$ARCHIVE_GAP;--看看有多少归档日志没有同步到
SQL> ALTER DATABASE REGISTER PHYSICAL LOGFILE 'filespec1';--手工注册这些归档日志
SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE CANCEL;--取消日志应用
SQL> ALTER DATABASE FAILOVER TO target_db_name;--此处的target_db_name是db_unique_name,如果成功直接执行最后一步ALTER DATABASE OPEN;如果不成功继续下面的操作
SQL> ALTER DATABASE FAILVOVER TO target_db_name FORCE;--如果成功直接执行最后一步ALTER DATABASE OPEN;如果不成功继续下面的操作
SQL> ALTER DATABASE ACTIVATE PHYSICAL STANDBY DATABASE;
SQL> ALTER DATABASE OPEN;
示例:备库操作步骤如下(主库的db_name和db_unique_name都是DB1,主库已经宕机的情况下,备库的db_name是DB1而db_unique_name是DB1DG)
sql
SQL> SELECT THREAD#, LOW_SEQUENCE#, HIGH_SEQUENCE# FROM V$ARCHIVE_GAP;
no rows selected

SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE CANCEL;
Database altered.

SQL> ALTER DATABASE FAILOVER TO DB1;
ALTER DATABASE FAILOVER TO DB1
ERROR at line 1:
ORA-16463: invalid target database name

SQL> ALTER DATABASE FAILOVER TO DB1DG;
ALTER DATABASE FAILOVER TO DB1DG
*
ERROR at line 1:
ORA-16472: failover failed due to data loss

SQL> ALTER DATABASE FAILVOVER TO DB1DG FORCE;
ALTER DATABASE FAILVOVER TO DB1DG FORCE
                         *
ERROR at line 1:
ORA-02231: missing or invalid option to ALTER DATABASE
SQL> ALTER DATABASE ACTIVATE PHYSICAL STANDBY DATABASE;
Database altered.

SQL> ALTER DATABASE OPEN;
Database altered.
RAC
RAC 的本质是一个数据库,多个实例运行。它通过Distributed Lock Management(DLM:分布式锁管理器) 来解决并发问题。因为RAC的资源是共享的,为了保证数据的一致性,就需要使用DLM来协调实例间对资源的竞争访问。RAC的DLM就叫作Cache Fusion(缓存融合)。
Cache Fusion是通过高速的Private Interconnect,在实例间进行数据块传递,它是RAC 最核心的工作机制,它把所有实例的SGA虚拟成一个大的SGA区,从而使得多个节点SGA对用户透明。每当不同的实例请求相同的数据块时,这个数据块就通过Private Interconnect 在实例间进行传递。以避免首先将块推送到磁盘,然后再重新读入其他实例的缓存中这样一种低效的实现方式。当一个块被读入RAC环境中某个实例的缓存时,该块会被赋予一个锁资源(与行级锁不同),以确保其他实例知道该块正在被使用。之后,如果另一个实例请求该块的一个副本,而该块已经处于前一个实例的缓存内,那么该块会通过Private Interconnect直接被传递到另一个实例的SGA。如果内存中的块已经被改变,但改变尚未提交,那么将会传递一个CR副本。这就意味着只要可能,数据块无需写回磁盘即可在各实例的缓存之间移动,从而避免了同步多实例的缓存所花费的额外I/O。这样对用户而言cache fusion就把多个实例的数据库缓冲区虚拟成一个数据库缓冲区,它实现了SGA对用户透明。很明显,不同的实例缓存的数据可以是不同的,也就是在一个实例要访问特定块之前,而它又从未访问过这个块,那么它要么从其他实例cache fusion过来,或者从磁盘中读入。
要发挥Cache Fusion的作用,要有一个前提条件,那就是互联网络的速度要比访问磁盘的速度要快!否则,没有引入Cache Fusion的意义。
整个Cache Fusion 有两个服务组成:GCS和GES。
Cache Fusion要解决的首要问题就是:数据块拷贝在集群节点间的状态分布图, 这是通过GRD 实现的。
Global Cache Service全局缓存服务(GCS):要和Cache Fusion结合在一起来理解。全局缓存要涉及到数据块。全局缓存服务负责维护该全局缓冲存储区内的缓存一致性,确保一个实例在任何时刻想修改一个数据块时,都可获得一个全局锁资源,从而避免另一个实例同时修改该块的可能性。进行修改的实例将拥有块的当前版本(包括已提交的和未提交的事物)以及块的前象 (post image)。如果另一个实例也请求该块,那么全局缓存服务要负责跟踪拥有该块的实例、拥有块的版本是什么,以及块处于何种模式。
Global Enqueue Service全局队列服务(GES):主要负责维护字典缓存和库缓存内的一致性。字典缓存是实例的SGA内所存储的对数据字典信息的缓存,用于高速访问。由于该字典信息存储在内存中,因而在某个节点上对字典进行的修改(如DDL)必须立即被传播至所有节点上的字典缓存。GES负责处理上述情况,并消除实例间出现的差异。 处于同样的原因,为了分析影响这些对象的SQL语句,数据库内对象上的库缓存锁会被去掉。这些锁必须在实例间进行维护,而全局队列服务必须确保请求访问相同对象的多个实例间不会出现死锁。
RAC区别于单机的一个就是多了一个GRD(global resource directory)内存区以及附属的多个后台进程和部分数据库文件,GRD里记录的是每一个数据块在集群间的分布图,它位于每一个实例的SGA的shared pool中,但是每个实例都是部分GRD,所有实例的GRD汇总在一起就是一个完整的GRD。该区域用来存储同一个数据库在不同节点上的分布,即多个实例在并发操作一个数据块时,将该数据块存储在各自实例的GRD内存区中。
GRD可以想像为一张大分区表,每个实例都是分区表中的分区。
GRD Master:每个被调入内存的对象,包括表,索引,cluster等,都会被分配一个master实例,相关动态视图V$GCSHVMASTER_INFO、V$GCSPFMASTER_INFO、V$HVMASTER_INFO,这个GRD master记录的信息是数据库对象,不是数据库的某行某块。每个实例只会维护该实例所master的那些资源的GRD记录。比如如下信息表明实例1里记录的GRD的数据就是T1,T3。每个实例都有一份完全一样的拷贝的GRD Master表。
object master_instance_id
T1 1
T2 2
T3 1
T4 2
RAC实例访问的形象理解1:比如$GCSPFMASTER_INFO记录中没有关于数据库对象表1的记录
实例1去访问表1的某行对应的块,发现$GCSPFMASTER_INFO中没有表1,也就是表1从来没有访问过,这样数据库就在$GCSPFMASTER_INFO中记录表1的master为实例1
RAC实例访问的形象理解2:比如$GCSPFMASTER_INFO记录的数据库对象表1的maser是实例2
实例1去访问表1的某行对应的块,实例1去访问实例2,实例2发现这个块不在GRD中,就告诉实例1这个块不在SGA中,实例2让实例1去走IO访问磁盘
实例1去访问表1的某行对应的块,实例1去访问实例2,实例2发现这个块在GRD中并且就在自己的SGA上,实例2把这个块的副本发送给实例1
实例1去访问表1的某行对应的块,实例1去访问实例2,实例2发现这个块在GRD中并且在实例3上,实例2告诉实例1这个块在实例3上,并且实例2让实例3把这个块的副本发送给实例1
RAC使用分布锁管理(DLM)机制对并发进行检测,用一个例子说明DLM作用
1、一个2节点的RAC
2、节点1想要修改数据1
3、节点1向DLM请求,DLM发现数据1还没有被任何节点使用,DLM就授权给节点1;并且DLM登记节点1对数据1的使用
4、节点2也想修改数据1
5、节点2向DLM请求,DLM发现数据1被节点1使用,DLM就会请求节点1"先给节点2用吧",节点1接到请求后释放其对数据1的占用,节点2能够操作数据1
6、DLM记录这个过程
需要强调的是DLM负责的是节点间的协调,而节点内的协调不是DLM负责,继续上面这个例子
1、现在节点2的进程1修改数据1
2、节点2的进程2也想修改数据1
3、节点2仍然请求DLM,DLM发现节点2现在已经有权限,无须授权
4、进程2对DLM的请求被通过,但是进程2是否能够修改数据1,还需要进一步检查
5、通过传统的锁模式,比如"行级锁",进程2发现数据1正被进程1修改,所以进程2只能等待
总结比喻:
把整个 RAC 集群想象成一个庞大的图书馆(共享数据库)。GRD 就像是这个图书馆的分布式、实时更新的联合卡片目录系统:
1、全局性: 它记录了所有书籍(数据块)的状态:
某本书现在在哪个分馆的书架(实例的 Buffer Cache)上?
这本书是被人在阅览(Shared Lock)?还是正在被修改不能打扰(Exclusive Lock)?
2、分布式: 目录卡片(资源信息)不是集中放在一个柜子里,而是分散存放在图书馆各个分馆(RAC 实例)的管理员(主实例)手中。
3、协调作用: 当一位读者(用户会话/进程)在任何分馆想找一本书(访问一个块):
他先查(或问管理员)这本书的卡片在哪个分馆管理员(主实例)那里。
然后联系那个分馆管理员询问这本书的当前状态(可用吗?被谁拿着?)。
管理员根据自己保管的卡片(GRD 分区)告诉他信息,并协调取书(块传输)或安排等待。
RAC提高性能的理解:负载不足导致sql执行很慢时,多个实例可以分摊负载(CPU、内存),负载不是性能瓶颈的情况下,RAC无法提高具体的sql的执行效率,相反实例越多,具体的单个SQL的性能越差。
实例越多性能越差的理解:比如10个节点,节点A要访问表1中的100个块,其中10个块在节点1,10个块在节点2.。。10个块在节点10,这样100个块,节点A就要访问表1的master实例10次,表1的master实例再告诉块具体在哪个节点,这些节点再把块推送到节点A,这样就需要10次节点A到master实例访问+10次master实例到各个节点的访问+10次各个节点推送块到节点A,总计20次的访问+10次的GC块传输
RAC的一些等待事件
gc buffer busy:即global cache buffer busy,产生的原因和单实例的 buffer busy waits 类似,就是一个时间点节点a的实例向节点b请求block的等待。主要是修改操作引起,而非读引起。
gcs log flush sync:flush 是Oracle为了保证Instance Recovery实例恢复机制,而要求每一个current block在本地节点local instance被修改后(modify/update) 必须要将该current block相关的redo 写入到logfile 后(要求LGWR必须完成写入后才能返回),才能由LMS进程传输给其他节点使用。
理解gcs log flush sync了就会明白为什么RAC到RAC的恢复或RAC到单机的恢复,一般都是recover 到某个thread的某个sequnce就可以了
理解redo共享了和redo单个sequence里面的scn不连续,就会明白为什么RAC到RAC的恢复或RAC到单机的恢复,一般都是recover到某个thread的某个scn或sequence就可以了
一些操作的注意事项:
1、因为RAC环境下各节点密码文件在各自的节点中,所以修改sys用户密码时,必须在所有节点上都执行一遍。
2、我们必须知道在oracle11g中,官方推荐GI和oracle 数据库软件分开管理,在这种情况下,我们会发现数据库监听器其实是位于GI的管理账号下,即通常我们所创建的grid账号。在该grid账号的$ORACLE_HOME/network/admin目录下我们会发现我们的listener.ORA文件。同时监听器的启动与关闭都是由该grid账号来控制,若使用oracle账号执行lsnrctl stop\start此时就会发现报错如下:
TNS-01190: The user is not authorized to execute the requested listener command
3、默认情况下我们的tnsnames.ora文件仍然存在于oracle账号下的相关位置。
4、在RAC环境中,监听器是由grid账号来维护的,此外ASM实例参数local_listener使用的一定是vip,数据库实例参数local_listener则vip、scan-ip均可使用。如果数据库实例参数local_listener配置了vip,此时客户端只能透过vip访问数据库,如果数据库实例参数local_listener参数设置为scan-ip此时客户端只能透过scan-ip访问数据库。建议使用scan-ip,这样数据库在增删节点的时候就不会影响到客户端的使用,客户端也无需也节点的变化而修改配置。Oracle官方建议在使用scan-ip时最少配置3个scan-ip。这样透过冗余可防止某个scan-ip不可用导致客户端无法访问数据库。如果local_listener配置vip,不同节点下的不一样,A节点(ASM和ORACLE实例都是)用A-vip,B节点(ASM和ORACLE实例都是)用B-vip
脑裂(split brain):描述的是私有网络心跳出现故障的时候,而每个节点都正常运行,这时侯每个节点都认为其他的节点宕机了,自己应该获得集群的控制权,这种状况就是脑裂。脑裂了某些原因导致心跳线无法连接,这时候每个NODE都是独立的个体了,突然心跳线恢复了,然后节点们互相争主权。在脑裂检查阶段Reconfig Manager会找出那些没有Network Heartbeat而有Disk Heartbeat的节点,并通过Network Heartbeat(如果可能的话)和Disk Heartbeat的信息来计算所有竞争子集群(subcluster)内的节点数目,并依据以下2种因素决定哪个子集群应当存活下去:1.拥有最多节点数目的子集群(Sub-cluster with largest number of Nodes);2.若子集群内数目相等则最低节点号的子集群(Sub-cluster with lowest node number)把其他子集群踢出,举例来说在一个2节点的RAC环境中总是1号节点会获胜。只有2个节点的时候,投票算法就失效了,number较小的1节点通过voting disk向2号节点发起驱逐,不过个人的理解为:第一个启动的节点,就是主节点(不一定是节点1),两个节点时,主节点驱逐另一个节点
配置ASM磁盘的几种方式
1、udev
2、oracleasm(asmlib)
3、AFD
在Linux平台中,系统启动时,每个磁盘会被系统分配sda、sdb这类名字,但是到底是a还是b取决于总线对硬件的扫描顺序,最先被扫描的会被分配sda,然后依次排序,如果有本地磁盘和存储盘,则可能导致每次重启后sda和sdb对应的硬件设备发生变化,为了避免这种不一致,要在/etc/mobprobe.conf中添加两行信息,强迫先扫描本地磁盘再扫描存储盘,不过到了Red Hat AS4系统及之后版本默认就是这样的扫描顺序,不需要再去配置这两行了。但是多个存储盘时,重启后各个存储盘的盘符可能会调换,导致存储盘的名字不固定。在Oracle 10g推出ASM技术后,要求ASM所有节点的磁盘名字一致,故需要ASM磁盘名字固定的解决方案,也就诞生了ASMLIB,后来Oracle 12C又推出更有优势的ASMFD来取代ASMLIB。
AFD:ASM Filter Driver,是Oracle在12.1.0.2版本中引入的新功能,是操作系统内核模块,主要的目的是为了简化Oracle的配置、提供统一的磁盘名字和权限的管理、减少Oracle数据库对主机配置的依赖和提升数据库部署的易用性。
ASMFD被推荐的理由
1、由于不同系统平台的技术方案都不一样,需要DBA对不同操作系统的技术都非常熟悉,增加对DBA技术能力的要求和实施数据库的技术复杂性。比如不同操作系统的udev或多路径解决方案规则都不一样,因此在Oracle 12开始推出新的技术ASMFD,ASMFD目前兼容常见的操作系统,提供统一的磁盘管理方式,同时操作本身非常简单、不需要依赖系统工程师,DBA也可以直接解决ASM磁盘绑定问题
2、Oracle Linux 6开始已经默认不再包含ASMLIB包,且ASMLIB需要针对特定 Linux 内核版本编译专有驱动 (oracleasm)。导致每次升级Linux内核或操作系统版本都必须重新编译oracleasm驱动。
3、过滤非Oracle进程的IO操作,在默认情况下,用户只要有对磁盘的写权限,就可以对磁盘进行写操作,如通过dd命令向磁盘写入数据,此时必将破坏磁盘里面原有数据,如果磁盘用于ASM环境,将导致磁盘组异常无法正常mount或者磁盘组里面的数据文件损坏,导致数据库无法正常打开。ASMFD可实现只允许Oracle的进程通过Oracle的接口才能向AFD的磁盘写入数据,防止非Oracle的进程向ASM磁盘写入数据,破坏ASM磁盘组的数据库,提升ASM磁盘的安全性,提升数据库数据库的可靠性。
4、ASMFD与ASMLIB与不一样,ASMLIB会写磁盘头信息,但是ASMFD只对磁盘打个标签并不像ASMLIB那样写磁盘头对磁盘加上特定的格式,ASMFD与ASMLIB不兼容,如果有ASMLIB,那么在配置ASMFD时,需要先卸载ASMLIB。
ASMFD使用ASMCMD afd_label命令比如$ORACLE_HOME/bin/asmcmd afd_label DATA1 /dev/sdb --init来准备磁盘,绑定成功后在/dev/oracleafd/disks/下面会生成设备文件,这些设备文件都是AFD的标签名。直接执行ASMCMD afd_label可以验证哪些磁盘已经被标记可以被ASMFD所使用。
RAC两节点的情况下需要多少个IP
答案:最少7个IP
2个Private IP
每个节点一个,通常配置在另一个物理网卡或虚拟接口上,与Public网络隔离,确保内部通信的安全和低延迟。用于RAC节点之间的内部通信,比如Cache Fusion(内存融合)、心跳检测等。Private IP属于专用网络。这个网络不对外暴露,只用于集群内部的数据交换。
2个Public ip
每个节点一个,每个节点的物理网络接口绑定的IP地址,用于节点与外部网络通信比如客户端连接、应用服务器访问数据库等。每个节点都有一个Public IP,属于公共网络,通常绑定在物理网卡上,需要稳定的网络连接,因为如果Public IP不可达,节点可能被认为宕机。
2个Virtual IP(VIP)
每个节点一个,用于实现快速故障转移。当某个节点发生故障时,VIP会漂移到其他健康节点,客户端通过VIP连接可以快速重定向,减少应用的中断时间。VIP与Public IP不同,它不绑定到物理网卡,而是由集群软件管理,确保高可用性。
1个Single Client Access Name IP (Scan IP)
集群级别的IP,负责负载均衡,只在一个节点上,SCAN IP可以自动根据RAC负载把会话分到对应的节点,因为PMON进程可以定时把每个节点上的负载注册到scan listener监听器上。这个IP可以有多个但是最少需要有一个。