目录
[ZooKeeper 集群部署指南](#ZooKeeper 集群部署指南)
[1. 环境准备与规划](#1. 环境准备与规划)
[2. 软件安装与配置](#2. 软件安装与配置)
[3. 集群节点配置](#3. 集群节点配置)
[4. 启动集群与状态验证](#4. 启动集群与状态验证)
[Hadoop 高可用配置](#Hadoop 高可用配置)
[1. 高可用架构与原理](#1. 高可用架构与原理)
[2. 核心配置文件详解](#2. 核心配置文件详解)
[3. 启动 JournalNode 服务](#3. 启动 JournalNode 服务)
[4. 格式化与启动 HDFS 集群](#4. 格式化与启动 HDFS 集群)
[5. 验证 ZooKeeper 中的 HA 状态](#5. 验证 ZooKeeper 中的 HA 状态)
[6. 测试故障切换](#6. 测试故障切换)
[YARN 高可用配置](#YARN 高可用配置)
[1. 配置 mapred-site.xml](#1. 配置 mapred-site.xml)
[2. 配置 yarn-site.xml](#2. 配置 yarn-site.xml)
[3. 启动 YARN 服务](#3. 启动 YARN 服务)
[4. 测试故障切换](#4. 测试故障切换)
ZooKeeper 集群部署指南
**摘要:**本文详细介绍了 ZooKeeper 集群的部署流程,涵盖环境准备、软件安装、配置文件详解、集群启动与验证、以及高可用(HA)配置等核心步骤。通过分步操作和代码示例,帮助读者快速搭建一个稳定可靠的 ZooKeeper 集群。
1. 环境准备与规划
在部署 ZooKeeper 集群之前,需要完成以下准备工作:
**服务器规划:**建议至少准备 3 台或 5 台服务器(奇数台),以确保集群选举的多数原则。本文示例使用三台服务器:server2 (192.168.223.182), server3 (192.168.223.183), server4 (192.168.223.184)。
**系统用户:**为统一管理,在所有节点创建专用用户(如 hadoop)。
**共享目录(可选):**若需使用 NFS 共享配置文件或数据,可额外配置一台 NFS 服务器(如 server5, 192.168.223.185)。
**网络与防火墙:**确保集群节点间网络互通,并开放 ZooKeeper 所需端口(默认 2181 用于客户端,2888 用于 Leader-Follower 通信,3888 用于选举)。
**JDK 安装:**ZooKeeper 需要 Java 运行环境,请在所有节点安装相同版本的 JDK(如 OpenJDK 8 或 11)。
2. 软件安装与配置
2.1 下载与解压
在其中一个节点(如 server1)下载 ZooKeeper 安装包,并解压到共享目录或各节点本地。
cpp
在server2、3、4、5执行
[root@server5 ~]#  mount 192.168.223.181:/home/hadoop/ /home/hadoop/
选取server5作为备节点
cpp
[root@server5 ~]#  yum install -y nfs-utils
[root@server5 ~]# useradd hadoop
[root@server5 ~]# vi /etc/hosts
cpp
# 以 hadoop 用户操作
[root@server1 ~]# ls
anaconda-ks.cfg  apache-zookeeper-3.8.6-bin.tar.gz
[root@server1 ~]# mv apache-zookeeper-3.8.6-bin.tar.gz /home/hadoop/
[root@server1 ~]# su - hadoop
[hadoop@server1 ~]$ tar -zxf apache-zookeeper-3.8.6-bin.tar.gz -C /home/hadoop/
[hadoop@server1 ~]$ cd /home/hadoop/apache-zookeeper-3.8.6-bin/
2.2 配置文件详解
进入 conf 目录,复制样例配置文件并编辑 zoo.cfg。
bash
[hadoop@server1 ~]$ cd apache-zookeeper-3.8.6-bin/conf/
[hadoop@server1 conf]$ cp zoo_sample.cfg zoo.cfg
[hadoop@server1 conf]$ vim zoo.cfg
关键配置项如下:
cpp
# 基础配置
tickTime=2000
initLimit=10
syncLimit=5
dataDir=/tmp/zookeeper
clientPort=2181
集群服务器列表
server.1=192.168.223.182:2888:3888
server.2=192.168.223.183:2888:3888
server.3=192.168.223.184:2888:3888
3. 集群节点配置
3.1 创建数据目录与 myid 文件
在每个 ZooKeeper 节点上,创建数据目录并写入唯一的 myid 文件。
bash
# 在 server2 (对应 server.1) 上执行
[hadoop@server2 ~]$ mkdir -p /tmp/zookeeper
[hadoop@server2 ~]$ echo 1 > /tmp/zookeeper/myid
在 server3 (对应 server.2) 上执行
[hadoop@server3 ~]$ mkdir -p /tmp/zookeeper
[hadoop@server3 ~]$ echo 2 > /tmp/zookeeper/myid
在 server4 (对应 server.3) 上执行
[hadoop@server4 ~]$ mkdir -p /tmp/zookeeper
[hadoop@server4 ~]$ echo 3 > /tmp/zookeeper/myid
4. 启动集群与状态验证
4.1 启动 ZooKeeper 服务
在每台节点上启动 ZooKeeper 服务。
bash
# 在 server2 上启动
[hadoop@server2 ~]$ cd apache-zookeeper-3.8.6-bin/
[hadoop@server2 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh start
在 server3 上启动
[hadoop@server3 ~]$ cd apache-zookeeper-3.8.6-bin/
[hadoop@server3 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh start
在 server4 上启动
[hadoop@server4 ~]$ cd apache-zookeeper-3.8.6-bin/
[hadoop@server4 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh start
4.2 检查服务状态
启动后,检查各节点的角色(Leader 或 Follower)。
cs
# 检查 server2 状态
[hadoop@server2 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh status
Mode: follower
检查 server3 状态
[hadoop@server3 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh status
Mode: leader
检查 server4 状态
[hadoop@server4 apache-zookeeper-3.8.6-bin]$ bin/zkServer.sh status
Mode: follower
输出显示 server3 为 Leader,server2 和 server4 为 Follower,表明集群选举成功,运行正常。
Hadoop 高可用配置
在完成 ZooKeeper 集群部署后,我们可以基于 ZooKeeper 实现 Hadoop HDFS 的高可用(High Availability, HA)。HDFS HA 通过配置两个 NameNode(一个 Active,一个 Standby)来消除单点故障,确保 HDFS 服务在 NameNode 故障时能够自动切换,保证集群持续可用。
1. 高可用架构与原理
Hadoop HDFS 高可用架构的核心组件包括:
Active NameNode:处理所有客户端请求,管理文件系统元数据。
Standby NameNode:实时同步 Active NameNode 的元数据变更,随时准备接管。
JournalNode 集群:通常由 3 个或 5 个节点组成,用于存储 NameNode 的编辑日志(Edits Log),确保 Active 和 Standby 之间的元数据同步。
ZooKeeper 集群:用于协调故障检测和主备切换,通过 ZKFC(ZooKeeper Failover Controller)监控 NameNode 状态。
DataNode:同时向两个 NameNode 发送心跳和块报告。
当 Active NameNode 发生故障时,ZooKeeper 会触发故障转移流程,将 Standby NameNode 提升为新的 Active,整个过程对客户端透明。
2. 核心配置文件详解
在配置 HA 之前,需要修改 Hadoop 的核心配置文件。以下配置基于本文的服务器规划:
NameNode 节点:server1 (192.168.223.181) 作为 h1,server5 (192.168.223.185) 作为 h2。
JournalNode 节点:server2、server3、server4(与 ZooKeeper 节点复用)。
ZooKeeper 集群:server2:2181, server3:2181, server4:2181。
配置 core-site.xml
该文件定义文件系统默认的访问地址和 ZooKeeper 集群地址。
cpp
[hadoop@server1 hadoop]$ vim core-site.xml
<configuration>
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://masters</value>
    </property>
    <property>
        <name>ha.zookeeper.quorum</name>
        <value>192.168.223.182:2181,192.168.223.183:2181,192.168.223.184:2181</value>
    </property>
</configuration>
2. 配置 hdfs-site.xml
这是 HA 配置的核心文件,需要详细设置 NameService、NameNode RPC/HTTP 地址、JournalNode 地址等。
cpp
[hadoop@server1 hadoop]$ vim hdfs-site.xml
<configuration>
    <property>
        <name>dfs.replication</name>
        <value>3</value>
    </property>
<property>
<name>dfs.nameservices</name>
<value>masters</value>
</property>

<property>
<name>dfs.ha.namenodes.masters</name>
<value>h1,h2</value>
</property>

<property>
<name>dfs.namenode.rpc-address.masters.h1</name>
<value>192.168.223.181:9000</value>
</property>

<property>
<name>dfs.namenode.http-address.masters.h1</name>
<value>192.168.223.181:9870</value>
</property>

<property>
<name>dfs.namenode.rpc-address.masters.h2</name>
<value>192.168.223.185:9000</value>
</property>

<property>
<name>dfs.namenode.http-address.masters.h2</name>
<value>192.168.223.185:9870</value>
</property>

<property>
<name>dfs.namenode.shared.edits.dir</name>
<value>qjournal://192.168.223.182:8485;192.168.223.183:8485;192.168.223.184:8485/masters</value>
</property>
···
将上述配置文件同步到所有 Hadoop 节点(包括 NameNode 和 DataNode)。
3. 启动 JournalNode 服务
JournalNode 用于存储 NameNode 的编辑日志,必须在首次启动 HDFS 前先启动。在三个 JournalNode 节点(server2、server3、server4)上依次执行:
cpp
[hadoop@server4 ~]$ cd hadoop
[hadoop@server4 hadoop]$ bin/hdfs --daemon start journalnode
[hadoop@server4 hadoop]$ jps
3923 QuorumPeerMain  # ZooKeeper 进程
4195 Jps
4152 JournalNode     # 成功启动的 JournalNode 进程
同样在 server2 和 server3 上启动 JournalNode。使用 jps 命令确认 JournalNode 进程已运行。
4. 格式化与启动 HDFS 集群
步骤 1:格式化 NameNode(仅在 server1 上执行)
cpp
[hadoop@server1 hadoop]$ bin/hdfs namenode -format格式化成功后,会在 /tmp/hadoop-hadoop/ 目录下生成 NameNode 的元数据。
步骤 2:将元数据拷贝到备节点(server5)
cpp
[hadoop@server1 hadoop]$ scp -r /tmp/hadoop-hadoop server5:/tmp步骤 3:在 ZooKeeper 中格式化 HA 状态(仅在 server1 上执行)
bash
[hadoop@server1 hadoop]$ bin/hdfs zkfc -formatZK此命令会在 ZooKeeper 中创建 /hadoop-ha 目录,用于存储故障转移所需的状态信息。
步骤 4:启动 HDFS 集群(在 server1 上执行)
bash
[hadoop@server1 hadoop]$ sbin/start-dfs.sh启动后,检查两个 NameNode 的进程:
cpp
# 在 server1 上查看
[hadoop@server1 hadoop]$ jps
4609 NameNode                   # Active NameNode
5026 Jps
4943 DFSZKFailoverController    # ZKFC 进程
在 server5 上查看
[hadoop@server5 tmp]$ jps
1671 Jps
1528 NameNode                   # Standby NameNode
1598 DFSZKFailoverController    # ZKFC 进程
**验证集群状态:**此时通过浏览器访问两个 NameNode 的 Web 界面:
访问
http://192.168.223.181:9870(server1),应显示 Active 状态。访问
http://192.168.223.185:9870(server5),应显示 Standby 状态。这表示 HA 集群已成功启动,一个节点为 Active,另一个为 Standby。
5. 验证 ZooKeeper 中的 HA 状态
可以通过 ZooKeeper 客户端查看 HA 相关的 ZNode,确认 Active NameNode 信息已注册。
cpp
[hadoop@server2 apache-zookeeper-3.8.6-bin]$ bin/zkCli.sh
Connecting to localhost:2181
[zk: localhost:2181(CONNECTED) 0] ls /
[hadoop-ha, zookeeper]                     # 存在 hadoop-ha 节点
[zk: localhost:2181(CONNECTED) 1] ls /hadoop-ha
[masters]                                   # 对应 nameservice
[zk: localhost:2181(CONNECTED) 2] get /hadoop-ha/masters/ActiveBreadCrumb
mastersh1server1 �F(�>                     # 显示当前 Active 为 h1 (server1)
6. 测试故障切换
下面模拟 Active NameNode(server1)故障,验证集群能否自动切换到 Standby(server5)。
步骤 1:查看当前进程并杀死 Active NameNode
cpp
# 在 server1 上查看进程
[hadoop@server1 hadoop]$ jps
5440 Jps
4609 NameNode                   # Active NameNode 进程
4943 DFSZKFailoverController    # ZKFC 进程
模拟故障,杀死 Active NameNode 进程
[hadoop@server1 hadoop]$ kill -9 4609
再次查看,NameNode 进程已消失
[hadoop@server1 hadoop]$ jps
5475 Jps
4943 DFSZKFailoverController    # ZKFC 仍在运行
步骤 2:观察备节点状态变化
cpp
# 在 server5(原 Standby)上查看进程
[hadoop@server5 tmp]$ jps
5130 Jps
5068 DFSZKFailoverController
4974 NameNode                   # 此时 NameNode 应已变为 Active
步骤 3:通过 Web 界面验证
刷新浏览器:
http://192.168.223.181:9870(server1)将无法访问或显示错误。
http://192.168.223.185:9870(server5)现在应显示为 Active 状态。
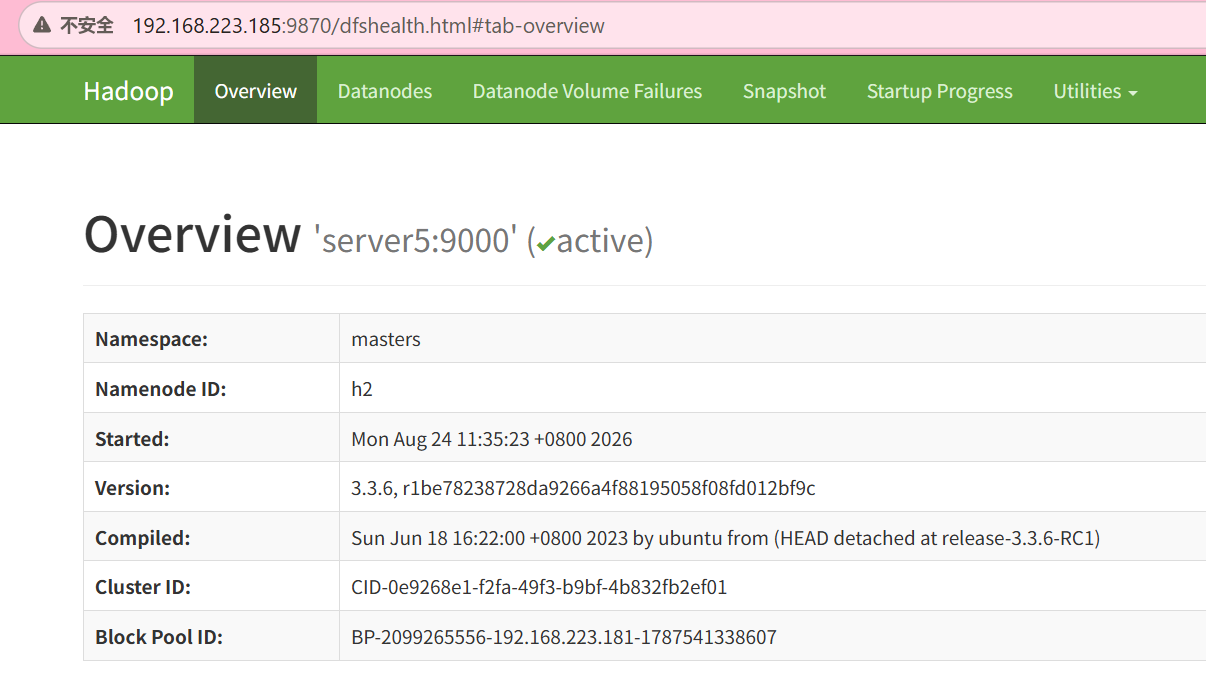
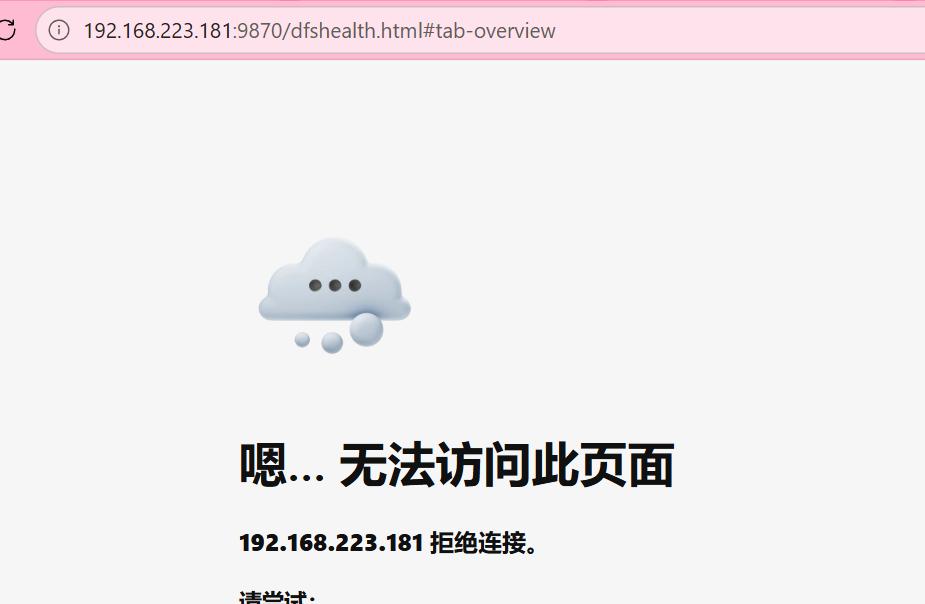
步骤 4:恢复原 Active 节点
在 server1 上重新启动 NameNode 进程,它将自动以 Standby 身份加入集群:
bash
[hadoop@server1 hadoop]$ bin/hdfs --daemon start namenode启动后,server1 的 NameNode 将处于 Standby 状态,server5 保持 Active。此时集群恢复为正常的一主一备模式。
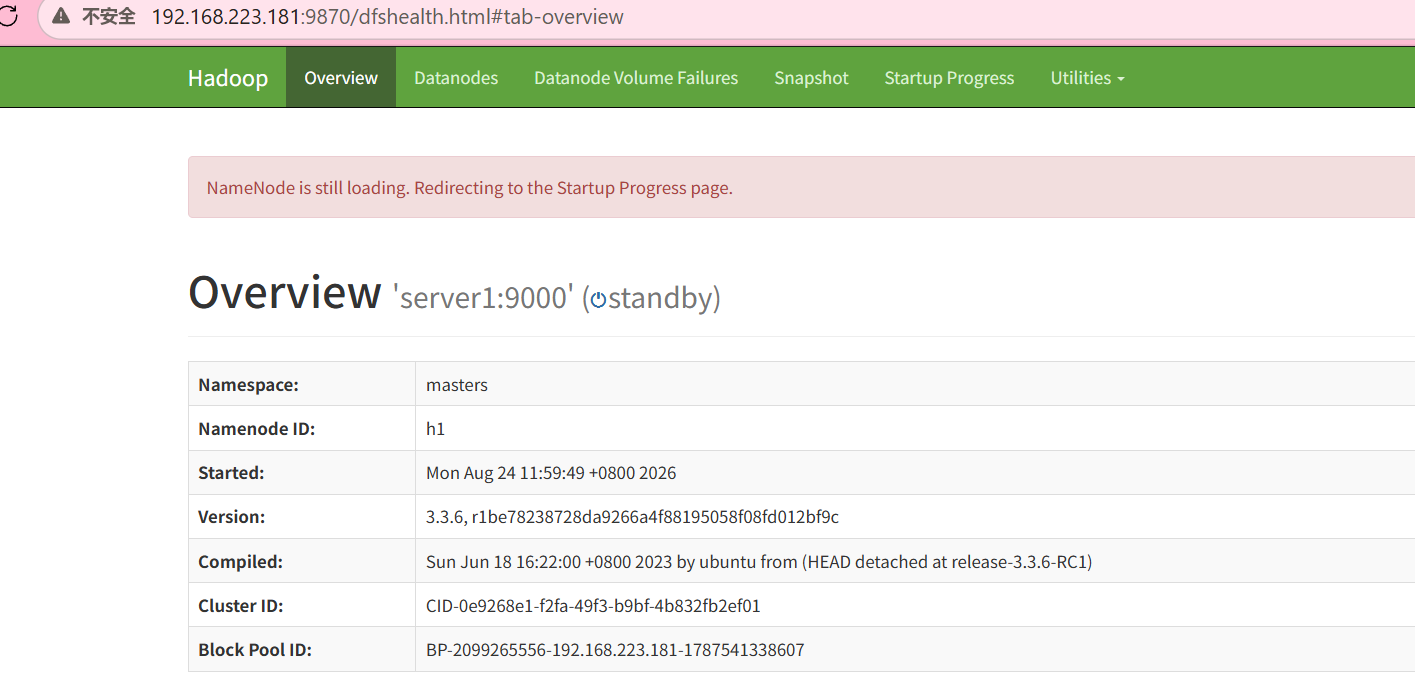
至此,一个具备高可用能力的 Hadoop 集群已部署完成,能够有效应对 NameNode 单点故障,保障大数据服务的持续稳定运行。
YARN 高可用配置
在完成 HDFS 高可用配置后,接下来配置 YARN ResourceManager 的高可用(HA),以进一步提升 Hadoop 集群的容错能力。
1. 配置 mapred-site.xml
首先,在 server1 上编辑 mapred-site.xml 文件,指定 MapReduce 框架为 YARN:
xml
[hadoop@server1 hadoop]$ vim mapred-site.xml
<configuration>
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
    <property>
        <name>mapreduce.application.classpath</name>
        <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>
    </property>
</configuration>
2. 配置 yarn-site.xml
接着,编辑 yarn-site.xml 文件,添加 YARN ResourceManager HA 相关配置:
xml
[hadoop@server1 hadoop]$ vim yarn-site.xml
# 添加如下内容:
<property>
    <name>yarn.resourcemanager.ha.enabled</name>
    <value>true</value>
</property>
<property>
<name>yarn.resourcemanager.cluster-id</name>
<value>RM_CLUSTER</value>
</property>
<property>
<name>yarn.resourcemanager.ha.rm-ids</name>
<value>rm1,rm2</value>
</property>
<property>
<name>yarn.resourcemanager.hostname.rm1</name>
<value>server1</value>
</property>
<property>
<name>yarn.resourcemanager.hostname.rm2</name>
<value>server5</value>
</property>
<property>
<name>yarn.resourcemanager.recovery.enabled</name>
<value>true</value>
</property>
<property>
<name>yarn.resourcemanager.store.class</name>
<value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
</property>
<property>
<name>yarn.resourcemanager.zk-address</name>
<value>192.168.223.182:2181,192.168.223.183:2181,192.168.223.184:2181</value>
</property>
注意: 请确保
yarn.resourcemanager.zk-address中的 ZooKeeper 地址正确无误。
3. 启动 YARN 服务
配置完成后,在 server1 上启动 YARN 服务:
cpp
[hadoop@server1 hadoop]$ sbin/start-yarn.sh
Starting resourcemanagers on [ server1 server5 ]
Starting nodemanagers
[hadoop@server1 hadoop]$
启动后,检查各节点进程状态:
cpp
# server1 节点
[hadoop@server1 hadoop]$ jps
5537 NameNode
7298 Jps
7163 ResourceManager  # Active ResourceManager
4943 DFSZKFailoverController
server5 节点
[hadoop@server5 tmp]$ jps
6242 Jps
5068 DFSZKFailoverController
6189 ResourceManager  # Standby ResourceManager
4974 NameNode
server2 节点
[hadoop@server2 ~]$ jps
3777 NodeManager
3876 Jps
1310 QuorumPeerMain
2975 DataNode
3055 JournalNode
server3 节点
[hadoop@server3 ~]$ jps
5968 Jps
5026 DataNode
5106 JournalNode
5828 NodeManager
1307 QuorumPeerMain
server4 节点
[hadoop@server4 ~]$ jps
3923 QuorumPeerMain
5748 NodeManager
5846 Jps
4986 DataNode
5066 JournalNode
通过浏览器访问 YARN Web 界面,可以看到 server1 为 Active 状态,server5 为 Standby 状态,三个 NodeManager 均正常运行。
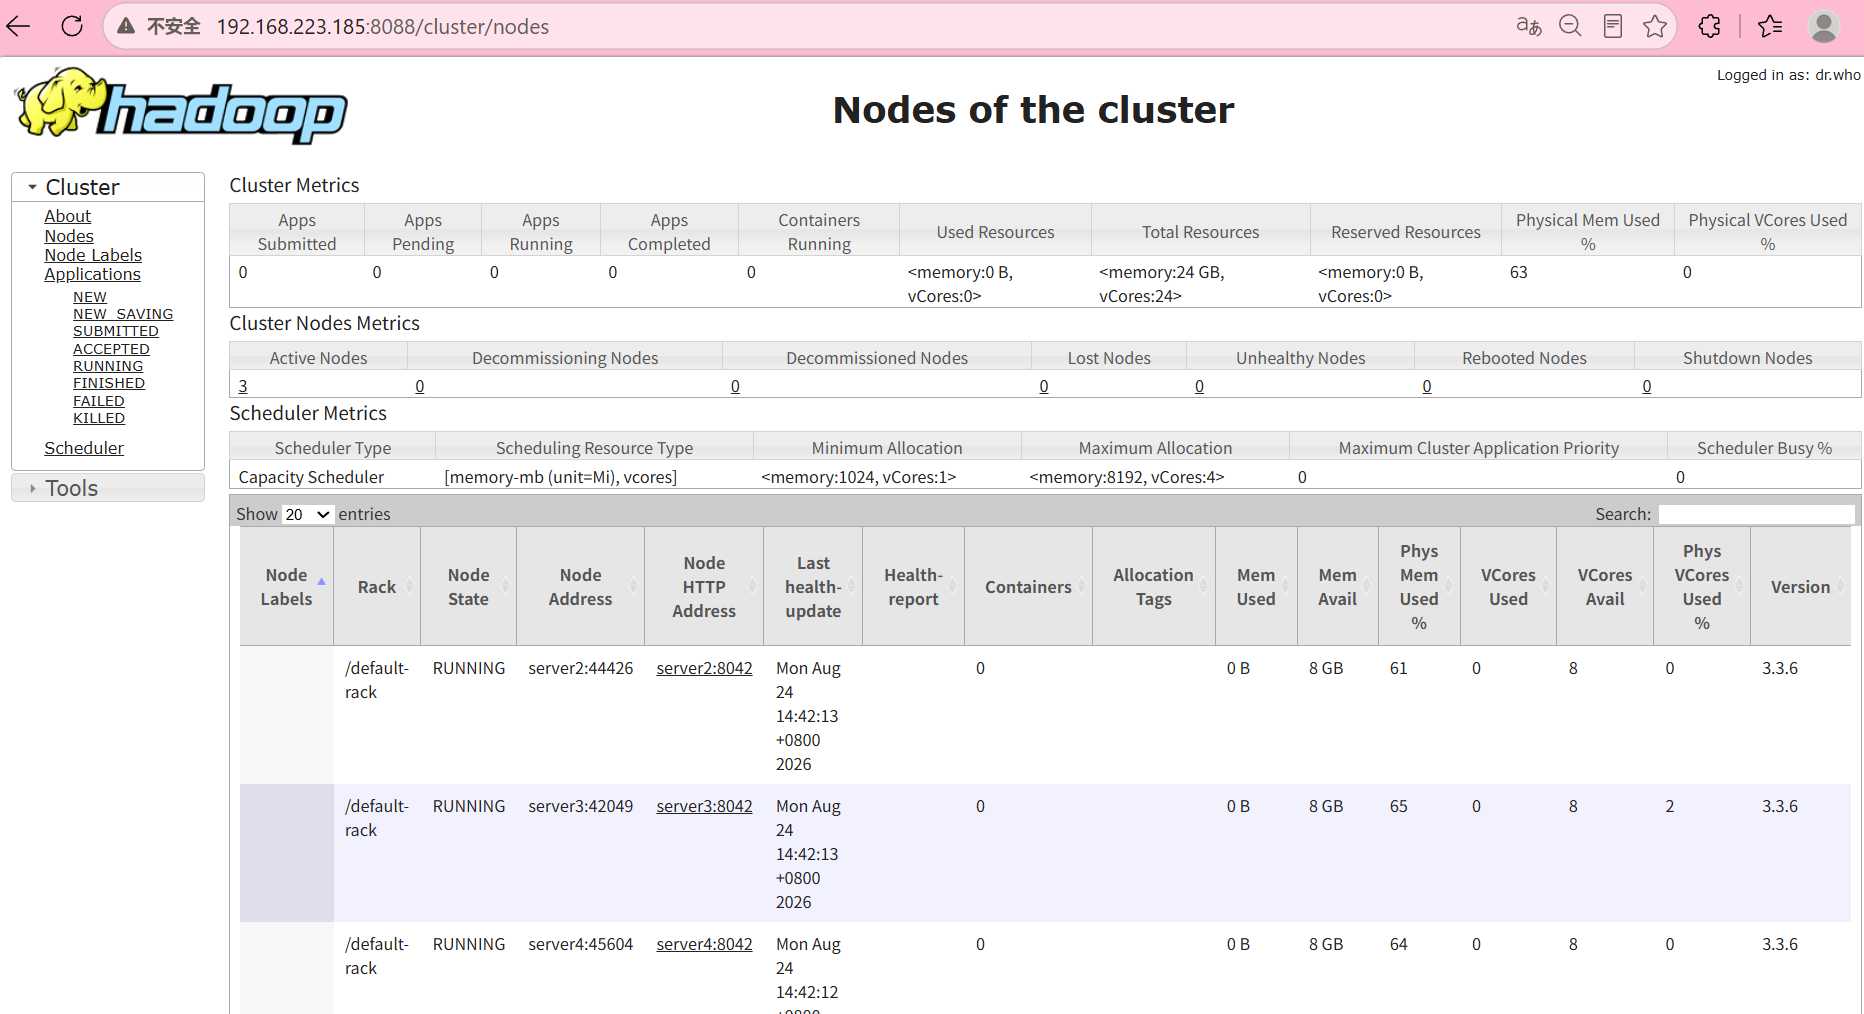
4. 测试故障切换
下面模拟 Active ResourceManager(server1)故障,验证集群能否自动切换到 Standby(server5)。
步骤 1:查看当前进程并杀死 Active ResourceManager
cpp
# 在 server1 上查看进程
[hadoop@server1 hadoop]$ jps
5537 NameNode
7298 Jps
7163 ResourceManager  # Active ResourceManager 进程
4943 DFSZKFailoverController
模拟故障,杀死 Active ResourceManager 进程
[hadoop@server1 hadoop]$ kill -9 7163
步骤 2:观察备节点状态变化
进程被终止后,server5 会自动接管集群,变为 Active ResourceManager。
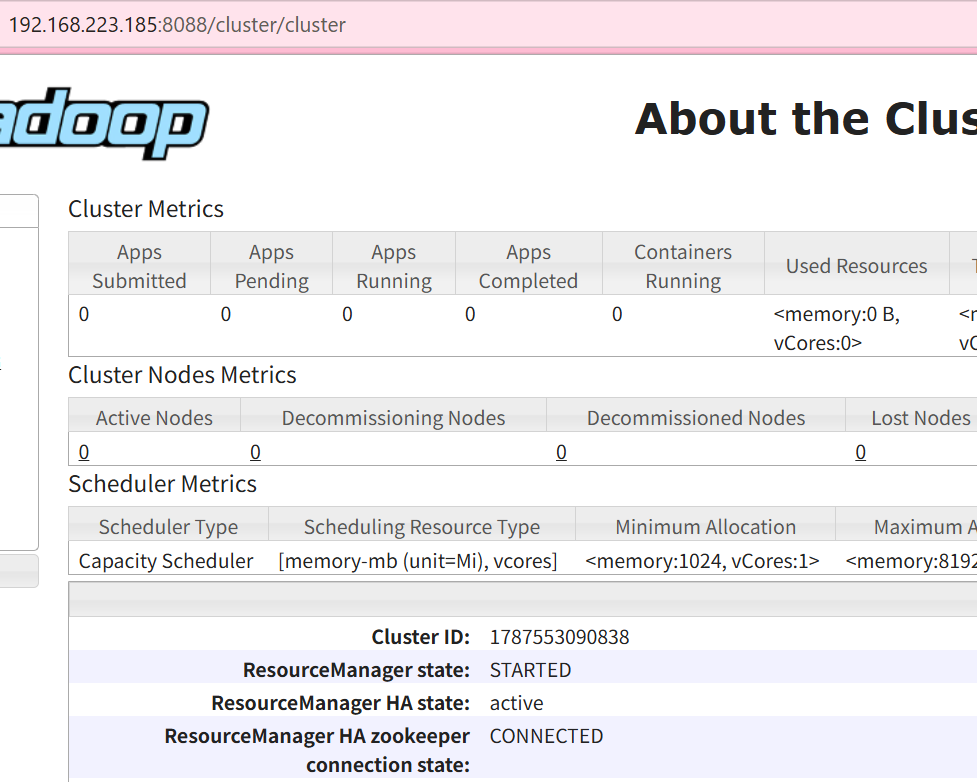
步骤 3:恢复原 Active 节点
在 server1 上重新启动 ResourceManager 服务:
bash
[hadoop@server1 hadoop]$ bin/yarn --daemon start resourcemanager重新启动后,server1 的 ResourceManager 将处于 Standby 状态,server5 保持 Active。此时集群恢复为正常的一主一备模式。
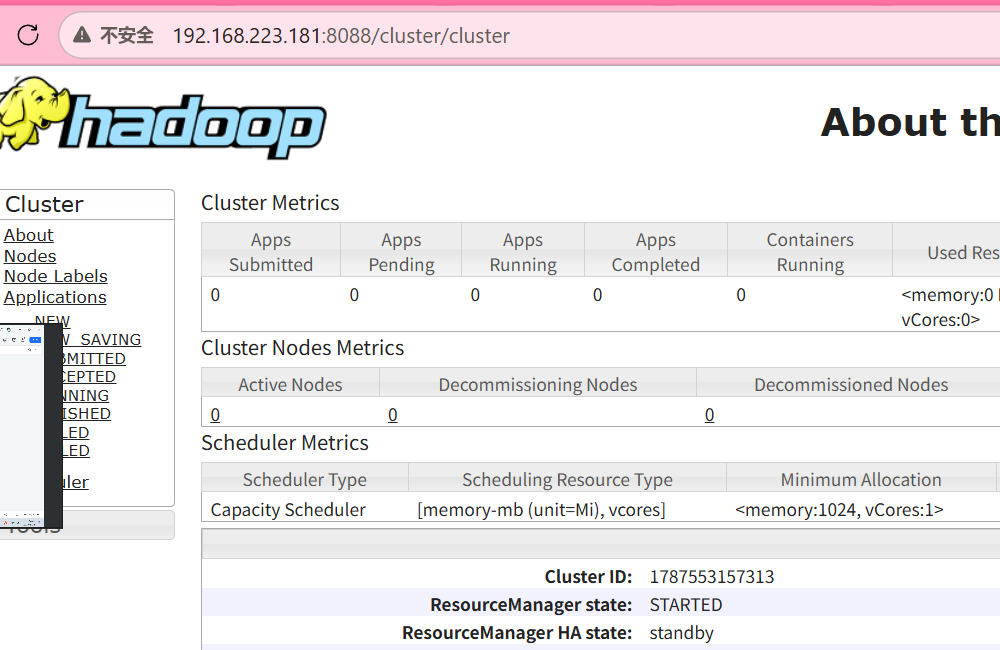
通过 zookeeper 客户端查看 YARN‑HA
查看 ZK 根目录下
/yarn‑leader‑election文件夹,这个目录专门用于 YARN‑HA 两个 ResourceManager 选主 。返回结果[RM_CLUSTER],RM_CLUSTER读取
RM_CLUSTER/ActiveBreadCrumb节点内容: 输出RM_CLUSTERrm2,含义:当前 YARN‑HA 的 Active 主 ResourceManager 是 rm2。rm2 对应server5
cpp
[hadoop@server2 apache-zookeeper-3.8.6-bin]$ bin/zkCli.sh
/home/hadoop/jdk/bin/java
Connecting to localhost:2181

WATCHER::

WatchedEvent state:SyncConnected type:None path:null

[zk: localhost:2181(CONNECTED) 0] ls /yarn-leader-election
>
[RM_CLUSTER]
[zk: localhost:2181(CONNECTED) 1] get /yarn-leader-election/RM_CLUSTER/ActiveBreadCrumb
>


RM_CLUSTERrm2
至此,YARN ResourceManager 的高可用配置与验证完成。整个 Hadoop 集群(HDFS + YARN)均已实现高可用,能够有效应对 NameNode 和 ResourceManager 的单点故障,保障大数据服务的持续稳定运行。