摘要:营销 Agent 的稳定性问题,往往不是模型不够强,而是事实、受众、品牌、素材和结果被塞进一段不可维护的 Prompt。本文从数据边界、检索、版本、岗位隔离和反馈污染五个角度,给出一套可落地的上下文架构。
一段 Prompt 写到五千字以后,最先得到的通常不是品牌一致性,而是维护焦虑。
产品资料复制一份,语气要求复制一份,历史爆文再塞三篇;做 CSDN 时补技术关键词,做头条时又要求"说人话"。同一个会话看似知道得很多,实际混合了不同可信度、不同更新时间和不同渠道作用域的信息。
营销 Agent 真正需要的不是更长的 system prompt,而是一套可查询、可版本化、可追责的上下文系统。
1. 上下文先按责任拆层
我会把数据拆成五层:
ts
type MarketingContext = {
  facts: ApprovedClaim[]
  audience: AudienceJob[]
  voice: VoiceRule[]
  assets: AssetRecord[]
  results: Observation[]
}
它们的更新频率、检索方式和失败策略完全不同。
facts必须带来源、版本和有效期;冲突时拒绝自动发布。audience保存用户任务、顾虑与判断标准,不只是一串人口属性。voice保存长期观点、禁用表达和正反例。assets保存截图、案例、FAQ、版权和适用场景。results保存统一观察窗口下的数据与假设,不能直接保存"结论"。
OpenAI 8 月 25 日面向小企业的营销活动,也把"活动上下文 + 表现 + 下一次建议"放到了一起。这不是某个产品的专属技巧,而是持续营销系统的基本闭环。
2. 不同层不要用同一种检索策略
事实层适合精确过滤:状态为 approved、更新时间有效、作用域匹配。品牌正反例和历史内容可以语义检索,但要限制来源集合。表现记录则先按平台和观察窗口筛选,再做聚合。
一个简单的检索顺序可以是:
text
任务解析
  → 确定受众与平台
  → 加载有效事实
  → 检索品牌正反例
  → 选择可用素材
  → 读取同平台、同窗口的历史观察
  → 交给岗位 Agent
如果一上来就把整个知识库做向量召回,过期价格和旧截图一样可能被"相似"地找回来。
3. 版本号解决的不是回滚,而是解释
营销内容经常遇到一个问题:昨天的说法今天为什么不能用了?
因此每次交付最好记录一个 context_snapshot:使用了哪版产品事实、哪版品牌规则、哪些素材和哪组历史观察。文章出现问题时,团队能判断是事实变了、规则错了,还是生成环节偏了。
这比把所有责任归给"模型幻觉"更有工程价值。
4. 共享业务底座,隔离平台岗位
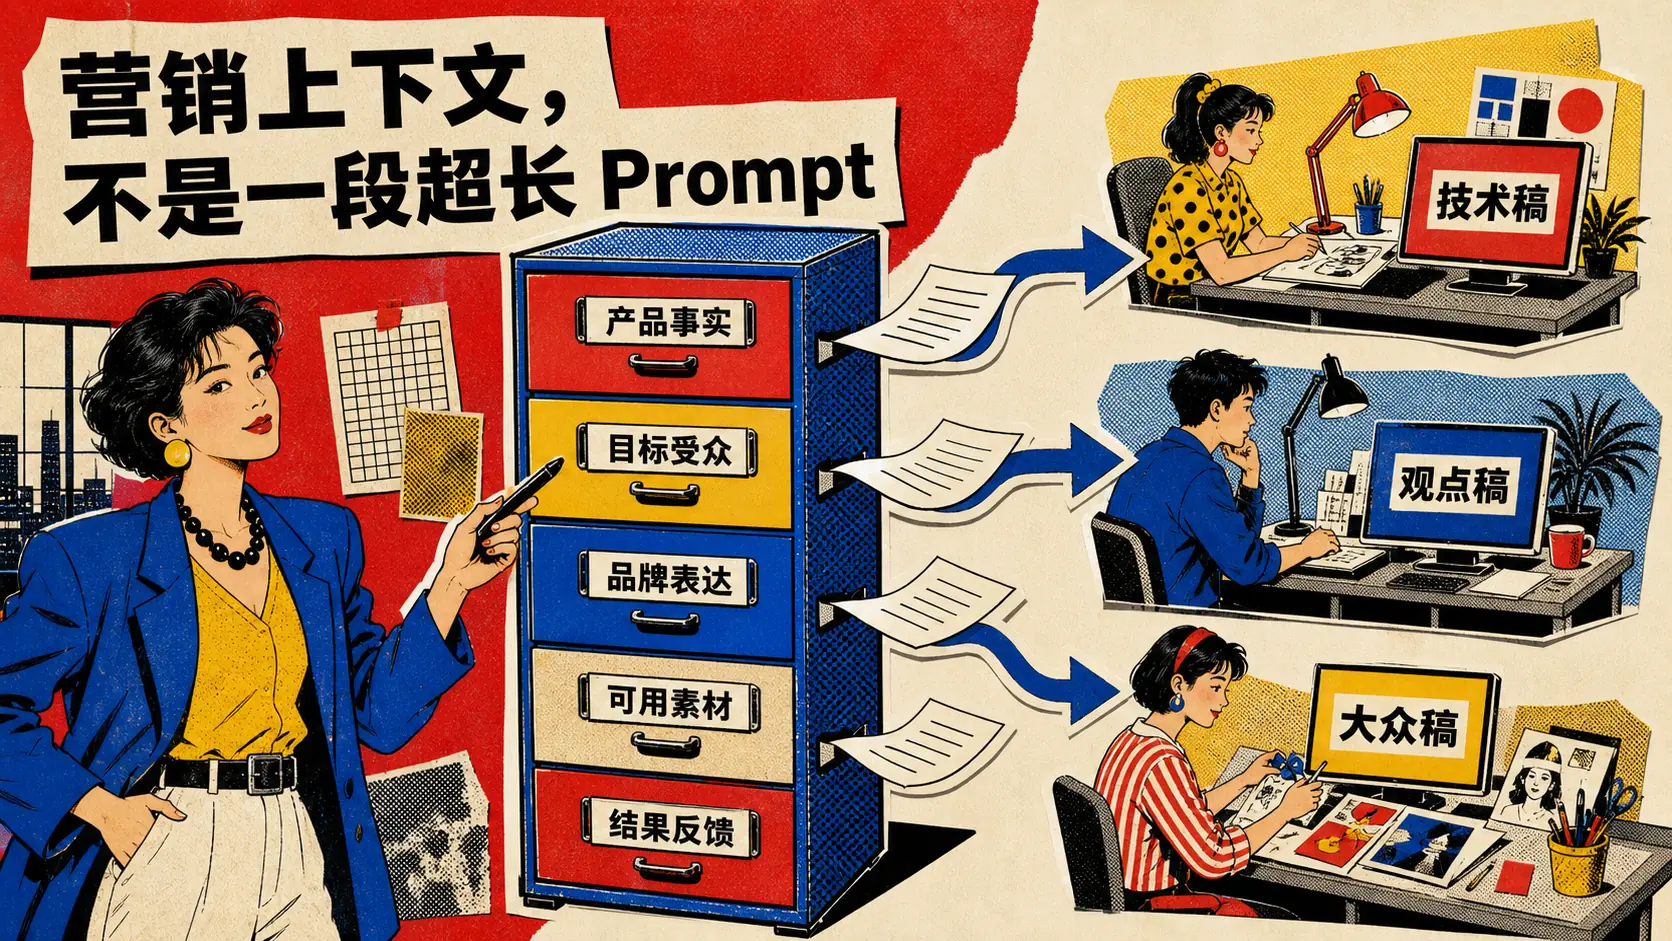
共享上下文不等于共享一份成稿。合理的边界是:
text
事实 / 受众 / 品牌 / 素材 / 结果
          ↓
   岗位 Agent 路由
   ├─ 技术搜索型内容
   ├─ 开发者观点型内容
   └─ 大众场景型内容
每个岗位只持有自己需要的渠道规则和发布工具。CSDN 的标签候选、掘金的分类、头条的标题长度与作品声明,都是执行层知识,不该污染共享品牌层。
我们在 Tipkay 里采用的也是这条路线:不同 AI 员工共享用户整理的品牌、产品、受众和素材,各自配置岗位流程、Skill 与 MCP;需要时可以复制一个现成员工,形成自己的版本。这样升级某个岗位时,不必把所有渠道一起重新训练。
产品关系在这里需要说清楚:这套架构并不保证涨粉。它解决的是上下文复用、平台隔离和长期维护成本。最后的公开提交仍应由人确认,本地素材与平台登录态也没有必要离开客户端。
5. 最危险的不是遗忘,而是错误反馈
把结果接回系统时要格外克制。
某篇文章阅读高,可能来自选题、时间、标题、封面、账号分发甚至偶然事件。正确做法是记录"观察 + 假设 + 待验证动作",而不是马上修改全局品牌规则。
json
{
  "observation": "具体问题型标题在本轮阅读更高",
  "confidence": "low",
  "next_test": "保持题材接近,只改变标题具体度",
  "do_not_promote_to_rule": true
}
反馈闭环如果没有置信度和观察窗口,只会把一次噪声升级成长期偏见。
最小实现,不必先上平台
今天就可以从五个文件开始:facts.md、audience.md、voice.md、assets.csv、results.csv。先建立版本和字段,再考虑数据库、向量检索或自动化编排。
判断系统是否变好,也不要只数生成量。更值得看的是:事实错误有没有减少、跨平台返工是否下降、同一品牌的观点是否稳定、一次复盘能否影响下一轮。
Prompt 是一次请求的说明书;营销上下文应该是团队可持续维护的业务资产。两者不是一回事。
参考: