大家好,我是小江。很多做国潮甜品设计的同行问我:"AI生成的图虽然好看,但每次动作都不一样,怎么用来做系列海报?怎么保证IP形象不崩坏?"
今天这篇教程,我不讲虚的,直接上代码。我们要解决的核心痛点是:如何利用Python脚本调用SDXL模型,配合ControlNet OpenPose,批量生成指定动作的"英歌舞翻糖吐司"产品图。
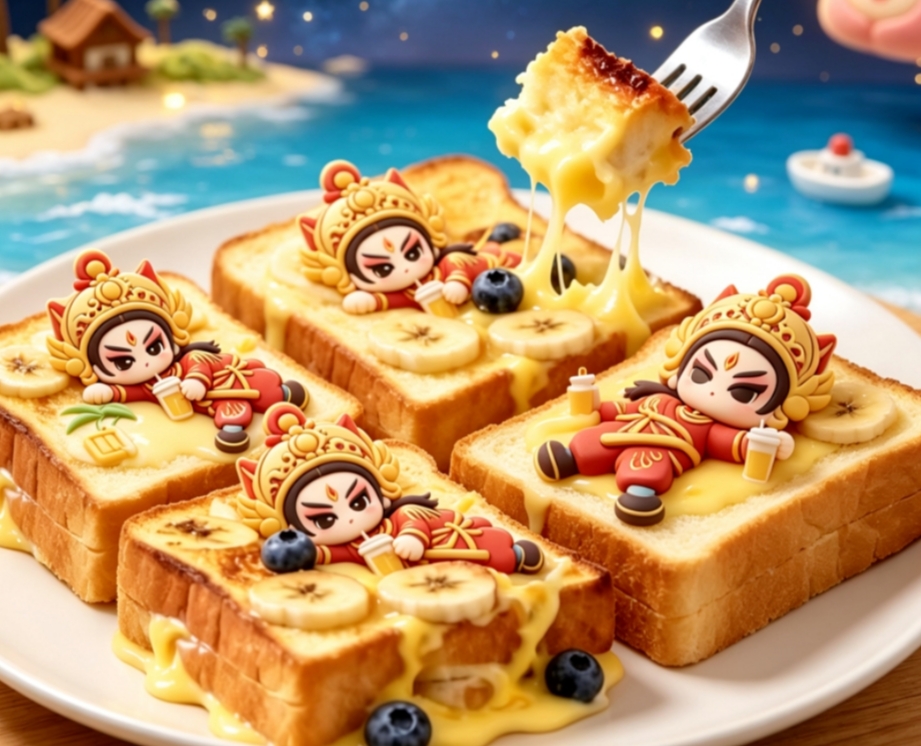
大家看这张图,英歌舞小人的姿势是固定的(手持英歌槌),翻糖的质感与吐司的融合度极高。这不仅仅是一张图,这是一套可以复用的视觉解决方案。
为了实现批量且稳定的输出,我编写了一个Python脚本,利用 stable-diffusion-webui-api 或 ComfyUI API 进行调用。
import requests
import json
import base64
定义API地址 (以ComfyUI为例)
API_URL = "http://127.0.0.1:8188/prompt"
def generate_yingge_toast(pose_image_path, prompt_text):
"""
生成英歌舞吐司的核心函数
:param pose_image_path: 预设好的英歌舞骨架图路径
:param prompt_text: 提示词
"""
1. 加载ControlNet配置
这里我们锁定OpenPose骨架,确保每次生成的英歌舞小人动作一致
controlnet_config = {
"class_type": "ControlNetApply",
"inputs": {
"image": pose_image_path,
"strength": 0.8, # 控制骨架影响的权重
"start_percent": 0.0,
"end_percent": 1.0
}
}
2. 构建Prompt payload
payload = {
"prompt": {
"3": { # KSampler节点
"inputs": {
"seed": 123456789, # 固定种子或随机
"steps": 30,
"cfg": 7.5,
"sampler_name": "euler",
"positive": "6", 0, # 连接正向提示词
"negative": "7", 0 # 连接反向提示词
}
},
"6": { # CLIPTextEncode (正向)
"inputs": {
"text": prompt_text,
"clip": "4", 0
}
},
... 其他节点配置 ...
}
}
3. 发送请求并保存图片
response = requests.post(API_URL, json=payload)
if response.status_code == 200:
print("生成成功!正在保存...")
save_image_logic...
else:
print(f"生成失败: {response.text}")
执行生成
target_prompt = "(masterpiece, best quality), chaoshan yingge dance character, fondant art style, lying on toast bread, melting cheese, blueberry garnish, cinematic lighting, food photography"
generate_yingge_toast("pose_yingge_01.png", target_prompt)