InfluxDB时序数据库优化
什么是谓词下推
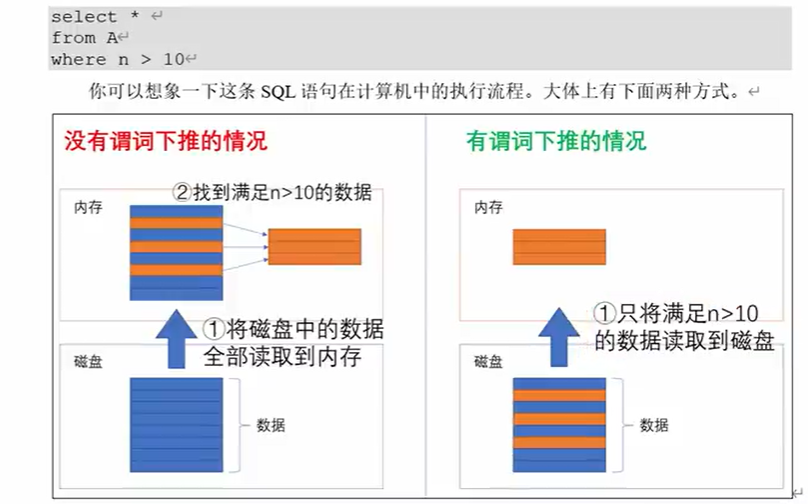
谓词就是过滤条件。下推就是让查询条件在靠近数据源的位置进行查询。如上图,在数据从磁盘读取到内存中时,就过滤好n>10的数据,这样就是谓词下推。节省了内存。想让谓词下推生效,应该写出符合influxdb要求的语句,才能出现谓词下推。
每个数据库都有自己的谓词下推的规则。我们在书写sql脚本时,遵循了各个数据库的规范和要求,就会自动触发该数据的谓词下推机制。
InfluxDB优化
- 合理使用谓词下推,例如: 在查询中使用开窗操作时,window()前面一定紧跟filter条件,不要跟map()等函数。这样会破坏influxdb的谓词下推。
- 避免将窗口宽度设置过小
- 避免使用"沉重"功能:这些功能耗费资源过多,尽量避免使用。包括如下:
xml
map()
reduce()
join()
union()
pivot()- 尽量使用set()而不是map()
- 平衡数据的时间范围和数据精度:
想要保证查询性能良好,应该平衡好查询的时间范围和数据精度。如果有个measurement每秒入库一条数据,一次请求6个月的数据,那么一个序列就包含千万级别数据。如果序列再多一些,可能达到十亿级别的数据。Flux必须将这些数据加载到内存中,返回给用户。所以,一方面要做好谓词下推,减少对内存的使用。另外如果必须查询长时间范围的数据,应该创建一个定时任务对数据进行降采样,然后将查询目标从原始数据改为降采样数据。
InfluxDB2.x与InfluxDB3.x比较
底层存储引擎
InfluxDB 2.x
使用 TSM (Time-Structured Merge Tree) 存储引擎,针对时间序列数据优化,但受限于传统行式存储模式,压缩率和查询效率在大数据场景下存在瓶颈。
InfluxDB 3.x
基于 Apache Arrow 和 Parquet 的列式存储引擎(IOx 引擎),利用列式存储的高压缩率和向量化计算,大幅提升查询性能(尤其是聚合分析),并降低存储成本。
查询语言
InfluxDB 2.x
支持 InfluxQL(类 SQL 语法)和 Flux(功能强大但学习成本高)。
InfluxDB 3.x
全面支持 SQL(通过 Apache Arrow Flight SQL),兼容主流 BI 工具(如 Tableau、Grafana)。
保留对 InfluxQL 的兼容性,但不再支持 Flux。
通过列式存储优化复杂查询(如多维度聚合、时间窗口分析)。
性能对比
写入性能: 3.x 的列式存储引擎在高吞吐场景下更稳定,支持实时写入与批量写入。
查询性能: 3.x 的向量化执行引擎对聚合查询(如 GROUP BY、JOIN)快 10 倍以上。
压缩率: 3.x 的 Parquet 格式压缩率更高,存储成本降低 50%~80%。
关键功能变更
弃用 TSM 引擎: 3.x 不再支持 TSM,需迁移数据到新引擎。
数据保留策略: 3.x 支持动态分区管理和生命周期策略(如按时间、标签自动清理)。
实时分析: 3.x 支持流式数据的实时聚合与物化视图。
"桶"概念总结
InfluxDB中,有桶的概念。在minio中,也有桶的概念。那么到底什么是桶呢?我们在什么场景下可以设计桶呢?
在软件设计中,"桶"(Bucket)这一概念被广泛用于逻辑隔离和管理数据的场景,其核心目的是通过分而治之的策略解决数据存储、访问、生命周期管理的复杂性。InfluxDB和MinIO都采用"桶"的概念,是因为它们都面临类似的数据管理需求,但具体实现和侧重点不同。以下从设计哲学、场景应用和实际案例角度详细分析:
为什么都用"桶"?------设计哲学
"桶"是一种逻辑容器,其本质是对数据的抽象分组,目的是:
- 隔离性:防止不同业务、用户或数据类型之间的干扰(例如A部门的数据不影响B部门)。
- 策略管理:为不同分组的数据定义独立规则(如保留时间、权限、加密方式)。
- 扩展性:通过分桶分散数据压力,提升系统的横向扩展能力。
这一设计模式类似于:
文件系统的文件夹: 按目录分类管理文件。
数据库的分库分表: 通过分片提升性能和隔离性。
云计算中的多租户隔离: 为不同租户分配独立资源。
何时需要设计"桶"?------典型场景
在程序中引入"桶"的概念,通常适用于以下场景:
1. 多租户隔离
场景:一个SaaS平台需要为不同客户(租户)存储独立数据,避免数据泄露或竞争。
实现:为每个租户分配独立桶(如tenant_A_bucket, tenant_B_bucket)。
优势:权限控制简单(桶级ACL),数据物理/逻辑隔离,计费按桶统计。
2. 数据分类与生命周期管理
场景:一个监控系统需要存储不同级别的日志(如debug_logs, error_logs),并定义不同的保留策略。
实现:按日志类型分桶,为error_logs桶设置30天保留,debug_logs桶仅保留7天。
优势:避免手动清理数据,降低存储成本。
3. 性能优化
场景:一个IoT平台需要高频写入海量设备数据,同时支持按设备类型快速查询。
实现:按设备类型分桶(如sensor_A_bucket, camera_B_bucket),结合时间分区。
优势:减少单桶数据量,提升查询效率;桶内数据按时间分片,优化写入吞吐。
4. 安全与合规
场景:金融数据需要按安全等级存储,如公开数据、用户隐私数据、审计日志。
实现:分桶存储(public_data, encrypted_pii, audit_logs),为每个桶配置独立加密策略和访问权限。
优势:满足合规要求(如GDPR),限制敏感数据的访问范围。
5. 跨环境或版本管理
场景:开发、测试、生产环境需要隔离数据,或支持数据版本回滚。
实现:按环境分桶(dev_bucket, prod_bucket),或启用MinIO的桶版本控制。
优势:避免测试污染生产数据,支持历史版本恢复。
实际案例对比
案例1:时序数据监控(InfluxDB桶)
需求:监控1000台服务器的CPU/内存指标,按地域(北京、上海)存储,保留策略不同。
设计:
创建两个桶:beijing_metrics(保留30天)、shanghai_metrics(保留7天)。
写入数据时,根据服务器IP自动路由到对应桶。
查询时直接指定桶,避免全量扫描。
优势:按地域隔离数据,降低单桶数据量;保留策略差异化,节省存储成本。
案例2:用户上传文件管理(MinIO桶)
需求:一个社交平台需要存储用户头像、视频、聊天附件,并为不同文件类型设置访问权限。
设计:
创建三个桶:avatars(公开读)、videos(私有访问+CDN加速)、attachments(加密存储+短期保留)。
通过MinIO的预设策略(Policy)控制每个桶的读写权限。
为videos桶配置生命周期规则,自动删除30天未访问的文件。
优势:按文件类型隔离,简化权限管理;结合生命周期规则自动化清理。
何时不需要"桶"?
"桶"虽好,但并非万能。以下场景可能不需要分桶:
数据规模极小: 单机单业务场景,数据量小,无需复杂隔离。
强事务一致性需求: 跨桶事务难以实现(如银行转账需跨账户更新)。
数据强关联: 需要频繁跨桶关联查询(如订单和用户信息需JOIN操作)。
总结:桶的设计本质
桶的核心价值是通过逻辑隔离降低系统复杂性,它的设计哲学可以归纳为:
分治策略: 将大数据集拆分为小单元,独立管理。
规则下沉: 将策略(权限、生命周期)绑定到数据单元,而非全局。
抽象统一: 对外提供一致的接口(如S3 API、InfluxDB写入协议),隐藏内部实现。
在设计系统时,如果遇到以下问题,可以考虑引入"桶"的概念:
-
数据需要按业务、用户、环境隔离。
-
不同数据集需要独立的管理规则。
-
系统需要横向扩展以应对海量数据。