摘要: Pinpoint 是 NAVER 开源的 Java APM,以 ServerMap、Scatter、CallStack 著称,却常让新手困惑 HBase 怎么起、pinpoint-bootstrap.jar 怎么挂。本文按「懂架构 → 部署后端 → 装探针 → 看懂控制台」四步展开,命令与组件均可在 Pinpoint 官方 GitBook 交叉验证,并附官方 README 示例截图。
很多团队把 Pinpoint 当成「深度 CallStack 工具」------其实它是一套覆盖拓扑、散点、调用栈与 JVM 巡检的分布式追踪平台,受 Google Dapper 启发,通过字节码增强实现无侵入接入。下文从 Agent / Collector / Web 三组件架构出发,说明 HBase + Pinot 双存储演进,再用 Java Agent 快速跑通 TestApp,对照 Demo 讲解 ServerMap、Scatter 与 Inspector;最后客观说明 Pinpoint 尚无内置 AI 能力,并介绍 Databuff 的 OTLP 三组件栈与 AI 问数模块,供后续演进参考。
§1 Pinpoint 简介
Pinpoint 是一套面向大规模分布式系统的应用性能管理(APM)工具1,由 NAVER 开源并遵循 Apache 2.0 许可。项目受 Google Dapper 论文启发,在跨服务 RPC 调用中自动注入 TraceId、SpanId 与 ParentSpanId,把原本「黑盒」的分布式事务还原为可排序的 Span 树。官方支持 Java 与 PHP (C-Agent)探针,Java 侧通过字节码 instrumentation 介入常见框架与 HTTP 客户端,无需修改业务代码,官方文档称资源开销约增加 3%1。
1.1 三组件架构与双存储
Pinpoint 逻辑上分为 Agent(探针) 、**Collector(采集器)**与 Web(控制台)三段23。Agent 以 Thrift 二进制格式异步上报 Trace 与统计;Collector 集群接收并写入存储;Web 从存储读取数据,渲染 ServerMap、Scatter、CallStack 等视图。v3.0 起存储进一步按数据类型拆分 :链路 Trace 仍写入 Apache HBase ,指标与新版 Inspector 统计则写入 Apache Pinot,经 Kafka 做流式摄入34------这是阅读安装文档时最容易忽略的变化。
text
[ Pinpoint Agent ]  →  Thrift / UDP 异步上报
        ↓
[ Pinpoint Collector ]  →  接收 · 采样 · 常量表去重
        ↓
[ Storage ]  →  HBase(Trace / 元数据)+ Pinot(Metric / Inspector)
        ↓
[ Pinpoint Web ]  →  ServerMap · Scatter · CallStack · Inspector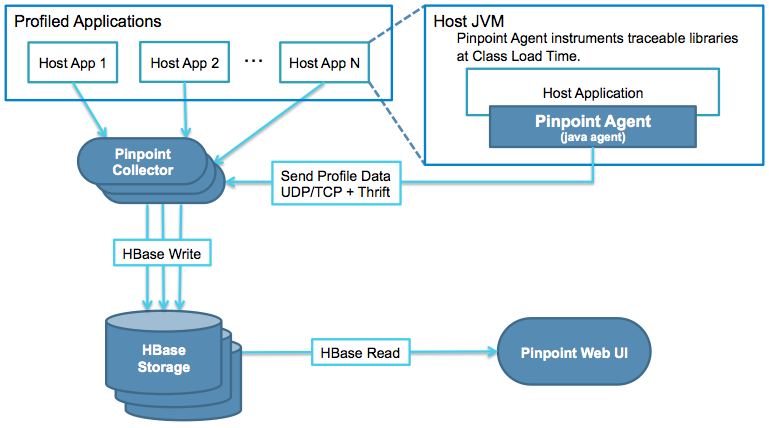
图 1-1 · Agent 无侵入挂载 JVM,Collector 可水平扩展,Trace 落 HBase,指标与新版 Inspector 落 Pinot(需 Kafka)。
1.2 核心数据模型
Pinpoint 用 Span、Trace、TraceId 描述一次分布式请求5:
- Span:单次 RPC 处理的基本单元,可含多个 SpanEvent 表达方法级细节
- Trace:同一 TransactionId 下 Span 的集合,按 SpanId / ParentSpanId 组织为树
- TraceId:由 TransactionId(全局唯一消息 ID)、SpanId、ParentSpanId 组成;TransactionId 含 AgentId、JVM 启动时间与递增序号,降低 ID 冲突概率
Agent 还会把重复出现的方法名、SQL 与字符串映射为 HBase 常量表 ID,以压缩上报体积------这是 Pinpoint 能在高 QPS 场景下保持较小网络开销的关键设计之一5。
1.3 控制台核心视图一览
官方 Overview 将 Pinpoint Web 的核心能力归纳为四类视图4,理解其分工有助于后文对照 Demo 截图:
| 视图 | 作用 | 典型排障场景 |
|---|---|---|
| ServerMap | 展示服务/组件拓扑与调用边 | 定位异常依赖、流量热点 |
| Scatter Chart | 请求耗时随时间散点分布 | 框选慢请求批次 |
| CallStack | 单次 Trace 的方法级瀑布图 | 定位慢 SQL、慢 RPC |
| Inspector | CPU、内存/GC、TPS、JVM 参数 | 区分代码热点与资源瓶颈 |
与 Zipkin 的差异: Pinpoint 走自动字节码增强路线,接入成本集中在 Agent 运维而非业务改码;Zipkin 更偏「库/SDK 手动埋点 + Span 存储查询」,Pinpoint 则在 UI 侧内置 ServerMap 与 Scatter 的联动下钻。需要强调的是,Pinpoint 官方文档未描述任何内置大模型或 AI 问数模块------智能分析仍依赖工程师在 CallStack 中人工判读。
§2 Pinpoint 简单使用
三步跑通:起存储与后端 → 挂 Java Agent → 在 Web UI 中验证数据
入门实践建议遵循「先让数据进来、再调优采样率」的顺序。下面 2.1--2.3 分别对应后端部署、Java 探针安装与控制台功能讲解,命令均来自 Pinpoint 官方 Quick Start 与 Installation 文档23。若只想快速体验 UI,可直接访问官方公开 Demo1;本文 §2.3 配图来自 Pinpoint 官方 GitHub README 示例。
§2.1 后端部署
手动安装需 HBase 表初始化;Docker 路径约 10 分钟可起全套
HBase 与表结构
Pinpoint Collector 与 Web 默认依赖 HBase 存储 Trace 与元数据3。解压 HBase 后启动,再执行官方脚本创建表:
bash
$ tar xzvf hbase-x.x.x-bin.tar.gz
$ cd hbase-x.x.x/
$ ./bin/start-hbase.sh
$ ./bin/hbase shell hbase-create.hbase
生产环境可选用 Snappy 压缩版脚本 hbase-create-snappy.hbase;HBase 版本需对照官方兼容性表选型。
Collector 与 Web
从 GitHub Latest Release 下载 Collector 与 Web 可执行 JAR,通过 ZooKeeper 地址串联组件2:
bash
$ java -Dpinpoint.zookeeper.address=localhost \
       -jar pinpoint-collector-boot-2.2.1.jar
$ java -Dpinpoint.zookeeper.address=localhost \
       -jar pinpoint-web-boot-2.2.1.jar
v3.x 若启用 Pinot 相关能力,还需预先安装 Kafka 与 Pinot,并按文档创建 Schema、Realtime Table 与 Hybrid Table3。Pinot 连接参数需在 Collector、Web 等组件的 application.yml 中分别配置。
Docker 快速体验
官方 pinpoint-docker 仓库提供一键 Compose,文档称完整安装约需 10 分钟26,适合本地 POC。体验结束后按仓库说明销毁容器即可;生产环境则需单独规划 HBase 集群、Pinot/Kafka 与 Collector 水平扩展。
运维提示: Pinpoint 支持采样(Sampling)------开发环境可全量采集,生产环境常设 1--5% 采样以降低 Collector 与 HBase 压力5。网络突发时 Agent 还可降级为 UDP 传输,把带宽优先让给业务流量。
§2.2 Java 探针安装
核心入口为 pinpoint-bootstrap.jar;三行 JVM 参数即可启用或禁用
获取 Agent 包
从 Latest Release 下载 pinpoint-agent-x.x.x.tar.gz 并解压2。Agent 目录中的 pinpoint-bootstrap.jar 是挂载入口------它在类加载期注入 Interceptor,分离「拦截逻辑」与「数据记录」,以控制 profiling 数据体积。
bash
$ tar xvzf pinpoint-agent-2.2.1.tar.gzQuick Start TestApp
官方 Quick Start 附带 Spring Boot 示例 TestApp,一条命令即可验证 Agent 是否正常工作2:
bash
$ java -jar \
  -javaagent:pinpoint-agent-2.2.1/pinpoint-bootstrap.jar \
  -Dpinpoint.agentId=test-agent \
  -Dpinpoint.applicationName=TESTAPP \
  pinpoint-quickstart-testapp-2.2.1.jar
控制台出现 Spring Boot 启动日志且 Agent 输出 added dynamic transformer 字样,表示字节码增强已生效。TestApp 默认监听 8082 端口,可在 Web UI 中看到 TESTAPP 应用节点。
生产 JVM 挂载方式
官方 Tech Details 给出通用三行配置5,适用于 Tomcat、可执行 JAR 等场景:
bash
-javaagent:$AGENT_PATH/pinpoint-bootstrap-$VERSION.jar
-Dpinpoint.agentId=<Agent 唯一 ID,建议 hostname>
-Dpinpoint.applicationName=<逻辑服务名,多实例共享>
agentId 在集群内须全局唯一(常用 hostname);applicationName 表示同一服务的逻辑分组,ServerMap 上多个 Agent 实例会聚合到同一应用节点下。若 Agent 引发兼容问题,删除上述三行即可完全卸载------这是字节码方案相对 SDK 侵入式的运维优势。
注意 -javaagent 须与其他 JVM 参数一并传入;对于 java -jar 启动方式,官方示例将 -javaagent 写在 -jar 之后,与 SkyWalking 等 Agent「必须在 -jar 之前」的惯例不同,请以 Pinpoint 文档为准2。
§2.3 功能界面解释
以官方 README 示例对照 ServerMap、Scatter、Inspector 三个核心视图
完成部署与探针接入后,打开 Web 控制台(Demo 地址见官方 README1)。Pinpoint Web 以应用为中心组织导航:先选 Application 与时间窗口,再在不同 Tab 间切换拓扑、散点、调用栈与巡检。下面结合官方 README 示例图说明日常排障路径。
ServerMap(服务拓扑)
ServerMap 可视化分布式系统中各组件的调用关系4。节点代表应用或外部依赖,连线表示调用方向;点击节点可查看当前状态、事务计数与下游明细。排障时通常先看 ServerMap 定位「哪条依赖边变红或流量异常」,再下钻 Scatter 或 CallStack。
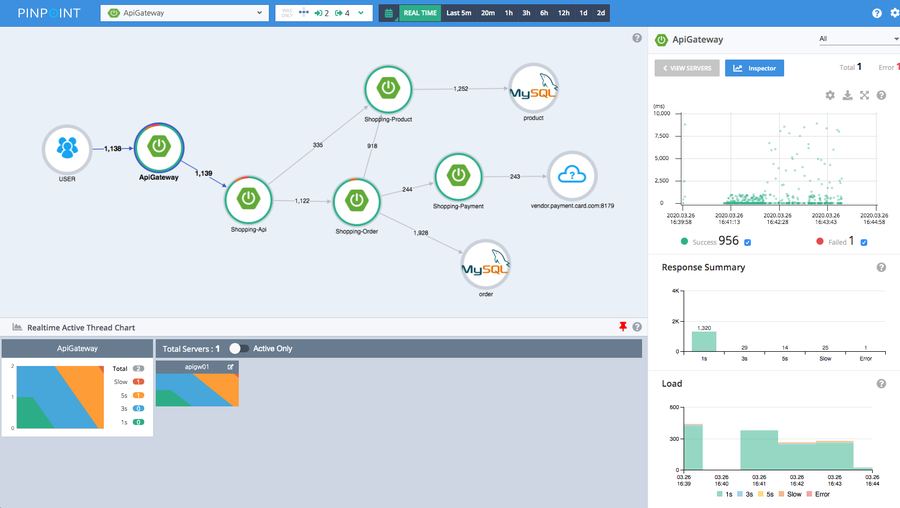
图 2-1 · ServerMap 展示 ApiGateway、Spring Boot 等节点及调用边,节点颜色与计数反映健康与流量,是全局排障入口。
Scatter Chart(请求散点图)
Scatter Chart 将每次请求的响应时间与发生时刻绘制为散点4,横轴为时间、纵轴为耗时,可一眼识别慢请求簇与错误请求(通常以不同颜色区分)。用户在散点上**框选(Drag)**即可筛选对应 Trace 并跳转 CallStack------这比逐条翻 Trace 列表更适合从「现象」反查「个案」。
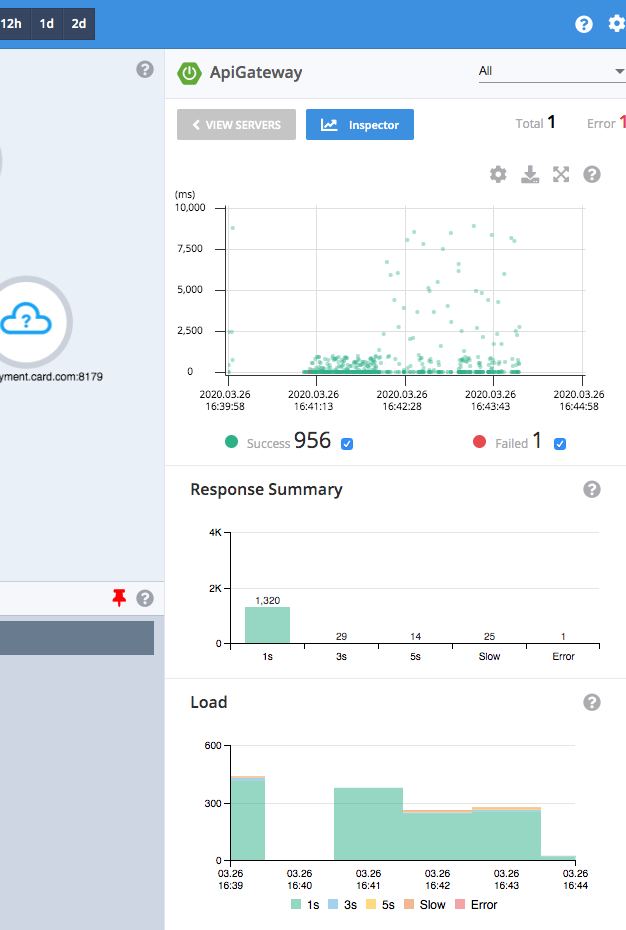
图 2-2 · Scatter 视图展示响应时间分布,框选区域可批量打开 CallStack,适合从延迟尖刺切入单链分析。
Inspector(应用巡检)
Inspector 展示应用级运行时细节:CPU 使用率、内存/GC、TPS、活跃线程与 JVM 参数等4。v3.0 的 New Inspector 后端已迁移至 Pinot,查询性能优于 Legacy HBase 方案,但前端交互形态与旧版相近。当 CallStack 显示某服务方法变慢时,Inspector 可帮助区分「代码热点」与「JVM 资源瓶颈」。
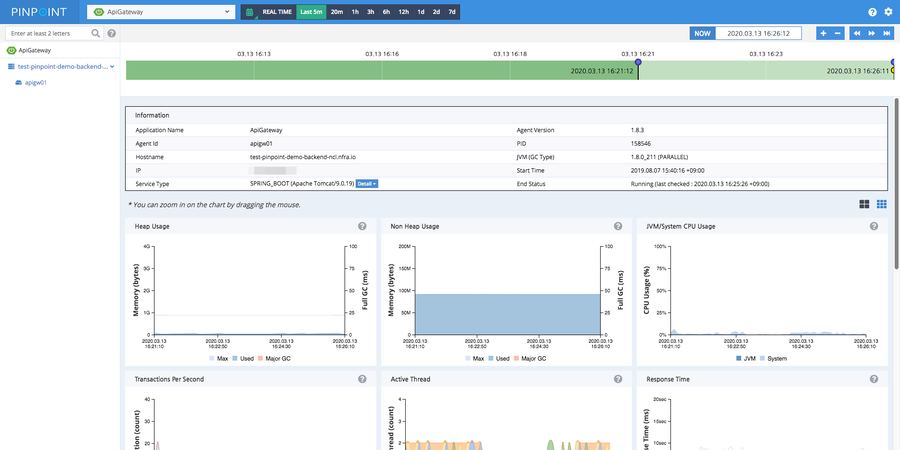
图 2-3 · Inspector 面板展示 CPU、堆内存、GC 与 TPS 曲线,可与 Scatter 时间窗口对照分析资源争用。
CallStack(调用栈瀑布图)
从 Scatter 框选或从事务列表进入 CallStack 后,可看到单次分布式 Trace 在各节点上的方法调用序列45。每一层 SpanEvent 标注类名、方法名与耗时,SQL 语句与外部 HTTP 调用也会以子 Span 形式展开------这是 Pinpoint 相较轻量追踪工具最具辨识度的能力,适合精确定位「哪一行 JDBC 慢了 200ms」。Web 从 HBase 读取 Trace 数据后按 SpanId 树排序生成视图,因此 HBase 读写延迟直接影响 CallStack 打开速度。
除 CallStack 外,Pinpoint 还提供 Realtime Active Thread Chart(实时活跃线程)等辅助面板。入门阶段掌握 ServerMap → Scatter → CallStack 的「由面到点」路径,即可覆盖多数 Java 微服务排障场景。需要再次强调:** Pinpoint 控制台以可视化查询为主,目前不提供内置 AI 问数或智能体排障模块**------告警联动、根因归纳仍依赖人工经验;若团队希望在熟悉 Pinpoint 之后探索 AI 辅助值班,可参考下文 Databuff 方案。
§3 AI 原生能力
需要客观说明的是:** Pinpoint 尚未提供内置的 AI 智能体或自然语言问数能力**------其 Web UI 聚焦 ServerMap、Scatter、CallStack 与 Inspector 等传统 APM 交互,不支持用对话方式查询 Doris/HBase 中的 Trace 或自动生成根因报告。对于已跑通 Pinpoint、又希望降低「翻面板找线索」成本的团队,可以了解另一款国产开源项目 Databuff:它在 OpenTelemetry 原生 APM 之上内置 AI 平台模块,下文作详细介绍。
3.1 Databuff 简介
Databuff 是面向 OpenTelemetry 标准的开源 APM,默认接收 OTLP Trace 与 Metrics,在同一存储上提供拓扑、链路查询、告警与 AI 辅助排障7。Databuff 已收录于 OpenTelemetry.io 官方 Vendors 生态名单 ,标注 Native OTLP 原生消费遥测数据9。与 Pinpoint「Agent + Collector + Web + HBase/Pinot」的多存储栈相比,Databuff 将分析引擎与存储收敛为更轻量的三组件架构:
text
[ OpenTelemetry SDK / Java Agent ]
        │ OTLP gRPC 4317 / HTTP 4318
        ▼
[ Ingest 接入 ] ── Trace 组装 · 指标分钟聚合
        ▼
[ Doris 统一存储 ] ── Trace / 指标 / 拓扑 / 告警
        ▼
[ Web 平台 ] ── APM UI + AI 多智能体
应用侧使用标准 OTel 环境变量即可接入,无需 Pinpoint 专有 Thrift 协议。一条安装脚本可在 Docker 环境拉起 Demo8:
bash
curl -fsSL https://www.databuff.ai/databuff/ai-apm-install.sh | bash从迁移视角看,Pinpoint 存量 Java 服务需替换为 OTel Java Agent 或经适配层改上报协议;Databuff 则与 OTel 生态默认端口(4317/4318)对齐,便于与 Zipkin、Jaeger 等并存 POC。典型 OTel Java 接入只需设置服务名与 Exporter 端点:
bash
OTEL_SERVICE_NAME=order-service
OTEL_EXPORTER_OTLP_ENDPOINT=http://ingest:4318
OTEL_EXPORTER_OTLP_PROTOCOL=http/protobuf
java -javaagent:opentelemetry-javaagent.jar -jar order-service.jar
Pinpoint 侧积累的 ServerMap 排障习惯,在 Databuff Web 中有对应的服务拓扑视图------节点聚合 RED 指标,点击可下钻实例与 Trace 列表。
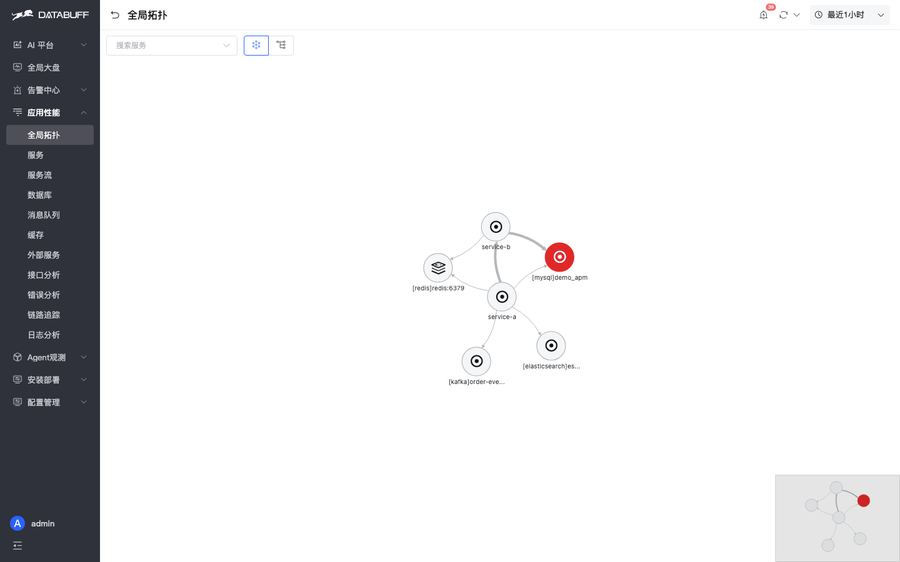
图 3-1 · Databuff 拓扑展示服务间调用关系与健康状况,交互路径与 Pinpoint ServerMap 类似,但数据来自 OTLP 统一管道。
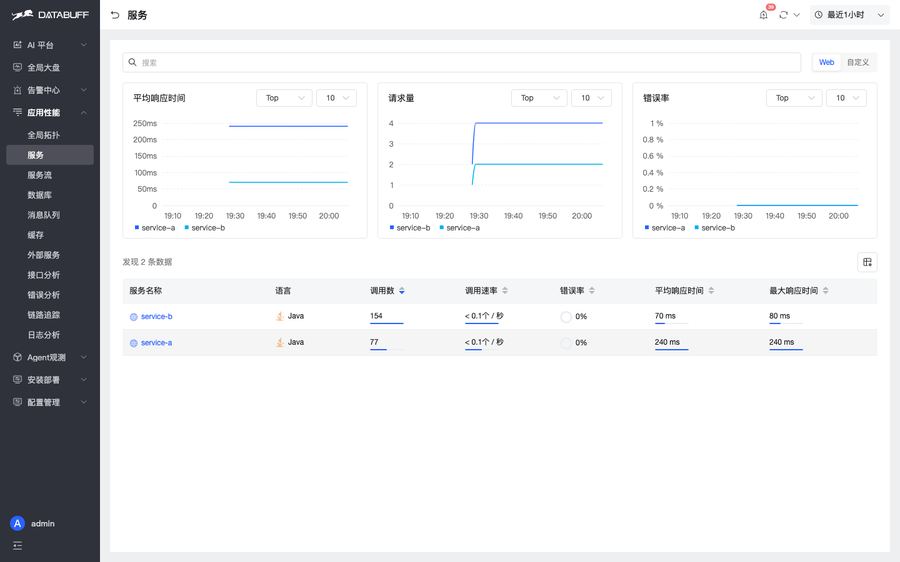
图 3-2 · 服务列表按 Layer 汇总 RPM、错误率与 P99,便于值班同学快速扫描异常服务,对应 Pinpoint 中按应用聚合的统计视角。
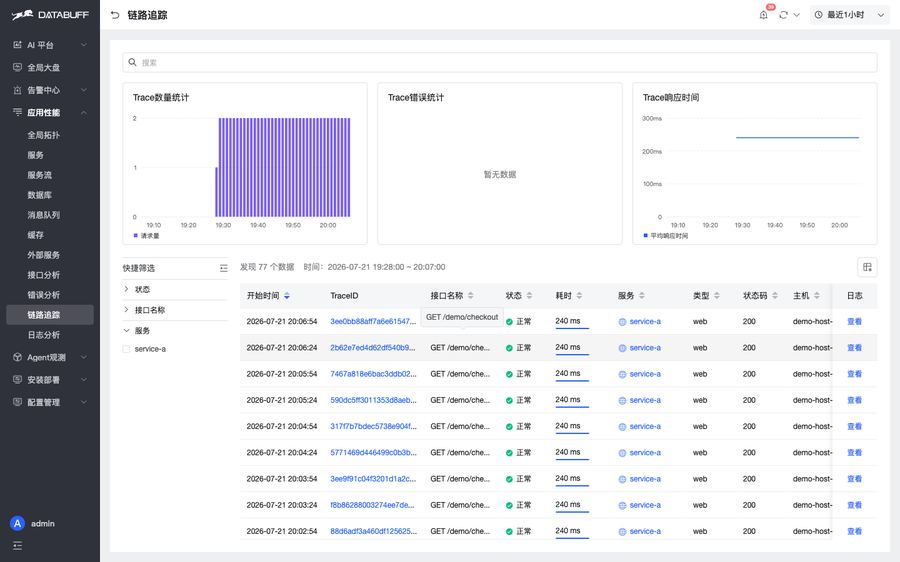
图 3-3 · Trace 列表支持按 Endpoint、状态与耗时筛选,可视为 Pinpoint Scatter + CallStack 组合能力的表格化入口。
3.2 Databuff 的 AI 平台模块介绍
许多 APM 产品的「AI」只是通用聊天窗;Databuff AI 平台 的差异在于:通过 Skill 调用平台工具,直接查询 Doris 里已入库的 OTel 数据 7------不是读文档猜答案,而是拉取真实 Trace、RED 指标与拓扑关系后再推理。一次完整 AI 排障会话通常经历四个阶段:** 意图识别**(Brain 解析自然语言)→ 数据拉取 (Query 专家执行 Trace/指标查询)→ 异常扫描 (Inspection 专家对照基线)→ 结论生成(结构化根因与建议)。核心模块包括 Brain(意图拆解与任务编排)、Query 专家(指标/链路查询)、Inspection 专家(异常巡检)与 MCP 扩展(对接 CMDB、工单等周边系统)。
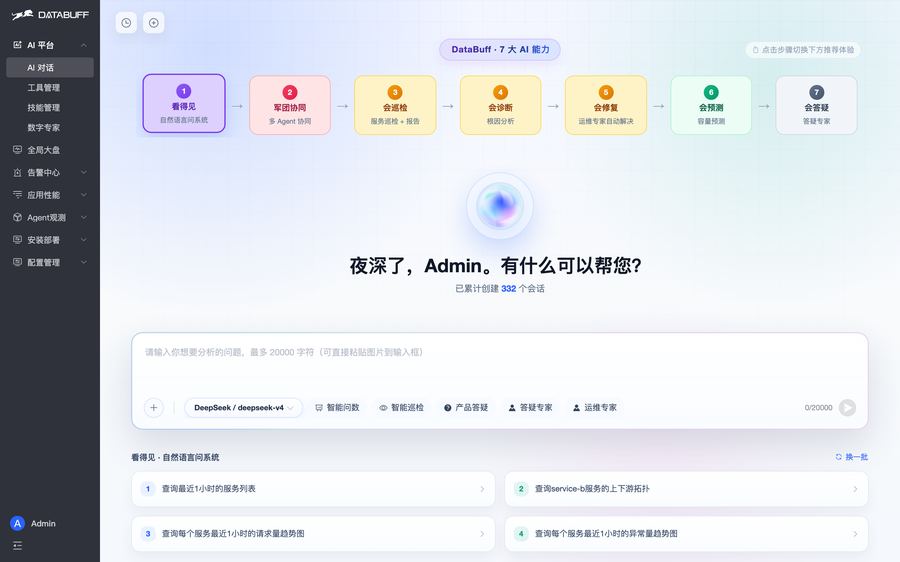
图 3-4 · AI 平台首页集中展示 Brain、Query、Inspection 等专家模块,用户从自然语言入口发起排障会话。
场景一:自然语言问诊
在 AI 对话中输入「拓扑节点变红,帮我诊断原因」或「过去一小时 order-service P99 为什么升高」等描述,Brain 接收意图并派发 Query / Inspection 专家,从 APM 存储拉取相关服务的耗时、错误率与拓扑上下文------把 Pinpoint 时代需要「先开 ServerMap → 再切 Scatter → 再翻 CallStack」的多步操作压缩成一句话。
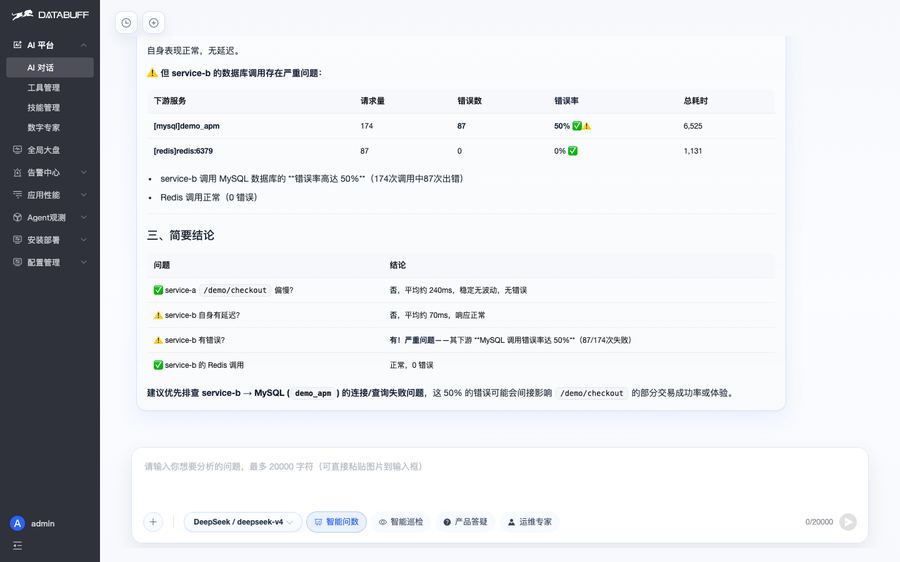
图 3-5 · AI 对话界面展示用户中文提问与多步推理过程,底层 Skill 直接访问 Doris 中的 Trace 与指标。
场景二:多专家协同与结构化推导
Query 专家负责拉取 RED 指标与 Trace 样本,Inspection 专家对照基线做异常扫描;Brain 将结果组织为结构化故障推导树------哪个节点异常、上下游谁受影响、证据来自哪条 Span 或分钟级指标------排障路径一目了然,便于在值班交接时复现推理过程。
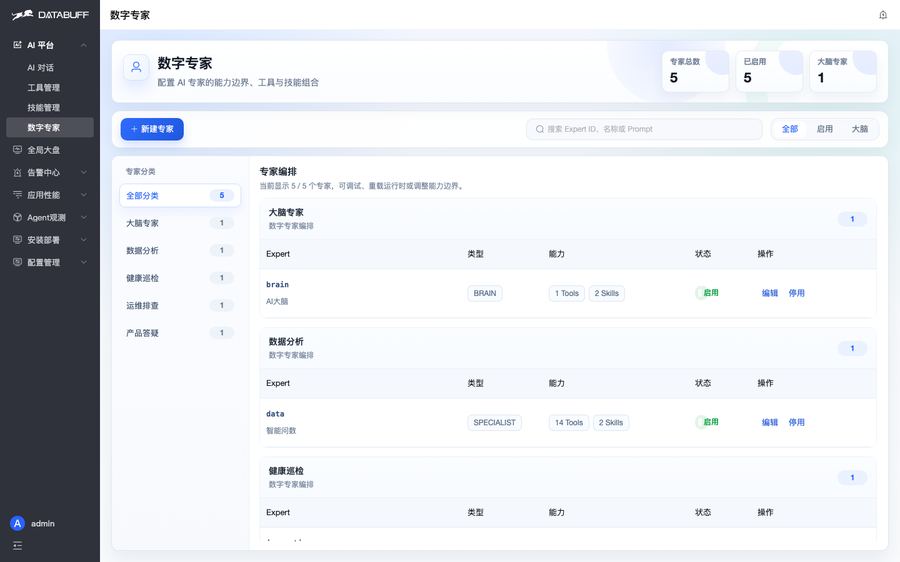
图 3-6 · 多专家协同视图展示 Brain 调度 Query、Inspection 等角色的过程,对应 Pinpoint 中人工切换多个 Tab 的自动化版本。
场景三:根因归纳与处置建议
推导完成后,AI 进一步给出根因定位、关联证据与处置建议,把分布式追踪数据翻译为可执行的值班动作------例如指出某下游 JDBC 调用延迟升高、建议检查连接池配置或对照发布变更时间线。MCP 扩展还可把结论推送到外部工单系统,形成「发现 → 推理 → 记录」闭环。
3.2.1 AI 平台快速上手(对照 Pinpoint Web 习惯)
DataBuff AI 平台的使用路径与 Pinpoint「先选 Application 再切 Tab」不同,更接近对话式入口11:
- 在「配置管理 → 模型配置」填入 LLM API Key(一次性)
- 进入「AI 平台」,用自然语言描述问题或点击巡检模板
- Brain 自动路由至 Query / Inspection 等专家,返回带数据证据的结论
- 需要人工复核时,点击结论中的服务/Trace 链接跳转到 APM 页面(同 Pinpoint 从 ServerMap 下钻 CallStack)
官方文档列出的高频问法包括:「哪些服务错误率最高?」「order 服务最近 1 小时延迟怎么样?」「找 5 条最慢的 Trace」「payment 服务调了谁、被谁调?」「帮我巡检所有核心服务」「order 错误率突然升高,什么原因?」11。这些场景在 Pinpoint 中通常对应 ServerMap + Scatter + Inspector 的组合操作;AI 平台的价值是把操作序列 压缩为意图描述,并把中间查询结果保留在会话上下文中,方便交接班复盘。
3.2.2 从 Pinpoint 迁移时的 AI 能力验收
若团队计划从 Pinpoint 切到 DataBuff,除 Trace 对齐外,建议单独做一轮AI 能力验收12:
- 数据一致性:同一时间段,DataBuff 服务列表是否出现与 Pinpoint Application 同名的服务;Trace 采样字段是否满足排障粒度要求(OTel 默认埋点 vs Pinpoint 方法级栈)
- AI 问数准确性:用 AI 查询某服务 P99,与 APM 图表人工读数对比误差是否在可接受范围
- 巡检召回:故意注入慢 SQL 或错误请求,看 Inspection 专家能否在无预设阈值下给出告警级结论
- 回滚演练:保留 Pinpoint Agent 启动参数,确认 15 分钟内可恢复单写 Pinpoint Collector
迁移文档明确:Pinpoint 历史 Trace、Inspector 数据与告警规则不会自动迁移;需在 DataBuff 告警中心重建规则。AI 平台并不能替代这一步------它解决的是「数据进来之后如何更快读懂」,而不是「配置如何自动复制」。
3.2.3 多智能体协同机制(为何不是简单聊天机器人)
DataBuff 的 AI 架构强调「AI 大脑 + 数字专家」11:Brain 负责理解意图并拆分子任务;Query 专家专注指标/Trace/拓扑查询;Inspection 专家专注异常扫描;产品答疑专家读取文档回答接入问题。复杂故障时,Brain 可并行派发多个专家,各自拉取不同证据后在会话中汇总------这区别于单轮 LLM 一次性生成长文。对 Pinpoint 资深用户而言,可把它理解为:ServerMap、Scatter、Inspector 三个 Tab 背后各有一个「自动化实习生」,而 Brain 扮演值班长角色协调分工。
外部能力通过 MCP 接入:在工具管理中注册远程 MCP Server,绑定到自定义数字专家后,AI 可在授权策略允许下调用外部 API(如创建工单、查询 CMDB)11。Pinpoint 生态以可视化 UI 为主,通常需自行开发 Webhook 集成;若你的 SRE 流程已标准化 Runbook,DataBuff 的 MCP 路径值得在 POC 阶段单独评估。
3.3 Pinpoint 与 DataBuff 能力对照
两家产品定位不同,下表从工程师日常选型角度做客观对照,便于理解「AI 能力升级」究竟升级了什么:
| 维度 | Pinpoint | Databuff |
|---|---|---|
| 接入协议 | 专有 Agent + Thrift 上报 | OTLP 4317/4318 原生 |
| 存储架构 | HBase(Trace)+ Pinot(Metric) | Apache Doris 统一 Trace/指标 |
| 拓扑视图 | ServerMap | 服务拓扑(图 3-1) |
| 慢请求分析 | Scatter 框选 + CallStack | Trace 列表 + AI 推导 |
| JVM 巡检 | Inspector(Pinot/HBase) | 指标面板 + Inspection 专家 |
| 内置 AI | 无 | Brain + Query/Inspection 多智能体 |
| 典型运维成本 | HBase + Pinot + Kafka 集群 | 三组件 Docker 一键 Demo |
Pinpoint 在 Java 生态深耕多年,CallStack 的方法级细节与 NAVER 超大规模实践背书仍是其优势;Databuff 则适合已采纳 OpenTelemetry、希望同一套 OTLP 管道同时服务传统 APM 与 AI 问数的团队。并行 POC 时,可让新业务走 OTel → Databuff,遗留 Java 系统继续 Pinpoint Agent,待验证 AI 问数收益后再决定是否扩大迁移范围。
演进建议 若团队已按本文完成 Pinpoint Collector + Java Agent 接入,可保留存量 Pinpoint 链路继续服务 Java 遗留系统;对新微服务并行挂载 OTel Agent 指向 Databuff,用同一业务流量对比「部署步骤、拓扑/Trace 查询、AI 问数」三项体验。二者并非互斥------Pinpoint 在 Java 字节码增强与 CallStack 深度上积累深厚,Databuff 则在 OTel 原生协议与 AI 问数上提供补充路径,适合作为「AI 能力升级」的对照参考。
小结
Gartner 在可观测性平台研究中强调,系统复杂度的上升与运营负担的加剧,推动了对 AI SRE 智能体的需求10。在这一背景下,可观测工具正在从「人工翻 ServerMap / Scatter」向「AI 辅助决策」演进。
Pinpoint 快速入门的核心路径是:** 理解 Agent / Collector / Web 三组件与 HBase + Pinot 双存储 → 初始化 HBase 表并启动 Collector/Web → 以 pinpoint-bootstrap.jar 挂载 Java 进程 → 在 ServerMap、Scatter 与 Inspector 中验证数据**。Pinpoint 在 Java 分布式追踪与 CallStack 深度上仍是成熟选择,但不提供内置 AI 能力。需要自然语言问数与多智能体协同排障时,可进一步了解 Databuff 的 OTLP 三组件栈与 AI 平台模块,在真实流量上对比两种方案的落地体验。