你提交了一个事务,MySQL 回了你一句 "commit ok"。
下一秒机房断电、进程崩溃,等数据库重启,这笔数据还在吗?
对已经成功提交的事务来说,只要提交所依赖的 redo log 已经安全落盘,即使数据页还没刷进数据文件,崩溃恢复后数据也能找回来。
当然,这里说的"安全落盘"有个前提:
操作系统和存储设备能够正确兑现 flush/fsync 的持久化语义,否则持久性依然可能落空。
持久性的目标其实就一句话:
事务一旦提交,它对数据的修改就是永久的,后面不管数据库崩了、服务器宕了、突然掉电了,已经写进去的东西不能丢。
InnoDB 兜住这条底线的核心机制,就是 redo log,加上它背后的 WAL(Write Ahead Logging,预写日志)思想。
持久性到底要保什么
先把目标钉死。
持久性(Durability)是事务 ACID 里的 D,它不管后面发生什么意外,只要事务提交成功,结果就必须留得住。
注意它保的是"已提交"的数据------没提交的事务本来就允许回滚,不在保护范围内。
InnoDB 靠什么做到?
答案就是 redo log。
redo log 主要记录的是数据页及其相关结构发生的修改信息,配合 WAL(Write Ahead Logging,预写日志)的核心约束------在对应的脏页被刷入磁盘数据文件之前,描述这些修改的 redo log 必须先持久化------让已经提交的修改即使没真正写进磁盘文件,也能在崩溃后恢复这笔已经提交的修改。
redo log 记的是数据页层面的物理修改
redo log 主要记录的是数据页及其相关结构发生的修改信息:
它关注的不是"执行了哪条 SQL",而是"哪些底层数据发生了什么修改"。
打个比方。
你执行一条 update,把 id=1 这行的某个字段从 100 改成 200。
undo log 主要用于事务回滚和 MVCC 所需的旧版本维护;
redo log 则更关注"崩溃之后,如何把已经发生但尚未写入数据文件的修改重新做出来"------它记录的是数据页层面的修改信息,恢复时不需要重新解析 SQL,也不需要重新走一遍索引查找。
这个差别很关键。
逻辑日志描述的是"做了什么事",恢复时往往得重新走一遍逻辑;
而 redo 记录的是数据页层面的修改,InnoDB 可以直接根据 redo 记录定位到相关的数据页,并重新执行对应的页面修改,而不需要重新解析和执行原始 SQL。
崩溃恢复时,InnoDB 直接扫描 redo log,把记录的修改重新应用到对应数据页上,恢复过程因此更加直接、高效,不必重新执行 SQL 逻辑。
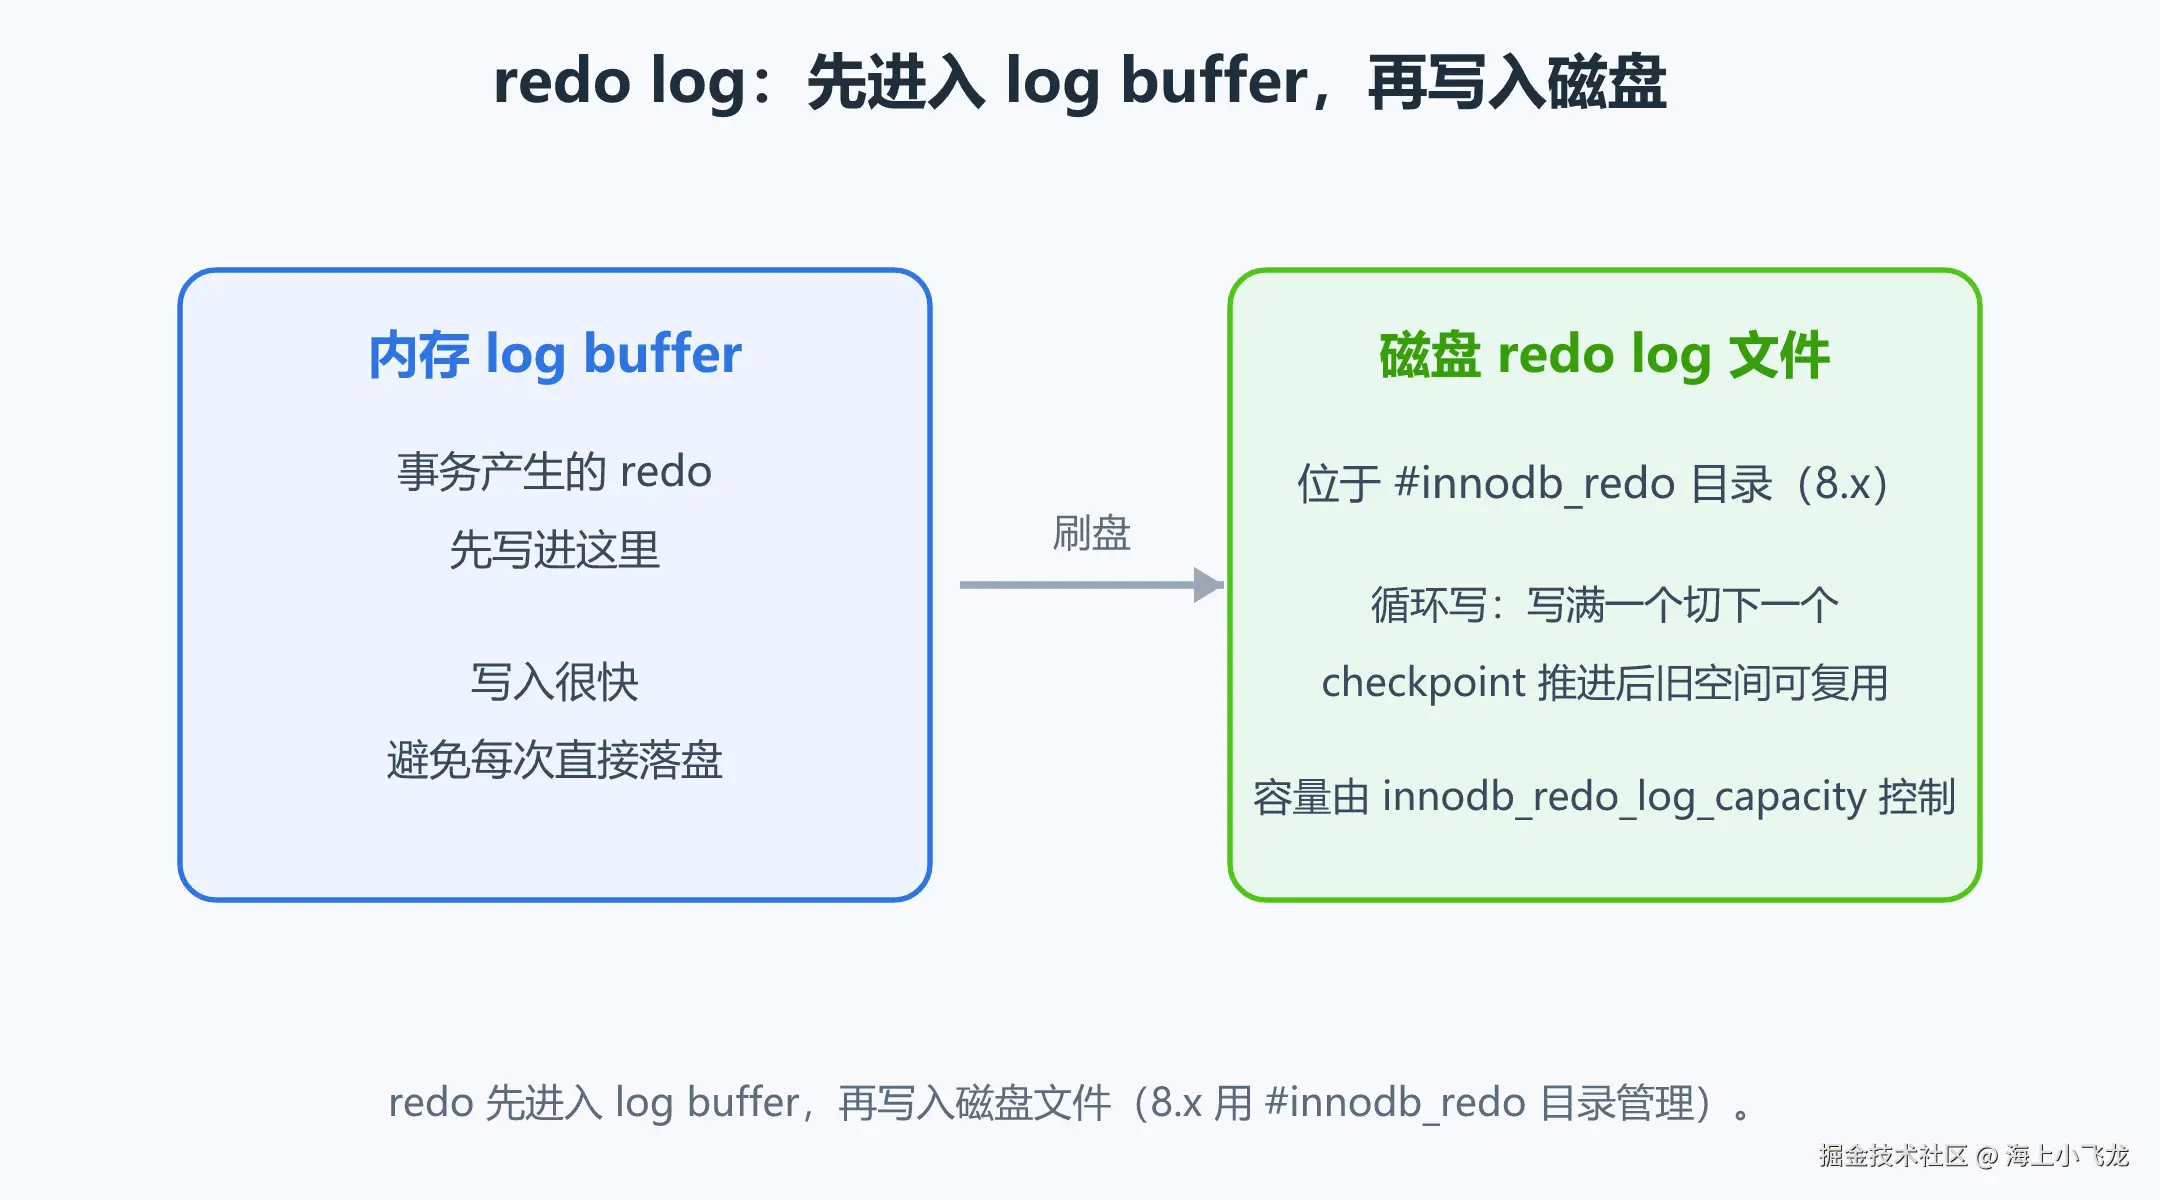
redo log:先进入 log buffer,再写入磁盘
redo 产生后,会先进入 InnoDB 的 log buffer;
随后根据提交策略和后台刷新机制,被写入 redo log 文件。
内存里有一块叫 log buffer 的区域,专门缓存还没落盘的日志。
每次产生 redo 记录,先写进这块内存,速度很快,目的就是别让每次写操作都直接落盘,把写入性能顶上去。
磁盘上则是 redo log 文件,它们组成了一块固定大小、循环使用的日志空间:一个文件写满,就切到下一个;
当某段 redo 所对应的数据页已经通过 checkpoint 刷入数据文件后,那部分日志空间就可以被重新复用。
在现在主流的 MySQL 8.x 里,redo log 的总容量由 innodb_redo_log_capacity 统一管理,相关文件位于 #innodb_redo 目录。
一个事务怎么落盘:先日志,后数据
那一个事务执行的时候,日志和数据到底谁先谁后?
真实的顺序是这样的:
当事务修改数据时,InnoDB 会在内存中修改 Buffer Pool 中的数据页,同时生成对应的 redo 记录并写入 log buffer。
WAL 真正保证的是------在对应的脏页被刷入磁盘数据文件之前,描述这次修改的 redo log 必须先持久化。
之后,InnoDB 再挑个合适的时机,把缓冲池里的脏页刷到真正的磁盘数据文件里。
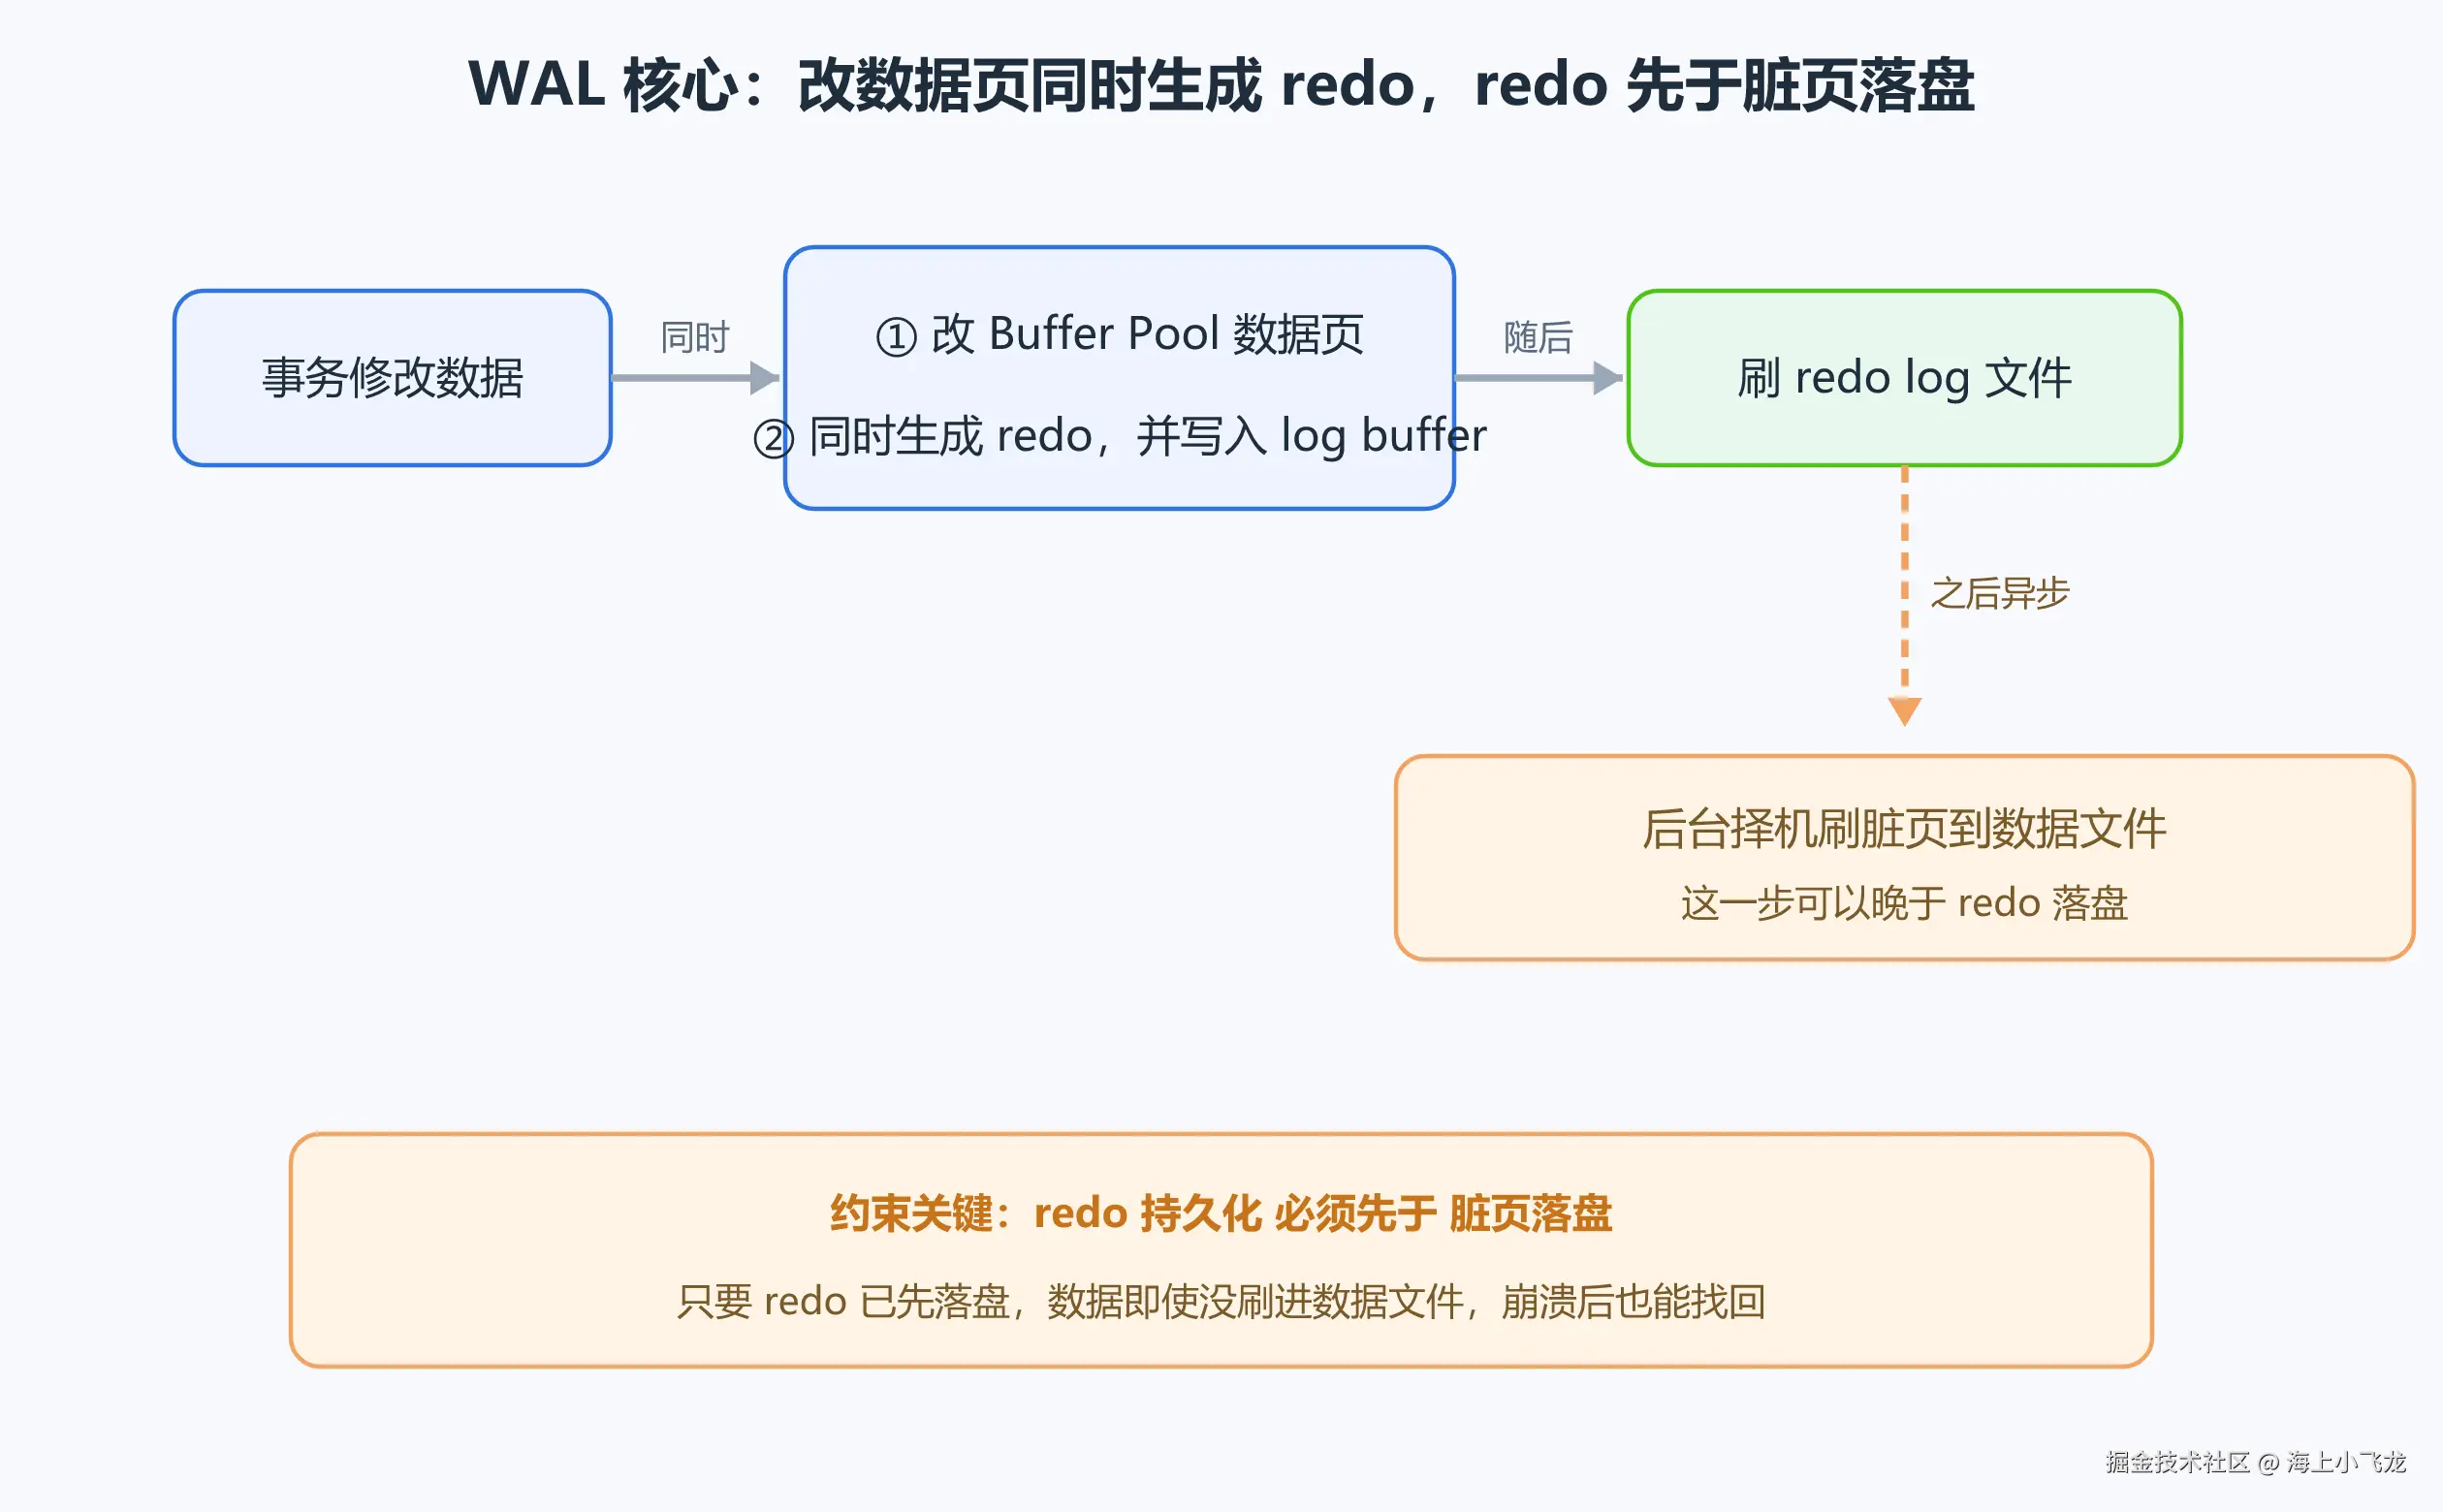
重点在最后这半句:
在存储系统能够正确兑现持久化语义的前提下,只要描述这次修改的 redo log 已经先于脏页安全落盘,即使数据页还没写进数据文件,重启后也可以通过 redo 恢复这笔已经提交的修改。
为什么非要先写日志:用顺序写换安全和性能
这套"redo 先持久化、数据页后落盘"的约束,表面看多此一举,本质是在性能和安全性之间做平衡。
性能上:
直接改磁盘数据文件,得先定位到哪一页哪一行的位置再写,这是随机写,慢。
redo log 是按 LSN 顺序追加写入的循环日志空间,整体上具有顺序写的特征。
相比频繁修改分散在数据文件中不同位置的数据页,顺序追加可以显著减少随机 I/O 带来的开销,WAL 就是用这种"优先顺序写"的方式,把大量随机写挡在门外。
安全上:
哪怕缓冲池里的数据改完了、还没来得及刷盘,服务器就宕机了,只要 redo log 已经持久化到磁盘,重启之后 InnoDB 照样能按日志记录把未刷盘的数据恢复出来,已提交的事务不会丢。
innodb_flush_log_at_trx_commit:三个值怎么选
这里有个面试里很能拉开差距的参数:
innodb_flush_log_at_trx_commit。
它决定的是"事务提交时,redo log 什么时候写入日志文件、什么时候执行持久化操作",一共三个值。
| 参数值 | 提交时做什么 | 落盘时机 | 安全性 | 性能 |
|---|---|---|---|---|
| 1 | 将 redo 写入 redo log 文件,并执行 fsync 等持久化操作 | 每次提交都落盘 | 最高,宕机也不丢已提交数据 | 有 IO 压力,最慢 |
| 0 | 不在每次提交时写/刷 redo log,由后台机制周期性处理 | 默认约每秒一次 | 可能丢失最近一小段已提交事务 | 较高 |
| 2 | 把 redo 写进操作系统缓存 OS buffer,不立刻 fsync | 由操作系统周期性刷出 | 介于 0 和 1 之间 | 较高 |
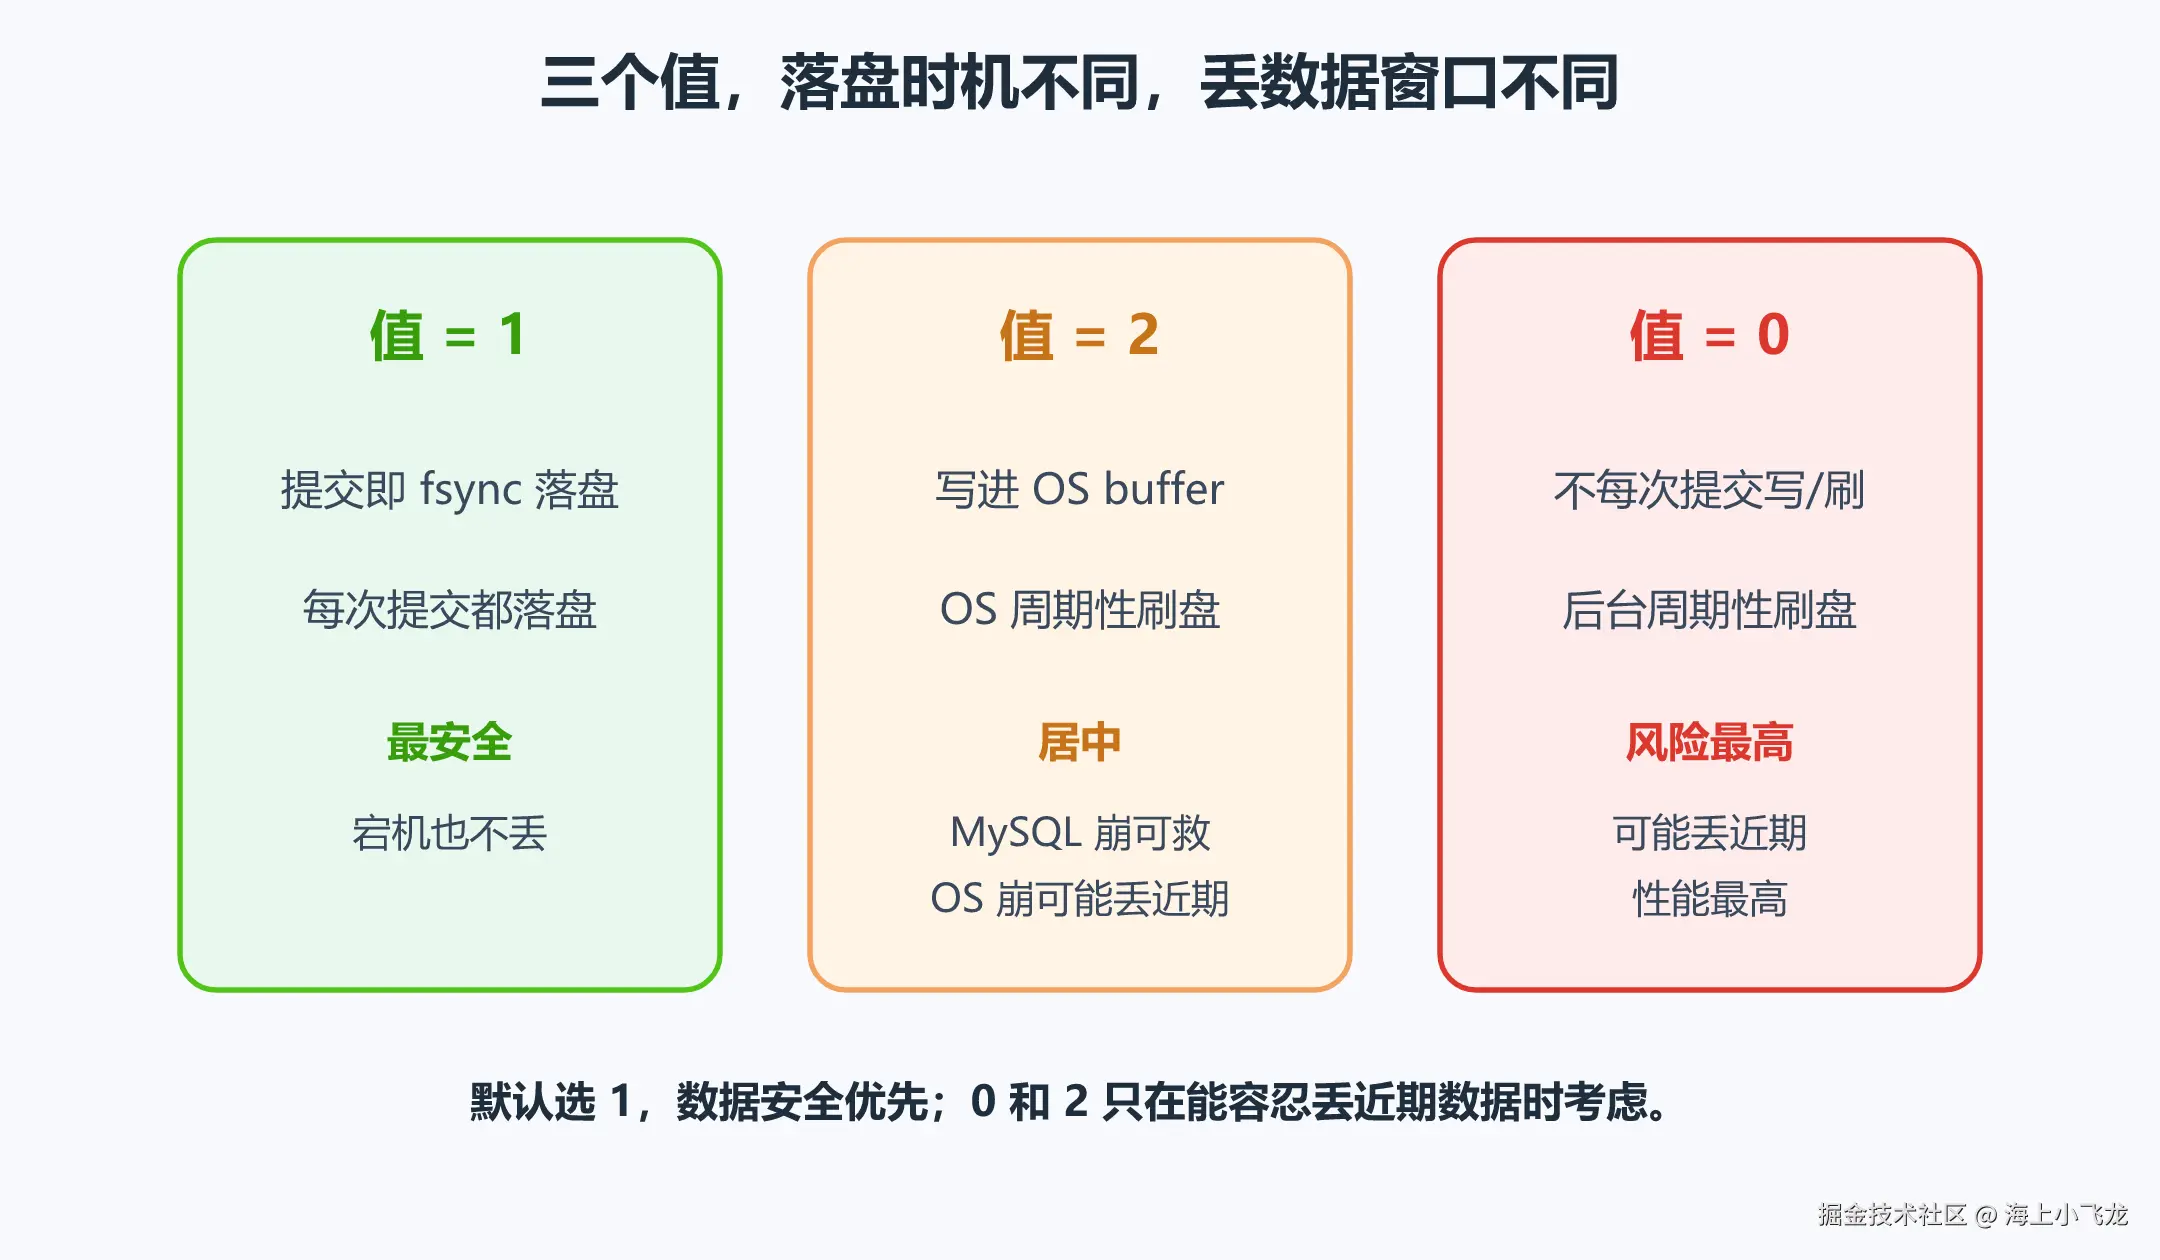
值为 2 时,redo log 在事务提交时已经写入操作系统缓存,但没有立即调用 fsync 等待真正持久化。
因此单纯的 mysqld 进程崩溃通常不会因为操作系统缓存丢失这部分日志;
但如果发生操作系统崩溃或突然断电,尚未持久化的数据仍可能丢失。
值 0 更激进,redo 不在每次提交时刷出,而由后台机制周期性处理,发生崩溃时可能丢失最近一小段时间内已经提交的事务。
实际选型很简单:
绝大多数场景直接上 1,数据安全优先。
只有明确能够容忍最近一小段时间事务丢失的业务,才会考虑 0 或 2。
如果 MySQL 同时开启了 binlog,还需要关注 sync_binlog;
在对持久性和复制一致性要求较高的场景,官方推荐 innodb_flush_log_at_trx_commit=1 并配合 sync_binlog=1。
真宕机了,InnoDB 怎么把数据找回来
假设最坏情况:
事务已经提交,提交所需的 redo log 也已经安全落盘,但缓冲池里的数据页还没刷进磁盘数据文件,这时候 MySQL 崩了。
重启之后,InnoDB 会自动进入崩溃恢复流程,根据 checkpoint 和 redo log,把需要恢复的修改重新应用到对应的数据页上。
对于崩溃时尚未提交的事务,InnoDB 会利用 undo 等机制进一步进行回滚。
最终,已经成功提交的事务得以保留,未提交事务不会以半完成状态留在数据库里。