开篇介绍:
hello 大家,本篇博客我们来学习Redis中的主从复制。
前言
在 Redis 的整个生态体系中,主从复制 是绝对绕不开的核心基石 ------ 它是 Redis 解决单点故障 、实现读写分离 、支撑高并发 的基础,更是后续进阶的哨兵模式 、Redis 集群的底层依赖,没有主从复制,Redis 就无法摆脱 "单节点脆弱性" 的桎梏,无法支撑中大型业务的稳定运行。
一、开篇直击:为什么 Redis 必须要有主从复制?
在学习主从复制的任何知识点之前,我们先静下心来,思考一个最朴素、最实际的问题:如果我们在生产环境中,只部署一台 Redis 节点,会出现什么可怕的问题?
这就是分布式系统中最经典、最致命的单点问题(Single Point of Failure,简称 SPOF)
案例 1:单点宕机,业务全面瘫痪
某小型电商平台,Redis 单节点部署,用于缓存商品详情、用户购物车数据,支撑前端的商品查询、购物车操作。某天晚上,Redis 节点所在的服务器突然断电,Redis 进程直接终止,此时发生了以下一系列灾难性后果:
- 所有前端商品查询请求,都无法从 Redis 获取缓存,全部穿透到后端数据库;
- 数据库瞬间被高并发读请求打崩,连接数耗尽,无法响应任何请求;
- 前端页面加载失败、购物车无法操作,用户无法下单,业务全面瘫痪;
- 运维人员紧急重启服务器、重启 Redis,但 Redis 数据因未开启持久化(或持久化文件损坏)全部丢失,需要从数据库全量导入数据,整个恢复过程耗时 2 小时,造成巨大的业务损失和用户流失。
案例 2:单节点性能瓶颈,无法支撑高并发
某资讯类 APP,Redis 单节点部署,用于缓存文章列表、用户浏览记录,日常读并发约 1 万 QPS,运行稳定。但在某次活动期间,APP 推出热门资讯推送,读并发瞬间飙升到 5 万 QPS,此时单节点 Redis 出现以下问题:
- Redis CPU 占用率飙升至 100%,无法及时处理所有读请求,大量请求超时;
- 网络带宽被占满,Redis 响应延迟从 10ms 飙升至 500ms 以上,前端页面加载卡顿;
- 主节点同时处理读请求和少量写请求(比如更新文章阅读量),写请求被阻塞,导致文章阅读量无法实时更新,数据出现临时错乱;
- 无法通过扩容单节点解决(CPU、内存、带宽已达上限),只能紧急降级业务,关闭热门资讯推送,影响活动效果。
案例 3:数据丢失,无法恢复
某社交平台,Redis 单节点部署,用于缓存用户会话信息(登录状态),开启了 RDB 持久化,每天凌晨 3 点自动生成 RDB 快照。某天凌晨,服务器硬盘损坏,RDB 快照文件无法读取,Redis 进程重启后,所有用户会话信息全部丢失,导致所有用户被迫重新登录,用户体验极差;同时,由于会话信息没有备份,无法恢复,大量用户投诉,平台口碑受损。
主从复制的核心价值:解决单点问题,支撑高可用、高并发
从上面 3 个案例可以看出,单节点 Redis 在生产环境中完全无法使用,而 Redis 主从复制,就是为了解决这些问题而生的,它的核心价值有 3 点,缺一不可:
- 解决单点故障,提升可用性:主节点宕机后,从节点可以快速切换为主节点,继续提供服务,避免业务瘫痪;
- 实现读写分离,分担主节点压力:主节点只处理写请求(set、incr、del 等修改操作),从节点只处理读请求(get、hget 等查询操作),将高并发读流量分摊到多个从节点,突破单节点性能瓶颈;
- 实现数据备份,避免数据丢失:从节点是主节点的完整数据副本,主节点数据损坏 / 丢失时,从节点可以作为备份,快速恢复数据,无需从数据库全量导入。
通俗类比:用 "老师 - 助教" 模式
为了让大家更容易理解主从复制的工作模式,我用一个 "老师 - 助教" 教学场景,做一个全程类:
- 主节点(Master)= 授课老师:核心职责是 "讲课、更新知识",对应 Redis 主节点,负责处理所有写请求,是数据的源头,所有数据修改都先在主节点完成;
- 从节点(Slave)= 助教老师:核心职责是 "从老师那里同步知识、给学生答疑",对应 Redis 从节点,只能从主节点同步数据,不能主动修改数据(默认只读),负责处理所有读请求;
- 知识传递 = 数据同步:知识只能从老师传递给助教,不能反过来(助教不能教老师),对应 Redis 主从复制的 "单向数据流"------ 只能从主节点同步到从节点,从节点的数据不会反向同步给主节点;
- 学生 = 业务客户端:学生有问题,只找助教答疑(读请求找从节点),需要更新知识(比如提交作业、提问新问题),只找老师(写请求找主节点);
- 多助教 = 多从节点:学生越多,需要的助教越多,对应业务读并发越高,需要的从节点越多,分担答疑压力(读压力)。
二、第一章:主从复制基础认知
2.1 什么是 Redis 主从复制?
Redis 主从复制,本质上是 Redis 提供的一种自动化、单向的数据同步机制,简单来说:
我们部署多台 Redis 节点,指定其中一台为 "主节点(Master)",其他所有节点为 "从节点(Slave)",主节点会自动、实时地将自身的所有数据(包括已有的历史数据、后续新增 / 修改 / 删除的数据),复制到所有从节点中,保证所有从节点的数据,和主节点的数据完全一致,形成 "一主多从" 的架构。
这里有 3 个关键词:
- 自动化:无需人工干预,只要配置好主从关系,主节点的数据会自动同步到从节点,后续主节点的任何数据修改,都会自动同步,不用手动执行同步命令;
- 单向:数据流只能从主节点流向从节点,从节点不能主动向主节点同步数据,也不能修改自身同步过来的数据(默认只读);
- 完全一致:正常情况下,所有从节点的数据,和主节点的数据完全相同,主节点修改一条数据,所有从节点都会同步修改,不会出现数据不一致的情况(特殊情况除外,后续会讲)
2.2 主从节点的核心角色与分工
主从节点的角色分工非常明确,没有任何模糊地带
2.2.1 主节点(Master)的核心职责
主节点是整个主从架构的 "核心",是数据的 "源头",所有写操作都必须在主节点完成,它的核心职责有 5 点:
- 处理所有写请求:这是主节点最核心的职责,所有客户端发送的写命令(set、incr、del、hset、lpush 等),都必须发送到主节点,主节点执行完写命令后,再将命令同步给从节点;
- 发起数据同步:主节点会主动向所有已连接的从节点,同步自身的数据,包括历史数据(首次同步)和新增数据(实时同步),无需从节点主动请求;
- 维护主从连接:主节点会实时维护与所有从节点的 TCP 连接,通过心跳机制,检测从节点的存活状态,一旦发现从节点下线,会断开连接,待从节点重新上线后,重新建立连接并同步数据;
- 记录复制状态:主节点会记录所有从节点的复制状态,包括每个从节点的 IP、端口、复制偏移量(offset)、连接状态(在线 / 离线)等,通过
info replication命令可以查看; - 处理从节点的同步请求:从节点上线、重连后,会向主节点发送同步请求,主节点会根据从节点的状态(首次连接 / 重连),决定执行全量复制还是部分复制,响应从节点的同步请求。
2.2.2 从节点(Slave)的核心职责
从节点是主节点的 "副本",是读请求的 "处理者",默认情况下不能处理写请求,它的核心职责有 5 点,和主节点的职责一一对应:
- 处理所有读请求:这是从节点最核心的职责,所有客户端发送的读命令(get、hget、lrange、smembers 等),都可以发送到从节点,从节点直接返回数据,无需转发给主节点,从而分担主节点的读压力;
- 接收主节点的同步数据:从节点会主动连接主节点,接收主节点同步过来的所有数据(历史数据、新增数据),并将数据保存到自身的内存(和磁盘,若开启持久化)中,保证和主节点数据一致;
- 维护与主节点的连接:从节点会通过心跳机制,实时检测与主节点的连接状态,一旦发现主节点下线,会不断重试连接,直到主节点重新上线,或者人工干预切换主节点;
- 记录自身复制状态:从节点会记录自身的复制状态,包括主节点的 IP、端口、复制偏移量(offset)、主节点的复制 ID(replid)、连接状态等,通过
info replication命令可以查看; - (可选)作为其他从节点的主节点:在树形主从拓扑中,从节点可以同时作为 "中间层主节点",接收下层从节点的同步请求,将自身的数据同步给下层从节点,分担顶层主节点的压力(后续拓扑结构会详细讲)。
2.3 主从复制的核心规则
主从复制有 4 条核心规则,是 Redis 官方规定的,不能打破,一旦打破,就会导致主从复制失败、数据不一致等问题:
规则 1:角色数量规则(1 主 N 从,一从 1 主)
- 一个主节点(Master),可以同时连接多个从节点(Slave),理论上没有上限,但实际生产中,建议不超过 10 个(太多会拖垮主节点),即 "1 主 N 从";
- 一个从节点(Slave),只能有一个主节点(Master),不能同时连接多个主节点,即 "一从 1 主",不能实现 "一从多主" 的架构。
规则 2:数据流方向规则(单向,不可逆)
- 数据流只能是 "主节点 → 从节点",不可逆,主节点的数据可以同步到从节点,但从节点的数据,无论如何都不能同步到主节点;
- 即使从节点被修改(关闭只读模式),修改后的数据也不会同步给主节点,也不会同步给其他从节点,会导致自身数据与主节点不一致(后续会讲危害)。
规则 3:写操作权限规则(主写从读,默认)
- 主节点:拥有全部写操作权限,可以执行任何写命令(set、incr、del 等),也可以执行读命令;
- 从节点:默认拥有只读权限,只能执行读命令(get、hget 等),不能执行任何写命令,一旦执行写命令,会直接报错(后续会演示)。
规则 4:数据一致性规则(正常情况下,完全一致)
- 正常情况下(主从连接正常、无网络中断、无命令错误),所有从节点的数据,和主节点的数据完全一致,主节点修改一条数据,所有从节点都会同步修改;
- 特殊情况下(网络中断、主从连接异常、命令执行错误),可能会出现主从数据不一致,但网络恢复后,会自动同步,恢复一致(部分复制的作用)。
2.4 主从复制的历史演变
为了让大家更好地理解后续的原理(比如 PSYNC 命令),这里补充一点主从复制的历史演变,只是帮助大家理解 "为什么有 PSYNC 命令",了解即可:
- Redis 2.8 版本之前:只有
SYNC命令,用于实现主从复制,但SYNC命令只有 "全量复制" 一种模式,无论从节点是首次连接,还是网络闪断重连,都要执行全量复制,效率极低,消耗大量 CPU、内存、带宽; - Redis 2.8 版本及之后:引入了
PSYNC命令,替代了SYNC命令,PSYNC命令支持 "全量复制" 和 "部分复制" 两种模式,首次连接执行全量复制,网络闪断重连执行部分复制,大幅提升了复制效率,减少了资源消耗; - 目前,所有主流 Redis 版本(5.0、6.0、7.0),都默认使用
PSYNC命令,SYNC命令已被废弃,仅用于兼容旧版本 Redis(2.8 之前)。
2.5 核心术语解释
后续学习中,会频繁出现一些核心术语,这里提前统一解释:
| 核心术语 | 解释(老师 - 助教类比) | 技术定义 |
|---|---|---|
| 主节点(Master) | 授课老师,负责讲课、更新知识 | 主从复制架构中,负责处理写请求、发起数据同步的核心节点 |
| 从节点(Slave) | 助教老师,负责同步知识、答疑 | 主从复制架构中,负责处理读请求、接收主节点同步数据的副本节点 |
| 复制 ID(replid) | 老师的 "身份 ID",每个老师有唯一 ID,助教同步知识时,会记录老师的 ID | 主节点的唯一标识(40 位字符串),用于标识主节点的数据版本,从节点会同步主节点的 replid |
| 备用复制 ID(replid2) | 助教之前跟随的老师的 ID,若当前老师离职,助教可以通过之前的老师 ID 找回旧知识 | 从节点用于保存上一个主节点的 replid,用于切主、重连时的同步验证 |
| 复制偏移量(offset) | 助教的 "学习进度",比如学到了第 100 页课件,老师的 "讲课进度",比如讲到了第 100 页 | 主从节点用于记录数据同步进度的计数器,主节点每发送 1 字节命令,offset+1;从节点每接收 1 字节命令,offset+1,offset 一致则数据一致 |
| 全量复制 | 助教首次跟随老师,需要把老师所有的课件(历史知识)全部抄一遍 | 从节点首次连接主节点时,主节点将自身所有数据一次性发送给从节点的同步方式 |
| 部分复制 | 助教中途走神,漏抄了几页课件,只需要找老师补抄漏抄的几页,不用重新抄全部 | 主从网络闪断重连后,主节点只将从节点丢失的部分数据发送给从节点的同步方式 |
| 复制积压缓冲区 | 老师的 "板书缓冲区",用于保存最近讲过的几页课件,方便助教补抄 | 主节点上的固定长度环形队列,用于保存最近执行的写命令,供部分复制时补发数据,默认大小 1MB |
| 心跳检测 | 老师每 10 分钟问一次助教 "在不在",助教每 1 分钟告诉老师 "我学到第 100 页了" | 主从节点用于维护连接状态的机制,主节点发 PING,从节点回复 ACK,检测对方存活状态 |
| 读写分离 | 老师只负责讲课(写),助教只负责答疑(读),分工明确 | 主节点处理所有写请求,从节点处理所有读请求,分担主节点压力的部署模式 |
三、第二章:主从复制全配置实战
主从复制的配置非常简单,Redis 提供了三种配置方式
3.1 实战前提准备(CentOS/Ubuntu 通用)
在开始配置之前,我们需要完成一些前提准备工作,避免后续操作出现问题:
3.1.1 环境准备(明确版本,避免兼容问题)
- 操作系统:CentOS 7.x/ Ubuntu 20.04(两种系统操作基本一致,差异会标注);
- Redis 版本:Redis 5.0.14(推荐,兼容所有主流版本,避免使用 2.8 之前的旧版本);
- 部署模式:本地多实例部署(一台机器启动多个 Redis 实例,模拟主从节点),优点是无需多台服务器,适合本地测试、学习;生产环境中,主从节点需部署在不同服务器,避免单台服务器宕机导致主从同时失效。
3.1.2 安装 Redis
如果还未安装 Redis,按照以下步骤操作,CentOS 和 Ubuntu 分别演示,避免遗漏:
(1)CentOS 7.x 安装 Redis
bash
# 1. 安装依赖(gcc、gcc-c++,Redis编译需要)
yum install -y gcc gcc-c++

# 2. 下载Redis 5.0.14安装包(官网地址,速度快)
wget http://download.redis.io/releases/redis-5.0.14.tar.gz

# 3. 解压安装包(解压到/usr/local目录下)
tar -zxvf redis-5.0.14.tar.gz -C /usr/local/

# 4. 进入解压后的目录,编译Redis
cd /usr/local/redis-5.0.14/
make

# 5. 安装Redis(安装到/usr/local/redis目录下)
make install PREFIX=/usr/local/redis

# 6. 复制Redis配置文件(默认配置文件在解压目录的redis.conf)
cp /usr/local/redis-5.0.14/redis.conf /usr/local/redis/conf/

# 7. 配置Redis环境变量(方便全局执行redis-server、redis-cli命令)
echo "export PATH=$PATH:/usr/local/redis/bin" >> /etc/profile
source /etc/profile

# 8. 验证Redis安装成功(执行以下命令,无报错即成功)
redis-server -v  # 查看Redis版本,输出Redis server v=5.0.14 sha=00000000:0 malloc=jemalloc-5.1.0 bits=64 build=0
redis-cli -v    # 查看Redis客户端版本,输出redis-cli 5.0.14
(2)Ubuntu 20.04 安装 Redis
bash
# 1. 更新软件源
apt update

# 2. 安装Redis(默认安装最新稳定版,若需5.0.14,可自行下载编译)
apt install -y redis-server

# 3. 验证Redis安装成功
redis-server -v  # 输出Redis server v=5.0.7 sha=00000000:0 malloc=jemalloc-5.2.1 bits=64 build=0
redis-cli -v    # 输出redis-cli 5.0.7

# 4. 查看Redis配置文件路径(Ubuntu默认路径)
ls /etc/redis/redis.conf  # 输出/etc/redis/redis.conf
3.1.3 多实例部署准备(核心:复制配置文件,修改端口)
本地多实例部署,核心是 "一个 Redis 安装包,多个配置文件,每个配置文件对应一个实例,端口不同",我们部署 2 个实例(后续可扩展为多个):
- 主节点(Master):端口 6379,使用默认配置文件(轻微修改);
- 从节点(Slave):端口 6380,复制默认配置文件,修改端口、守护进程等参数。
操作步骤(CentOS/Ubuntu 通用,路径根据自身系统调整):
bash
# 1. 进入Redis配置文件目录(CentOS路径)
cd /usr/local/redis/conf/

# 若为Ubuntu,进入默认配置文件目录
# cd /etc/redis/

# 2. 复制配置文件,命名为redis-slave-6380.conf(从节点6380的配置文件)
cp redis.conf redis-slave-6380.conf

# 3. 修改从节点配置文件(redis-slave-6380.conf),核心修改5个参数
# 用vim编辑配置文件,不懂vim的同学,可使用nano编辑(nano redis-slave-6380.conf)
vim redis-slave-6380.conf

# 3.1 修改端口(默认6379,改为6380,避免端口冲突)
port 6380

# 3.2 开启后台守护进程运行(必须开启,否则终端关闭,Redis实例停止)
daemonize yes

# 3.3 修改pid文件路径(每个实例的pid文件必须不同,避免冲突)
pidfile /var/run/redis_6380.pid

# 3.4 修改日志文件路径(每个实例的日志文件分开,方便排查错误)
logfile "/var/log/redis/redis-6380.log"

# 3.5 修改数据存储路径(每个实例的数据目录分开,避免数据混淆)
dir /var/lib/redis/6380

# 4. 创建日志文件和数据目录(避免启动时报错,权限不足)
# CentOS
mkdir -p /var/log/redis/
mkdir -p /var/lib/redis/6380
chmod 777 /var/log/redis/
chmod 777 /var/lib/redis/6380

# Ubuntu(默认已存在,若不存在,执行以下命令)
# mkdir -p /var/lib/redis/6380
# chmod 777 /var/lib/redis/6380

# 5. 修改主节点配置文件(redis.conf),开启后台守护进程(可选,方便后台运行)
vim redis.conf
daemonize yes # 将no改为yes关键提醒:主节点的配置文件,默认不需要做任何额外修改,只需要开启后台守护进程即可;所有修改,都只针对从节点!
3.2 三种主从配置方式
Redis 提供了三种配置主从关系的方式,效果完全一致,只是适用场景不同:
方式 1:配置文件配置(永久生效,生产环境推荐)
这种方式是将主从配置写入从节点的配置文件中,重启 Redis 实例后,主从关系依然保留,永久生效,适合生产环境稳定部署。
操作步骤
-
编辑从节点配置文件(redis-slave-6380.conf):
vim /usr/local/redis/conf/redis-slave-6380.conf # CentOS # vim /etc/redis/redis-slave-6380.conf # Ubuntu -
在配置文件末尾,添加以下配置(指定主节点的 IP 和端口):
# 格式:slaveof 主节点IP 主节点端口 # 本地部署,主节点IP为127.0.0.1,端口6379 slaveof 127.0.0.1 6379 -
启动主节点(6379):
redis-server /usr/local/redis/conf/redis.conf # CentOS # redis-server /etc/redis/redis.conf # Ubuntu -
启动从节点(6380):
redis-server /usr/local/redis/conf/redis-slave-6380.conf # CentOS # redis-server /etc/redis/redis-slave-6380.conf # Ubuntu -
验证主从关系是否建立成功。
优点与缺点
- 优点:永久生效,重启 Redis 实例后,主从关系不会丢失;配置集中,便于管理;适合生产环境;
- 缺点:修改配置后,需要重启 Redis 实例才能生效,不能动态调整。
方式 2:启动命令行配置(临时生效,测试环境推荐)
这种方式是在启动从节点时,通过--slaveof参数指定主节点的 IP 和端口,无需修改配置文件,快速搭建主从关系,临时生效,重启从节点后,主从关系丢失,适合本地测试、临时验证。
操作步骤(全程实战)
-
确保主节点已启动(6379):
redis-server /usr/local/redis/conf/redis.conf # CentOS # redis-server /etc/redis/redis.conf # Ubuntu -
启动从节点时,指定
--slaveof参数:# 格式:redis-server 从节点配置文件路径 --port 从节点端口 --slaveof 主节点IP 主节点端口 redis-server /usr/local/redis/conf/redis-slave-6380.conf --port 6380 --slaveof 127.0.0.1 6379 # CentOS # redis-server /etc/redis/redis-slave-6380.conf --port 6380 --slaveof 127.0.0.1 6379 # Ubuntu -
验证主从关系是否建立成功。
优点与缺点
- 优点:无需修改配置文件,快速搭建,适合测试;无需重启实例,即时生效;
- 缺点:临时生效,重启从节点后,主从关系丢失;不适合生产环境。
方式 3:Redis 命令行配置(动态生效,临时切换主节点推荐)
这种方式是在从节点启动后,通过 Redis 客户端(redis-cli)执行slaveof命令,动态指定主节点,无需修改配置文件,无需重启 Redis 实例,临时生效,重启从节点后,主从关系丢失,适合临时切主、故障恢复时的动态调整。
操作步骤
-
启动主节点(6379)和从节点(6380),此时从节点未配置主节点,是独立节点:
# 启动主节点 redis-server /usr/local/redis/conf/redis.conf # CentOS # redis-server /etc/redis/redis.conf # Ubuntu # 启动从节点(不指定--slaveof参数) redis-server /usr/local/redis/conf/redis-slave-6380.conf # CentOS # redis-server /etc/redis/redis-slave-6380.conf # Ubuntu -
连接从节点的 Redis 客户端:
redis-cli -p 6380 # 连接端口6380的从节点 -
在从节点客户端,执行
slaveof命令,指定主节点:127.0.0.1:6380> slaveof 127.0.0.1 6379 OK # 回复OK,说明主从关系配置成功 -
验证主从关系是否建立成功。
优点与缺点
- 优点:动态生效,无需修改配置文件,无需重启实例;可以快速切换主节点(比如主节点宕机,快速切换到其他主节点);
- 缺点:临时生效,重启从节点后,主从关系丢失;配置分散,不便于生产环境长期管理。
三种方式对比总结
| 配置方式 | 生效方式 | 重启后是否保留 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|---|---|
| 配置文件配置 | 永久生效 | 是 | 生产环境 | 永久生效、配置集中、便于管理 | 需要重启实例才能生效 |
| 启动命令行配置 | 临时生效 | 否 | 测试环境、临时验证 | 无需修改配置、快速搭建 | 重启后丢失、不适合生产 |
| Redis 命令行配置 | 动态生效 | 否 | 临时切主、故障恢复 | 动态调整、无需重启、快速切主 | 重启后丢失、配置分散 |
3.3 验证主从复制是否成功
配置完主从关系后,我们需要通过多种方法验证,确保主从复制正常工作,数据能够正常同步:
方法 1:查看主从节点进程(验证实例是否启动)
首先,验证主节点(6379)和从节点(6380)的 Redis 实例是否正常启动,进程是否存在:
# 查看Redis相关进程(CentOS/Ubuntu通用)
ps -ef | grep redis
正常输出(解析):
root      1234  0.0  0.1 141888  2048 ?        Ssl  10:00   0:00 redis-server 127.0.0.1:6379  # 主节点进程,端口6379
root      1235  0.0  0.1 141888  2048 ?        Ssl  10:01   0:00 redis-server 127.0.0.1:6380  # 从节点进程,端口6380
root      1236  0.0  0.0 112824   988 pts/0    S+   10:02   0:00 grep --color=auto redis
关键判断:存在两个 Redis 进程,分别对应端口 6379(主)和 6380(从),说明实例启动成功。
方法 2:查看端口监听(验证端口是否正常开放)
通过netstat命令,查看主从节点的端口是否正常监听,确保能够建立连接:
# 查看6379和6380端口的监听状态(CentOS/Ubuntu通用)
netstat -nlpt | grep -E "6379|6380"
正常输出(解析):
tcp        0      0 127.0.0.1:6379          0.0.0.0:*               LISTEN      1234/redis-server  # 6379端口监听,主节点
tcp        0      0 127.0.0.1:6380          0.0.0.0:*               LISTEN      1235/redis-server  # 6380端口监听,从节点
✅ 关键判断:两个端口都处于LISTEN状态,说明端口正常开放,能够接收连接。
方法 3:使用 info replication 命令(核心方法,查看复制状态)
info replication是查看主从复制状态的唯一核心命令,可以查看节点角色、主从连接状态、复制偏移量、从节点列表等所有关键信息,我们分别在主节点和从节点执行,逐行解析输出。
(1)主节点(6379)执行 info replication
# 连接主节点客户端
redis-cli -p 6379
# 执行info replication命令
127.0.0.1:6379> info replication
正常输出:
# Replication  # 复制相关信息的标识,以下所有字段都属于复制模块
role:master    # 节点角色:master(主节点),若为从节点,此处为slave
connected_slaves:1  # 当前连接的从节点数量:1个(我们只部署了1个从节点)
slave0:ip=127.0.0.1,port=6380,state=online,offset=100,lag=0  # 从节点详情(slave0表示第一个从节点,多个从节点会有slave1、slave2...)
# ip=127.0.0.1:从节点的IP地址(本地部署,所以是127.0.0.1)
# port=6380:从节点的端口
# state=online:从节点的状态(online=在线,offline=离线)
# offset=100:从节点当前的复制偏移量(表示从节点已经同步到主节点的第100字节数据)
# lag=0:从节点的延迟(单位:秒),0表示无延迟,延迟越低越好
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 主节点的复制ID(replid),唯一标识主节点的数据版本
master_replid2:0000000000000000000000000000000000000000  # 主节点的备用复制ID(replid2),主节点默认是0,只有从节点晋升为主节点后,才会有值
master_repl_offset:100  # 主节点当前的复制偏移量(表示主节点已经执行到第100字节的命令)
second_repl_offset:-1   # 备用复制偏移量,默认-1,无实际意义
repl_backlog_active:1   # 复制积压缓冲区的状态:1=开启,0=关闭(有从节点连接时,自动开启)
repl_backlog_size:1048576  # 复制积压缓冲区的大小:1048576字节=1MB(默认大小)
repl_backlog_first_byte_offset:1  # 复制积压缓冲区的起始偏移量
repl_backlog_histlen:100  # 复制积压缓冲区中已保存的数据长度:100字节(和主节点offset一致)
主节点正常状态判断:
- role=master;
- connected_slaves≥1(我们部署了 1 个,所以是 1);
- slave0 的 state=online;
- master_repl_offset 和 slave0 的 offset 一致(此处都是 100),说明数据同步正常。
(2)从节点(6380)执行 info replication
# 连接从节点客户端
redis-cli -p 6380
# 执行info replication命令
127.0.0.1:6380> info replication
正常输出:
# Replication
role:slave                 # 节点角色:slave(从节点)
master_host:127.0.0.1      # 主节点的IP地址(我们配置的主节点IP)
master_port:6379           # 主节点的端口(我们配置的主节点端口)
master_link_status:up      # 主从连接状态:up=正常,down=断开(核心判断字段)
master_last_io_seconds_ago:1  # 距离上次与主节点通信的时间:1秒(越小越好,说明通信频繁)
master_sync_in_progress:0  # 是否正在进行数据同步:0=未同步,1=正在同步(正常情况下是0)
slave_repl_offset:170      # 从节点当前的复制偏移量(和主节点的master_repl_offset一致,说明数据同步完成)
slave_priority:100         # 从节点的优先级(故障转移时,优先级越高,越容易被选为新主节点,默认100,值越小优先级越高)
slave_read_only:1          # 从节点的只读模式:1=开启,0=关闭(默认开启,禁止写操作)
connected_slaves:0         # 从节点连接的从节点数量:0(我们的从节点没有下属从节点)
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 主节点的复制ID(和主节点的master_replid完全一致,说明同步的是正确的主节点)
master_replid2:0000000000000000000000000000000000000000  # 备用复制ID(默认0,未切换过主节点)
master_repl_offset:170     # 主节点的复制偏移量(和自身的slave_repl_offset一致,说明数据同步正常)
second_repl_offset:-1
repl_backlog_active:1      # 复制积压缓冲区开启(从节点也会有缓冲区,用于切主时的同步)
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:170
从节点正常状态判断:
- role=slave;
- master_host 和 master_port 正确(127.0.0.1:6379);
- master_link_status=up;
- slave_repl_offset 和 master_repl_offset 一致;
- master_replid 和主节点的 master_replid 一致。
方法 4:数据同步测试(最直观,验证数据能否正常同步)
前面的方法都是查看状态,最直观的方法是 "主节点写入数据,从节点查询数据",验证数据能否正常同步,我们测试不同数据类型的同步(string、hash、list),确保所有数据类型都能正常同步。
测试 1:string 类型数据同步
# 主节点(6379)写入数据
127.0.0.1:6379> set name "redis-master"
OK
127.0.0.1:6379> set age 20
OK

# 从节点(6380)查询数据
127.0.0.1:6380> get name
"redis-master"  # 同步成功
127.0.0.1:6380> get age
"20"            # 同步成功
测试 2:hash 类型数据同步
# 主节点(6379)写入hash数据
127.0.0.1:6379> hset user:1 id 1 name zhangsan age 25
(integer) 3  # 成功写入3个字段

# 从节点(6380)查询hash数据
127.0.0.1:6380> hgetall user:1
1) "id"
2) "1"
3) "name"
4) "zhangsan"
5) "age"
6) "25"  # 同步成功
测试 3:list 类型数据同步
# 主节点(6379)写入list数据
127.0.0.1:6379> lpush list1 a b c d
(integer) 4  # 成功写入4个元素

# 从节点(6380)查询list数据
127.0.0.1:6380> lrange list1 0 -1
1) "d"
2) "c"
3) "b"
4) "a"  # 同步成功(lpush是从左边插入,所以查询结果是倒序)
测试 4:从节点写操作禁止(验证只读模式)
# 从节点(6380)执行写命令
127.0.0.1:6380> set name "redis-slave"
(error) READONLY You can't write against a read only slave.  # 报错,提示只读模式,不能写操作
关键判断:主节点写入的所有数据,从节点都能正常查询;从节点执行写命令报错,说明只读模式正常,主从复制工作正常。
3.4 断开复制与切主操作
在生产环境中,经常会遇到 "主节点宕机,需要切换从节点为主节点""需要更换主节点,将从节点切换到新主节点" 等场景,这就需要用到 "断开复制" 和 "切主操作"
3.4.1 断开主从复制(slaveof no one)
从节点执行slaveof no one命令,可以断开与当前主节点的复制关系,同时,从节点会晋升为主节点,不再同步原主节点的数据,但会保留原有同步过来的数据。
操作步骤
# 连接从节点(6380)客户端
redis-cli -p 6380

# 执行断开复制命令
127.0.0.1:6380> slaveof no one
OK  # 回复OK,说明断开成功

# 查看复制状态,验证从节点晋升为主节点
127.0.0.1:6380> info replication
输出解析(核心变化):
# Replication
role:master  # 角色从slave变为master,晋升为主节点
connected_slaves:0  # 没有连接的从节点(刚晋升,还未配置从节点)
master_replid:3a7b4c8d9e0f1a2b3c4d5e6f7a8b9c0d1e2f3a4b  # 生成了新的复制ID(不再和原主节点一致)
master_replid2:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 备用复制ID,保存原主节点的复制ID
master_repl_offset:200  # 复制偏移量继续累积
断开复制的核心流程
- 从节点断开与原主节点的 TCP 连接,停止接收原主节点的同步数据;
- 从节点的角色从
slave变为master,生成新的复制 ID(replid); - 从节点的备用复制 ID(replid2),保存原主节点的复制 ID,用于后续可能的重连、切主;
- 从节点保留原有同步过来的数据,不会清空;
- 从节点的只读模式依然开启(slave_read_only=1),若需要作为新主节点处理写请求,需要手动关闭只读模式(后续演示)。
注意事项
- 断开复制后,从节点晋升为主节点,但默认还是只读模式,不能处理写请求,需要手动关闭只读模式;
- 断开复制后,原主节点的
connected_slaves数量会减少 1(原主节点会检测到从节点下线,断开连接); - 断开复制后,若原主节点恢复,从节点(已晋升为主节点)不会自动重新同步原主节点的数据,需要手动执行
slaveof命令重新配置。
bash
redis-server /usr/local/redis/conf/redis-master-6381.conf  # CentOS
# redis-server /etc/redis/redis-master-6381.conf  # Ubuntu

# 5. 验证新主节点启动成功(查看进程和端口)
ps -ef | grep redis-6381  # 存在进程即成功
netstat -nlpt | grep 6381 # 端口处于LISTEN状态即成功-
确认原主节点(6379)已宕机(模拟生产故障):
# 停止原主节点(6379) redis-cli -p 6379 shutdown # 验证原主节点已宕机(无进程、无端口监听) ps -ef | grep redis-6379 # 无输出即宕机 netstat -nlpt | grep 6379 # 无输出即宕机 -
连接需要切主的从节点(6380),执行切主命令:
# 连接从节点(6380)客户端 redis-cli -p 6380 # 执行切主命令,切换到新主节点(6381) 127.0.0.1:6380> slaveof 127.0.0.1 6381 OK # 回复OK,说明切主命令执行成功,开始切换流程 -
验证切主是否成功(核心:查看从节点复制状态):
127.0.0.1:6380> info replication正常输出(重点看切主后的变化):
Replication
role:slave # 依然是从节点,只是主节点变了(切主后不会自动晋升为主节点,除非执行slaveof no one)
master_host:127.0.0.1 # 主节点IP变为新主节点(6381)的IP,与我们配置的新主节点一致
master_port:6381 # 主节点端口变为6381(核心变化,证明切主成功,不再连接原主节点6379)
master_link_status:up # 与新主节点的连接状态:up(正常),说明已成功与新主节点建立连接
master_last_io_seconds_ago:1 # 距离上次与新主节点通信的时间:1秒,通信正常
master_sync_in_progress:0 # 是否正在进行数据同步:0=未同步(已完成同步),若刚执行切主命令,此处会显示1(正在全量同步)
slave_repl_offset:50 # 从节点当前的复制偏移量,与新主节点的master_repl_offset(50)完全一致,说明同步完成
slave_priority:100 # 从节点优先级不变,依然是100
slave_read_only:1 # 只读模式依然开启,禁止写操作
connected_slaves:0 # 该从节点没有下属从节点(若为树形拓扑,此处会显示下属从节点数量)
master_replid:4c8d9e0f1a2b3c4d5e6f7a8b9c0d1e2f3a4b5c6d # 新主节点(6381)的复制ID,与新主节点执行info replication显示的master_replid完全一致
master_replid2:3a7b4c8d9e0f1a2b3c4d5e6f7a8b9c0d1e2f3a4b # 备用复制ID,保存上一个主节点(6380曾晋升的主节点)的复制ID,用于后续若再次切回原主节点的同步验证
master_repl_offset:50 # 新主节点的复制偏移量,与自身slave_repl_offset一致,数据同步正常
second_repl_offset:-1
repl_backlog_active:1 # 复制积压缓冲区开启,跟随新主节点的缓冲区配置
repl_backlog_size:1048576
repl_backlog_first_byte_offset:1
repl_backlog_histlen:50
切主成功核心判断:
master_host和master_port变为新主节点的 IP 和端口;master_link_status:up(与新主节点连接正常);master_replid与新主节点的master_replid完全一致;slave_repl_offset与新主节点的master_repl_offset完全一致。
切主操作的核心流程
切主操作不是简单的 "更换主节点 IP",而是有完整的内部流程,每一步都会影响数据和服务,结合我们上面的实战场景(从节点 6380 从 6379 切到 6381):
- 断开与旧主节点的连接:从节点(6380)收到
slaveof 127.0.0.1 6381命令后,立即断开与原主节点(6379)的 TCP 连接,停止接收原主节点的任何同步数据,无论原主节点是否在线(即使原主节点恢复,也不会再连接); - **清空自身所有数据:这是最关键、最容易被忽略的一步!从节点会彻底清空自身内存中所有已同步的数据(包括原主节点同步过来的 string、hash、list 等所有数据),目的是避免与新主节点的数据混淆,保证后续同步的数据与新主节点完全一致;**切主后,从节点(6380)查询之前同步的
name字段,会返回nil(数据已清空):
   127.0.0.1:6380> get name
(nil) # 数据已清空,与新主节点保持一致(新主节点6381未写入name字段)- 与新主节点建立连接并同步数据:从节点主动与新主节点(6381)建立 TCP 连接,执行完整的同步流程 ------ 由于是第一次与新主节点连接,会执行全量复制 (发送
PSYNC ? -1),接收新主节点的 RDB 文件、缓冲区命令,加载数据,完成同步; - 进入实时命令复制阶段:全量复制完成后,从节点跟随新主节点,进入实时同步状态,新主节点执行的所有写命令,都会实时同步到该从节点,保证数据一致。
切主操作的注意事项
-
数据清空的影响:切主会清空从节点所有数据,若从节点正在提供读服务,切主期间会出现 "读不到数据"(返回 nil),建议在业务低峰期执行切主操作,或提前做好数据备份;
-
新主节点的要求:新主节点必须是 "独立的主节点"(
role:master),不能是其他主节点的从节点(除非是树形拓扑的中间层从节点),否则会导致同步失败;错误场景:若新主节点(6381)本身是 6379 的从节点(role:slave),从节点 6380 切主到 6381,会报错:(error) ERR SLAVE OF is not allowed on a slave node # 提示:从节点不能作为其他从节点的主节点 -
切主后的验证:切主后,必须执行 3 步验证:① 查看
info replication确认连接和同步状态;② 新主节点写入数据,从节点查询验证同步;③ 从节点执行写命令,确认只读模式正常; -
多从节点切主:若有多个从节点需要切换到新主节点,需逐个执行切主命令,避免多个从节点同时向新主节点发起全量复制,拖垮新主节点;
-
原主节点恢复后的处理:切主后,若原主节点(6379)恢复,不会自动与从节点(6380)重新建立连接,若需要切回原主节点,需在从节点(6380)再次执行
slaveof 127.0.0.1 6379,并再次经历 "清空数据→全量同步" 的流程。
3.5 从节点只读模式详解
之前我们提到 "从节点默认只读",但很多同学会有疑问:"能不能关闭只读模式?关闭后有什么影响?"
3.5.1 只读模式的核心配置(两种配置方式)
从节点的只读模式由slave-read-only参数控制,默认值为yes(开启),支持两种配置方式:
-
配置文件配置(永久生效):
# 从节点配置文件(redis-slave-6380.conf) slave-read-only yes # 开启只读(默认),改为no即关闭 -
命令行配置(临时生效,重启失效):
# 连接从节点(6380)
redis-cli -p 6380
# 关闭只读模式
127.0.0.1:6380> config set slave-read-only no
OK
# 开启只读模式
127.0.0.1:6380> config set slave-read-only yes
OK
3.5.2 关闭只读模式的实战演示(为什么不建议关闭)
我们关闭从节点的只读模式,看看会发生什么,理解 "为什么生产环境绝对禁止关闭":
-
关闭从节点(6380)只读模式:
127.0.0.1:6380> config set slave-read-only no OK -
从节点(6380)写入数据:
127.0.0.1:6380> set age 30 OK # 关闭只读后,可正常写入数据 127.0.0.1:6380> get age "30" -
查看主节点(6381)的数据:
127.0.0.1:6381> get age (nil) # 主节点没有该数据,从节点的修改不会同步给主节点 -
主节点(6381)写入相同 key 的数据:
127.0.0.1:6381> set age 40 OK -
再次查看从节点(6380)的 age 字段:
127.0.0.1:6380> get age
"40"  # 主节点的修改会覆盖从节点的手动修改,导致从节点手动写入的数据丢失
3.5.3 关闭只读模式的危害
- 主从数据不一致:从节点手动写入的数据,不会同步给主节点,也不会同步给其他从节点,导致自身数据与主节点不一致;
- 数据丢失:主节点执行相同 key 的写命令时,会覆盖从节点手动写入的数据,导致从节点的手动修改丢失,无法恢复;
- 业务错乱:客户端从该从节点读取到 "不一致的数据",会导致业务逻辑错乱(比如查询到旧数据、错误数据),排查难度极大。
结论:无论什么场景,生产环境的从节点,必须保持只读模式开启 (slave-read-only=yes),禁止关闭!
3.6 网络传输延迟配置详解
之前提到repl-disable-tcp-nodelay参数控制主从网络传输效率,这里拆解参数作用、两种配置的实战效果、适用场景:
3.6.1 核心参数解析
# 从节点配置文件(redis-slave-6380.conf),主节点无需配置该参数
repl-disable-tcp-nodelay no # 默认值:no(开启TCP_NODELAY)- 参数值说明:
no= 开启 TCP_NODELAY,yes= 关闭 TCP_NODELAY; - 核心作用:控制主节点发送同步命令的 "实时性" 和 "带宽消耗",本质是 "trade-off(取舍)"------ 实时性和带宽消耗,二选一。
3.6.2 两种配置的实战对比
| 参数值 | 核心逻辑 | 主从延迟 | 带宽消耗 | 适用场景 | 实战效果演示 |
|---|---|---|---|---|---|
| no(默认,开启 TCP_NODELAY) | 主节点执行完写命令后,立即发送给从节点,不合并数据包,哪怕是 1 字节的小命令 | 极低(毫秒级),几乎无延迟 | 较大(每个小命令都单独发送,占用额外带宽) | 同机房、局域网部署(主从节点在同一机房,带宽充足,优先保证实时性) | 主节点执行set a 1,从节点几乎同时收到命令,slave_repl_offset立即同步,延迟≤1ms |
| yes(关闭 TCP_NODELAY) | 主节点会合并小数据包(默认等待 40ms,由 Linux 内核控制),将多个小命令合并成一个数据包发送 | 较高(约 40ms,取决于内核配置),延迟明显 | 较小(合并数据包,减少发送次数,节省带宽) | 跨机房、公网部署(主从节点在不同机房,带宽昂贵,优先节省带宽) | 主节点 1 秒内执行 10 个set小命令,主节点会合并成 1 个数据包,40ms 后发送给从节点,从节点延迟约 40ms |
3.6.3 生产配置建议
- 若主从节点在同一机房 / 局域网 (90% 的生产场景):保持默认值
repl-disable-tcp-nodelay no,优先保证主从数据实时性,机房带宽充足,无需担心带宽消耗; - 若主从节点在不同机房 / 跨公网 (特殊场景,如异地备份):修改为
repl-disable-tcp-nodelay yes,优先节省带宽,接受 40ms 左右的延迟,避免跨机房带宽被占满; - 补充:若跨机房部署,且想降低延迟,可修改 Linux 内核参数
tcp_delack_min(调整合并等待时间),但不建议新手操作,避免影响其他服务。
3.7 密码验证的完整实战
生产环境中,Redis 主节点必须设置密码(防止未授权访问),此时从节点必须配置masterauth参数,与主节点密码一致,否则无法建立主从连接,同步失败。
3.7.1 步骤 1:主节点(6379)设置密码(3 种方式,实战演示)
主节点设置密码,支持 3 种方式,与从节点的配置方式对应,生产推荐 "配置文件方式"(永久生效)。
方式 1:配置文件方式(永久生效,生产推荐)
# 编辑主节点配置文件(redis.conf)
vim /usr/local/redis/conf/redis.conf  # CentOS
# vim /etc/redis/redis.conf  # Ubuntu

# 添加/修改密码参数(任意位置,建议放在配置文件开头)
requirepass 123456  # 密码设为123456(生产环境建议设复杂密码,如Redis@2024!)

# 重启主节点(修改配置文件后,必须重启才能生效)
redis-cli -p 6379 shutdown  # 停止主节点
redis-server /usr/local/redis/conf/redis.conf  # 重启主节点
验证主节点密码:
# 连接主节点,未输入密码,执行命令报错
redis-cli -p 6379
127.0.0.1:6379> get name
(error) NOAUTH Authentication required.  # 提示需要密码验证

# 输入密码,验证成功
127.0.0.1:6379> auth 123456
OK
127.0.0.1:6379> get name
"redis-master"  # 可正常执行命令
方式 2:命令行方式(临时生效,重启失效,测试用)
# 连接主节点(已启动,未设密码)
redis-cli -p 6379
# 执行命令设置密码
127.0.0.1:6379> config set requirepass 123456
OK

# 验证密码(同上,需auth 123456才能执行命令)
❌ 缺点:主节点重启后,密码失效,恢复无密码状态,不适合生产。
方式 3:启动命令行参数(临时生效,重启失效,测试用)
# 启动主节点时,通过--requirepass参数设密码
redis-server /usr/local/redis/conf/redis.conf --requirepass 123456  # CentOS
# redis-server /etc/redis/redis.conf --requirepass 123456  # Ubuntu
3.7.2 步骤 2:从节点(6380)配置主节点密码(3 种方式,与主节点对应)
从节点需要配置masterauth参数,与主节点的requirepass密码一致,否则无法建立主从连接,同步失败。
方式 1:配置文件方式(永久生效,生产推荐)
# 编辑从节点配置文件(redis-slave-6380.conf)
vim /usr/local/redis/conf/redis-slave-6380.conf  # CentOS
# vim /etc/redis/redis-slave-6380.conf  # Ubuntu

# 添加/修改masterauth参数,与主节点密码一致
masterauth 123456

# 重启从节点(修改配置文件后,必须重启)
redis-cli -p 6380 shutdown
redis-server /usr/local/redis/conf/redis-slave-6380.conf --slaveof 127.0.0.1 6379  # CentOS
# redis-server /etc/redis/redis-slave-6380.conf --slaveof 127.0.0.1 6379  # Ubuntu
方式 2:命令行方式(临时生效,重启失效,测试用
# 连接从节点(已启动,未配置masterauth)
redis-cli -p 6380
# 执行命令配置masterauth
127.0.0.1:6380> config set masterauth 123456
OK
# 重新配置主从关系(使密码生效)
127.0.0.1:6380> slaveof 127.0.0.1 6379
OK
方式 3:启动命令行参数(临时生效,重启失效,测试用)
# 启动从节点时,通过--masterauth参数设密码
redis-server /usr/local/redis/conf/redis-slave-6380.conf --slaveof 127.0.0.1 6379 --masterauth 123456  # CentOS
# redis-server /etc/redis/redis-slave-6380.conf --slaveof 127.0.0.1 6379 --masterauth 123456  # Ubuntu
3.7.3 步骤 3:验证密码配置成功(核心,避免同步失败)
# 查看从节点(6380)的复制状态
127.0.0.1:6380> info replication
正常输出(核心判断):
master_link_status:up  # 连接正常,密码验证成功
master_host:127.0.0.1
master_port:6379
# 其他字段正常,slave_repl_offset与主节点一致
3.7.4 密码错误的故障场景
若从节点masterauth与主节点requirepass不一致,会导致主从连接失败,同步失败,我们实战模拟该场景,讲解排查和解决方法:
故障现象
-
从节点执行
info replication,显示master_link_status:down; -
从节点日志中出现报错(核心排查依据):
# 查看从节点日志(CentOS) cat /var/log/redis/redis-6380.log # 报错信息 1235:M 10 Feb 2026 11:30:00.000 * Connecting to MASTER 127.0.0.1:6379 1235:M 10 Feb 2026 11:30:00.001 * MASTER <-> REPLICA sync started 1235:M 10 Feb 2026 11:30:00.001 # Error: Authentication failed. # 关键报错:认证失败 1235:M 10 Feb 2026 11:30:01.000 * Retrying with SYNC after a failed PSYNC with target: master -
主节点执行
info replication,connected_slaves:0(未连接到从节点)。
故障原因
从节点masterauth参数值,与主节点requirepass参数值不一致(比如主节点密码 123456,从节点配置 12345)。
解决方法(3 步)
-
确认主节点密码:
redis-cli -p 6379 127.0.0.1:6379> auth 123456 OK 127.0.0.1:6379> config get requirepass # 查看主节点密码 1) "requirepass" 2) "123456" -
确认并修改从节点
masterauth:redis-cli -p 6380 127.0.0.1:6380> config get masterauth # 查看从节点当前配置的密码 1) "masterauth" 2) "12345" # 发现密码错误 127.0.0.1:6380> config set masterauth 123456 # 修改为正确密码 OK -
重新建立主从连接,验证恢复:
127.0.0.1:6380> slaveof 127.0.0.1 6379
OK
127.0.0.1:6380> info replication
master_link_status:up  # 连接正常,同步恢复
3.8 主从复制常见故障排查
学习主从复制,不仅要会配置、懂原理,还要会排查故障 ------ 生产环境中,主从复制很容易出现各种问题(同步失败、连接中断、数据不一致等)
故障 1:主从节点无法建立连接(master_link_status:down)
故障现象
- 从节点
info replication显示master_link_status:down; - 从节点日志报错:
Connecting to MASTER 127.0.0.1:6379 failed: Connection refused; - 主节点
info replication显示connected_slaves:0。
排查步骤(实战,一步一步来)
-
排查主节点是否正常运行:
ps -ef | grep redis-6379 # 查看主节点进程是否存在 netstat -nlpt | grep 6379 # 查看主节点端口是否监听 -
排查主节点 IP 和端口是否正确:
# 从节点查看当前配置的主节点IP和端口 127.0.0.1:6380> config get masterhost masterport 1) "masterhost" 2) "127.0.0.1" # 确认IP正确 3) "masterport" 4) "6379" # 确认端口正确 -
排查网络是否通畅(主从节点之间能否 ping 通、端口能否访问):
# 从节点所在服务器ping主节点IP(本地部署ping 127.0.0.1) ping 127.0.0.1 # 测试主节点端口是否可访问(用telnet) telnet 127.0.0.1 6379 # 若telnet成功,会显示Connected to 127.0.0.1;失败则显示Connection refused -
排查主节点是否设置密码,从节点是否配置 masterauth(参考 3.7.4)。
常见故障原因及解决方法
| 故障原因 | 解决方法 | |
|---|---|---|
| 主节点未启动 | 启动主节点:redis-server /usr/local/redis/conf/redis.conf | |
| 主节点端口冲突(6379 被其他进程占用) | 1. 查看占用 6379 端口的进程:netstat -nlpt | grep 6379;2. 停止该进程:kill -9 进程 ID;3. 重启主节点 |
| 从节点配置的主节点 IP / 端口错误 | 1. 命令行修改:config set masterhost 正确 IP、config set masterport 正确端口;2. 配置文件修改(永久生效),重启从节点 | |
| 主从节点之间网络不通(跨机房 / 防火墙拦截) | 1. 检查防火墙规则,开放主节点 6379 端口和从节点 6380 端口;2. 确认主从节点 IP 可互通 | |
| 主节点设密码,从节点未配置 masterauth | 从节点配置 masterauth,与主节点密码一致,重新建立主从连接 |
故障 2:主从连接正常,但数据同步失败(slave_repl_offset 与 master_repl_offset 不一致)
故障现象
- 从节点
info replication显示master_link_status:up,但slave_repl_offset远小于主节点的master_repl_offset; - 主节点写入新数据,从节点查询不到;
- 从节点日志报错:
MASTER <-> REPLICA sync failed: RDB transfer error。
排查步骤
-
查看从节点日志,确认同步失败的具体原因(核心排查依据):
cat /var/log/redis/redis-6380.log -
查看主节点是否正在执行 bgsave(全量复制时,主节点需要生成 RDB 文件):
127.0.0.1:6379> info persistence rdb_bgsave_in_progress:0 # 0=未执行,1=正在执行(若正在执行,等待执行完成) -
查看从节点的数据目录权限,是否有写入权限(RDB 文件无法保存):
# 查看从节点数据目录权限(CentOS) ls -ld /var/lib/redis/6380 # 若权限不足(如只有读权限),会显示dr--r--r--,需要修改权限 -
验证主节点是否有数据,从节点是否清空旧数据(切主后未同步,可能是数据未清空)。
常见故障原因及解决方法
| 故障原因 | 解决方法 |
|---|---|
| 主节点 bgsave 失败(无法生成 RDB 文件) | 1. 查看主节点日志,确认 bgsave 失败原因(如内存不足);2. 释放主节点内存(删除无用数据);3. 手动执行 bgsave:127.0.0.1:6379> bgsave;4. 重新建立主从连接 |
| 从节点数据目录权限不足(无法保存 RDB 文件) | 修改数据目录权限:chmod 777 /var/lib/redis/6380,重启从节点 |
| 主节点 RDB 文件损坏 | 1. 删除主节点损坏的 RDB 文件(默认路径 /var/lib/redis/dump.rdb);2. 手动执行 bgsave 生成新的 RDB 文件;3. 重新建立主从连接 |
| 主从节点 Redis 版本不一致(如主节点 7.0,从节点 5.0) | 升级从节点 Redis 版本,与主节点一致(Redis 版本向下兼容,但跨版本可能导致同步失败) |
故障 3:从节点执行写命令报错(READONLY You can't write against a read only slave)
故障现象
- 从节点执行写命令(如 set、del),报错:
(error) READONLY You can't write against a read only slave.; - 业务客户端从从节点读取数据正常,但写入数据失败。
故障原因
从节点默认开启只读模式(slave-read-only=yes),禁止执行写命令,这是 Redis 的默认规则,目的是保证主从数据一致。
解决方法(分场景)
- 若业务需要写入数据:禁止在从节点写入,将写请求转发到主节点,从节点只处理读请求;
- 若为测试场景,临时需要写入:关闭从节点只读模式(
config set slave-read-only no),但测试完成后,必须重新开启(config set slave-read-only yes); - 若误关闭了只读模式,导致数据不一致:执行
slaveof no one断开复制,再执行slaveof 主节点IP 主节点端口重新建立连接,从节点会清空数据,重新全量同步,恢复数据一致。
故障 4:主节点宕机后,从节点无法提供服务
故障现象
- 主节点宕机(进程消失、端口关闭);
- 从节点
info replication显示master_link_status:down; - 业务客户端从从节点读取数据正常,但写入数据失败(因为主节点宕机);
- 重新启动主节点后,从节点无法自动重新建立主从连接。
故障原因
- 主从复制没有 "自动故障转移" 功能,主节点宕机后,从节点不会自动晋升为主节点,也不会自动重新连接主节点;
- 从节点只读模式开启,无法处理写请求;
- 从节点与主节点断开连接后,不会自动重新建立连接(需要手动触发)。
解决方法(生产实战,两步恢复服务)
-
临时恢复写服务(将从节点晋升为主节点):
# 连接从节点(6380)
redis-cli -p 6380
# 断开与原主节点的连接,晋升为主节点
127.0.0.1:6380> slaveof no one
OK
# 关闭只读模式(允许处理写请求)
127.0.0.1:6380> config set slave-read-only no
OK
# 验证晋升成功
127.0.0.1:6380> info replication
role:master  # 已晋升为主节点
connected_slaves:0
✅ 此时,业务客户端可将写请求转发到 6380,读请求继续在 6380 处理,服务恢复正常。
-
主节点恢复后,重新建立主从关系(将原主节点作为从节点,同步新主节点数据):
# 启动原主节点(6379)
redis-server /usr/local/redis/conf/redis.conf

# 连接原主节点(6379)
redis-cli -p 6379
# 执行slaveof,将原主节点作为从节点,同步新主节点(6380)的数据
127.0.0.1:6379> slaveof 127.0.0.1 6380
OK
# 验证同步状态
127.0.0.1:6379> info replication
role:slave
master_host:127.0.0.1
master_port:6380
master_link_status:up  # 连接正常,同步恢复
✅ 恢复后,新主节点(6380)处理写请求,原主节点(6379)作为从节点,处理读请求,回到主从架构。
故障 5:复制积压缓冲区不足,导致频繁全量复制
故障现象
- 主从网络闪断后,重新连接,不是执行部分复制,而是执行全量复制;
- 主节点日志报错:
Replica requested PSYNC but offset is out of backlog; - 从节点日志报错:
Full resync from master requested because offset is out of backlog; - 频繁全量复制,导致主节点 CPU、内存、带宽占用过高,响应变慢。
故障原因
复制积压缓冲区默认大小为 1MB(repl_backlog_size=1048576),当主从网络中断时间过长,主节点执行的写命令过多,超过缓冲区大小,缓冲区中的旧命令被覆盖,从节点重连后,自身的offset不在缓冲区的可用范围内,主节点无法补发丢失的数据,只能执行全量复制。
解决方法(生产推荐)
-
调大复制积压缓冲区大小(根据业务写并发调整,一般设为 64MB~128MB):
# 主节点执行(临时生效,重启失效) 127.0.0.1:6379> config set repl_backlog_size 67108864 # 64MB(67108864字节) OK # 从节点也需要调大(临时生效) 127.0.0.1:6380> config set repl_backlog_size 67108864 OK -
配置文件修改(永久生效,生产推荐):
# 主节点配置文件(redis.conf) vim /usr/local/redis/conf/redis.conf repl_backlog_size 67108864 # 添加/修改为64MB # 从节点配置文件(redis-slave-6380.conf) vim /usr/local/redis/conf/redis-slave-6380.conf repl_backlog_size 67108864 # 重启主从节点,使配置生效 -
优化网络,减少网络中断时间(如部署在同一机房,检查网络稳定性,避免频繁闪断)。
✅ 配置建议:写并发越高、网络越不稳定,缓冲区设越大;一般 64MB 可满足绝大多数中小业务场景,写并发极高的场景(如每秒 10 万写 QPS),可设为 128MB。
故障 6:主从数据不一致(主节点有数据,从节点无数据 / 数据错误)
故障现象
- 主节点执行写命令后,从节点查询不到该数据,或数据不一致(如主节点
set a 1,从节点get a返回nil); - 主从节点
info replication显示slave_repl_offset与master_repl_offset一致,但数据依然不一致; - 从节点曾关闭过只读模式,手动写入过数据。
常见故障原因及解决方法
| 故障原因 | 解决方法 |
|---|---|
| 从节点曾关闭只读模式,手动写入数据,后被主节点命令覆盖 | 1. 断开从节点复制:slaveof no one;2. 清空从节点数据:flushall;3. 重新建立主从连接:slaveof 主节点 IP 主节点端口,全量同步恢复 |
| 主从同步过程中,从节点宕机,重启后未重新同步 | 1. 从节点重启后,执行 slaveof 主节点 IP 主节点端口;2. 查看 info replication,确认同步完成 |
主节点执行了flushall/flushdb命令,从节点同步失败 |
1. 若主节点有 RDB/AOF 备份,恢复主节点数据;2. 从节点重新建立主从连接,全量同步;3. 禁止在主节点手动执行 flushall/flushdb(风险极高) |
| 复制过程中,网络中断,部分命令未同步,且缓冲区被覆盖 | 1. 调大复制积压缓冲区;2. 从节点重新建立主从连接,全量同步;3. 优化网络 |
3.9 主从复制实战总结
- 配置原则:主节点不修改配置(仅开启守护进程、设密码),所有配置都在从节点;
- 三种配置方式:生产用 "配置文件方式"(永久生效),测试用 "命令行 / 启动参数方式"(临时生效);
- 核心验证命令:
info replication(查看主从状态)、ps -ef | grep redis(查看进程)、netstat -nlpt(查看端口); - 关键参数:
slaveof(配置主从)、masterauth(主节点密码)、slave-read-only=yes(只读模式)、repl_backlog_size(复制缓冲区)、repl-disable-tcp-nodelay(传输延迟); - 故障排查核心:先看日志,再用 info replication 排查,最后检查进程 / 端口 / 网络;
- 生产避坑:从节点只读模式禁止关闭、主节点必须设密码、复制缓冲区调大、避免频繁全量复制。
四、第三章:主从复制三大拓扑结构
前面我们讲解了主从复制的配置、故障排查,接下来详细拆解三种拓扑结构的实战部署步骤、性能对比、适用场景
4.1 一主一从结构
4.1.1 架构回顾
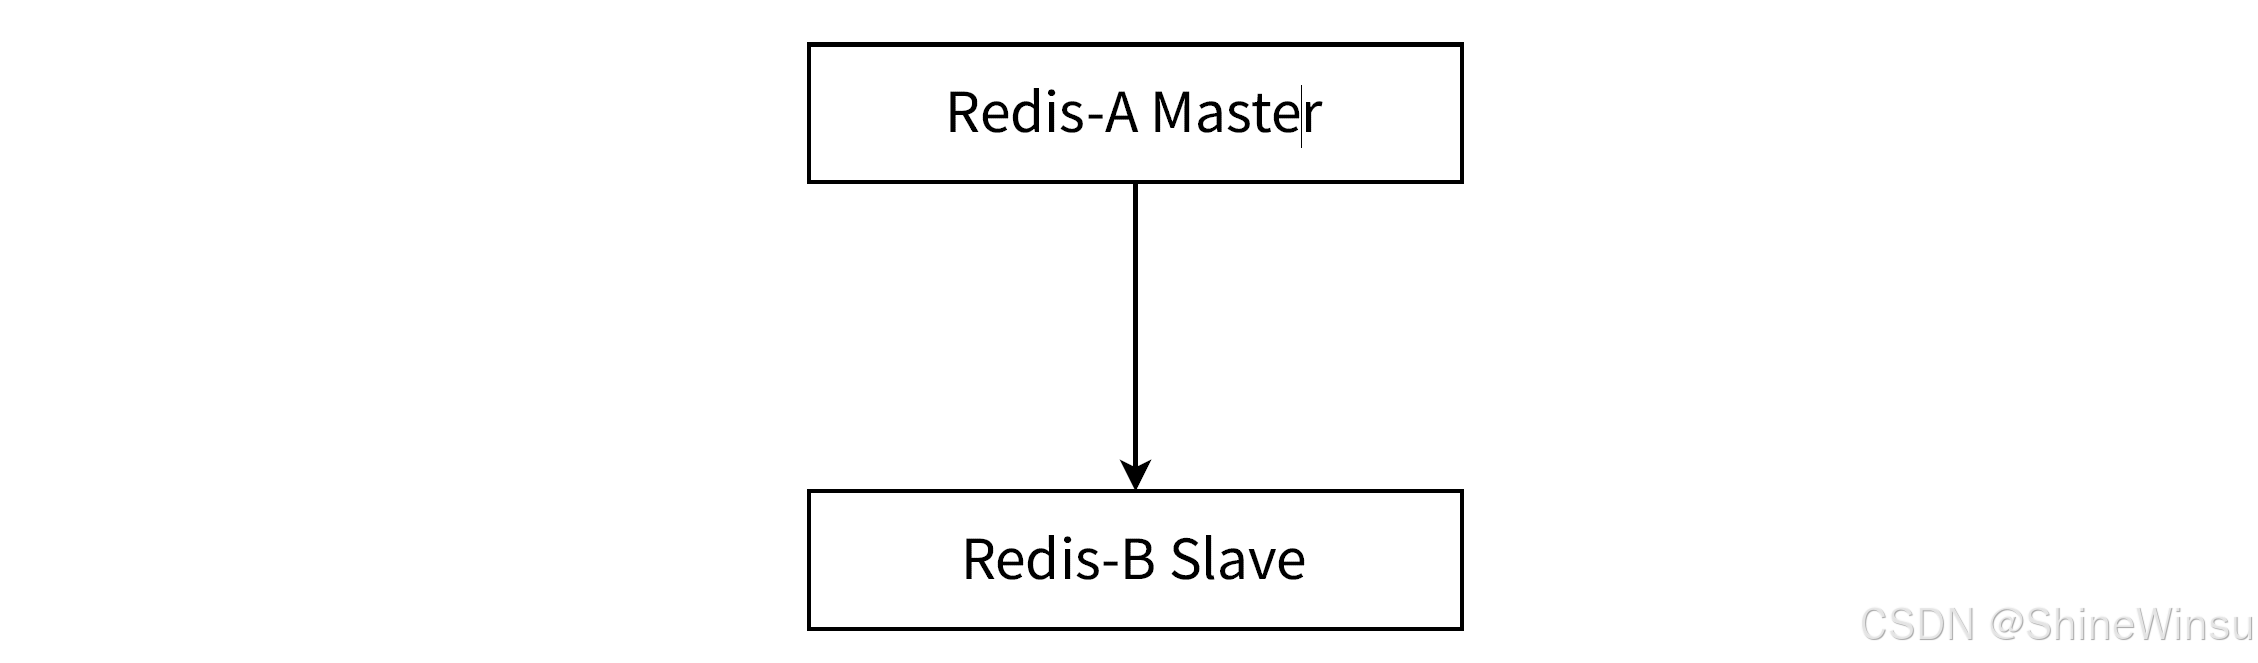
主节点(Master)6379(老师)
        ↓(知识传递=数据同步)
从节点(Slave)6380(助教)- 核心特点:1 主 1 从,从节点仅作为主节点的 "热备份"+"读请求分担者",不承担其他角色;
- 适用场景:小型业务、低并发场景(读 QPS≤1 万)、对可用性要求不高(可接受手动故障转移)。
4.1.2 实战部署步骤(完整,CentOS/Ubuntu 通用)
我们基于之前的部署基础,搭建一主一从架构,步骤如下:
-
部署主节点(6379):
# 1. 配置主节点(redis.conf) vim /usr/local/redis/conf/redis.conf # CentOS # vim /etc/redis/redis.conf # Ubuntu daemonize yes # 开启后台运行 requirepass 123456 # 设密码(生产必配) # 2. 启动主节点 redis-server /usr/local/redis/conf/redis.conf # 3. 验证主节点 redis-cli -p 6379 -a 123456 # 直接输入密码连接 127.0.0.1:6379> info replication role:master connected_slaves:0 # 暂无从节点,正常 -
部署从节点(6380):
# 1. 复制配置文件,修改参数 cp /usr/local/redis/conf/redis.conf /usr/local/redis/conf/redis-slave-6380.conf vim /usr/local/redis/conf/redis-slave-6380.conf # 修改核心参数 port 6380 # 端口6380 daemonize yes # 后台运行 pidfile /var/run/redis_6380.pid logfile "/var/log/redis/redis-6380.log" dir /var/lib/redis/6380 slaveof 127.0.0.1 6379 # 配置主节点 masterauth 123456 # 主节点密码 slave-read-only yes # 开启只读 repl_backlog_size 67108864 # 64MB缓冲区 repl-disable-tcp-nodelay no # 同机房,低延迟 # 2. 创建目录,修改权限 mkdir -p /var/lib/redis/6380 chmod 777 /var/lib/redis/6380 # 3. 启动从节点 redis-server /usr/local/redis/conf/redis-slave-6380.conf # 4. 验证从节点 redis-cli -p 6380 -a 123456 127.0.0.1:6380> info replication role:slave master_host:127.0.0.1 master_port:6379 master_link_status:up # 连接正常 slave_repl_offset:xxx # 与主节点一致 -
验证架构正常(数据同步 + 读写分离):
# 主节点写入数据
127.0.0.1:6379> set user:2 id 2 name lisi age 28
OK

# 从节点查询数据(读请求)
127.0.0.1:6380> hgetall user:2
1) "id"
2) "2"
3) "name"
4) "lisi"
5) "age"
6) "28"  # 同步成功

# 从节点执行写命令(禁止)
127.0.0.1:6380> set user:2 age 29
(error) READONLY You can't write against a read only slave.  # 正常报错
4.1.3 一主一从的优化配置
为提升可用性和性能,一主一从架构建议做如下优化(核心:主节点关持久化,从节点开持久化):
核心配置差异
| 节点类型 | 持久化配置 | 配置说明 |
|---|---|---|
| 主节点(redis.conf) | 关闭持久化 | save ""(关闭 RDB)appendonly no(关闭 AOF) |
| 从节点(redis-slave-6380.conf) | 开启持久化 | save 900 1(900 秒 1 次写操作生成 RDB)save 300 10(300 秒 10 次写操作生成 RDB)appendonly yes(开启 AOF)appendfilename "appendonly-6380.aof"(指定 AOF 文件名)appendfsync everysec(每秒同步 AOF,性能 + 安全兼顾) |
一主一从架构优点
- 配置简单、易部署维护:仅需配置 1 个从节点,拓扑设计简单,故障排查快,适合新手 / 小型业务;
- 数据备份 + 读写分离:从节点作为热备份,主节点故障可恢复数据;从节点分担读请求,缓解主节点压力;
- 资源消耗低:仅需 2 台服务器(生产)/2 个实例(测试),CPU / 内存 / 带宽占用少,部署成本低。
一主一从架构缺点
- 读并发能力有限:单从节点仅能分担部分读请求,读 QPS 上限约 2-3 万,无法支撑≥5 万 QPS 的高并发读场景;
- 可用性依赖手动切换:主节点宕机后,从节点无法自动晋升,需人工执行
slaveof no one+ 关闭只读,恢复服务需 1-5 分钟,期间写服务不可用; - 无冗余备份:仅 1 个从节点,若从节点宕机,主从同时失效,数据备份丢失风险高。
4.2 一主多从结构
4.2.1 架构说明
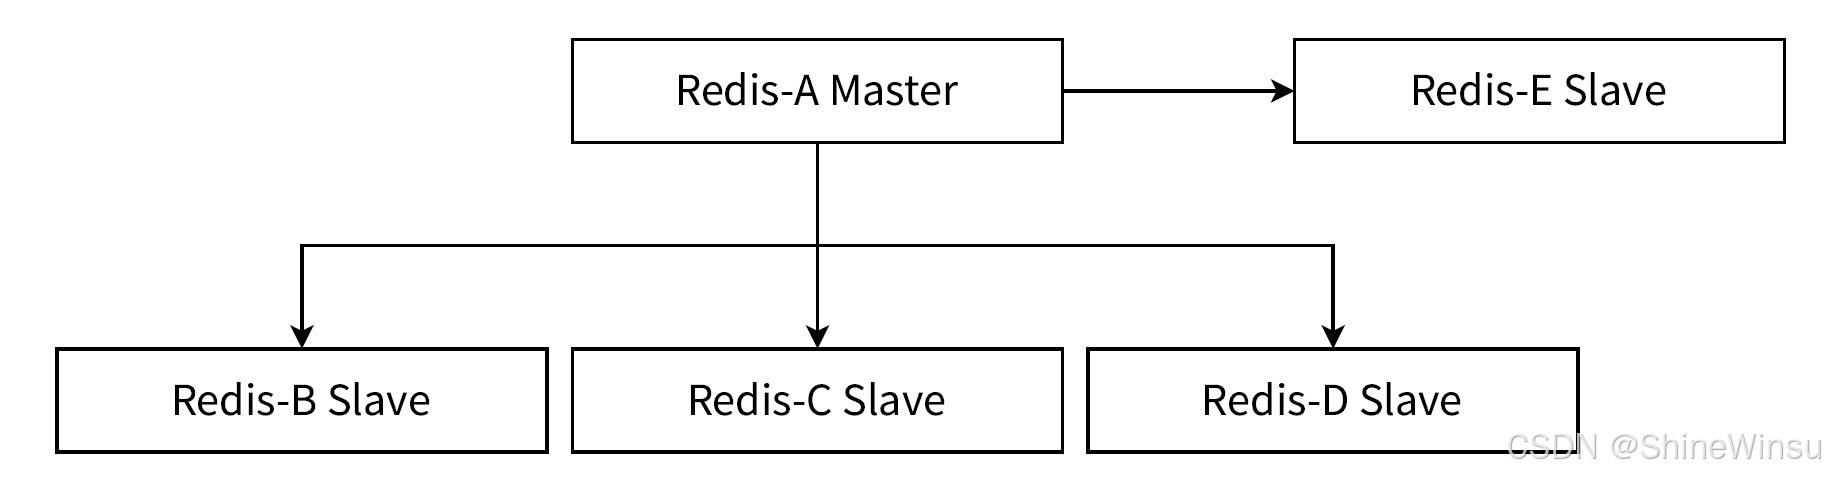
主节点(Master)6379(老师)
        ↓(数据同步)
从节点(Slave)6380(助教1)、6381(助教2)、6382(助教3)...(多个助教)核心特点:1 个主节点 + N 个从节点(N≥2,生产建议 2-5 个),所有从节点直接同步主节点数据;从节点承担读请求,主节点仅处理写请求。
适用场景:中大型业务、高并发读场景(读 QPS≥3 万)、对可用性有一定要求(多从节点冗余备份),如电商商品详情、资讯 APP 文章列表等读多写少场景。
4.2.2 实战部署步骤(基于一主一从扩展,CentOS/Ubuntu 通用)
在一主一从(6379 主、6380 从)基础上,新增 6381、6382 两个从节点,搭建一主三从架构,步骤如下:
步骤 1:新增从节点配置文件(6381、6382)
复制现有从节点配置文件,修改端口、pid、日志、数据目录等唯一参数:
# 进入Redis配置文件目录
# CentOS:
cd /usr/local/redis/conf/
# Ubuntu:
# cd /etc/redis/

# 1. 生成6381从节点配置文件
cp redis-slave-6380.conf redis-slave-6381.conf

# 2. 编辑6381配置文件,修改核心参数(仅改端口相关5项)
vim redis-slave-6381.conf
# 需修改的参数:
port 6381  # 端口改为6381
pidfile /var/run/redis_6381.pid  # pid文件改为6381
logfile "/var/log/redis/redis-6381.log"  # 日志文件改为6381
dir /var/lib/redis/6381  # 数据目录改为6381
# 其他参数(slaveof、masterauth、slave-read-only等)与6380一致,无需修改

# 3. 生成6382从节点配置文件
cp redis-slave-6380.conf redis-slave-6382.conf

# 4. 编辑6382配置文件,修改核心参数
vim redis-slave-6382.conf
# 需修改的参数:
port 6382  # 端口改为6382
pidfile /var/run/redis_6382.pid
logfile "/var/log/redis/redis-6382.log"
dir /var/lib/redis/6382
# 其他参数与6380一致
步骤 2:创建数据目录并修改权限
避免启动时报 "权限不足 / 目录不存在" 错误:
# CentOS(Ubuntu若目录不存在也执行)
mkdir -p /var/lib/redis/6381
mkdir -p /var/lib/redis/6382
chmod 777 /var/lib/redis/6381
chmod 777 /var/lib/redis/6382
步骤 3:启动新增从节点(6381、6382)
确保主节点(6379)已正常运行,再启动新从节点:
# 启动6381从节点
# CentOS:
redis-server /usr/local/redis/conf/redis-slave-6381.conf
# Ubuntu:
# redis-server /etc/redis/redis-slave-6381.conf

# 启动6382从节点
# CentOS:
redis-server /usr/local/redis/conf/redis-slave-6382.conf
# Ubuntu:
# redis-server /etc/redis/redis-slave-6382.conf
步骤 4:验证一主三从架构是否正常(4 步全覆盖)
验证 1:查看所有节点进程(确认实例启动)
ps -ef | grep redis正常输出(核心判断):
root      1234  0.0  0.1 141888  2048 ?        Ssl  10:00   0:00 redis-server 127.0.0.1:6379  # 主节点
root      1235  0.0  0.1 141888  2048 ?        Ssl  10:01   0:00 redis-server 127.0.0.1:6380  # 从节点6380
root      1236  0.0  0.1 141888  2048 ?        Ssl  10:02   0:00 redis-server 127.0.0.1:6381  # 从节点6381
root      1237  0.0  0.1 141888  2048 ?        Ssl  10:03   0:00 redis-server 127.0.0.1:6382  # 从节点6382
✅ 四个进程都存在 → 所有节点启动成功。
验证 2:查看主节点(6379)复制状态(确认从节点连接)
# 连接主节点
redis-cli -p 6379 -a 123456
# 执行复制状态查询
127.0.0.1:6379> info replication正常输出(核心解析):
# Replication
role:master
connected_slaves:3  # 连接的从节点数量为3(6380、6381、6382)
slave0:ip=127.0.0.1,port=6380,state=online,offset=200,lag=0
slave1:ip=127.0.0.1,port=6381,state=online,offset=200,lag=0
slave2:ip=127.0.0.1,port=6382,state=online,offset=200,lag=0
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06
master_replid2:0000000000000000000000000000000000000000
master_repl_offset:200
repl_backlog_active:1
repl_backlog_size:67108864  # 64MB缓冲区(优化项)
repl_backlog_first_byte_offset:1
repl_backlog_histlen:200
✅ 核心判断:connected_slaves=3,所有从节点state=online,offset与主节点一致。
验证 3:查看新增从节点(6381、6382)复制状态
# 连接6381从节点
redis-cli -p 6381 -a 123456
127.0.0.1:6381> info replication正常输出(核心解析):
# Replication
role:slave
master_host:127.0.0.1  # 主节点IP正确
master_port:6379       # 主节点端口正确
master_link_status:up  # 与主节点连接正常
slave_repl_offset:200  # 与主节点offset一致,同步正常
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06
slave_read_only:1      # 只读模式开启
connected_slaves:0     # 无下属从节点
验证 4:数据同步测试(主节点写入,所有从节点查询)
# 主节点(6379)写入新数据(hash类型)
127.0.0.1:6379> hset product:1 id 1 name "手机" price 3999 stock 100
(integer) 4

# 从节点6380查询
127.0.0.1:6380> hgetall product:1
1) "id"
2) "1"
3) "name"
4) "手机"
5) "price"
6) "3999"
7) "stock"
8) "100"  # 同步成功

# 从节点6381查询(结果与6380一致)
127.0.0.1:6381> hgetall product:1  # 同步成功

# 从节点6382查询(结果与6380一致)
127.0.0.1:6382> hgetall product:1  # 同步成功
✅ 所有从节点都能查询到主节点写入的数据,说明数据同步正常,一主三从架构部署成功。
4.2.3 一主多从架构的优化配置
在之前基础上,新增 3 个优化配置,进一步提升性能和可用性:
优化 1:主节点开启 "复制积压缓冲区" 自动扩容(Redis 5.0 + 支持)
# 主节点(6379)执行(临时生效)
127.0.0.1:6379> config set repl_backlog_ttl 3600  # 缓冲区空闲3600秒(1小时)后自动收缩到默认大小
OK
127.0.0.1:6379> config set repl_backlog_size 67108864  # 初始大小64MB
OK
✅ 核心作用:缓冲区自动根据实际需求扩容 / 收缩,避免缓冲区过小导致频繁全量复制,过大浪费内存。
优化 2:从节点开启 "只读 replicas"(Redis 6.0 + 支持)
# 从节点配置文件(redis-slave-6380.conf、6381.conf、6382.conf)
replica-read-only yes  # Redis 6.0+将slave-read-only改为replica-read-only,功能一致,推荐使用新参数
✅ 核心作用:与slave-read-only=yes一致,开启只读模式,Redis 6.0 + 推荐使用新参数,兼容性更好。
优化 3:配置从节点优先级,指定故障转移时的晋升顺序
# 从节点配置文件,给不同从节点设置不同优先级(值越小,优先级越高)
# 6380从节点(优先晋升为主节点)
slave-priority 50
# 6381从节点(次优先)
slave-priority 100
# 6382从节点(最低优先级)
slave-priority 150
✅ 核心作用:主节点宕机后,手动切换时,优先选择优先级高的从节点晋升为主节点(如 6380 优先),避免随意选择导致性能不足。
4.2.5 一主多从结构的优缺点
优点(4 点,生产核心优势)
- 读并发能力强:多个从节点分担读请求,读 QPS 可线性提升(如 3 个从节点,读 QPS 可达 6-9 万),支撑高并发读场景;
- 数据冗余备份:多个从节点,即使某个从节点宕机,其他从节点仍可提供读服务和数据备份,降低数据丢失风险;
- 主节点压力小:主节点仅处理写请求,读请求全部由从节点承担,主节点 CPU、内存、带宽压力大幅降低,提升写请求处理效率;
- 部署灵活:可根据读并发需求,动态新增从节点(无需修改主节点配置,仅需配置新从节点的
slaveof),扩容成本低。
缺点(3 点,生产避坑重点)
- 主节点是性能瓶颈和单点故障:所有写请求都集中在主节点,写并发过高(如每秒 10 万写 QPS)会导致主节点过载;主节点宕机后,所有写服务不可用,需要手动切换从节点为主节点;
- 主节点同步压力大:主节点需要向所有从节点同步数据,从节点数量越多,主节点的同步压力越大(CPU、带宽消耗越高),建议从节点数量不超过 5 个;
- 主从延迟风险:主节点写请求同步到多个从节点,可能出现延迟不一致(如某个从节点延迟 10ms,某个延迟 20ms),导致不同从节点返回的数据不一致(极端场景)。
4.3 树形拓扑结构(主 - 从 - 从,跨机房 / 读并发极高场景)
4.3.1 架构说明
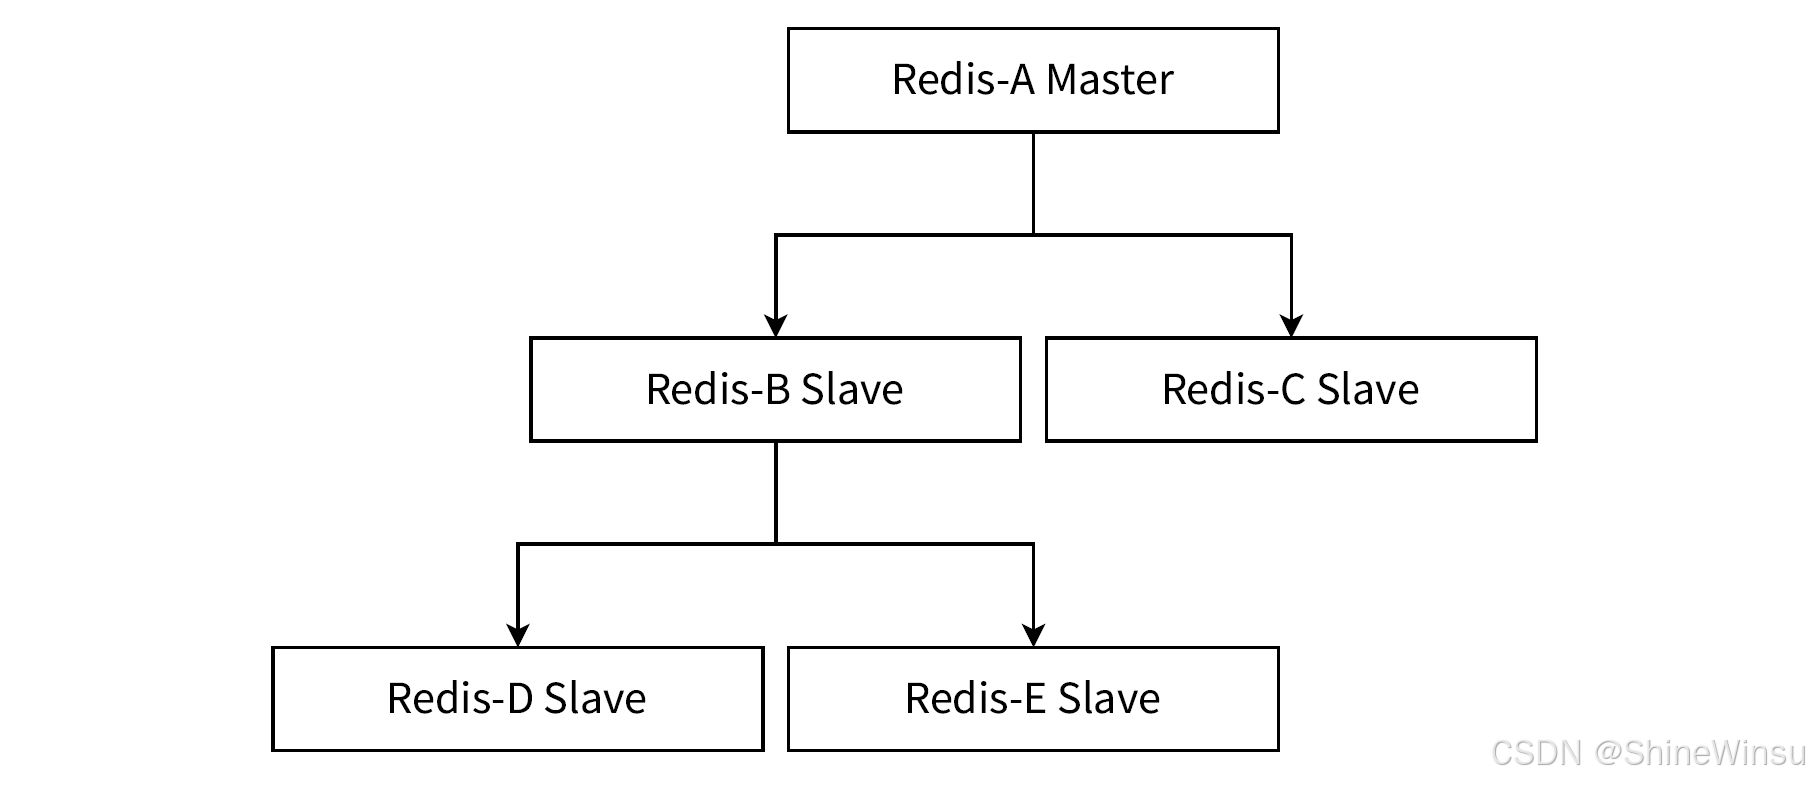
主节点(Master)6379(老师)
        ↓(数据同步)
从节点(Slave)6380(助教组长,中间层从节点)
        ↓(数据同步)
从节点(Slave)6381(助教)、6382(助教)...(下层从节点)- 核心特点:1 个主节点 + 1 个(或多个)中间层从节点 + N 个下层从节点;主节点仅同步数据到中间层从节点,中间层从节点同步数据到下层从节点;中间层从节点既承担读请求,又作为 "二级主节点",转发主节点的数据到下层从节点;
- 适用场景:跨机房部署(如主节点 + 中间层从节点在机房 A,下层从节点在机房 B)、读并发极高(读 QPS≥10 万)、主节点同步压力过大(从节点数量超过 5 个)的场景。
4.3.2 实战部署步骤(基于一主多从扩展,CentOS/Ubuntu 通用)
我们搭建 "1 主 1 中间层 2 下层" 的树形拓扑:
- 主节点:6379(机房 A,仅处理写请求,同步数据到 6380);
- 中间层从节点:6380(机房 A,同步 6379 数据,转发到 6381、6382,承担部分读请求);
- 下层从节点:6381、6382(机房 B,同步 6380 数据,承担大部分读请求)。
步骤 1:修改中间层从节点(6380)配置,开启复制转发
中间层从节点需要开启 "复制转发" 功能,才能将主节点同步过来的数据,转发到自身的从节点(6381、6382),默认情况下,Redis 从节点不会转发数据,需手动开启:
# 编辑中间层从节点(6380)配置文件
vim /usr/local/redis/conf/redis-slave-6380.conf  # CentOS
# Ubuntu:vim /etc/redis/redis-slave-6380.conf

# 添加/修改以下参数,开启复制转发(Redis 5.0+参数)
replica-serve-stale-data yes  # 从节点同步期间,允许返回旧数据(避免读请求报错)
replica-read-only yes  # 依然开启只读模式(中间层从节点也禁止写操作)
repl-diskless-sync yes  # 开启无磁盘同步(可选,提升同步效率,减少磁盘IO)
repl-diskless-sync-delay 5  # 无磁盘同步延迟5秒(等待所有下层从节点连接)

# 关键参数:开启复制转发(Redis 3.2+支持,旧版本用slave-skip-min-slaves-to-write)
replica-forwarded-commands yes  # 开启复制转发,中间层从节点会将主节点的同步命令,转发到下层从节点
✅ 注意:中间层从节点的slaveof参数依然是127.0.0.1 6379,同步主节点数据,无需修改。
步骤 2:重启中间层从节点(6380),使配置生效
# 停止6380从节点
redis-cli -p 6380 -a 123456 shutdown

# 重启6380从节点(CentOS)
redis-server /usr/local/redis/conf/redis-slave-6380.conf
# Ubuntu:redis-server /etc/redis/redis-slave-6380.conf

# 验证中间层从节点配置(确认复制转发开启)
redis-cli -p 6380 -a 123456
127.0.0.1:6380> config get replica-forwarded-commands
1) "replica-forwarded-commands"
2) "yes"  # 已开启,正确
步骤 3:修改下层从节点(6381、6382)配置,同步中间层从节点
之前我们的 6381、6382 是同步主节点 6379,现在修改为同步中间层从节点 6380,步骤如下:
(1)修改 6381 从节点配置
vim /usr/local/redis/conf/redis-slave-6381.conf  # CentOS
# Ubuntu:vim /etc/redis/redis-slave-6381.conf

# 修改slaveof参数,从同步6379改为同步6380
slaveof 127.0.0.1 6380  # 同步中间层从节点6380
# masterauth参数不变(依然是123456,与主节点密码一致,因为中间层从节点转发的命令需要密码验证)
masterauth 123456
# 其他参数(port、pid、log等)不变
(2)修改 6382 从节点配置
vim /usr/local/redis/conf/redis-slave-6382.conf  # CentOS
# Ubuntu:vim /etc/redis/redis-slave-6382.conf

# 修改slaveof参数,同步中间层从节点6380
slaveof 127.0.0.1 6380
masterauth 123456
# 其他参数不变
步骤 4:重启下层从节点(6381、6382),使配置生效
# 停止6381从节点
redis-cli -p 6381 -a 123456 shutdown
# 重启6381(CentOS)
redis-server /usr/local/redis/conf/redis-slave-6381.conf

# 停止6382从节点
redis-cli -p 6382 -a 123456 shutdown
# 重启6382(CentOS)
redis-server /usr/local/redis/conf/redis-slave-6382.conf
步骤 5:验证树形拓扑架构是否正常
验证 1:查看主节点(6379)复制状态(仅连接中间层从节点 6380)
127.0.0.1:6379> info replication正常输出(核心解析):
role:master
connected_slaves:1  # 仅连接1个从节点(6380,中间层),下层从节点(6381、6382)不直接连接主节点
slave0:ip=127.0.0.1,port=6380,state=online,offset=300,lag=0
master_repl_offset:300
# 其他参数正常
✅ 核心判断:connected_slaves=1,仅 6380 连接主节点,符合树形拓扑逻辑。
验证 2:查看中间层从节点(6380)复制状态(连接主节点 + 下层从节点)
127.0.0.1:6380> info replication正常输出(核心解析):
# Replication
role:slave  # 依然是从节点(同步主节点6379)
master_host:127.0.0.1
master_port:6379
master_link_status:up  # 与主节点连接正常
slave_repl_offset:300  # 与主节点offset一致,同步正常
connected_slaves:2  # 连接2个下层从节点(6381、6382),作为中间层主节点
slave0:ip=127.0.0.1,port=6381,state=online,offset=300,lag=0  # 下层从节点6381
slave1:ip=127.0.0.1,port=6382,state=online,offset=300,lag=0  # 下层从节点6382
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 与主节点replid一致
replica-forwarded-commands:yes  # 复制转发已开启
✅ 核心判断:role=slave(同步主节点),connected_slaves=2(连接下层从节点),复制转发开启,符合中间层角色定位。
验证 3:查看下层从节点(6381、6382)复制状态(同步中间层 6380)
127.0.0.1:6381> info replication正常输出(核心解析):
role:slave
master_host:127.0.0.1  # 主节点IP改为6380(中间层),不再是6379
master_port:6380       # 主节点端口改为6380
master_link_status:up  # 与中间层从节点连接正常
slave_repl_offset:300  # 与中间层、主节点offset一致,同步正常
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 与主节点replid一致(中间层转发的)
slave_read_only:1
connected_slaves:0
✅ 6382 从节点验证方法相同,输出与 6381 一致,说明下层从节点同步正常。
验证 4:数据同步测试(主节点写入,所有从节点查询)
# 主节点(6379)写入新数据(list类型)
127.0.0.1:6379> lpush order:list 1001 1002 1003 1004
(integer) 4

# 中间层从节点(6380)查询
127.0.0.1:6380> lrange order:list 0 -1
1) "1004"
2) "1003"
3) "1002"
4) "1001"  # 同步成功(主节点→中间层)

# 下层从节点6381查询
127.0.0.1:6381> lrange order:list 0 -1  # 同步成功(中间层→下层)

# 下层从节点6382查询
127.0.0.1:6382> lrange order:list 0 -1  # 同步成功(中间层→下层)
✅ 所有从节点(中间层、下层)都能查询到主节点写入的数据,说明数据转发、同步正常,树形拓扑生效。
验证 5:复制转发测试(中间层同步主节点命令,转发到下层)
# 主节点(6379)执行删除命令
127.0.0.1:6379> del order:list
(integer) 1

# 中间层从节点(6380)查询,确认删除
127.0.0.1:6380> lrange order:list 0 -1
(empty list or set)  # 已删除

# 下层从节点6381查询,确认删除(中间层转发了删除命令)
127.0.0.1:6381> lrange order:list 0 -1
(empty list or set)  # 已删除
✅ 主节点的删除命令,通过中间层从节点转发到下层从节点,所有从节点数据同步删除,说明复制转发功能正常。
4.3.4 树形拓扑结构的优缺点
优点
- 降低主节点同步压力:主节点仅同步数据到中间层从节点,无需同步到所有下层从节点,从节点数量再多,也不会大幅增加主节点的 CPU、带宽消耗;
- 节省跨机房带宽:跨机房部署时,主节点仅需发送 1 份数据到中间层从节点,中间层转发到下层从节点,避免多份数据跨机房传输,节省昂贵的跨机房带宽;
- 读并发能力极强:下层从节点数量可灵活扩展(如 10 个 +),读 QPS 可突破 10 万,支撑超高并发读场景;
- 跨机房部署友好:解决跨机房同步延迟高、带宽消耗大的问题,实现 "主机房写、从机房读",提升从机房业务的访问速度(就近读)。
缺点
- 架构复杂、维护成本高:涉及主节点、中间层从节点、下层从节点,配置、故障排查都比一主多从复杂(如中间层从节点宕机,所有下层从节点同步失败);
- 中间层从节点是单点故障:中间层从节点宕机后,所有下层从节点无法同步数据,读服务可能受影响(若下层从节点有持久化,可临时提供读服务,但数据不会更新);
- 主从延迟叠加:主节点→中间层从节点有延迟,中间层→下层从节点有延迟,总延迟是两者之和(如主→中间层 10ms,中间层→下层 10ms,总延迟 20ms),延迟比一主多从高;
- 配置复杂:中间层从节点需要开启复制转发,下层从节点需要配置正确的同步对象,跨机房部署还需要配置防火墙、公网 IP,对运维能力要求较高。
4.4 三种拓扑结构对比总结
| 拓扑结构 | 架构示意图 | 核心优点 | 核心缺点 | 适用场景 | 生产部署建议 |
|---|---|---|---|---|---|
| 一主一从 | 主 6379→从 6380 | 1. 配置简单、易维护;2. 资源消耗低;3. 实现基础备份与读写分离 | 1. 读并发有限(≤3 万 QPS);2. 无冗余备份;3. 手动故障转移 | 小型业务、低并发读、对可用性要求不高(如小型网站、内部系统) | 测试 / 小型生产,用 2 台服务器,主节点关闭持久化,从节点开启持久化 |
| 一主多从 | 主 6379→从 6380、6381、6382 | 1. 读并发强(≤9 万 QPS);2. 数据冗余备份;3. 主节点压力小;4. 扩容灵活 | 1. 主节点是单点故障;2. 主节点同步压力大(从节点≤5 个);3. 主从有毫秒级延迟 | 中大型业务、高并发读、读多写少(如电商、资讯 APP、社交平台) | 生产首选,用 3-6 台服务器,主节点关闭持久化,从节点开启持久化,从节点数量 2-5 个 |
| 树形拓扑 | 主 6379→中间层 6380→下层 6381、6382 | 1. 主节点同步压力极低;2. 节省跨机房带宽;3. 读并发极强(≤10 万 + QPS);4. 跨机房友好 | 1. 架构复杂、维护成本高;2. 中间层是单点故障;3. 主从延迟叠加 | 超高并发读、跨机房部署、从节点数量 > 5 个(如大型电商、全国性 APP) | 跨机房 / 超高并发场景,用 6 台以上服务器,中间层从节点至少 2 个(避免单点),跨机房关闭 TCP_NODELAY |
五、第四章:主从复制底层原理深度拆解
前面我们讲解了主从复制的配置、拓扑、故障排查,都是 "实战层面" 的内容,接下来拆解 "底层原理"------ 为什么主节点的数据能同步到从节点?全量复制和部分复制的区别是什么?PSYNC 命令如何工作?
5.1 主从复制的核心同步流程
无论哪种拓扑结构,主从复制的核心同步流程都分为 "三个阶段",全程结合 "老师 - 助教" 类比,让大家直观理解:
- 建立连接阶段(握手阶段):助教(从节点)主动找到老师(主节点),说明 "我要跟随你,同步你的知识(数据)",老师确认身份(密码验证)后,与助教建立连接;
- 数据同步阶段(核心阶段):老师根据助教的情况(首次跟随 / 中途走神),决定是 "把所有课件都抄给助教(全量复制)",还是 "只把助教漏抄的几页课件给助教(部分复制)",助教接收课件(数据),并保存起来;
- 实时同步阶段(维持阶段):后续老师讲的新内容(主节点执行的写命令),都会实时抄给助教(从节点),助教实时更新自己的课件(数据),确保与老师的课件完全一致,同时,助教和老师会定期确认 "对方是否在线"(心跳检测)。
简单总结:连接→同步(全量 / 部分)→实时同步 + 心跳检测,这三个阶段循环往复,维持主从复制正常运行。
5.2 建立连接阶段
建立连接阶段,是主从复制的第一步,核心是 "从节点主动发起连接,主节点验证身份,建立 TCP 连接,协商同步参数":
5.2.1 建立连接的 5 个详细步骤
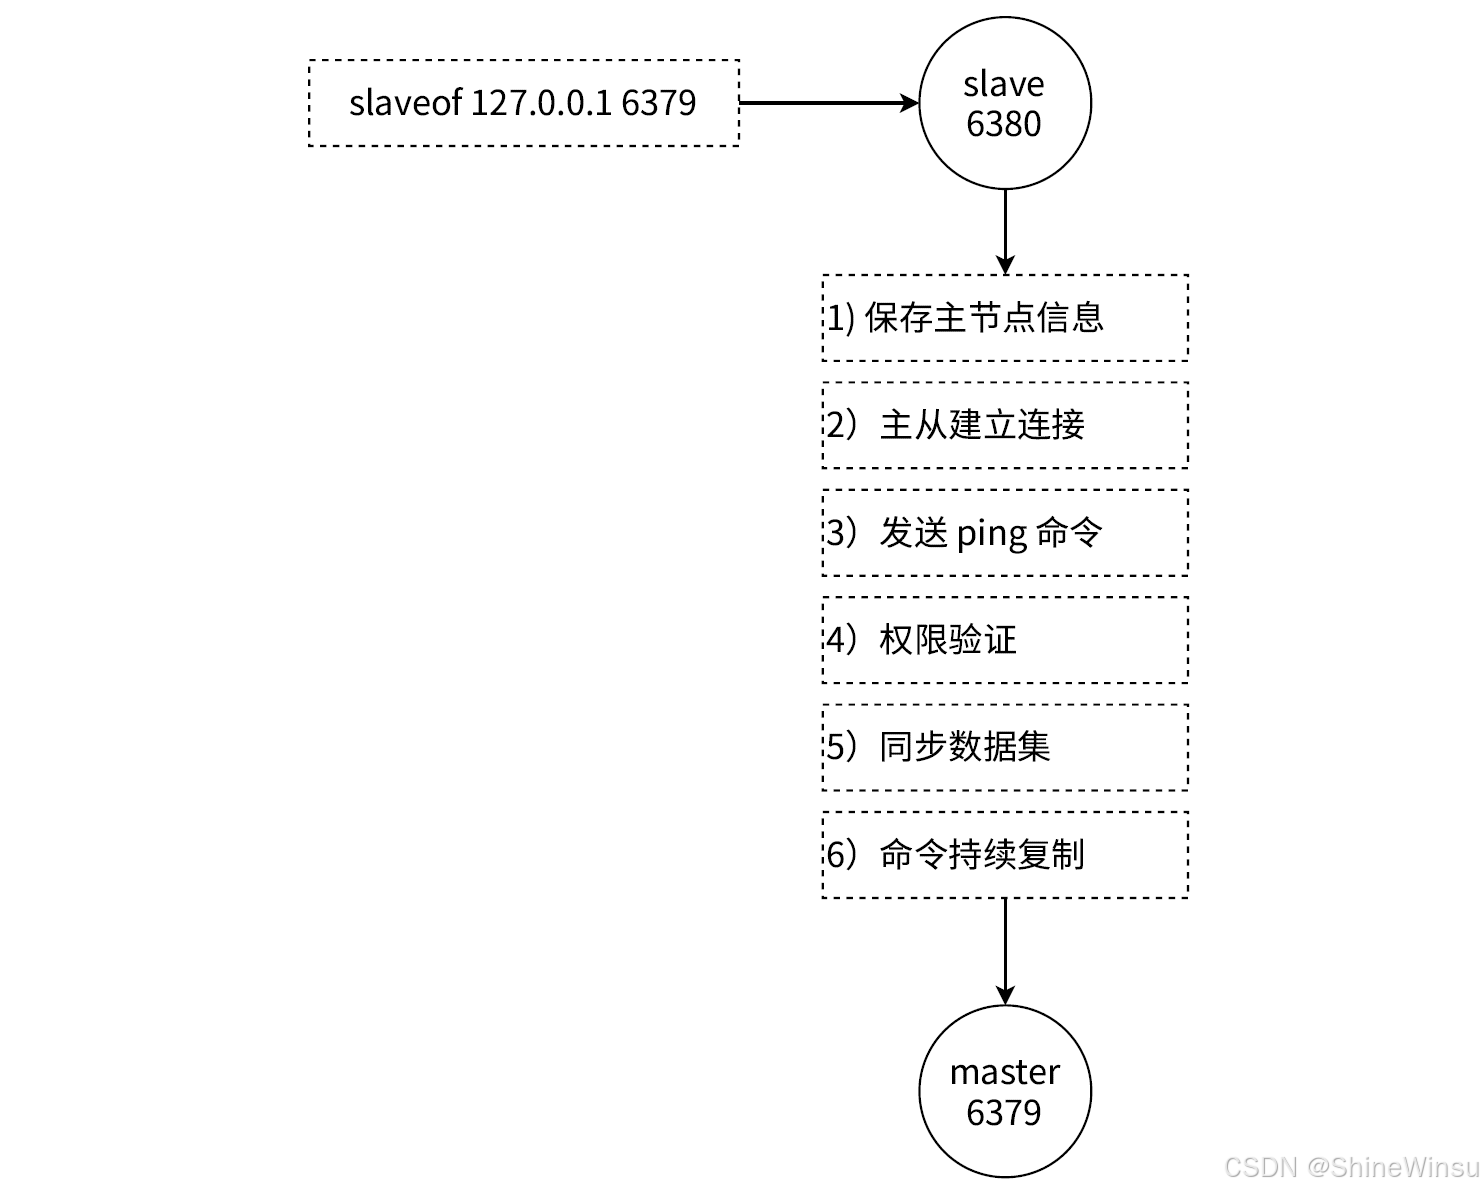
| 步骤 | 通俗类比(老师 - 助教) | 技术细节(实战解析) | 实战验证方法 |
|---|---|---|---|
| 步骤 1:从节点发起连接请求 | 助教找到老师,说 "我要跟随你,同步你的知识" | 从节点执行slaveof 主节点IP 主节点端口命令(配置文件 / 命令行),主动向主节点发起 TCP 连接请求,请求端口为住节点的 Redis 端口(6379) |
从节点日志会显示:Connecting to MASTER 127.0.0.1:6379 |
| 步骤 2:主节点接收连接请求 | 老师停下讲课,问助教 "你是谁?(验证身份)" | 主节点收到从节点的 TCP 连接请求后,创建一个新的客户端连接(专门用于与该从节点通信),并向从节点发送 "欢迎连接" 的响应 | 主节点日志会显示:Accepted repl connection from 127.0.0.1:xxxx(xxxx 是从节点的随机端口) |
| 步骤 3:密码验证(若主节点设密码) | 助教出示学生证(身份验证),老师确认无误 | 从节点向主节点发送AUTH 密码命令(密码由masterauth配置),主节点验证密码是否正确,若正确,进入下一步;若错误,拒绝连接 |
密码错误时,从节点日志显示:Error: Authentication failed;正确则显示:MASTER <-> REPLICA sync started |
| 步骤 4:协商同步参数 | 老师问助教 "你之前有没有跟随过其他老师?有没有漏抄的课件?",助教回答 "没有 / 有,漏抄到第 100 页" | 从节点向主节点发送自身的 "复制偏移量(offset)" 和 "复制 ID(replid)",告知主节点 "我当前的同步进度";主节点根据从节点的 offset 和 replid,决定执行全量复制还是部分复制 | 从节点执行info replication,可查看自身的slave_repl_offset和master_replid |
| 步骤 5:建立同步关系,进入数据同步阶段 | 老师确认后,说 "好,我现在把课件给你",助教准备接收 | 主节点确认从节点的同步进度后,标记该从节点为 "已连接从节点",更新自身的connected_slaves计数;从节点标记自身为 "slave",更新master_host、master_port等参数,双方进入数据同步阶段 |
主节点info replication显示该从节点state=online;从节点info replication显示master_link_status=up |
5.2.2 实战演示:建立连接的全过程(查看日志)
我们通过查看主从节点的日志,直观看到建立连接的每一步,实战验证:
(1)从节点(6380)日志(建立连接的关键信息)
cat /var/log/redis/redis-6380.log # CentOS5.2.3 建立连接阶段的关键注意事项(实战必避坑)
- 从节点发起连接后,会自动清空自身所有数据 (日志中 "Flushing old data"),目的是避免与主节点数据混淆,无论从节点之前是否有数据,都会被清空;❌ 错误场景:从节点有重要数据,未备份就执行
slaveof命令,导致数据丢失,无法恢复;✅ 解决方案:执行slaveof命令前,先备份从节点数据(save生成 RDB,或bgsave)。 - 主节点接收从节点连接后,会创建一个专门的客户端连接用于同步,该客户端仅处理复制相关命令(如发送 RDB、写命令),不处理普通业务客户端的请求;
- 密码验证失败时,从节点会持续重试连接(默认每 1 秒重试一次),日志中会反复出现 "Authentication failed",直到密码配置正确;
- 从节点执行
slaveof no one后,会断开与主节点的连接,晋升为独立主节点,此时再执行slaveof 主节点IP 端口,会再次发起连接,清空自身数据,重新同步。
5.3 数据同步阶段(核心阶段)------ 全量复制(首次同步 / 重大同步)
数据同步阶段分为 "全量复制" 和 "部分复制",其中全量复制是最核心、最耗时的同步方式,适用于
- "从节点首次同步主节点"
- "从节点 offset 超出主节点复制缓冲区范围"
- "从节点 replid 与主节点不一致"
三种场景
5.3.1 全量复制的通俗类比(老师 - 助教)
助教是第一次跟随老师,没有任何之前的课件(数据),老师需要:① 先把自己所有的课件(主节点所有数据)整理成一本手册(RDB 文件);② 把手册抄给助教(发送 RDB 文件);③ 助教收到手册后,把手册上的内容全部抄到自己的笔记本上(加载 RDB 文件);④ 老师在整理手册的过程中,新讲的内容(主节点执行的写命令),单独记在一张纸上,等助教抄完手册后,再把这张纸上的内容抄给助教(发送缓冲区命令);⑤ 助教抄完所有内容后,笔记本上的内容就和老师完全一致了。
5.3.2 全量复制的 6 个详细步骤
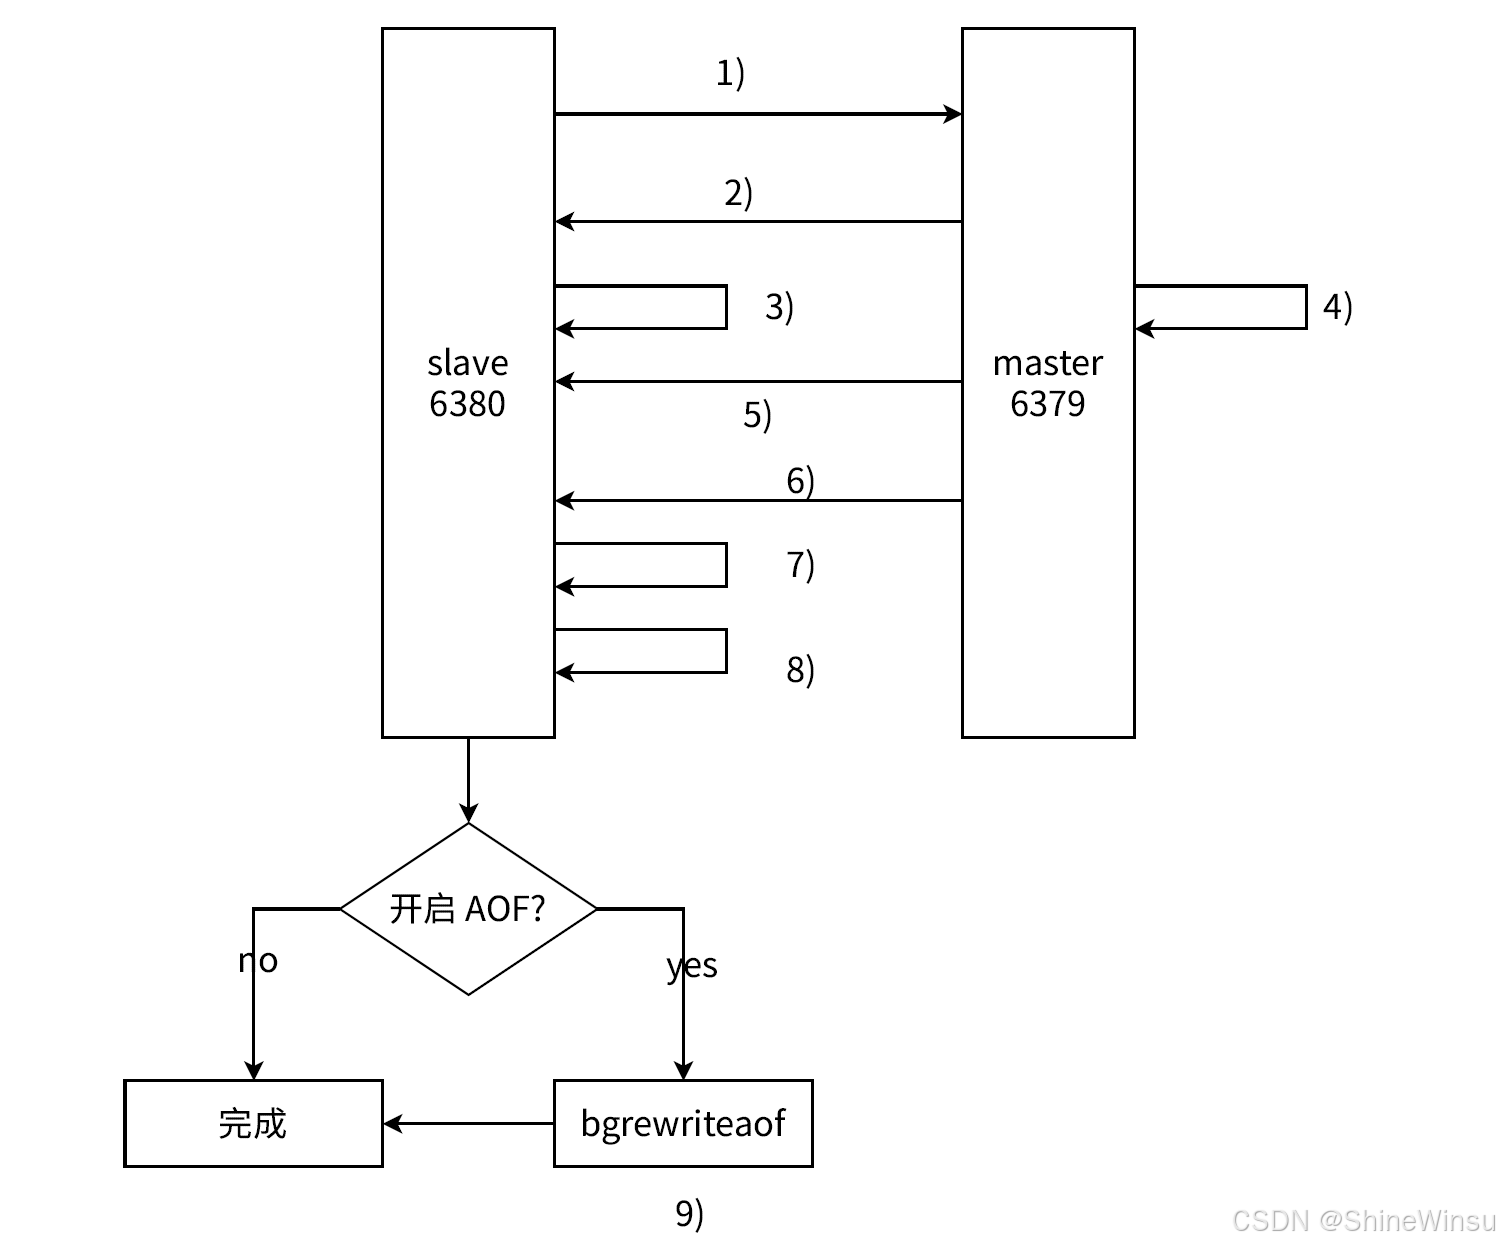
| 步骤 | 通俗类比 | 主节点操作(技术细节) | 从节点操作(技术细节) | 实战日志验证(核心日志) |
|---|---|---|---|---|
| 步骤 1:从节点发起全量复制请求 | 助教对老师说 "我是第一次来,没有任何课件,麻烦把所有课件都给我" | 无(等待从节点请求) | 从节点发送PSYNC ? -1命令(?表示不知道之前的 replid,-1表示 offset 为 - 1,即首次同步),请求全量复制 |
从节点日志:Replica asks for synchronization;主节点日志:Full resync requested by replica |
| 步骤 2:主节点准备全量复制(生成 RDB 文件 + 记录缓冲区命令) | 老师开始整理所有课件(生成 RDB),同时新讲的内容单独记在纸上(缓冲区命令) | 1. 主节点执行BGSAVE命令,后台生成 RDB 文件(不阻塞主节点处理写请求);2. 主节点创建一个 "复制缓冲区"(repl_backlog),将BGSAVE执行期间所有的写命令(如 set、del)都记录到缓冲区中;3. 主节点生成一个新的master_replid(复制 ID),用于标识本次全量复制的数据集 |
无(等待主节点发送数据) | 主节点日志:Starting BGSAVE for SYNC with target: disk;Background saving terminated with success |
| 步骤 3:主节点发送 RDB 文件到从节点 | 老师把整理好的课件手册(RDB 文件)抄给助教 | 1. BGSAVE执行成功后,主节点将 RDB 文件的大小、校验和等信息发送给从节点;2. 主节点通过之前建立的 TCP 连接,将 RDB 文件逐字节发送给从节点;3. 发送期间,主节点继续将新的写命令记录到复制缓冲区 |
1. 从节点接收主节点发送的 RDB 文件信息,准备接收 RDB 文件;2. 从节点创建一个临时文件,用于保存接收的 RDB 文件;3. 从节点持续接收 RDB 文件字节,写入临时文件 | 主节点日志:Sending RDB to replica;从节点日志:MASTER <-> REPLICA sync: receiving 1st byte from master |
| 步骤 4:从节点加载 RDB 文件(清空旧数据 + 导入 RDB) | 助教收到手册后,清空自己的笔记本(旧数据),把手册上的内容全部抄到笔记本上 | 无(持续记录缓冲区命令) | 1. 从节点接收完 RDB 文件后,校验 RDB 文件的完整性(避免文件传输损坏);2. 从节点执行FLUSHALL命令,清空自身所有旧数据;3. 从节点加载 RDB 文件,将 RDB 文件中的数据导入到自身内存中(加载期间,从节点会阻塞,无法处理读请求);4. 加载完成后,从节点更新自身的slave_repl_offset为 RDB 文件对应的 offset(即主节点生成 RDB 时的 offset) |
从节点日志:MASTER <-> REPLICA sync: Flushing old data;MASTER <-> REPLICA sync: Loading DB in memory |
| 步骤 5:主节点发送复制缓冲区中的命令 | 老师把整理手册期间新讲的内容(缓冲区命令),抄给助教 | 1. 主节点查询复制缓冲区,将BGSAVE执行期间记录的所有写命令,按顺序发送给从节点;2. 发送完成后,主节点更新自身的master_repl_offset,并记录从节点的当前 offset |
1. 从节点接收主节点发送的缓冲区命令,按顺序执行每一条命令;2. 每执行一条命令,从节点就更新自身的slave_repl_offset,确保与主节点的 offset 一致;3. 执行完成后,从节点的数据集与主节点完全一致 |
主节点日志:Sending buffered commands to replica;从节点日志:MASTER <-> REPLICA sync: Finished with success |
| 步骤 6:全量复制完成,进入实时同步阶段 | 助教抄完所有内容,笔记本与老师完全一致,后续老师新讲的内容,实时抄录 | 主节点标记该从节点为 "online",更新connected_slaves列表,后续执行的所有写命令,都会实时发送给该从节点 |
从节点标记master_link_status=up,后续持续接收主节点发送的写命令,实时执行,维持数据一致 |
主节点日志:Synchronization with replica succeeded;从节点日志:MASTER <-> REPLICA sync: Finished with success |
5.3.3 全量复制的实战验证
我们通过实战命令和日志,验证全量复制的整个流程:
验证 1:查看主节点 BGSAVE 执行情况(步骤 2)
# 连接主节点6379
redis-cli -p 6379 -a 123456
# 查看持久化信息,确认BGSAVE执行成功
127.0.0.1:6379> info persistence
rdb_bgsave_in_progress:0  # 0=未执行,1=正在执行(全量复制时会显示1)
rdb_bgsave_status:ok      # BGSAVE执行成功
rdb_last_save_time:1739172000  # 最近一次BGSAVE的时间(对应全量复制的时间)
验证 2:查看从节点 RDB 加载情况(步骤 4)
# 连接从节点6380
redis-cli -p 6380 -a 123456
# 查看从节点复制信息,确认RDB加载完成
127.0.0.1:6380> info replication
slave_repl_offset:1000  # 与主节点master_repl_offset一致,说明加载完成
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 与主节点master_replid一致(全量复制生成的新replid)
master_replid2:0000000000000000000000000000000000000000  # 首次同步,无历史replid
验证 3:查看主从节点 offset 一致性(步骤 5)
# 主节点查看offset
127.0.0.1:6379> info replication
master_repl_offset:1000

# 从节点查看offset
127.0.0.1:6380> info replication
slave_repl_offset:1000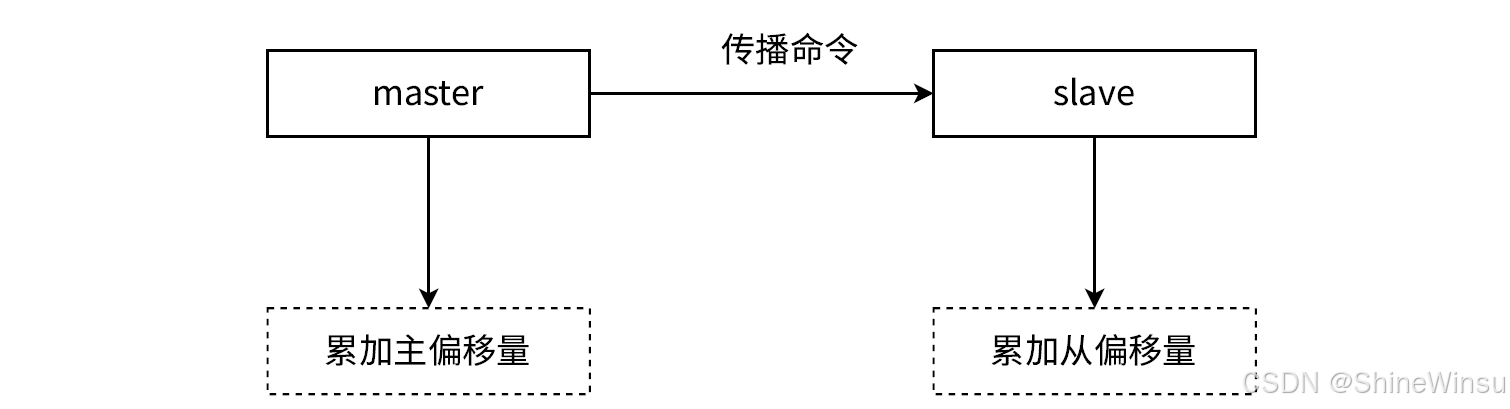
✅ 核心判断:主从节点 offset 完全一致,说明全量复制完成,数据同步正常。
5.3.4 全量复制的性能影响
全量复制是 "重量级" 操作,会消耗主节点和从节点的 CPU、内存、带宽资源,尤其是主节点发送 RDB 文件和缓冲区命令时,对性能影响较大:
(1)对主节点的性能影响(3 点)
- CPU 消耗:执行
BGSAVE命令时,主节点需要 fork 子进程,fork 过程会消耗 CPU(fork 时间与主节点内存大小正相关,内存越大,fork 时间越长); - 磁盘 IO 消耗:
BGSAVE生成 RDB 文件,需要写入磁盘,磁盘 IO 繁忙时,会导致BGSAVE执行缓慢,甚至失败; - 带宽消耗:发送 RDB 文件和缓冲区命令给从节点,尤其是 RDB 文件较大(如 10GB+)时,会占用大量带宽,若主节点有多个从节点同时执行全量复制,带宽会被占满,导致主节点无法正常处理业务请求。
(2)对从节点的性能影响(2 点)
- 磁盘 IO 消耗:接收 RDB 文件,写入临时文件,消耗磁盘 IO;
- 内存 + 阻塞影响:加载 RDB 文件时,从节点会阻塞,无法处理任何读请求(阻塞时间与 RDB 文件大小、从节点内存速度正相关),业务客户端会出现读超时。
(3)全量复制的优化方案
-
控制主节点内存大小:主节点内存建议不超过 16GB(最优),最大不超过 32GB,减少
BGSAVEfork 时间和 RDB 文件大小; -
主节点关闭持久化,从节点开启持久化:避免主节点
BGSAVE生成 RDB 文件消耗性能(从节点开启持久化,保证数据安全); -
避免多个从节点同时执行全量复制:新增从节点时,先让其同步一个已同步完成的从节点(如树形拓扑的中间层从节点),再切换到同步主节点,避免直接同步主节点,减少主节点带宽压力;
-
开启无磁盘同步(Redis 2.8 + 支持):主节点生成 RDB 文件时,不写入磁盘,直接通过网络发送给从节点,减少主节点磁盘 IO 消耗,配置如下:
# 主节点配置文件(redis.conf) repl-diskless-sync yes # 开启无磁盘同步 repl-diskless-sync-delay 5 # 延迟5秒发送,等待从节点准备就绪 -
合理设置复制缓冲区大小:调大
repl_backlog_size(如 64MB+),减少部分复制触发失败,从而减少全量复制的频率; -
选择合适的时间执行全量复制:新增从节点、主从断连后重新同步等场景,尽量在业务低峰期(如凌晨)执行,减少对业务的影响。
5.4 数据同步阶段(核心阶段)------ 部分复制(增量同步)
部分复制是 "轻量级" 同步方式,适用于 "主从节点短暂断连(如网络闪断),重新连接后" 的场景,核心是 "只同步断连期间主节点执行的写命令",无需同步所有数据,大幅节省资源、减少延迟,是主从复制中最常用的同步方式(全量复制仅在首次同步时触发)。
5.4.1 部分复制的通俗类比(老师 - 助教)
助教在听课过程中,短暂走神(主从断连),错过了老师讲的 3 个知识点(主节点执行的 3 条写命令),走神结束后,助教不需要让老师重新讲所有内容(全量复制),只需要让老师把自己错过的 3 个知识点(断连期间的写命令)重新讲一遍(部分复制),抄到笔记本上,就可以和老师的内容保持一致。
5.4.2 部分复制的核心前提
部分复制能触发的核心是 "主节点记录了断连期间的写命令,从节点知道自己错过的命令范围",需要满足 3 个前提,否则会触发全量复制:
- 主从节点重新连接后,从节点的
master_replid与主节点的master_replid一致(说明从节点同步的是当前主节点的数据集,没有切换过主节点); - 从节点的
slave_repl_offset在主节点复制缓冲区(repl_backlog)的可用范围内(主节点缓冲区中保存了从节点 offset 之后的所有写命令,可补发); - 主从节点都开启了部分复制功能(Redis 2.8 + 默认开启,无需额外配置,旧版本不支持部分复制,只能用全量复制)。
5.4.3 部分复制的 5 个详细步骤
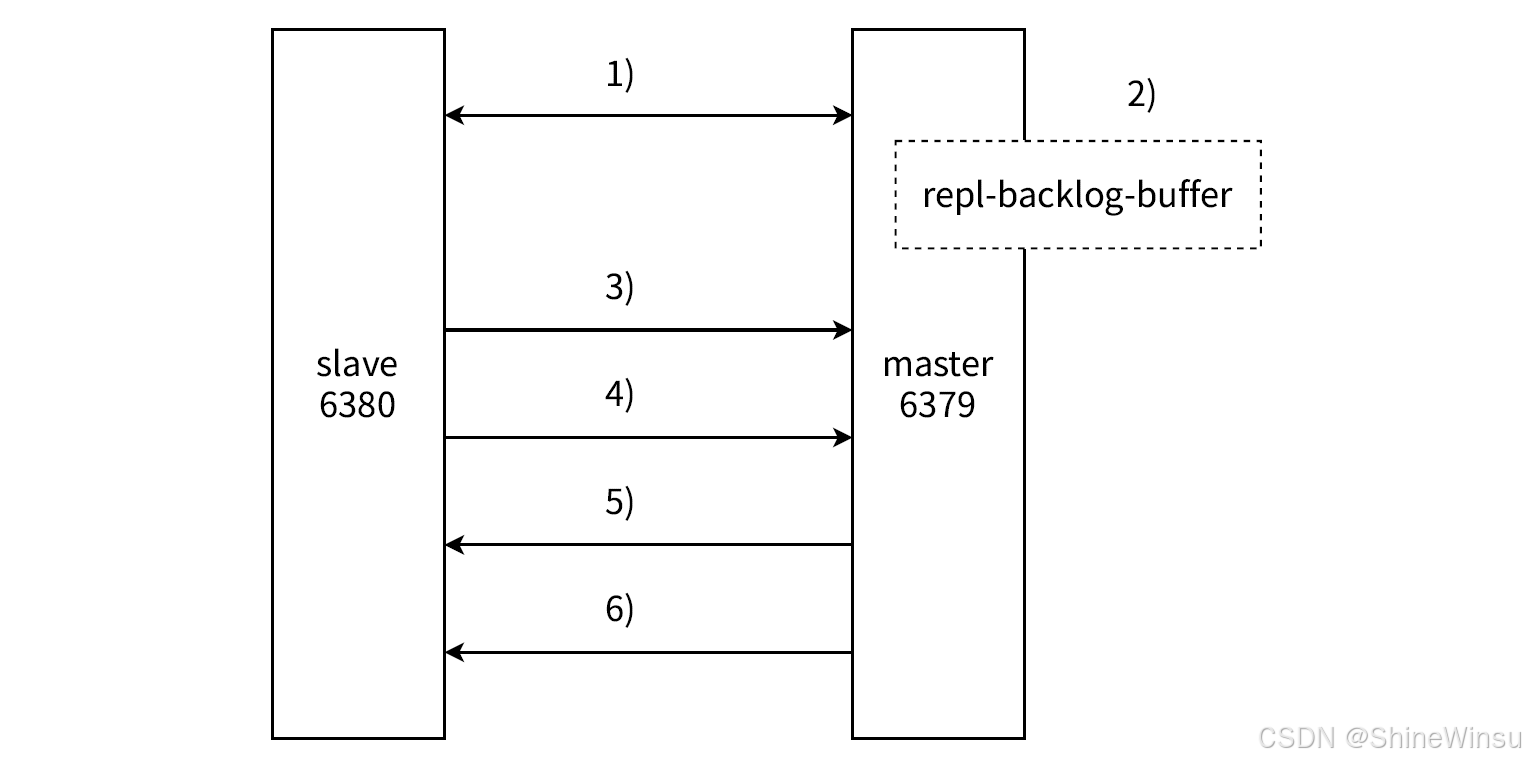
结合实战场景(主从节点正常同步,从节点 6380 断连 10 秒,重新连接后触发部分复制):
| 步骤 | 通俗类比 | 主节点操作(技术细节) | 从节点操作(技术细节) | 实战日志验证(核心日志) |
|---|---|---|---|---|
| 步骤 1:主从节点短暂断连 | 助教走神,与老师断开联系(听不到老师讲课) | 1. 主节点检测到与从节点的 TCP 连接断开,标记该从节点为 "offline";2. 主节点继续执行写命令,将所有写命令(断连期间)记录到复制缓冲区(repl_backlog)中;3. 主节点保持自身的master_replid和master_repl_offset不变 |
1. 从节点检测到与主节点的连接断开,标记master_link_status=down;2. 从节点停止接收主节点的写命令,保持自身的slave_repl_offset和master_replid不变;3. 从节点每隔 1 秒重试连接主节点 |
主节点日志:Replica 127.0.0.1:6380 is offline;从节点日志:Connection with master lost |
| 步骤 2:从节点重新连接主节点 | 助教走神结束,重新找到老师,恢复联系 | 主节点接收从节点的重新连接请求,验证密码(若有),建立新的 TCP 连接 | 从节点发起重新连接请求,发送自身的master_replid和slave_repl_offset(告知主节点 "我之前同步到了 offset=1000,现在需要继续同步") |
主节点日志:Accepted repl connection from 127.0.0.1:45679;从节点日志:Reconnecting to MASTER 127.0.0.1:6379 |
| 步骤 3:从节点发起部分复制请求 | 助教对老师说 "我之前听到了 offset=1000,麻烦把 1000 之后的内容(知识点)重新讲一遍" | 无(等待从节点请求) | 从节点发送PSYNC 主节点replid 1000命令(replid 是主节点的 replid,1000 是自身的 offset),请求同步 offset=1000 之后的命令 |
从节点日志:Sending PSYNC request to master;主节点日志:Replica asks for PSYNC |
| 步骤 4:主节点校验,发送缓冲区命令 | 老师确认助教的 replid(是自己的学生),确认 offset=1000 之后有内容(缓冲区中有),就把这些内容重新讲一遍 | 1. 主节点校验从节点发送的 replid,与自身 replid 一致;2. 主节点校验从节点的 offset(1000),确认在复制缓冲区的可用范围内;3. 主节点从复制缓冲区中,提取 offset=1000 之后的所有写命令,按顺序发送给从节点;4. 发送完成后,主节点更新从节点的状态为 "online" | 1. 从节点接收主节点发送的写命令,按顺序执行每一条命令;2. 每执行一条命令,从节点更新自身的slave_repl_offset,确保与主节点的 offset 一致;3. 执行完成后,从节点的数据集与主节点完全一致 |
主节点日志:Partial resync accepted by replica;Sending buffered commands to replica;从节点日志:Partial resync from master accepted |
| 步骤 5:部分复制完成,恢复实时同步 | 助教抄完错过的知识点,重新开始实时抄录老师新讲的内容 | 主节点后续执行的所有写命令,都会实时发送给从节点 | 从节点标记master_link_status=up,持续接收主节点的写命令,实时执行,维持数据一致 |
主节点日志:Replica 127.0.0.1:6380 is online;从节点日志:MASTER <-> REPLICA sync: Finished with success |
5.4.4 部分复制的实战验证
我们通过实战操作,模拟主从断连、重新连接,验证部分复制的触发和执行:
步骤 1:模拟主从断连(断开从节点与主节点的连接)
# 找到从节点6380与主节点6379的TCP连接(从节点的客户端端口)
netstat -nlpt | grep 6379  # 查看主节点的连接,找到从节点的端口(如45678)
# 终止该TCP连接(模拟断连)
kill -9 连接对应的进程ID  # 或用iptables临时阻断端口,模拟网络闪断
步骤 2:主节点执行写命令(断连期间,生成需要补发的命令)
# 连接主节点6379
redis-cli -p 6379 -a 123456
# 执行3条写命令(断连期间的命令,会记录到复制缓冲区)
127.0.0.1:6379> set a 10
OK
127.0.0.1:6379> set b 20
OK
127.0.0.1:6379> set c 30
OK
# 查看主节点offset(此时offset=1003,比断连前多3)
127.0.0.1:6379> info replication
master_repl_offset:1003
步骤 3:重新连接主从节点,验证部分复制
# 重启从节点6380(重新连接主节点)
redis-cli -p 6380 -a 123456 shutdown
redis-server /usr/local/redis/conf/redis-slave-6380.conf

# 查看从节点日志,确认触发部分复制
cat /var/log/redis/redis-6380.log
# 核心日志(部分复制成功):
1235:M 10 Feb 2026 14:10:00.000 * Reconnecting to MASTER 127.0.0.1:6379
1235:M 10 Feb 2026 14:10:00.002 * Successfully authenticated with MASTER
1235:M 10 Feb 2026 14:10:00.003 * Partial resync from master accepted: offset 1000, master_replid 2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06
1235:M 10 Feb 2026 14:10:00.004 * MASTER <-> REPLICA sync: Finished with success

# 验证从节点数据(是否同步了断连期间的3条命令)
redis-cli -p 6380 -a 123456
127.0.0.1:6380> get a
"10"
127.0.0.1:6380> get b
"20"
127.0.0.1:6380> get c
"30"  # 同步成功,触发部分复制

# 验证主从节点offset一致
127.0.0.1:6379> info replication
master_repl_offset:1003
127.0.0.1:6380> info replication
slave_repl_offset:1003  # 一致,部分复制完成
✅ 核心判断:从节点日志出现 "Partial resync accepted",主从 offset 一致,断连期间的命令同步成功,说明部分复制触发成功。
5.4.5 部分复制的优化方案
- 调大复制缓冲区大小(
repl_backlog_size):缓冲区越大,能保存的写命令越多,主从断连的时间可以更长,避免断连时间过长导致 offset 超出缓冲区范围,触发全量复制;✅ 配置建议:根据主节点写并发调整,写并发越高,缓冲区设越大,一般 64MB 可满足绝大多数场景,写并发极高(每秒 10 万 QPS)设为 128MB+; - 优化网络稳定性:减少主从节点之间的网络闪断(如部署在同一机房、检查网络设备),缩短断连时间,降低部分复制的触发频率,同时避免断连时间过长导致全量复制。
5.4.6 部分复制与全量复制的对比
| 对比维度 | 全量复制 | 部分复制 |
|---|---|---|
| 触发条件 | 1. 从节点首次同步;2. 从节点 replid 与主节点不一致;3. 从节点 offset 超出主节点缓冲区范围 | 1. 主从节点短暂断连后重新连接;2. 从节点 replid 与主节点一致;3. 从节点 offset 在主节点缓冲区范围内 |
| 同步内容 | 主节点所有数据(RDB 文件)+ 同步期间的缓冲区命令 | 主从断连期间主节点执行的写命令(仅缺失的命令) |
| 资源消耗 | 高(CPU、内存、带宽、磁盘 IO 消耗大) | 低(仅消耗少量带宽,无 CPU、磁盘 IO 大量消耗) |
| 同步延迟 | 高(取决于 RDB 文件大小、网络带宽,可能几秒到几分钟) | 低(取决于断连期间的命令数量,一般毫秒级) |
| 适用场景 | 首次同步、主从断连时间过长、replid 不一致 | 主从短暂断连(网络闪断)后重新连接 |
| Redis 版本支持 | 所有版本 | 2.8 + 版本(默认开启) |
5.5 实时同步阶段(维持阶段)------ 心跳检测 + 命令传播
数据同步阶段(全量 / 部分)完成后,主从复制进入 "实时同步阶段",核心是 "主节点实时发送写命令,从节点实时执行,同时主从节点通过心跳检测维持连接",确保主从数据实时一致,这是主从复制长期维持的关键阶段。
5.5.1 实时同步阶段的两个核心任务(必记)
实时同步阶段有两个核心任务,相辅相成,缺一不可:① 命令传播(主节点实时发送写命令,从节点实时执行);② 心跳检测(主从节点互相确认在线状态,确保连接正常)。
5.5.2 任务 1:命令传播(实时同步写命令,核心)
(1)通俗类比(老师 - 助教)
助教抄完所有课件后,老师后续讲的每一个新知识点(主节点执行的每一条写命令),都会实时告诉助教,助教实时抄录到自己的笔记本上(从节点实时执行命令),确保笔记本上的内容和老师完全一致,没有延迟。
(2)技术细节
- 主节点命令传播操作:
- 主节点执行任何一条写命令(set、del、hset、incr 等)后,都会立即将该命令发送给所有已连接的从节点(online 状态);
- 主节点发送命令时,会按顺序发送,确保从节点执行命令的顺序与主节点一致(避免数据不一致);
- 主节点发送命令后,会更新自身的
master_repl_offset(每执行一条写命令,offset+1); - 主节点不会等待从节点的执行响应,采用 "异步传播" 方式(发送命令后,立即处理下一条业务命令),提高主节点的写请求处理效率。
- 从节点命令传播操作:
- 从节点持续接收主节点发送的写命令,按顺序执行每一条命令(严格遵循主节点的命令顺序);
- 从节点每执行一条命令,都会更新自身的
slave_repl_offset,确保与主节点的master_repl_offset一致; - 从节点执行命令时,会阻塞吗?------ 不会,从节点执行写命令是异步的,不阻塞自身处理读请求(读请求可以正常执行,写命令后台顺序执行);
- 从节点执行命令失败怎么办?------ 若执行命令失败(如命令格式错误),从节点会断开与主节点的连接,标记
master_link_status=down,并持续重试连接,重新连接后触发全量 / 部分复制,恢复数据一致。
(3)实战验证:命令传播(实时同步)
# 主节点(6379)执行写命令
127.0.0.1:6379> set d 40
OK
127.0.0.1:6379> incr e
(integer) 1
127.0.0.1:6379> hset user:3 id 3 name wangwu
(integer) 2

# 立即查看主节点offset
127.0.0.1:6379> info replication
master_repl_offset:1008  # 执行3条命令,offset从1003增加到1008

# 查看从节点(6380)数据和offset
127.0.0.1:6380> get d
"40"
127.0.0.1:6380> get e
"1"
127.0.0.1:6380> hgetall user:3
1) "id"
2) "3"
3) "name"
4) "wangwu"  # 实时同步成功

127.0.0.1:6380> info replication
slave_repl_offset:1008  # 与主节点offset一致
✅ 核心判断:主节点执行写命令后,从节点立即能查询到对应数据,主从 offset 一致,说明命令传播正常,实时同步生效。
5.5.3 任务 2:心跳检测(维持主从连接,必记)
主从节点进入实时同步阶段后,会通过 "心跳检测" 互相确认对方是否在线,避免连接断开后未发现,导致数据不一致,详细拆解:
(1)心跳检测的双向机制(主→从,从→主)
Redis 的心跳检测是 "双向的",主节点和从节点都会主动发送心跳包,确保连接正常:
① 从节点→主节点(心跳请求,核心)
- 频率:默认每 1 秒发送一次(无需配置,Redis 默认);
- 发送内容:
REPLCONF ACK <offset>命令,其中offset是从节点当前的slave_repl_offset; - 核心作用:
- 告知主节点 "我还在线";
- 告知主节点 "我当前同步到了哪个 offset,是否有缺失的命令";
- 主节点收到该命令后,若发现从节点的 offset 落后于自身的 offset,会立即补发缺失的命令(确保从节点同步不落后)。
② 主节点→从节点(心跳响应,辅助)
- 频率:默认每 10 秒发送一次(由
repl-ping-replica-period参数控制); - 发送内容:
PING命令(空命令,仅用于确认连接); - 核心作用:告知从节点 "我还在线",若从节点长时间(超过
repl-timeout参数)未收到主节点的PING命令,会认为主节点宕机,标记master_link_status=down,并持续重试连接。
(2)核心配置参数(实战可调整)
# 主节点配置文件(redis.conf),控制主节点→从节点的心跳频率
repl-ping-replica-period 10  # 主节点每10秒向从节点发送一次PING命令(默认10秒)

# 所有节点配置文件,控制心跳超时时间
repl-timeout 60  # 心跳超时时间60秒(默认60秒),若超过60秒未收到对方心跳,认为连接断开
✅ 配置建议:无需修改默认值,若主从网络不稳定,可将repl-ping-replica-period改为 5 秒(增加心跳频率),repl-timeout改为 30 秒(缩短超时时间),更快发现连接断开。
(3)实战验证:心跳检测
# 查看主节点日志,确认主节点向从节点发送PING命令
cat /var/log/redis/redis-6379.log
# 核心日志:
1234:M 10 Feb 2026 14:20:00.000 * PING sent to replica 127.0.0.1:6380
1234:M 10 Feb 2026 14:20:10.000 * PING sent to replica 127.0.0.1:6380  # 每10秒一次

# 查看从节点日志,确认从节点向主节点发送REPLCONF ACK命令
cat /var/log/redis/redis-6380.log
# 核心日志:
1235:M 10 Feb 2026 14:20:00.000 * REPLCONF ACK 1008
1235:M 10 Feb 2026 14:20:01.000 * REPLCONF ACK 1008  # 每1秒一次
✅ 核心判断:主节点日志每 10 秒出现 "PING sent to replica",从节点日志每 1 秒出现 "REPLCONF ACK",说明心跳检测正常。
5.5.4 实时同步阶段的注意事项
- 主节点命令传播是异步的:主节点发送命令后,不会等待从节点执行完成,就会处理下一条命令,因此可能出现 "主节点执行完命令,从节点还未执行" 的毫秒级延迟,这是正常现象,无法完全避免;✅ 解决方案:对 "写后立即读" 的业务场景(如用户注册后立即查询),强制读主节点,避免读取到旧数据;
- 从节点心跳超时后的处理:从节点超过
repl-timeout时间未收到主节点心跳,会断开连接,标记master_link_status=down,并持续重试连接,重新连接后触发全量 / 部分复制,无需人工干预; - 主节点收到多个从节点的
REPLCONF ACK命令后,会优先补发 offset 落后最多的从节点的命令,确保所有从节点都能同步到最新数据。
5.6 主从复制核心命令深度解析
前面的实战中,我们频繁使用slaveof、info replication等命令,这里详细拆解 3 个核心命令的用法、参数
5.6.1 命令 1:slaveof(配置主从关系,核心命令)
(1)命令格式(两种用法)
# 用法1:设置从节点,同步指定主节点(IP+端口)
slaveof <masterip> <masterport>

# 用法2:取消从节点身份,晋升为独立主节点(断开与原主节点的连接)
slaveof no one
(2)参数解析
masterip:主节点的 IP 地址(本地部署用 127.0.0.1,跨机房部署用公网 IP);masterport:主节点的 Redis 端口(如 6379);no one:固定参数,表示 "取消从节点身份",无需修改。
(3)实战场景
-
部署从节点时,配置主从关系:
# 从节点6380执行,同步主节点6379 127.0.0.1:6380> slaveof 127.0.0.1 6379 OK -
主节点宕机后,将从节点晋升为主节点:
# 从节点6380执行,取消从节点身份,晋升为主节点 127.0.0.1:6380> slaveof no one OK # 关闭只读模式,处理写请求 127.0.0.1:6380> config set slave-read-only no OK -
从节点同步错误主节点后,重新配置正确主节点:
# 从节点6380原本同步错误主节点6390,现在重新同步正确主节点6379 127.0.0.1:6380> slaveof 127.0.0.1 6379 OK # 注意:执行后,从节点会清空自身数据,重新同步6379的数据 -
树形拓扑中,配置下层从节点同步中间层从节点:
# 下层从节点6381执行,同步中间层从节点6380
127.0.0.1:6381> slaveof 127.0.0.1 6380
OK
(4)注意事项
- 执行
slaveof <masterip> <masterport>后,从节点会自动清空自身所有数据,无论之前是否有数据,都会被清空,避免数据混淆; - 执行
slaveof no one后,从节点会断开与原主节点的连接,晋升为独立主节点,自身的role变为master,master_link_status变为down(无主节点); - 该命令是临时生效的,重启从节点后,会恢复到配置文件中
slaveof参数指定的主节点,若要永久生效,需修改从节点配置文件中的slaveof参数。
5.6.2 命令 2:info replication(查看主从复制状态,排查故障核心)
(1)命令格式
info replication(2)命令作用
查看当前节点(主节点 / 从节点)的复制状态,包括节点角色、主从连接状态、offset、replid、从节点列表等核心信息,是排查主从复制故障的 "万能命令",无论什么故障,先执行该命令,再定位问题。
(3)主节点执行该命令的输出解析(核心字段,必记)
127.0.0.1:6379> info replication
# Replication
role:master  # 节点角色:master(主节点)
connected_slaves:3  # 连接的从节点数量:3个(6380、6381、6382)
slave0:ip=127.0.0.1,port=6380,state=online,offset=1008,lag=0  # 第一个从节点:IP、端口、状态(online=在线)、offset、延迟(lag=0毫秒)
slave1:ip=127.0.0.1,port=6381,state=online,offset=1008,lag=0  # 第二个从节点
slave2:ip=127.0.0.1,port=6382,state=online,offset=1008,lag=0  # 第三个从节点
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 主节点复制ID(标识当前数据集)
master_replid2:0000000000000000000000000000000000000000  # 备用复制ID(用于部分复制失败时回退)
master_repl_offset:1008  # 主节点当前的复制偏移量(每执行一条写命令,offset+1)
repl_backlog_active:1  # 复制缓冲区是否开启:1=开启,0=关闭
repl_backlog_size:67108864  # 复制缓冲区大小:64MB
repl_backlog_first_byte_offset:1  # 复制缓冲区中第一条命令的offset
repl_backlog_histlen:1008  # 复制缓冲区中当前保存的命令长度
✅ 核心字段解读:
connected_slaves:确认主节点连接的从节点数量是否正确;slavex:state:确认从节点状态是否为online(离线则为offline);master_repl_offset:主节点当前的 offset,用于与从节点 offset 对比,确认同步是否正常;repl_backlog_active:确认复制缓冲区是否开启,避免部分复制无法触发。
(4)从节点执行该命令的输出解析
127.0.0.1:6380> info replication
# Replication
role:slave  # 节点角色:slave(从节点)
master_host:127.0.0.1  # 同步的主节点IP
master_port:6379  # 同步的主节点端口
master_link_status:up  # 与主节点的连接状态:up=正常,down=断开
master_last_io_seconds_ago:1  # 距离上次与主节点通信的时间(1秒,通信正常)
master_sync_in_progress:0  # 是否正在进行同步:0=未同步,1=正在同步(全量/部分)
slave_repl_offset:1008  # 从节点当前的offset,与主节点一致则同步正常
slave_priority:100  # 从节点优先级(值越小,故障转移时优先级越高)
master_replid:2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06  # 主节点的复制ID,与主节点一致
master_replid2:0000000000000000000000000000000000000000  # 备用复制ID
slave_read_only:1  # 是否开启只读模式:1=开启,0=关闭
connected_slaves:0  # 该从节点没有下属从节点(树形拓扑的中间层从节点会有)
repl_backlog_active:1  # 复制缓冲区是否开启
repl_backlog_size:67108864  # 复制缓冲区大小
repl_backlog_first_byte_offset:1
repl_backlog_histlen:1008
✅ 核心字段解读(故障排查重点):
master_link_status:最核心字段,down表示连接断开,需排查网络、密码、主节点状态;slave_repl_offset:与主节点master_repl_offset对比,不一致则同步异常;master_sync_in_progress:1表示正在同步,若长时间为1,需查看日志,确认同步是否卡住;master_replid:与主节点master_replid对比,不一致则会触发全量复制。
5.6.3 命令 3:PSYNC/SYNC(同步命令,底层命令,无需手动执行)
(1)命令作用
PSYNC和SYNC是主从复制底层用于 "请求同步、协商同步方式" 的命令,无需手动执行,从节点发起同步时会自动发送,其中PSYNC是 Redis 2.8 + 新增的命令,支持部分复制,SYNC是旧版本命令,仅支持全量复制。
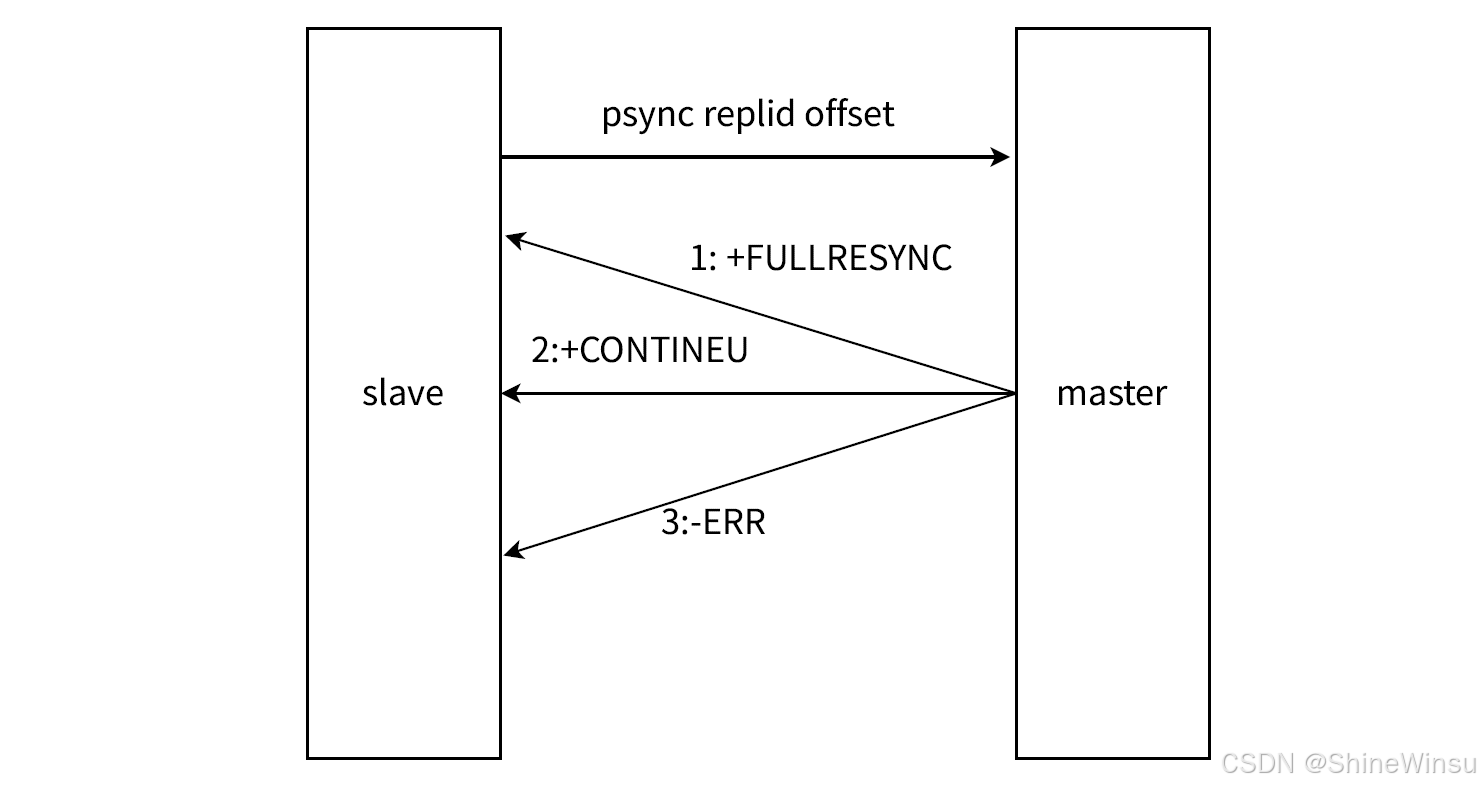
(2)命令格式(底层自动发送,了解即可)
# PSYNC命令(Redis 2.8+,支持全量/部分复制)
PSYNC <master_replid> <slave_repl_offset>

# SYNC命令(旧版本,仅支持全量复制)
SYNC
(3)命令解析
PSYNC ? -1:从节点首次同步时发送,?表示不知道主节点的 replid,-1表示 offset 为 - 1,请求全量复制;PSYNC <replid> <offset>:从节点重新连接时发送,replid是主节点的 replid,offset是自身的 offset,请求部分复制;- 主节点收到
PSYNC命令后,会根据 replid 和 offset,决定返回+FULLRESYNC(全量复制)或+CONTINUE(部分复制)。
(4)注意事项
无需手动执行该命令,从节点会自动发送,排查同步故障时,可通过日志查看该命令的发送和响应情况(如 "Partial resync accepted" 表示 PSYNC 请求部分复制成功)。
5.7 主从复制核心参数深度解析
前面的实战中,我们配置了多个参数(如slaveof、masterauth),这里详细拆解 6 个核心参数的作用、默认值、生产配置建议,确保大家能根据业务场景,配置出最优的主从复制参数,避免踩坑。
5.7.1 参数 1:slaveof(配置主从关系,核心参数)
(1)参数格式(配置文件中)
slaveof <masterip> <masterport>(2)参数作用
指定当前节点作为从节点,同步指定 IP 和端口的主节点,是主从复制的核心参数,与slaveof命令功能一致,但配置文件中配置是永久生效,命令行执行是临时生效。
(3)默认值
默认无配置(即节点默认角色为主节点,不主动同步任何节点);若未配置该参数,节点启动后role=master,connected_slaves=0。
(4)生产配置建议
- 一主一从架构(从节点):配置为
slaveof 主节点IP 主节点端口,本地部署示例:slaveof 127.0.0.1 6379; - 一主多从架构(所有从节点):所有从节点统一配置为
slaveof 主节点IP 主节点端口,确保所有从节点同步同一个主节点,示例:6380、6381、6382 均配置slaveof 127.0.0.1 6379; - 树形拓扑架构(下层从节点):配置为
slaveof 中间层从节点IP 中间层从节点端口,示例:下层从节点 6381 配置slaveof 127.0.0.1 6380(6380 为中间层从节点); - 跨机房部署(从节点 / 下层从节点):配置为主节点 / 中间层从节点的公网 IP + 端口 ,示例:机房 B 的 6381 配置
slaveof 123.45.67.89 6380(123.45.67.89 为机房 A 中间层从节点公网 IP); - 无需作为从节点的节点(独立主节点):不配置该参数,保持默认即可,避免误配置导致节点变为从节点。
(5)注意事项
- 配置文件中修改
slaveof后,必须重启从节点才能生效 ;命令行执行slaveof命令是临时生效,重启节点后会恢复到配置文件中的设置(若想永久生效,需同步修改配置文件); - 若从节点已配置
slaveof并同步主节点,后续修改slaveof参数(如切换主节点),重启后从节点会清空自身所有数据,重新同步新的主节点,需提前备份从节点数据; - 主节点无需配置
slaveof参数(默认为主节点),若主节点误配置slaveof,会导致主节点变为从节点,自身写请求被禁止(只读),引发业务故障; - 跨机房部署时,
slaveof的 IP 必须是主节点 / 中间层从节点的公网 IP,且目标节点需开放对应端口(防火墙放行),否则从节点无法连接。
5.7.2 参数 2:masterauth(从节点验证主节点密码,核心参数)
(1)参数格式(配置文件中)
masterauth <password>(2)参数作用
当主节点(或中间层从节点)开启密码验证(配置requirepass <password>)时,从节点必须配置masterauth,并填写与主节点requirepass一致的密码,否则从节点无法通过主节点的身份验证,无法建立同步连接(日志会报密码错误)。简单说:masterauth是从节点 "登录" 主节点的密码,确保主从连接的安全性。
(3)默认值
默认值为空字符串(""),即不设置密码验证,若主节点未配置requirepass,从节点可无需配置masterauth。
(4)生产配置建议
- 所有从节点(无论哪种拓扑),必须配置
masterauth,且密码与主节点requirepass完全一致(主节点必须开启requirepass,禁止无密码部署); - 密码建议设置复杂密码(字母 + 数字 + 特殊符号,长度≥8 位),避免简单密码被破解,示例:
masterauth Redis@123456; - 若主节点后续修改
requirepass密码,所有从节点的masterauth必须同步修改(配置文件 + 重启),否则主从连接会断开,同步失败; - 树形拓扑中,下层从节点的
masterauth,需填写与主节点 一致的密码(而非中间层从节点的requirepass),因为中间层从节点转发主节点的同步命令时,会验证该密码; - 多个从节点的
masterauth必须保持一致(均与主节点密码一致),便于维护和扩容。
(5)注意事项
masterauth仅需在从节点配置,主节点无需配置(主节点用requirepass设置自身密码,用于客户端和从节点登录);- 密码不一致的后果:从节点反复重试连接主节点,日志持续输出
Error: Authentication failed,无法建立同步连接,主从复制失败; - 配置文件中修改
masterauth后,必须重启从节点才能生效 ;命令行临时修改用config set masterauth <password>,重启后失效(需同步修改配置文件); - 若主节点未配置
requirepass(无密码),从节点配置masterauth也不会报错,但无实际意义(建议主节点强制开启密码验证)。
5.7.3 参数 3:slave-read-only(从节点只读模式,核心参数)
(1)参数格式(配置文件中)
slave-read-only yes|no(补充)Redis 6.0+ 新增参数(推荐使用)
Redis 6.0+ 将slave-read-only更名为replica-read-only,功能完全一致,仅参数名不同,推荐使用新参数(兼容性更好):
replica-read-only yes|no(2)参数作用
控制从节点是否开启 "只读模式":
- 设为
yes(开启):从节点仅允许执行读命令(如 get、hget、lrange),禁止执行任何写命令(如 set、del、hset),避免从节点数据被篡改; - 设为
no(关闭):从节点允许执行写命令,但会导致主从数据不一致(主节点同步命令会覆盖从节点的写数据),仅在特定场景使用(如从节点晋升为主节点时)。
(3)默认值
Redis 2.8+ 默认值为yes(开启只读模式);Redis 6.0+ 中,slave-read-only和replica-read-only默认均为yes,若同时配置,replica-read-only生效。
(4)生产配置建议(强制开启)
- 所有从节点(无论哪种拓扑、是否跨机房),必须配置为
yes(开启只读模式) ,禁止设置为no; - 仅有的例外场景:主节点宕机后,将从节点晋升为主节点时,临时关闭只读模式(命令行执行
config set slave-read-only no),让其处理写请求;待原主节点恢复后,再根据需求切换主从关系,重新开启只读模式; - Redis 6.0+ 部署时,推荐使用新参数
replica-read-only yes,示例:replica-read-only yes。
(5)注意事项
- 开启只读模式后,从节点仍允许执行
flushall、flushdb等危险命令(若未限制),需额外配置禁止这些命令(如通过rename-command重命名命令); - 即使开启只读模式,管理员通过命令行仍可执行写命令(需验证密码),但业务客户端禁止执行写命令,需通过权限控制限制业务客户端的操作;
- 若误将
slave-read-only设为no,从节点执行写命令后,主节点同步的命令会覆盖该写数据,导致从节点数据 "丢失",引发业务查询异常(读旧数据 / 错误数据); - Redis 6.0+ 中,若同时配置
slave-read-only no和replica-read-only yes,最终生效的是replica-read-only yes(只读模式开启),需注意参数冲突。
5.7.4 参数 4:repl_backlog_size(复制缓冲区大小,优化参数)
(1)参数格式(配置文件中)
repl_backlog_size <size>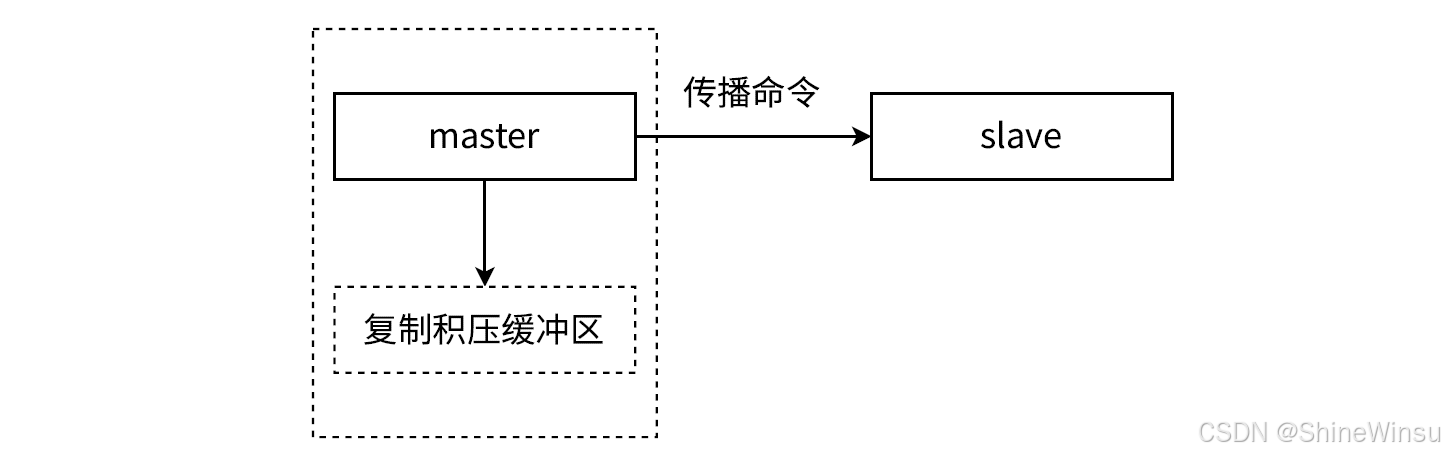
(单位:字节,可直接写数字,如 67108864 表示 64MB)
(2)参数作用
设置主节点 "复制积压缓冲区"(repl_backlog)的大小,该缓冲区的核心作用是:
- 保存主节点执行的写命令,供从节点短暂断连后重新连接时,补发缺失的命令(触发部分复制);
- 避免从节点断连时间过长,缓冲区中的旧命令被覆盖,导致无法触发部分复制,只能触发全量复制(消耗大量资源)。
简单说:复制缓冲区越大,能保存的写命令越多,主从断连的 "最大允许时间" 越长(断连时间 = 缓冲区大小 / 每秒写命令总量)。
(3)默认值
Redis 默认值为1048576字节(即 1MB),该默认值过小,无法满足绝大多数生产场景(写并发稍高,1MB 缓冲区几秒就会被写满),必须手动修改。
(4)生产配置建议(分场景调整)
根据主节点写并发、部署场景(同机房 / 跨机房)调整,推荐值如下(直接套用):
- 同机房部署、写并发较低(每秒写 QPS≤1 万):设为 64MB(67108864),示例:
repl_backlog_size 67108864; - 同机房部署、写并发中等(每秒写 QPS 1-5 万):设为 128MB(134217728),示例:
repl_backlog_size 134217728; - 跨机房部署、写并发较低(每秒写 QPS≤1 万):设为 128MB(134217728),跨机房网络不稳定,需更大缓冲区;
- 跨机房部署、写并发中等(每秒写 QPS 1-5 万):设为 256MB(268435456),示例:
repl_backlog_size 268435456; - 写并发极高(每秒写 QPS≥5 万):设为 512MB(536870912),避免缓冲区快速被写满。
(5)注意事项(生产必避坑)
- 该参数仅需在主节点配置,从节点无需配置(从节点也有复制缓冲区,但无需手动设置,由 Redis 自动管理);
- 缓冲区大小并非越大越好:过大(如 1GB)会浪费主节点内存,过小则无法满足断连需求,需根据实际写并发调整;
- 配置文件中修改
repl_backlog_size后,必须重启主节点才能生效 ;命令行临时修改用config set repl_backlog_size <size>,重启后失效; - 若主节点有多个从节点,复制缓冲区是所有从节点共享的,无需为每个从节点单独配置;
- 结合
repl_backlog_ttl参数(Redis 5.0+)使用,可实现缓冲区自动扩容 / 收缩(如repl_backlog_ttl 3600,缓冲区空闲 1 小时后自动收缩到默认大小)。
5.7.5 参数 5:repl-disable-tcp-nodelay(TCP_NODELAY 配置,优化参数)
(1)参数格式(配置文件中)
repl-disable-tcp-nodelay yes|no(2)参数作用
控制主节点向从节点发送同步命令(命令传播、全量复制的 RDB 文件除外)时,是否启用 "Nagle 算法":
- Nagle 算法(
repl-disable-tcp-nodelay yes):合并多个小数据包为一个大数据包发送,节省网络带宽,但会增加命令传播延迟(约 40ms 左右); - 禁用 Nagle 算法(
repl-disable-tcp-nodelay no):不合并数据包,每个写命令单独发送,延迟极低(毫秒级),但会消耗更多网络带宽。
核心权衡:延迟 vs 带宽,根据部署场景选择开启 / 关闭。
(3)默认值
Redis 默认值为no(禁用 Nagle 算法),即优先保证低延迟,适合同机房部署场景。
(4)生产配置建议(分场景选择)
- 同机房部署(带宽充足、延迟要求高):保持默认值
no,禁用 Nagle 算法,减少命令传播延迟(毫秒级),确保主从数据实时一致; - 跨机房部署(带宽昂贵、延迟可接受):设为
yes,启用 Nagle 算法,合并数据包,节省跨机房带宽(跨机房带宽成本高,优先节省带宽); - 树形拓扑架构:
- 主节点→中间层从节点(同机房):
repl-disable-tcp-nodelay no(低延迟); - 中间层从节点→下层从节点(跨机房):
repl-disable-tcp-nodelay yes(省带宽)。
- 主节点→中间层从节点(同机房):
(5)注意事项(生产必避坑)
- 该参数仅需在主节点配置(中间层从节点作为 "二级主节点",向下层从节点发送命令时,也需配置该参数);
- 跨机房部署若误设为
no,会导致跨机房带宽被大量小数据包占用,带宽成本飙升,甚至出现带宽拥堵,导致同步延迟过高; - 同机房部署若误设为
yes,会导致命令传播延迟增加(40ms 左右),对于 "写后立即读" 的场景,会频繁出现读取旧数据的问题; - 修改该参数后,必须重启主节点 / 中间层从节点才能生效 ;命令行临时修改用
config set repl-disable-tcp-nodelay yes,重启后失效。
5.7.6 参数 6:repl-ping-replica-period(主节点心跳频率,维持连接参数)
(1)参数格式(配置文件中)
repl-ping-replica-period <seconds>(单位:秒,填写整数)
(2)参数作用
设置主节点向所有已连接的从节点(online 状态)发送PING命令的频率,用于心跳检测:
- 主节点定期发送
PING命令,告知从节点 "自身在线"; - 从节点若在
repl-timeout时间内未收到主节点的PING命令,会认为主节点宕机,标记master_link_status=down,并持续重试连接。
简单说:该参数控制主节点向从节点的 "心跳频率",频率越高,越能快速发现主节点宕机。
(3)默认值
Redis 默认值为10秒,即主节点每 10 秒向从节点发送一次PING命令。
(4)生产配置建议(无需修改默认,特殊场景调整)
- 绝大多数场景(同机房、网络稳定):保持默认值
10秒,既能快速发现主节点宕机,又不会增加主节点和网络压力; - 网络不稳定场景(跨机房、无线网络):改为
5秒,增加心跳频率,更快发现主从连接断开,减少数据同步延迟; - 业务对可用性要求极高场景(金融、支付):改为
3秒,进一步缩短心跳间隔,确保主节点宕机后能快速被发现,便于人工干预切换主从。
(5)注意事项(生产必避坑)
- 该参数仅需在主节点配置,从节点无需配置;
- 频率设置过低(如 1 秒):会导致主节点频繁发送
PING命令,增加主节点 CPU 和网络压力,不推荐; - 频率设置过高(如 30 秒):会导致主节点宕机后,从节点长时间未发现,同步延迟过大,甚至触发不必要的全量复制;
- 修改该参数后,无需重启主节点 ,命令行临时修改用
config set repl-ping-replica-period 5,立即生效(配置文件修改后仍需重启才能永久生效)。
5.7.7 参数 7:repl-timeout(心跳超时时间,维持连接参数)
(1)参数格式(配置文件中)
repl-timeout <seconds>(单位:秒,填写整数)
(2)参数作用
设置主从复制的 "心跳超时时间",用于判断主从连接是否正常,触发条件:
- 从节点:在
repl-timeout时间内,未收到主节点的PING命令(心跳),或未收到主节点发送的同步命令(命令传播、全量 / 部分复制的命令),则认为主节点宕机,标记master_link_status=down,并持续重试连接; - 主节点:在
repl-timeout时间内,未收到从节点的REPLCONF ACK命令(从节点的心跳),则认为该从节点离线,标记state=offline,停止向其发送同步命令。
简单说:该参数是主从连接的 "超时阈值",超过这个时间无通信,就认为连接断开。
(3)默认值
Redis 默认值为60秒,即主从节点超过 60 秒无通信,就认为连接断开。
(4)生产配置建议(分场景调整)
- 同机房部署、网络稳定:保持默认值
60秒,避免网络波动导致误判连接断开; - 网络不稳定场景(跨机房、无线网络):改为
30秒,缩短超时时间,更快发现连接断开,减少同步延迟; - 结合
repl-ping-replica-period配置:建议repl-timeout是repl-ping-replica-period的 3-6 倍(如repl-ping-replica-period=5秒,repl-timeout=30秒),避免因网络波动导致误判。
(5)注意事项(生产必避坑)
- 该参数所有节点都需配置(主节点和从节点),建议所有节点配置一致,避免出现判断不一致的情况;
- 超时时间设置过短(如 10 秒):容易因网络波动(如毫秒级卡顿)导致误判连接断开,从节点频繁重试连接,甚至触发全量复制,影响业务;
- 超时时间设置过长(如 120 秒):主节点宕机后,从节点长时间未发现,无法及时重试连接,同步延迟过大,业务读请求可能读取到旧数据;
- 修改该参数后,无需重启节点 ,命令行临时修改用
config set repl-timeout 30,立即生效(配置文件修改后需重启才能永久生效); - 连接断开后,从节点会每隔 1 秒重试连接主节点,直到重新连接成功,无需人工干预。
5.7.8 核心参数总结
| 参数名称 | 默认值 | 核心作用 | 生产推荐值(分场景) | 配置节点 |
|---|---|---|---|---|
| slaveof | 无配置 | 配置从节点同步的主节点(IP + 端口) | 一主一从 / 多从:slaveof 主 IP 6379;树形下层:slaveof 中间层 IP 中间层端口;跨机房:公网 IP | 从节点 / 下层从节点 |
| masterauth | 空字符串 | 从节点验证主节点密码 | 与主节点 requirepass 一致(如 masterauth Redis@123456) | 从节点 / 下层从节点 |
| slave-read-only(6.0 + 用 replica-read-only) | yes | 控制从节点是否开启只读模式 | 所有从节点:yes(开启);从节点晋升主节点时临时设 no | 从节点 / 下层从节点 |
| repl_backlog_size | 1MB | 设置主节点复制缓冲区大小,支持部分复制 | 同机房低并发:64MB;同机房中并发 / 跨机房低并发:128MB;跨机房中并发:256MB+ | 主节点 / 中间层从节点 |
| repl-disable-tcp-nodelay | no | 控制主节点是否启用 Nagle 算法(延迟 vs 带宽) | 同机房:no;跨机房:yes | 主节点 / 中间层从节点 |
| repl-ping-replica-period | 10 秒 | 主节点向从节点发送 PING 命令的频率(心跳) | 稳定场景:10 秒;不稳定 / 高可用场景:5 秒 / 3 秒 | 主节点 / 中间层从节点 |
| repl-timeout | 60 秒 | 主从心跳超时时间,判断连接是否断开 | 稳定场景:60 秒;不稳定场景:30 秒(建议是 ping 频率的 3-6 倍) | 所有节点 |
5.8 主从复制底层原理常见问题
前面讲解了主从复制的流程、命令、参数,实际生产中,主从复制难免出现故障(如同步失败、延迟过高、连接断开),这里结合底层原理,拆解 6 个最常见的故障,每个故障都包含 "故障现象、故障原因、排查步骤、解决方案",全程实战化,可直接用于生产故障排查。
5.8.1 故障 1:从节点无法连接主节点(master_link_status=down)
(1)故障现象(必看)
- 从节点执行
info replication,显示master_link_status=down(连接断开); - 从节点日志持续输出
Connecting to MASTER 主节点IP:端口,但始终无法连接,或提示Authentication failed; - 主节点执行
info replication,connected_slaves数量未包含该从节点,或显示该从节点state=offline; - 从节点无法同步主节点数据,业务读请求若走该从节点,可能读取到旧数据(若有)或报错。
(2)故障原因(按概率排序,必查)
- 密码不一致:主节点
requirepass与从节点masterauth密码不一致(最常见); - 网络问题:主从节点之间网络不通(防火墙未放行端口、IP 错误、网络中断);
- 主节点未启动:主节点宕机、未启动,或主节点端口错误(如误写 6380 为 6379);
slaveof配置错误:从节点slaveof参数配置的主节点 IP / 端口错误(如跨机房用内网 IP);- 主节点拒绝连接:主节点配置
bind参数,仅允许特定 IP 访问,从节点 IP 未在允许范围内; - 权限问题:从节点数据目录权限不足,无法创建临时文件(接收 RDB 文件时),导致连接失败。
(3)排查步骤(按简单到复杂,实战可直接套用)
步骤 1:检查主节点状态(最基础)
# 查看主节点是否启动(CentOS)
ps -ef | grep redis-server | grep 主节点端口(如6379)
# 若未启动,启动主节点
redis-server /usr/local/redis/conf/redis.conf

# 查看主节点端口是否可访问
netstat -nlpt | grep 主节点端口(如6379)
步骤 2:检查从节点slaveof和masterauth配置(最常见)
# 连接从节点,查看配置
redis-cli -p 从节点端口 -a 密码
127.0.0.1:从节点端口> config get slaveof
1) "slaveof"
2) "主节点IP 主节点端口"  # 确认IP和端口是否正确

127.0.0.1:从节点端口> config get masterauth
1) "masterauth"
2) "从节点密码"  # 记录密码,与主节点requirepass对比

# 连接主节点,查看requirepass配置
redis-cli -p 主节点端口 -a 主节点密码
127.0.0.1:主节点端口> config get requirepass
1) "requirepass"
2) "主节点密码"  # 与从节点masterauth对比,是否一致
步骤 3:检查主从节点网络连通性(防火墙、IP)
# 在从节点上,ping主节点IP,检查网络是否连通
ping 主节点IP
# 若ping不通,排查网络中断、IP错误

# 在从节点上,测试主节点端口是否可访问(telnet)
telnet 主节点IP 主节点端口
# 若提示"Connection refused",说明端口未开放,检查防火墙

# 检查防火墙配置(CentOS,开放主节点端口)
firewall-cmd --list-ports  # 查看已开放端口
# 若主节点端口未开放,开放端口(永久生效)
firewall-cmd --add-port=主节点端口/tcp --permanent
firewall-cmd --reload
步骤 4:检查主节点bind参数(是否限制 IP 访问)
# 连接主节点,查看bind配置
127.0.0.1:主节点端口> config get bind
1) "bind"
2) "127.0.0.1"  # 仅允许本地访问,从节点(非本地)无法连接
步骤 5:检查从节点数据目录权限(少见,但需排查)
# 查看从节点数据目录权限(CentOS)
ls -ld /var/lib/redis/从节点端口(如6380)
# 若权限不足(非777),修改权限
chmod 777 /var/lib/redis/从节点端口
(4)解决方案(对应故障原因,直接落地)
- 密码不一致:修改从节点
masterauth,与主节点requirepass完全一致,重启从节点;或临时修改从节点密码(config set masterauth 主节点密码),同步修改配置文件; - 网络问题:修复网络(重启路由器、交换机);防火墙开放主节点端口;确认主节点 IP 正确(跨机房用公网 IP);
- 主节点未启动:启动主节点,确认主节点配置文件正确(无语法错误);
slaveof配置错误:修改从节点slaveof参数(配置文件 + 重启),填写正确的主节点 IP 和端口;- 主节点
bind限制:修改主节点bind参数为0.0.0.0(允许所有 IP 访问,生产不推荐),或添加从节点 IP 到bind列表(推荐),重启主节点; - 权限不足:修改从节点数据目录权限为 777,重启从节点,重新建立连接。
5.8.2 故障 2:主从同步延迟过高(slave_repl_offset 与 master_repl_offset 差距大)
(1)故障现象(必看)
- 主节点执行
info replication,master_repl_offset值较大;从节点执行info replication,slave_repl_offset值较小,两者差距持续增大(如差距超过 1000); - 业务读请求走从节点时,读取到旧数据(如主节点已更新数据,从节点仍显示旧值);
- 从节点日志持续输出
MASTER <-> REPLICA sync: Receiving commands,但slave_repl_offset增长缓慢; - 极端情况下,延迟超过
repl-timeout,导致主从连接断开,重新触发全量复制。
(2)故障原因(结合原理,必查)
- 主节点写并发过高:主节点每秒写 QPS 过高(如超过 10 万),写命令生成速度超过从节点执行速度,导致延迟累积;
- 从节点性能不足:从节点 CPU、内存、磁盘 IO 不足(如 CPU 100%、内存溢出),无法及时执行主节点发送的写命令;
- 网络延迟过高:主从节点跨机房部署,网络延迟过大(如超过 100ms),命令传播延迟累积;或网络带宽不足,主节点发送命令速度受限;
- 全量复制未完成:从节点正在执行全量复制(加载 RDB 文件),加载期间无法执行写命令,导致延迟剧增;
- 复制缓冲区过小:
repl_backlog_size过小,主节点写命令快速覆盖缓冲区,导致从节点频繁触发全量复制,进一步增加延迟; - 从节点数量过多:一主多从架构中,从节点数量超过 5 个,主节点同步压力过大,命令传播延迟增加;
- 从节点开启持久化消耗性能:从节点同时开启 RDB 和 AOF 持久化,磁盘 IO 繁忙,影响写命令执行速度。
(3)排查步骤(实战可直接套用)
步骤 1:检查主节点写并发和负载
# 连接主节点,查看写命令执行情况(临时开启慢查询,捕捉写命令)
127.0.0.1:6379> config set slowlog-log-slower-than 0  # 记录所有命令
127.0.0.1:6379> slowlog get 10  # 查看最近10条命令,确认是否有大量写命令

# 查看主节点CPU、内存负载
127.0.0.1:6379> info stats
used_cpu_sys:10.5  # 系统CPU使用情况
used_cpu_user:25.3  # 用户CPU使用情况(过高说明负载大)
used_memory_human:8.00G  # 内存使用情况

# 查看主节点写QPS(approximate_keys_per_second)
127.0.0.1:6379> info stats | grep keys_per_second
步骤 2:检查从节点负载和执行速度
# 连接从节点,查看CPU、内存负载
127.0.0.1:从节点端口> info stats
used_cpu_sys:15.2  # 若CPU过高(如超过80%),说明性能不足
used_cpu_user:30.5
used_memory_human:8.00G  # 内存是否溢出

# 查看从节点是否正在执行全量复制
127.0.0.1:从节点端口> info replication
master_sync_in_progress:1  # 1=正在同步(全量/部分),0=未同步

# 查看从节点磁盘IO情况(CentOS)
iostat -x 1 3  # 查看磁盘IO使用率,若%util接近100%,说明磁盘IO繁忙
步骤 3:检查主从网络延迟和带宽
# 在从节点上,测试与主节点的网络延迟(ping)
ping 主节点IP -c 10  # 查看平均延迟,若超过50ms,说明延迟过高

# 测试主从节点之间的带宽(scp命令,传输文件测试)
# 在主节点创建100MB测试文件
dd if=/dev/zero of=test.txt bs=100M count=1
# 在从节点上下载,查看传输速度
scp 主节点IP:/root/test.txt /root/  # 若速度过低,说明带宽不足
步骤 4:检查复制缓冲区和从节点数量
# 主节点查看复制缓冲区使用情况
127.0.0.1:6379> info replication
repl_backlog_size:67108864  # 缓冲区大小
repl_backlog_histlen:67108864  # 已使用大小(若等于缓冲区大小,说明已写满)

# 查看主节点连接的从节点数量
127.0.0.1:6379> info replication | grep connected_slaves
connected_slaves:6  # 超过5个,同步压力过大
(4)解决方案
- 主节点写并发过高:
- 拆分主节点:将不同业务的数据拆分到多个主节点,分担写压力;
- 控制写并发峰值:通过业务限流,避免写请求集中爆发(如每秒写 QPS 控制在 5 万以内);
- 优化写命令:合并批量写命令(如用 mset 代替多次 set),减少命令数量。
- 从节点性能不足:
- 升级从节点硬件(增加 CPU 核心、扩大内存、更换 SSD 磁盘);
- 关闭从节点不必要的功能(如关闭 Redis 集群模式、禁用无用的日志);
- 新增从节点,分担读压力,减少单个从节点的命令执行压力。
- 网络延迟 / 带宽不足:
- 同机房部署:将主从节点部署在同一机房,降低网络延迟;
- 跨机房优化:开启
repl-disable-tcp-nodelay yes,合并数据包,节省带宽;升级跨机房带宽; - 树形拓扑:采用主 - 从 - 从架构,减少跨机房同步的数据量。
- 全量复制未完成:
- 选择业务低峰期执行全量复制(如凌晨);
- 优化全量复制:主节点关闭持久化,从节点开启持久化;开启无磁盘同步(
repl-diskless-sync yes); - 调大复制缓冲区,避免频繁触发全量复制。
- 复制缓冲区过小:修改主节点
repl_backlog_size参数(如从 64MB 改为 128MB),重启主节点,避免缓冲区快速写满。 - 从节点数量过多:
- 减少从节点数量(控制在 5 个以内);
- 采用树形拓扑架构,增加中间层从节点,分担主节点同步压力。
- 从节点持久化消耗性能:
- 优化 AOF 配置:
appendfsync everysec(每秒同步一次,平衡性能和安全性); - 关闭 RDB 持久化(仅保留 AOF),减少磁盘 IO 消耗;
- 定时在业务低峰期执行
bgsave,生成 RDB 备份,避免实时 RDB 消耗性能。
- 优化 AOF 配置:
5.8.3 故障 3:全量复制频繁触发(日志频繁出现 Full resync)
(1)故障现象(必看)
- 从节点日志频繁输出
Full resync requested by replica、Starting BGSAVE for SYNC,每几分钟或几小时触发一次全量复制; - 主节点 CPU、磁盘 IO 频繁飙升(BGSAVE 生成 RDB 文件),带宽被大量占用,影响主节点写请求处理;
- 从节点频繁加载 RDB 文件,加载期间无法处理读请求,业务报错或读取旧数据;
- 主从同步频繁中断,
slave_repl_offset反复重置为 0。
(2)故障原因(结合全量复制触发条件,必查)
- 复制缓冲区过小:
repl_backlog_size过小,主从节点短暂断连(如网络闪断)后,从节点slave_repl_offset超出缓冲区范围,触发全量复制; - 主节点重启频繁:主节点因故障、维护频繁重启,重启后生成新的
master_replid,从节点master_replid与主节点不一致,触发全量复制; - 主从连接不稳定:网络波动频繁,主从连接反复断开、重新连接,每次重新连接都触发全量复制;
- 从节点频繁重启:从节点因性能不足、故障频繁重启,重启后作为新节点,首次同步主节点,触发全量复制;
- 主节点执行
debug reload命令:该命令会重启主节点(软重启),生成新的master_replid,触发所有从节点全量复制; - Redis 版本不一致:主从节点 Redis 版本不同(如主节点 6.2,从节点 5.0),同步过程中出现兼容性问题,导致全量复制反复触发。
(3)排查步骤
步骤 1:查看从节点日志,确认全量复制触发频率和原因
# 查看从节点日志,过滤全量复制相关信息(CentOS)
grep "Full resync" /var/log/redis/redis-从节点端口.log
# 输出示例:1235:M 10 Feb 2026 15:00:00.000 * Full resync from master: 2fbd35a8b8401b22eb92ff49ad5e42250b3e7a06:0
# 若频繁出现,说明全量复制频繁触发

# 查看日志中是否有连接断开信息
grep "Connection with master lost" /var/log/redis/redis-从节点端口.log
步骤 2:检查主节点复制缓冲区使用情况
# 主节点查看复制缓冲区大小和已使用情况
127.0.0.1:6379> info replication
repl_backlog_size:67108864  # 缓冲区大小(默认1MB需修改)
repl_backlog_histlen:67108864  # 已使用大小,若等于缓冲区大小,说明已写满
repl_backlog_first_byte_offset:1000  # 缓冲区第一条命令的offset
步骤 3:检查主从节点重启记录
# 查看主节点重启记录(CentOS)
journalctl -u redis-server | grep "restart"  # 若频繁出现restart,说明主节点频繁重启

# 查看从节点重启记录
journalctl -u redis-server@从节点端口 | grep "restart"
步骤 4:检查主从节点网络稳定性和 Redis 版本
# 查看主从节点网络波动情况(CentOS)
ping 主节点IP -c 100 | grep "packet loss"  # 查看丢包率,丢包率过高说明网络不稳定

# 查看主从节点Redis版本
redis-server -v  # 主节点版本
redis-cli -p 从节点端口 -a 密码 info server | grep redis_version  # 从节点版本
(4)解决方案
- 复制缓冲区过小:调大主节点
repl_backlog_size参数(如从 64MB 改为 128MB/256MB),重启主节点;结合repl_backlog_ttl参数,实现缓冲区自动扩容 / 收缩; - 主节点重启频繁:
- 排查主节点重启原因(如内存溢出、配置错误、硬件故障),修复故障,避免频繁重启;
- 主节点关闭持久化,减少
BGSAVE和AOF触发的重启; - 采用主从切换,将频繁重启的主节点改为从节点,更换新的主节点。
- 主从连接不稳定:
- 优化网络环境(检查网络设备、减少网络拥堵);
- 调整
repl-timeout参数(如改为 30 秒),避免网络波动导致误判连接断开; - 同机房部署,减少跨机房网络波动的影响;
- 开启
repl-disable-tcp-nodelay no(同机房),减少命令传播延迟,降低连接断开概率。
- 从节点频繁重启:
- 排查从节点重启原因(性能不足、内存溢出、磁盘 IO 繁忙),升级硬件或优化配置;
- 减少从节点负载(新增从节点,分担读压力);
- 从节点关闭不必要的功能(如关闭持久化,仅主节点开启,不推荐,建议从节点开启 AOF)。
- 主节点误执行
debug reload:禁止在生产环境执行debug reload命令;若需重启主节点,选择业务低峰期,提前通知,避免影响业务; - Redis 版本不一致:将主从节点 Redis 版本统一(推荐 6.2.x 版本,稳定且支持所有核心功能);升级节点时,先升级从节点,再升级主节点,避免版本兼容性问题。
结语
hello 各位,到这里,Redis 主从复制从实战配置、拓扑架构、底层原理、故障排查四个核心维度,已经做了全网最细致、最落地的全解析,从基础的一主一从搭建,到高并发的一主多从、跨机房的树形拓扑,再到全量 / 部分复制的底层流程、核心命令与参数的深度拆解,甚至生产级的故障排查方案,全程手把手实战,把主从复制的每一个知识点、每一个避坑点都扒得明明白白。
回顾整篇内容,我们从生产中最致命的单点故障 切入,引出主从复制的核心价值 ------解决单点问题、实现读写分离、完成数据备份,这也是 Redis 从单节点走向分布式的第一步,更是后续哨兵模式、Redis Cluster 集群的底层基石,没有主从复制,Redis 的高可用、高并发就无从谈起。
我们把主从复制的核心逻辑,浓缩为最核心的3 个核心认知 和1 个终极原则,刻在脑子里,生产落地绝不踩坑:
3 个核心认知
- 角色分工定死:主节点只写、从节点只读(默认),数据流单向从主到从,从节点永远不能反向同步主节点,禁止关闭从节点只读模式,否则必出数据不一致;
- 同步流程固定 :所有主从复制的同步,都遵循建立连接→数据同步(全量 / 部分)→实时同步 + 心跳检测三阶段,首次同步必走全量,断连重连满足前提走部分,这是 Redis 的底层逻辑,无法更改;
- 核心命令 / 参数记死 :核心命令就 3 个 ------
slaveof配主从、info replication查状态、PSYNC做同步(底层自动执行);核心参数围绕密码、只读、缓冲区、网络、心跳展开,按场景套用生产推荐值,无需凭空配置。
1 个终极原则
主从复制的核心是 "取舍",所有配置和优化都是在 "性能、延迟、带宽、可用性" 之间做平衡:
- 同机房部署,优先保低延迟、高性能,关闭 Nagle 算法、调大缓冲区;
- 跨机房部署,优先保省带宽、稳连接,开启 Nagle 算法、配置合理心跳超时;
- 低并发场景,追求简单易维护,用一主一从 / 一主多从;
- 超高并发 / 跨机房场景,追求低主节点压力、高读性能,用树形拓扑。
很多同学学完主从复制会有疑问:"主从复制需要手动切主,可用性不够,生产中怎么用?"这正是主从复制的边界 ------ 它是 Redis 高可用的基础 ,但不是终点。生产中,我们会在主从复制的基础上,搭配哨兵模式 实现自动故障转移 (主节点宕机,哨兵自动选从节点升主),再搭配Redis Cluster 实现数据分片 + 多主多从,支撑百万级并发。但所有高级架构,都离不开主从复制的核心逻辑,把主从复制学透,后续的哨兵、集群就是 "水到渠成"。
学习主从复制的过程,也是学习分布式系统核心思想 的过程:数据同步、读写分离、故障转移、资源平衡,这些思想不仅适用于 Redis,也适用于 MySQL、MongoDB 等所有分布式数据库 / 缓存。把主从复制的底层原理、实战配置、故障排查吃透,不仅能搞定 Redis 的高可用,更能建立分布式系统的思维,为后续学习更复杂的分布式架构打下坚实基础。
本篇内容从理论到实战,从基础到进阶,从配置到排错,覆盖了主从复制生产落地的所有场景,建议大家收藏反复回看,结合本地实战敲一遍命令、搭一遍拓扑、模拟一次故障,把知识点变成实际操作能力。
后续,我们会在主从复制的基础上,继续拆解Redis 哨兵模式 (自动故障转移)、Redis Cluster 集群(数据分片 + 高可用),带你从单节点 Redis,一步步搭建出支撑中大型业务的分布式 Redis 架构,让你的 Redis 技术栈从 "基础" 走向 "实战"、从 "单点" 走向 "分布式"。
一步一个脚印打牢基础,生产环境才不会掉链子。我们下篇博客见~