。本文讲 区域 7 · 持久化恢复 :一次对话的所有状态变化都被写进一个追加式事件日志,崩溃之后从精确断点接着干。
0. 先建立心智模型
为什么 Agent 需要"先落盘,再动作"
前面几篇反复出现一句话:rollout.jsonl 是唯一事实源,内存只是它的投影。 为什么?因为 AI Agent 和普通 Web 应用有一个本质区别:
- Web 应用:一次请求进来,算完返回,进程崩了,丢的只是这一次请求;
- AI Agent:一次对话要跑几十轮、执行几十个工具,有些工具(比如
exec rm -rf、部署命令)有不可逆的副作用 。如果进程在"已经执行了副作用、但结果还没写进对话"的时候崩溃,重启之后你怎么知道那个命令到底跑没跑?
如果不知道,你有两个选择:重跑它 (可能造成二次伤害)或装作没发生(可能丢结果)。两个都错。
Grodex 的答案是把这一切变成可回放的事件 :每个关键动作,先写进日志,再动手。 日志不是事后记账,而是动作的前置条件。这样崩溃之后,日志就是唯一可信的"当时发生了什么"。
三个关键区分
- 事件日志(rollout)vs 对话转录(transcript):日志是完整事实,给恢复和审计;转录是给模型看的投影,可被压缩替换;
- 日志 vs SQLite :日志是唯一事实源;SQLite 的索引、内存的投影,都是可以从日志重建的派生------所以叫"单一事实源";
- 崩溃 vs 取消:崩溃是进程没了;取消是用户喊停。两者都会在日志里留下"中间态",都要被"治愈"成可重放的合法状态。
1. 一张日志,怎么被写出来:单写 Actor
rollout.jsonl 是追加式 JSON Lines 文件,每行一个事件。但它不是谁都能写的------有一个单写 Actor(JournalHandle)独占写路径 ,直接对文件 File::create().append(true) 是禁止的。为什么要独占?因为有几个性质必须被保证:
seq:物理顺序 = 逻辑顺序
每个事件有一个全局单调递增的 seq。seq 是在 Actor 内部、fsync 之前分配的 ,不是调用方拍脑袋给的。这保证了一件事:磁盘上的物理顺序 == 逻辑上的 seq 顺序------即使调用方并发发起写,日志也不会出现"序号 5 写在了 4 前面"这种交错。
写入失败:seq 不消耗
如果序列化 / 写 / flush / fsync 任何一步失败,seq 不会被消耗 (先返回错误、再决定是否 bump)。日志因此永远不会出现永久空洞------恢复时严格校验 seq 连续性,空洞 = 损坏。
fsync 分级:EveryN 与门事件
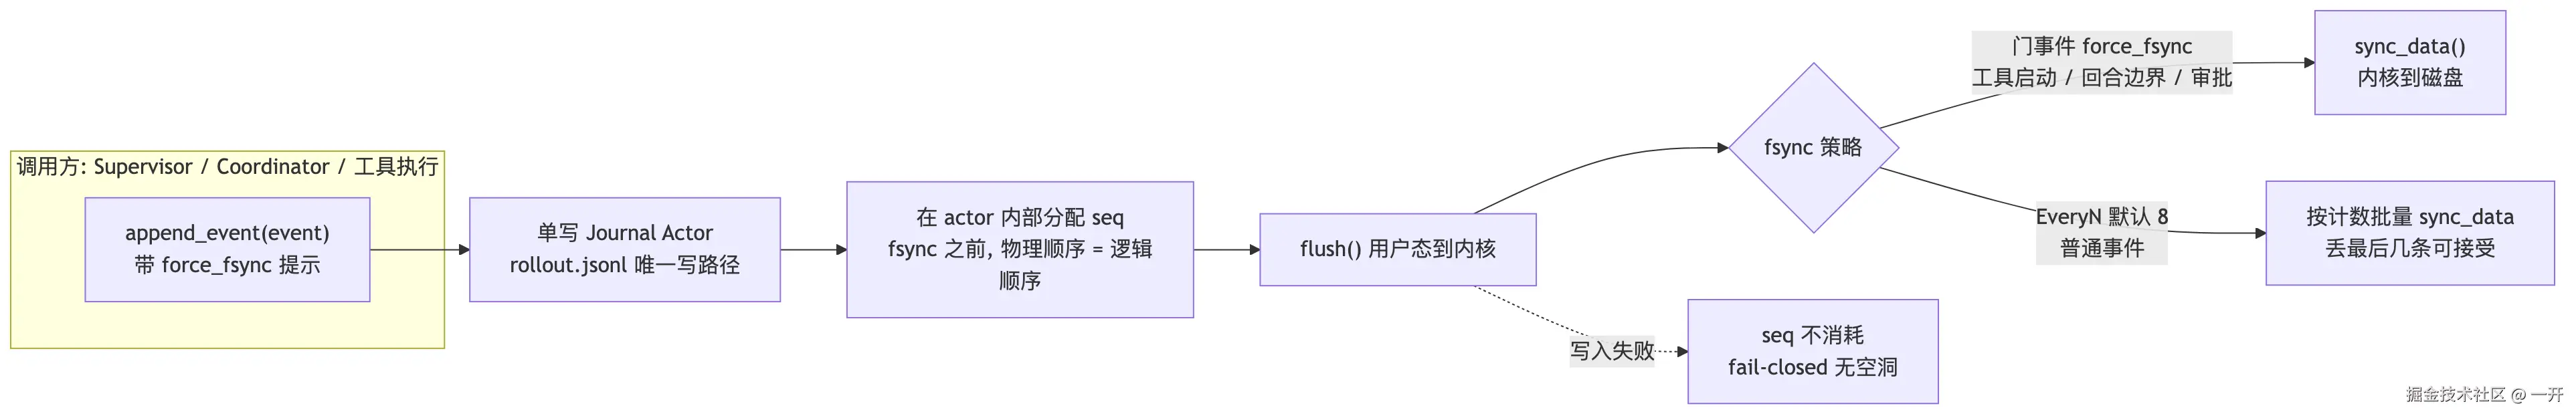
写进内核缓冲区(flush)和真正落盘(sync_data)是两回事。Grodex 用 FsyncPolicy 控制落盘频率:
| 策略 | 含义 | 用在 |
|---|---|---|
Always |
每件事都 fsync | 审批、工具启动、回合边界------正确性攸关 |
EveryN { n: 8 }(默认) |
每 8 件事批量 fsync 一次 | 流式文本/推理片段------丢了能重新采样 |
TestOnly |
从不 fsync | 仅测试(tmpfs) |
普通事件(write_state、write_user_input、write_step_started、write_model_output)走 EveryN:掉电丢最后几条是可接受的,resume 会重新采样 ;而门事件 (ToolExecutionStarted、ToolResultCommitted、ToolExecutionFinished、TurnCompleted、CompactionCommitted 等)强制 sync_data()------因为它们守护副作用和回合边界。
为什么
ToolExecutionStarted必须强同步?因为崩溃恢复是靠它找到"正在执行的工具"的。如果这个事件还在内核缓冲区里就崩了,恢复时根本不知道这个工具存在过------那才是真丢。
大内容外置:blob 的原子写
模型正文、工具输出可能几 MB,全塞进 JSONL 会让每行巨大。所以大内容走内容寻址 blob (SHA-256 命名),事件里只存 blob_ref + hash + size,由 read_artifact 工具按需读回。blob 的写入是原子写:写临时文件 → fsync → rename → fsync 目录。读者要么看到完整 blob,要么什么都看不到,永远不会读到半个文件。而且同名 hash 天然去重(同内容只存一份)。
2. 事件信封:一个统一的"事实"格式
每行事件是同一个信封(RolloutEvent):
bash
schema_version · seq · session_id · turn_id · step_id · generation · timestamp
event_type · payload · sensitivity- schema_version:前后兼容------旧版本日志读不懂时 fail-closed,而不是悄悄丢;
- generation:Step 代数,用来拒绝"迟到事件"(见 §3);
- sensitivity :
Normal / Credential / Personal------含凭据或个人信息的事件不得进入调试日志(脱敏前置,先分类后落盘,不能写了再删)。
事件类型覆盖了 agent 的每个关键动作:用户输入、模型产出、工具从准备→审批→启动→执行完→提交的五连、压缩、回合完成、子 Agent、租约、审批票据......每一个"状态变化"都是一行,没有例外(包括"应用自己发起的工具调用"------不经过模型的 AppOnly 调用也必须入账,这是不变量 #17)。
3. 从日志重建:Reducer 与代数栅栏
恢复的第一步是回放 (replay):把日志从头读到尾,喂给 SessionReducer,它折叠出完整的会话上下文。回放不是无脑拼接,它在路上做严格校验:
- seq 单调 :缺号直接报错(
SeqGap)、重号报错(DuplicateSeq); - 代数单调 :generation 倒退报错(
GenerationRegression); - 孤儿校验 :
TurnCompleted时还有没配对的工具调用 → 报OrphanedToolResult; - 会话匹配:事件属于别的 session → 拒绝。
配套一个 GenerationFence(代数栅栏),专门隔离迟到事件:恢复后代数递增,任何带着旧代数的迟到事件被 LateEvent 拒绝。这是不变量 #14 的落地------"迟到的审批、工具结果、后台通知,不能修改新代数的状态"。
严格模式 vs 容忍模式
恢复分两种模式:
- 严格模式(审计/崩溃测试):任何孤儿、任何缺口,直接失败------宁可报错,不猜;
- 容忍模式 (
/resume真实路径):用户按 Esc 中断的回合,日志里必然残留"工具调用了、结果没了"的孤儿。容忍模式治愈 它们:从ToolExecutionFinished捕获的内容合成 ToolResult(如果工具真跑完了),否则补一个明确的[interrupted] 结果未知------把中断也变成一条合法、可重放的事件(01 篇 §7 的治愈协议,这里由 reducer 实现)。
4. 恢复的智能:一个工具调用,崩溃后有五种"命运"
这是区域 7 最核心的部分。恢复时,Grodex 不仅重建上下文,还把每一个执行中的工具调用归类成五种命运 (ToolCallFate):
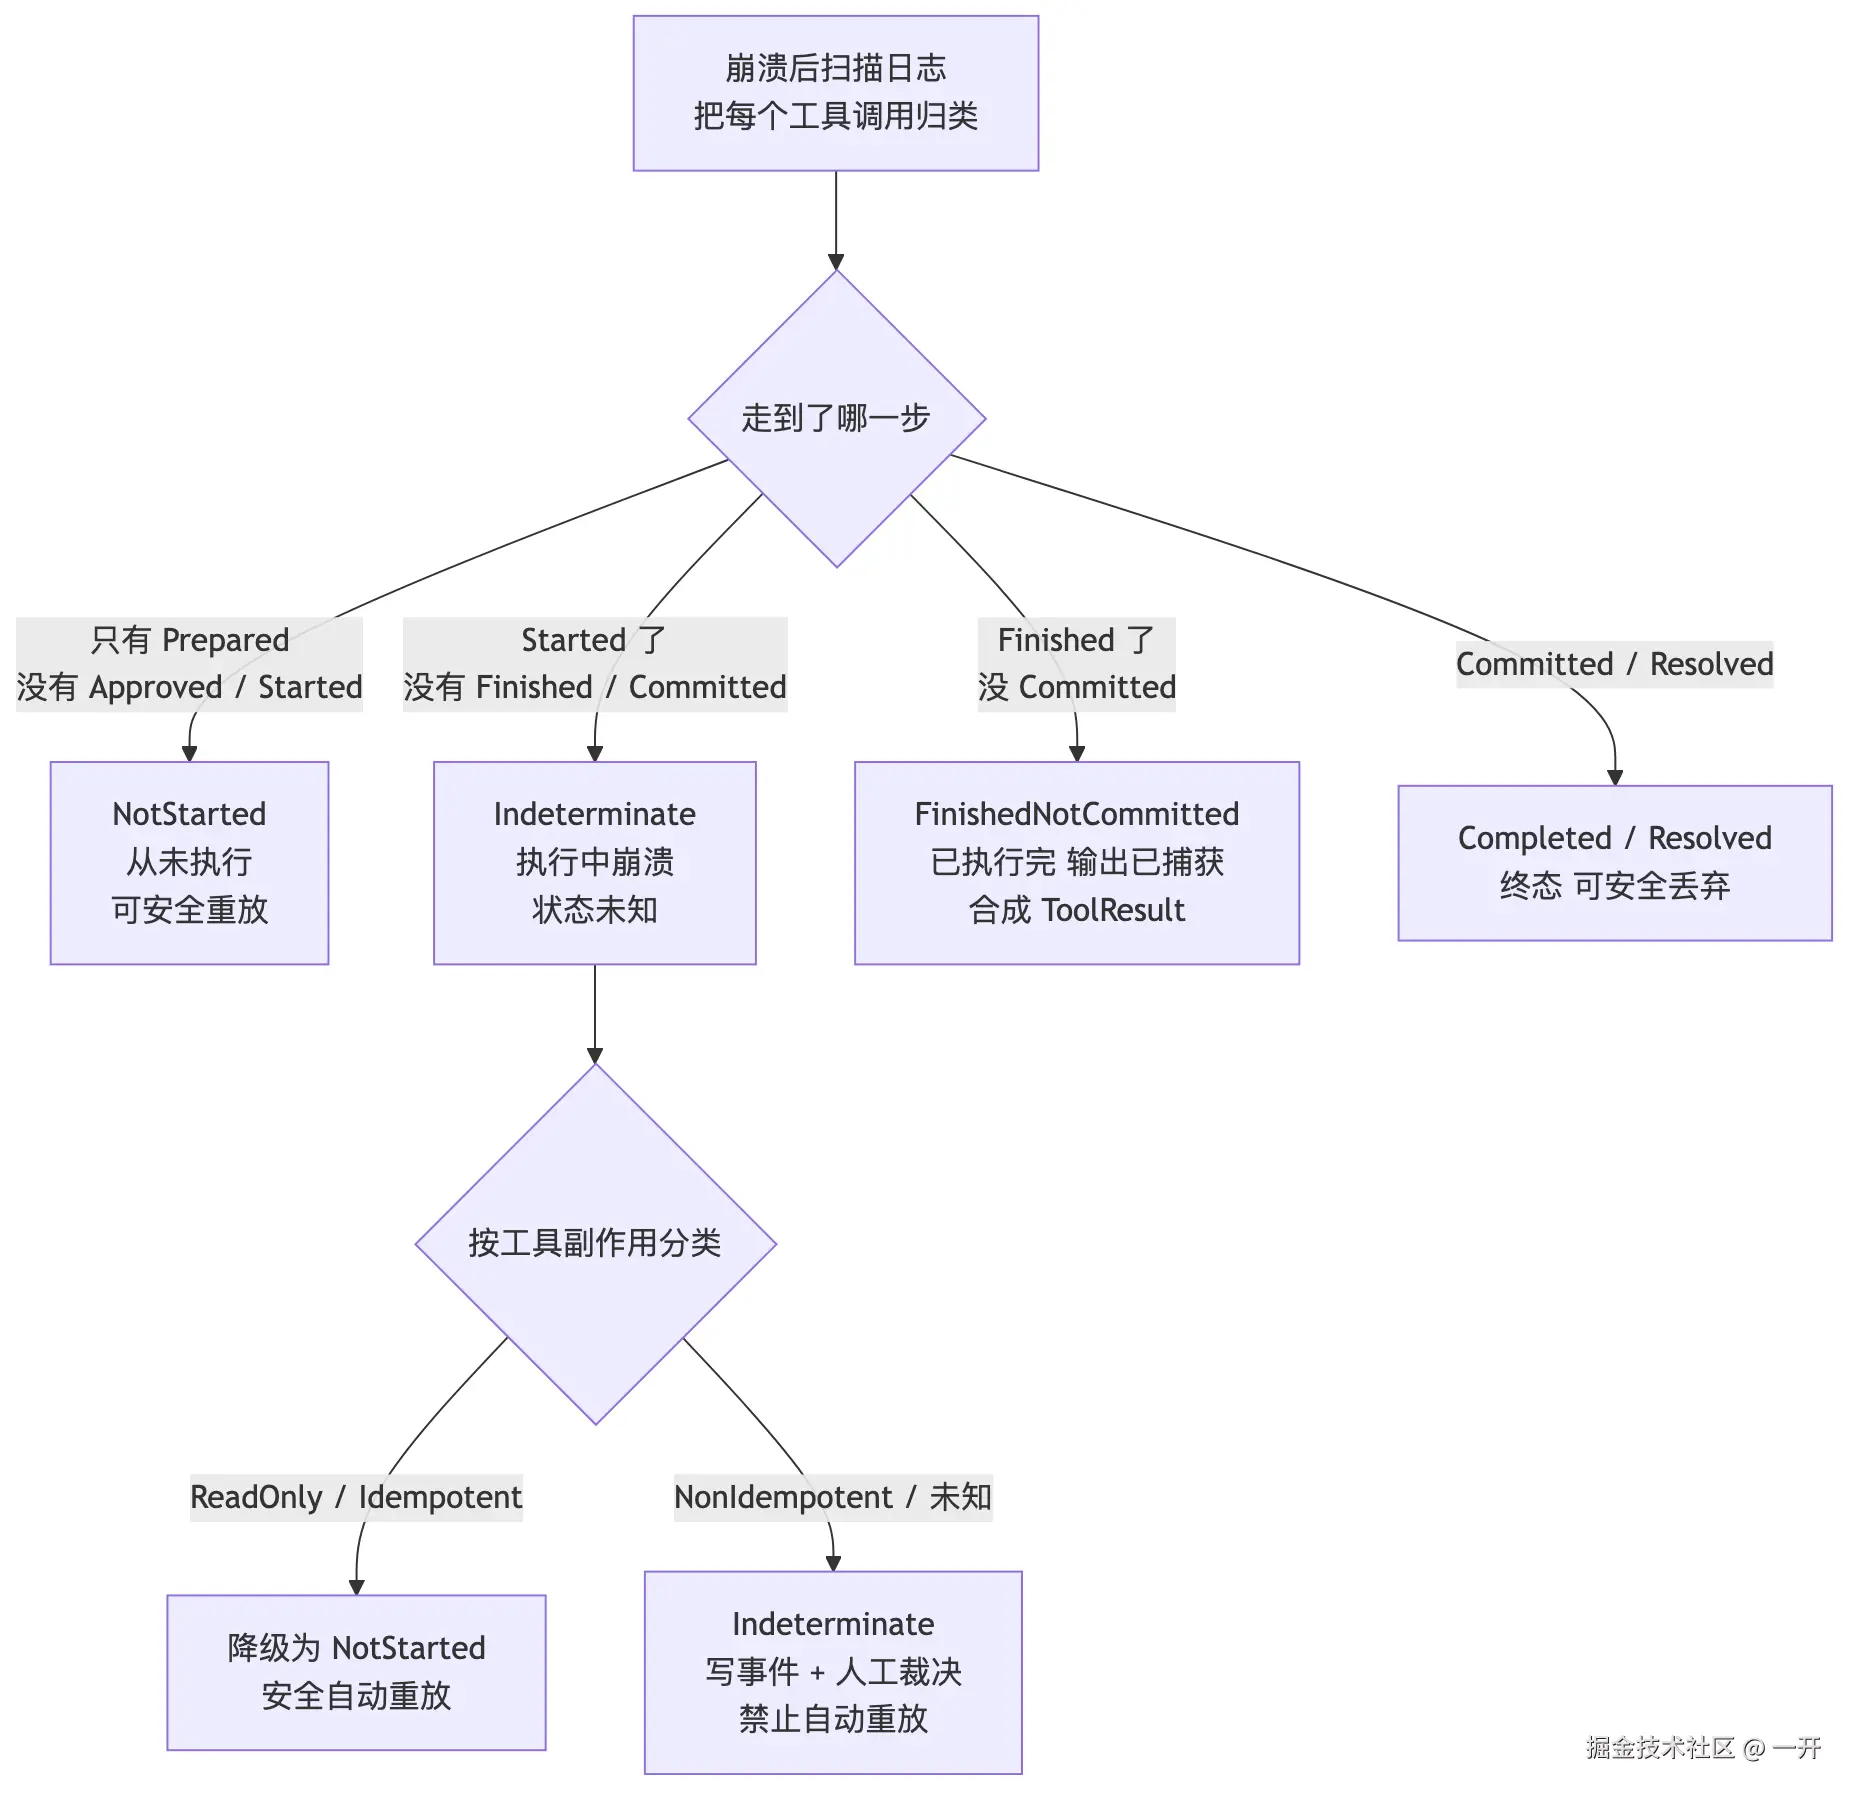
| 命运 | 含义 | 恢复行为 |
|---|---|---|
NotStarted |
准备过、没执行 | 安全重放(没产生任何副作用) |
Indeterminate |
执行中崩溃,副作用状态未知 | 写事件 + 人工裁决,禁止自动重放 |
FinishedNotCommitted |
执行完了、输出已捕获、没提交 | 从捕获内容合成 ToolResult(不用问人) |
Completed |
提交过了 | 安全丢弃 |
Resolved |
之前已裁决过 | 安全丢弃 |
最危险的是 Indeterminate:为什么禁止自动重放
一个工具 exec rm -rf 正在跑,进程崩了。它到底删了没删?你无法从日志判断 ------因为 Started 之后那个致命动作可能已经发生。这时自动重放是明文禁止的:万一第一次真的执行了,再跑一次就是二次伤害。
Indeterminate 的正确出路是走人工裁决协议:
- 恢复时发现
Started无Finished,写一条ToolOutcomeIndeterminate,把问题抛给前端; - 用户去查真实世界状态,然后选择:
Succeeded(确认执行成功,补结果)/Failed(确认失败或半截,补错误)/Retry(丢弃,让模型下轮重发); - 裁决写一条
ToolOutcomeResolved落盘------从此这条调用有了终态,下次恢复不会再问。
聪明的部分:副作用分类自动降级
不是所有执行中的工具都要惊动用户。恢复器带着一张 tool_name → SideEffectClass 的表(side_effect_map,03 篇 §5 提过):
- ReadOnly (如
read_file)→ 执行中崩溃 = 没副作用,自动降级为NotStarted,安全重放; - Idempotent → 配了
operation_id,重跑靠幂等键去重,自动降级为NotStarted; - NonIdempotent / 未知 → 降级失败,保持
Indeterminate,交给人类。
结果:read_file 卡住不会把整个 resume 堵在人工裁决上;exec rm -rf 则绝不会被悄悄重跑。 这是"工程上宁可谨慎"和"用户体验上不瞎问"之间的平衡------而且这个平衡是按每个工具声明的副作用等级自动做的,不是硬编码。
幂等记账与审批/租约恢复
RecoveryCheckpoint 还顺带恢复了几个跨崩溃的账本:
already_executed_operation_ids:已提交的 operation_id 集合。接受幂等键的工具必须拒绝重跑 集合里的键(is_safe_to_replay判 false);consumed_leases:已消费的一次性租约,恢复后同一租约禁止再次消费(防重放,呼应区域 6);resolved_tickets/requested_tickets:已经答复过的审批不重复问;还没答复的审批在恢复后重新抛给前端(你答到一半崩了,恢复接着问你)。
5. 一次完整的恢复:resume 全流程
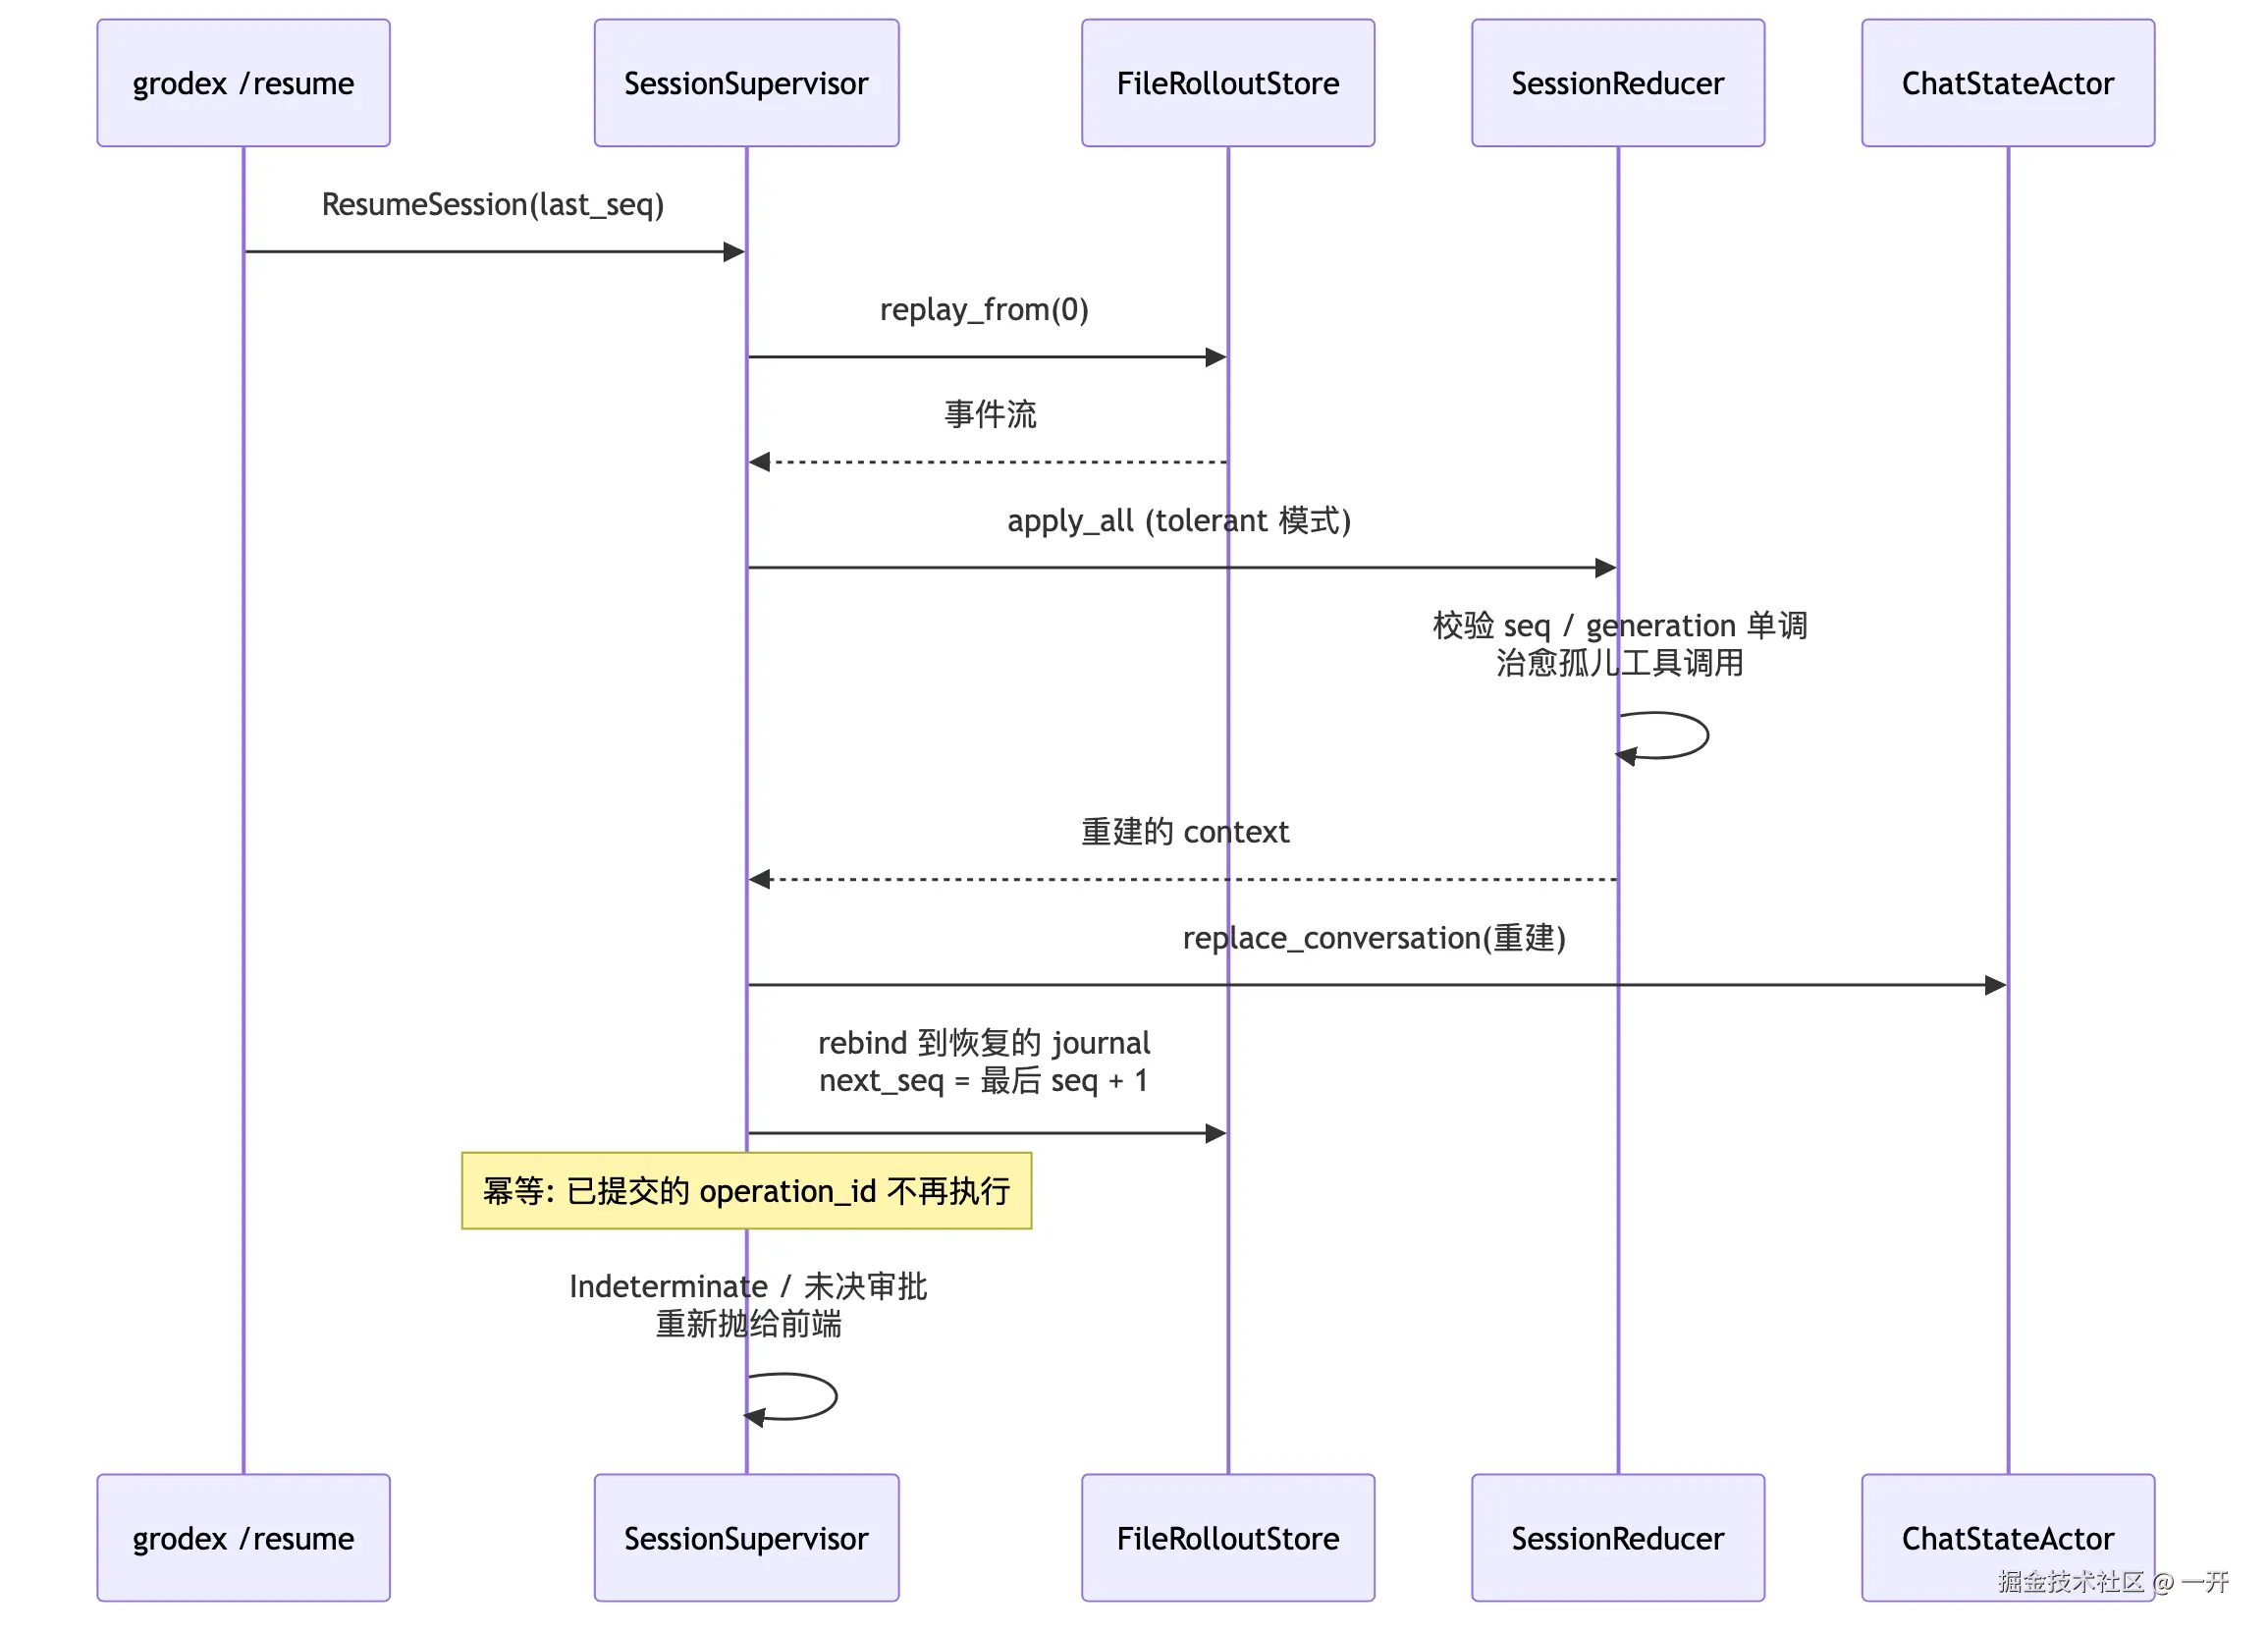
grodex /resume向 Supervisor 发ResumeSession;- Supervisor 让 store
replay_from(0)读回全部事件; SessionReducer(容忍模式)回放:校验 seq/代数单调 + 治愈孤儿 → 重建上下文;- 重建结果
replace_conversation写回 ChatStateActor------后续的 Turn 带着完整历史跑; - store rebind 到被恢复的 journal,
next_seq = 最后 seq + 1------新事件接着旧日志追加,不会开个新文件把历史丢了; - 幂等:已提交的 operation_id 不再执行;
- 把
Indeterminate调用和未决审批重新抛给前端处理。
rebind 的排队屏障:别把新会话写进旧日志
/resume 里最微妙的是 rebind :要把正在写的 store 从"临时新会话"切到"被恢复的旧会话"。如果不加保护,可能有一个在途的写请求还在飞,切换后写到了错误的地方。解决方法是 quiesce 屏障 :rebind 先等 Actor 排空在途队列、落盘,再换文件句柄;同时 Actor 对每条消息校验 session_id 作为兜底------要么干净地成功,要么明确报错,绝不静默污染。
一个真实踩过的坑:436 MB 的日志膨胀
早期版本每次 /resume 都会把整个恢复出来的上下文再写一条 ContextRestored 进同一个 journal------而原事件已经能重建上下文了,于是每 resume 一次,journal 就多一份全量副本。真实会话里观察到 436 MB 的重复快照。
修复(replay_journal_lean):回放时识别"冗余的 ContextRestored"------上下文非空时,这种事件只解析元数据头、跳过几 MB 的 payload 不物化,既省内存又不再重复写入。这段代码注释本身就是很好的工程叙事:"冗余快照是纯浪费,解析它的巨型 payload 是对内存的不尊重。"
6. 一次"中断"的治愈:取消也走日志
区域 7 不只管崩溃,还管取消后的日志完整性。用户在工具执行中按 Esc,回合任务被 abort------此时日志停在"工具调用了、结果永远不来"的中间态。Supervisor 会:
- 扫描转录,找到没有结果的孤儿 ToolCall;
- 给它们写一条
已中断的错误结果(write_tool_result_interrupted); - 用
write_turn_completed封顶回合。
治愈 = 把"被打断"也变成一条合法、可重放的事件,让日志永远闭合------否则下次 resume 的严格校验会报孤儿错误,会话永久不可恢复。这和 01 篇 §7 讲的取消协议是同一件事,区域 7 是它的落盘侧。
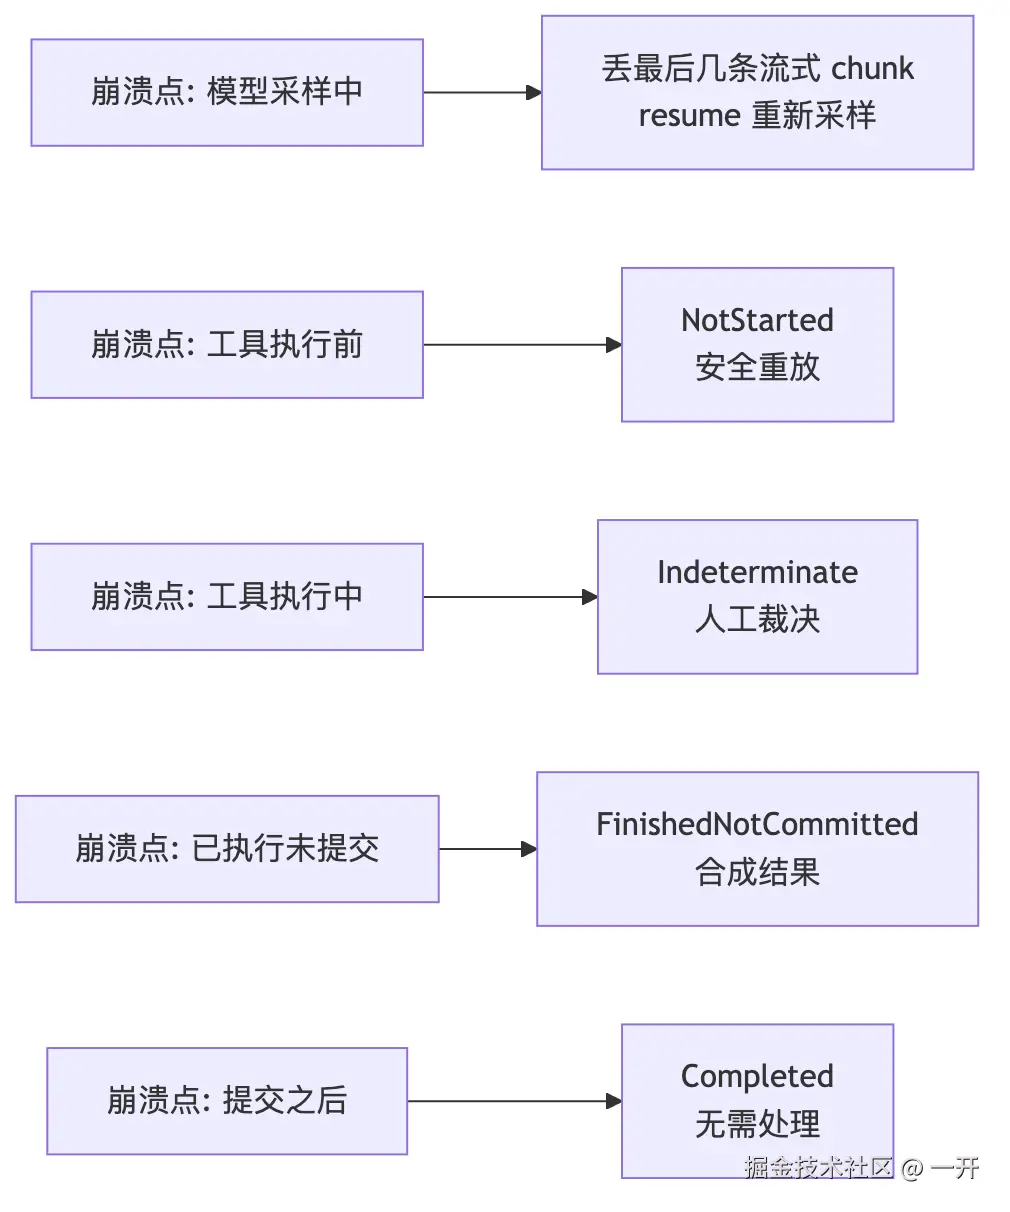
7. 崩溃发生在哪一步,恢复时就怎么办:场景矩阵
| 崩溃点 | 日志里有什么 | 恢复行为 |
|---|---|---|
| 模型采样中 | 最后几条流式 chunk 未落盘 | 丢弃可接受,resume 重新采样 |
| 工具派发后、执行前 | ToolCallPrepared,无 Started |
NotStarted,安全重放 |
| 工具执行中(只读/幂等) | ToolExecutionStarted,无 Finished |
自动降级 NotStarted,安全重放 |
| 工具执行中(非幂等) | ToolExecutionStarted,无 Finished |
Indeterminate,人工裁决 |
| 工具执行完、提交前 | ToolExecutionFinished,无 Committed |
FinishedNotCommitted,合成 ToolResult |
| 结果提交后 | ToolResultCommitted |
Completed,无需处理 |
| 审批发出后、答复前 | ApprovalRequested,无 Resolved |
恢复后重新抛给用户 |
8. 为什么没有"第二套事实源"
很多人会问:都有 SQLite 了,干嘛还搞个 JSONL?答案在 01 篇就写过(不变量 #13):rollout.jsonl 是唯一事实源;SQLite 索引、内存转录、前端快照,全都是可以从它重建的投影。
- 想审计?重放日志;
- 想恢复?重放日志;
- 想确认"当时模型看到了什么"?日志里的
PromptSnapshotBuilt+ 内容哈希; - 想修一个 bug 却搞不清状态?重放日志到那一步,断点看状态。
任何一层投影坏了,重放一遍就能重建;而日志本身被严格校验保护着(seq 单调、schema 版本、损坏 fail-closed)。单一事实源的价值就是:永远只有一个真相,而真相永远在盘上。
9. 小结
一句话总结区域 7:把"崩溃"从事故变成常态的工程。 单写 Actor 保证日志的物理顺序与逻辑顺序一致、写失败不产生空洞;fsync 分级让"正确性攸关的动作"强同步、"丢了能重算的内容"批量落盘;回放校验 seq 与代数单调;工具调用被归类成五种命运,只读/幂等的自动重放、非幂等的交给人类裁决;幂等记账、租约防重放、审批票据恢复一应俱全------每一个副作用都有据可查,每一次中断都能被治愈成合法状态。