一句话:browser4agent 是一个浏览器扩展 + 本地小程序,让任何 AI Agent 通过 MCP 或命令行使用你真实的、已登录的浏览器;再加上「页面工具」------AI 时代的油猴脚本。
GitHub:github.com/mantou132/b...
先看两组数据
让 Agent 总结一个网页,最常见的做法是把整页内容读给它。问题是:整页内容往往不是 Agent 需要的东西。
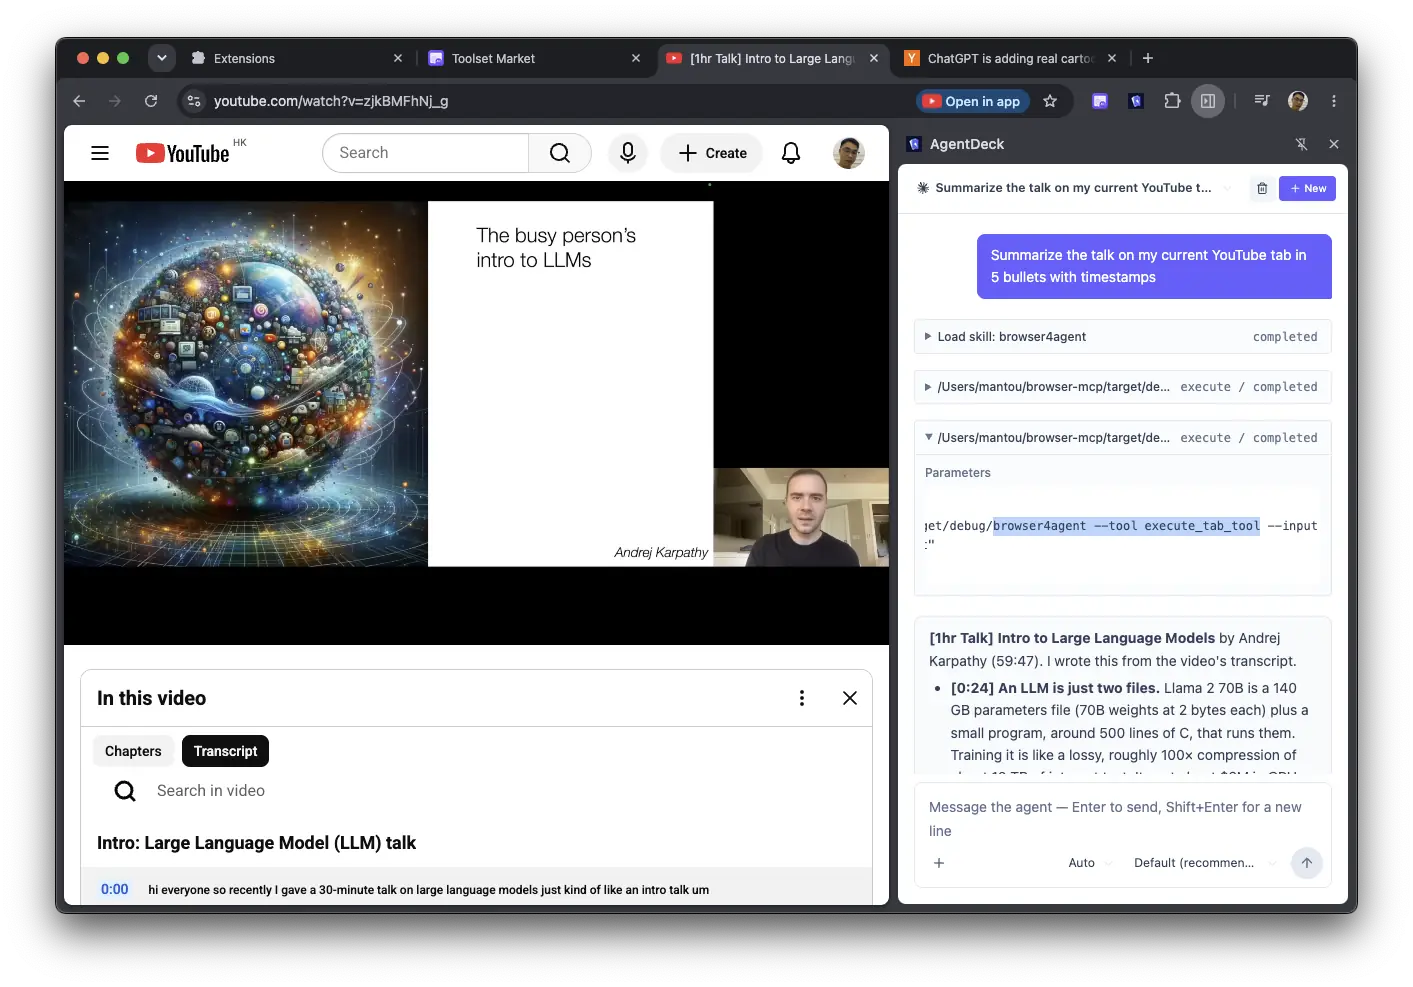
场景一:总结一个 1 小时的 YouTube 演讲
| 方式 | Token | 耗时 | 拿到的演讲内容 |
|---|---|---|---|
| 通用读取整页 | 12,937 | 36 ms | 抽查 20 句,一句都没有 |
页面工具 get_transcript |
32,126 | 1.0 s | 完整的 1,162 行带时间戳字幕 |
字幕不在页面里------要用户点开字幕面板才会渲染,字幕接口现在还要校验来源 token。所以通用读取只能拿到标题、简介和推荐视频,演讲说了什么,一个字都没有。
场景二:总结一个 682 条评论的 Hacker News 讨论
| 方式 | Token |
|---|---|
| 通用读取整页 | 约 14.2 万 |
| 截图(82 屏) | 约 11.5 万 |
get_thread 全部评论(结构化,带层级) |
约 7.8 万 |
get_thread({ max_depth: 0 }) 只要 45 条顶层评论 |
约 6 千 |
HN 本身是很干净的 HTML,通用读取也能拿到内容;页面工具的价值在于结构化 + 可过滤:同样的问题,只用 1/22 的 token。
数据测于 Chrome 157,token 用 OpenAI
o200k_base分词器估算,Claude 的计数会略有不同。完整测试
这就是我做「页面工具」的原因。
页面工具:AI 时代的油猴脚本
当年油猴(Tampermonkey)解决的问题是:网站不会照顾每个用户的需求,那就由社区给网站写脚本。
今天 Agent 面临同样的问题:网站是给人看的,不是给 Agent 用的。Agent 要么拿到一大坨 HTML,要么什么有用的都拿不到。
页面工具就是给 Agent 用的油猴脚本:按 URL 匹配网站,精确返回 Agent 需要的数据,或者帮它完成一个操作。 写法也很像油猴------一个 JS 文件,用注释声明元数据:
js
/**
 * @module Hacker News Tools
 * @description Read Hacker News story lists and full comment threads
 * @icon 🟧
 */

/**
 * Read the story and comments on the current item page; depth is the reply nesting level
 * @pattern https://news.ycombinator.com/item*
 * @param {{ limit?: number, max_depth?: number }} options
 * @param {number} [options.limit=200] - Maximum number of comments to return
 * @param {number} [options.max_depth] - 0 means top-level comments only
 */
export function get_thread({ limit = 200, max_depth } = {}) {
  // 在页面里直接用 DOM API 解析,返回结构化 JSON
}- 函数注释就是给 Agent 看的工具描述,
@param自动生成 JSON Schema 入参 @pattern决定工具在哪些网站出现,Agent 打开对应页面才能看到它- 代码跑在页面里,天然带着你的登录态
怎么获得工具:
- 扩展内置市场:一键订阅。目前已有 YouTube、Hacker News、Google Docs、Google Sheets 等社区工具集,内置还有通用表单填写、表格提取、Gmail 写草稿、飞书文档编辑等工具
- 社区仓库 :browser4agent-toolsets,欢迎 PR。每个工具集都在公开 PR 里审核后才发布
- 网站自己提供 :网站通过 WebMCP 注册的工具,扩展会自动接入。页面工具和 WebMCP 工具是同一个形状(名字、描述、JSON Schema、执行函数),哪天网站官方支持了,社区版就可以退场
不挑 Agent,不挑浏览器
- Agent:Claude Code、Codex、Cursor、VS Code、Zed、Antigravity 通过 MCP 接入;不支持 MCP 的 Agent,可以通过命令行 Skill 接入------能跑 shell 命令就能用
- 浏览器:Chrome、Edge、Firefox
- 安装向导自动配置:检测到上面哪些 Agent,就帮你写好 MCP 配置或装好 Skill
不用换一个 AI 浏览器,也不被某家厂商的 Agent 绑定。厂商自家浏览器扩展用不了的地方,它也能用。
用的是你真实的浏览器
Playwright 这类方案通常另起一个浏览器实例,Agent 要访问需要登录的页面,你得在里面重新登录一遍;遇到 SSO、内网、二次验证就更麻烦。
browser4agent 直接在你日常用的浏览器里工作:你登录了什么,Agent 就能访问什么。读公司内网文档、看后台数据、整理邮件草稿,都不用额外处理登录。
为前端开发者准备的能力
除了读页面、管理标签页,它还给 Agent 提供了一整套调试能力:
- 页面报错、Cookie、localStorage、截图
- 在标签页里执行 Agent 现写的脚本
- 在扩展后台执行脚本,管理标签页和窗口
- Chrome DevTools Protocol(Chromium 内核):拿网络响应体、做性能指标采集等底层调试
举个真实例子:我让 Agent 调一个卡片展开动画。它通过 CDP 采集 LayoutCount、LayoutDuration,再注入脚本用 requestAnimationFrame + ResizeObserver 逐帧采样,定位到 350ms 动画里文本重排了 40 多次,然后改代码把重排降到 0。整个过程不需要我盯着 DevTools。完整案例
还有一个命令行入口,写脚本、快速检查都很方便:
bash
browser4agent --tool list_tabs
browser4agent --tool read_tab --input '{"tab_id": 123}'
本地运行,没有遥测
Agent 连接的是本机 127.0.0.1 上的 Native Host,Native Host 再和扩展通信。不经过任何云端中转,没有任何遥测。
关于安全,说实话
Agent 接入后能做你在浏览器里能做的一切,所以我不想把安全说得很轻松:
- 最大的风险是提示词注入。 Agent 读到的网页里可能藏着针对它的指令,而它手里有你浏览器的全部权限。这个问题扩展单方面解决不了。建议使用执行工具前会征求确认的 Agent,不要让它无人值守地浏览不可信内容
- 页面工具是跑在你页面里的代码。 市场在订阅和更新前都会展示完整代码,更新不会自动推送,要你看过新代码后手动更新。只订阅你信任的工具集
- 本地服务只监听回环地址 ,拒绝
Host不是回环地址的请求(防 DNS 重绑定),只接受application/json请求------这类请求需要 CORS 预检,而服务端从不放行,所以网页调不到它。本机以你的用户身份运行的程序可以调用它------这和你磁盘上的浏览器配置文件是同一个信任边界
三步上手
-
安装本地程序并运行安装向导:
bash# macOS / Linux brew install mantou132/tap/browser4agent && browser4agentWindows 用 Scoop,见 README
-
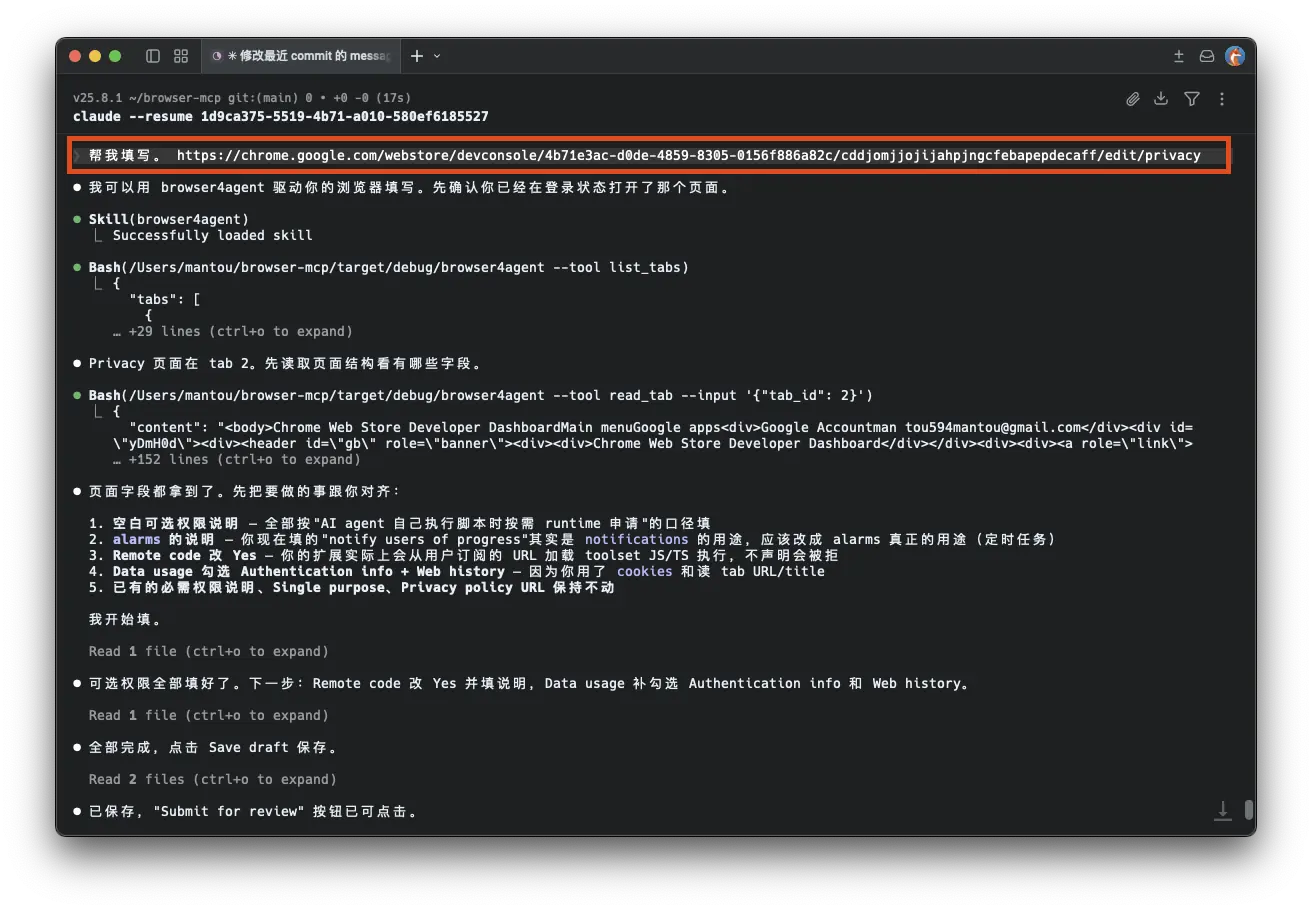
在向导里选择要配置的 Agent,然后对它说:「帮我总结一下当前标签页」
最后
这是我一个人维护的开源项目。如果你有经常让 Agent 处理、但它总是处理不好的网站,欢迎来 browser4agent-toolsets 提 issue 或者直接写一个工具集------就像当年给网站写油猴脚本一样。
觉得有用的话,给个 Star ⭐:github.com/mantou132/b...