提取网站的设计风格有两种常见方法。第一种是把页面截图交给视觉模型,由模型识别颜色、字体、间距和页面结构;第二种是输入网站 URL,由浏览器加载页面,再读取 DOM、计算样式、响应式布局和交互状态。
截图适合分析单个画面。URL 分析可以比较多个页面、视口和状态,还能记录每条规则来自哪里。本文配合我做的开源项目 Imprint 及其 Astro 公开案例,讲解第二种方法的实现。
Imprint 是本地运行的桌面应用。它的输入是网站 URL,输出包括 DESIGN.md、CSS Variables 和 Tailwind v4 @theme。DESIGN.md 是普通 Markdown 文件,Claude Code、Gemini CLI 以及其他能够读取项目文件的 Coding Agent 都可以使用。本文使用 Codex CLI 来演示生成目标页面。
为什么需要提取网站的设计风格
一张截图可以提供颜色、字号、边距和当前布局,但它没有记录这些数值之间的关系。
例如,截图中有一个 16px 的间距。这个值可能是全站间距尺度的一部分,也可能只是某个卡片的局部调整;同样的蓝色可能用于主要按钮,也可能只是插图中的装饰色。但是只看当前画面无法区分这两种情况。
响应式和交互状态也不在静态截图里。桌面端的三列布局到了移动端是改成单列、隐藏部分内容,还是调整区块顺序,需要比较多个视口。Hover、Focus、Disabled 和展开状态则要在页面运行后观察。
任务只包含一个静态页面时,Coding Agent 可以根据截图处理当前画面的视觉样式。当任务扩展到列表页、设置页和移动端后,这些颜色、间距和组件样式还是要在多个页面之间保持一致的。但是单张截图没有记录这些跨页面规则,所以 Coding Agent 可能会为各个页面分别补充样式,最终造成页面之间的风格差异。
原始 CSS 还需要结合渲染结果
直接抓取样式表可以得到更多数据,但数据里会混入未使用的规则、第三方组件样式、重置样式和构建后的类名。CSS 声明还要经过层叠、继承、媒体查询和运行时状态,才能变成页面采用的样式。
截图、CSS 和 DOM + 计算样式分别记录页面渲染过程中的不同信息:
text
截图:指定视口和状态下的像素结果
CSS:页面可能使用的样式声明
DOM + 计算样式:元素当前采用的样式结果
分析网站 URL 时,不能只读取 CSS。浏览器需要先把网站运行起来,再从可见元素中读取最终样式,同时保留页面、视口、元素角色和交互状态等来源信息。
实战演示:Astro URL → DESIGN.md → Harbor Deploy
先看 Astro 公开案例。来源网站是 https://astro.build/,目标页面是一个中性的部署控制台 Harbor Deploy。
这次运行依次完成以下操作:
- Imprint 加载 Astro URL,分析首页、博客页和服务商页面。
- 分析结果导出为
DESIGN.md、CSS Variables 和 Tailwind v4 主题。 - Codex CLI 读取导出的设计文件,以及 Harbor Deploy 对路由、表格、筛选和设置的页面需求。
- 任务文件另外规定,生成页面不能复制 Astro 的品牌、文案、素材和页面结构。
- Codex CLI 生成概览、部署记录和设置三个页面。
Astro 的宣传页、博客页和服务商页面使用了相近的深色视觉语言,但页面内容结构不同。目标页改用部署控制台结构,包含指标卡片、部署表格、筛选、设置和状态反馈,并排除 Astro 的品牌文案、插画和页面结构。
下面是 Imprint 在加载网站后自动保存的 Astro 首页截图:
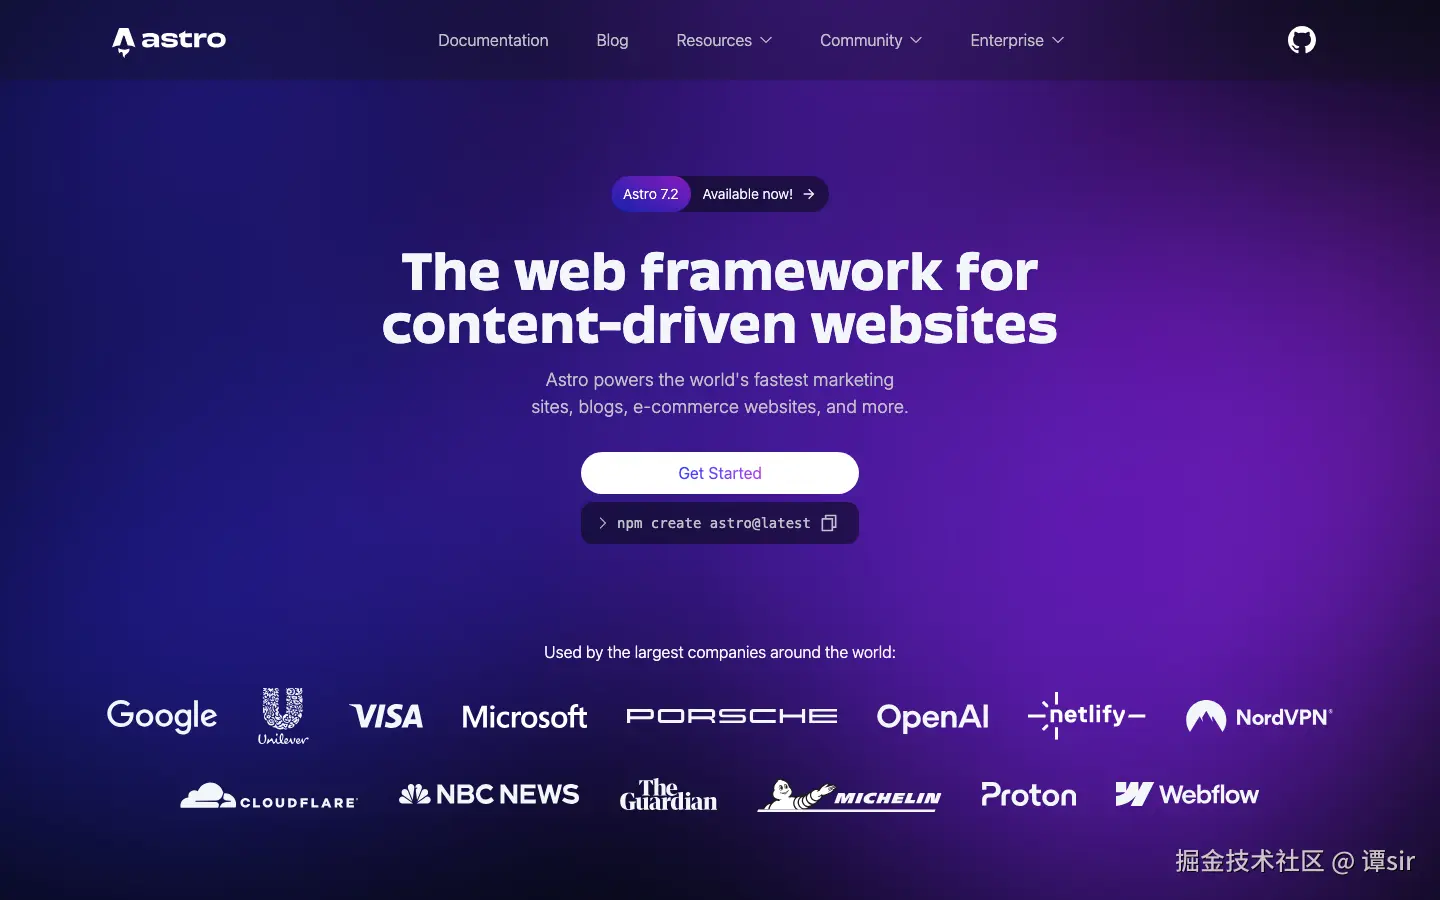
这张图只用于记录来源,没有作为分析输入,也没有传给 Codex CLI。Agent 收到的是 DESIGN.md、样式变量和产品任务。排除来源截图后,可以检查 Agent 是否根据文档复用设计规则,避免直接复制 Astro 的页面结构。
生成的 Harbor Deploy 概览页如下:
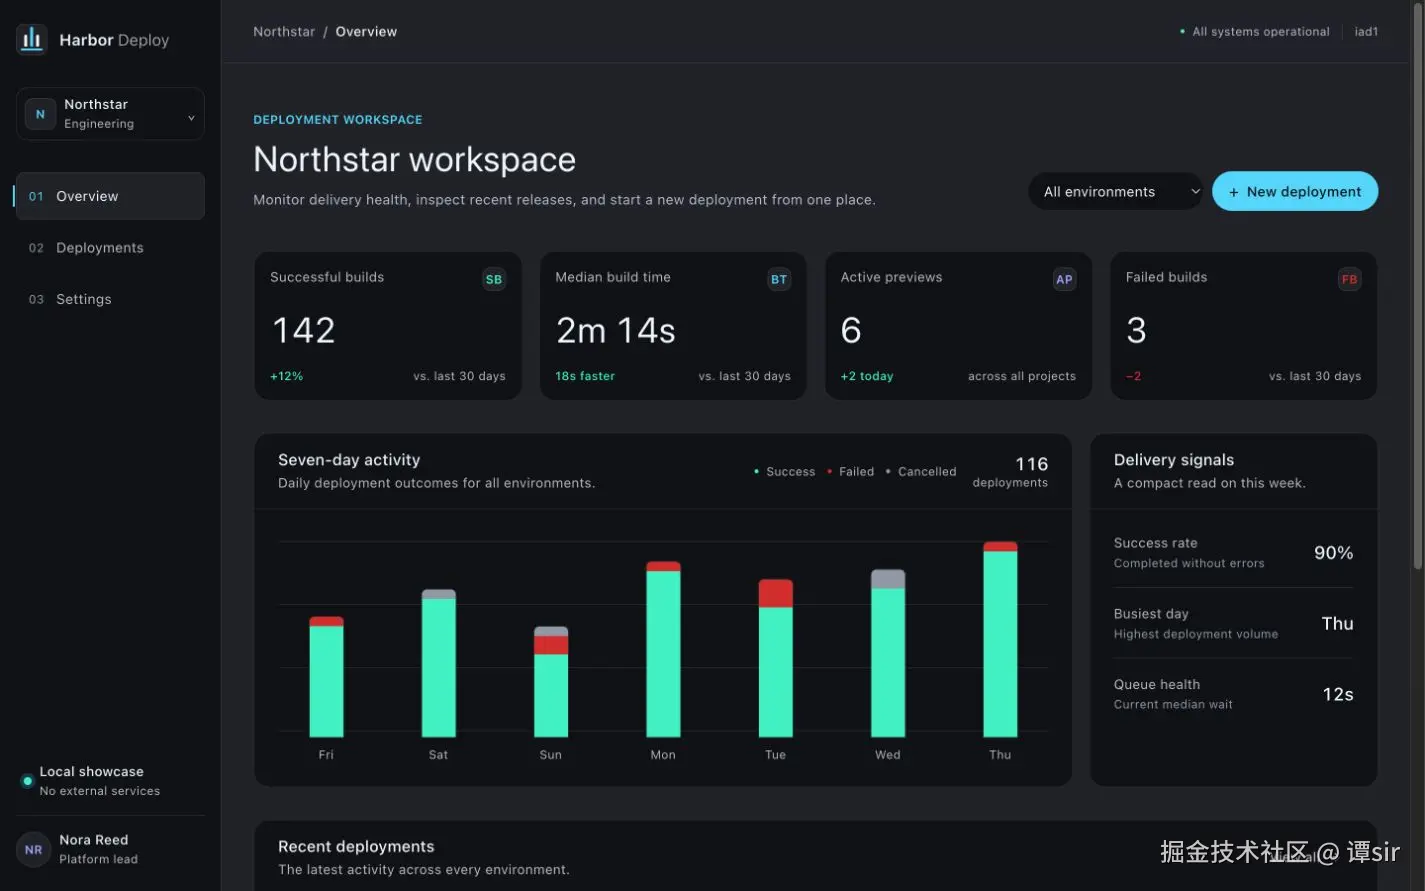
本案例记录了固定的运行环境和验收结果。Imprint 0.1.0 分析了 3 个页面,共完成 6 次页面捕获,覆盖桌面、平板和移动端视口,耗时 36.8 秒。交互分析发现 36 个候选,其中 3 个完成安全观察,另外 33 个被跳过。生成结果分别在 1440 × 900 和 390 × 844 下检查,浏览器控制台没有警告或错误。
视频中的 Desktop 分析实际等待了 44 秒,成片压缩了等待过程。36.8 秒来自另一轮固定案例运行,所以视频用于展示操作顺序,案例目录中的文件和 manifest.json 才是本次结果的来源记录。
DESIGN.md 保存什么
从页面中收集颜色和尺寸后,还要把数值整理成可以复用的规则。下面节选 Astro 案例生成的两条核心规则:
markdown
#### Core Design Rules

- **Typography:** Use ui-sans-serif, system-ui, sans-serif ...
  with the captured sizes 1rem and weights 300, 400.
  _(high confidence · evidence refs: 3 · scope: astro.build/ · desktop;
  astro.build/agencies · desktop; +1 more scope)_

- **Density and rhythm:** Build recurring padding and gaps from
  the most-used observed spacing values: 16px, 32px, 48px, 80px.
  _(high confidence · evidence refs: 40 · scope: astro.build/ · desktop;
  astro.build/agencies · desktop; +1 more scope)_
这里不只列出了字体和间距值,还写了置信度、来源数量和适用范围。完整的 DESIGN.md 又把内容分成几类:
Core Design Rules保存有跨页面支持、可以作为默认选择的规则。Contextual Component Patterns保存按钮、输入框等组件在特定场景下的样式,不能直接扩展成全局规则。Local Design Observations保存只在某个页面、区块或视口出现的事实。Unknowns and Coverage Gaps记录没有观察到、无法可靠匹配或需要补充证据的内容。Design Evidence Overview汇总页面、视口、组件、交互和截图来源。
Astro 案例把 16px / 32px / 48px / 80px 写入核心间距规则,因为这些值获得了足够的跨页面支持;圆角没有形成同样的全局结论。文档只允许在匹配的按钮或输入框上使用对应圆角,不能因为多次观察到 9999px,就把所有卡片都改成胶囊形。
置信度表示当前结论获得了多少来源支持,不评价来源网站或生成结果的质量。Astro 文档中有 56 条高置信度、32 条中等置信度和 5 条低置信度结果。字号 0.844rem、字间距 0.4px 和圆角 6px 等项目被单独列入复查清单,用户可以直接定位,无需重新检查整份文档。这类标记不会阻止导出,只用于提示复查,也便于后续人工审核。
这也是 DESIGN.md 和一份 Token 列表的主要区别。Token 告诉 Agent 可以用哪些值,DESIGN.md 还要说明这些值该用在哪里、哪些情况没有足够证据。
从 URL 到 DESIGN.md
Imprint 按以下顺序处理网站 URL:
text
网站 URL
    ↓
Chrome / Edge 加载页面
    ↓
发现并选择代表性页面
    ↓
采集桌面、平板和移动端证据
    ↓
读取 DOM、计算样式、页面结构和安全交互状态
    ↓
归一化颜色、字体、间距、圆角和阴影
    ↓
生成 Token、组件模式和来源记录
    ↓
导出 DESIGN.md、CSS Variables 和 Tailwind 主题
用浏览器加载页面
普通 HTTP 请求只能取得服务器返回的 HTML。SPA 的主体可能只有一个空容器,Web Font 尚未加载,客户端路由和运行时组件也没有执行。此时读取 HTML,拿不到用户最后看到的 DOM,更没有元素的计算样式。
Imprint 使用 playwright-core 控制电脑上已有的 Chrome、Edge 或兼容 Chromium。playwright-core 本身不附带浏览器,因此电脑没有安装兼容浏览器时,分析会停止并显示原因。
页面打开后,分析器会等待主要资源和字体加载,检查登录墙、验证码、错误页等页面状态,并冻结会影响截图和尺寸测量的动画。随后才开始提取。入口页会按用户选择的视口依次运行:
typescript
for (let i = 0; i < viewportNames.length; i++) {
  throwIfAnalysisAborted(analysisSignal)
  const vpName = viewportNames[i]
  const viewport = VIEWPORTS[vpName] || VIEWPORTS.desktop

  const page = i === 0 && initialPage && !initialPage.isClosed() ? initialPage : await runtime.context.newPage()
  await configurePageViewport(page, vpName, viewport)
  const pageResponseStatus = page !== initialPage ? await navigatePage(page, url) : responseStatus

  const preparation = await preparePageForExtraction(page)
  const health = await ensurePageHealth(page, {
    expectedUrl: url,
    responseStatus: pageResponseStatus,
  })
  // 通过健康检查后再提取样式和页面证据
}
这段代码来自 src/core/analyzer/index.ts。实际实现还会记录每个阶段的失败原因,避免某个视口加载失败后仍然生成完整覆盖的结论。
选择页面和视口
只分析首页容易把首页特有的品牌展示当成全站规则。内容页、列表页和博客页能提供不同的排版密度和组件实例。
Imprint 会读取页面链接和 Sitemap,再按通用 URL 语义给候选页面分类。例如,/blog/ 通常归入博客类,文档路径和价格路径对应另外两类页面。候选链接会去重,选择时降低同类页面反复入选的优先级。这里没有 Astro 域名、品牌名称、CSS 类名或测试 ID 的专用分支;同一套逻辑用于其他网站。
入口页按所选桌面、平板和移动端视口采集。发现的子页面先使用主要视口,页面结构出现移动端变化信号时再补充移动视口。Astro 案例最终形成 3 个页面、6 次捕获,各页面的捕获数量由视口选择和页面结构信号决定。
响应式结论还需要确认两个视口中的区块是同一个区块。DOM 路径相近但语义角色不同,分析器就不比较它们。Astro 案例因此保留了 responsive-section-identity-mismatch 限制,没有把无法确认的区块顺序写成响应式规则。
读取 DOM 和计算样式
浏览器的 getComputedStyle 返回元素在当前状态下采用的样式。它已经处理了样式层叠、继承、媒体查询和 CSS Variables,比读取原始声明更接近页面的实际结果。
页面可能包含几千个 DOM 节点。Imprint 先排除隐藏和零尺寸元素,再记录文字色、背景色、字体、间距、边框、圆角、阴影和布局属性。提取器中的可见性判断如下:
typescript
for (const el of elements) {
  const computed = getComputedStyle(el)

  if (computed.display === 'none' || computed.visibility === 'hidden' || computed.opacity === '0') continue

  const rect = el.getBoundingClientRect()
  if (el !== document.documentElement && el !== document.body && (rect.width <= 0 || rect.height <= 0)) continue

  const color = normalizeObservedColor(computed.color)
  const bgColor = normalizeObservedColor(computed.backgroundColor)
  // 继续记录元素角色、样式值和来源
}
提取器仍会保留可见的布局容器。一个没有文字的 <div> 也可能提供页面背景、卡片边框或区块间距。分析器会结合标签、ARIA 属性、链接状态和几何信息判断元素角色。
同一个数值也会按用途分别计数。16px 可能来自字号、内边距或网格间隙;只有来源类别相同,才会进入同一组候选。这样可以避免把常见字号直接当成间距 Token。
归纳颜色、字体和间距
颜色不能只按出现次数排序
浏览器可能返回 HEX、RGB、RGBA 和带透明度的颜色。Imprint 先把颜色统一成稳定格式,再按 RGB 距离合并近似值。聚类代码的主体如下:
typescript
function clusterFrequency(
  frequency: ColorFrequency,
  limit = 20,
  threshold = 30,
): Array<{ hex: string; count: number }> {
  const parsed: ColorRGB[] = []
  for (const [colorStr, count] of frequency) {
    const color = parseColor(colorStr)
    if (!color) continue
    color.count = count
    parsed.push(color)
  }
  parsed.sort((a, b) => b.count - a.count || stableColorKey(a).localeCompare(stableColorKey(b)))

  const clusters: ColorRGB[][] = []
  for (const color of parsed) {
    const cluster = clusters.find((candidate) => colorDistance(candidate[0], color) < threshold)
    if (cluster) cluster.push(color)
    else clusters.push([color])
  }
  // 每组选择出现次数最多的颜色作为代表值
}
聚类只能解决"哪些颜色接近",不能确定颜色用途。出现最多的颜色往往是页面背景,不一定是主要操作色。Imprint 还会记录颜色出现在文字、背景、链接、选中状态还是主要操作元素上,并提高明确操作背景的权重。文字前景色和状态色不会因为出现频繁就被误命名为主要按钮色。
字体和间距需要先消除测量噪声
计算样式可能返回 11.9062px 这类小数。它可能来自缩放或布局计算,原始设计值则是 12px。Token 构建会先归一化接近半像素的值,再按用途和出现记录排序:
typescript
const fontSizeFreq = normalizeLengthFrequency(frequencyForCategory(styles, 'fontSize', styles.fontSizes))
const sortedFontSizes = numericSort(sortByFrequency(fontSizeFreq).map(pxToRem).filter(uniqueFilter()).slice(0, 8))

const spacingFreq = normalizeLengthFrequency(frequencyForCategory(styles, 'spacing', styles.spacings))
const spacings = sortByFrequency(spacingFreq)
  .filter((value) => {
    if (!isScalarLength(value)) return false
    const number = parseFloat(value)
    return !isNaN(number) && number > 0 && number <= 96
  })
  .filter(uniqueFilter())
  .slice(0, 12)
.sort((a, b) => parseFloat(a) - parseFloat(b))同一个页面可能会采集多个视口。例如,首页有桌面、平板和移动端三份记录,另一个页面可能只有桌面端记录。直接累加会让首页中的颜色和间距在统计时占三倍权重。style-merge.ts 先计算每个视口内各类样式的使用比例,再对同一 URL 的结果取平均。这样,新增移动端记录只补充响应式证据,不会提高该页面在全站 Token 排序中的权重。
组件数量也采用相同思路。每个页面只选择一份规范捕获来统计组件实例,优先使用桌面视口;其他视口只参与响应式观察。否则同一个按钮在桌面、平板和移动端各出现一次,就会被误算成三个独立实例,组件置信度也会随捕获数量上升。
观察响应式布局和交互状态
响应式分析根据同一区块在不同视口下的结构变化生成结论,关注可见性、顺序、网格列数、尺寸和边框方向。
Astro 博客页的 Hero 在桌面端到移动端之间发生了顺序变化,标题字号从 48px 调整到 24px;一个 Aside 区块的右边框变成上边框。由于这些变化都有匹配的区块身份和视口来源,它们可以写进局部响应式规则。只有一端出现的区块则不能直接判定为 CSS 隐藏,也可能是页面没有加载完整或匹配失败。
交互状态采用两类来源。第一类是样式表和计算样式中声明的 :hover / :focus / :active 等被动记录;它们证明页面包含相应样式,但不证明用户操作已经执行。第二类是浏览器实际执行安全操作后得到的前后样式变化。
Hover 和 Focus 通常可以安全执行。点击、提交表单、购买、删除、退出登录等操作可能改变业务数据,不能为了收集样式自动触发。分析器会筛选安全候选,其余项目写入跳过记录。
Astro 案例有 36 个交互候选,安全执行了 3 个,跳过 33 个。跳过数量会原样保留,避免把未执行的候选写成已覆盖状态。
记录来源和未覆盖范围
一条设计规则至少要知道它来自哪个页面、哪个视口、哪个元素或区块,以及出现了多少次。来源很少的样式可以保留为局部观察,但不能写成全站默认值。
Imprint 在构建 Design Evidence 时会同时生成限制记录。下面这段代码处理页面、视口和交互覆盖:
typescript
const limitations: string[] = []
limitations.push(...(input.limitations || []))

if (uniqueUrls.size < input.expectedPageCount) limitations.push('fewer-pages-than-requested')
if (capturedExpectedCombinations < expectedCaptureCount) limitations.push('fewer-page-viewports-than-requested')
if (viewportCoverage.length < 2) limitations.push('single-viewport')
if (pages.some((page) => page.horizontalOverflow)) limitations.push('horizontal-overflow-observed')

const interactionCandidateCount = input.captures.reduce(
  (sum, capture) => sum + capture.snapshot.interactionCandidates.length,
  0,
)
const safelyObservedCount = interactionObservations.filter((observation) => observation.safety === 'safe-active').length
if (interactionCandidateCount > safelyObservedCount) limitations.push('some-safe-interactions-skipped')
这些限制会直接写入 DESIGN.md。Astro 的结果明确记录了水平溢出、安全交互未完全观察和响应式区块身份不匹配。Coding Agent 据此可以降低相关规则的适用范围,用户也能定位需要复查的部分。
页面截图同样属于来源记录。Imprint 在 URL 加载完成后自动捕获截图,用于核对当时的页面和视觉结果;它不支持把独立截图文件作为分析输入,也不会自动把截图传给外部 Agent。
把导出文件交给 Coding Agent
不同导出文件承担的作用如下:
| 文件 | 用途 |
|---|---|
DESIGN.md |
说明设计规则、组件模式、适用范围和限制 |
| CSS Variables | 在目标项目中复用具体样式值 |
Tailwind v4 @theme |
把 Token 接入 Tailwind v4 项目 |
多页面项目可以把 DESIGN.md 放在项目根目录,再从全局样式入口加载 CSS Variables 或 Tailwind 主题。Agent 先读取设计规则,再根据当前产品的功能要求决定页面内容和组件。
例如,目标页面需要输入框时,Agent 可以使用文档中的输入框组件模式,并从 CSS Variables 取得对应颜色、圆角和间距。目标页面没有同类组件时,这条模式就不适用。产品任务始终决定内容和行为,设计文件只约束有来源支持的视觉与交互写法。
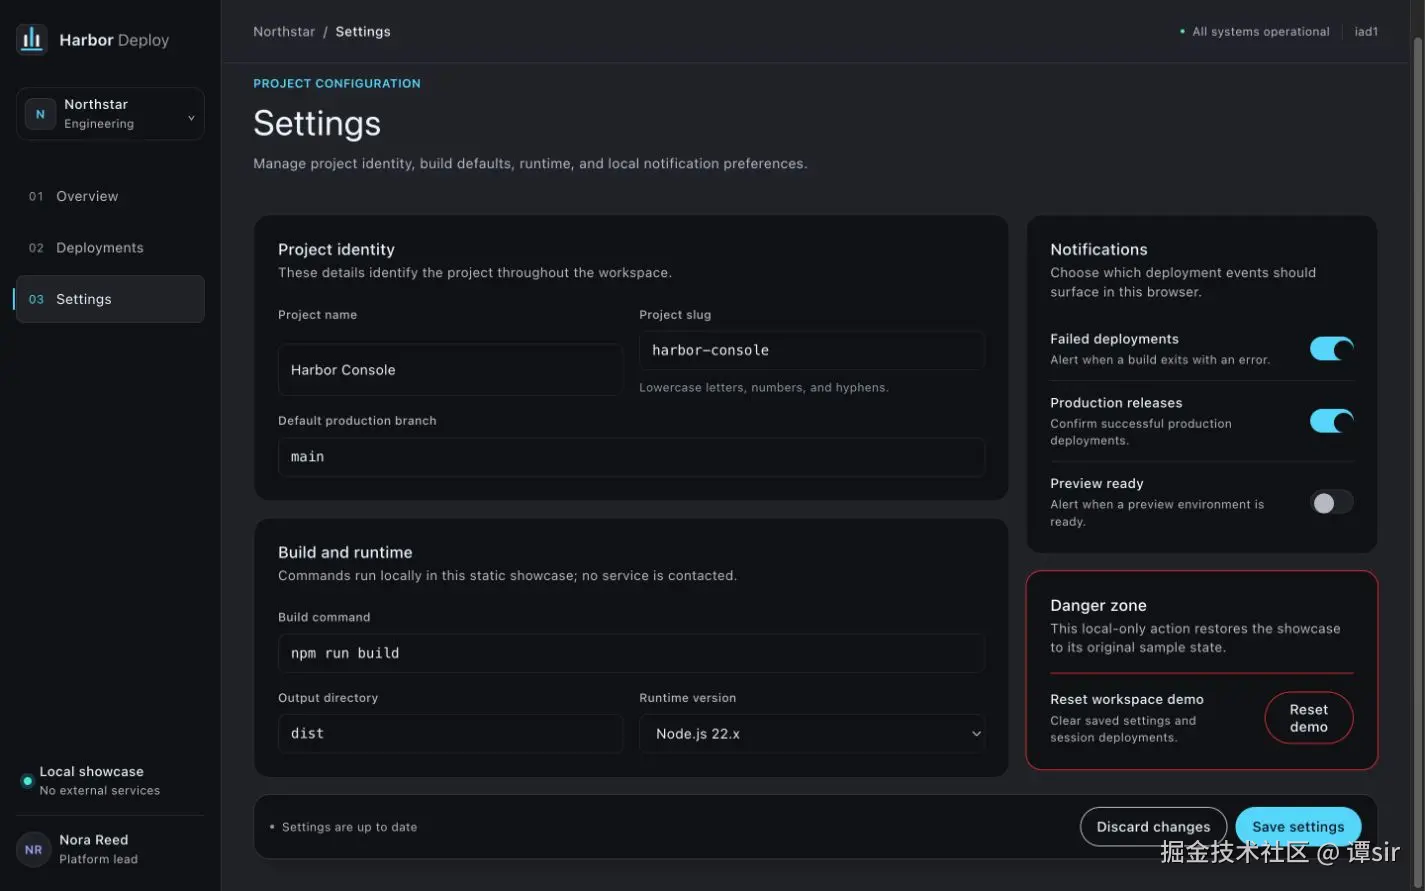
Harbor Deploy 案例另外提供了两份文件:TASK.md 规定三条路由、表格、筛选、设置和响应式行为;AGENTS.md 禁止复制 Astro 的名称、Logo、文案、插画、图片和页面布局,也禁止远程素材和依赖。来源截图没有放进 Agent 上下文。
案例选择 Codex CLI 只用于演示生成步骤。换成 Claude Code、Gemini CLI 或其他能读取项目文件并修改代码的 Coding Agent,输入仍然是同一组文件。Imprint 不内置或运行 Agent,也不负责生成 Harbor Deploy 的业务功能。
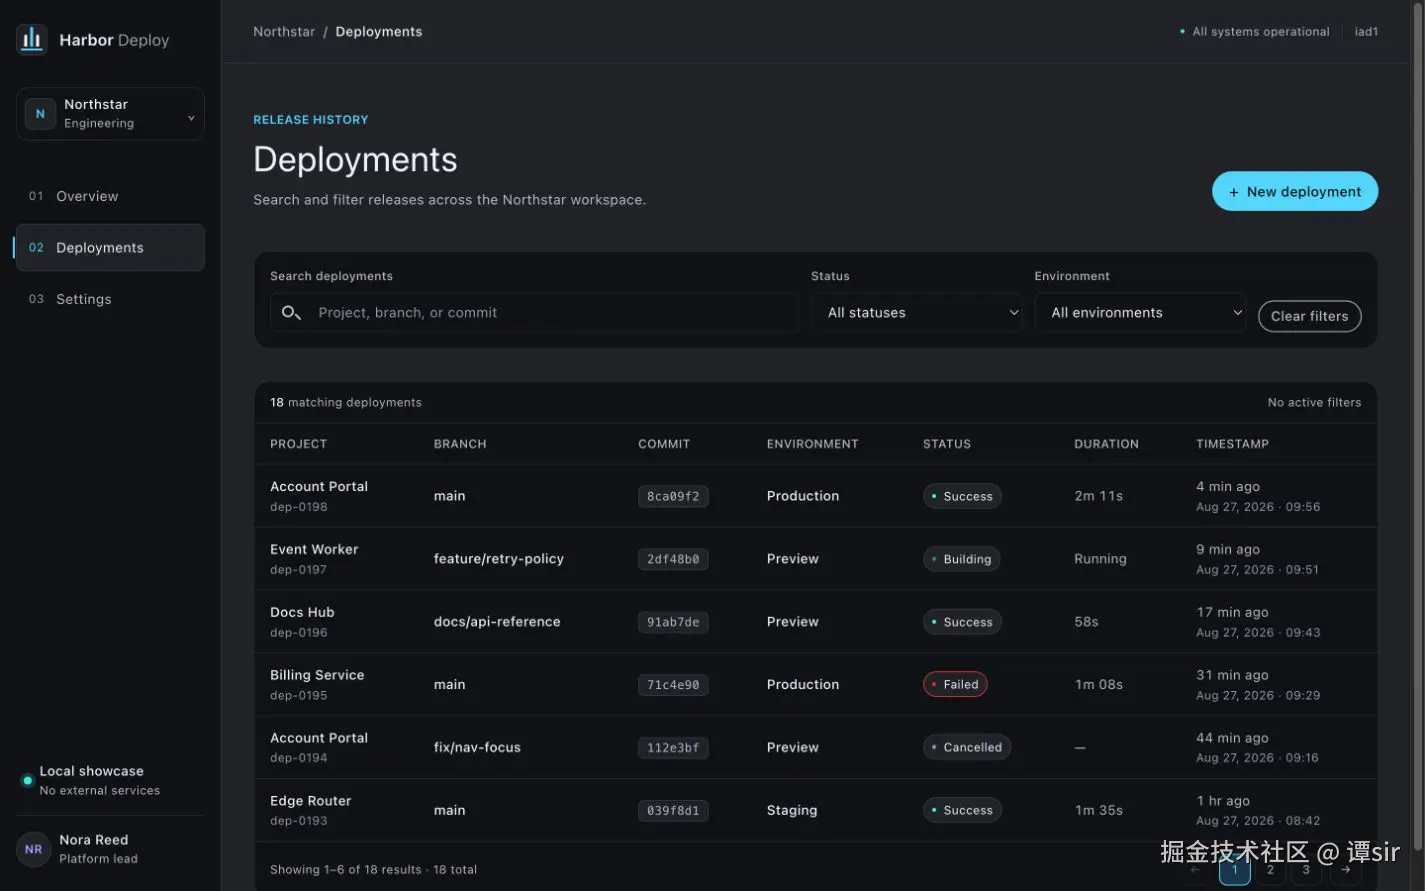
下面是另外两个生成页面:
| 部署记录 | 设置 |
|---|---|
 |
 |
代码如何共用
Imprint 有 Desktop、CLI 和本地 stdio MCP 三个入口,但分析和导出只有一份实现:
text
Desktop ─┐
CLI ─────┼── src/core/analyzer + src/core/export
MCP ─────┘
Electron 只处理桌面窗口、IPC、历史记录和文件导出,不维护另一套分析器。这样可以保证 Desktop 与源码构建入口使用相同的页面发现、样式提取、Token 构建和 DESIGN.md 生成逻辑。
当前公开发行的只有 Desktop。CLI 和 MCP 已经有源码构建入口,但还不是正式安装能力;案例为了固定命令和导出全部格式使用了源码构建的 CLI,不代表 0.1.0 安装包包含 CLI 或 MCP。
几种提取方法的差异
| 方法 | 输入 | 可以取得的信息 | 限制 |
|---|---|---|---|
| 截图与视觉模型 | 一张或多张截图 | 当前画面的颜色、排版和结构 | 缺少 DOM、响应式状态和规则来源 |
| 直接读取 CSS | HTML 和样式表 | CSS 声明、变量和媒体查询 | 包含未使用样式,不能表示最终计算结果 |
| 人工设计审查 | 页面和人工判断 | 可以结合业务语义判断规则 | 时间成本高,难以重复执行 |
| 浏览器分析 | 网站 URL | DOM、计算样式、多个视口、交互状态和来源记录 | 分析时间较长,结论受页面覆盖范围限制 |
浏览器分析用于扩大可观察范围,并保存数据来源和不确定内容。最终哪些规则适合目标产品,仍需要用户审核。
成本和边界
分析时间取决于页面数量、资源加载、网络质量和交互候选数量。Astro 的 36.8 秒只对应 2026 年 8 月 27 日那次固定运行,不能作为其他网站的预计耗时。
使用时还要注意以下限制:
- 输入只有网站 URL,不支持独立截图文件。
- 电脑需要安装 Chrome、Edge 或兼容 Chromium。
- 结论只覆盖成功加载的页面、视口和状态。
- 登录墙、验证码、反自动化机制和不稳定的动态内容可能中断采集。
- 无法确认安全性的交互会被跳过。
- 来源少、置信度低或仅在局部出现的规则需要人工复查。
- 导出内容用于迁移观察到的设计语言,不包含复制来源品牌、文案、图片或其他受保护内容的授权。
下载与公开案例
颜色和字号可以直接从计算样式中读取。区分全站规则和局部样式、记录每条结论的来源,以及保留未覆盖的页面和状态,需要在浏览器采集之后继续处理。浏览器提供渲染结果,Token 构建整理数值,DESIGN.md 保存规则、适用范围和限制。
我把这套方法实现成了 Imprint。0.1.0 已提供 macOS 和 Windows Desktop 下载,应用在本地分析网站 URL,并导出 DESIGN.md、CSS Variables 和 Tailwind v4 主题。可以选择一个熟悉的网站测试,重点检查哪条规则缺少来源,或者哪条结论不可信。