推荐一个好用的爬虫CLI工具

在Github上发现一个CLI工具,专门用来爬虫,叫作Brightdata CLI,到目前Star数已经超过5K。

简单说这个CLI是终端直接调用的轻量工具,不用写完整代码,登录后输入一行指令就能完成网页抓取、控制浏览器、搜索引擎批量检索、AI关键词自动采集等等,堪称网络数据采集百宝箱。

相比较之前用的requests、playwright脚本,这个CLI把数据请求、HTML解析的活都干了,接受url和字段需求自动返回数据集。
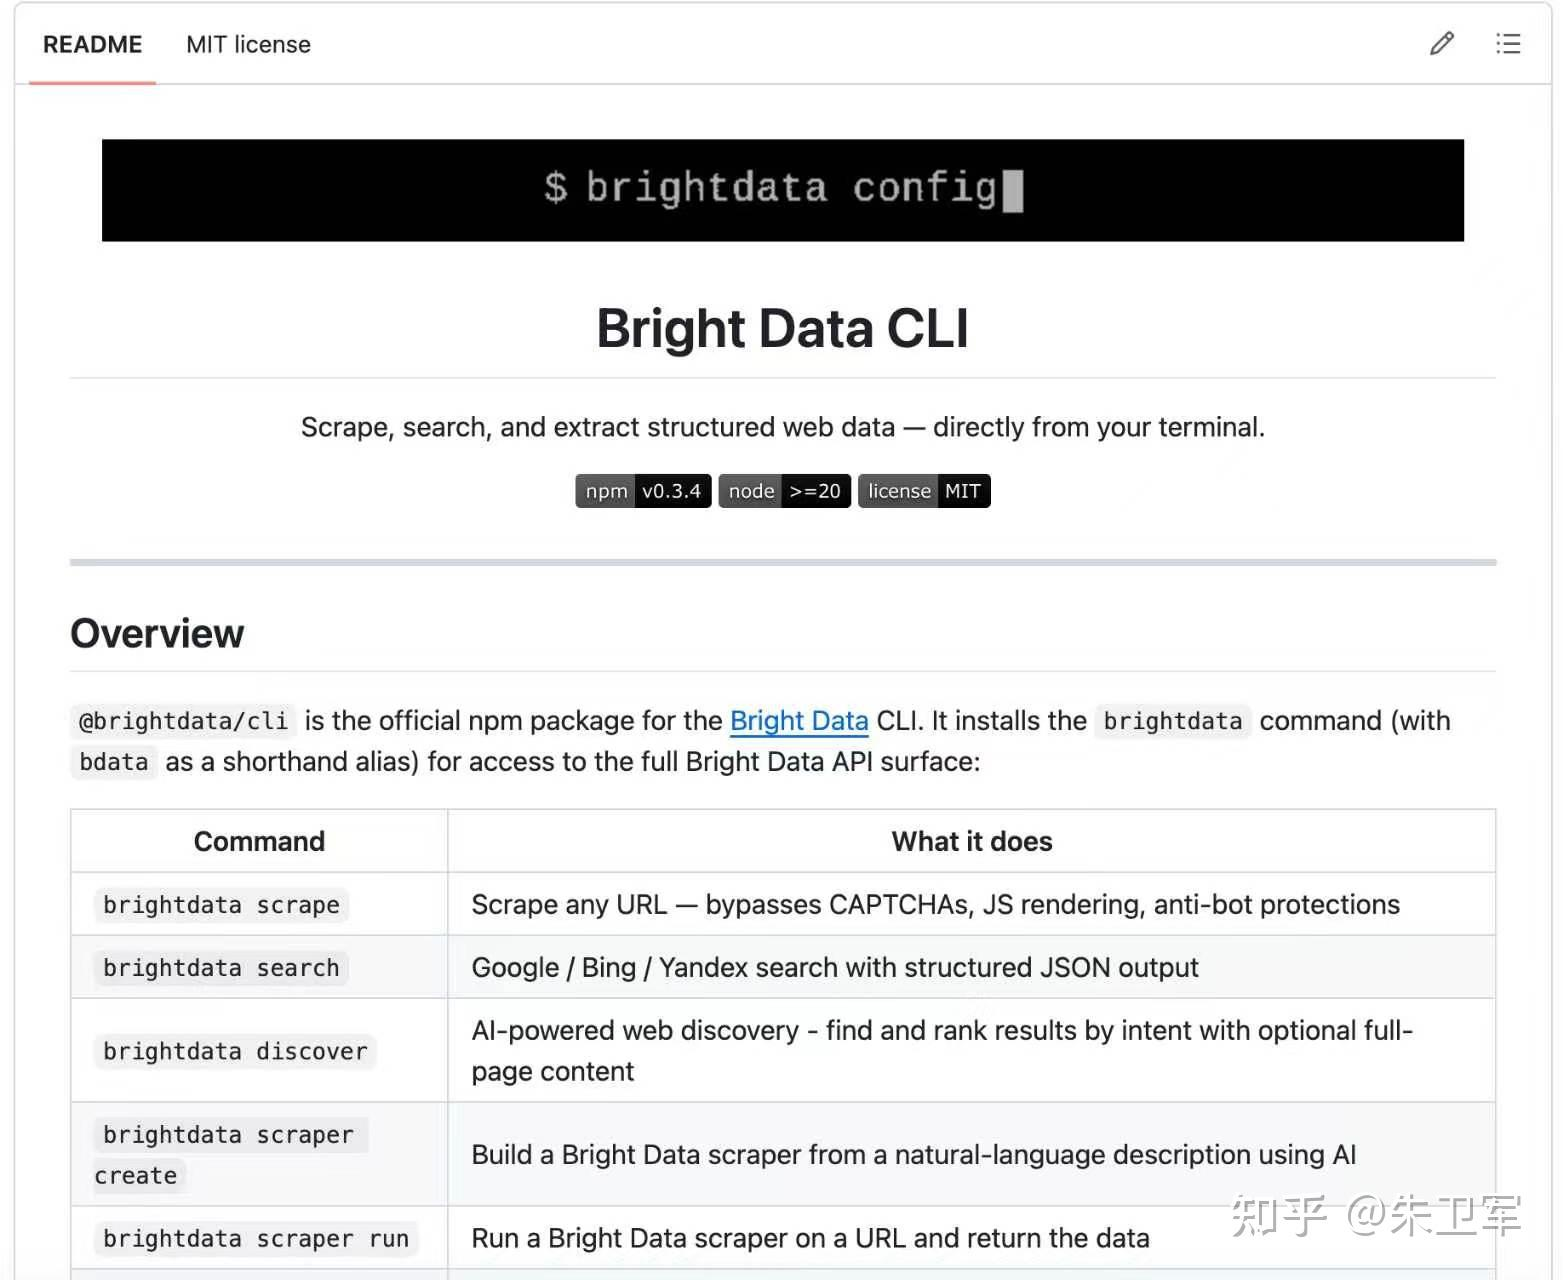
这里面涉及到一个很重要的网络采集技术,那就是针对网站爬虫检测的处理能力。

看readme介绍,Brightdata CLI还能自动处理人际验证、动态页面渲染、浏览器指纹,等于打通了公开数据的采集通道,不需要再写脚本去处理反爬,可以看这个演示。

https://get.brightdata.com/dataforai

采集到的结果能直接导出Markdown、CSV,还可以通过MCP服务接入到Codex、Claude code上,等于插座随处可用。

我感觉这类数据采集非常适合大模型训练数据,比如视频、图片、音频等多模态数据,也可以作为电商运营数据源。
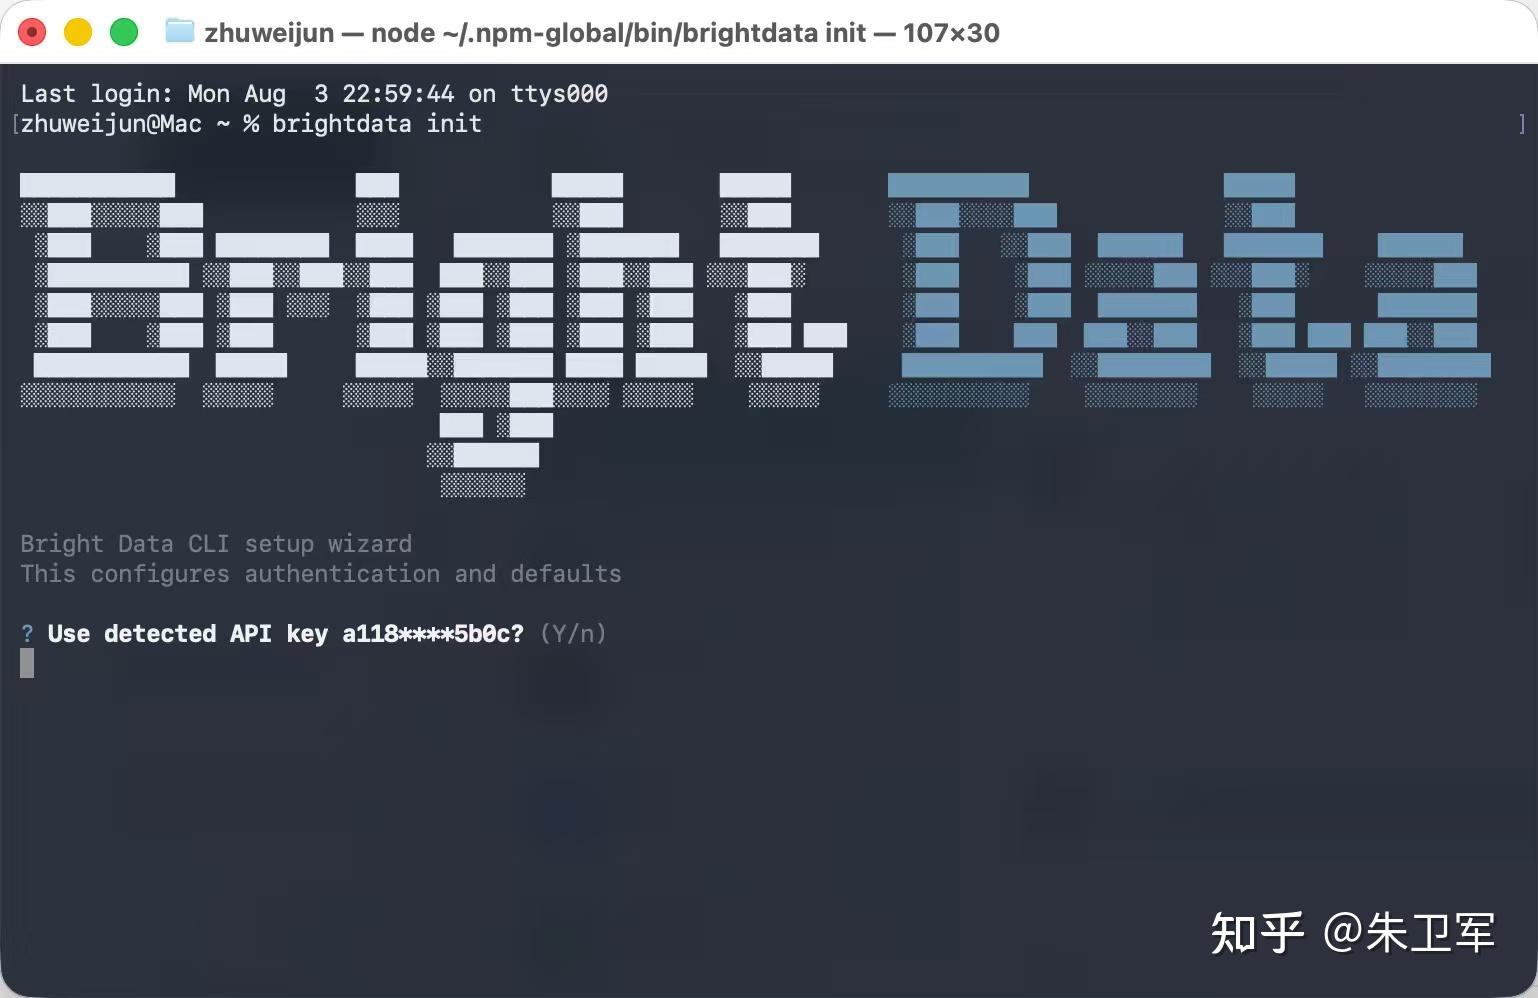
安装这个CLI也很简单,mac用curl安装,win用npm安装,一句命令搞定。

现在很多工具都CLI化,从速度、兼容性、系统支持上来说比传统app要好用很多。

相关推荐
wuyk5551 天前
Spider-第16讲-线程池与竞态问题
大数据·爬虫·python·elasticsearch·搜索引擎
wuyk5553 天前
Spider-第14讲-表单提交与CSRF
前端·爬虫·python·elasticsearch·csrf
wuyk5555 天前
Spider-第11讲-工程化改造与可维护性
大数据·爬虫·elasticsearch·搜索引擎
wuyk5555 天前
Spider-第12讲-asyncio异步并发爬取
大数据·爬虫·elasticsearch·搜索引擎
小宋10215 天前
AI 爬虫把大学图书馆站点拖垮:按行为指纹给爬虫分类、按类发配额、用边缘缓存分层,以带宽成本结构和真实用户 P95 延迟定档
人工智能·爬虫·分类
wuyk5556 天前
Spider-第10讲-SQLite持久化与去重
数据库·爬虫·sqlite
wuyk5556 天前
Spider-第09讲-三格式落盘CSV-Excel-JSON
爬虫·python·json·excel
wuyk5557 天前
Spider-第07讲-JSON接口与正则提取
爬虫·python·json
feasibility.7 天前
一物降一物?AI逆向没有终局:REA拆App,BLA设套,LASIK清场
人工智能·爬虫·github·逆向·skill·rea
wuyk5559 天前
Spider-第03讲-HTTP速通与读懂响应
网络·爬虫·网络协议·http