大家好!我是云创AI。智谱和阿里同时甩出王炸模型------重点是价格为上一个版本的1/10,实在是太香了,废话不多说,今天就来聊聊其中的号称Qwen4:Qwen3.8-Flash模型。
8月26日晚间阿里通义千问团队正式发布了 Qwen3.8-Flash。通义团队同时发布了 Qwen3.8-Flash-Next 的开源权重,Next 新架构将是全新一代 Qwen4 系列模型的雏形。
这是一个多模态 MoE 模型,主模型参数量为 125B,额外配备 51B 的 N-gram Embedding,每 token 激活 6B 参数。它原生支持 262,144 tokens 上下文,并可通过 YaRN 扩展至 1M tokens。
划重点,这是一个多模态 MoE 模型,主模型参数量为125B,额外配备 51B 的 N-gram Embedding,每 token 激活 6B 参数。 它原生支持 262,144 token 上下文,并可通过 YaRN 扩展至 1M token。
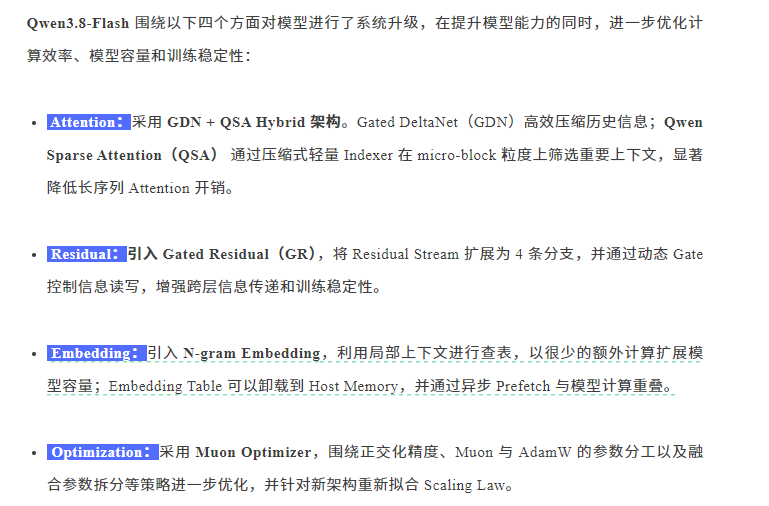
据介绍,Qwen3.8-Flash 围绕四个方向进行了系统升级:
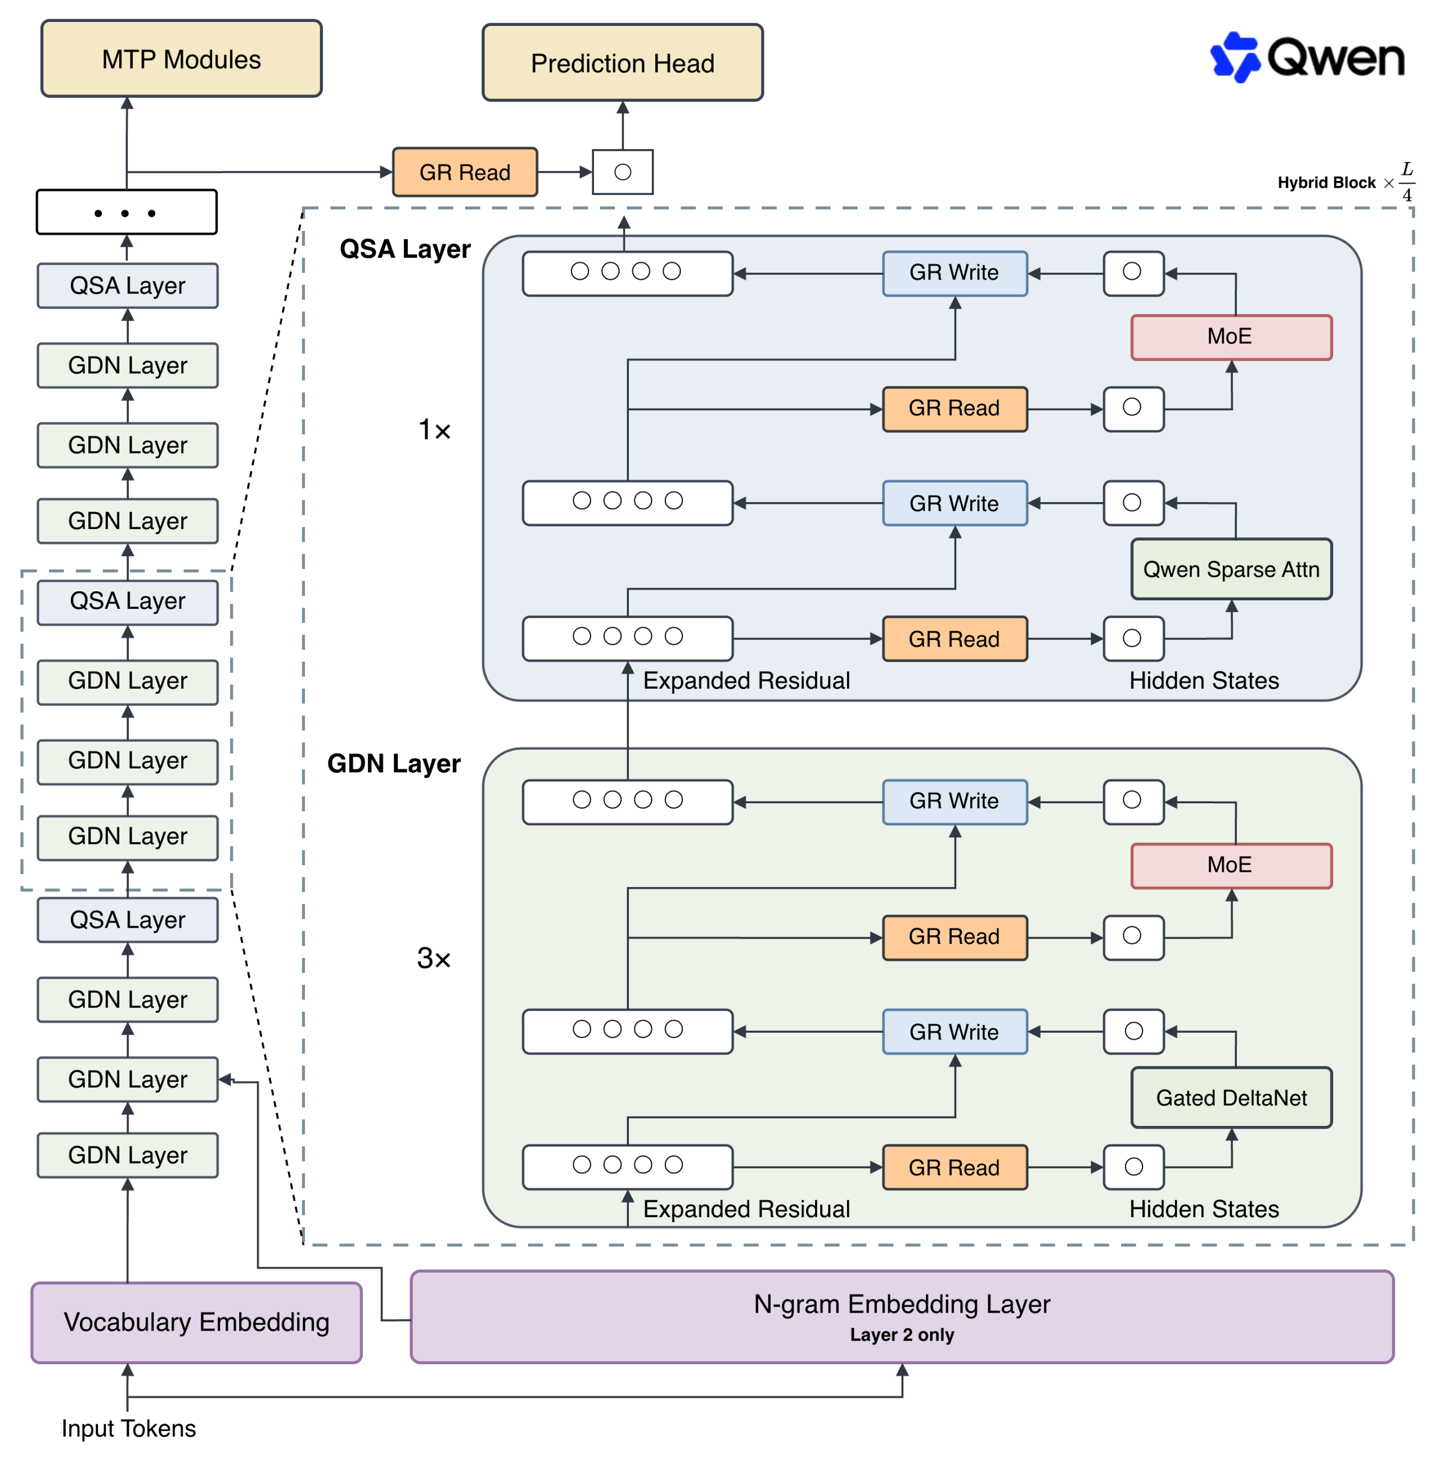
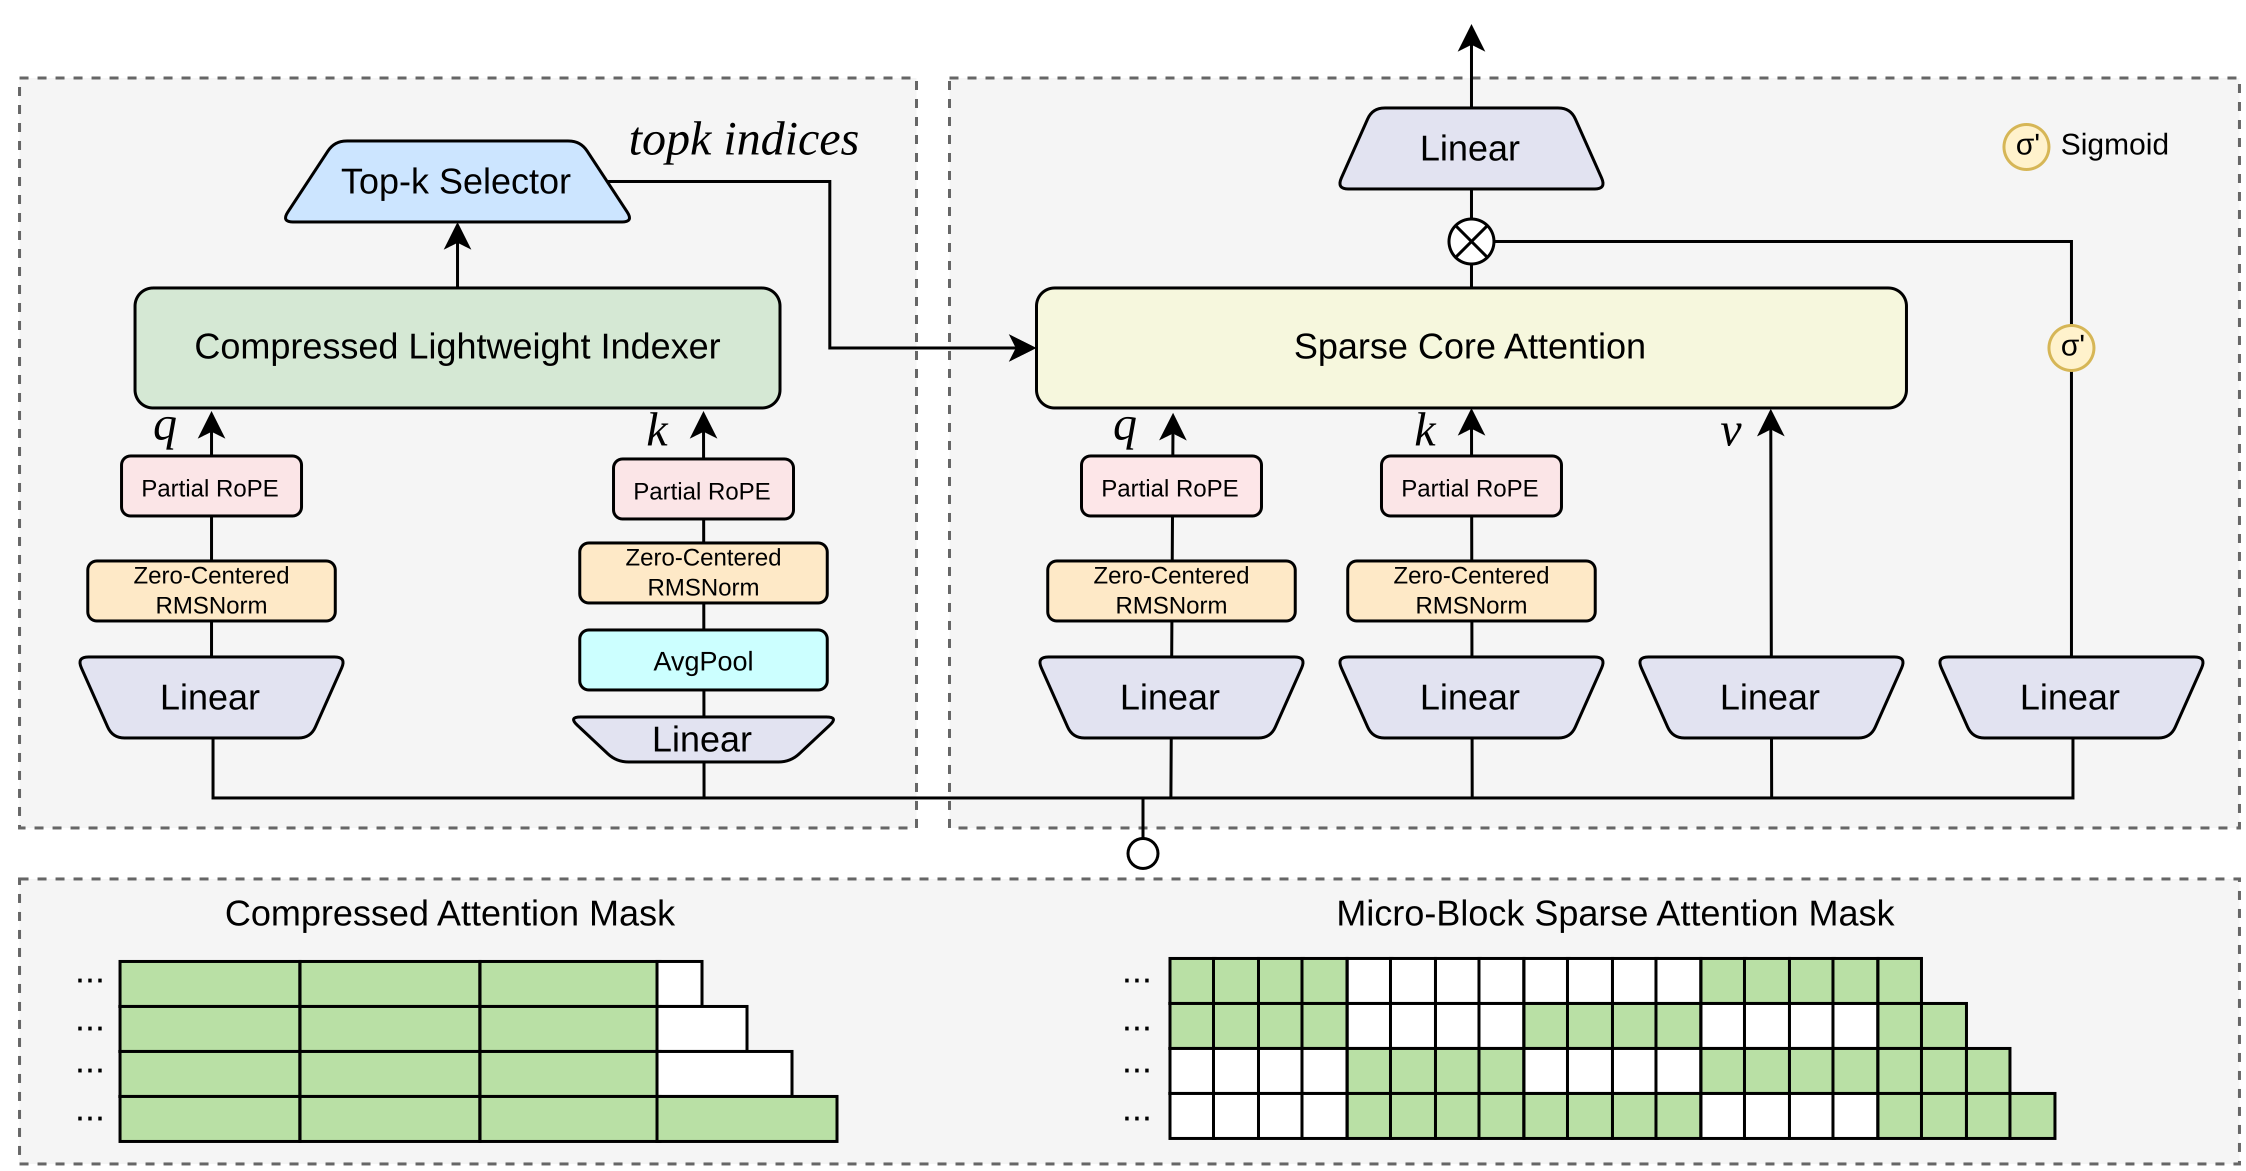
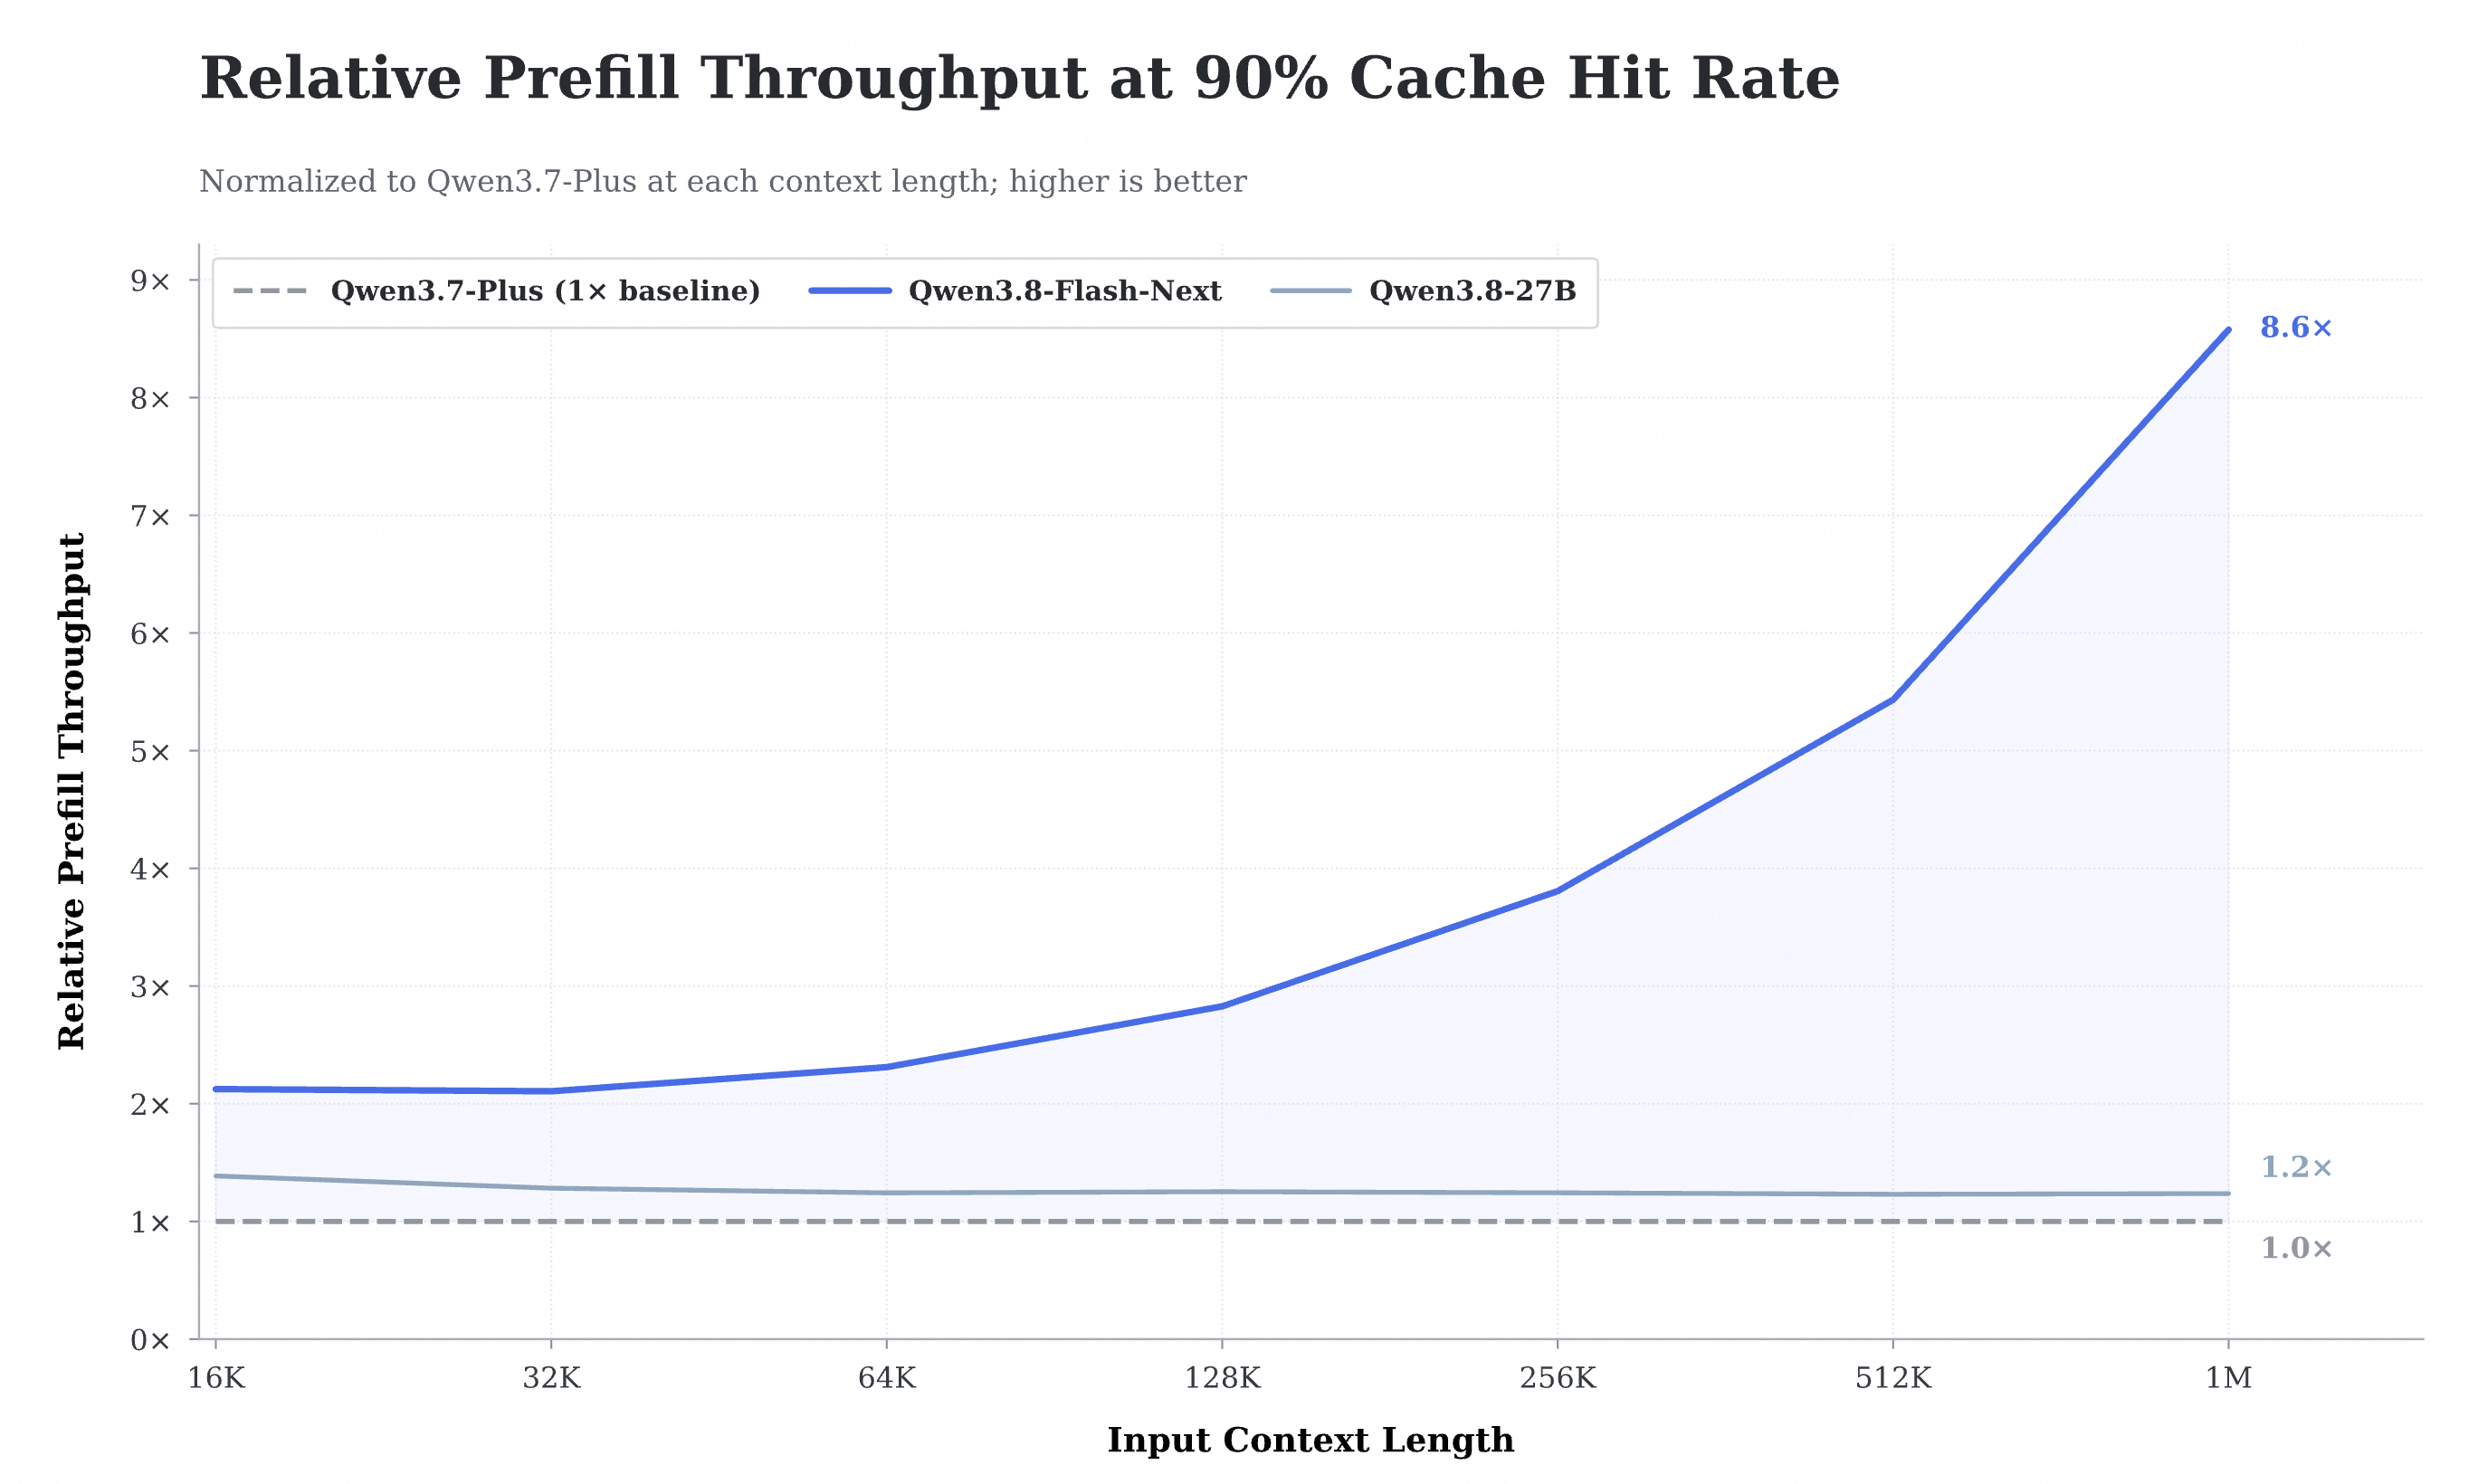
- 在 Attention 方面,采用 GDN(Gated DeltaNet)+ QSA(Qwen Sparse Attention)混合架构。GDN 负责高效压缩历史信息,QSA 则通过轻量级 Indexer 在 micro-block 粒度上筛选重要上下文,显著降低长序列 Attention 开销。面对 1M token 的超长上下文,QSA 的 Attention Kernel 在 Prefill 和 Decode 阶段分别实现最高 7.6 倍和 4.9 倍的加速。
- 在 Residual 方面,引入 Gated Residual(GR)机制,将残差流扩展为 4 条并行分支,通过动态 Gate 控制信息读写。残差状态支持 FP8 存储,大幅降低访存开销。
- 在 Embedding 方面,引入 51B 参数的 N-gram Embedding,利用局部上下文查表扩展模型容量。这些参数可卸载至 Host Memory,通过异步 Prefetch 与模型计算重叠,不长期占用 GPU 显存。
- 在 Optimization 方面,采用 Muon Optimizer,并针对正交化精度、参数分工及融合矩阵拆分等策略进行优化。针对新架构重新拟合了 Scaling Law。
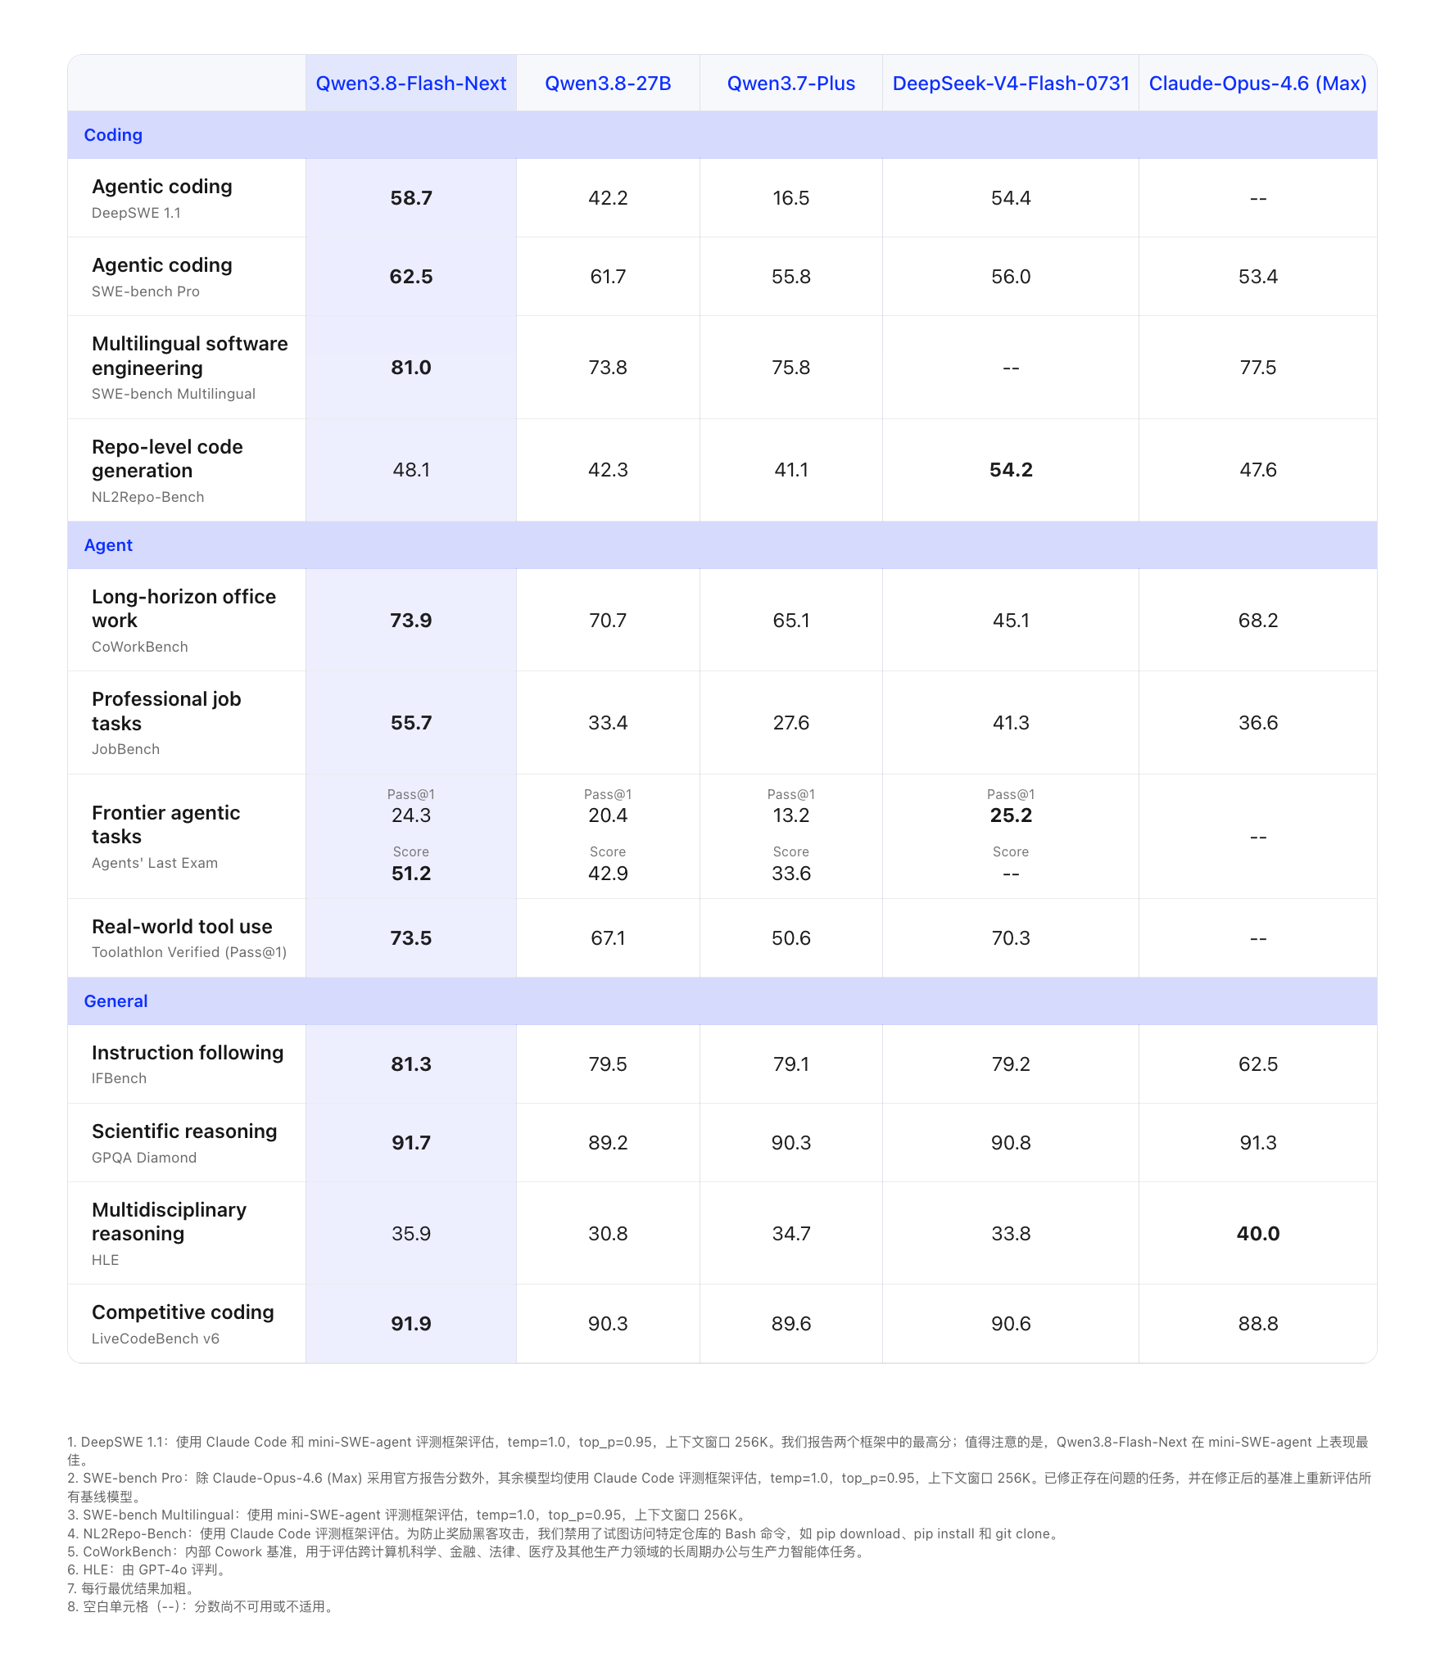
相比于 Qwen3.7-Plus,Qwen3.8-Flash显著降低了训练与推理成本,训练开销仅约为前者的 1/9,但在编码和办公任务上却具有更强的能力。
性能与成本
相比 Qwen3.7-Plus,Qwen3.8-Flash 的训练成本仅约为前者的九分之一,但在编码和办公任务上具备更强能力。
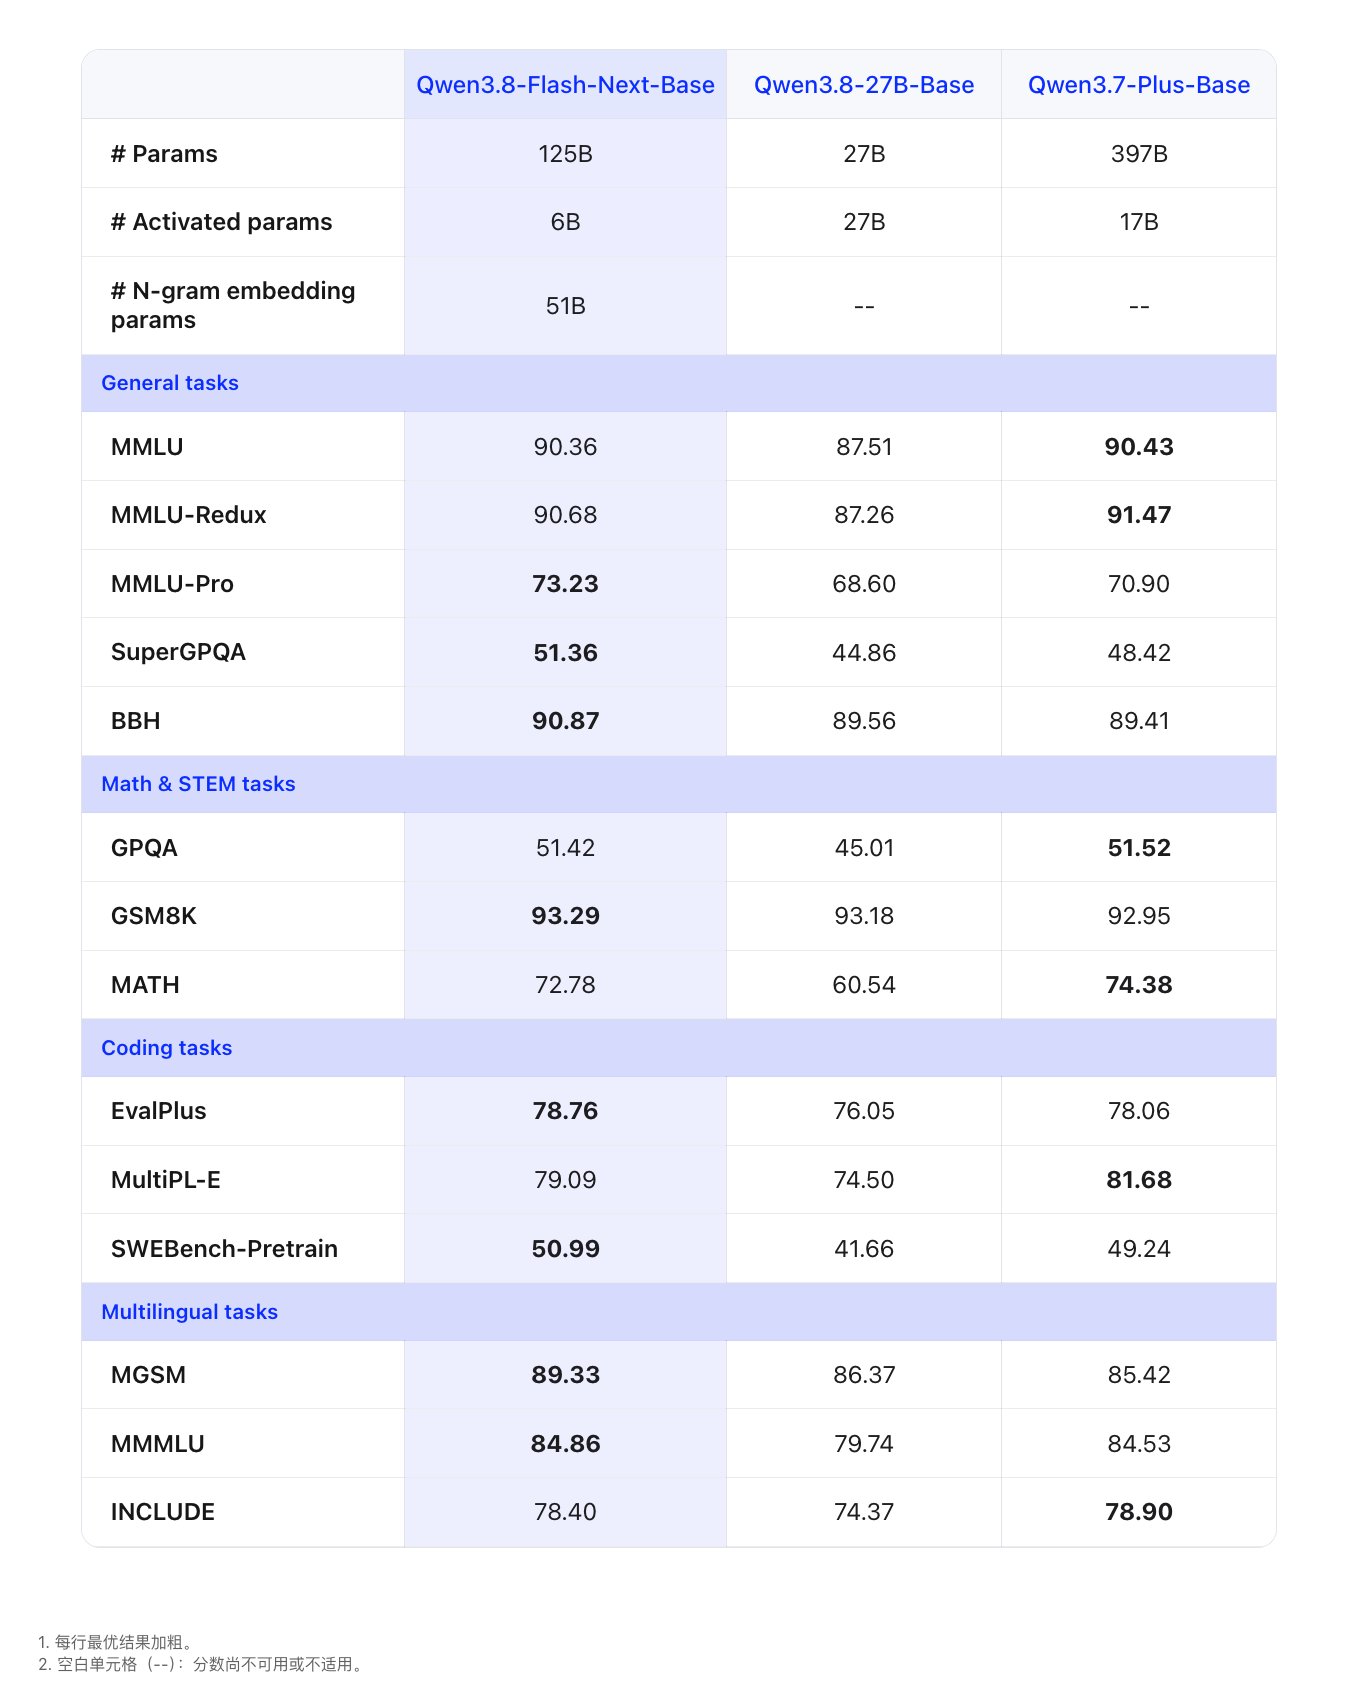
在 6B 激活参数下,Qwen3.8-Flash-Next-Base 在 14 个 benchmark 中的 8 个上取得最优结果,包括 MMLU-Pro、SuperGPQA、BBH、SWEBench-Pretrain、MGSM 与 MMMU。
模型表现
纯文本:
多模态:
模型结构:
Base 模型表现:
Qwen3.8-Flash现已上线千问AI平台,对外提供API服务,每百万Tokens输入1元,输出3元。今晚,Qwen3.8-Flash还将首发上线"千问办公"。
我们同时发布了Qwen3.8-Flash-Next的开源权重,Next新架构将是全新一代Qwen4系列模型的雏形。我们这次提前释出结构上的改动,以便在基于此构建 Qwen4 完整模型家族之前,先让社区对其进行检验。
模型权重将在 Hugging Face 与 ModelScope 发布,默认 1M 上下文并内置官方工具的生产版本,以 Qwen3.8-Flash 的形式在千问AI平台提供服务。有关 Qwen3.8-Flash-Next 架构设计、训练方法和实验分析的更多技术细节,请参阅 GitHub 仓库中的技术报告。
可用性与定价
云创AI从官方获悉,Qwen3.8-Flash 即将上线千问 AI 平台,对外提供 API 服务,定价为每百万 Tokens 输入 1 元、输出 3 元。
模型权重已于北京时间 8 月 26 日 23:00 在 Hugging Face 与 ModelScope 平台开源,同步发布 FP8 量化版本。Qwen3.8-Flash-Next 默认支持 1M 上下文并内置官方工具。
Qwen3.8-Flash模型体验地址👇
技术报告:https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
技术博客:https://qwen.ai/blog?id=qwen3.8-flash-next
Hugging Face:
ModelScope:
千问AI平台:
https://www.qianwenai.com/models/qwen3.8-flash
Qwen3.8-Flash总结
Qwen3.8-Flash-Next 在 Qwen3-Next 所引入的混合架构之上,沿 Attention、Residual、Embedding 与 Optimization 四个方向作了扩展。
QSA 在每一层内部将序列压缩为 micro-block,在保持精确检索能力的同时,降低了长上下文下的注意力开销与 indexing 开销。
Gated Residual 将残差流扩展为多条并行分支,并以逐元素的动态门控控制读写,在算术开销可忽略的前提下改善跨层信息传递与训练稳定性;残差状态还可以保存为 FP8,进一步降低访存量。
N-gram Embedding 以确定性寻址的查表记忆扩展容量,可以在几乎不增加每 token 计算的前提下扩展,并卸载到 host memory。
优化方面,Muon 作为主优化器使用,其中正交化精度、参数分工与融合矩阵拆分是决定性的实现选择,我们也针对新架构重新拟合了 Scaling Law。
和此前发布 Qwen3-Next 时一样,这一次我们仍然选择提前开放这些权重,希望社区能够对这一全新的架构进行测验。我们也将继续对其进行完善,并逐步向 Qwen4 演进。
参考资料:
-
技术报告:https://github.com/ QwenLM / Qwen3.8-Flash-Next / blob / main / tech_report.pdf
-
**技术博客:**https://qwen.ai/ blog?id=qwen3.8-flash-next
-
**Hugging Face:**https://huggingface.co/Qwen/Qwen3.8-Flash-Next?spm=a2ty_o06.30285417.0.0.1d73c921FsyOPe\&file=Qwen3.8-Flash-Next