我用 MiniMax H3 做了一次可复核的测试:不拍摄真人画面,也不手工制作口型,只输入一张男性正面照片和一段完整中文男声,观察最终视频的音画长度、嘴型变化和画面稳定性。
上图为测试流程的视觉整理;人物照片来自在线演示提供的官方示例素材。
这次得到的成片约 6.67 秒、544 × 544、24fps。输入男声长 6.648 秒,成片视频流长 6.667 秒,两者相差约 19 毫秒。整句口播播放到末尾,人物嘴部和局部表情持续变化。
MiniMax H3 中文男声完整测试成片
测试输入与处理方式
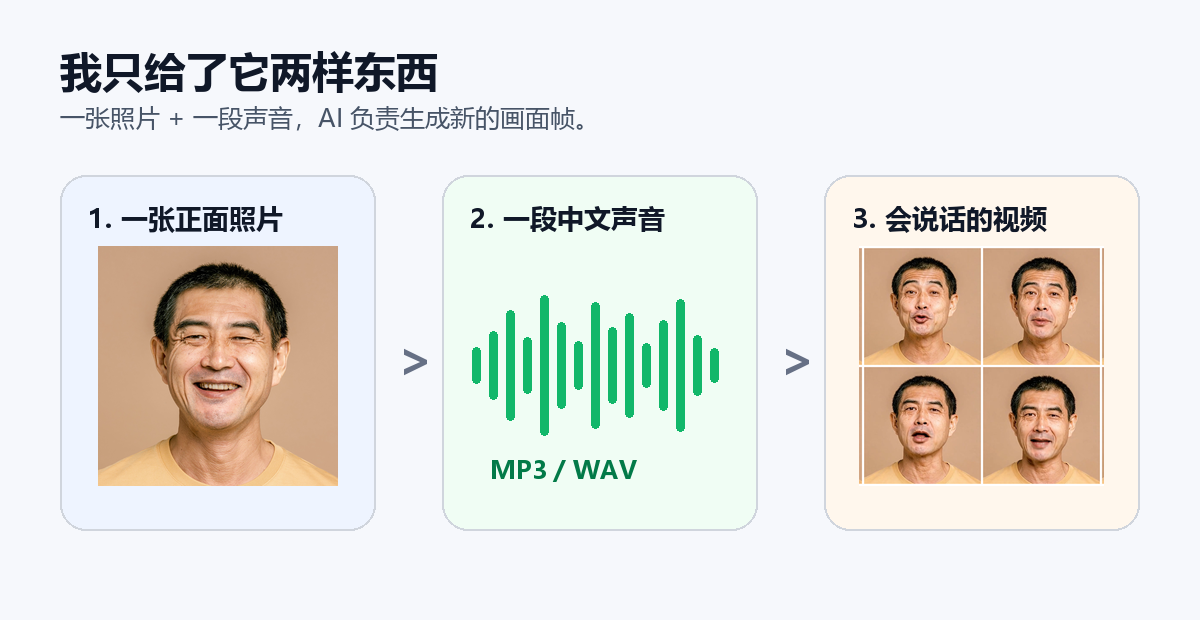
图像输入
为了验证基础能力,我使用了在线演示提供的官方示例人物图。它不是我生成的原创人物,本文也不把它作为原创素材展示。
音频输入
测试使用一段 6.648 秒的中文男声:
大家好,只需要一张照片和一段声音,人工智能就能让我自然地开口说话。
原始输出比口播多出约 0.64 秒尾部空白。为统一比较口径,我只裁掉这段空白并重新封装原始男声音频,没有替换生成画面,也没有二次修改口型。
我重点检查了什么
普通的"照片配音频"不会改变静态画面。这次测试关注模型能否依据音频生成连续画面,让嘴型、下巴和局部表情随声音变化,同时保持人物身份、衣服和背景稳定。
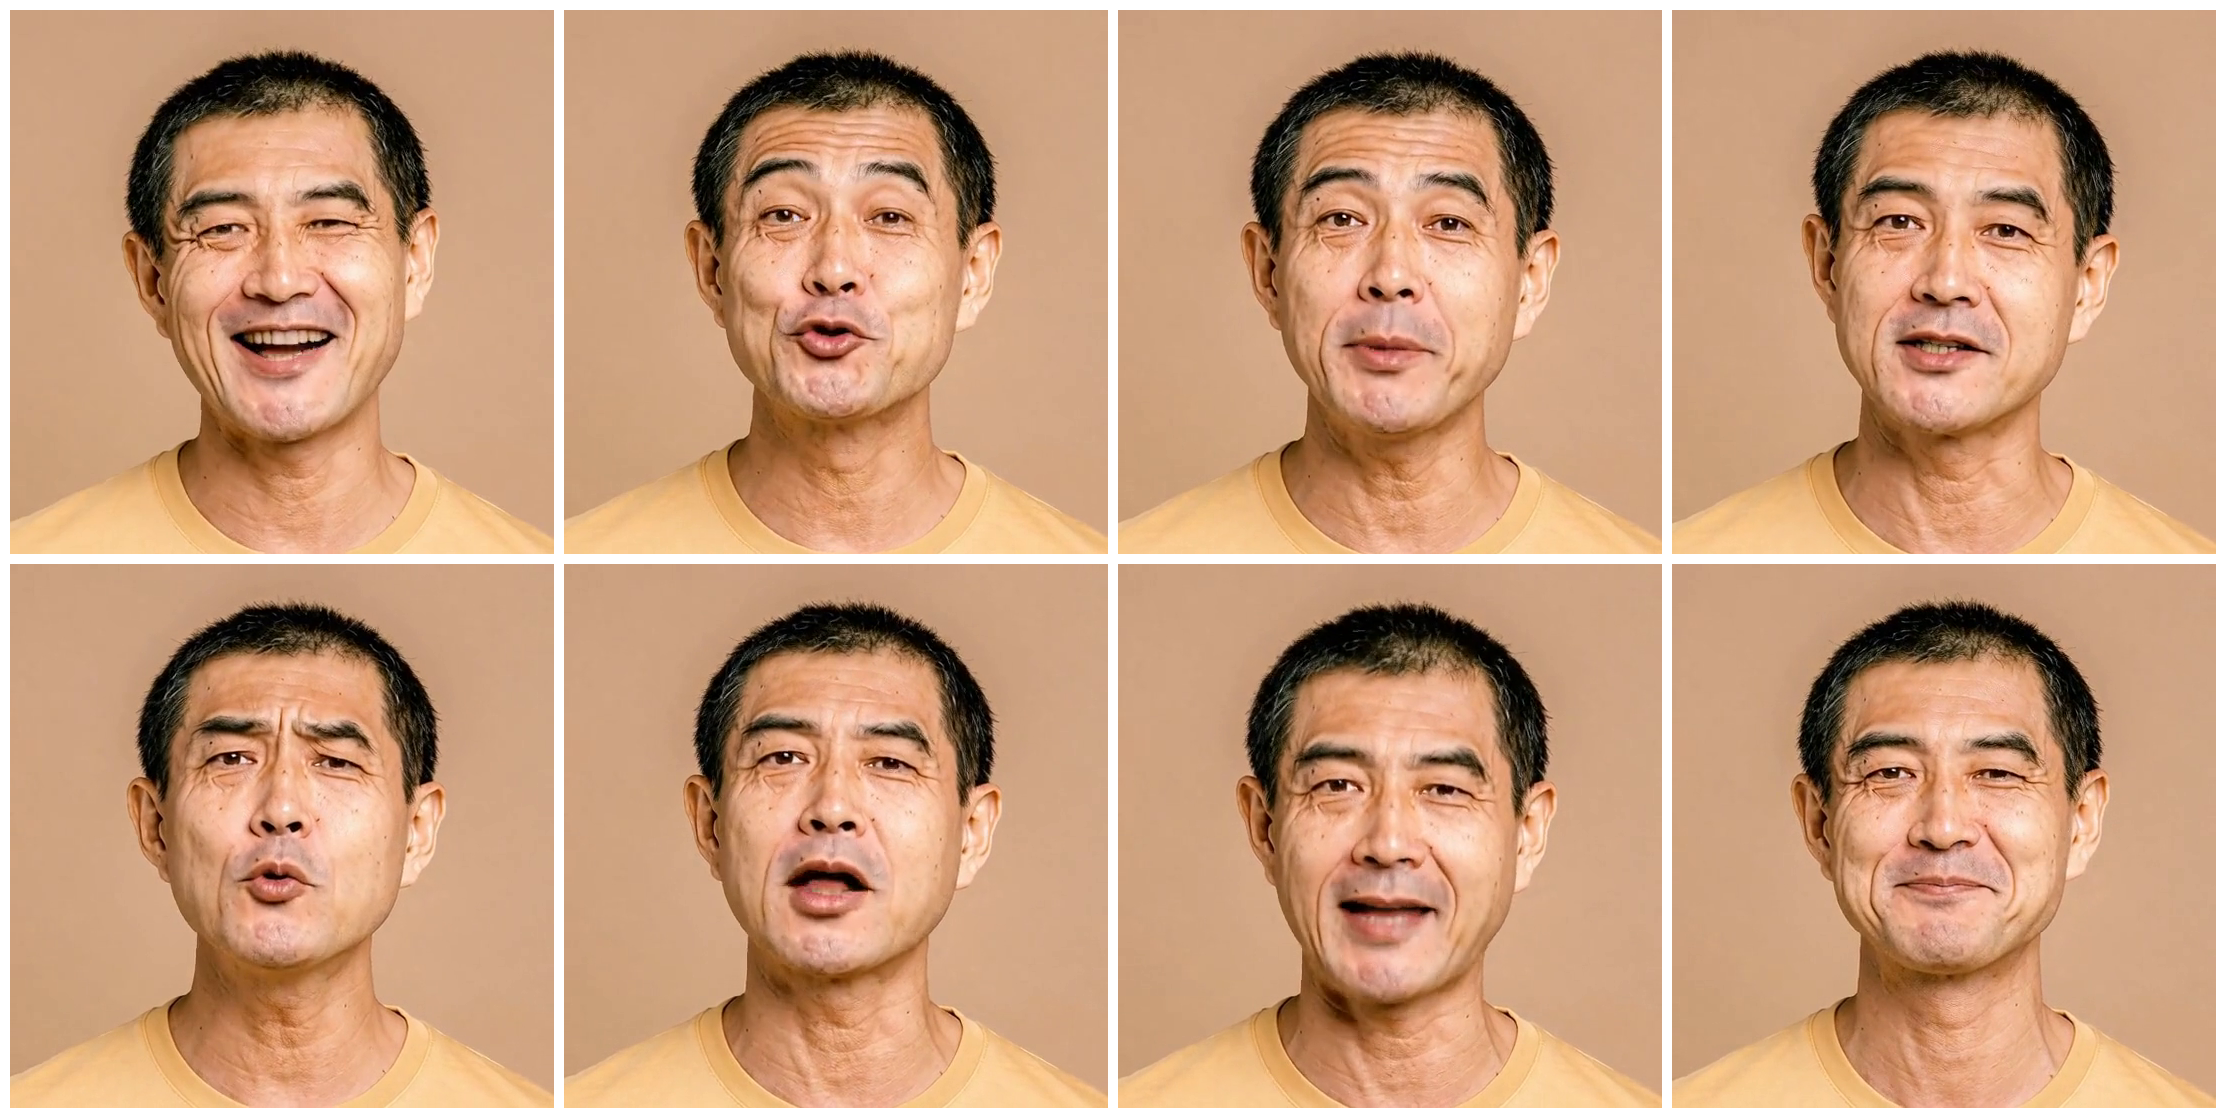
上图是从完整成片中等距截取的 8 个时间点。嘴型持续变化,最后一帧正常收口,人物身份和整体画面基本稳定。
实测结果
| 检查项 | 观察结果 |
|---|---|
| 口播完整性 | 中文男声完整播放,视频没有在句子中途停止 |
| 音画长度 | 音频 6.648 秒,视频流 6.667 秒,相差约 19 毫秒 |
| 嘴型变化 | 嘴部、下巴和局部表情随音频持续变化 |
| 身份一致性 | 没有出现明显换脸,衣服与背景总体稳定 |
| 可见缺陷 | 个别帧的牙齿和嘴角有轻微变形 |
这里的"约 19 毫秒"只表示两个媒体流总时长接近,不能单独证明逐音素级口型完全同步。肉眼可以确认人物持续说话,但更精细的唇音对应关系还需要逐帧分析。
影响结果的几个边界
照片条件会影响稳定性。 本次输入是清晰正脸;侧脸、遮挡或低分辨率图片是否同样稳定,本文没有验证。
低推理步数不代表最终质量。 本次测试使用 7 个推理步数,牙齿和嘴角仍有轻微瑕疵。提高步数能否稳定改善细节,需要另做对照实验。
公开演示环境会引入额外变量。 GPU 排队、运行额度和页面状态会影响能否及时复现,但不属于模型画面质量本身。
肖像与声音需要获得授权。 涉及真人时,应避免未经允许复制他人的形象或声音,更不能用于冒充和误导。
结论
在这组输入条件下,MiniMax H3 能把一张正面照片和一段短中文男声生成连续口播视频:句子完整,媒体流总时长接近,人物身份与背景总体稳定。它的局限也很明确------牙齿和嘴角仍可能变形,而这次短样本不能外推到长视频、侧脸、遮挡或复杂动作。
这次测试能够支持的结论是:它已具备短时正脸口播的基本可用性;更长内容和复杂输入下的一致性,还需要更多样本验证。