摘要:普通 Spark 作业 Driver 挂了,重跑就行;但 Spark Streaming 的 Driver 挂着的是"流处理的进度"------挂了不自动恢复,整个流就断在那一刻。这篇讲清 SparkStreaming Driver HA 靠什么实现(checkpoint 持久化 + YARN 自动重启),checkpoint 到底存了哪些东西,以及一套能直接用的 getOrCreate + supervise 搭建代码和三个必须注意的坑。
关键词:Spark Streaming, Driver HA, checkpoint, getOrCreate, supervise, 故障恢复
一、SparkStreaming 的 Driver 为什么特殊
普通 Spark 批处理作业,Driver 挂了任务重算就行------RDD 血缘容错天然支持。但 Spark Streaming 不一样:
- Driver 挂着的是整个流处理的调度中枢(DStream 的 lineage、批处理的节奏)。
- 有状态算子(updateStateByKey 之类)的累计状态也只在 Driver 侧内存里。
所以 Driver 一挂,如果不做特殊处理,流就永久停摆。Driver HA 就是让 Driver 挂了之后能自动重启、从断点接着处理。
二、checkpoint 存了什么:恢复的根基
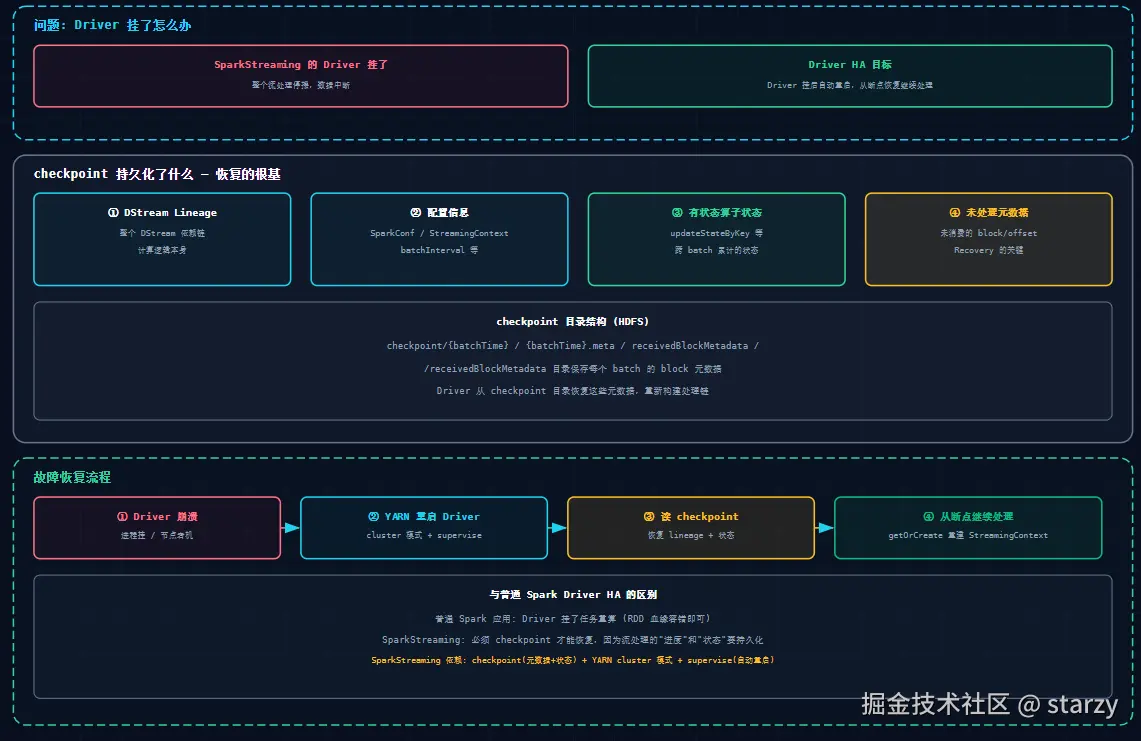
SparkStreaming 的 Driver HA 核心是 checkpoint。它是恢复的根基,持久化了四类东西:
- DStream Lineage:整个 DStream 的依赖链,也就是"计算逻辑本身"。
- 配置信息:SparkConf、StreamingContext、batchInterval 等。
- 有状态算子的状态:updateStateByKey 等跨 batch 累计的状态。
- 未处理元数据:还没消费完的 block/offset 元数据------这是"断点续传"的关键,决定了从哪继续。
在 HDFS 上,checkpoint 目录里最核心的是 receivedBlockMetadata,它记录了每个 batch 的 block 元数据。Driver 恢复时就从这里重建处理链。
三、故障恢复的完整流程
一次完整的 Driver HA 恢复是这样走的:
- Driver 崩溃:进程挂了或所在节点宕机。
- YARN 自动重启 Driver :这要求部署在 cluster 模式 下(Driver 跑在 ApplicationMaster 里),并且开了 --supervise。
- 读 checkpoint:新 Driver 从 checkpoint 目录恢复 lineage 和状态。
- 从断点继续 :
getOrCreate重建 StreamingContext,接着处理没处理完的数据。
三个要素缺一不可:checkpoint(存状态)+ cluster 模式(Driver 在 AM 里)+ supervise(挂了自动重启)。client 模式下 Driver 跑在提交机上,挂了没人拉起来,HA 无从谈起。
四、搭建实操
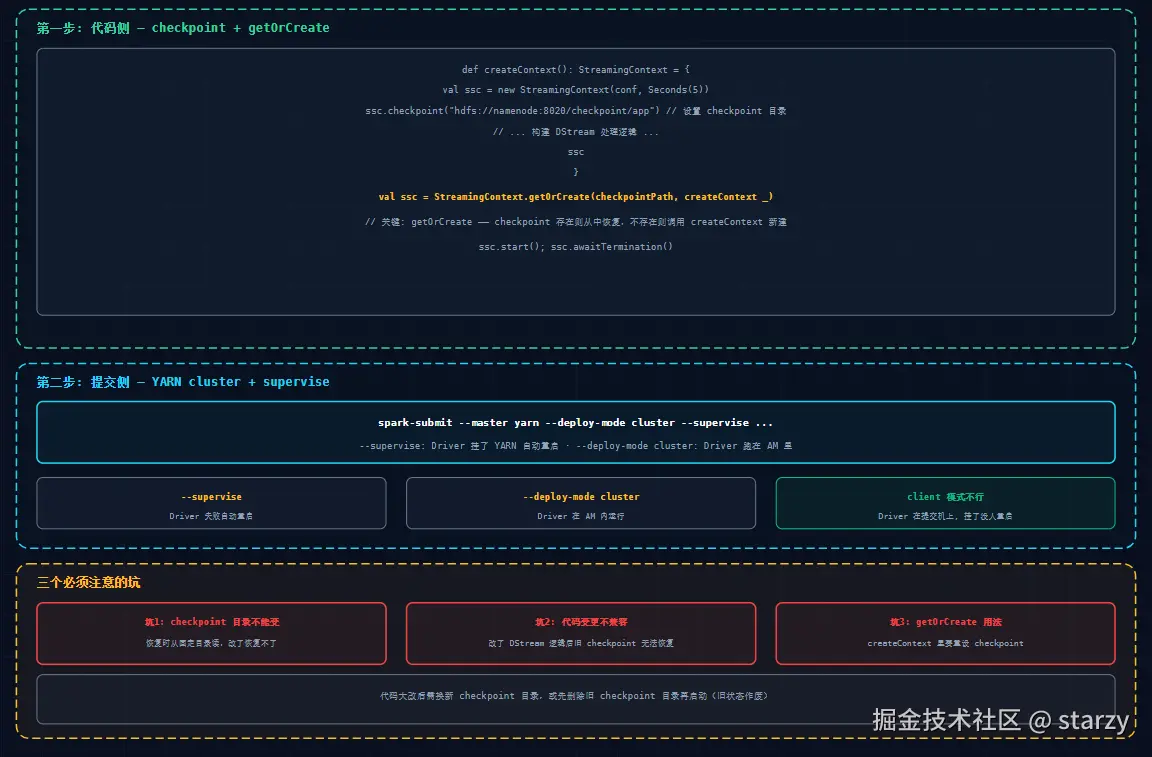
第一步:代码侧,checkpoint + getOrCreate
scala
def createContext(): StreamingContext = {
  val ssc = new StreamingContext(conf, Seconds(5))
  ssc.checkpoint("hdfs://namenode:8020/checkpoint/app")
  // ... 构建 DStream 处理逻辑 ...
  ssc
}

// 关键:getOrCreate ------ checkpoint 存在就恢复,不存在就新建
val ssc = StreamingContext.getOrCreate(checkpointPath, createContext _)
ssc.start()
ssc.awaitTermination()
getOrCreate 是整套机制的核心入口:它先检查 checkpoint 目录是否存在------存在,说明是故障恢复场景,直接从中重建 StreamingContext;不存在,说明是首次启动,调用 createContext 新建。
注意 createContext 里要重新设置 checkpoint 目录 (ssc.checkpoint(...) 这行),因为新建场景也需要把 checkpoint 路径告诉 StreamingContext,后续才会持续写 checkpoint。
第二步:提交侧,cluster + supervise
bash
spark-submit \
  --master yarn \
  --deploy-mode cluster \
  --supervise \
  --class com.example.StreamingApp \
  app.jar
--deploy-mode cluster:Driver 跑在 ApplicationMaster 里,随集群管理。--supervise:Driver 挂了,YARN 自动重启它。
五、三个必须注意的坑
坑一:checkpoint 目录不能变
恢复时是从固定目录读的,改了路径就等于找不回原来的状态,恢复会失败。checkpoint 目录要稳定、用可靠的 HDFS 路径。
坑二:代码变更不兼容
checkpoint 里存的是 DStream 的 lineage(序列化的计算逻辑)。你改了处理逻辑之后,旧 checkpoint 里的 lineage 和新代码对不上,恢复时会抛反序列化/兼容性异常。所以上线新逻辑时,要换新的 checkpoint 目录,或先删掉旧 checkpoint 再启动(旧状态作废,从零开始)。
坑三:getOrCreate 的正确用法
createContext 里必须重新执行 ssc.checkpoint(...),很多人漏了这一步,导致首次启动后根本没有 checkpoint 目录,HA 形同虚设。同时 createContext 里的逻辑要和恢复后的逻辑一致,否则新旧 lineage 对不上。
六、总结
- SparkStreaming 的 Driver 挂着流处理进度和状态,HA 依赖 checkpoint 持久化 + YARN 自动重启,缺一不可。
- checkpoint 存四类东西:lineage、配置、有状态算子状态、未处理元数据,最后一项决定"从哪续传"。
- 搭建三要素:代码侧
checkpoint+getOrCreate,提交侧--deploy-mode cluster+--supervise。 - 三个坑:checkpoint 目录不能变、代码变更要换新目录、createContext 里要重设 checkpoint。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践