--让AI看懂数据
随着大模型与企业数据体系的快速融合,越来越多"对话式分析"开始落地:查数据、做分析、写报告都能一气呵成。
在这一过程中,企业内部的 "数据知识" (指标口径、业务规则、术语定义、常用模板等)变得至关重要,它决定了模型能否在正确语境下算出对的数、说清楚因果和边界。
然而,在真实业务里,这些数据知识往往分散在文档、报表、群聊与个人经验中,版本不一致、同名不同义、小小的口径差异,都会导致模型看似很会答,实际上经常答错、答偏、不可控。
因此,我们需要一套面AI的数据知识底座(DataLeap),把分散知识沉淀为可理解、可复用、可治理、可持续迭代的能力,支撑可靠的数据分析智能体落地。
1. 痛点与问题
1.1 被数据卡住的两类人
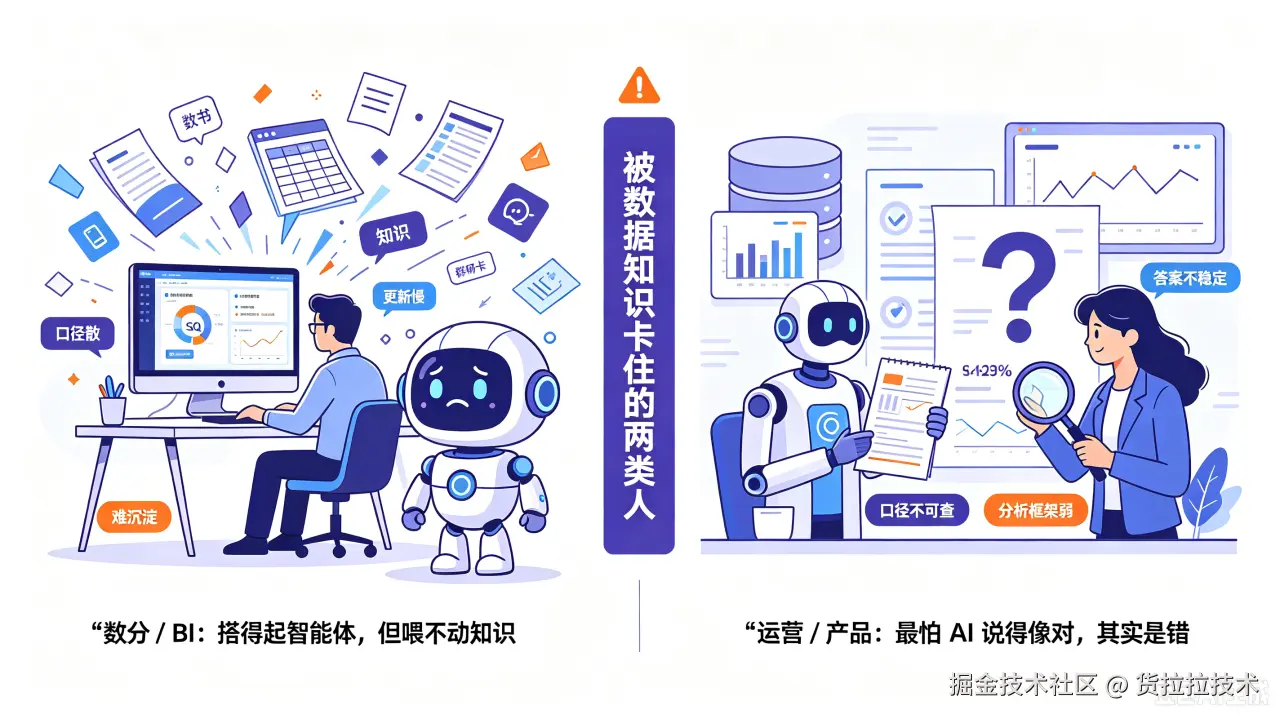
1️⃣分析师:搭得起智能体,但"喂不动知识"
对分析师而言,智能体搭建的难点不仅在于流程设计,更在于跨平台数据与知识的打通,由于关键资产高度分散,知识难以结构化复用,导致在类似问题上反复"从零开始"。智能体越多,维护成本越高,长期将演变为不可持续的技术债。
2️⃣运营 / 产品:最怕看起来对,其实是错
业务更在意答案的可用与可验:同题不同问、 SQL 过滤条件错误导致与真实数据对不上;在周报、复盘、异常分析等场景,难点不仅是取数,更是分析方法与结论可信度;通用助手往往缺少稳定框架,也难以做到严格按口径引用来源,因此不稳定、不可信、不敢用。
1.2 问题本质
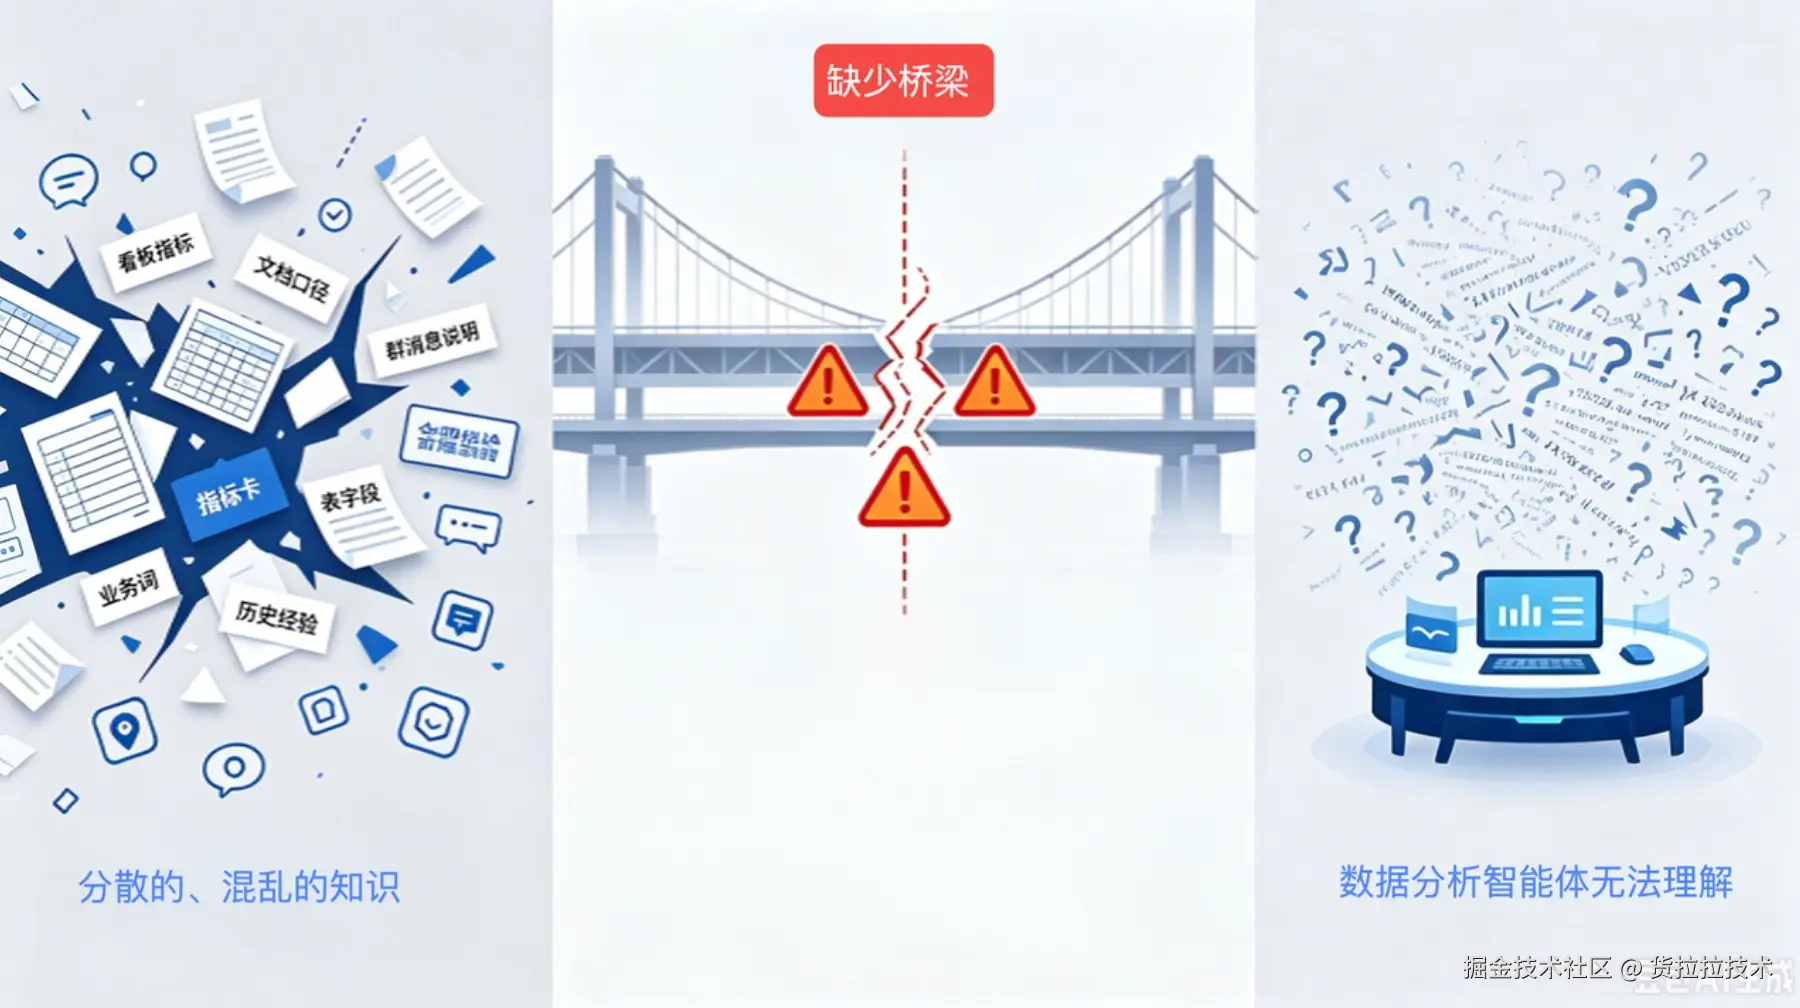
归根结底,问题并不在于"知识是否存在"、也不在于"模型够不够聪明",而在于知识供给的形态与智能体的理解方式不匹配,业务知识与智能体可理解、可执行的知识之间存在一道"断层"。
要让智能体真正进入业务主流程,必须在两者之间搭建一座桥 ,将零散口径、隐性经验与数据资产编织成可检索、可解释、可追溯、可治理的统一体系------这座桥,就是 "数据知识底座" 。
2. 目标与思路
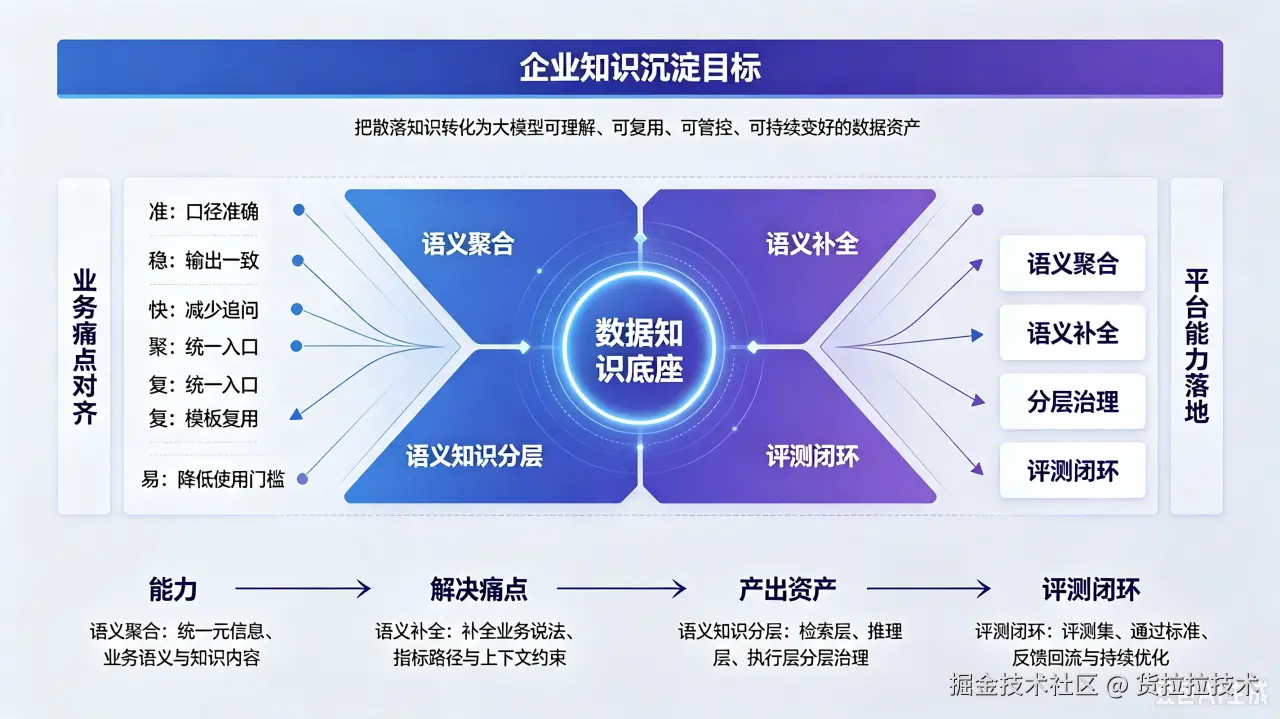
把散落在飞书文档/报表/SQL/人脑中的指标口径与业务知识,沉淀 为AI可理解、可复用、可管控、可持续变好的 "数据知识底座" ,支撑 数分 / 运营快速搭建可靠的数据分析智能体。
需要重点强调以下四个特征:
- AI 可理解:沉淀的内容并非面向阅读的说明文档,而是结构化、可解析、可调用的语义定义与业务规则。
- 可复用:一次建设,支持在多场景、多应用中统一调用,降低重复建设与口径漂移。
- 可管控:具备清晰的数据来源与责任归属,支持权限管理,并建立规范的版本与变更流程。
- 可持续变好:可评测、可发现缺口,并能够通过闭环机制持续补齐与优化,形成长期演进能力。
在此基础上,BI 与运营在搭建数据分析智能体时获得的是稳定、可靠的知识供给,而非依赖偶然性的"召回命中"。
3. 技术实现
3.1 多平台语义整合
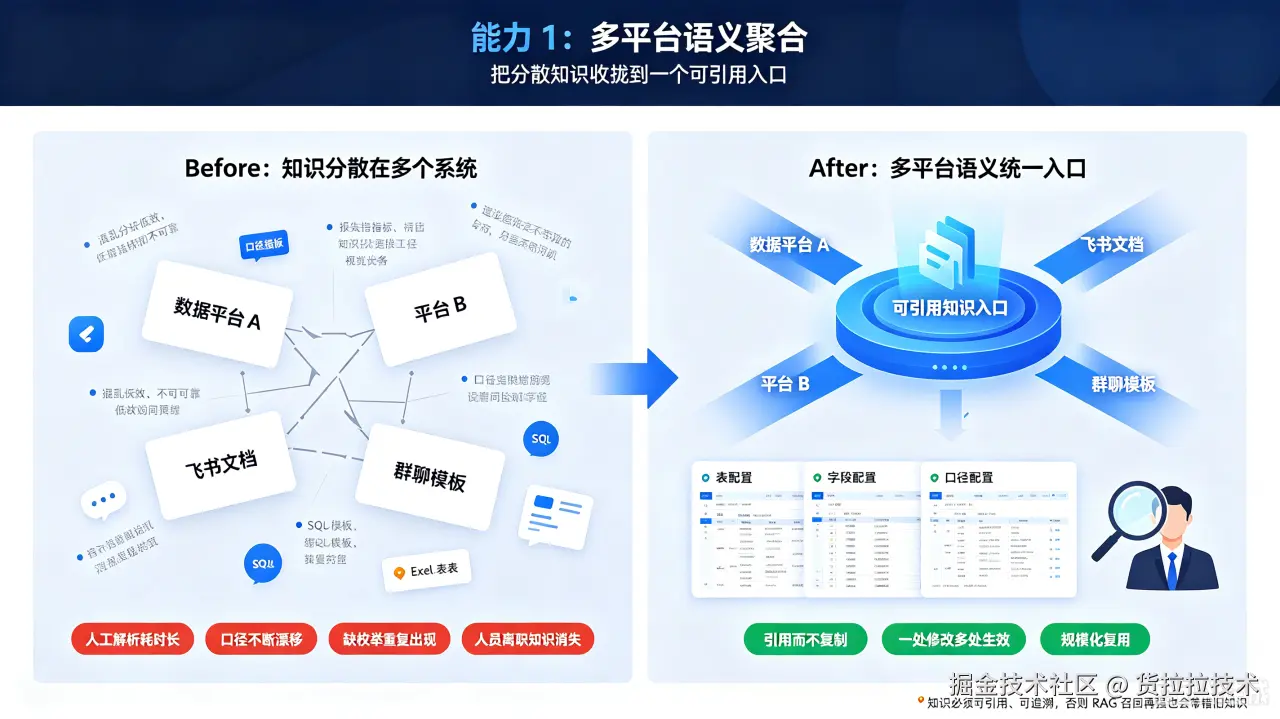
现实里,数据知识往往散落在多个系统:A 平台的字段解释、B 平台的报表指标、飞书文档里的口径说明,以及群聊里流传的 SQL 模板。结果就是靠人肉把信息拼起来:解析耗时、口径持续漂移;"缺枚举""口径不一致"的问题反复出现;甚至一个人离职,一个关键口径就跟着消失。
我们的做法是把"分散的描述"变成"可管理的资产":打通多数据平台语义;用一张集中配置表 承载表、字段、指标口径等结构化信息;业务侧从"复制粘贴"改为"引用",一处修改即可多处生效;最终实现规模化复用,一致性有保障。
3.2 智能语义补全
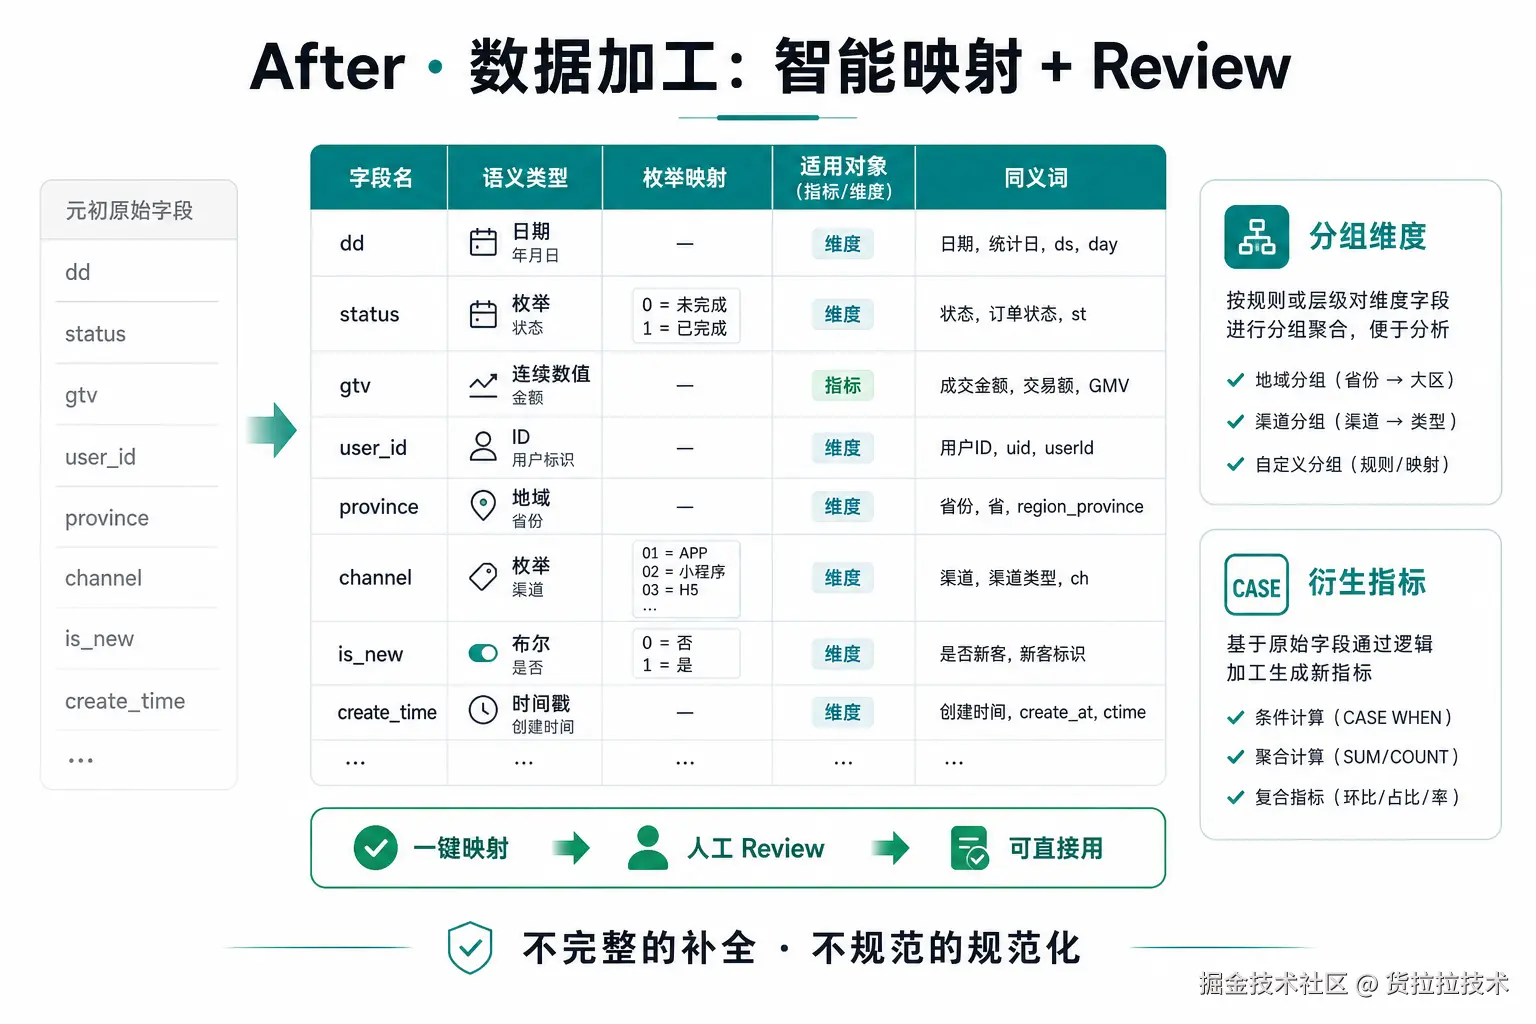
企业数据有很多"业务黑话"。AI 要能答题,必须知道它对应的标准语义、枚举值,以及同义词/别名映射。我们的原则只有两句:
1.不完整的,补充完整
2.不规范的,加工规范
流程也很简单:AI 一键映射语义 → 人工 Review 兜底 → 结果直接沉淀为统一知识资产可复用。
实践中最有效的是四类:语义类型、枚举映射、适用对象、同义词。价值在于把"资深数分才懂的隐性知识"变成可复用的显性配置。
3.3 语义知识分层
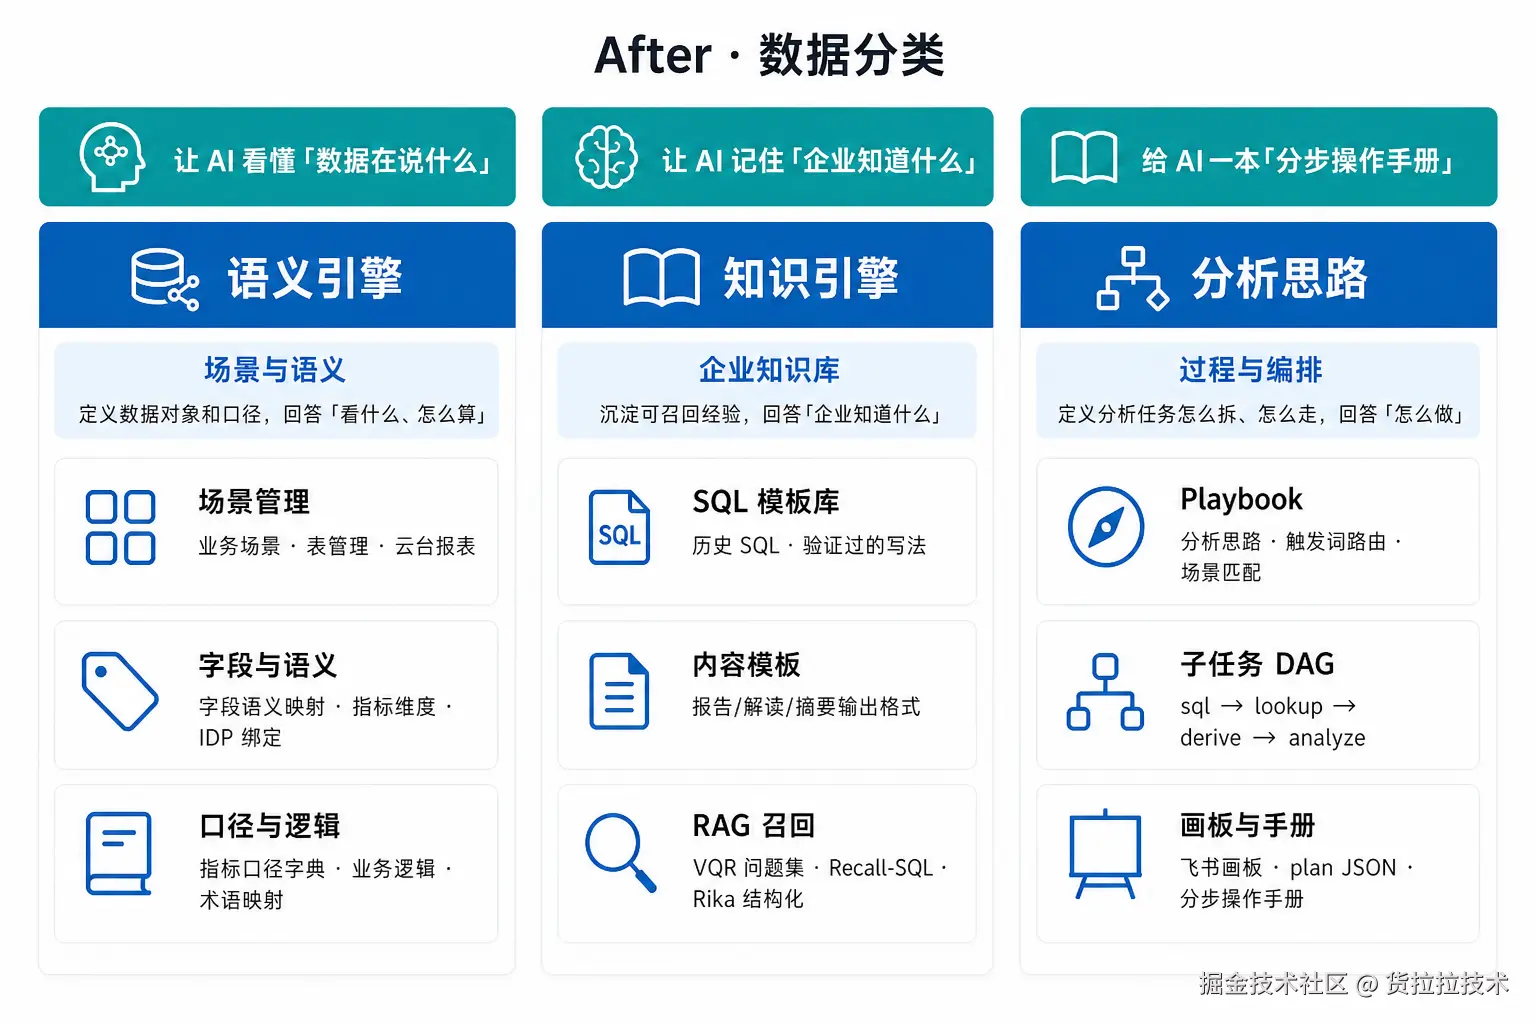
这是 DataLeap 最有特色的一块:我们不把"数据知识"揉成一锅,而是按 AI 需要它做什么 分成三层,各自治理、各自可控。
第一层:语义引擎: 让 AI 看得懂数据在说什么
第二层:知识引擎: 让 AI 知道企业已经沉淀了什么
第三层:分析思路: 告诉模型如何解决复杂问题
为什么必须分层?
三类知识的治理要求完全不同:指标口径是硬知识,要严格对齐、可管控、不能漂移;业务规则是软知识,会迭代,必须支持持续补全与更新;分析思路是方法论,依赖过程化表达,不是一段 SQL 能说清。
3.4 可评测的数据飞轮
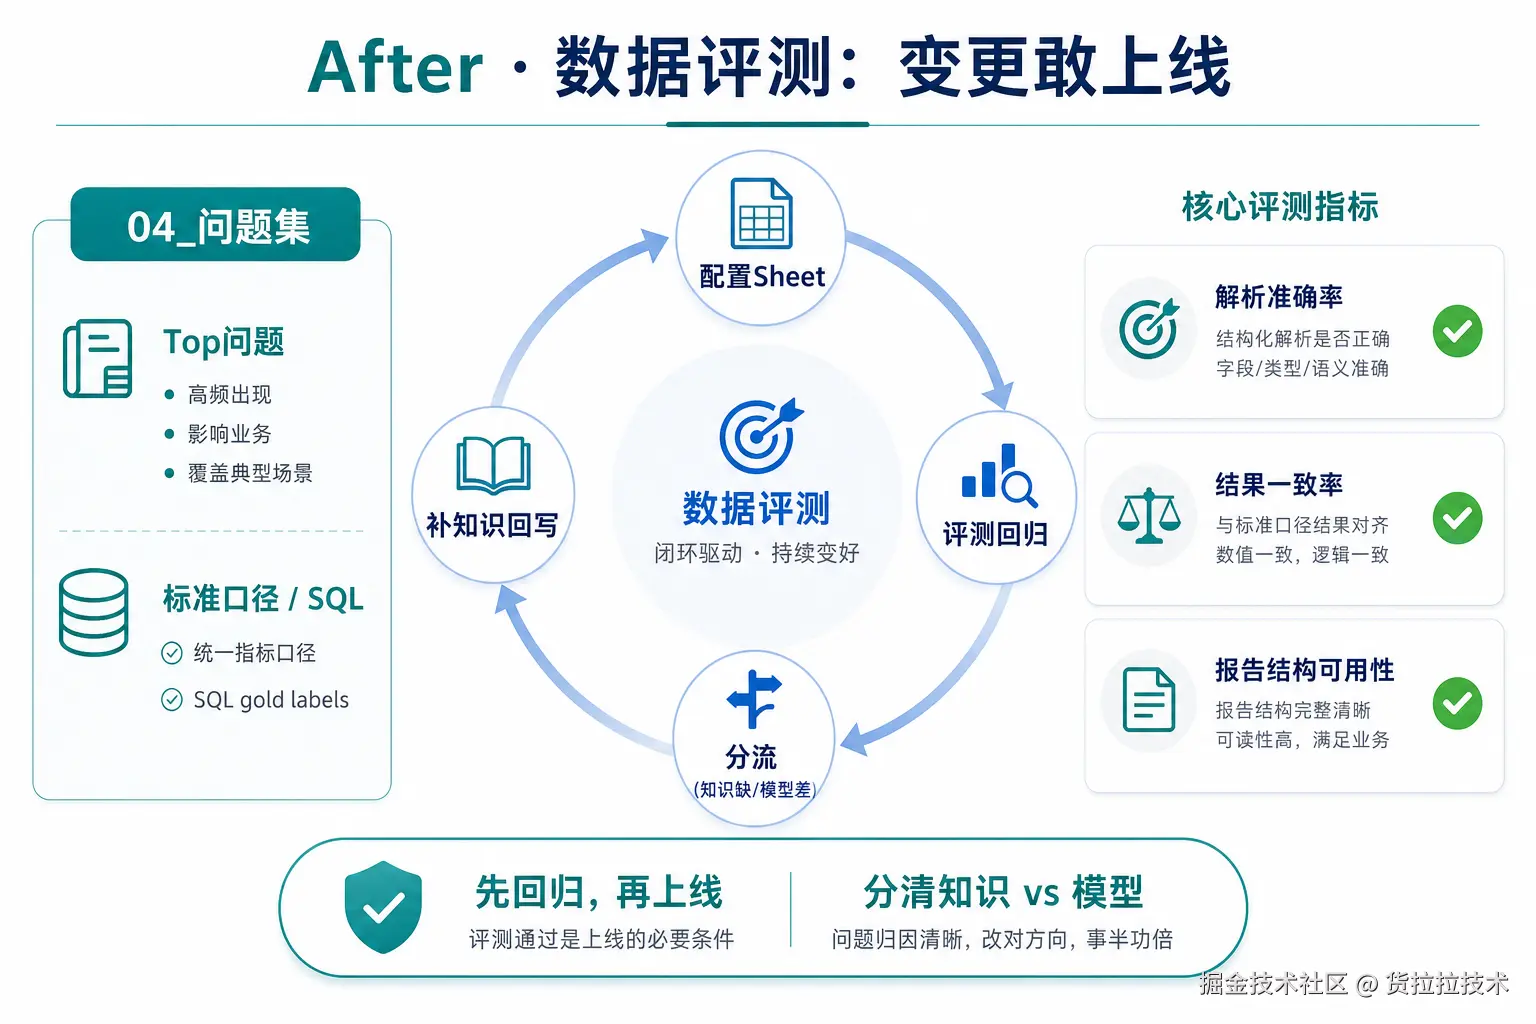
完成前三步后,我们一度认为"知识底座"已具备上线条件。但在实际运行中很快暴露出关键缺口:生成的知识缺乏可评测标准,难以持续迭代;当结果异常时,也无法快速定位问题来源(知识、口径还是模型)。
为此,我们补齐 "可评测 + 可持续补全" 这一闭环能力:上线前引入评测与回归机制,确保关键用例达标;上线后将高频问题持续回写沉淀为标准口径、SQL 与规则。
与此同时,建立三项稳定度量指标------解析准确率、结果一致率、报告结构可用性------以量化衡量效果,把上线后的"救火式排障"转为"可控回归"。失败样本持续反哺知识库,推动能力迭代形成正向飞轮。
4. 最佳实践
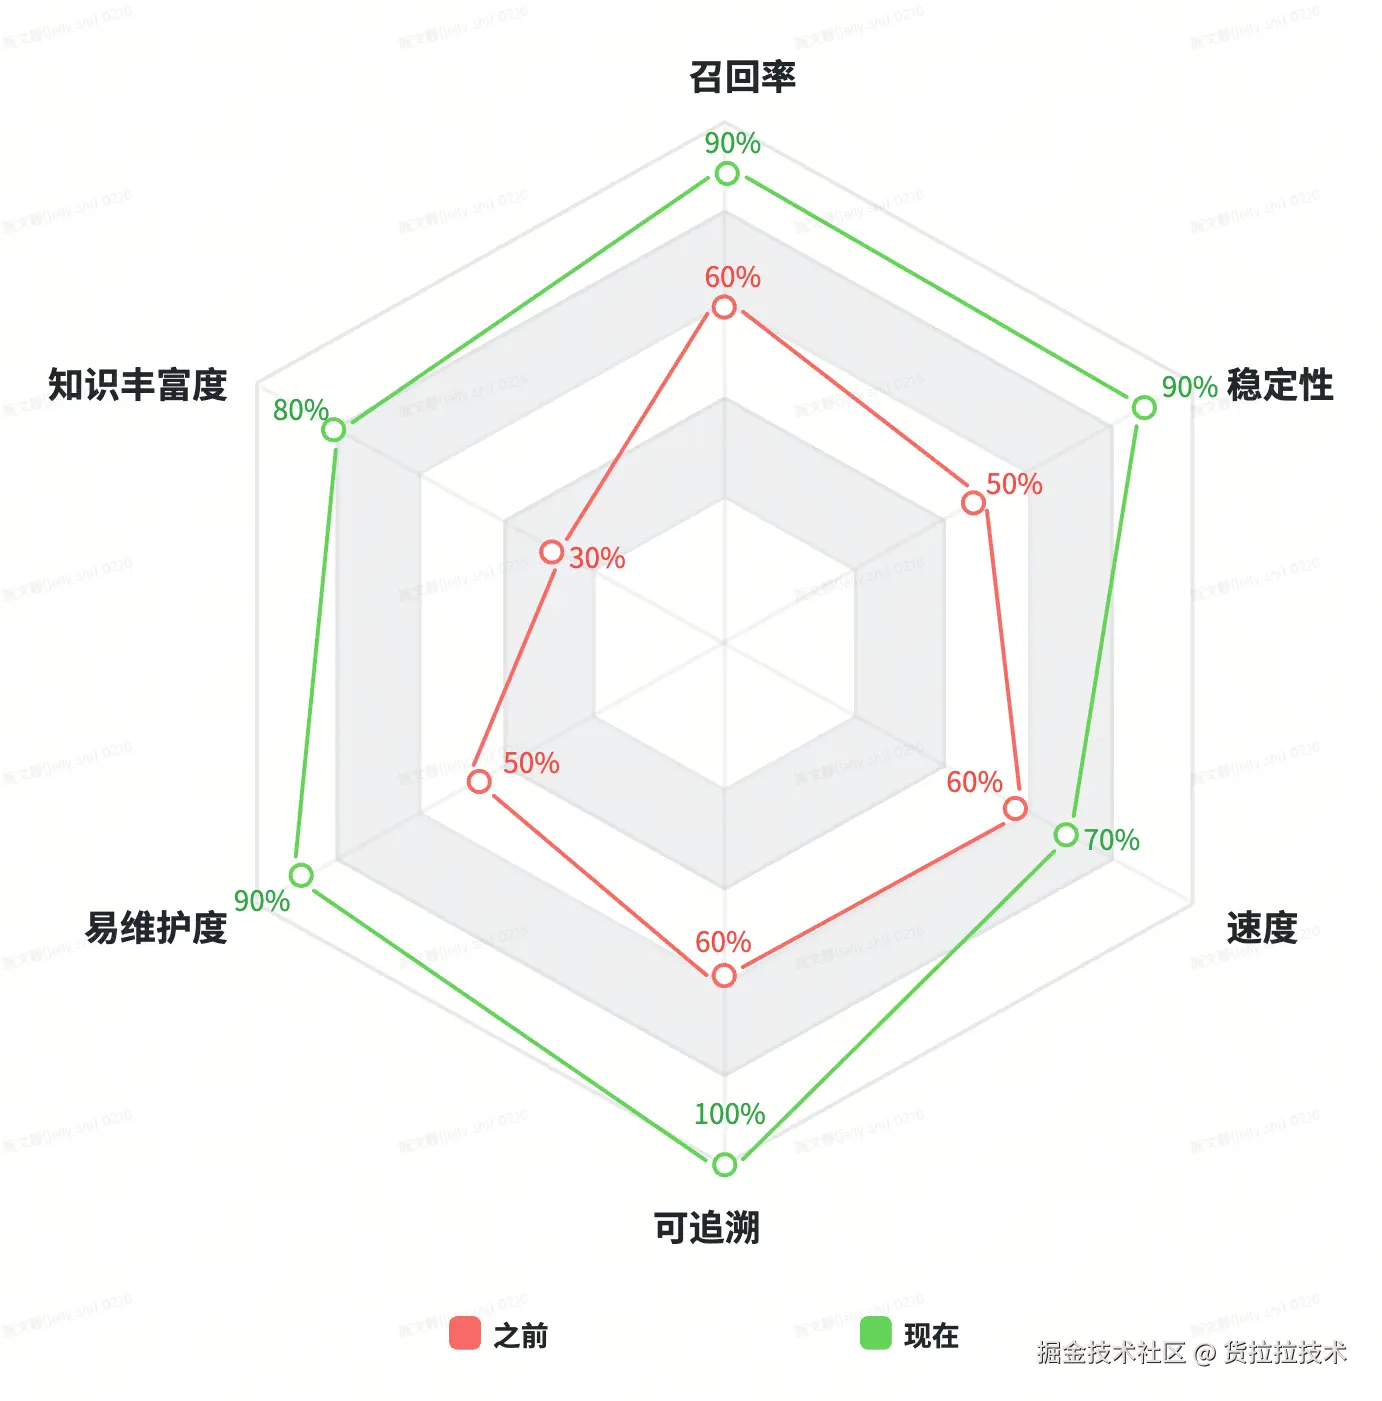
我们已在财务、金融、企业、小车邀约等多个场景完成落地验证。通过完善的语义与业务知识体系,召回率与整体稳定性可提升至 90% 。
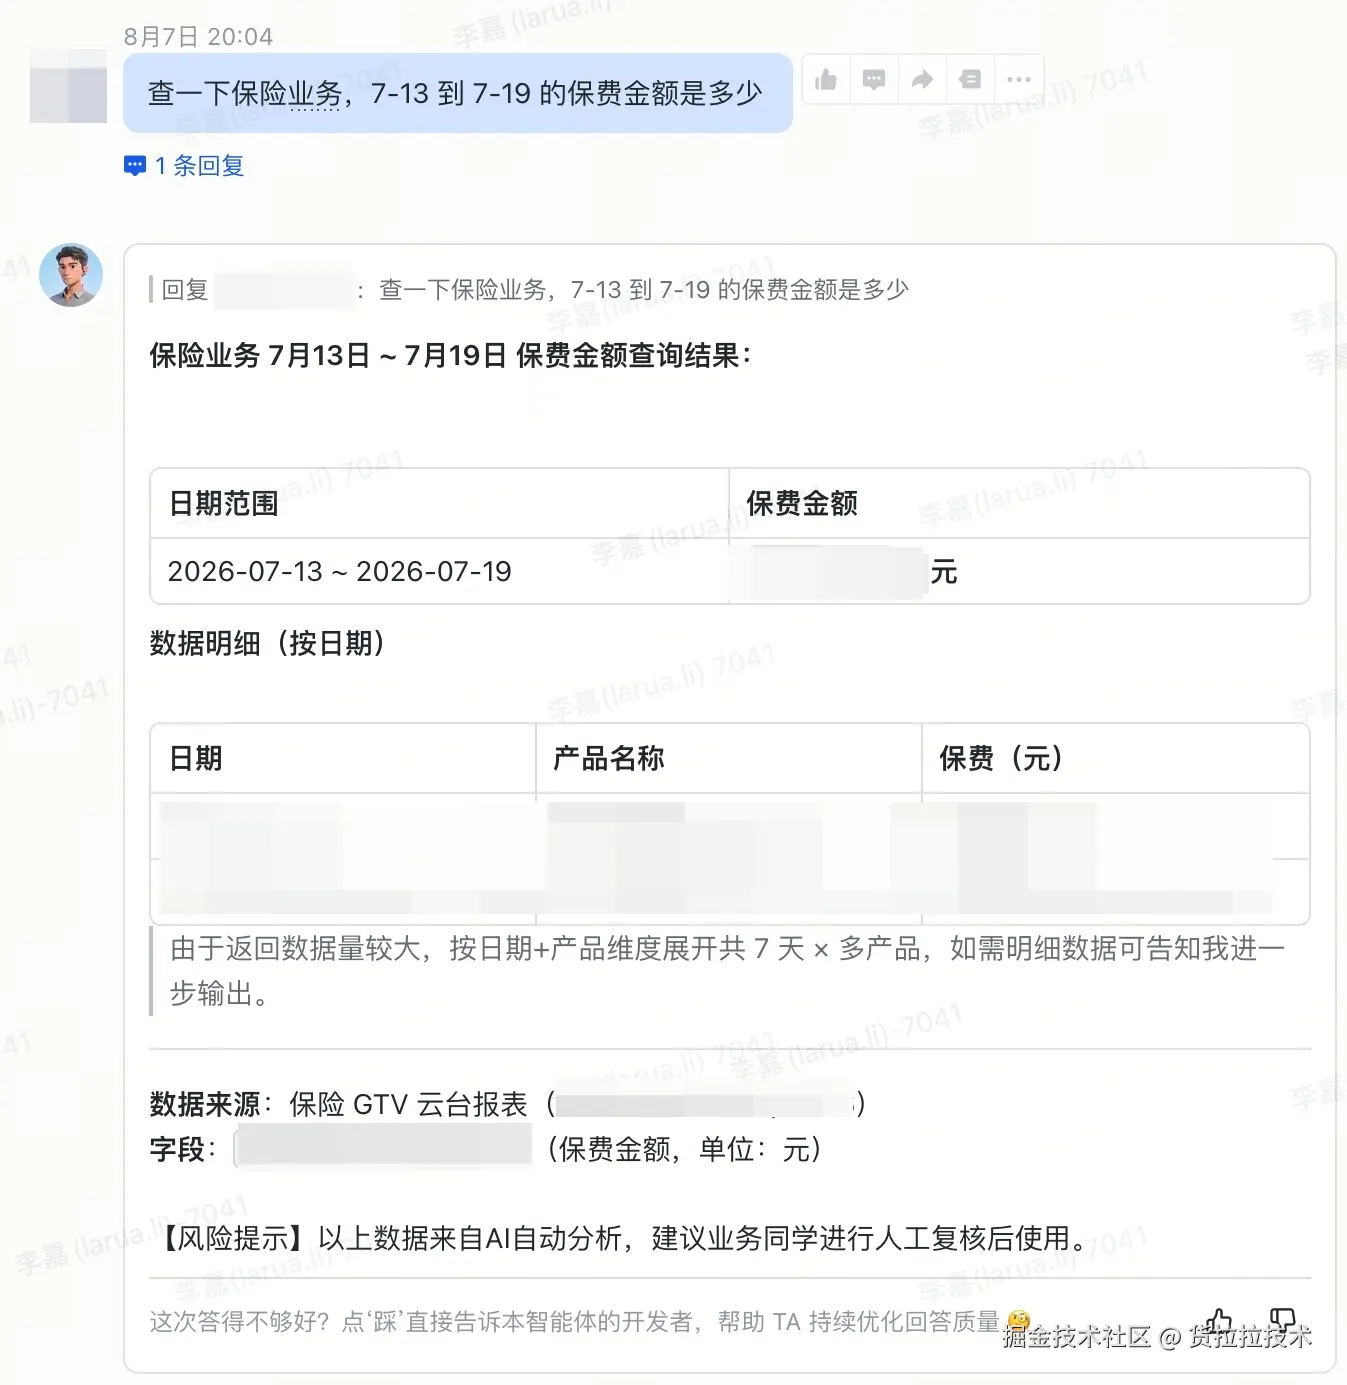
4.1 查数据
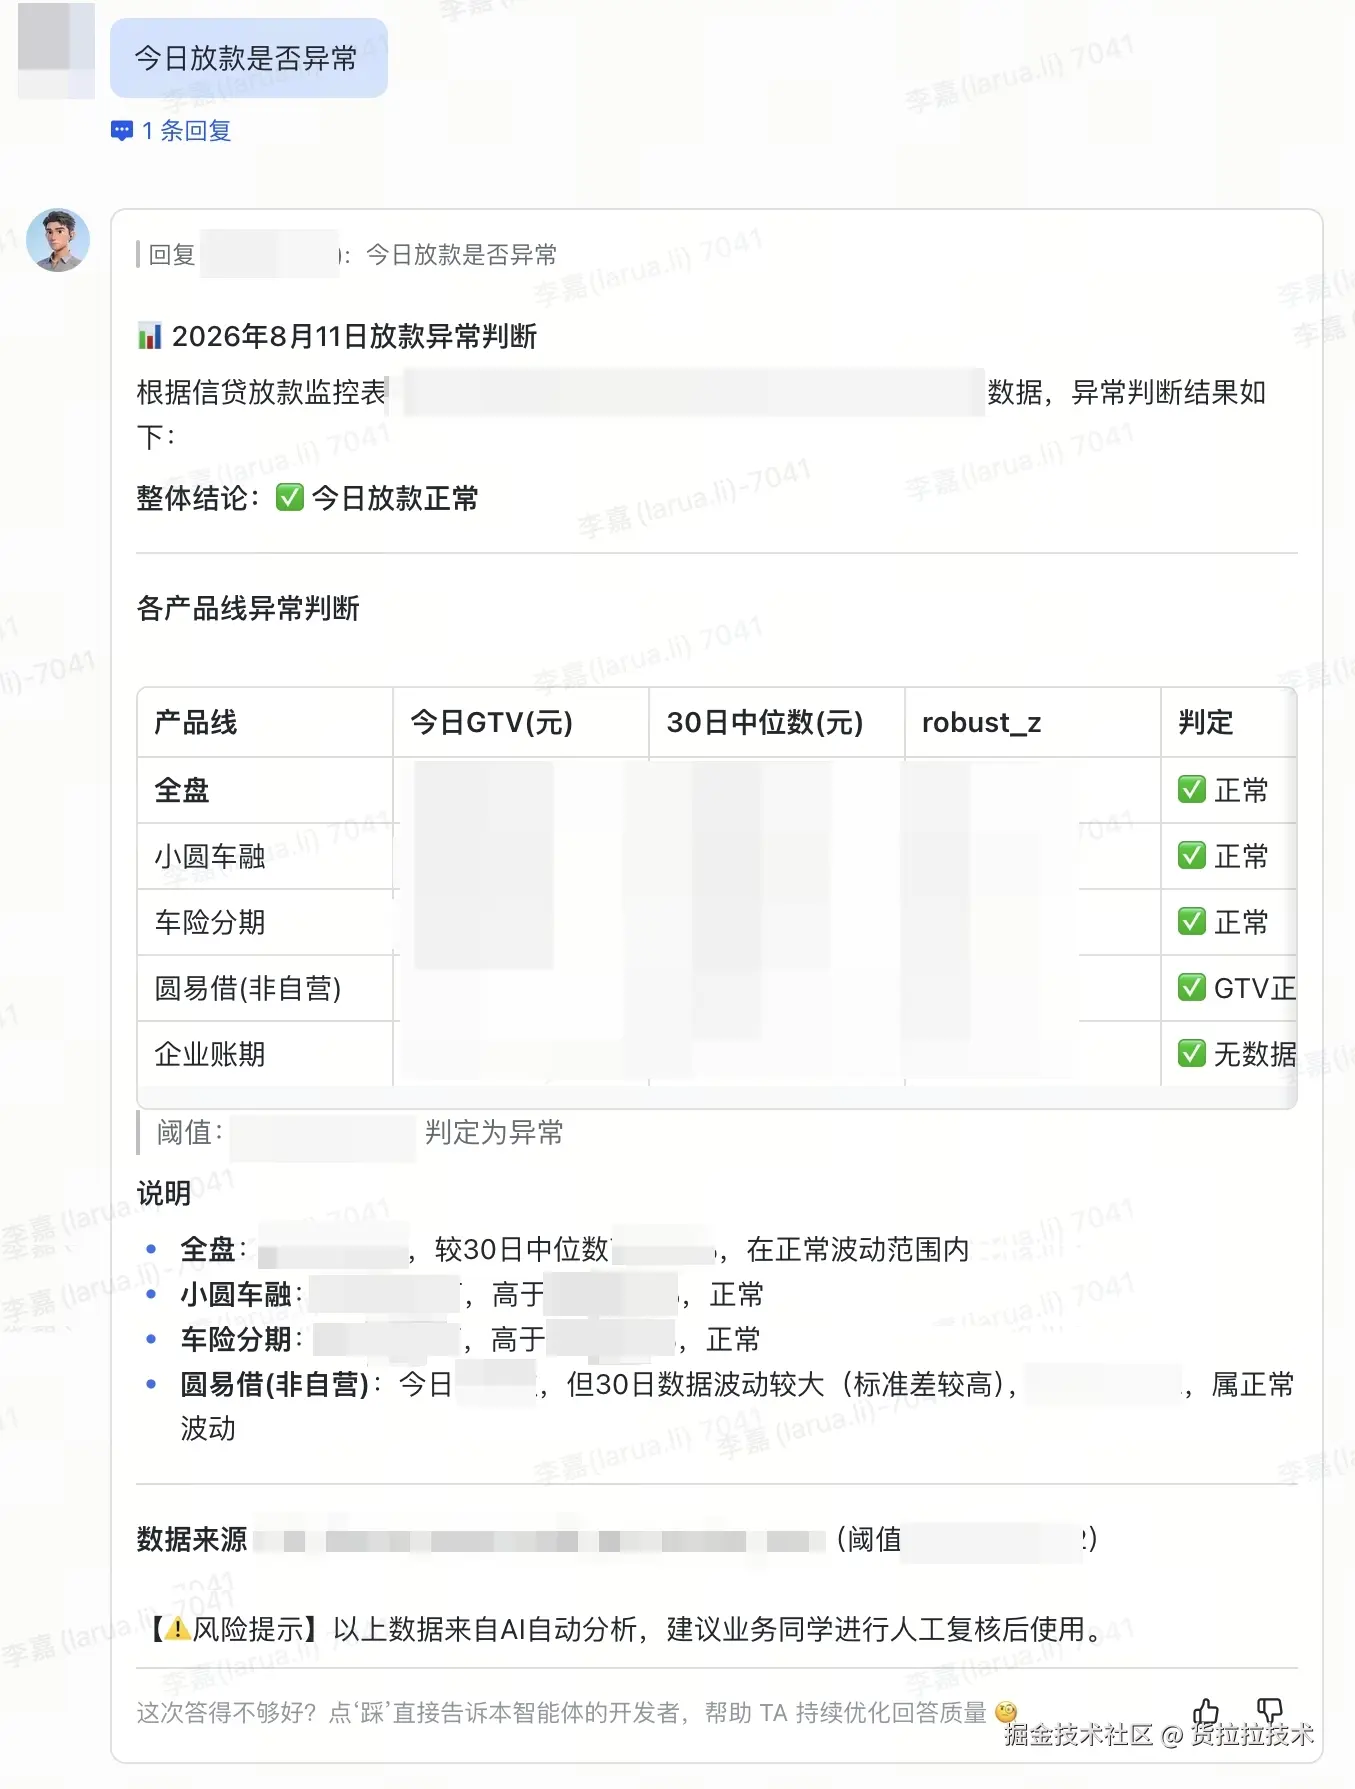
4.2 异常诊断分析
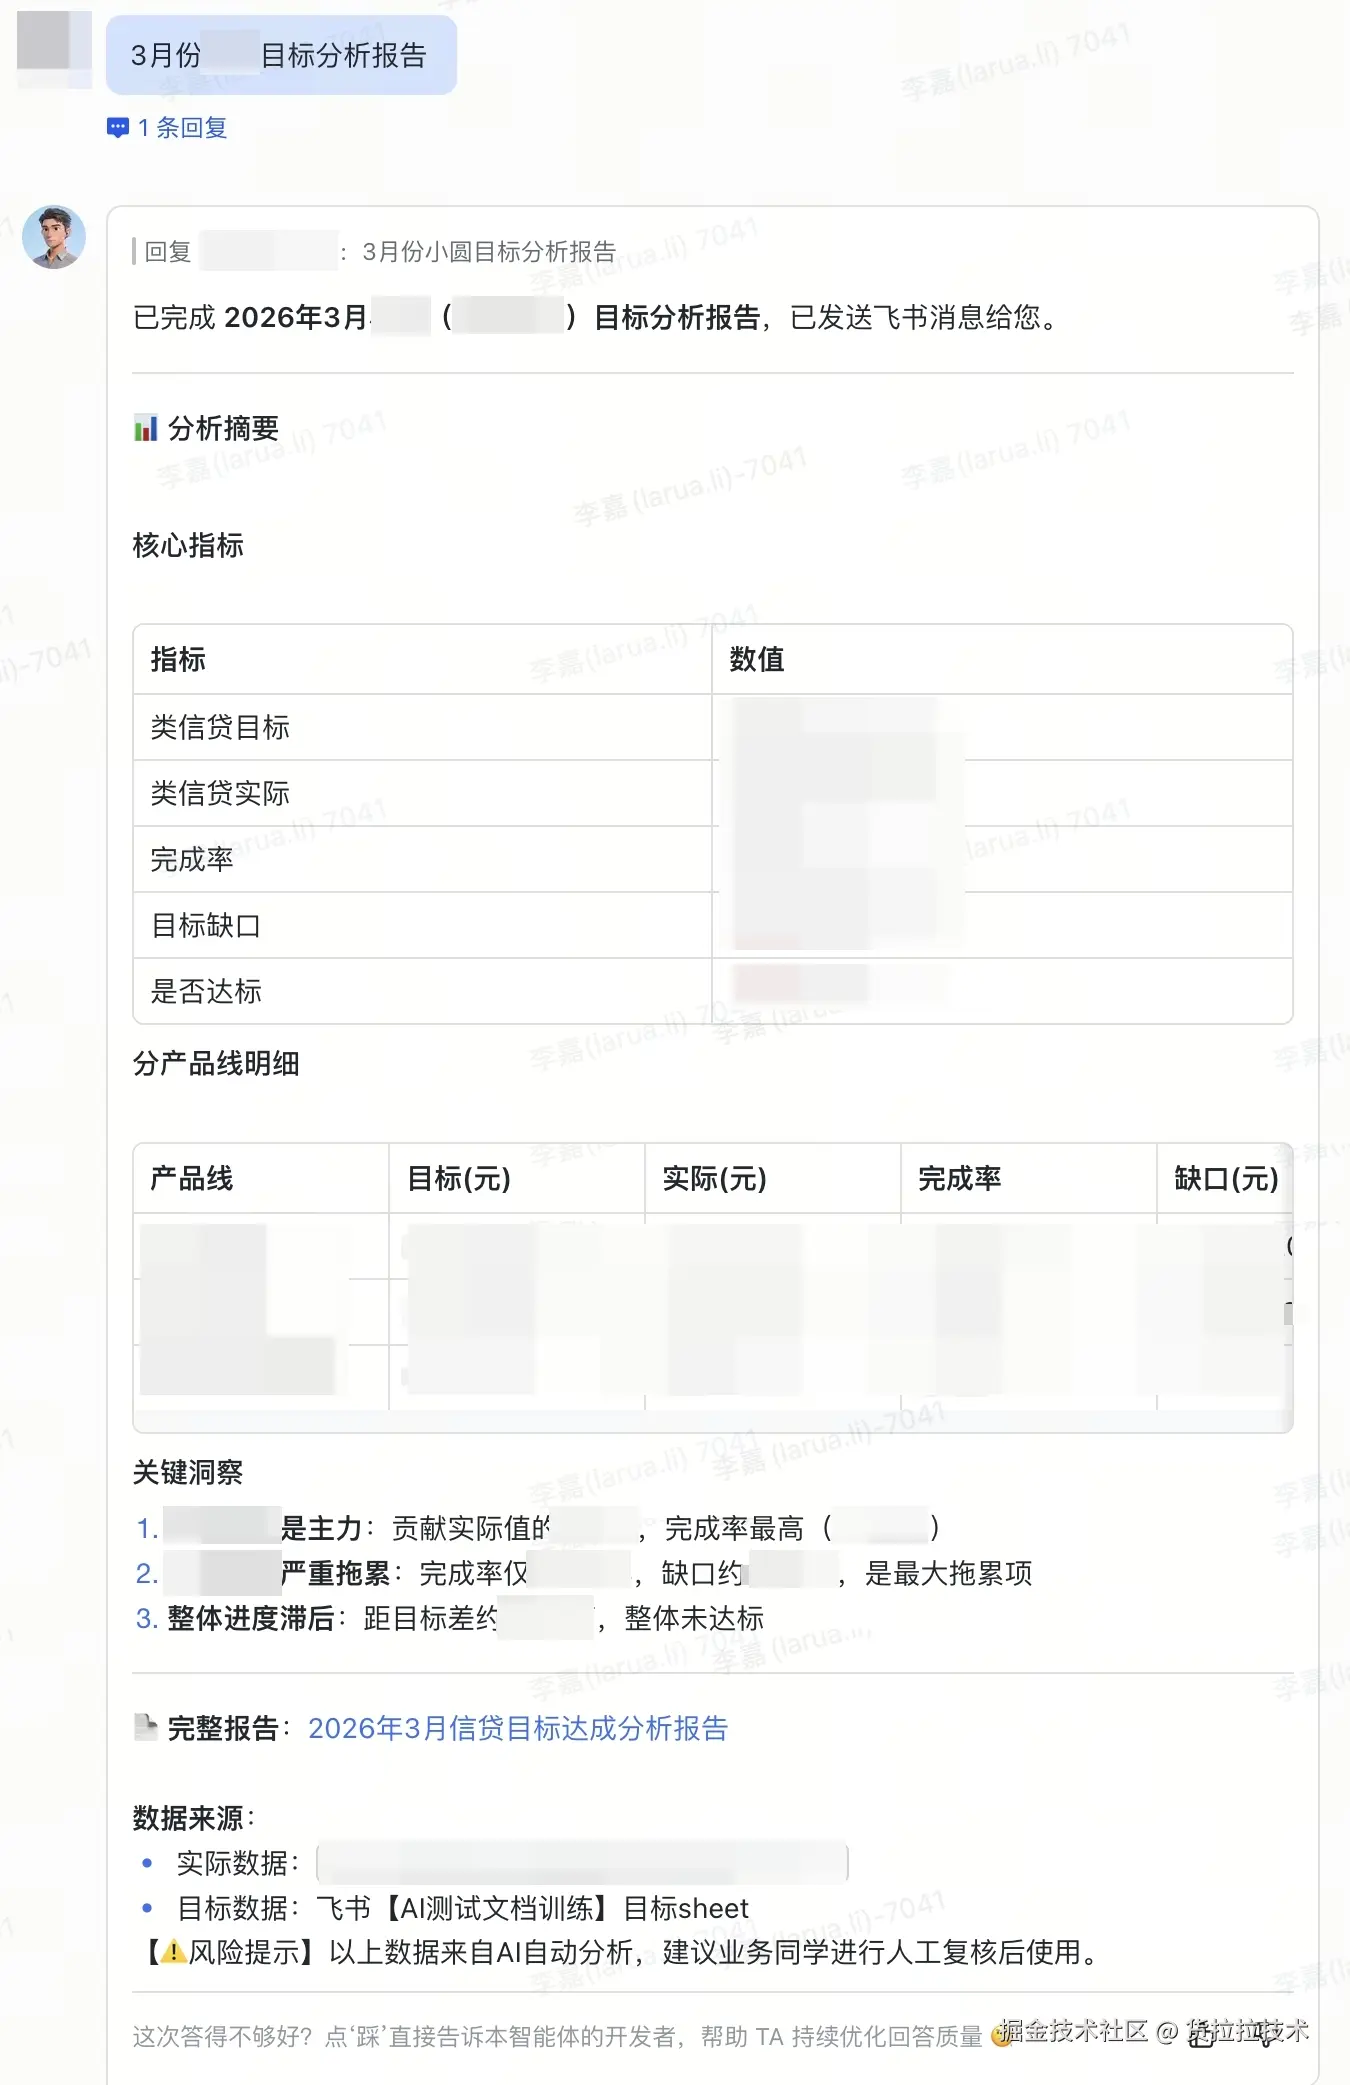
4.3 分析报告
5. 结束语
一句话总结:数据分析智能体能否稳定落地,关键不在于模型能力,而在于数据知识底座是否完善、口径是否一致、资产是否可复用。
如果你也在做 AI 数据分析应用,且同样被"口径漂移、知识分散、结果不稳"困扰,欢迎一起交流。
部门:技术中心-大数据技术与产品部
作者:施文静、李嘉、王海艳