一、引言
Apache Kafka 经常被称为"消息队列",但这只能解释它的一部分能力。更准确地说,Kafka 是一个以 分区、复制、持久化日志 为核心的分布式事件流平台:生产者持续追加事件,消费者使用 offset 记录读取位置,多个消费组可以按照各自节奏独立读取、回溯和重新处理历史数据。
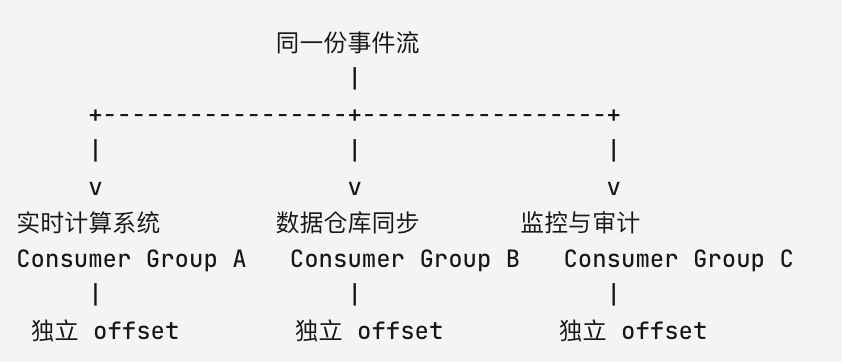
Kafka不把消息看成消费后立即消失的临时对象,而是把它看成追加到分布式日志中的事件。消费者读取一条事件,并不会导致这条事件被删除。事件是否保留,由 Topic 的保留策略决定;消费者读取到什么位置,则由自身的 offset 决定。因此,同一批数据可以被实时风控、数据仓库、监控平台和推荐系统分别消费。
二、架构与核心概念
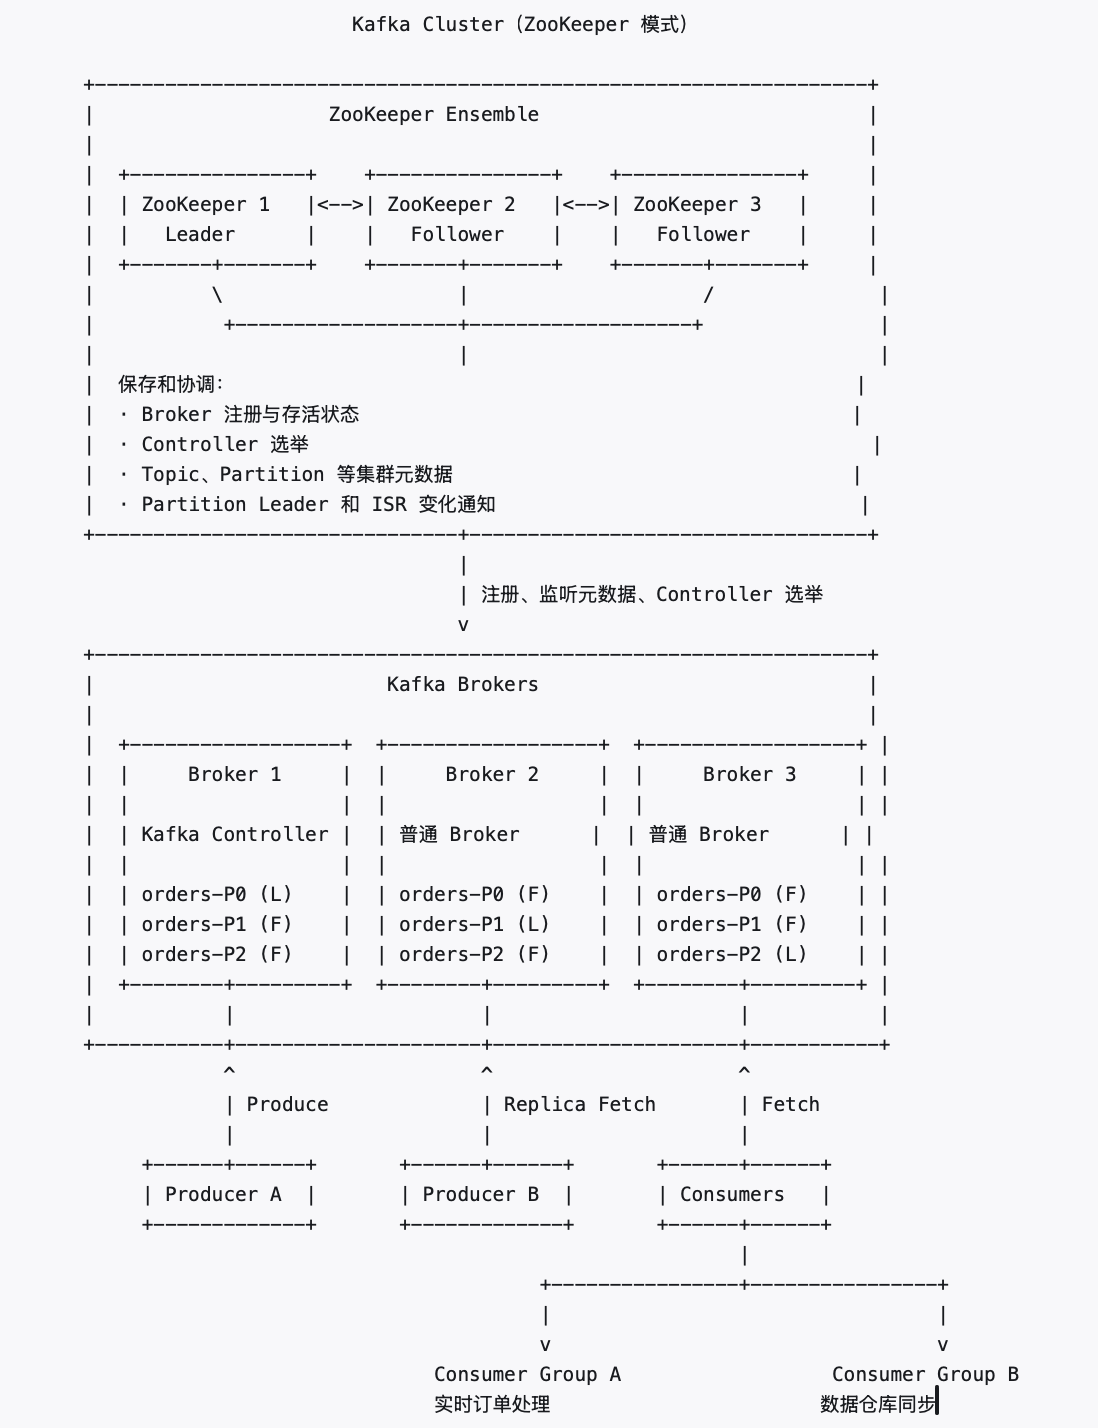
其中,Kafka 4.x 已移除 ZooKeeper 模式,只支持 KRaft,使用 controller quorum 管理集群元数据。
理解 Kafka,首先要理解一条主线:
Producer
   |
   | 发送事件
   v
Topic
   |
   | 拆分
   v
多个 Partition
   |
   | 复制
   v
多个 Broker 上的 Replica
   |
   | 按 Consumer Group 分配
   v
Consumer
1.Broker
Broker 是运行 Kafka 服务的节点,负责:
- 保存 Partition 日志;
- 接收 Producer 的写入请求;
- 响应 Consumer 的拉取请求;
- 在 Broker 之间复制数据;
- 承担消费组协调、事务协调等职责。
生产者和消费者通常只需要配置部分 Broker 地址作为bootstrap.servers 。客户端连接任意可用的引导节点后,会获取完整集群元数据,不需要手工列出所有 Broker。
2.Topic
Topic 是事件流的逻辑名称,例如:
orders
payments
user-behavior
database-changelog
Topic 是配置和管理边界。不同 Topic 可以设置不同的:
- Partition 数量;
- 副本因子;
- 数据保留时间;
- 日志压缩策略;
- 最小同步副本数;
- 单条消息大小限制。
Topic 不是一份单独的大文件,它由一个或多个 Partition 组成。
3.Partition
Partition 是 Kafka 的存储、局部顺序和并行处理单位,其本质是一个只追加的有序日志。
Topic: orders

Partition 0: [0][1][2][3][4][5]...
Partition 1: [0][1][2][3]...
Partition 2: [0][1][2][3][4]...
                ^
                offset
每条记录进入某个 Partition 后,会获得一个递增的 offset。需要特别注意:Kafka 只保证同一个 Partition 内的记录顺序,不保证整个 Topic 的全局顺序。
如果订单事件使用order_id 作为 key,并且分区数量与分区算法不变,那么同一订单的事件通常会进入同一 Partition,从而获得局部顺序。
不过,这个结论有两个边界:
- 增加 Partition 后,key 到 Partition 的映射可能改变;
- 更换分区器或分区算法后,映射也可能改变。
因此,"使用相同 key 就永远有序"并不严谨。更准确的说法是: 在分区数量、分区算法和业务 key 规则稳定时,同 key 事件通常能够保持 Partition 内顺序。
4.Replica
为避免单个 Broker 故障导致数据不可用,一个 Partition 可以拥有多个 Replica。
假设副本因子为 3:
                       Broker 1
                    +-------------+
写入请求 ----------> | P0 Leader   |
                    +------+------+
                           |
               +-----------+-----------+
               |                       |
               v                       v
          Broker 2                Broker 3
       +-------------+         +-------------+
       | P0 Follower |         | P0 Follower |
       +-------------+         +-------------+
正常情况下:
- Leader 处理该 Partition 的生产和消费请求;
- Follower 从 Leader 拉取数据;
- Leader 故障后,Kafka 从满足条件的副本中选出新 Leader。
Kafka 新版本也支持 follower fetching,但默认的数据读取路径仍应按照 Leader 读取模型理解;具体是否从本地副本读取,受客户端和机架感知配置影响。
5.ISR
ISR 是 In-Sync Replicas 的缩写,表示当前处于同步状态的副本集合,Leader 本身也属于 ISR。
例如:
Assigned Replicas: [1, 2, 3]
ISR:               [1, 2]
这表示 Partition 配置了 3 份副本,但 Broker 3 上的副本已经落后到不再被认为同步。
因此:
所有 Replica != ISR如果配置:
min.insync.replicas=2同时生产者使用:
acks=all那么 ISR 少于 2 时,Broker 会拒绝写入,而不是继续以单副本接收数据。系统以暂时降低可用性为代价,避免在副本不足时继续累积数据风险。
6.Consumer Group
Consumer Group 用于让多个消费者共同处理一个 Topic。
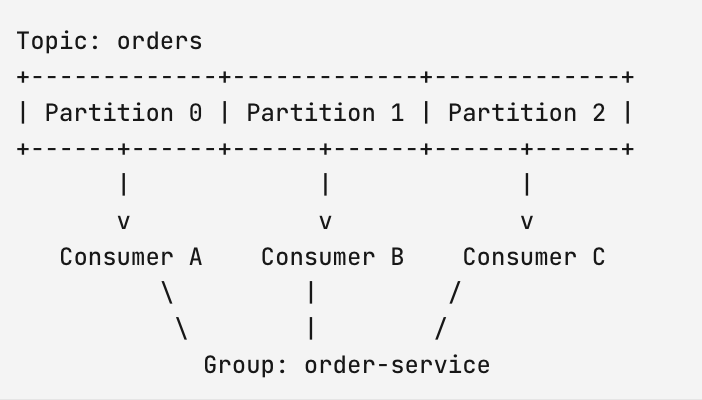
在传统 Consumer Group 中,同一个 Partition 在同一时刻最多分配给组内一个 Consumer。因此,消费并行度受 Partition 数限制。
假设一个 Topic 有 3 个 Partition:
|-------|---------|-----------------------|
| 消费者数量 | 实际并行消费者 | 结果 |
| 1 | 1 | 一个消费者处理全部 Partition |
| 2 | 2 | 两个消费者分担 3 个 Partition |
| 3 | 3 | 每个消费者处理一个 Partition |
| 5 | 3 | 两个消费者处于空闲状态 |
这意味着增加消费者并不一定提高吞吐。只有当 Partition 数足够、Broker 和下游系统仍有余量时,横向扩容消费者才可能有效。
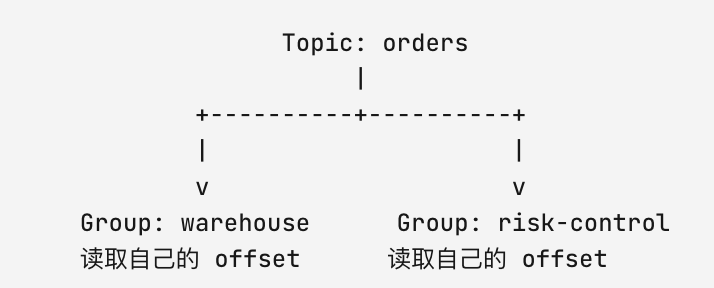
不同 Consumer Group 之间互不影响:
7.Offset
Kafka 中有几种容易混淆的位置概念。
|--------------------|------------------------------|
| 概念 | 含义 |
| Record Offset | 一条记录在 Partition 中的位置 |
| Consumer Position | Consumer 下一次准备读取的位置 |
| Committed Offset | 消费组持久保存的恢复位置 |
| High Watermark | 已复制到足够副本、可安全暴露的日志边界 |
| Last Stable Offset | read_committed 模式下可读取的事务稳定边界 |
假设 Consumer 已处理 offset 为 100 的消息,提交值通常是 101,含义是"下次从 101 开始读取"。
Partition:
... [98] [99] [100] [101] [102] ...

已经处理到:       100
提交的下一位置:         101
提交 offset 只是在 Kafka 中保存恢复位置,并不代表业务一定处理成功。例如,应用先提交 offset,再写数据库,随后数据库写入失败,这条消息在重启后可能不会再次被读取。
三、生产和消费流程
一次典型写入和消费过程如下:
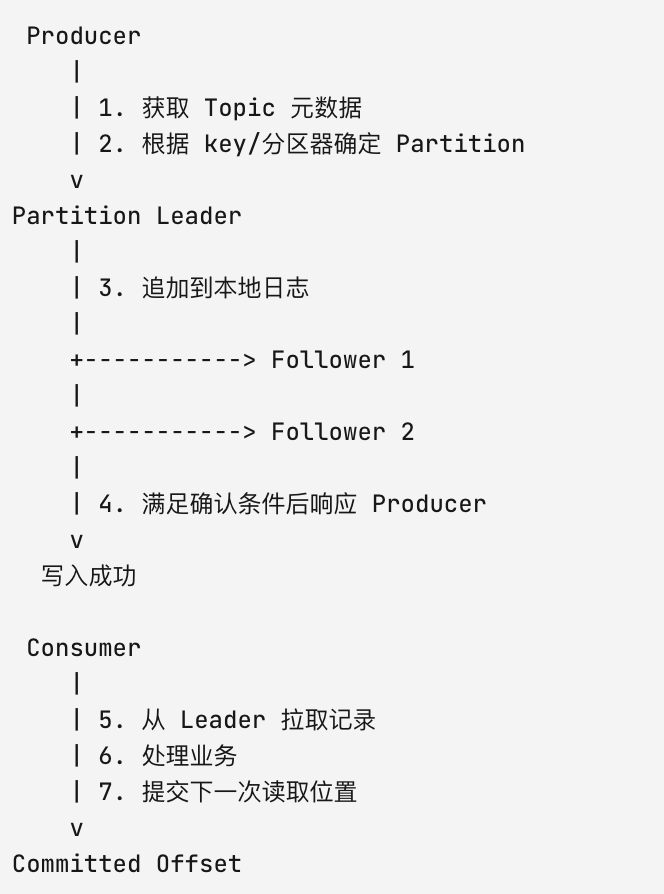
Producer 通常不会把所有数据先发送给一个中央路由节点,而是先获取 Topic 元数据,然后直接向目标 Partition 的 Leader 发送数据。这减少了中心转发瓶颈。
Consumer 采用拉取模式。它根据自己的处理能力向 Broker 请求数据,并维护读取位置。慢消费者不会要求 Producer 降速,但会形成不断增长的消费积压。
四、Kafka 为什么吞吐高
1.顺序追加
Kafka 将记录持续追加到 Partition 日志尾部,主要使用顺序 I/O,而不是围绕每条消息维护复杂的随机更新结构。
随机写:
磁盘位置 A -> 位置 Z -> 位置 C -> 位置 M

顺序追加:
[旧数据][旧数据][新数据][新数据][新数据] ->
顺序访问通常比频繁随机寻址更适合磁盘和现代存储设备。不过,Kafka 性能仍然受磁盘、网络、page cache 命中率、日志段数量、副本恢复和消息尺寸等因素影响。
2.批处理
Producer 会把多条记录组合成 Record Batch,再统一发送:
逐条发送:
[M1] -> [M2] -> [M3] -> [M4]

批量发送:
[M1 M2 M3 M4] ->
批量处理可以减少:
- 网络请求次数;
- 系统调用次数;
- 请求头开销;
- 磁盘写入次数;
- 压缩元数据开销。
batch.size 和linger.ms 会影响批量程度。Kafka 4.x版本 起,Producer 的linger.ms 默认值由早期版本的 0 调整为 5 毫秒,旧版经验不能直接套用到当前版本。
3.Page Cache
Kafka 倾向于使用操作系统 page cache 管理热点数据,而不是在 JVM 堆中维护一份大规模重复缓存。
这样做的好处包括:
- 减少 JVM 大堆带来的垃圾回收压力;
- 操作系统可以统一管理磁盘缓存;
- Broker 重启后,操作系统缓存不一定立即消失;
- 刚写入的数据往往仍在 page cache 中,消费者可以快速读取。
但 page cache 不是无限资源。Kafka Broker 与其他高 I/O 程序混部,可能产生严重的缓存竞争。
4.少拷贝路径
在适用的非 SSL 传输路径中,Kafka 可以利用sendfile 等机制减少数据在内核空间和用户空间之间的复制。
概念上的传统路径:
磁盘 -> 内核缓存 -> 应用缓冲区 -> Socket 缓冲区 -> 网卡减少复制后的路径更接近:
磁盘 -> 内核缓存 -----------------------> 网卡需要注意:使用 SSL 时不能利用同样的sendfile 零拷贝路径。
5.压缩
Kafka 支持 gzip、snappy、lz4 和 zstd 等压缩算法。压缩以 Record Batch 为单位进行,通常可以减少网络流量和磁盘占用。
是否选择 zstd、lz4 或其他算法,需要根据以下指标压测:
- 消息内容的可压缩性;
- CPU 预算;
- 网络带宽;
- 端到端延迟;
- Broker 解压和重压缩行为;
- 客户端兼容性。
五、数据保留与回放
Kafka 的数据生命周期与消费者读取行为解耦。消息被消费后,不会因此立即删除。
常见保留配置包括:
retention.ms=604800000
retention.bytes=107374182400
retention.ms 控制保留时间,retention.bytes 控制空间上限。需要注意,retention.bytes 是按 Partition 生效的,不是整个 Topic 共享一个总容量。
Kafka 按日志段进行清理,而不是在每条记录刚到期时立即逐条删除。因此,即使记录已经超过保留时间,实际释放空间也可能存在延迟。
这种设计让 Kafka 支持数据回放:
实时消费:
offset 1000 -> 1001 -> 1002 -> ...

问题修复后重新计算:
offset 0 -> 1 -> 2 -> ... -> 1002
回放能力适用于:
- 修复计算逻辑后重算;
- 恢复下游数据库;
- 新系统接入后补历史数据;
- 审计和问题复盘;
- 重新构建搜索索引或状态存储。
六、可靠性机制
一组常见的高可靠配置如下:
# Topic
replication.factor=3
min.insync.replicas=2

# Producer
acks=all
enable.idempotence=true

# Broker
unclean.leader.election.enable=false
acks=all 并不表示所有已配置 Replica 都确认,而是等待当前同步副本集合满足确认条件。因此,它需要与min.insync.replicas 配合。
|----------|-----------------|------------------------|
| 配置 | Producer 何时认为成功 | 主要风险 |
| acks=0 | 不等待 Broker 响应 | 可能静默丢失 |
| acks=1 | Leader 本地写入成功 | Leader 故障时,尚未复制的数据可能丢失 |
| acks=all | 当前 ISR 满足确认要求 | 延迟相对更高,ISR 不足时可能拒绝写入 |
如果所有同步副本都不可用,是否允许一个落后的副本成为 Leader,由unclean.leader.election.enable 控制。开启不干净选主可以提高极端故障下的可用性,但可能造成数据截断或丢失;关闭后则可能让 Partition 暂时不可用。这是典型的完整性与可用性取舍,不存在适合所有系统的统一答案。
七、消息语义
- At-most-once:先提交 offset,再处理业务。如果提交后处理失败,消息可能不会再次读取,因此可能丢处理,但通常不会重复处理。
- At-least-once:先处理业务,再提交 offset。如果业务已成功,但提交 offset 前应用崩溃,重启后可能再次处理该消息。这是很多业务系统更常用的模式,但下游必须考虑幂等。
- Exactly-once:Kafka 可以通过以下机制提供事务能力:幂等 Producer 避免生产重试导致重复追加、Transaction 将多个 Partition 的写入原子化、将消费 offset 与输出记录放在同一事务中提交、Consumer 使用isolation.level=read_committed 跳过中止事务等。
Kafka 在其事务边界内可以提供 Exactly-once 处理能力,但跨出 Kafka 后,需要外部系统共同参与。
八、功能生态
1.Kafka Connect
Kafka Connect 用于 Kafka 与外部系统之间的数据集成。
外部系统                    Kafka                    外部系统
数据库 ---- Source Connector ---> Topic ---> Sink Connector ---- 数据仓库
文件系统 -- Source Connector ---> Topic ---> Sink Connector ---- 搜索引擎
主要概念包括:
- Source Connector:将外部数据写入 Kafka;
- Sink Connector:将 Kafka 数据写到外部系统;
- Connector:负责规划数据任务;
- Task:实际执行数据传输;
- Worker:运行 Connector 和 Task。
Standalone 模式适合本地开发和简单任务;Distributed 模式支持多个 Worker、任务重新分配、故障转移和动态扩缩,更适合生产环境。
需要注意,Connector 的交付语义取决于具体实现和目标系统能力,不能仅凭"使用 Kafka Connect"就推断整个链路一定是 Exactly-once。
2.Kafka Streams
Kafka Streams 是嵌入 Java 或 Scala 应用的客户端库,不是需要单独部署的一套计算集群。
它支持:
-
map 、filter ;
-
分组与聚合;
-
Stream-Stream Join;
-
Stream-Table Join;
-
窗口计算;
-
事件时间处理;
-
本地状态存储;
-
状态变更日志与故障恢复。
Input Topic
|
v
Kafka Streams Application
|
+--> Filter
|
+--> Group / Window / Aggregate
|
+--> State Store
|
v
Output Topic
有状态计算的数据通常保存在本地 State Store,并通过 Kafka Changelog Topic 进行恢复。其有效并行度仍受输入 Partition 和任务划分约束。
九、优势与代价
|-----------|-------------------------------------|
| 优势 | 原因 |
| 高吞吐 | 顺序追加、批处理、压缩、page cache 和分区并行 |
| 可扩展 | Topic 可以通过多个 Partition 分布在多个 Broker |
| 高可用 | Partition 副本、ISR 和 Leader 故障转移 |
| 可回放 | 消费位置与数据生命周期分离 |
| 多订阅者 | 不同 Consumer Group 独立维护 offset |
| 生态丰富 | Connect、Streams 及大量第三方集成 |
| 流批一体的数据基础 | 同一事件日志可服务实时处理和离线同步 |
|----------|-----------------------------|
| 代价 | 表现 |
| 顺序边界 | 只保证 Partition 内顺序 |
| 运维复杂度 | 需要管理副本、磁盘、网络、分区和 Controller |
| 容量成本 | 长时间保留和多副本会放大存储需求 |
| 热点风险 | key 分布不均可能形成热 Partition |
| 消费一致性 | 业务侧仍需处理重复、失败和外部副作用 |
| 分区不可随意调整 | 扩分区可能改变 key 映射和顺序假设 |
| 低延迟并非零成本 | 批量吞吐、复制可靠性和延迟之间需要权衡 |
十、适用场景
- 事件驱动架构:订单、支付、库存、物流等系统通过事件解耦。
- 日志与指标管道:集中采集应用日志、访问日志和运行指标,再写入数据湖、搜索系统或实时监控平台。
- CDC 数据同步:数据库变更通过 CDC 工具进入 Kafka,再同步到目标端。
- 实时计算:Kafka 作为 Flink、Spark Structured Streaming 或 Kafka Streams 的输入和输出层。
- 数据回放和审计:需要长期保留事件、重新计算、恢复下游状态或复盘历史操作时,Kafka 的 offset 和保留机制具有明显优势。
Kafka 并非任何消息需求的默认答案。以下场景应谨慎选择:
- 只需少量、低频、简单异步任务,使用 Kafka 可能增加不必要的运维成本;
- 需要复杂消息优先级、单条消息任意延迟投递时,专用消息系统可能更直接;
- 需要跨所有事件的严格全局顺序,而吞吐量又较高;
- 需要同步请求响应,RPC 或 HTTP 通常更合适;
- 需要对外部数据库和 HTTP 调用自动实现全局事务;
- 数据量很小,却需要维护多 Broker 和 Controller 集群。
Kafka 擅长的是可持久、可回放、高吞吐的事件流,不是对所有通信模型进行替代。
十一、小结
Kafka 的核心并不复杂: 生产者把事件追加到分区日志,Broker 对日志进行持久化和复制,消费者按照自己的 offset 拉取数据。 但正是 Partition、Replica、ISR、Consumer Group 和数据保留之间的组合,让 Kafka 同时具备高吞吐、可扩展、可回放和多订阅者能力。
建立 Kafka 的正确认知,需要记住几个边界:
- Kafka 是事件流平台,不只是传统消息队列;
- 顺序保证以 Partition 为边界;
- 高可用来自副本和 ISR,不是单一配置;
- 消息提交位置不等于业务处理完成;
- Exactly-once 有明确的系统边界;
- 增加 Partition、Consumer 或重试次数都不是无成本优化;
- 生产稳定性依赖容量规划、监控、压测和故障演练。