✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
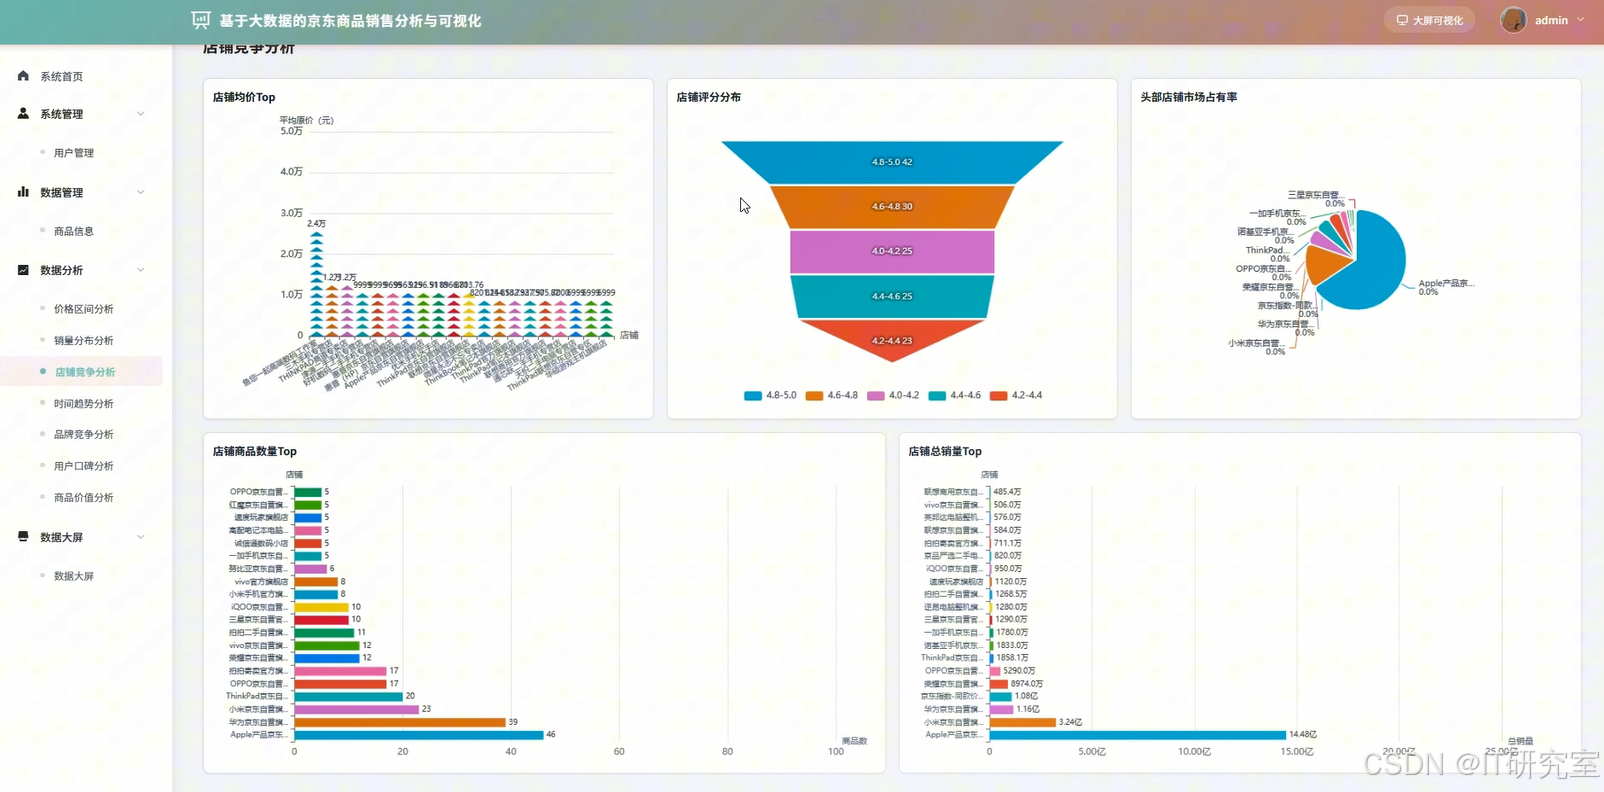
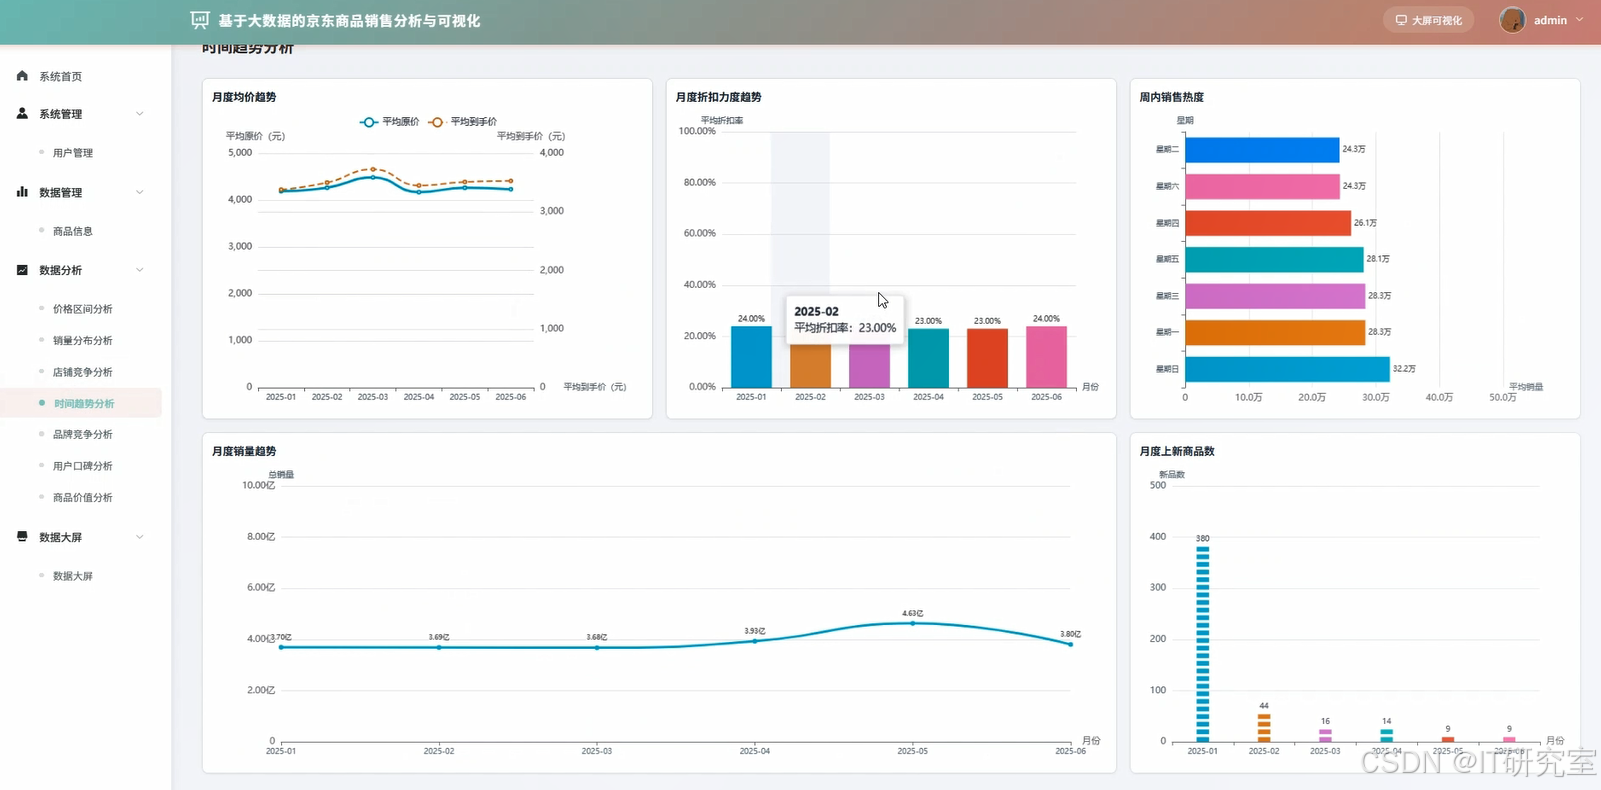
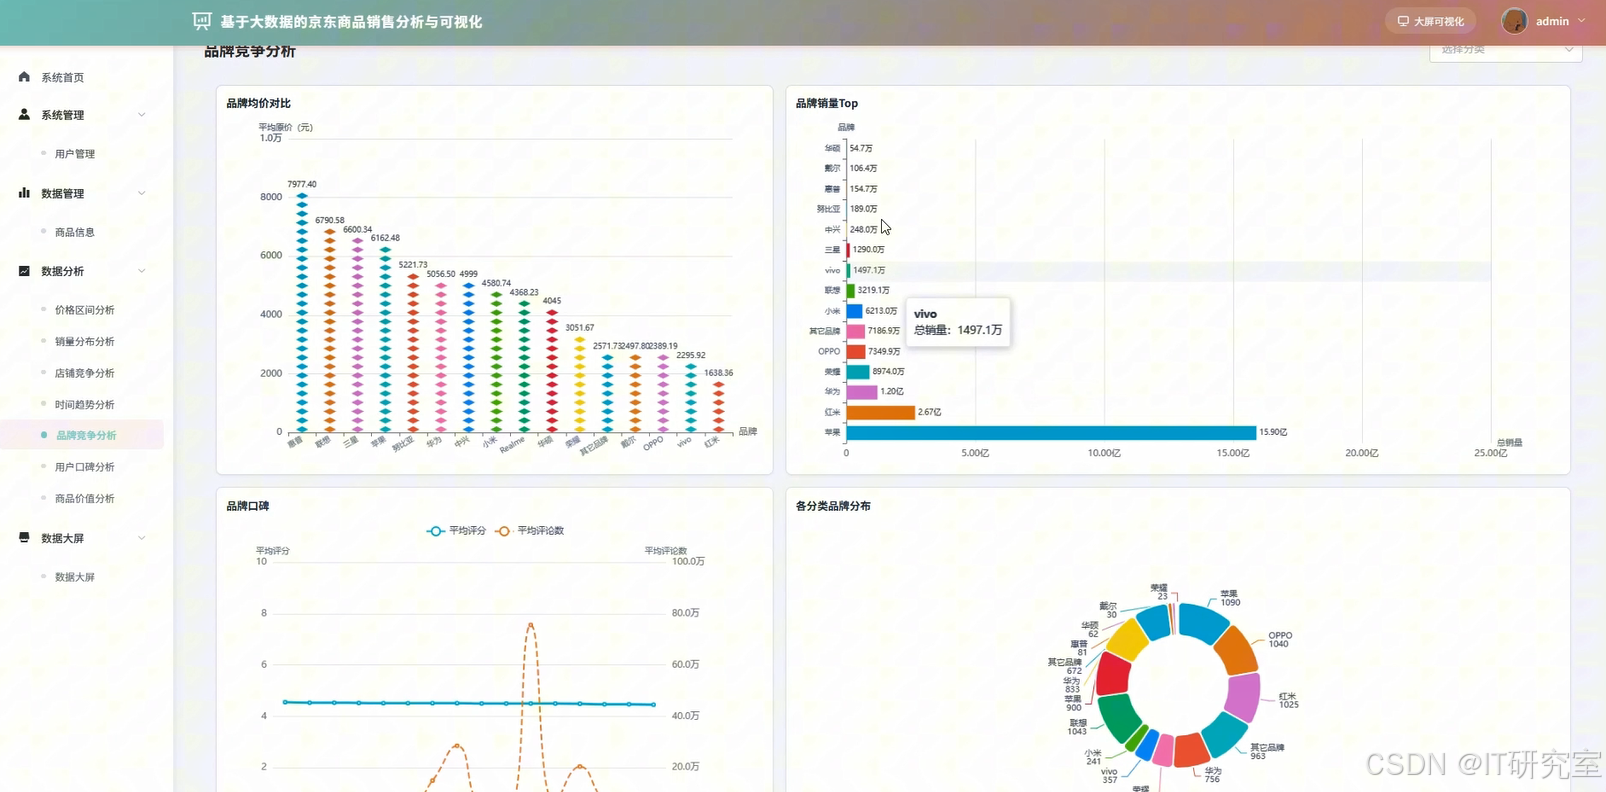
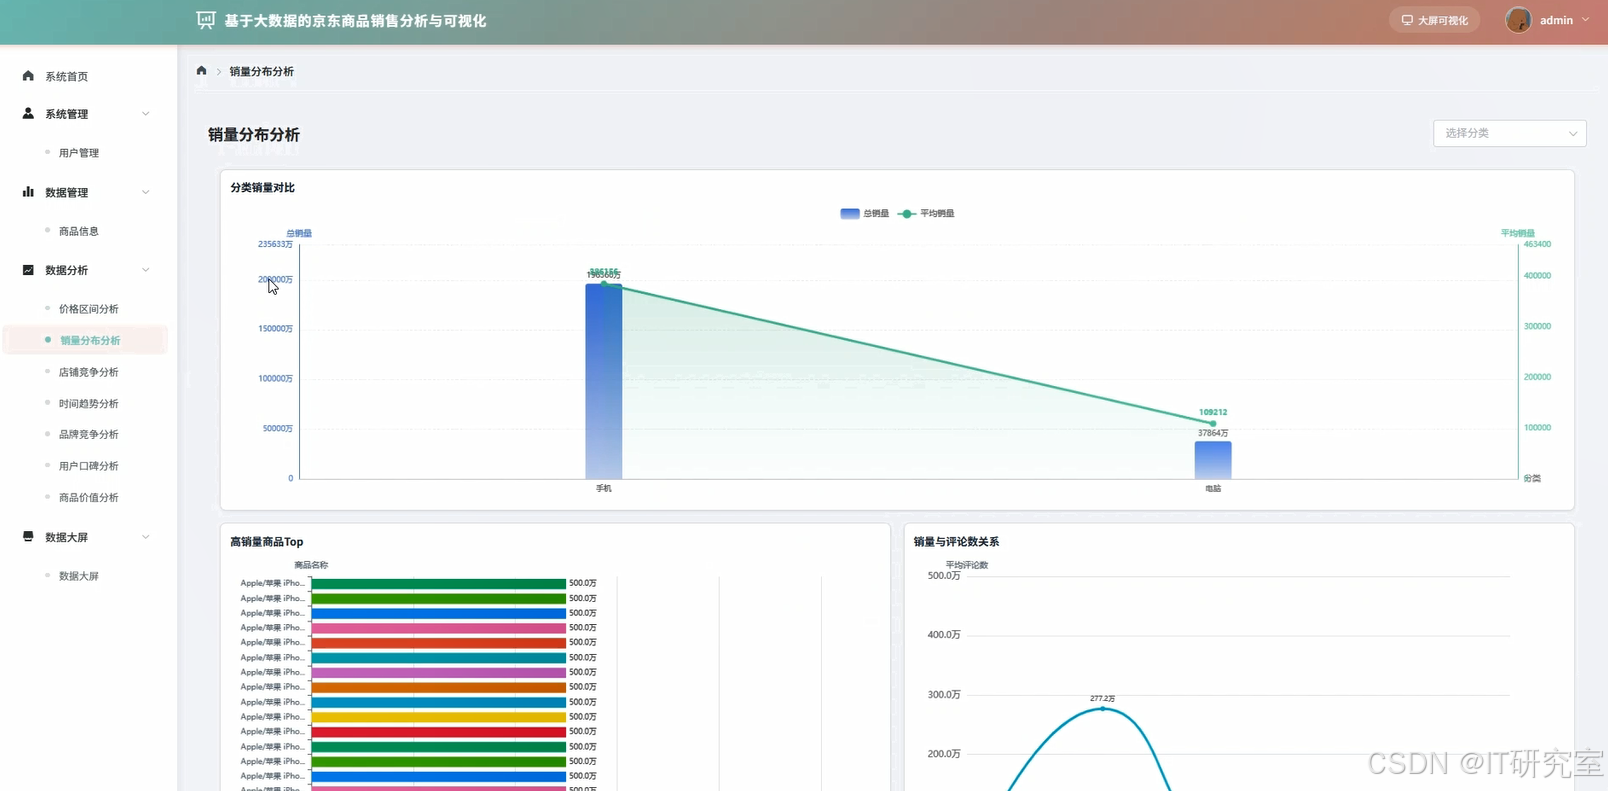
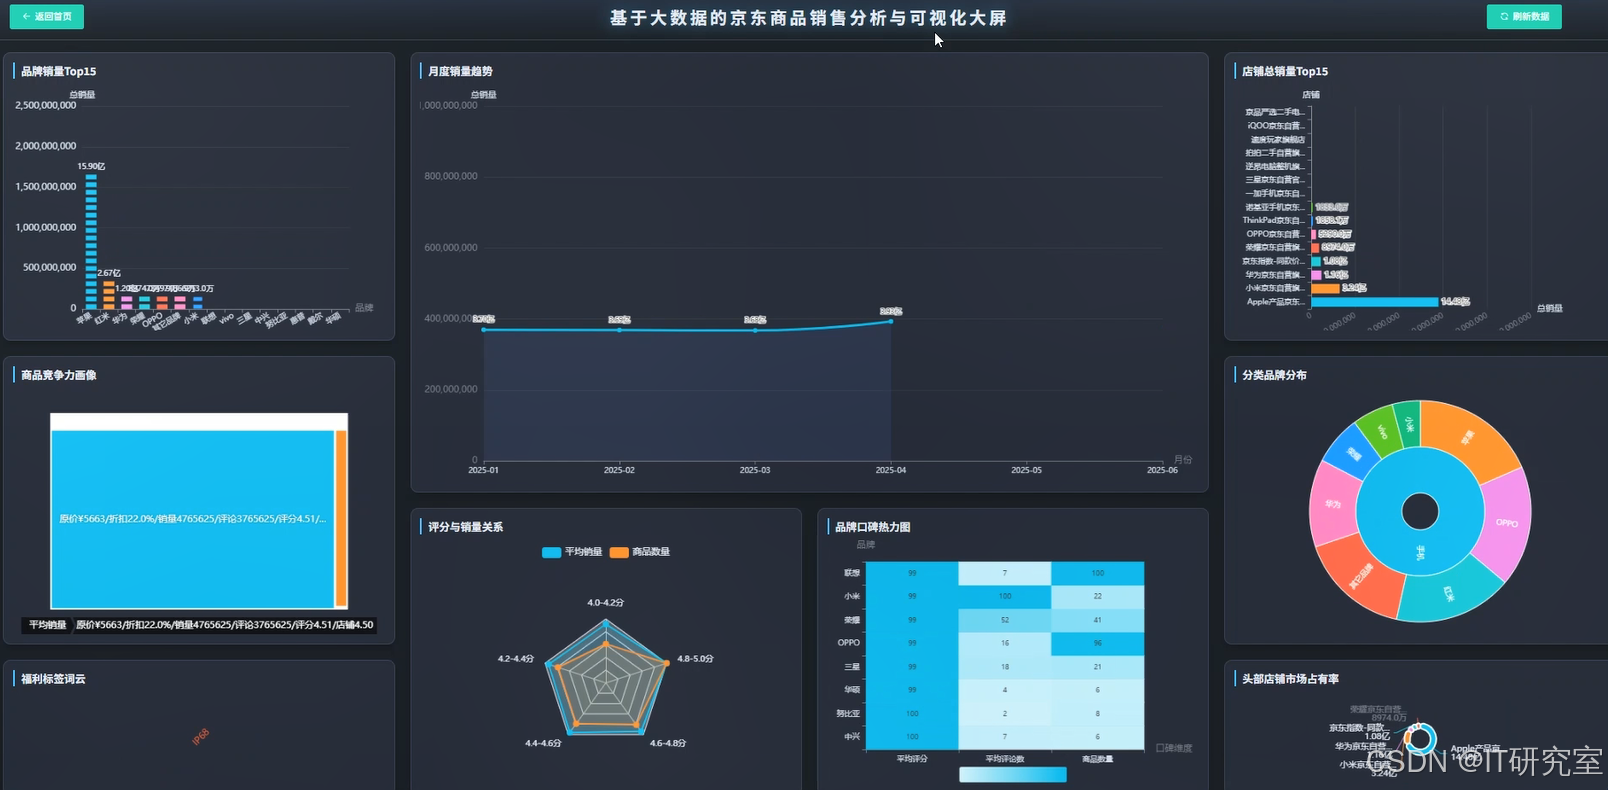
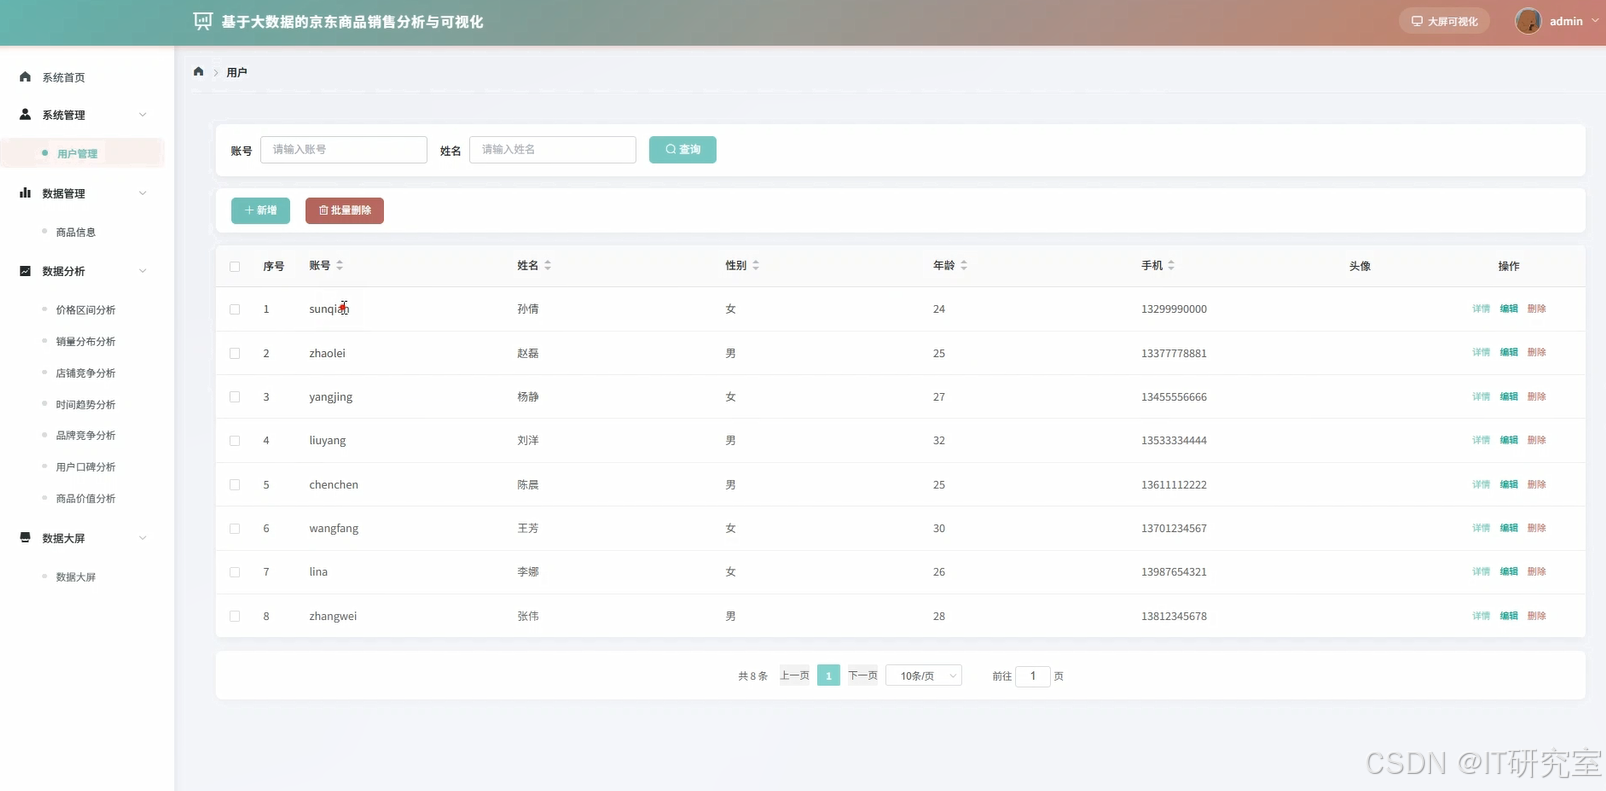
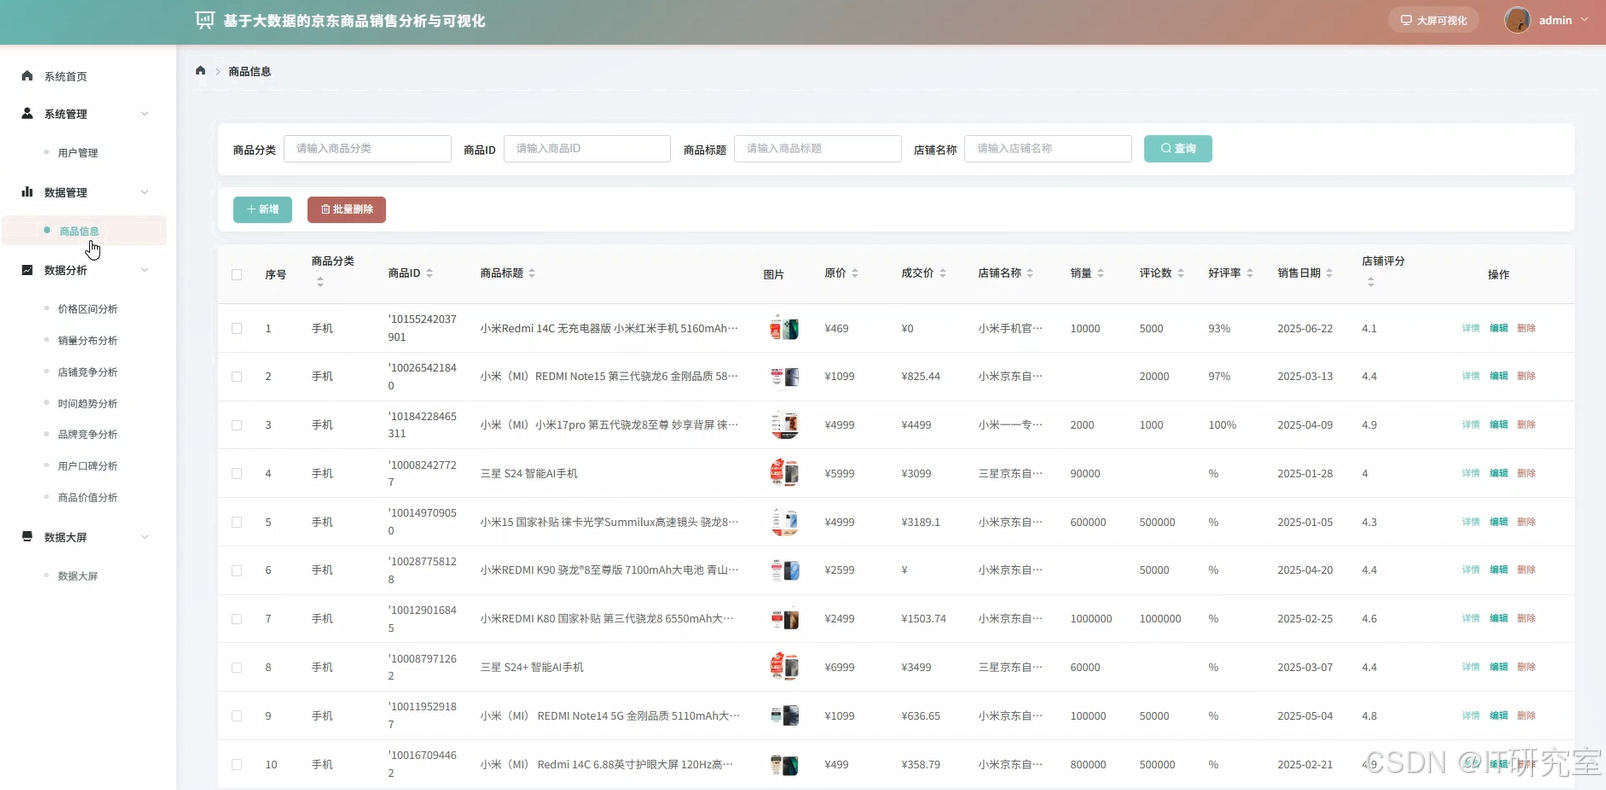
本系统"基于大数据的京东商品销售分析与可视化"是一个运用Hadoop分布式文件系统(HDFS)进行原始数据存储,并利用Spark计算引擎进行内存级数据处理的大数据毕设项目。系统后端采用Python语言及Django框架构建,前端运用Vue.js结合ECharts图表库搭建交互式可视化界面。在功能层面,系统不仅涵盖了商品信息、用户等基础数据的管理,更核心的是实现了对京东商品销售数据的多维度深度分析,具体包括价格区间分布、销量地域与品类分布、店铺竞争格局、销售时间趋势、品牌市场占比以及基于评论的用户口碑分析。系统通过Spark SQL对海量历史数据进行高效聚合与统计,将分析结果存储于MySQL数据库,最终在数据大屏上以丰富的图表形式综合展示,旨在帮助用户(如电商运营者或研究者)直观洞察商品销售背后的商业规律。
选题背景
随着电商平台的蓬勃发展,商品销售数据呈现出指数级增长态势,这些数据背后潜藏着巨大的商业价值。然而,面对海量、多源且结构不一的销售记录,传统的数据处理工具如Excel在数据清洗、聚合分析方面显得力不从心,难以支撑深度的商业洞察。当前,如何借助大数据技术高效处理和分析这些数据,已成为一个备受关注的方向。Hadoop生态中的HDFS提供了可靠的分布式存储能力,而Spark则凭借其基于内存的快速计算模型,尤其适合处理复杂的迭代式分析任务。本课题正是基于这样的技术背景,选取京东平台商品销售数据作为分析对象,探索运用Spark进行数据预处理、多维指标计算以及趋势挖掘的具体方法,并将分析结果通过可视化手段清晰呈现,以响应电商领域对实时、准确数据决策支持的实际需求。
选题意义
从实际应用价值来看,本课题所构建的系统能够为中小型电商卖家或数据分析爱好者提供一个低门槛、开箱即用的销售分析工具。通过价格区间分析,卖家可以快速定位自身产品在市场的价格层级,辅助定价策略;通过销量分布与时间趋势分析,能够精准把握不同品类商品的销售旺季与地域偏好,优化库存与营销节奏;店铺与品牌竞争分析则有助于识别头部竞品,评估自身市场份额。从学习与技术实践角度来看,本课题完整覆盖了从数据采集、清洗、计算到前端展示的大数据项目全流程,对于掌握Hadoop+Spark这一主流技术栈具有切实的锻炼价值。同时,系统采用了前后端分离的开发模式,模块划分清晰,也有利于后续功能的扩展与维护。当然,受限于个人能力与实验环境,系统在实时数据处理和算法模型方面尚显稚嫩,但仍不失为一个具有完整业务闭环的实践参考。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
- 基于大数据的京东商品销售分析与可视化的设计与实现界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, when, count, sum as _sum, avg, floor, year, month, dayofmonth, date_format
import pandas as pd

spark = SparkSession.builder.appName("JDProductAnalysis").config("spark.some.config.option", "some-value").getOrCreate()
df = spark.read.option("header", True).option("inferSchema", True).csv("hdfs://path/to/jd_sales_data.csv")
df_clean = df.filter(col("price").isNotNull() & col("sales_volume").isNotNull() & col("comment_count").isNotNull())
df_price = df_clean.withColumn("price_range", when(col("price") < 50, "0-50").when((col("price") >= 50) & (col("price") < 100), "50-100").when((col("price") >= 100) & (col("price") < 200), "100-200").when((col("price") >= 200) & (col("price") < 500), "200-500").otherwise("500以上"))
price_range_analysis = df_price.groupBy("price_range").agg(count("*").alias("product_count"), avg("sales_volume").alias("avg_sales"), avg("comment_count").alias("avg_comments"))
price_result_pd = price_range_analysis.toPandas()
price_json = price_result_pd.to_json(orient="records")
import json
price_list = json.loads(price_json)
for item in price_list:
    print(f"价格区间: {item['price_range']}, 商品数: {item['product_count']}, 平均销量: {item['avg_sales']:.2f}, 平均评论: {item['avg_comments']:.2f}")
df_sales_dist = df_clean.withColumn("sales_level", when(col("sales_volume") < 100, "低销量").when((col("sales_volume") >= 100) & (col("sales_volume") < 500), "中等销量").when((col("sales_volume") >= 500) & (col("sales_volume") < 1000), "高销量").otherwise("爆款"))
sales_distribution = df_sales_dist.groupBy("category", "sales_level").agg(count("*").alias("product_count"), _sum("sales_volume").alias("total_sales"))
sales_dist_pd = sales_distribution.toPandas()
sales_dist_json = sales_dist_pd.to_json(orient="records")
sales_list = json.loads(sales_dist_json)
for item in sales_list:
    print(f"品类: {item['category']}, 销量等级: {item['sales_level']}, 商品数: {item['product_count']}, 总销量: {item['total_sales']}")
df_time = df_clean.withColumn("sale_date", col("sale_date").cast("date"))
df_time_trend = df_time.groupBy("sale_date").agg(_sum("sales_volume").alias("daily_total_sales"), avg("price").alias("daily_avg_price"), count("*").alias("daily_order_count"))
df_time_trend = df_time_trend.withColumn("year", year("sale_date")).withColumn("month", month("sale_date")).withColumn("day", dayofmonth("sale_date"))
time_trend_pd = df_time_trend.orderBy("sale_date").toPandas()
time_trend_json = time_trend_pd.to_json(orient="records")
time_list = json.loads(time_trend_json)
for item in time_list[-10:]:
    print(f"日期: {item['sale_date']}, 日总销量: {item['daily_total_sales']}, 日平均价: {item['daily_avg_price']:.2f}, 日订单数: {item['daily_order_count']}")
spark.stop()
五、系统视频
基于大数据的京东商品销售分析与可视化的设计与实现项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的京东商品销售分析与可视化的设计与实现-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇