环境:Redis 7 单体(无持久化)、Lettuce Pipeline(c=16, batch=100)、10 万 key 空间、每轮 5s 预热 + 10s 采样。文中吞吐绝对值受客户端影响,请关注相对差距,全部数据来自我自己的压测工程,文末附复现方式。
〇、一分钟带走版
赶时间的话,结论在这里;想知道数据是怎么跑出来的,往下看。
String 有 int/embstr/raw 三种编码:整数走 int,≤44B 走 embstr(一次 malloc,连续内存),更大走 raw(两次 malloc)。我实测过:embstr 比 raw 的 SET 快 25%、GET 快 14%,差距来自 malloc 次数和 cache 命中率;INCR 最快,53 万 ops/s,因为零分配纯算术。最容易踩的坑是 APPEND:embstr 和 int 都是"只读"起点,每次追加触发跨编码重分配,max 延迟实测比 raw 预分配高 7.3 倍(287ms vs 39ms),所以增量构建大字符串要先 SET 铺底容量再追加。
一、从一个"玄学抖动"说起
先说场景。我们有个接口要往 Redis 里写聚合结果,早期实现图省事,直接对同一个 key 反复 APPEND 拼接 JSON 片段。平时延迟 3~4ms,稳得很,但每隔一阵子就出现一个 200ms+ 的长尾请求。
排查了一圈网络、GC、连接池,都没问题。最后发现根因藏在 Redis 的一个"面试八股"知识点里------String 的三种内部编码。
int、embstr、raw,这三个词你大概率背过:
| 编码 | 触发条件 | 内存布局 |
|---|---|---|
| int | value 是 64 位整数 | 直接内联在 RedisObject 的 long 字段里 |
| embstr | 字符串 ≤ 44 字节 | RedisObject + sds 头 + 数据,1 次 malloc 连续分配 |
| raw | 字符串 > 44 字节 | RedisObject 和 sds 2 次 malloc 分开分配 |
注:44 是 Redis 7.x / 64 位平台下的常见阈值(
OBJ_ENCODING_EMBSTR_SIZE_LIMIT,由 RedisObject + sdshdr 的对齐余量算出),换版本或 32 位平台数值会变。生产上别背数字,用OBJECT ENCODING key在目标环境实测确认 。
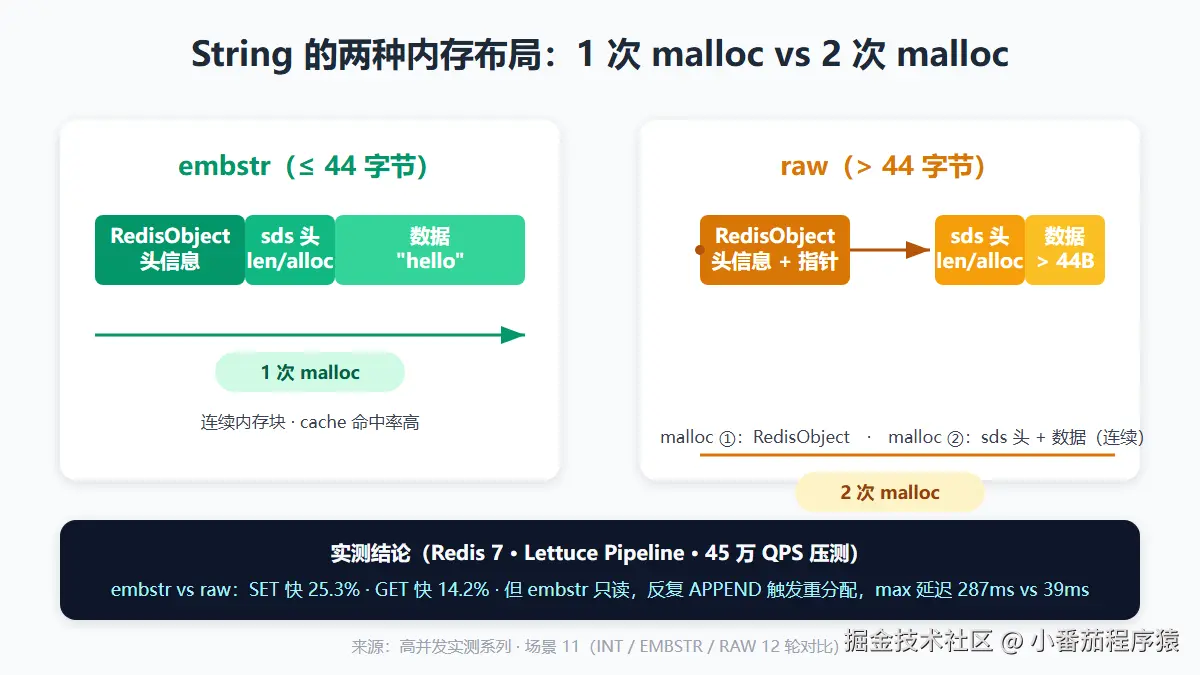
这个布局差异带来的真实性能差距,见第三节实测数据。
背到"44 这个阈值"就算掌握了?我原本也这么以为。直到我把这三种编码拉到十几万 QPS 的压测下逐个对比,才发现:面试题只考了这套机制 10% 的真相,剩下 90% 藏在延迟长尾里。
于是我搭了一个压测工程,用 OBJECT ENCODING 逐轮验证编码切换,一共跑了 12 轮对比实验。下面直接上数据和结论。
二、实验怎么做的
为了保证对比公平,压测分两步走:
第一步:预加载,"凑"出三种编码。 Redis 的编码是自动选择的,没法手动指定,所以先用 Pipeline 预灌 4 组各 10 万个 key:
intKeys→SET纯整数 → int 编码embstrKeys→SET40B 字符串 → embstr 编码rawKeys→SET200B 字符串 → raw 编码modKeys→SET整数,留给后面APPEND触发 int→raw 转换
第二步:逐轮压测 + 编码验证。 每轮 5s 预热 + 10s 采样,采集 ops/s、avg/p50/p90/p99/max 延迟和 slowlog 增量,并且每轮用 OBJECT ENCODING 回查编码,确认没有"测错对象":
sql
[编码验证] int=int, embstr=embstr, raw=raw
[编码验证] mod(int)=int(APPEND 后应变 raw)
12 轮分三组:基础对比(SET/GET × 三种编码 + INCR)、大 value 衰减(200B vs 1KB)、APPEND 专项(raw 预分配 vs embstr 重分配)。先看第一组。
三、第一组数据:基础对比,embstr 确实能打
| 操作 | 编码 | ops/s | avg | p99 | max | slowlogΔ |
|---|---|---|---|---|---|---|
| SET 整数 | int | 415,544 | 3.86ms | 11.94ms | 32.39ms | 4 |
| SET 40B | embstr | 448,159 | 3.58ms | 9.15ms | 33.72ms | 5 |
| SET 200B | raw | 357,566 | 4.49ms | 12.01ms | 32.91ms | 4 |
| GET 整数 | int | 429,694 | 3.73ms | 11.26ms | 31.12ms | 6 |
| GET 40B | embstr | 457,400 | 3.52ms | 10.93ms | 48.00ms | 2 |
| GET 200B | raw | 400,466 | 4.01ms | 10.01ms | 27.48ms | 3 |
| INCR | int | 532,654 | 3.02ms | 7.85ms | 29.02ms | 4 |
三个结论:
1. embstr 比 raw 快,SET +25.3%,GET +14.2%。 根因是教科书级的:embstr 一次 malloc 分配出连续内存,raw 要分两次。SET 的差距(25%)比 GET(14%)更大,因为写入路径要多付一次 malloc + memcpy,分配器的开销在写入时被放大;读取两边都是 O(1) 查 dict 返回指针,差距只剩 cache 命中率的贡献。
2. INCR 是 Redis String 的最快路径:53 万 ops/s,p99 只有 7.85ms。 int 编码下 value 就是 RedisObject 里的一个 long,INCR 只做一次整数加法------零 malloc、零 memcpy、零 sds 操作。主线程纯算术,没有比这更便宜的了。
3. 一个容易忽略的点:能不能进 int 编码,取决于值本身,不是引号。 Redis 在协议层收到的是字节串,SET k 0 和 SET k "0" 是同一个值,都会走 int。真正的分界是这个字节串能否被 string2ll 解析成 64 位整数 :SET k 100 是 int,但 SET k "100 "(带空格)、SET k 1.5、SET k 99999999999999999999(超出 64 位)都会退化成 embstr/raw。所以计数器场景别用浮点、别带空格、别存超长数字------一旦退化成字符串编码,INCR 的零分配优势就没了。
到这里为止,数据和八股文说的差不多。真正有意思的是后面两组。
四、第二组:value 变大,raw 吞吐线性下跌
raw 编码的 SET/GET 在第一组里垫底,但只测了 200B。真实业务里 raw 通常装的是 JSON、HTML 片段这种大块头,于是我加了 1KB 的对照组:
| 操作 | value | ops/s | avg | p99 | 相比 200B |
|---|---|---|---|---|---|
| SET raw | 200B | 357,566 | 4.49ms | 12.01ms | 基线 |
| SET raw | 1KB | 218,997 | 7.32ms | 15.50ms | -38.8% |
| GET raw | 200B | 400,466 | 4.01ms | 10.01ms | 基线 |
| GET raw | 1KB | 289,606 | 5.56ms | 13.20ms | -27.7% |
value 从 200B 涨到 1KB(5 倍),吞吐掉了约三分之一。根因是 memcpy 的数据量线性增长,而 Redis 主线程是单线程------你每多拷 800 字节,全实例的每一个请求都在陪你等。SET 掉得比 GET 更狠(-38.8% vs -27.7%),因为写入路径是"分配 + 拷贝"两次搬运。
这也解释了 slowlog 的来源:大 value 的操作在主线程耗时更长,更容易踩进 slowlog 阈值。几百 KB 以上的 value 建议压缩或拆分,不是一句"Redis 内存便宜"就能随便塞的。
五、最有价值的发现:平均值骗了你,APPEND 的 max 差了 7.3 倍
回到开头那个"玄学抖动"。我专门设计了 APPEND 专项对比:
- APPEND_RAW :先
SET一个足够大的初始值(raw,触发 sds 预分配),再反复APPEND小块 - APPEND_EMBSTR :value 从 embstr 起步(≤44B),直接反复
APPEND
结果非常有戏剧性------平均吞吐几乎一样,max 延迟差了 7.3 倍:
| 操作 | 编码 | ops/s | avg | p99 | max |
|---|---|---|---|---|---|
| APPEND_RAW | raw 预分配 | 410,066 | 3.92ms | 11.22ms | 39.31ms |
| APPEND_EMBSTR | embstr→raw | 409,705 | 3.93ms | 9.71ms | 286.79ms |
只看 avg 和 p99,你会得出"两种写法没区别"的结论。但 max 一列暴露了真相:embstr 起步的 APPEND 会随机抖出 287ms 的毛刺------正是开头那个线上抖动的元凶。
根因在编码的"可变性"上:
- raw 的 sds 有预分配机制 (
sdsMakeRoomFor):空间不足时按几何倍增扩容(1MB 以内近似翻倍,超过SDS_MAX_PREALLOC后改为固定步长线性增长,避免大 value 浪费内存),所以只要当前容量够用,后续APPEND就是 O(1) 原地追加,整体摊销下来是 O(1); - embstr 是只读编码 (Redis 源码
t_string.c里就是这么定义的):它的 sds 是一次性连续分配的,alloc等于len,没有为增长预留任何 spare 空间 。所以每次APPEND都必须新建 sds、把旧值全量拷过去、再释放旧内存------每次都是 O(N) 的重分配。
而且这是跨编码的坑 :int 起步也一样。APPEND 一个 int 编码的 key,会先转 raw 再操作,实测确认 encodingAfter = raw。也就是说,只要起点不是"已预分配的 raw",反复 APPEND 就是反复全量重分配,延迟长尾完全不可控。
这个知识点,面试题不考,文档只有一句"embstr is read-only",但生产上它就是 200ms 的毛刺。
六、生产建议:一张速查表 + 四条原则
| 你要存的数据 | 该有的样子 | 实测依据 |
|---|---|---|
| 计数器 / 自增(浏览量、库存、频控) | 纯整数 value,走 int | 532K ops/s,p99 最低,零分配 |
| 短状态 / Token / 短配置(≤44B) | 不用管,自动 embstr | SET +25%,GET +14% |
| JSON / 长文本(>44B) | 只能 raw,控制大小 | 1KB 比 200B 吞吐 -39% |
| 增量拼接构建大字符串 | 先 SET 初始 raw,再 APPEND | 摊销 O(1),max 39ms |
| 对 int / embstr 反复 APPEND | ❌ 避开 | max 延迟 287ms,长尾爆炸 |
四条原则:
- 能用整数就别用字符串 :确保写入的是干净的十进制整数(无空格、无小数点、不超 64 位),计数场景优先直接
INCR/DECR,一步进入最快路径; - 短文本不用优化:Redis 自动帮你选了 embstr,这是机制内建的福利;
- 要拼接,先铺底 :先
SET一个预估大小的初始值把 sds 容量撑起来,后续 APPEND 全走预分配,全程 O(1); - 盯 max,别只盯 avg:这次 287ms 的坑,p99 上完全看不出来。Redis 是单线程,一个请求的长尾就是全实例的长尾。
七、写在最后
这只是编码压测系列的第一篇。同一套方法,我还实测了另外三组"教科书没写全"的结论:
- Hash :field ≤64 时 listpack 的 HGET 比 hashtable 快 20+ 倍;但 field 逼近 128 时 hashtable 反超 21%------"保住 listpack"是个流行已久的伪优化;
- Set :hashtable 编码下
SMEMBERS慢 30 倍,是所有对比里差距最大的操作; - ZSet:高并发 ZADD 下 skiplist 反而比 listpack 快 11%。
如果这篇对你有用,欢迎点赞收藏,系列后续会陆续整理出来。
复现说明 :Redis 7 单体(Docker,appendonly no),Java + Lettuce Pipeline,c=16、batch=100、10 万 key,每轮 5s 预热 + 10s 采样,每轮 OBJECT ENCODING 验证编码。压测工程后续会整理开源。
已知局限(先替你问了) :
- 数据为单轮采样,max 是本次观测到的单次极值,受系统噪声影响,绝对值请当作量级参考(多轮复测与 p99.9 分位会在后续版本补上);
- 未记录内存分配器(jemalloc / libc)与 lazyfree 配置,这两者会影响 malloc 与释放相关操作的绝对耗时;
- 单机 + Pipeline 客户端,客户端打包/序列化会压低吞吐上限,所以请看相对差距,别拿绝对 QPS 和 redis-benchmark 的结果对比;
- 不同硬件、Redis 版本、value 尺寸下阈值与衰减幅度会有出入,欢迎评论区贴出你的实测结果。
技术这一行不缺声音,缺的是把一个问题压到见底的耐心。与其多讲一句结论,不如多跑一轮实验------八股可以被背,结论只能被跑出来。接下来我只想做一件事:把那些被背下来的东西,一个一个亲手验证到底。
如果你也相信跑出来的数据比说出来的道理更可靠,欢迎同行。所有结论都欢迎来抬杠,带上你的数据。路远,我们慢慢挖。