同样一段降噪、同样一次格式转换,你可以在浏览器里点两下,也可以打开 Audition 拖一个效果器,还可以写一行 FFmpeg 命令,甚至自己跑一个模型推理。四条路径都能到终点,但成本、精度、可复现性完全不同。选错了不是结果不对,而是花了三倍的力气拿到一个差不多的结果。
这篇文章按任务类型把四条路径拆开,给出每条路径的适用边界和切换临界点。
四条路径的能力画像
先建立基本认知:四类方案不是互相替代的关系,而是各有甜区。
网页工具零安装零配置,打开浏览器就能用。代价是文件大小有限制、依赖网络、批量能力弱、参数空间有限。
GUI 软件(Audition、iZotope RX、GoldWave)提供最丰富的参数控制和实时预览能力。你能看到频谱、拖动力度曲线、逐帧微调。代价是:学习曲线陡、授权费用高(RX 标准版 $399)、无法批量自动化、换台电脑配置就没了。
命令行工具(FFmpeg、SoX)是批量处理的王者。一行命令处理一千个文件,参数写死在脚本里,跑一百次结果一模一样。代价是:没有实时预览,调参靠盲猜,需要一定的命令行基础。
自建模型推理(本地跑 Demucs、RNNoise、自训练模型)提供最高的灵活度------你可以用自己的数据微调,可以完全离线运行,可以嵌入自己的产品管线。代价是:需要 GPU、需要 ML 工程能力、维护成本最高。
按任务类型分流:确定性变换 vs 需要模型推断
这是选路径的第一刀:这个任务是确定性的,还是需要模型推断的?
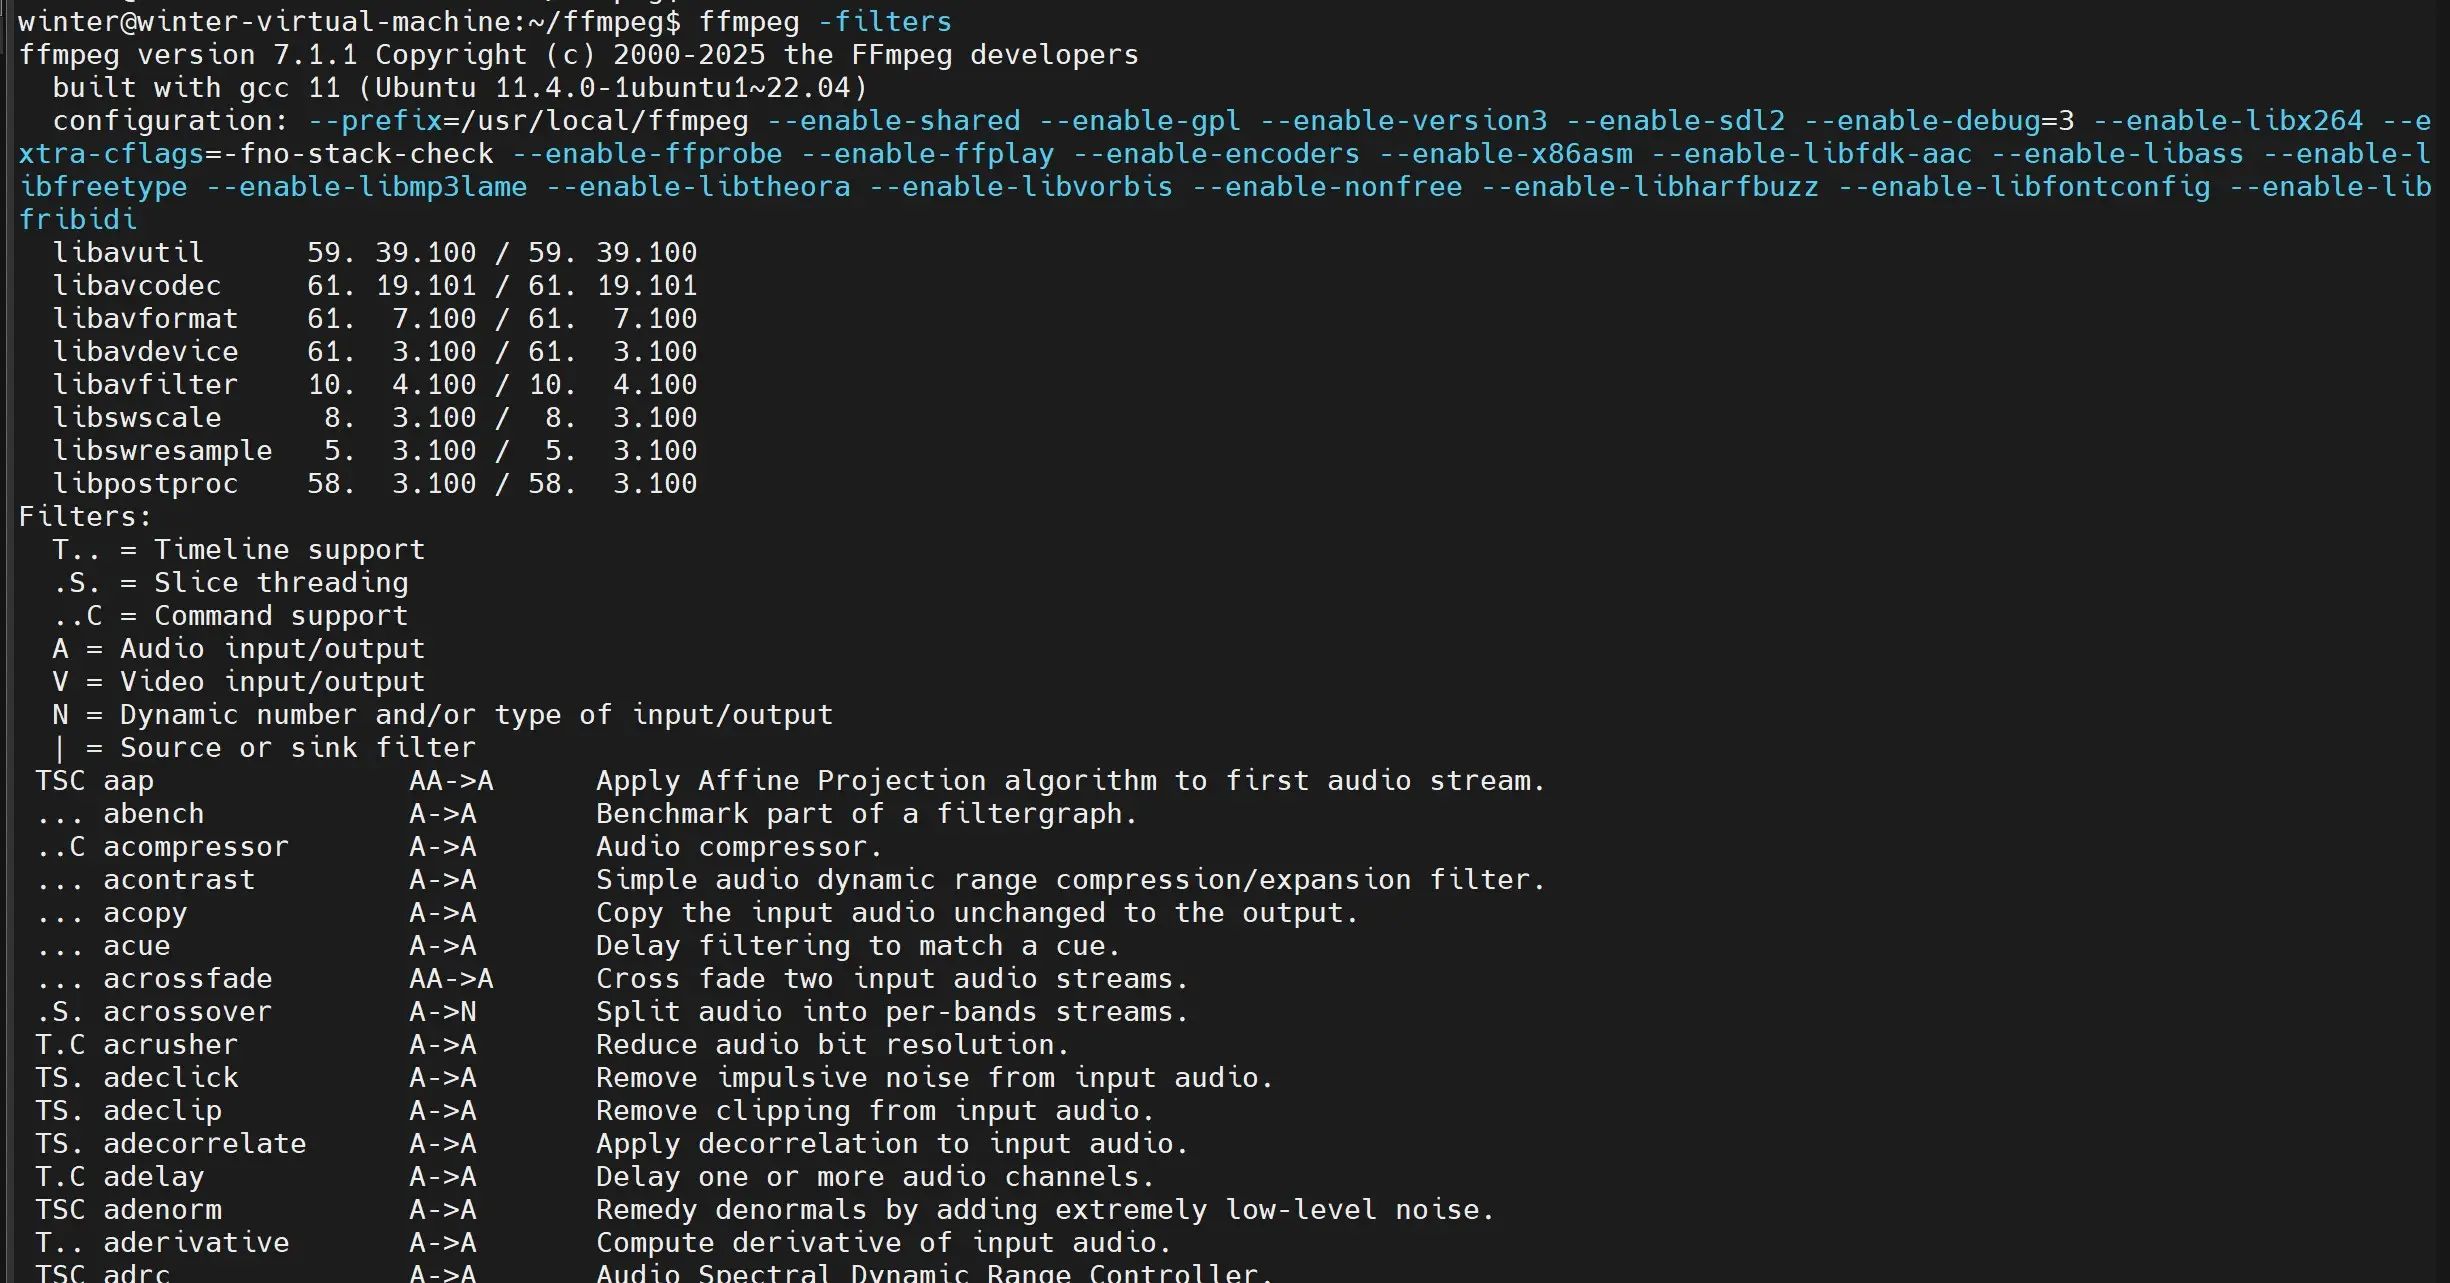
确定性变换------格式转换、采样率变换、声道混合、裁剪拼接、音量调整------这类任务的输出完全由输入和参数决定,不存在"效果好不好"的问题,只存在"参数对不对"的问题。这类任务命令行是最优解:
批量把 WAV 转 320k MP3,保持原始采样率
for f in *.wav; do
ffmpeg -i "f" -codec:a libmp3lame -b:a 320k -ar 44100 "{f%.wav}.mp3"
跑一百个文件和跑一个文件的成本一样------写一次命令,循环执行。同样的任务在 GUI 软件里你得开一百次文件、点一百次导出。
需要模型推断的任务------人声分离、降噪、音源分离、语音增强------这类任务的输出质量取决于模型的训练数据和架构。这时候网页工具或本地模型推理是更好的选择,因为模型已经封装好了,你不需要理解 FFT 窗长该设多少。
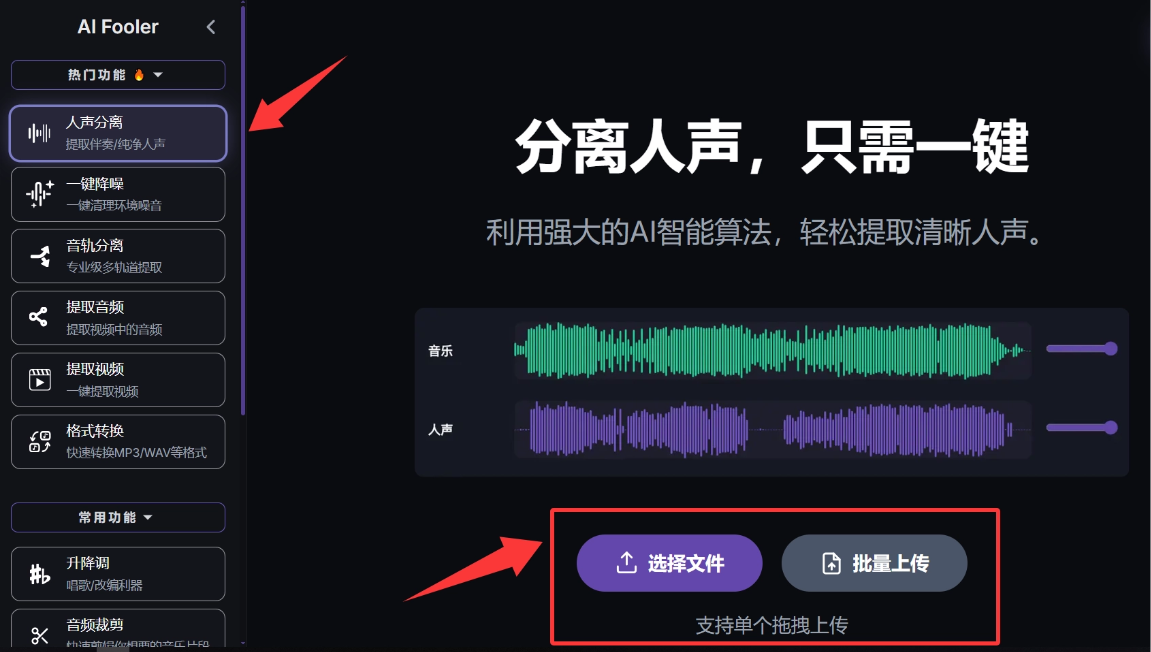
以人声分离为例,aifooler在线网站背后是训练好的深度网络,你上传音频,它返回分离结果。
如果自己用 FFmpeg 做,你需要手动设计滤波器------中置声道提取、相位反转、频谱减法------效果远不如模型,且调参时间以小时计。
批量规模与单次时长的临界点
第二刀是量。
单次处理、文件小于 200MB、不需要精细调参------网页工具完胜。上传、等待、下载,三步搞定。
批量处理(10 个以上文件)、单文件超过 500MB、需要统一参数------命令行是不二之选。FFmpeg 处理一个 1GB 文件和处理一百个 10MB 文件的总时间差不多,瓶颈在 I/O 而不是启动开销。
批量处理 + 需要模型推断 + 数据不能出内网------这时候才轮到自建模型推理。用 Python 脚本批量调 Demucs,一次跑几百个文件,全程离线。
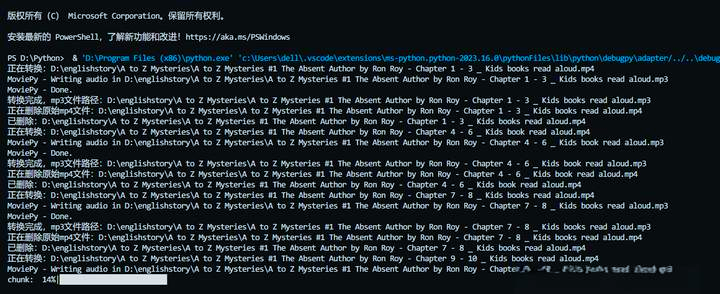
有一个经验临界点:单次任务用网页工具,超过 5 个文件就该考虑写脚本了。 因为网页工具每个文件都要手动上传、等待、下载,5 个文件就是 15 次手动操作,而脚本只需要写一次。
可复现性:命令行参数可版本化,GUI 不行
第三刀是可复现性------你能不能在三个月后重新跑出一样的结果?
命令行天然可复现:参数写在脚本里,脚本可以进 Git,三年后 `git log` 就能看到当时用的什么参数。
GUI 软件做不到这一点。你在 Audition 里拖了一个 EQ 曲线,除非你截图或导出预设,否则没有人能复现你的操作。团队协作时这是致命问题------"你当时怎么调的?"是一个无法回答的问题。
网页工具的可复现性取决于平台是否记录参数。大多数在线工具不暴露底层参数,你只知道"点了降噪按钮",不知道它用的是谱减法还是维纳滤波、噪声门限是多少。
自建模型推理的可复现性最强------模型权重、推理代码、预处理参数全部在你手里。但前提是你有良好的工程习惯(Docker 镜像、依赖锁定、随机种子固定)。
精度不是唯一维度,还有隐私与数据出境
最后一刀往往被忽略:你的音频数据能不能离开你的设备?
网页工具需要上传文件到服务器。平台通常承诺限时删除(AIFooler 声明 24 小时后自动删除),但对商业机密或未发布素材,风险可能不可接受。
GUI 软件和命令行工具完全本地运行,数据不出设备。这是最安全的选项。
自建模型推理也可以完全离线,但前提是你有本地 GPU 资源。如果走云 GPU(如 AutoDL、恒源云),数据还是要上传,只是上传到你自己租的机器上。
对于播客创作者、自媒体人,大部分素材不涉及敏感信息,网页工具的便利性远大于隐私风险。但对于企业内部培训录音、法律咨询录音、医疗口述记录,本地处理是硬性要求。
问自己三个问题:这个任务是确定性还是推断性的?我要处理几个文件?数据能不能上传?答案出来后,路径自然就清晰了。