翻出一盒二十年前录的磁带,或者一段从旧录像带转出来的演唱会,你把它丢进分离工具,满心期待能扒出一条干净的伴奏。结果出来的人声发飘、音准像坐过山车,伴奏里糊着一层沙沙的嘶声,高频干脆是一片死寂。换了几次模型,结果都差不多。
先别急着怪模型。这类素材的效果上限,在你按下分离按钮之前就已经被定死了------定死它的不是工具,是几十年前那台录音机,以及磁带、录像带这种介质本身的物理特性。
先破除一个误解:老素材分不好,不是模型的问题
一种常见的想法是:老素材年代久、编码旧,所以得换个"更高级"的模型来救。这个思路从根上就错了。
分离模型做的事情,是在时频平面上判断每一个点属于人声还是伴奏。它能判断得多准,取决于这一格里还剩多少可用的判据。老化素材的问题不在于判据"难判断",而在于判据本身已经不存在了------高频被介质砍掉、音高被机械抖动带跑、噪声把细节盖住。模型面对的不是一道难题,是一张信息已经残缺的图。
换句话说:模型决定你能摸到天花板的百分之多少,而老化介质决定天花板有多低。 换个模型,天花板不会升高。
底层原理:模型吃的是四类线索,老化介质毁掉的正是它们
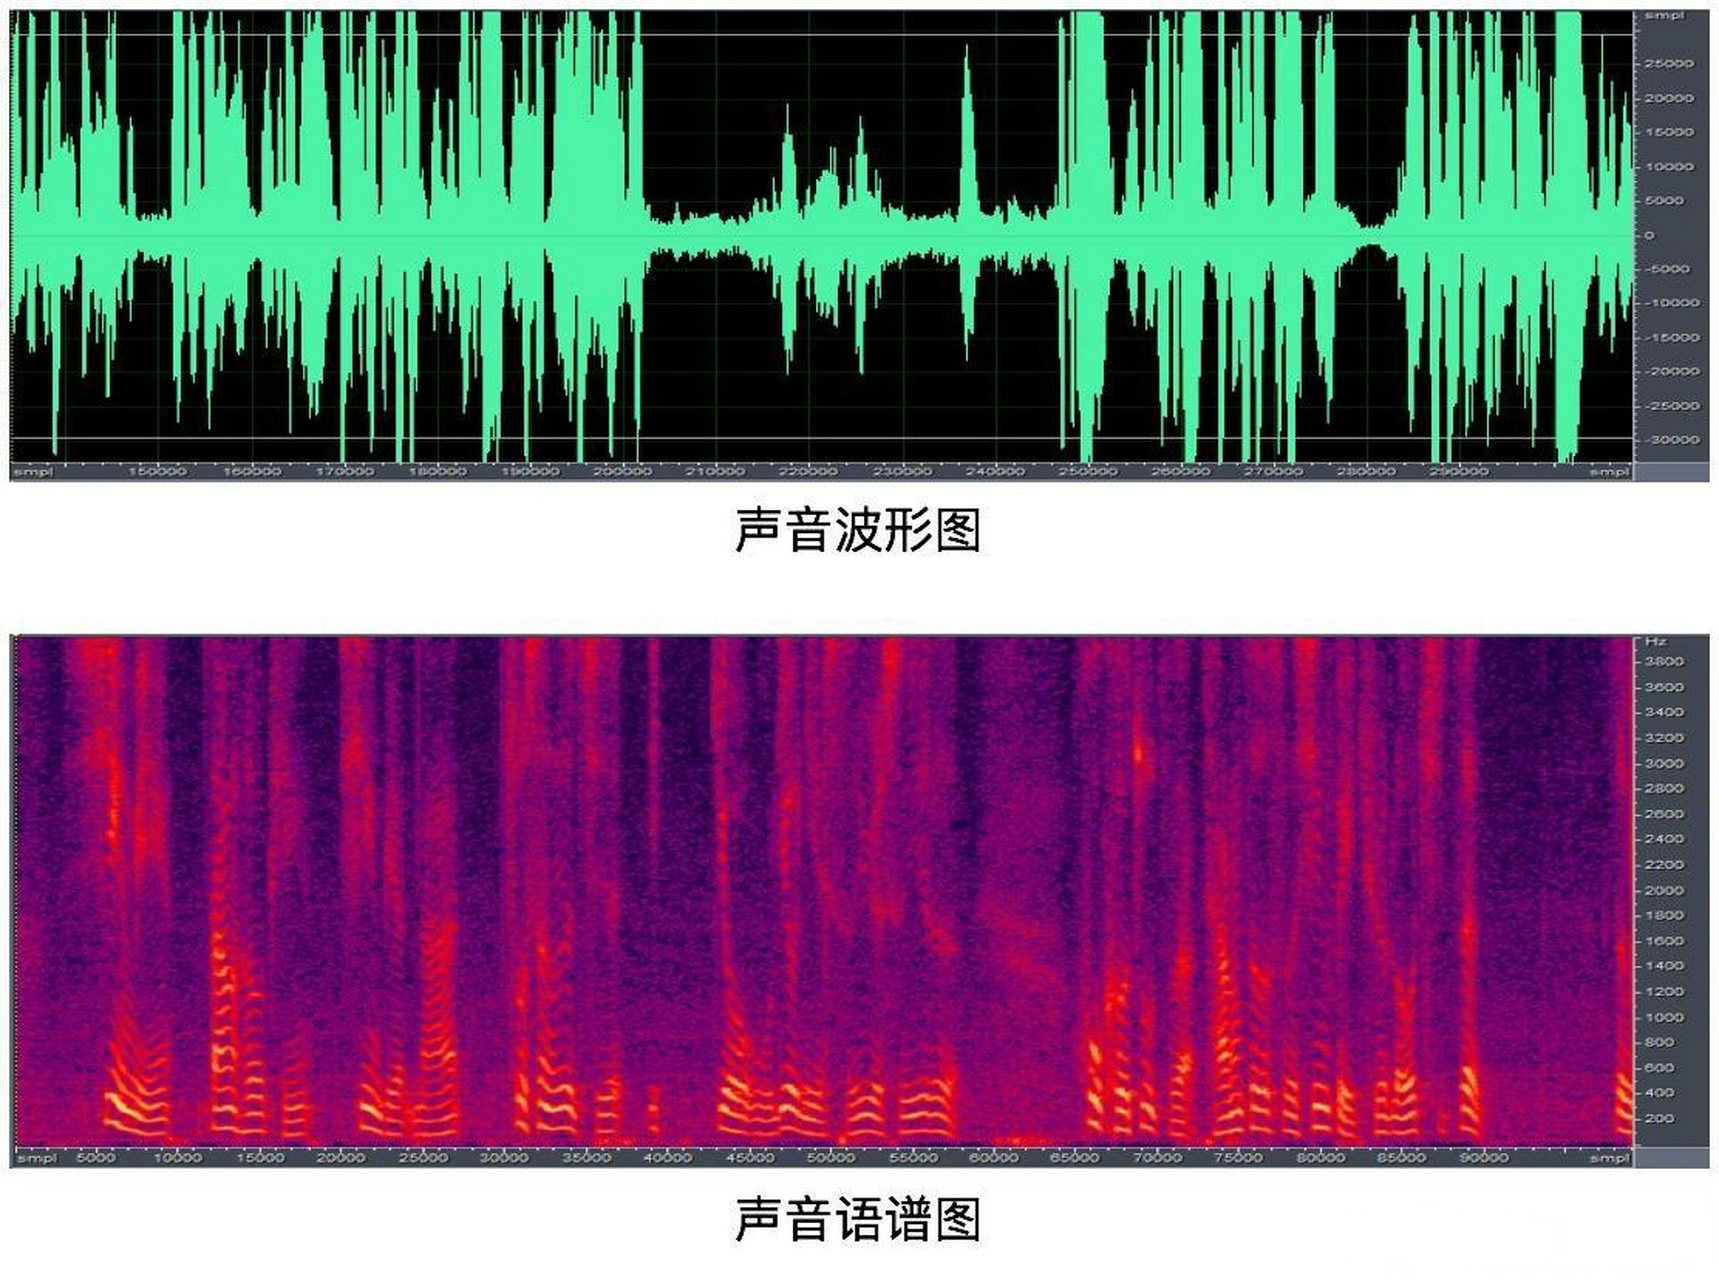
主流分离方案先做 STFT(短时傅里叶变换),把波形转成时频图,模型在这张图上输出掩码(Mask),数值 0 到 1,表示每格能量有多少比例归人声。模型赖以判断的线索主要有四类:
• 谐波结构:人声有清晰的基频与整数倍谐波,在时频图上是一条条平行的亮线
• 频段分布:人声能量集中在几百 Hz 到几 kHz,齿音在 6kHz 以上
• 时间连续性:一句歌词的谐波是连续曲线,噪声是随机散点
• 声道与相位线索:真立体声里人声居中,左右高度相关
历史介质的三种劣化,恰好一一砸在这些线索上。下面三个难点,就是这么来的。
难点一:带宽受限------高频泛音先天就不在
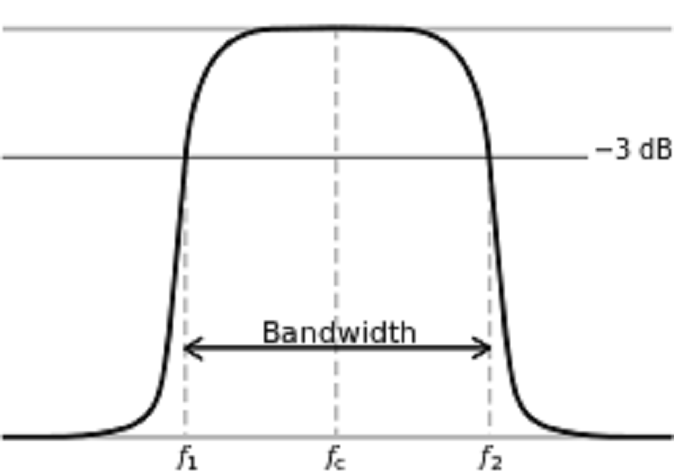
磁带的可用带宽通常在 12 到 15kHz 封顶,普通卡座录音甚至只到 10kHz 上下;老式录像带的伴音轨带宽更窄。这意味着 15kHz 以上的一切------齿音、镲片的空气感、弦乐的泛音------在录制的那一刻就没被写进磁带。
这直接砸掉了模型最锐利的一类判据。区分人声与高频乐器,本来就靠高频区的谐波分布;现在这一整片区域是空的,模型只能在剩下的中低频里硬判。结果就是分离出的人声发闷、伴奏的镲片发木。
更麻烦的是,很多人拿到这种素材后习惯先"拉高频"------用均衡器或激励器把高频抬起来。这属于无中生有:被砍掉的信息不会因为拉高增益而回来,抬起来的是噪声和失真。带宽缺口只能接受,不能修复。
难点二:抖晃失真------音高在飘,模型按稳定音高训练
磁带靠机械传动走带,走带速度不可能绝对恒定。速度的慢变叫抖(wow),快变叫晃(flutter)。效果是:整段录音的音高在持续地、不规则地漂移,幅度可以到几十个音分。
问题出在这里:模型训练时用的素材,音高是稳定的。它学到的谐波模板是"基频为 f 时,谐波落在 2f、3f......"。当输入的音高一直在飘,实际的谐波线是弯的,和模型的模板对不上,掩码就会判断失准------表现为人声在某些字上突然变薄、伴奏里漏出人声片段。
抖晃和普通的"跑调"不一样,它是机械性的、全局的。这也决定了处理顺序:必须先去抖,再分离。 顺序反了,等于拿一张歪掉的地图去找路。
难点三:底噪劣化------嘶声占满高频,掩码边界全糊
磁带底噪是一种典型的宽带噪声,能量主要堆在高频,就是那层熟悉的"嘶------"。老录像带还叠加了走带的机械噪声和电源哼声。
这类噪声对分离的伤害是双重的。其一,它填满了本来就空的高频区,让那一带的时频图变成一片均匀的灰,模型无法判断哪一格该归谁。其二,噪声能量会摊进人声轨------因为模型要满足"输入总能量必须分配给某一轨"的封闭假设,而无处可归的嘶声,往往被摊派到人声上,于是分离出的人声反而更脏。
数字化时还有一个坑:采样率不必追高。源素材带宽只有十几 kHz,采到 44.1kHz 已经绰绰有余,采到 96kHz 只是把噪声也采得更精细,对结果毫无帮助,还白白让文件变大。
能力边界:四件确实做不到的事
第一,补不回被介质砍掉的高频。 那是录制阶段的物理损失,任何后期手段拉起来的都是无中生有的谐波。
第二,分不开抖晃带来的音高漂移。 除非先做去抖处理,否则漂移会一直跟着素材走,模型无法在分离环节把它修正掉。
第三,去不掉已经摊进人声轨的嘶声。 噪声一旦被掩码分配进人声,它就是人声轨的一部分,只能在分离之后对人声轨再做一次轻度降噪。
第四,处理对象是上传的本地文件,不存在贴一个网址在线抓取解析。 老磁带、旧录像这类素材,得先自己完成数字化,得到本地音频文件,才能进入处理流程。
落地方案:先修复,再分离
老化素材的正确顺序是固定的,不能颠倒。
第一步,先解决抖晃。如果素材音高明显不稳,用去抖工具做一次速度校正,让音高回到稳定状态------这一步对应难点二,是后续所有处理的前提。第二步,处理稳态噪声。磁带嘶声、电源哼声都属于频谱形状稳定的噪声,可以先压掉。第三步,才是分离。第四步,分离出人声轨后,如果还残留摊派进来的噪声,再对人声轨做一次轻度降噪。
第二、三、四步里的降噪和分离,处理的是本地上传的音频文件、素材 24 小时后自动删除,不必为了修一段老录音装一整套本地软件。分离这一步用人声提取在线工具就能完成。
最后
老磁带、旧录像能不能分,答案不在模型有多强,而在你愿不愿意接受它的上限。先看清楚素材被毁掉的是哪一类判据,再决定值不值得修、修到哪一步就收手。搞清楚哪一步在丢信息,比反复换模型更省时间。