什么是自定义函数
hive的内置函数满足不了所有的业务需求。hive提供很多的模块可以自定义功能,比如:自定义函数、serde、输入输出格式等。而自定义函数可以分为以下三类:
UDF: user defined function:用户自定义函数,一对一的输入输出 (最常用的)。比如abs()
UDAF: user defined aggregation function:用户自定义聚合函数,多对一的输入输出,比如:count sum max。
UDTF: user defined table-generate function :用户自定义表生产函数 一对多的输入输出,比如:lateral view explode
如何使用自定义函数
将字符串的首字母变大写案例
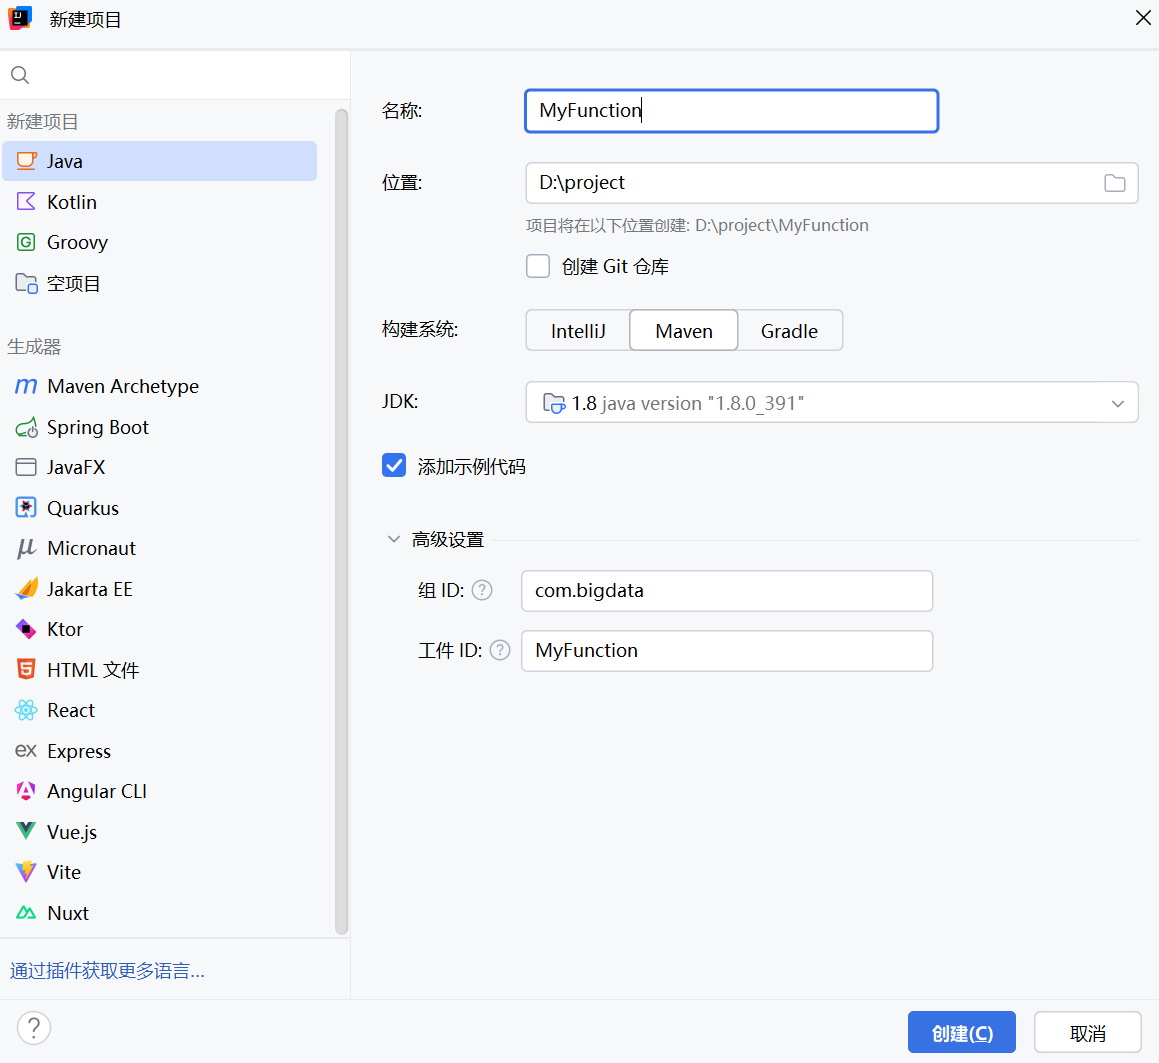
创建Maven项目:MyFunction,在pom.xml,加入以下maven的依赖包
sql
<dependencies>
    <dependency>
        <groupId>org.apache.hive</groupId>
        <artifactId>hive-exec</artifactId>
        <version>3.1.2</version>
    </dependency>

    <!-- https://mvnrepository.com/artifact/org.apache.hadoop/hadoop-common -->
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-common</artifactId>
        <version>3.3.1</version>
    </dependency>
</dependencies>
需要继承一个类:继承org.apache.hadoop.hive.ql.udf.generic.GenericUDF,并重写抽象方法。
java
package com.bigdata;

import org.apache.hadoop.hive.ql.exec.UDFArgumentException;
import org.apache.hadoop.hive.ql.metadata.HiveException;
import org.apache.hadoop.hive.ql.udf.generic.GenericUDF;
import org.apache.hadoop.hive.serde2.objectinspector.ObjectInspector;
import org.apache.hadoop.hive.serde2.objectinspector.primitive.PrimitiveObjectInspectorFactory;

public class UpperDemo extends GenericUDF {
    // 初始化 检查数据的入口是否正常
    @Override
    public ObjectInspector initialize(ObjectInspector[] objectInspectors) throws UDFArgumentException {
        if (objectInspectors.length != 1) {
            // 说明参数的数量不对
            throw new UDFArgumentException("参数数量错误");
        }
        // 返回值类型检查
        return PrimitiveObjectInspectorFactory.javaStringObjectInspector;
    }

    @Override
    public Object evaluate(DeferredObject[] deferredObjects) throws HiveException {
        // 获取这个字符串
        String msg = deferredObjects[0].get().toString(); // hello  hEELo
        String upperCase = msg.toUpperCase();//HELLO
        // 将一个大写字符串拼接后面的小写字符串 就得到了我们想要的
        String newMsg = upperCase.substring(0,1) + msg.substring(1).toLowerCase();
        return newMsg;
    }

    // 展示信息的
    @Override
    public String getDisplayString(String[] strings) {
        return "这是一个首字母会变大写的函数";
    }
}
编写好之后,打jar包。
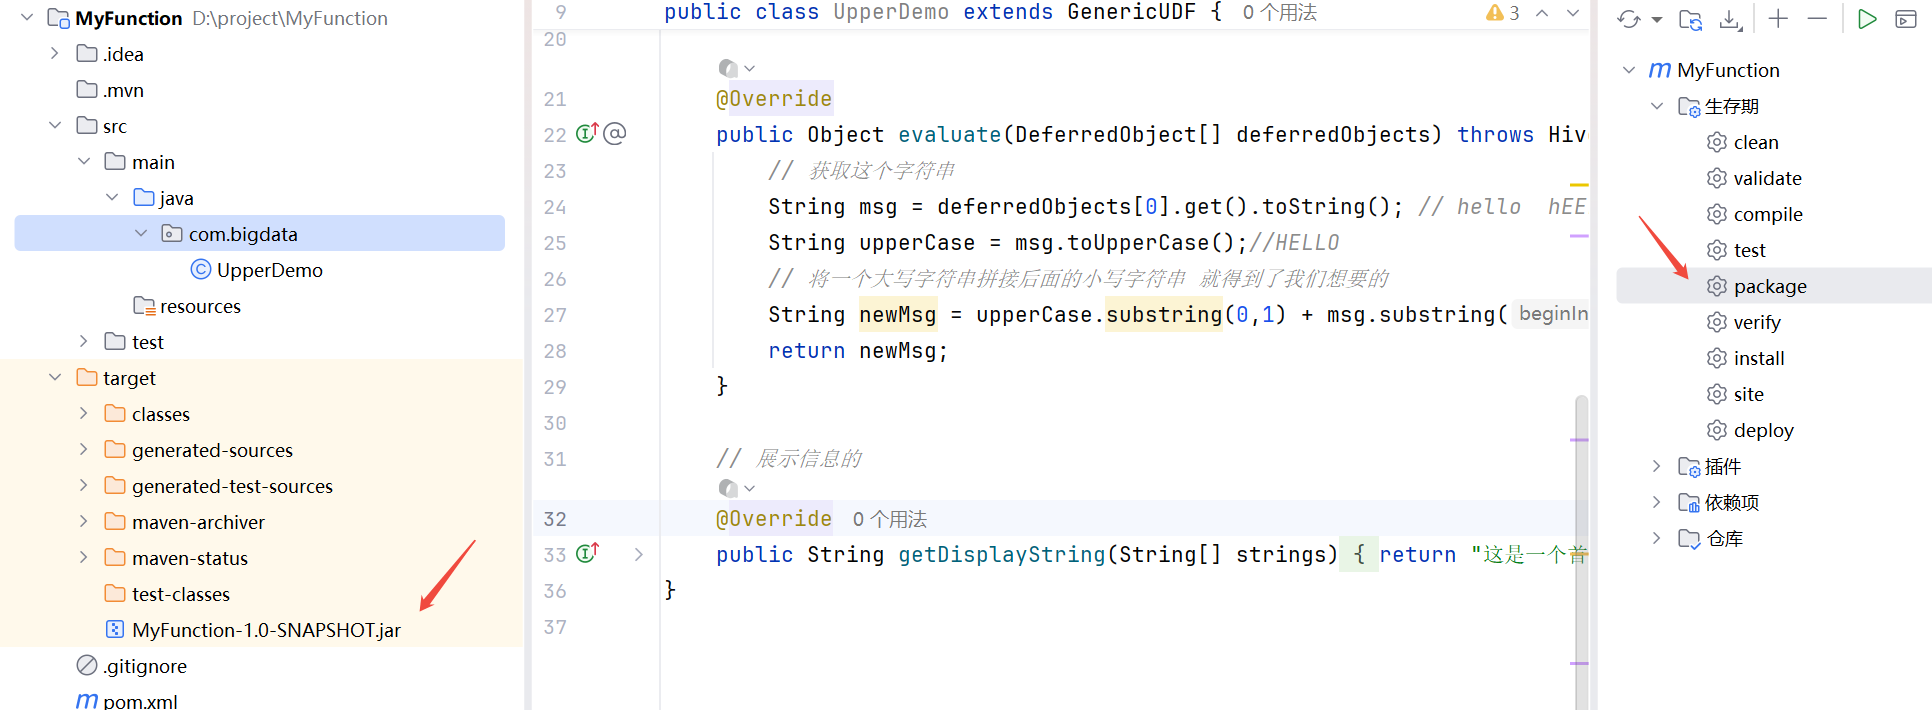
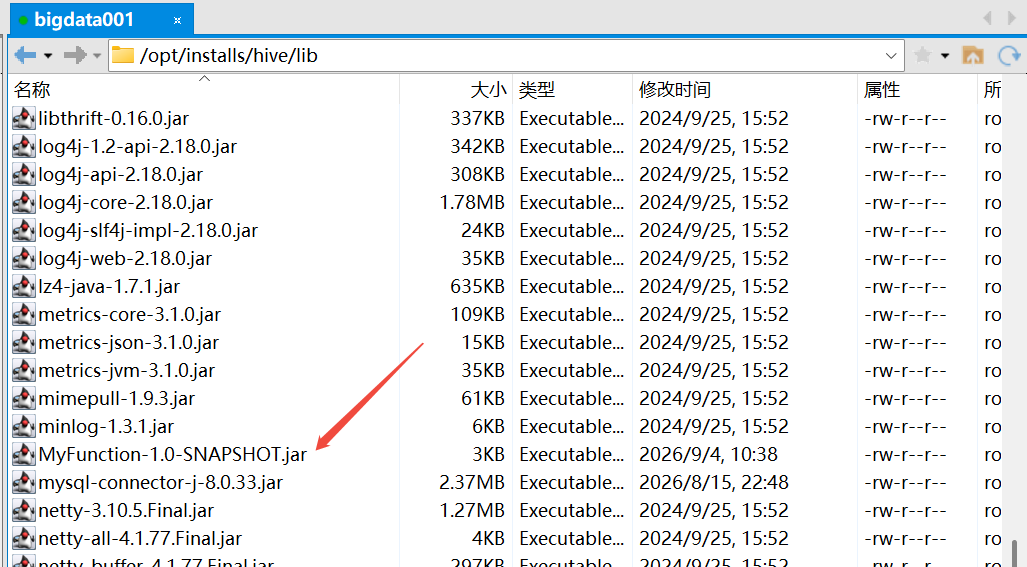
将该jar包放入 hive的lib文件夹下。
命令加载 (只针对当前session有效)
- 将编写好的UDF打包并上传到服务器,将jar包添加到hive的classpath中
add jar /opt/installs/hive/lib/MyFunction-1.0-SNAPSHOT.jar;
- 创建一个自定义的临时函数名
create temporary function firstUpper as 'com.bigdata.UpperDemo';
- 查看我们创建的自定义函数,
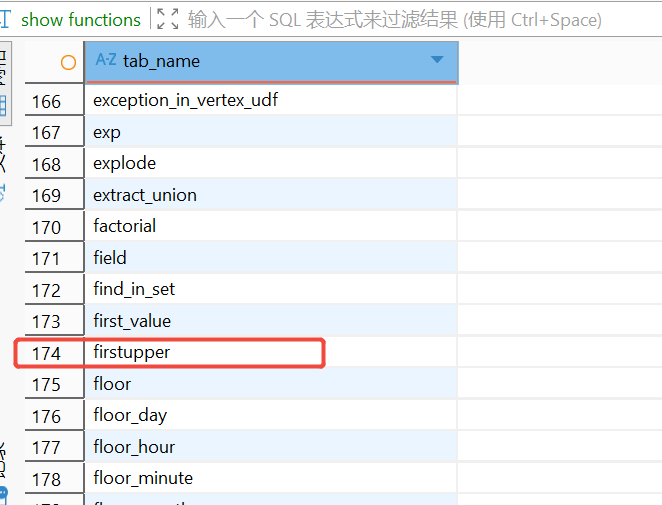
show functions;
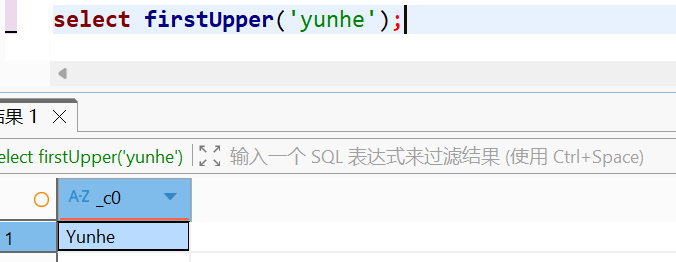
4.在hive中使用函数进行功能测试
select firstUpper('yunhe');
- 如何删除自定义函数?在删除一个自定义函数的时候一定要确定该函数没有调用
drop temporary function if exists firstUpper;