前言
在 C++ 的标准模板库中,关联式容器一直是我们处理查找、去重、映射等问题的利器。我们早已熟悉 set 和 map 的有序特性,但当我们不那么关心顺序,只追求极致的插入、查找、删除效率时,unordered_set 和 unordered_map 便登场了。它们基于哈希表实现,平均时间复杂度 O(1),但相应的,它们对元素类型有特殊要求,迭代器也不再有序。本文会先介绍 unordered_set 的基本用法,再对比 set 的差异,接着引出 unordered_map,最后通过完整的性能测试代码让你直观感受"哈希"带来的速度提升。
一、unordered_set 系列入门
首先,我们从 unordered_set 开始。它的声明如下:
cpp
template < class Key,
           class Hash = hash<Key>,
           class Pred = equal_to<Key>,
           class Alloc = allocator<Key> >
class unordered_set;-
第一个模板参数
Key就是我们要存储的元素类型。 -
第二个
Hash是哈希函数,默认用std::hash<Key>,它要求Key能够转换成整型值(以便计算桶下标)。如果默认不支持(比如自定义类),我们可以自己提供仿函数。 -
第三个
Pred是比较相等性的函数,默认是std::equal_to<Key>,要求Key支持operator==。 -
第四个是空间配置器,通常我们用默认值即可。
所以说,unordered_set 对 Key 的要求与 set 截然不同:set 要求支持
<比较(用于红黑树排序),而 unordered_set 要求支持"转整形"和"=="。这种差异来自底层数据结构------哈希表。
与 set 的主要差异(三个维度)
-
迭代器类型:set 的迭代器是双向迭代器(可以 ++ 和 --),而 unordered_set 是单向迭代器(只能 ++)。
-
遍历顺序:set 底层是红黑树,中序遍历的结果是升序且去重的;unordered_set 底层是哈希桶,遍历结果是无序的,但也会去重。
-
性能:set 的增删查改复杂度为 O(log N),而 unordered_set 平均为 O(1)。在数据量较大时,哈希表通常更快。
让我们先用一个简单例子验证无序和遍历行为。
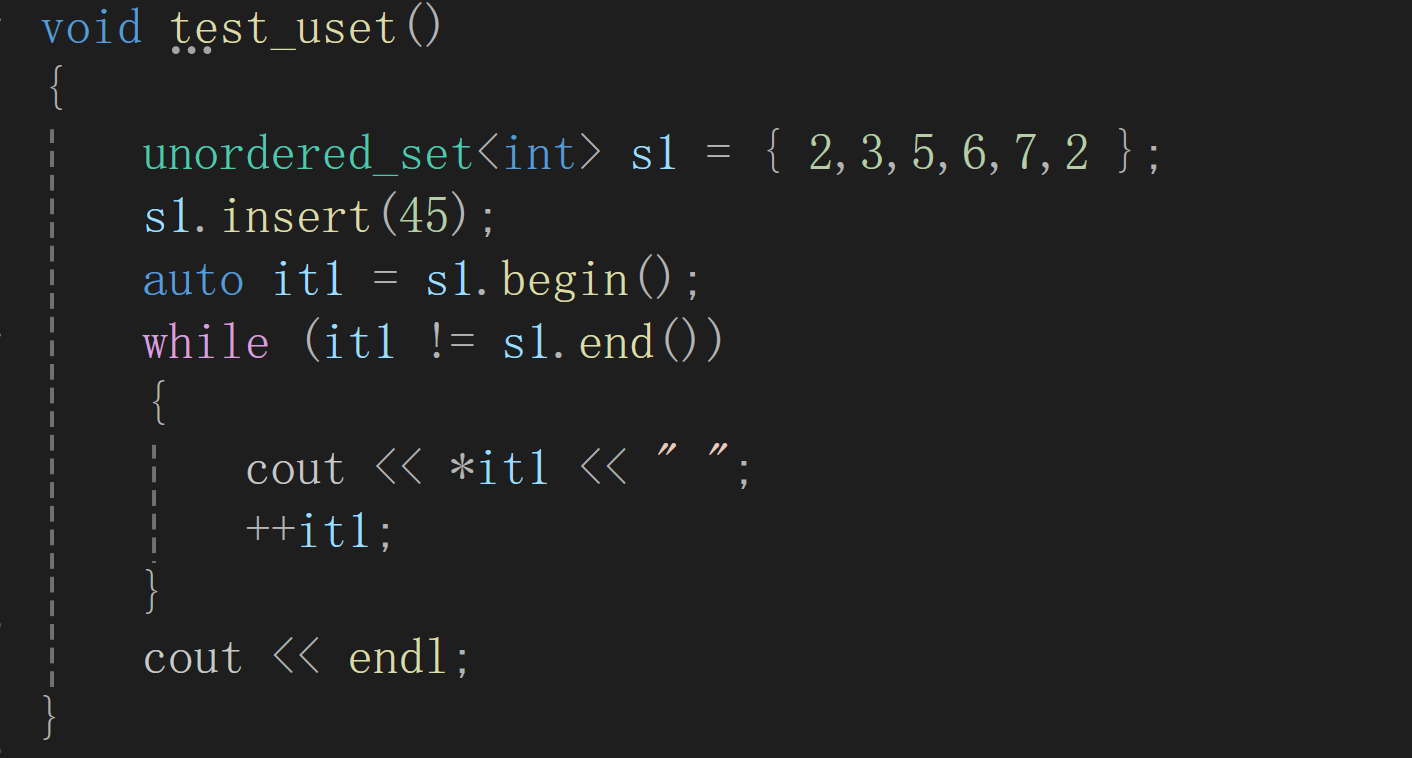
这里我们初始用列表插入了 2,3,5,6,7,2(注意重复的 2 会被去重),然后插入 45,最后从 begin 遍历到 end。由于底层是哈希表,输出的顺序不一定是输入顺序,例如可能是"7 5 2 3 6 45"之类的任意排列,但绝对不会出现重复值。这就是"无序 + 去重"的直观体现。
二、unordered_map 的基本使用
与unordered_set 类似,unordered_map 存储键值对(key-value)。它的模板参数多了一个 Mapped 类型,即值的类型。同样,它的 key 必须支持哈希和等于比较。它与 map 的差异与上面完全一致:
-
map 是有序(按 key 升序)双向迭代器,unordered_map 无序单向迭代器。
-
map 的 key 要求 <,unordered_map 要求哈希和 ==。
-
性能上 unordered_map 通常更快。
函数演示插入和遍历:
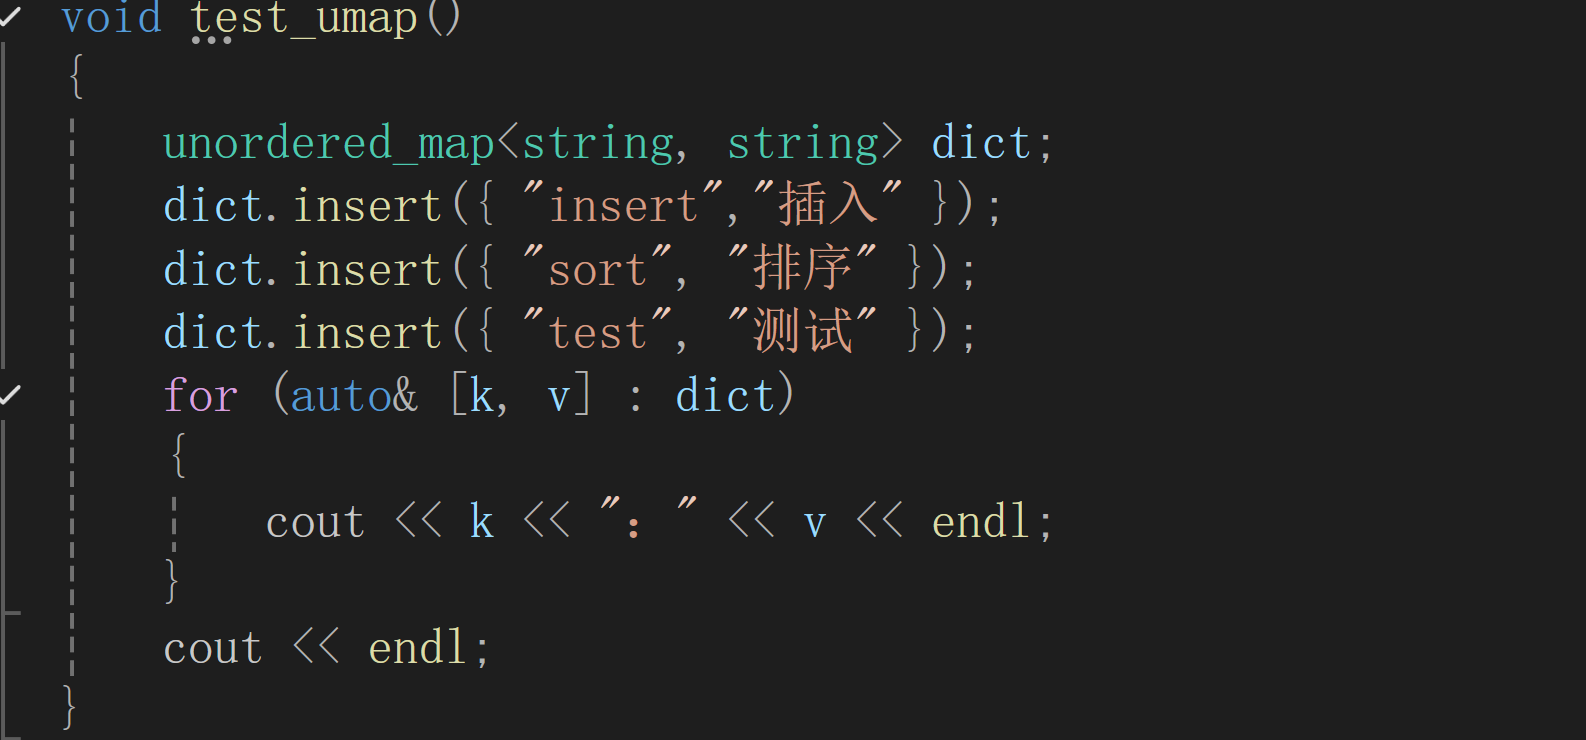
这里我们向字典中插入了三个英文单词的中文释义,然后使用 C++17 的结构化绑定(auto& [k, v])遍历所有键值对。因为 unordered_map 无序,输出顺序可能不是 "insert"、"sort"、"test" 的顺序,而是随机的。但每个 key 都是唯一的,重复插入相同 key 会失败(除非使用 multiset 系列)。
三、深入性能对比------通过测试代码
为了切身感受 O(1) 与 O(log N) 的差距,我给出了一个完整的测试函数 test_set2。这个测试会生成大量随机数,分别插入 set 和 unordered_set,然后统计插入、查找、删除的耗时。
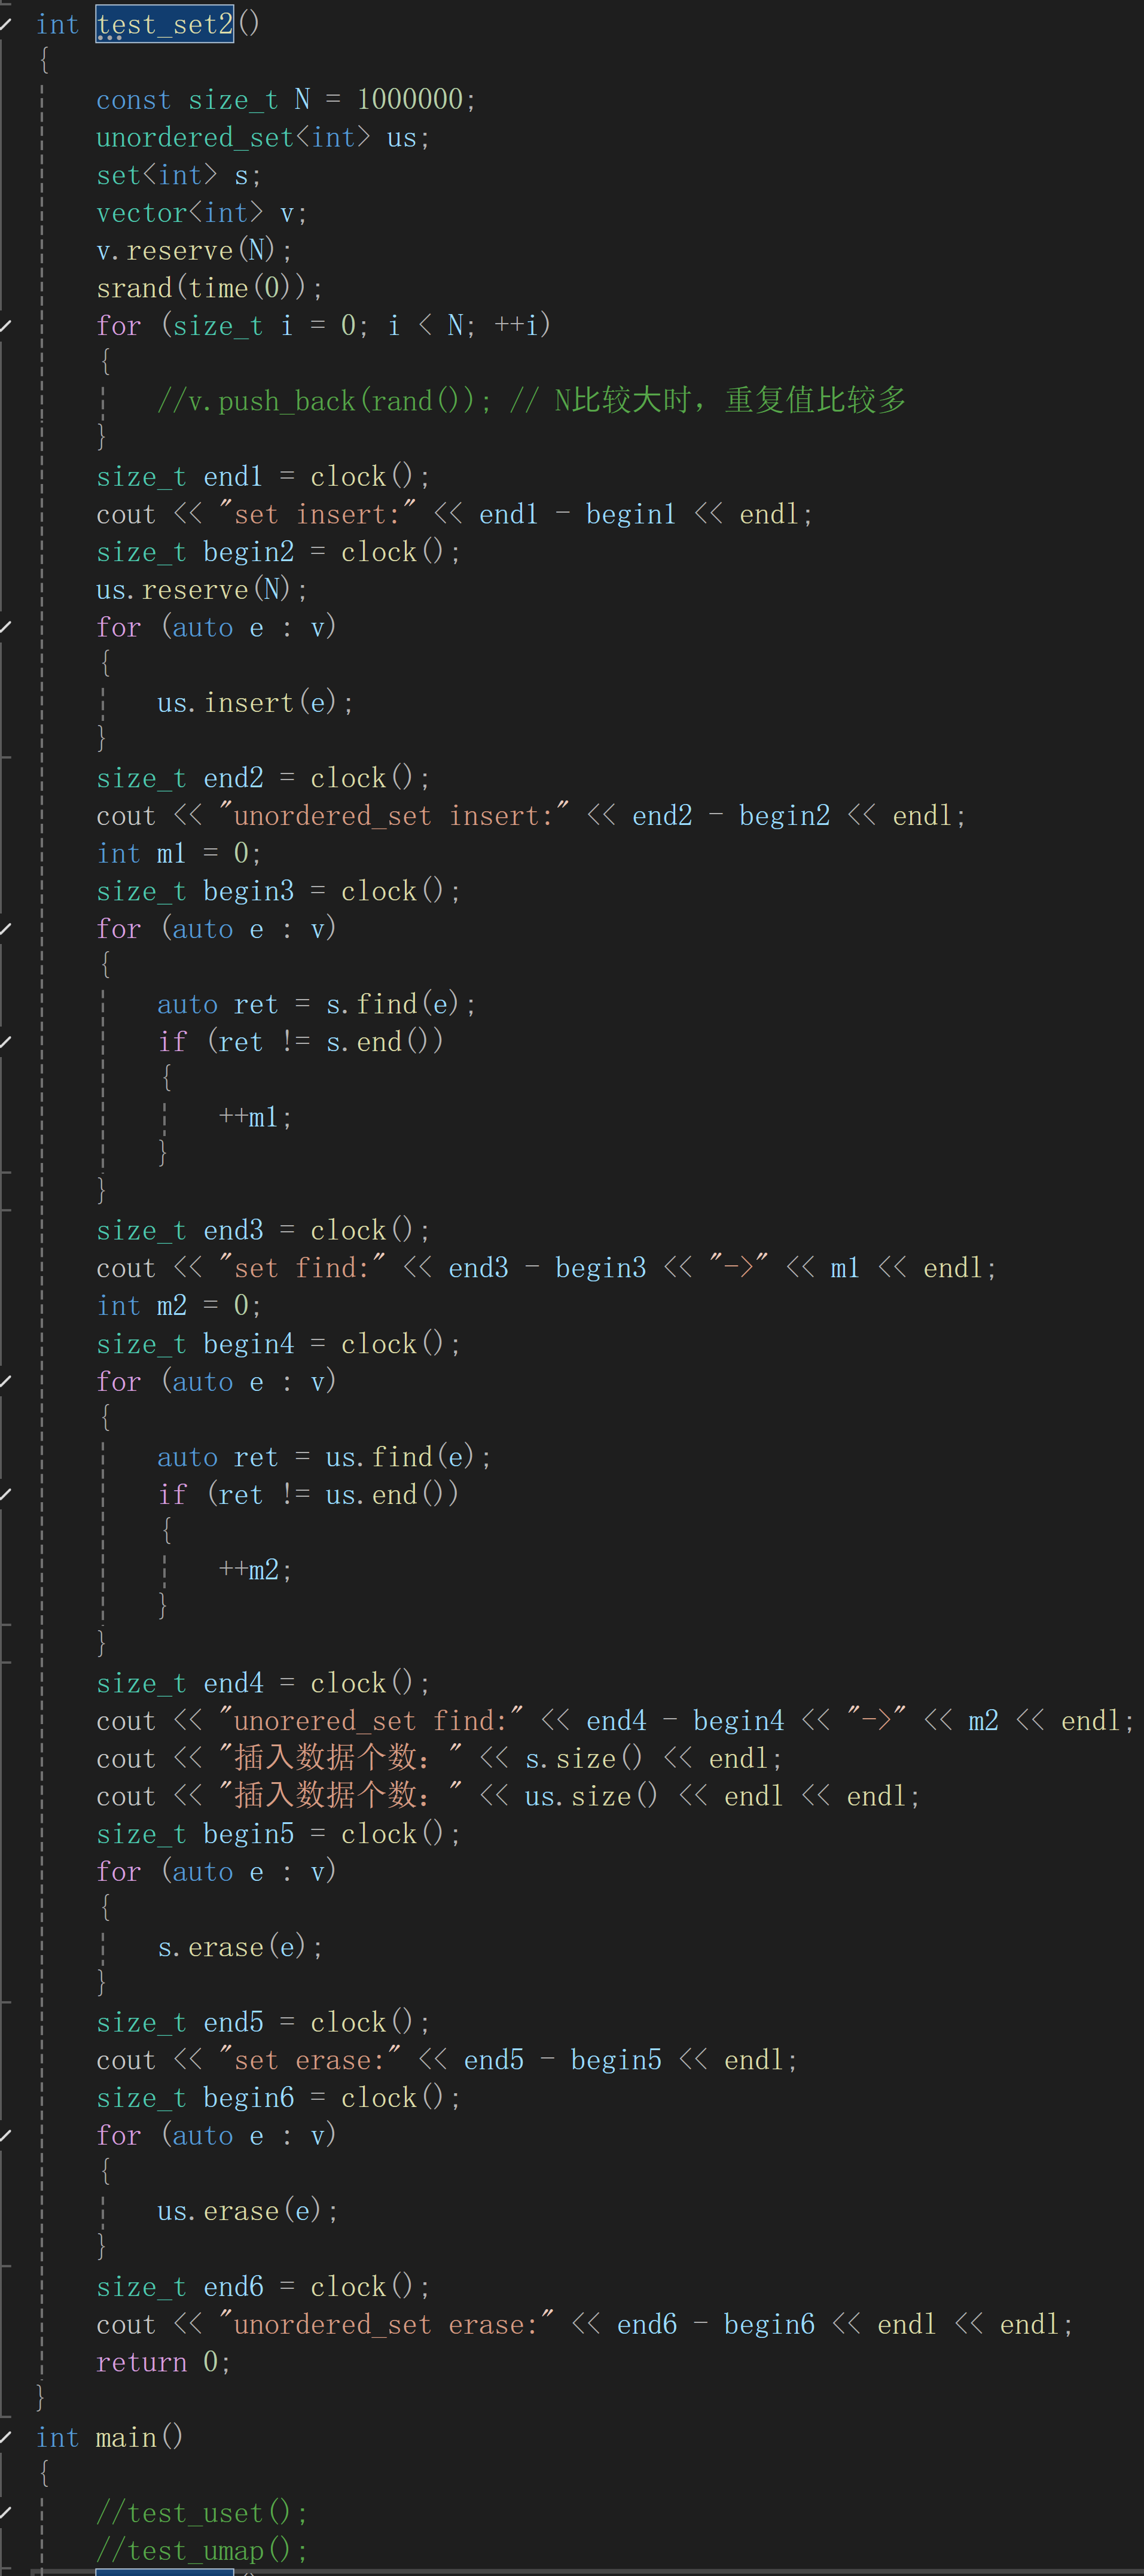
代码细节剖析:
-
我们生成 N=100 万个随机数(加上 i 以减少重复,使得重复值相对少一些,更真实反映查询效率)。
-
对于 unordered_set,我们调用了
reserve(N),这是提前把桶的数量扩展到足够容纳 N 个元素,避免插入过程中频繁 rehash(重新分配桶)带来的开销。这是使用 unordered 容器时一个重要的优化技巧。 -
分别计时插入、查找、删除操作,并输出消耗的毫秒数(clock() 函数返回 CPU 时钟数,差值即为时间)。
-
查找时统计成功找到的数量(应该等于容器的大小),用来验证数据完整性。
-
最后打印两个容器的实际元素个数,它们应该相同(去重后)。
预期的结果
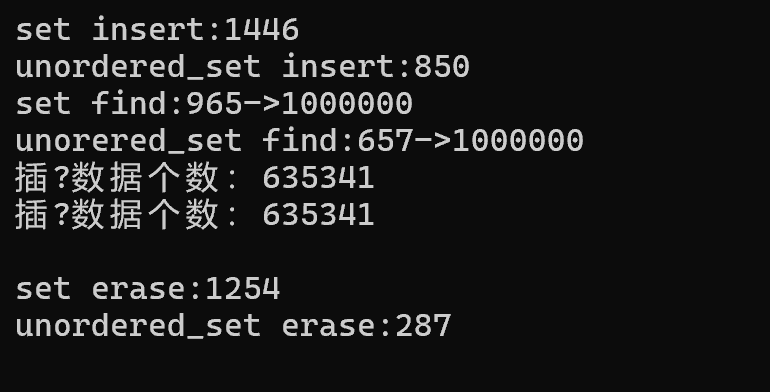
在大多数环境里,你会看到 unordered_set 的插入、查找、删除耗时都显著小于 set,通常差距在几倍到十几倍不等。这直接验证了 O(1) 对比 O(log N) 的优势。当然,如果数据量很小,或者重复值极多,差距可能不明显,但大规模数据下哈希表胜出。
四、关于 unordered_multimap 和 unordered_multiset
这两个容器与 multimap/multiset 类似,允许键重复。它们的接口和用法与普通版本一致,只是插入时不会去重,查找会返回所有匹配项。对于需要存储多个相同 key 的场景,可以直接选用它们。
五、总结
-
unordered_set / unordered_map 基于哈希桶,平均 O(1) 的效率,非常适合大规模查找去重。
-
它们对 Key 的要求是支持哈希转换和相等比较,而不是小于比较。
-
遍历顺序无序,迭代器为单向。
-
性能明显优于 set/map,但会牺牲有序性和双向遍历的能力。
-
在使用时,可主动
reserve预分配桶数以提升插入效率。