Kafka实战 自定义分区器 几种常见的分区器

自定义分区器

kafka topic是可以分为很多很多分区的,每一条消息在Kafka中存储的时候是要选择其中一个分区进行存储的,并且只能存在于一个分区当中。

这条消息到底该存在哪个分区当中?这个是由分区器来决定的。

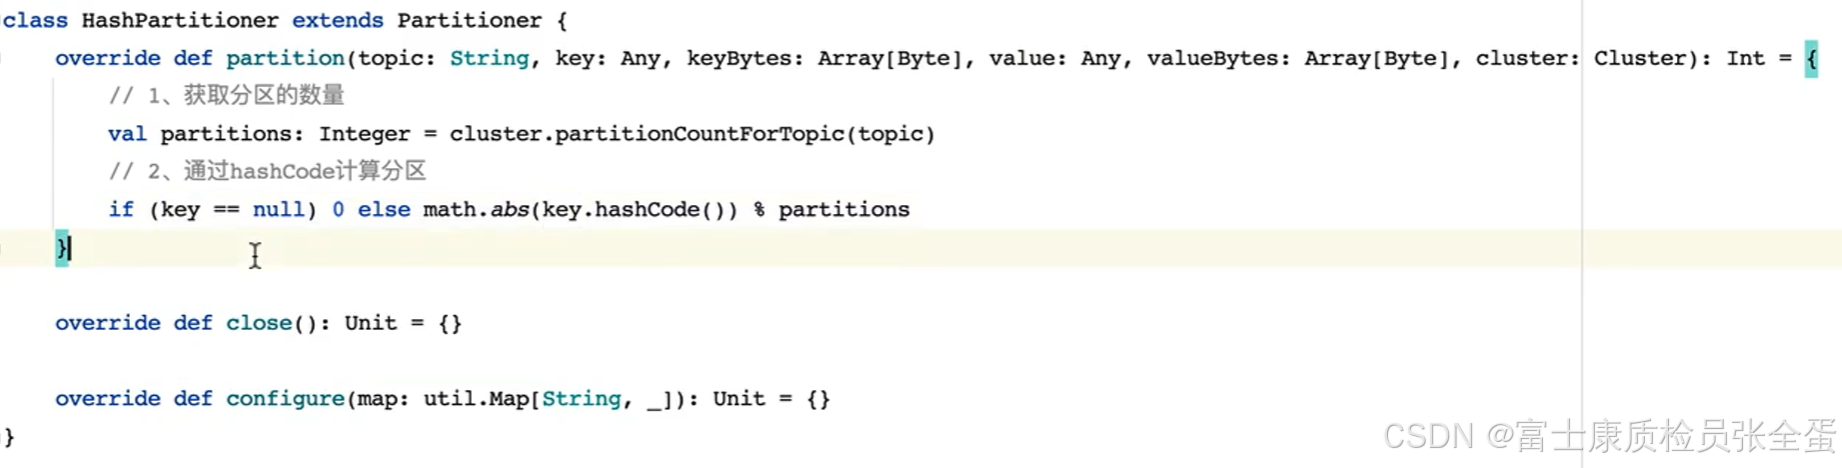
分区器在Kafka当中默认采用的是哈希分区器,也就是根据消息的hash值%分区的数量,这样就可以将分区号计算出来。当然也可以根据自己的需求去定义自己的分区器。
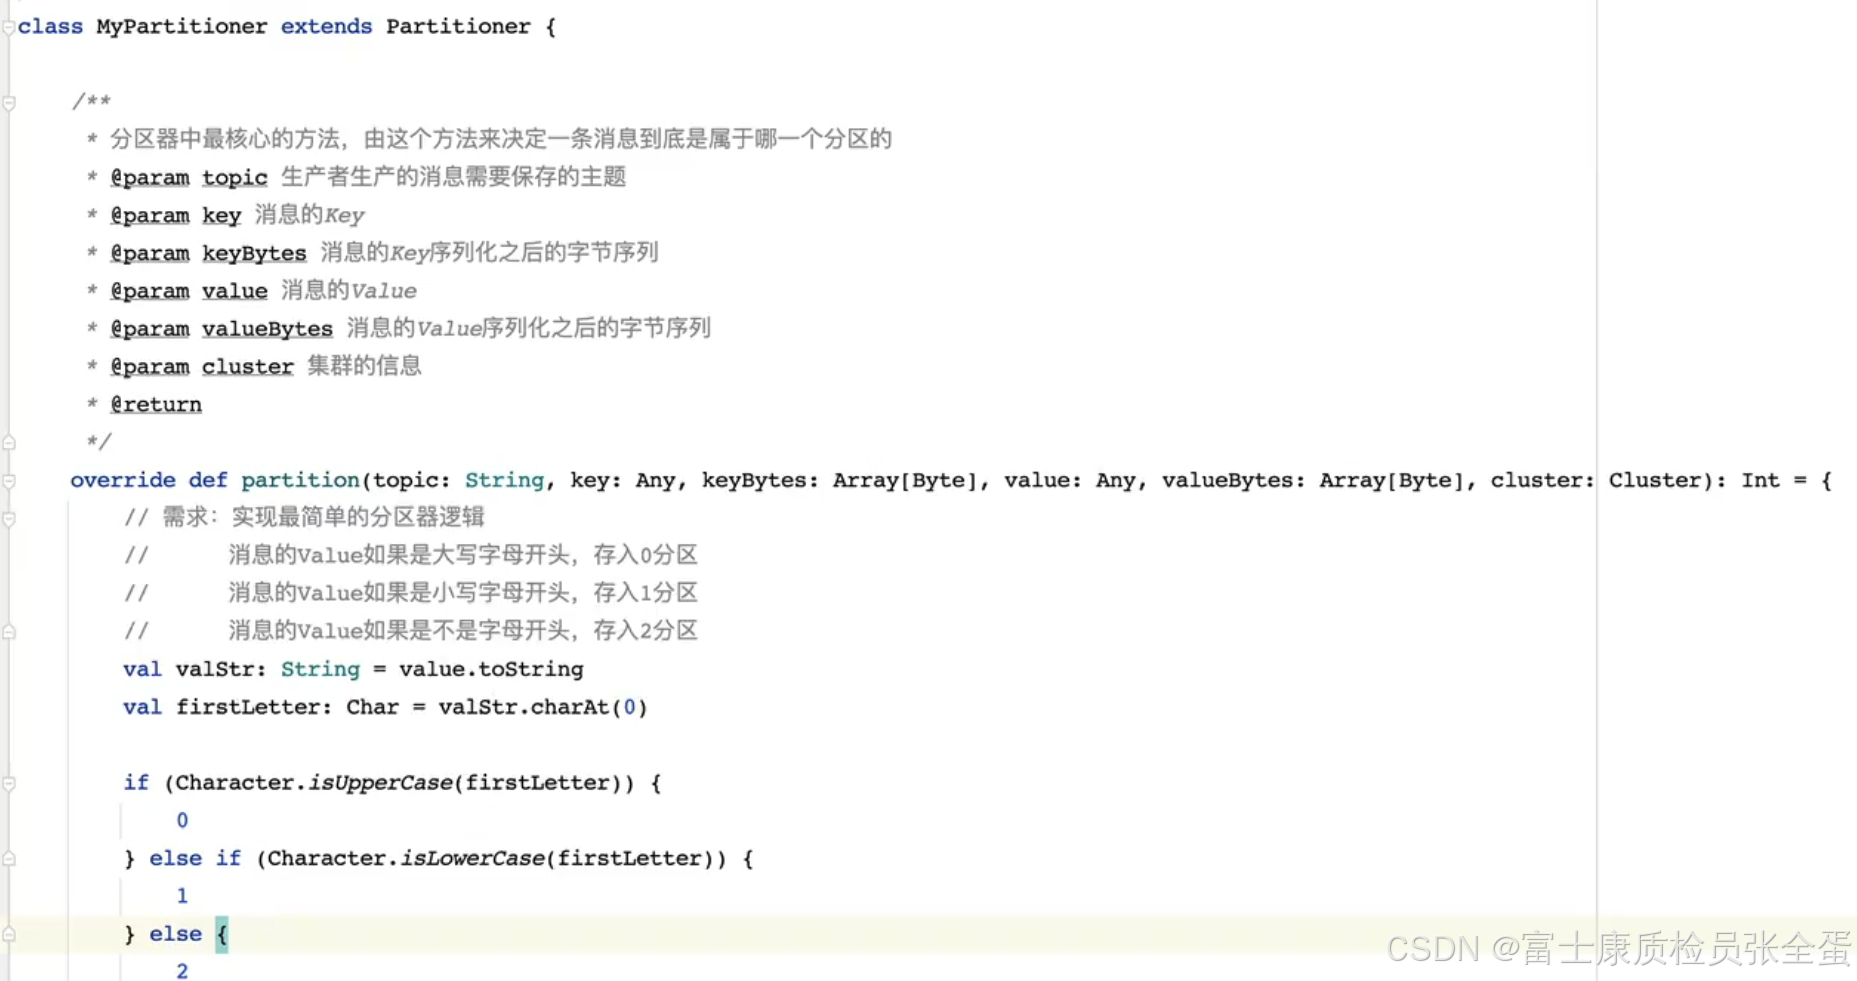
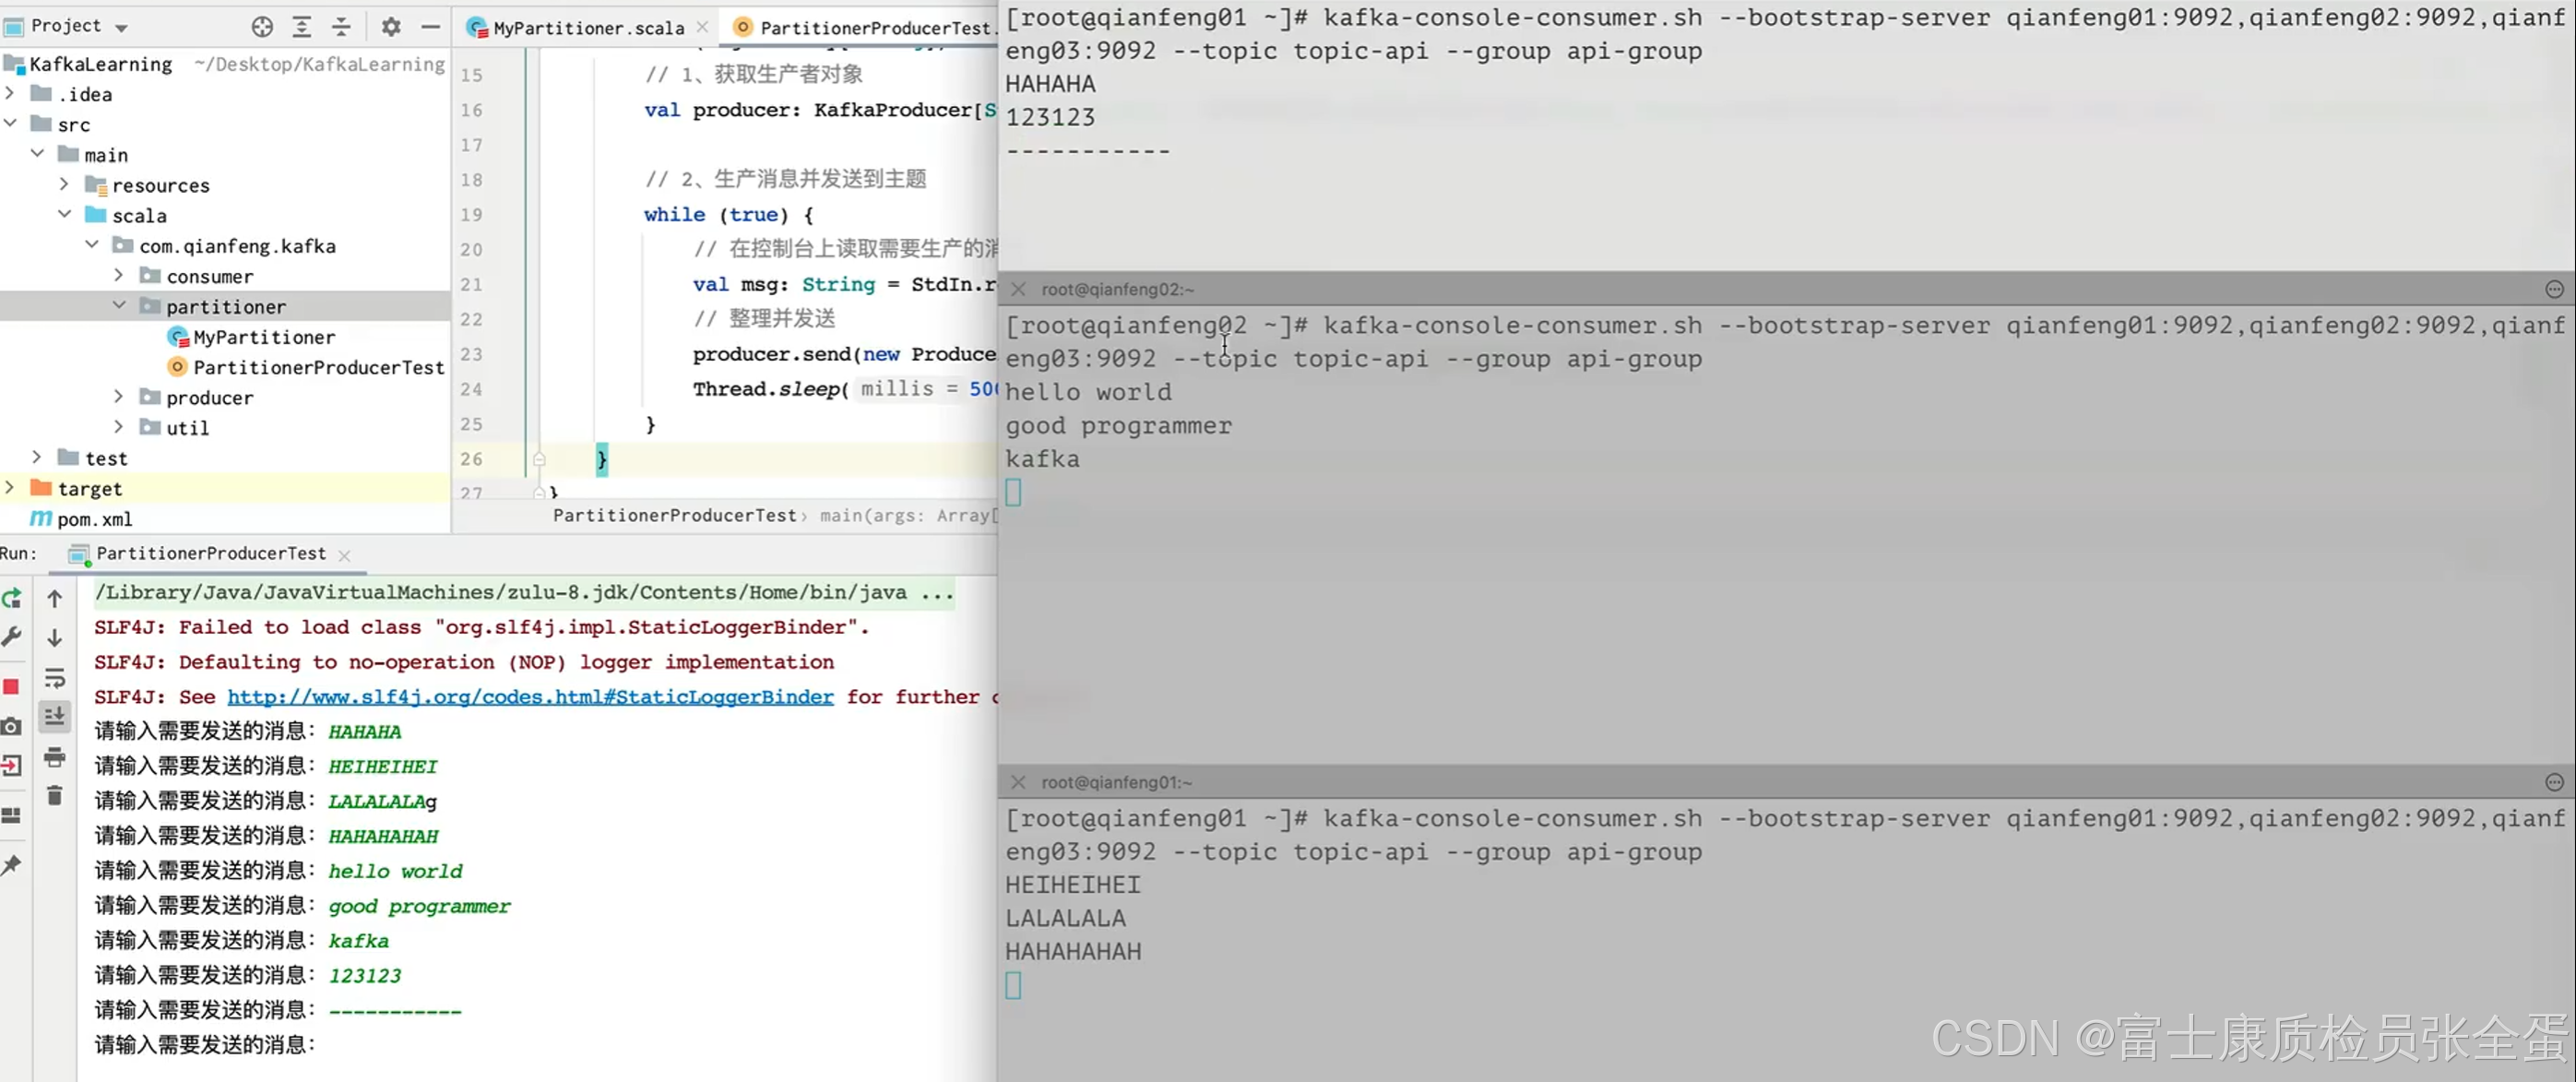
生产者
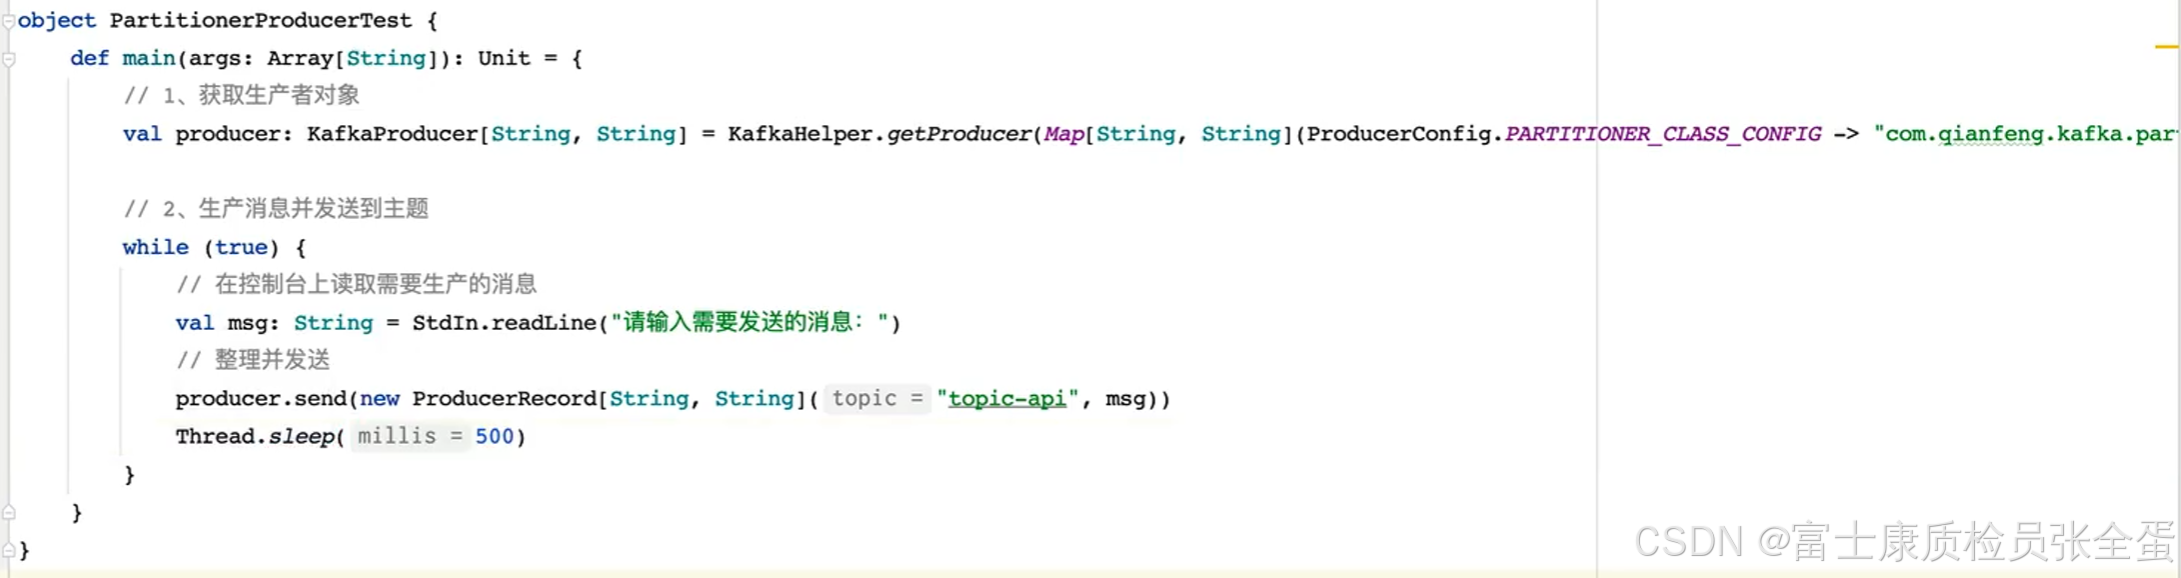
可以看到大写字母开头的,是第三个窗口的分区收到了,说明监听的是0分区。第一个HAHAHA是因为最开始只启动了第一个消费者,所以三个分区它都消费。

后来有两个消费者上线了之后,他们各司其职,各自去消费一个分区。下面分区器的逻辑就是,大写字母、小写字母、或者不属于前面两者的都分别存放于不同的分区当中。
几种常见的分区器

随机分区器。比如有多个分区,随机返回0 1 2就行了。第一件事情就是获取所有的分区数量,得知道一共有多少分区才行。
哈希分区器 可以根据值或者key的哈希值来选择分区
轮询分区器 发送一条消息放到0分区,下一条消息放在1分区,再下一条消息放在2分区。
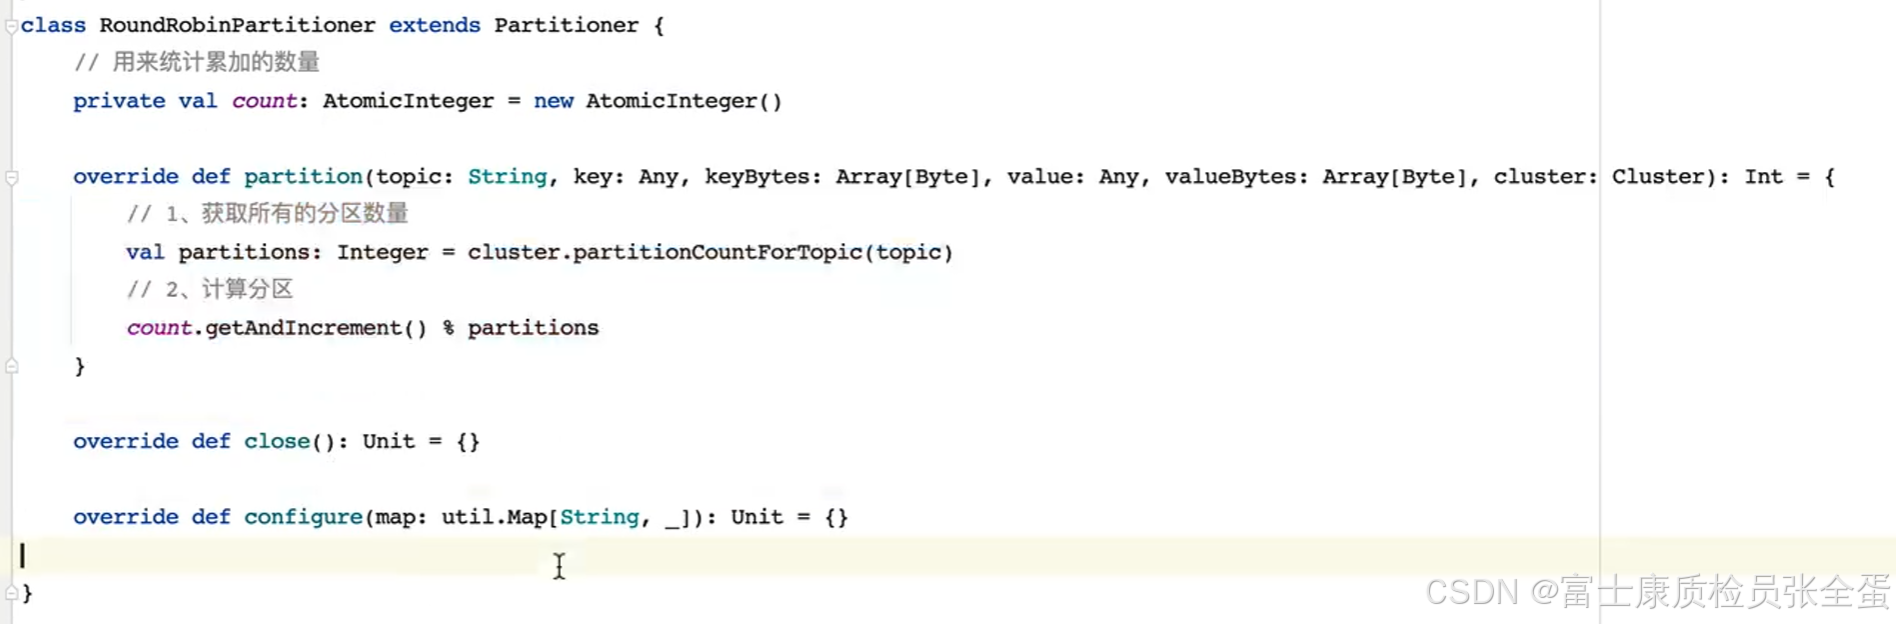
分区器只需要自己去写一个类去实现接口即可,具体想要做什么样的分区逻辑,在partition中实现一下就行。

相关推荐
Thomas.Sir5 天前
第21课:PyTorch|GPU多卡训练与分布式训练基础【让多卡并行成为你的加速引擎】
人工智能·pytorch·分布式
Cicada1285 天前
库存消息消费的正确性设计——从幂等窗口到批量流水线
分布式·系统架构
Nano叶落5 天前
Kafka 消费积压排查入门:Docker 搭环境亲手制造一次 ‘消息堵死‘,10 分钟看懂 Lag
kafka
Francek Chen6 天前
【大数据处理与分析】数据仓库Hive:04 数据仓库Hive概述
大数据·数据仓库·hive·hadoop·分布式
Gl�ria6 天前
Hadoop/YARN 集群缩容:下线DN节点
大数据·hadoop·分布式
吉甫作诵6 天前
Kafka 集群安装与运维实战:消费组排查、Offset 重置与副本重分配
大数据·运维·分布式·kafka·消息队列
imDwAaY6 天前
消息队列四大核心问题:顺序性、幂等性、可靠性与一致性
学习·kafka·rabbitmq
wno7046 天前
Spring Boot整合Kafka
spring boot·kafka
是Dream呀6 天前
Harness 工程:让 Agent 真正把任务做完
人工智能·分布式·缓存·agent