**SenseNova-U1.5-8B-MoT 是商汤科技 SenseNova 团队于 2026 年发布的原生统一多模态生成模型,**采用 NEO-unify 架构设计,可在单一模型内完成图像生成、图像编辑与多模态理解等任务。模型公开约 18B 参数的 BF16 精度版本,在图像质量、文字渲染、4K 图像生成和复杂指令遵循等方面全面升级,能够实现更精准的画面控制、更稳定的主体保持以及更丰富的视觉创作能力,为海报设计、图像编辑和多模态内容生产提供更加高效的 AI 解决方案。
目前,HyperAI超神经官网已上线了「SenseNova-U1.5-8B-MoT:图像生成与编辑」,快来试试吧~
在线使用:https://go.hyper.ai/gR13X
8 月 28 日- 9 月 3 日,hyper.ai 官网更新速览:
* 优质公共数据集:3 个
* 优质教程精选:3 个
* 热门百科词条:5 条
* 9 月截稿顶会:6 个
访问官网:hyper.ai
公共数据集精选
1. LibriTTS-R 音质改进英语语音数据集
LibriTTS-R 是 LibriTTS 语料库的音频质量改进版本,相关论文成果为 LibriTTS-R: A Restored Multi-Speaker Text-to-Speech Corpus,旨在为语音研究提供更高质量的英语语音数据。该数据集包含约 585 小时的多说话人英语朗读语音,采样率为 24kHz,并划分为 7 个数据分割(splits)。
在线使用:LibriTTS-R | Datasets | HyperAI
2. GLOBE_V2 全球口音英语语音数据集
GLOBE 数据集是于 2024 年发布的一个高质量英语语音语料库,旨在解决零样本说话人自适应 TTS 系统对口音说话人泛化能力差的问题。该数据集包含 535 小时 24kHz 采样率的语音数据,数据源自 23,519 位说话人,覆盖全球 164 种口音,并附带详细的说话人元数据。GLOBE_V2 在此基础上提供 44.1 kHz 采样率的音频,同时移除了约 5% 存在音量异常或音频与文本对齐问题的样本,进一步提升了数据质量。
在线使用: GLOBE_V2 | Datasets | HyperAI
3. USGS Global Earthquake 全球区域地震数据集
USGS Global Earthquake 是一个基于美国地质调查局(USGS)地震事件数据整理的全球区域地震数据集,旨在为地震活动的时空分布分析、区域地震灾害研究及数据可视化教学提供数据。该数据集覆盖 1900 至 2026 年的地震记录,每个文件收录对应一个地震事件,记录震级、发震时间、经纬度、深度、震中位置描述等 USGS 标准事件字段,并根据坐标补充了大洲、区域和国家等地理字段。该数据集为原始全球地震数据集的区域拆分版本,已按地理区域保存为独立的 CSV 文件。
在线使用:USGS Global Earthquake | Datasets | HyperAI
公共教程精选
1. SenseNova-U1.5-8B-MoT:图像生成与编辑
SenseNova-U1.5-8B-MoT 是商汤 SenseNova 团队推出的原生统一多模态模型,基于 NEO-unify 架构,在单一模型中支持图像生成、编辑与多模态理解。模型强化 4K 生成、中英文文字渲染、复杂指令遵循与精细视觉控制,可用于海报设计、图像编辑、视觉问答等内容创作场景。
在线运行:https://go.hyper.ai/gR13X
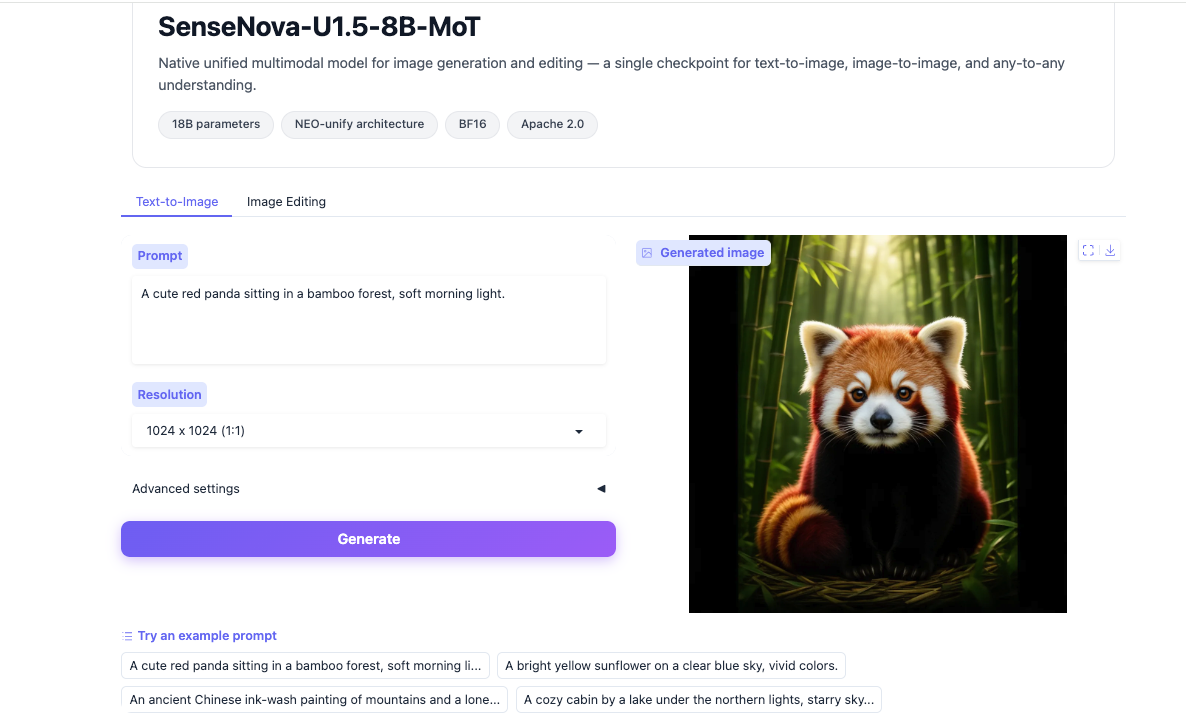
demo 页面
2. DeepSeek-V4-Flash-Vision-Exp 多模态推理与 Open WebUI 部署
DeepSeek-V4-Flash-Vision-Exp 是 DeepSeek 于 2026 年 8 月推出的 V4 系列首款实验性多模态模型,在 V4-Flash 架构上加入视觉编码器与对齐模块,通过持续训练获得视觉理解能力。模型采用稀疏 MoE 与 DFlash Attention,可处理截图、图表、文档及代码图像等内容,面向多模态 Agent 与视觉理解场景。
在线运行:DeepSeek-V4-Flash-Vision-Exp :Multimodal Reasoning & Open WebUI Deployment | Notebooks | HyperAI
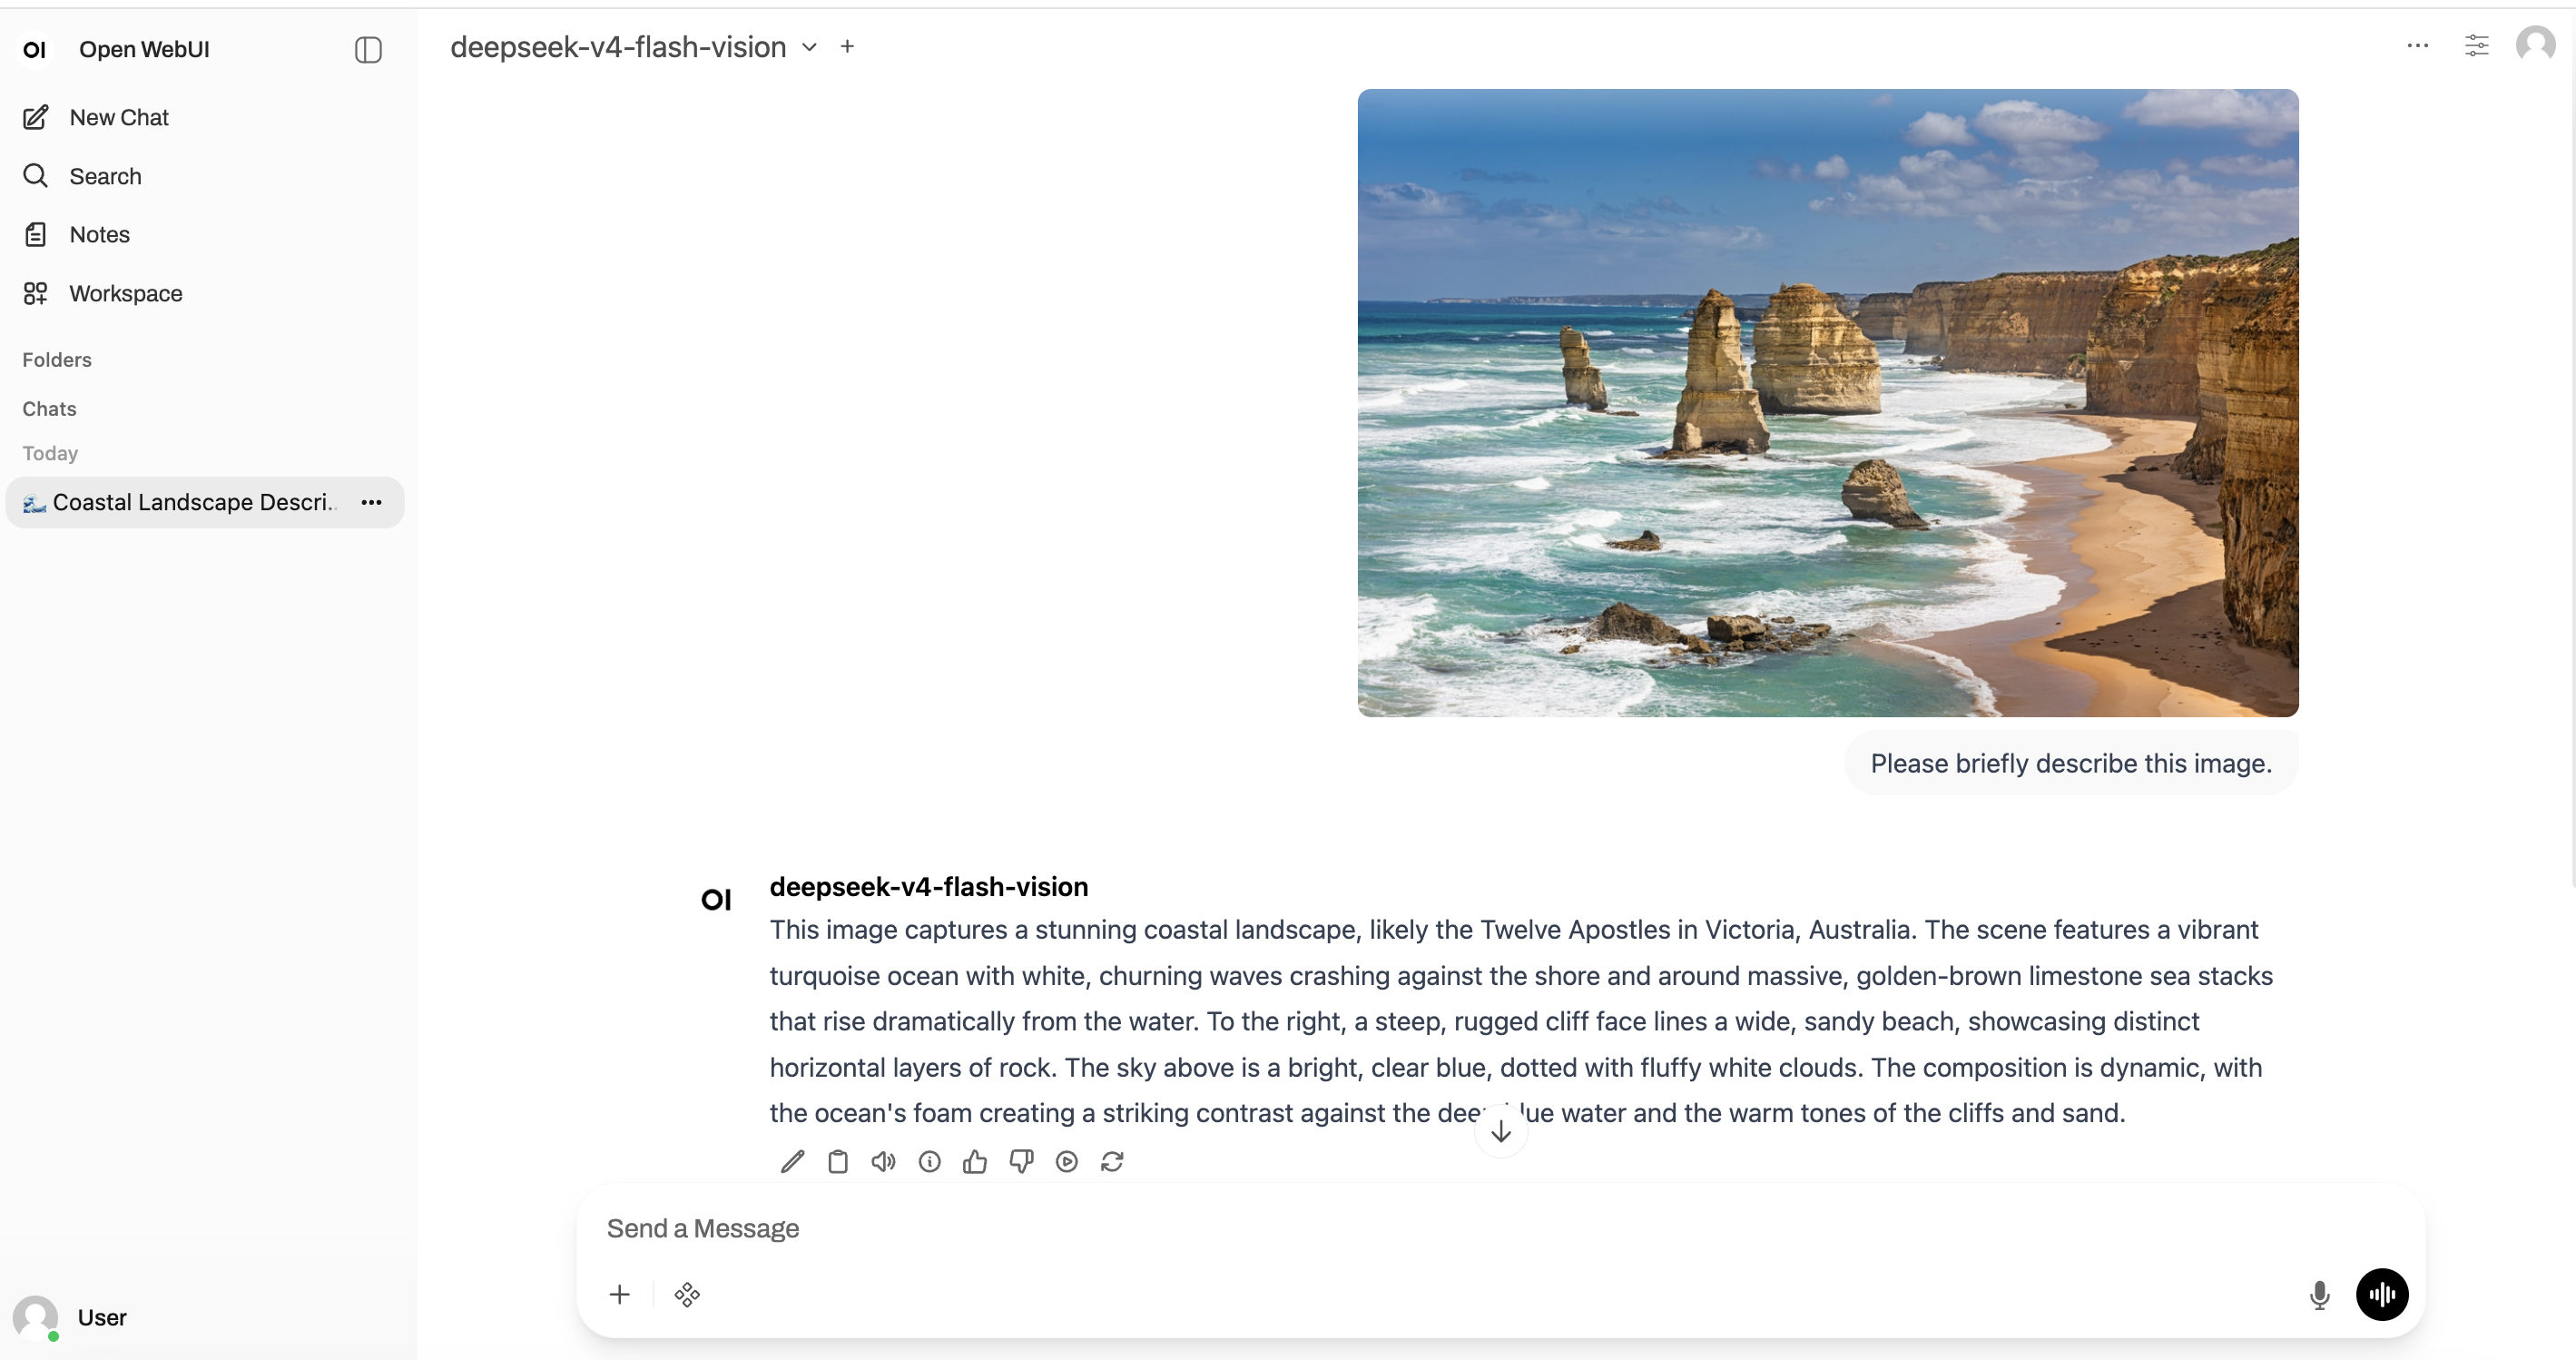
demo 页面
3. Qwen3.8-Flash-Next-FP8 多模态大模型
Qwen3.8-Flash-Next-FP8 是阿里 Qwen 团队推出的下一代实验模型,采用混合注意力与稀疏 MoE 架构,以 125B 总参数、6B 激活参数实现高效推理。模型原生支持 262K 长上下文及文本、图像和视频输入,并采用 FP8 量化,在多模态理解、Agent 工具调用和复杂推理等任务上保持旗舰级性能。
在线运行:Qwen3.8-Flash-Next-F8 Multimodal Large Language Model | Notebooks | HyperAI
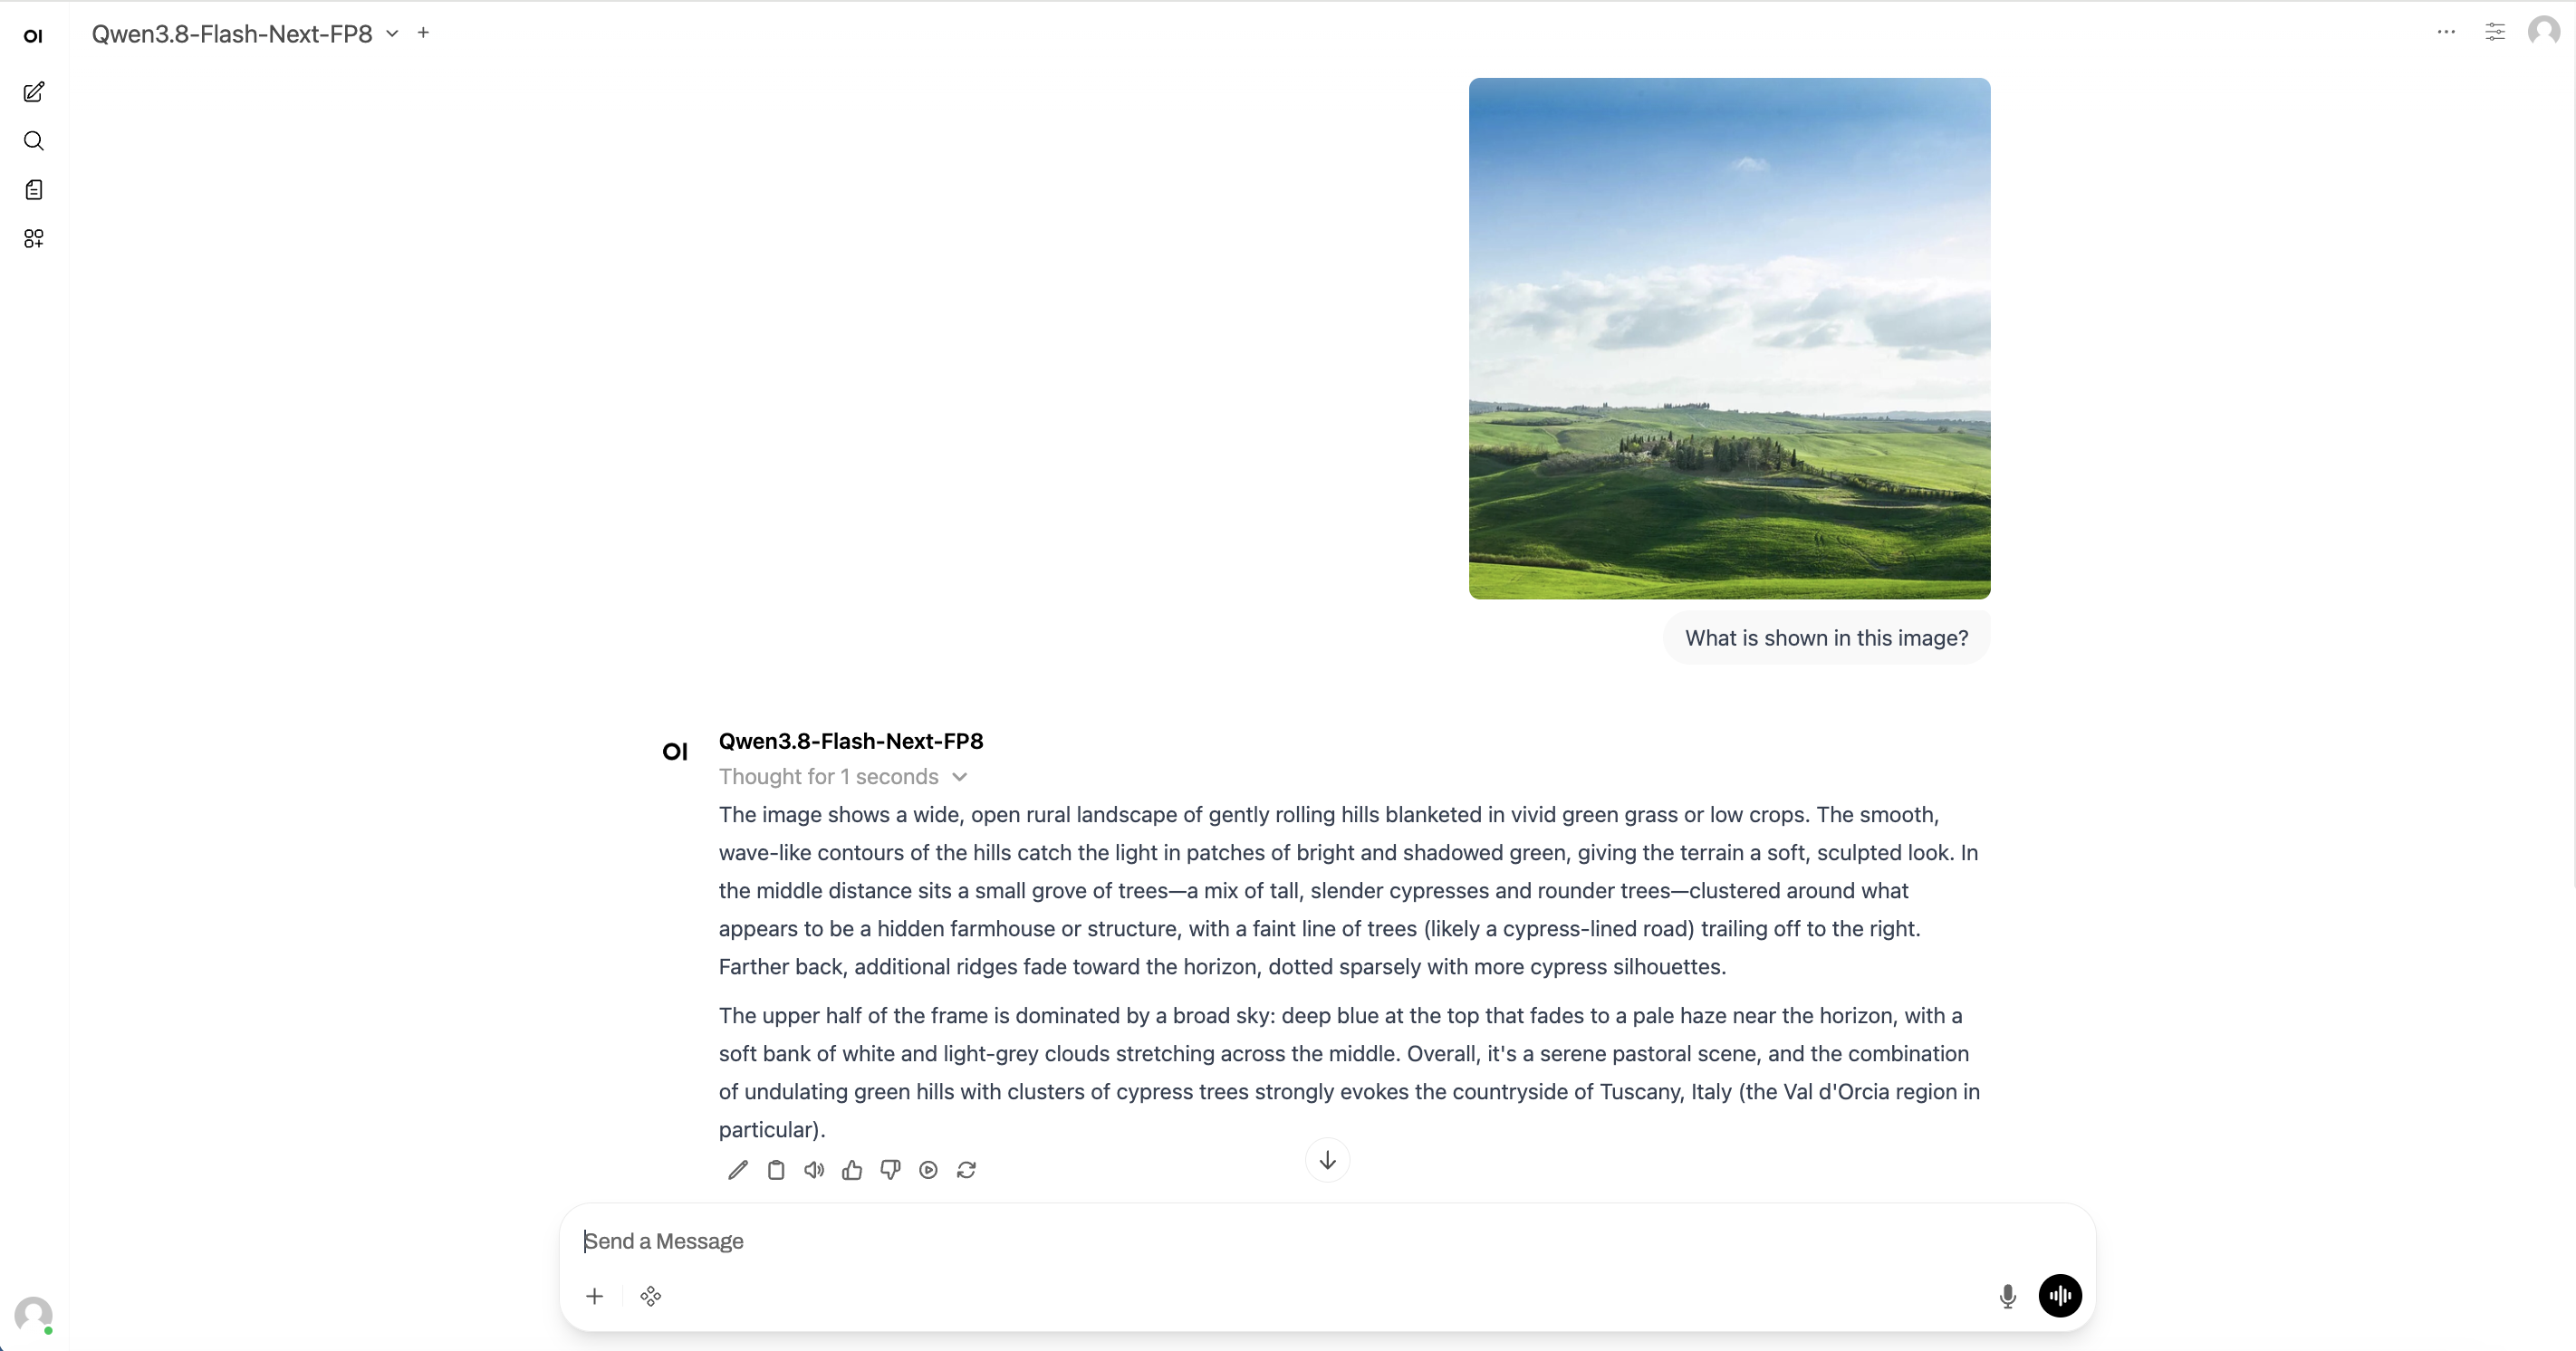
demo 页面
热门百科词条精选
1. 光学字符识别 OCR
2. 世界动作模型 WAM
3. 遥感 Remote Sensing
4. 故障词元 Glitch Token
5. 生成型预训练变换模型 GPT
这里汇编了数百条 AI 相关词条,让你在这里读懂「人工智能」:
9 月截稿顶会
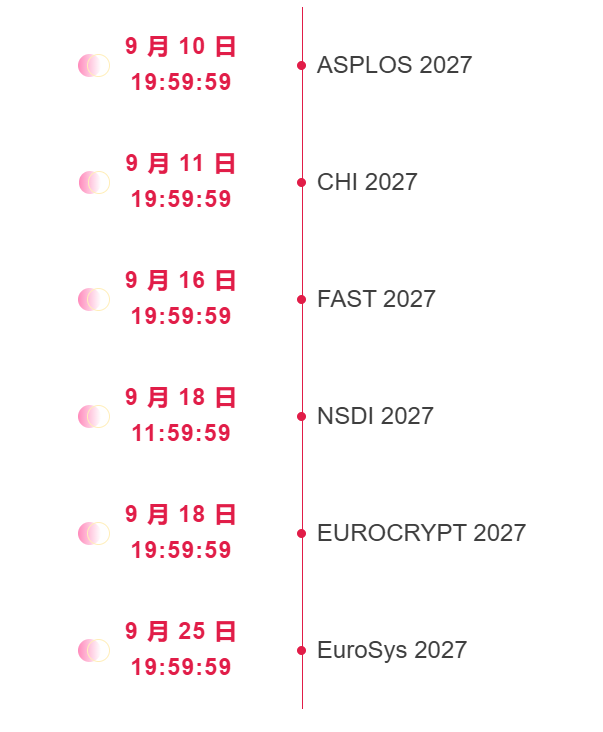
* 截稿时间为 AoE 时间
一站式追踪人工智能学术顶会:https://go.hyper.ai/event
以上就是本周编辑精选的全部内容,如果你有想要收录 hyper.ai 官方网站的资源,也欢迎留言或投稿告诉我们哦!
下周再见!