这个问题 GPT 5.6 sol 的时候大家就都在说,Anthropic 在 Fable 5 的时候我记得应该也说过,比如 Superpower 在现在的强模型下就变成负优化,除了浪费 Token 毫无用处。
所以不得不感慨那句名言:只要你学得够慢,你就不用学了。
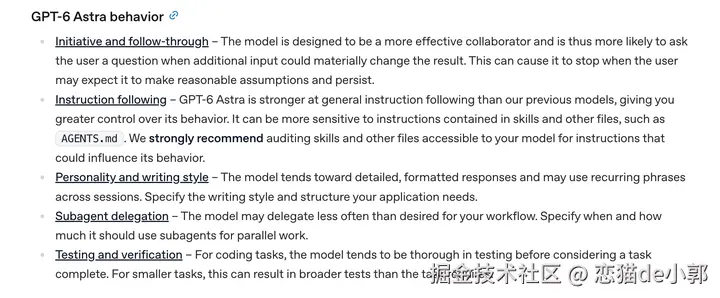
这个说法其实和 OpenAI 给 GPT-6 Astra 的官方 prompting guidance 也基本一致,在 OpenAI 的 API 说明里也提到过, GPT-6 Astra 的 instruction following 比前代更强,所以也更容易受到 Skill、 * AGENTS.md * 等上下文指令影响,模糊、互相冲突、范围过宽的规则,会让它提前暂停、询问用户,甚至直接阻塞任务:
比如官方提供的这两个例子:
「Use when working with databases, queries, models, or persistence. 」,这些词的覆盖范围太大,比如你可能只是改一个 ORM model,或者修一条 query 这些普通逻辑的时候,模型都可能判断 migration Skill 和当前任务相关,这时候的结果就是 Skill 被过度触发,后面的 migration 规则、检查步骤、参考资料也跟着进入上下文:
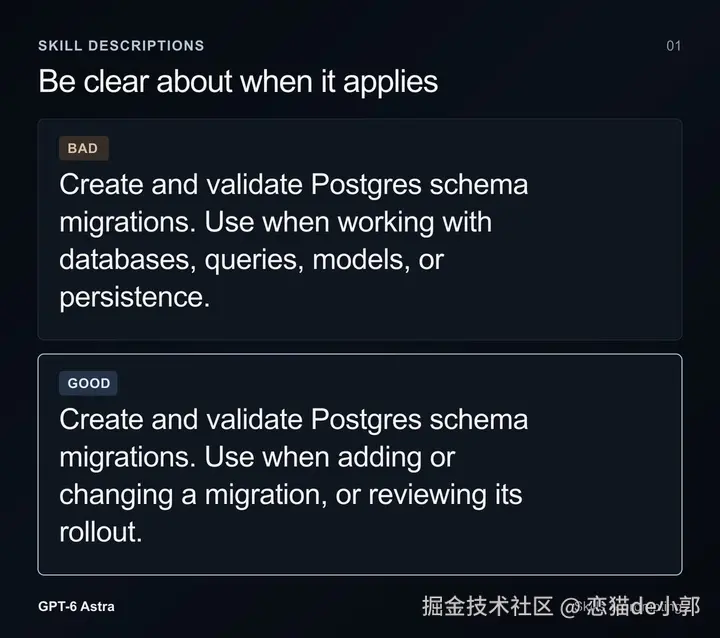
然后官方推荐的版本把触发条件收紧成:「adding or changing a migration, or reviewing its rollout」,这样它描述的就是具体任务,不会被多次多余执行混入上下文。
另外一个也是,因为很多人的 AGENTS.md 现在就是这类 BAD 版本:
Before every edit, read architecture.md, database.md, and deployment.md.
这种规则其实过去很常见,因为早期 Agent 经常不知道主动找项目文档,所以大家直接强制它"每次都读",但是现在来到 Astra 之类的模型, AI 真的会认真反复执行这个约束。
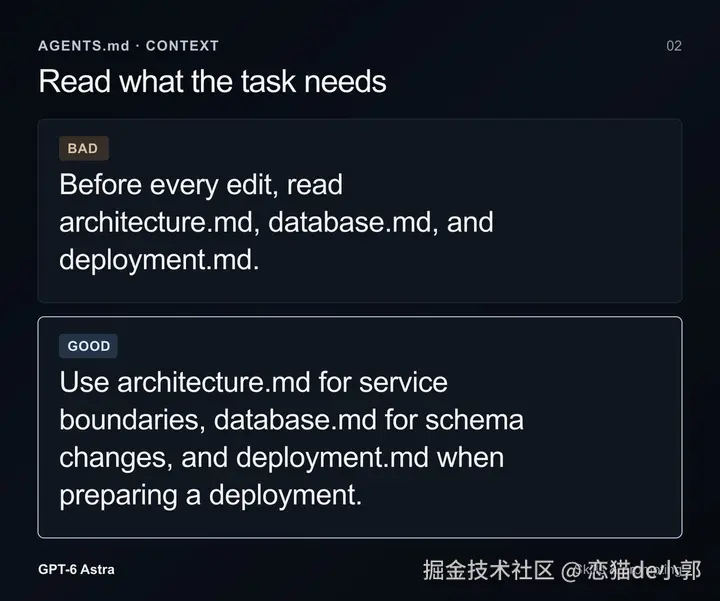
你就算只改了一个字符串,它也会完整把你几个 md 都读一遍,改第二次,它又会完全读一遍,整个过程除了浪费 token ,让进度变慢,实际上毫无意义,而且上下文会快速膨胀,导致幻觉更重。
而在推荐的版本里:
Use architecture.md for service boundaries, database.md for schema changes, and deployment.md when preparing a deployment.
实际上是在建立一个简单的 context routing table:
| 当前任务 | 加载的上下文 |
|---|---|
| 修改 service boundary | architecture.md |
| 修改 schema | database.md |
| 准备部署 | deployment.md |
| 普通 UI bug | 都不用 |
| 修一个 typo | 都不用 |
也就是 OpenAI 一直提到的 Harness 工程的方式,给一套精准的上下文索引和项目约束。
实际上这确实是目前 AI flow 工程的常见问题,因为模型在变,但是你的 AGENT.md 和 Skill 还有 Rule 一直没变的话,实际上会跟不上模型的能力。
现在很多 Coding Agent 配置,本质上记录的是上一代模型的缺陷,然后现在模型逐步优化完善后,如果还有大量强制行为或者规则在,那就可能反而导致执行混乱。
所以从目前的情况来看,我们其实应该把 prompt maintenance 当成模型迁移的一部分,每次换模型都需要考虑需不需要适配。
特别是 Skills,多加载和多执行 Skills 会带来是很大的上下文问题,可能很多人对 Skill 的理解是:
项目里放几十个 SKILL.md 没什么关系,需要的时候模型自然会加载。
但是 Codex 目前用的是 progressive disclosure,也就是启动时不会把所有 Skill 正文全部塞进上下文,但它必须先知道有哪些 Skill,还有什么时候应该选择它们。
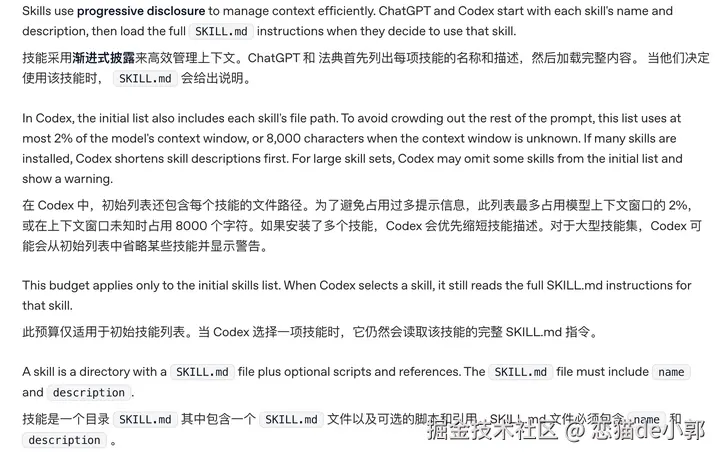
也就是说,启动时模型会先拿到每个 Skill 的 name 和 description,Codex 还会带上文件路径,如果模型判断某个 Skill 和当前任务匹配以后,就会再读取完整 SKILL.md,这里隐式触发本身就依赖 description。
也就是 description 实际就承担了 Skill router 的职责,如果像前面的例子一样,一个 PostgreSQL migration Skill,它的描述被写成:
创建和检查 PostgreSQL migration。处理数据库、query、model 或 persistence 时使用。
这时候会带来什么问题其实前面我们就提到过了,所以类似过去的 Superpowers 规则,在 Astra 这里的问题会特别明显,因为它什么流程都介入,还把很多流程从"建议"写成了"强制门禁" 。
特别 Superpowers 的核心 using-superpowers Skill 写得很激进:只要有哪怕 1% 的可能某个 Skill 适用,就必须调用;任何回复、澄清问题、浏览代码、检查文件之前,都先做 Skill 判断。
虽然 Superpowers 后来作者调整过流程,但是实际上这种「约束哲学」在现在的模型已经没什么必要,就它那种严格流程纪律,在模型激活喜好和轨迹上都很不友好。
比如可能会把模型从"高概率自然轨迹"硬推到一条规定轨迹上,还有干扰什么时候做判断。
所以,在现在的强模型时代,特别 Codex 里用的 Progressive Disclosure ,重点就是必须让 Skills 能做到按需加载,不能有太过于宽放的规则,Skill 必须是一套按任务加载的操作手册 ,类似 :
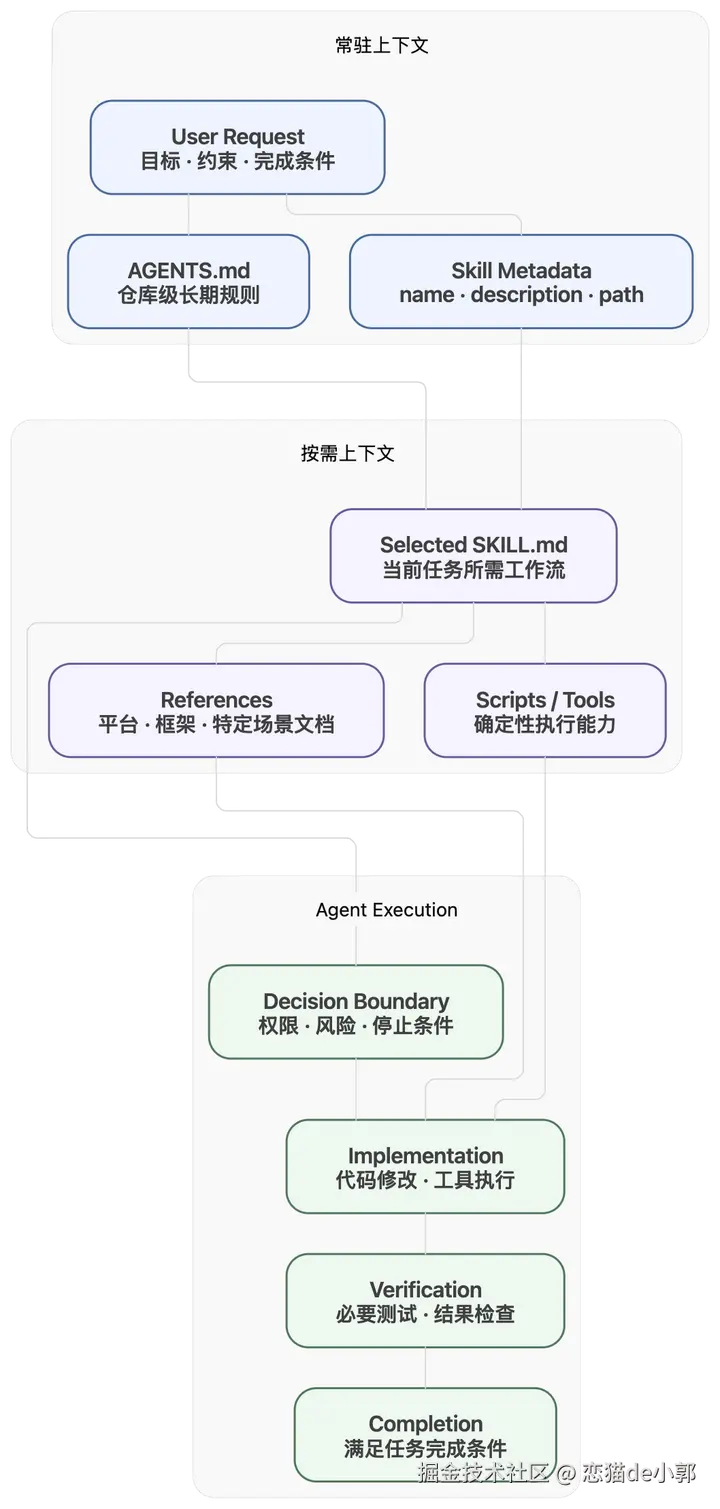
这个道理同样在 AGENTS.md也一样,因为 AGENTS.md 的覆盖范围更广,根据 OpenAI 的建议,现在把这类规则最好成有条件的文档目录,比如前面说的:
- architecture.md 用于涉及 service boundary 的修改
- database.md 用于 schema 相关修改
- deployment.md 只在准备 deployment 时读取
所以比如常见的 AGENTS.md 写:
erlang
Always run tests after every change.
Always verify your implementation.
Never finish until all tests pass.
目前 Astra 本身已经更倾向于执行验证,如果你还写这些规则,那你的 GPT 就会疯狂些测试用例,这个 GPT 5.6 sol 应该有人体验过了。
所以,模型越会遵守指令,一些历史遗留规则的副作用越容易完整执行出来。
还有一类似需要注意的 Coding Agent 的约束行为,比如我们以前可能会把"需要确认"的范围写得很宽,比如:
erlang
Ask before modifying additional files.
Ask before making architectural decisions.
Ask before running commands that change the repository.
这些规则在老模型上可能会有用,但是在Astra 可能就反而成为干扰它决策时的判断方向,会找不到安全的边界。
按照目前的 AI 情况,可能我们一年前建立起来的 CLAUDE.md、AGENTS.md、rules、Skill、system prompt,到了现在可能反而都是累赘,所以我们应该在每次模型升级之后,根据不同模型重新评估下整个 Prompt 的可靠性。