"同时运行 4 个 Agent"正在从极客演示变成真实工作方式。
OpenAI 9 月 6 日发布的内部数据提到,研究员经常在并发会话中使用 coding agents,使用 4 个或更多 Agent 的高并发方式正在增加。更有意思的是,官方没有把并发包装成线性提速:3.1 个 Agent 工作日只是运行时口径,复杂流程仍有其他瓶颈;成功的 4--8 小时任务里,超过一半至少需要一次人工介入。
多 Agent 的工程难点因此不在 Promise.all(),而在共享状态。四个 Agent 可以同时工作,不代表它们应该同时改同一个文件、操作同一个浏览器、提交同一个账号。
判断能否并行,只问两个问题
第一,两个任务之间有没有数据依赖?
第二,它们会不会写同一个可变资源?
可以用一个很小的判定器表达:
ts
function canRunInParallel(a: Task, b: Task) {
  const hasDependency =
    a.dependsOn.includes(b.id) || b.dependsOn.includes(a.id);

  const sharedWrites = a.writes.some(resource =>
    b.writes.includes(resource)
  );

  return !hasDependency && !sharedWrites;
}
这比按"岗位名称不同"判断更可靠。研究 Agent 和编辑 Agent 名字不同,但如果编辑依赖尚未冻结的事实,它们就不该全程并发。两个平台编辑都叫 editor,只要分别写 csdn.md 和 juejin.md,反而可以安全并行。
用 fork-join 切开任务
以多平台内容生产为例,比较清晰的图是:
text
                       ┌─> product_facts ─┐
brief ── fork ─────────├─> audience_q&a ──┼─> join/freeze
                       └─> trend_scan ────┘       │
                                                  ├─> csdn.md
                                                  ├─> juejin.md
                                                  ├─> toutiao.md
                                                  └─> images/
                                                        │
                                                   review/join
                                                        │
                                                   publish queue
第一轮并行收集相互独立的证据,join 后生成只读事实版本。第二轮并行产出互不覆盖的稿件和视觉,review 后进入单一发布队列。
这套图里最重要的不是 fork,而是两次 join。没有明确汇合条件的并发,只会把不完整产物更快地推向下游。
Artifact Contract 比群聊转述可靠
每个 Agent 的返回值不应该只有一段"我已经完成"的自然语言。至少要有:
json
{
  "taskId": "juejin-draft",
  "artifact": "platforms/juejin.md",
  "basedOn": "facts@sha256:5e...",
  "checks": {
    "newUnverifiedClaims": 0,
    "imageCount": 2,
    "summaryLength": 78
  },
  "status": "needs_review"
}
basedOn 解决版本漂移,checks 让合并节点只看异常,status 则决定是否可以进入下一阶段。人不必复读所有上下文,只处理差异和例外。
共享资源使用 single-writer
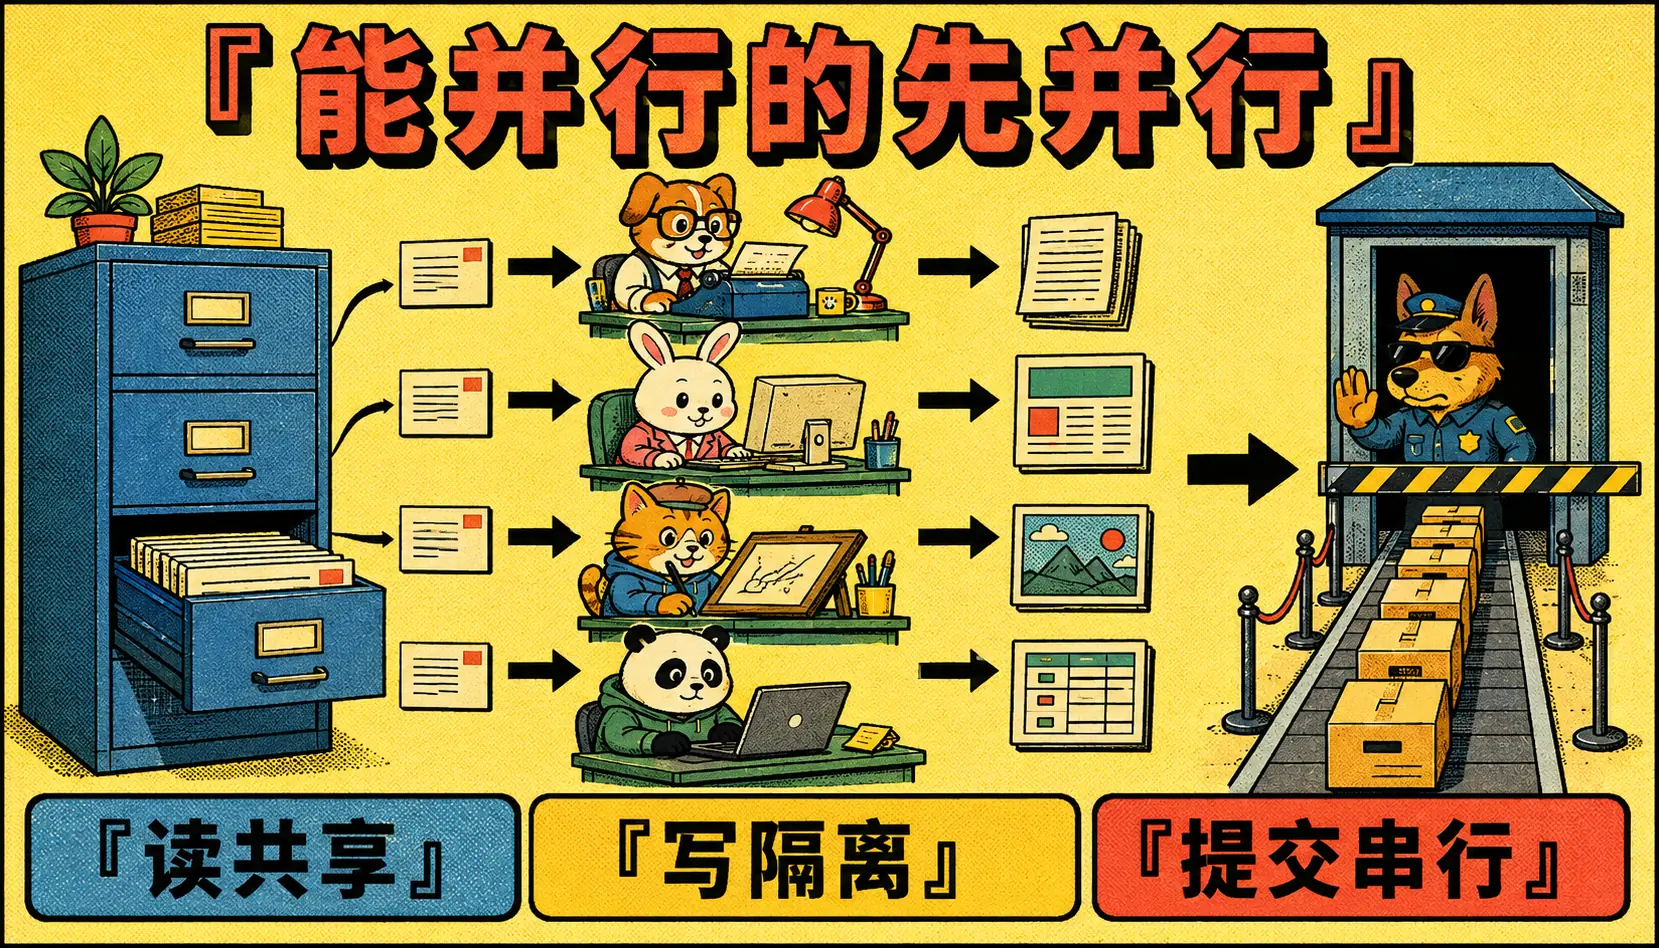
对唯一真相源、浏览器和生产账号,我更倾向单写者模型:
yaml
facts_source:
  writer: research_lead
  readers: "*"

platform_files:
  writer: owning_editor
  isolation: path

browser_session:
  writer: publisher
  concurrency: 1

external_submit:
  writer: publisher
  gate: human_confirmation
所谓 single-writer,不是禁止协作,而是禁止多个岗位直接争抢同一个最终状态。其他 Agent 可以提交 patch 或建议,由 owner 合并。这个约束看似保守,却能消掉大量最难复现的竞态问题。
并发预算不应等于模型上限
系统能开 20 个 Agent,不代表应该默认开 20 个。并发度至少受四件事约束:
- 独立子任务的数量;
- 人能同时审核多少异常;
- 外部 API、浏览器和账号的限流;
- 失败后需要回滚的共享状态。
一个实用的策略是小批次 fan-out:先并行 3--4 个证据任务,join 后再决定是否继续。与其让十几个 Agent 在错误前提上跑很远,不如让事实冻结成为天然的背压点。
这也是我们做 Tipkay 时偏向岗位化 AI 团队的一个原因。官网描述的方式是:复杂目标拆给不同岗位,每位员工做好自己的部分,再把结果交给下一位;岗位分别配置经验、流程、Skill 与 MCP。这里不把它包装成"无限并发",真正想解决的是所有权和交接:谁读什么、写什么、何时停下等确认。
如果要记一条落地规则,我会选这一句:
text
读共享,写隔离,提交串行。多 Agent 的价值不是让屏幕上同时跑满进度条,而是把互不依赖的等待重叠起来,同时不牺牲版本一致性和对外动作的确定性。
参考资料:
- OpenAI, Research acceleration: The view inside OpenAI:openai.com/index/resea...
- Tipkay 官网:www.tipkay.com/