一、Token:大模型眼中的"语言单位"
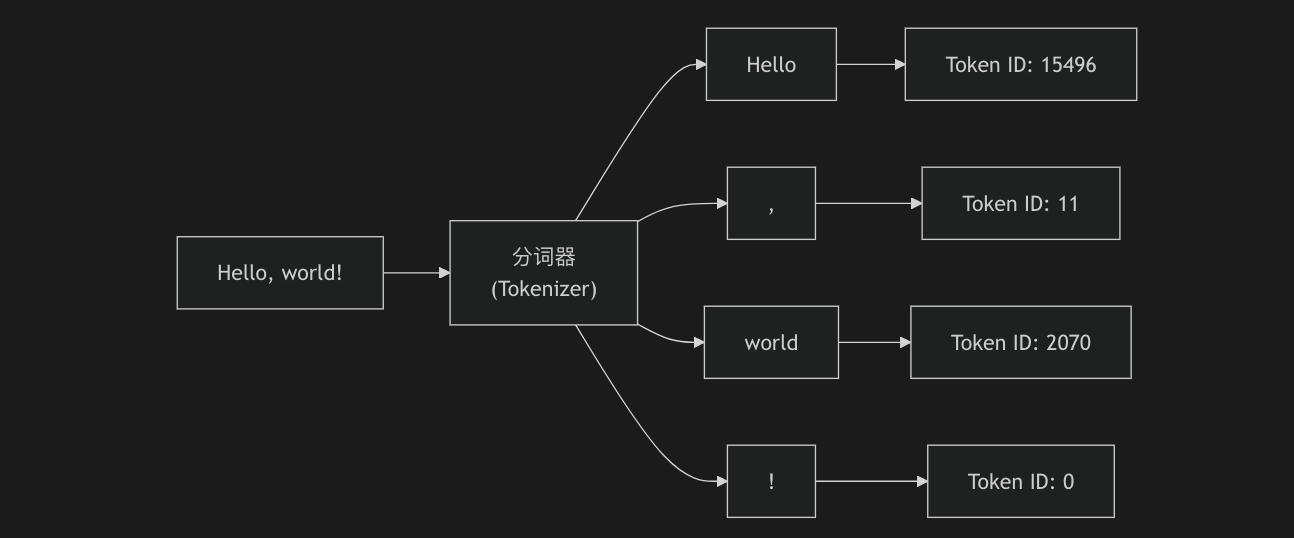
大模型处理的是文本,但它的计算单元不是"字",也不是"词",而是 Token(词元)。
1. 什么是 Token?
Token 是模型处理文本的最小单元。它可以是:
-
一个完整的单词:
"hello"→ 一个 Token -
一个词的一部分:
"unbelievable"→["un", "believ", "able"](3 个 Token) -
一个标点符号:
","→ 一个 Token -
一个汉字:
"大"→ 一个 Token
不同的分词器(Tokenizer)有不同的切分方式,同一个句子在不同模型下切出的 Token 数量可能不同。
2. 为什么需要 Token?
| 原因 | 说明 |
|---|---|
| 词汇表限制 | 世界上的词是无限的,但模型需要一个有限的词汇表 |
| 处理未知词 | 分词可以把没见过的新词拆成已知的子词片段 |
| 控制长度 | Token 数量影响计算成本和上下文窗口 |
| 多语言支持 | 分词器可以同时处理中文、英文等不同语言 |
3. Token 的计数方式
模型计费通常按 Token 计,中英文的 Token 比例大致如下:
-
英文:1 个单词 ≈ 1.3 个 Token
-
中文:1 个汉字 ≈ 1.5 ~ 2 个 Token
用 tiktoken 查看 Token 数量(OpenAI 的分词器)
import tiktoken
enc = tiktoken.encoding_for_model("gpt-4")
text = "大模型的学习"
tokens = enc.encode(text)
print(f"Token 数量: {len(tokens)}") # 输出: 5
print(f"Token ID: {tokens}") # 输出: [12345, 67890, ...]
二、Embedding:把文字变成数学
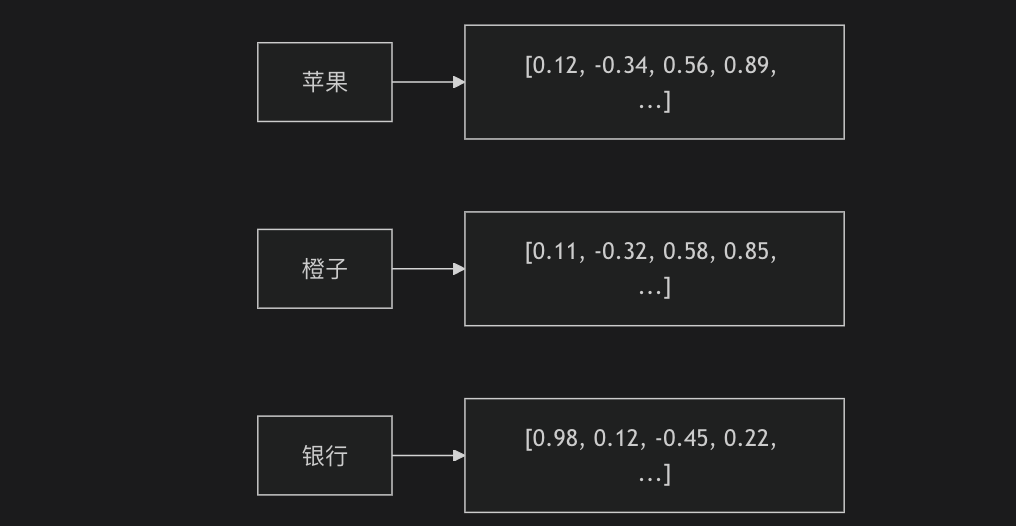
计算机不理解文字,只理解数字。为了让模型"理解"文字,需要把 Token 转换成向量(Vector),这个过程叫 Embedding(嵌入)。
1. 什么是向量?
一个向量就是一个数字列表,比如 [0.12, -0.34, 0.56, ...]。高维向量(比如 768 维、1024 维、4096 维)可以表示丰富的语义信息。
2. 向量的核心特性:语义空间
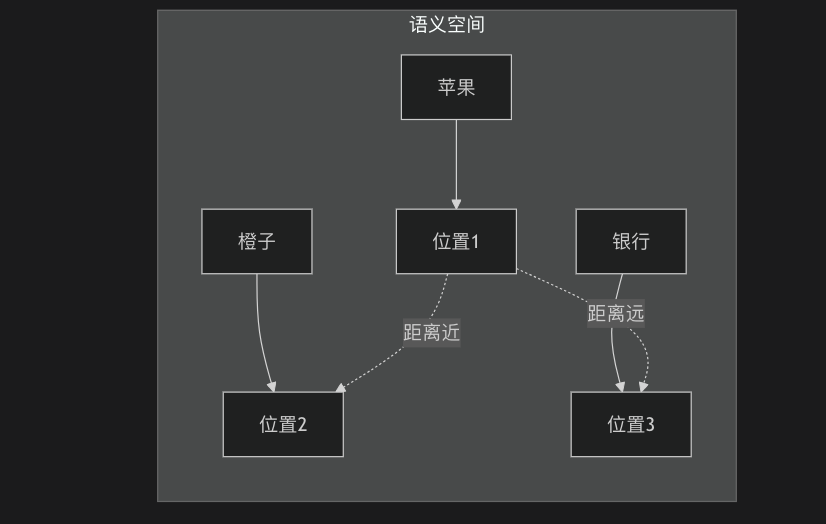
-
相似词的向量距离近 :
"苹果"和"橙子"的向量在空间中距离较近(都是水果) -
不相关词的向量距离远 :
"苹果"和"银行"的向量距离远 -
语义关系可以被计算 :
"国王"-"男人"+"女人"≈"女王"
3. 向量维度
| 模型 | 向量维度 |
|---|---|
| BERT-base | 768 |
| GPT-2 | 768 |
| GPT-3.5 | 4096 |
| GPT-4 | 8192 |
| 中文开源模型 (ChatGLM) | 4096 |
维度越高,表达能力越强,但计算成本也越高。
三、注意力机制:大模型读懂上下文的核心
Transformer 架构中最重要的创新就是 注意力机制(Attention Mechanism)。
1. 注意力
注意力机制让模型在处理一个词时,能够动态地关注到句子中其他所有词,并分配不同的"注意力权重"。
处理 "小明去了银行,他在那里开户" 这句话时,模型处理到 "那里" 这个代词时,注意力会集中在 "银行" 这个中心词上。
2. 自注意力(Self-Attention)
自注意力是在同一句话内部计算词与词之间的关系。
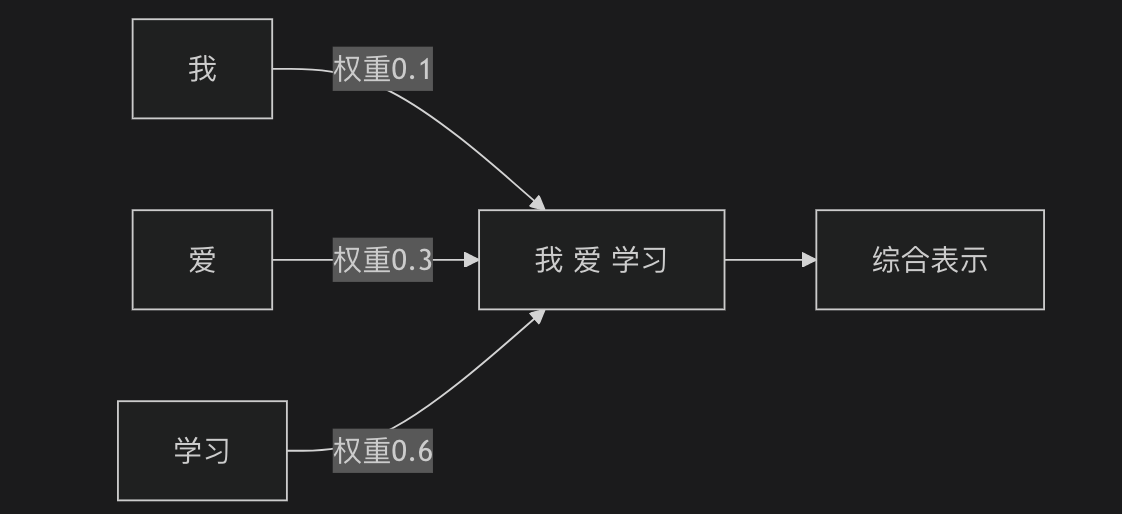
对于 "我 爱 学习" 中的 "爱":
-
注意 "我":0.1
-
注意 "爱":0.3
-
注意 "学习":0.6
→ 模型知道 "爱" 这个词在上下文中主要关联 "学习"。
3. 多头注意力(Multi-Head Attention)
多个注意力头并行计算,每个头关注不同的关系,然后拼接起来:
注意力头1:关注语法关系(主谓宾)
注意力头2:关注语义关系(同义词)
注意力头3:关注指代关系(代词指代)
...
这种设计让模型可以从多个角度理解文本。
4. 注意力机制的数学简化
attention_score = query · key / √d
attention_weight = softmax(attention_score)
output = attention_weight · value
简单理解:
-
Query:当前词在找什么
-
Key:其他词能提供什么
-
Value:其他词的实际内容
-
先算相关性(Query × Key),再用相关性加权求和(Value)
四、三者的关系
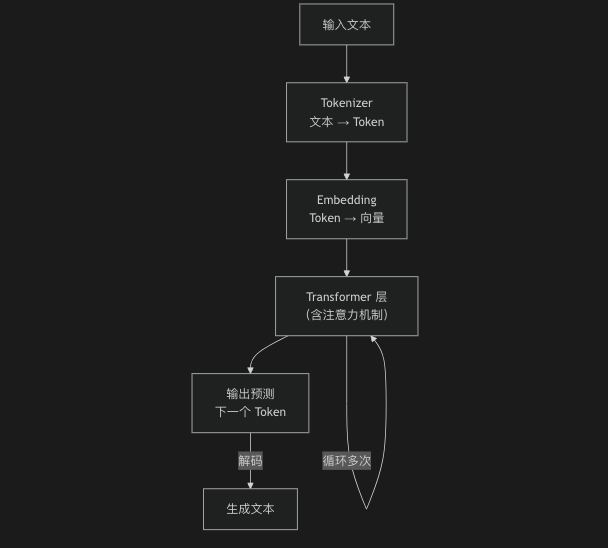
关系
| 概念 | 作用 | 类比 |
|---|---|---|
| Token | 把文字切成可计算的最小单元 | 把句子拆成积木块 |
| Embedding | 把 Token 转换成数学向量 | 给每个积木块贴上一个位置标签 |
| 注意力机制 | 计算词与词之间的关系 | 在搭建积木时,知道哪些块需要粘在一起 |