成为全栈·Node 后端篇·列表接口三件套:分页、筛选、排序
列表接口是后端最容易被低估的东西------"不就是查一批数据、翻个页吗"。直到有一天运营告诉你第 50 页和第 51 页出现了同一篇文章,或者有人往 sort 参数里塞了一段 SQL。分页、筛选、排序这三件事,每一件都有它专属的翻车方式。
这一篇把列表接口的三件套一次讲透:分页怎么保证不重不漏、筛选怎么用白名单挡住 SQL 注入、排序怎么避开连表后的 ambiguous column,顺便给 LIKE 全表扫描装一个刹车。顺带说清一件事:分页要用的 total / totalPages 一律由后端算好返回,别让前端拿着一页数据去猜总数。
一、分页:offset 分页 + 稳定键
最常用的分页是 offset 分页 :?page=2&pageSize=20 算出 offset = (page-1)*pageSize,SQL 里 LIMIT 20 OFFSET 20。我们的 parsePage 在解析时就把边界钳死了:
ts
// pagination.ts --- parsePage
const page = Math.max(1, Number(c.req.query('page') ?? 1) || 1);
const pageSize = Math.min(100, Math.max(1, Number(c.req.query('pageSize') ?? 20) || 20));
return { page, pageSize, offset: (page - 1) * pageSize };
两个细节:
- page 和 pageSize 都要钳制 。
page最小 1(不能传 0 或负数搞出负 offset),pageSize夹在[1, 100]------既防传 0 的离谱请求,也防有人传pageSize=10000一次性拖垮数据库。这是列表接口的第一道护栏。 - 返回
total和totalPages(契约Pagination四件套)。前端才能画"第 2 / 共 8 页"的分页器。
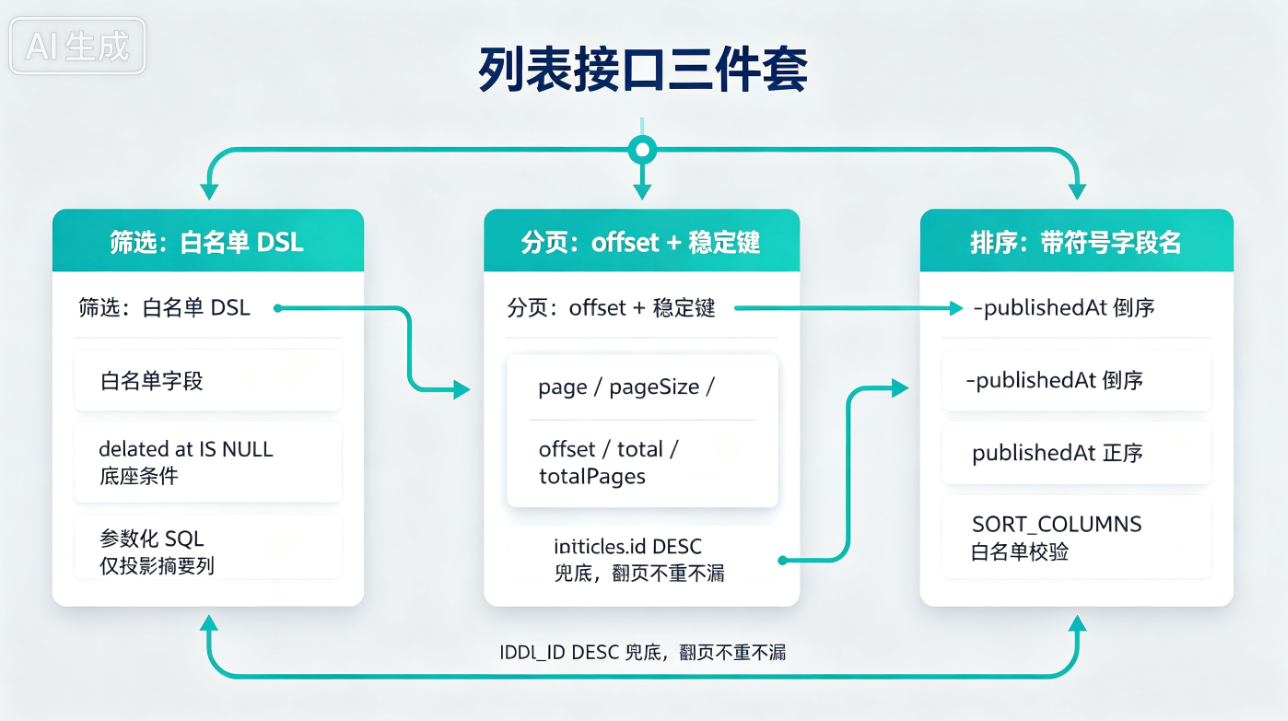
还有个更隐蔽的点:排序必须有稳定键,否则翻页会"重漏" 。想象按 viewCount 排序,第 1 页末尾和第 2 页开头有几篇文章 viewCount 恰好相等。如果排序只写 ORDER BY view_count DESC,数据库不保证这些"并列"行的相对顺序,两次查询可能把同一行既放第 1 页又放第 2 页(重复),或两边都漏掉(丢失)。解法是在末尾恒接一个唯一稳定键:
ts
// pagination.ts --- buildSortSql 末尾
return sql`${sql.raw(column)} ${sql.raw(dir)}, articles.id DESC`;
articles.id DESC 作为兜底键,保证并列时顺序确定,翻页绝不重漏。这是列表接口的"基本功",但新手十个有九个漏写。
关于分页还有一个常被问的问题:为什么用 offset 而不是游标(cursor)分页?游标分页(WHERE id > lastId LIMIT 20)在超大数据集上更高效、且不受中间插入删除影响,但它有两个代价:一是不能"跳到第 10 页"(必须顺序翻),二是实现复杂。我们的内容站规模有限(文章几千到几万),offset 分页配合稳定键完全够用,还能让前端直接做"页码跳转"。等真到了百万级、且不需要跳页的场景,再切游标也不迟------分页策略是和业务规模绑定的,别提前为想象中的流量过度设计。
再补一句:分页的 total 和 totalPages 必须来自后端,别让前端自己猜------前端不知道全集大小,算出来的页码必然错。所以 meta() 把 total 和 totalPages 一起算好塞进信封,前端只管渲染分页器。
二、筛选:白名单 DSL,绝不让用户拼 SQL
筛选是列表接口最大的注入风险源。最危险的写法是把用户传的字段名直接拼进 SQL:
ts
// ❌ 致命:用户传 ?sort=id; DROP TABLE articles;-- 直接拼进 SQL
const sql = `SELECT * FROM articles ORDER BY ${c.req.query('sort')}`;
我们的 queryArticles 用"白名单 + 条件数组"的方式构造筛选,从根上堵死注入:
ts
const conds: SQL[] = [isNull(articles.deletedAt)];   // base:永远 AND 上"未软删"
if (q.forcedStatus) conds.push(eq(articles.status, q.forcedStatus));
if (q.authorId !== undefined) conds.push(eq(articles.authorId, q.authorId));
// ...keyword / tag / category 各自追加
const where = and(...conds);
这套"列表 DSL"有几个纪律(P-37):
- 白名单优于黑名单 :允许筛选的字段是写死在代码里的(
status/authorId/keyword/tag/category),用户传的任何不在清单里的参数直接被忽略,根本进不了 SQL。 base永远 AND :isNull(articles.deletedAt)是底座条件,所有筛选都和它AND在一起。这样无论怎么筛,软删文章永远不会漏出来------不用在每个分支里重复写"排除软删"。- 动态条件安全拼接 :用 Drizzle 的
and(...conds)把条件数组拼成参数化 SQL,每个值都走占位符,不存在字符串拼接注入。 - 投影摘要列 :列表查询
select只取id/title/summary/slug/...这些摘要列,绝不取content长文本 。一篇content几万字,列表一页 20 篇全取出来就是几十万字符的内存和带宽浪费。详情接口才取content。
把筛选串起来看,一次 GET /articles?status=pending&authorId=7 最终生成的 SQL 大致是:SELECT ... FROM articles WHERE deleted_at IS NULL AND status = 'pending' AND author_id = 7 ORDER BY ... LIMIT 20 OFFSET 0。注意 deleted_at IS NULL 是底座、永远在场,业务分支只管往上叠自己的条件------这就是白名单 DSL 的好处:新增一个筛选维度,只需在 queryArticles 里加一个 if (q.xxx) conds.push(...),底座和注入防护全自动复用,不用每次重写"排除软删"。可维护性和安全性是一起拿到的。
三、排序:带符号字段名 + 基表限定(P-11)
排序我们用"带符号字段名"约定:-publishedAt 表示倒序、publishedAt 表示正序。解析时剥掉 - 前缀得到裸字段名,再查白名单:
ts
// pagination.ts --- SORT_COLUMNS 白名单
const SORT_COLUMNS: Record<string, string> = {
  publishedAt: 'COALESCE(articles.published_at, articles.created_at)',
  viewCount: 'articles.view_count',
  createdAt: 'articles.created_at',
};
两个安全/正确要点:
第一,未知字段直接回退默认。 bare && bare in SORT_COLUMNS 不成立时,排序回退到 -publishedAt。用户传 ?sort=hack 不会报错,也不会拼进 SQL,只是"无效排序被忽略"。这又是一道注入护栏------排序字段也只能从白名单里来。
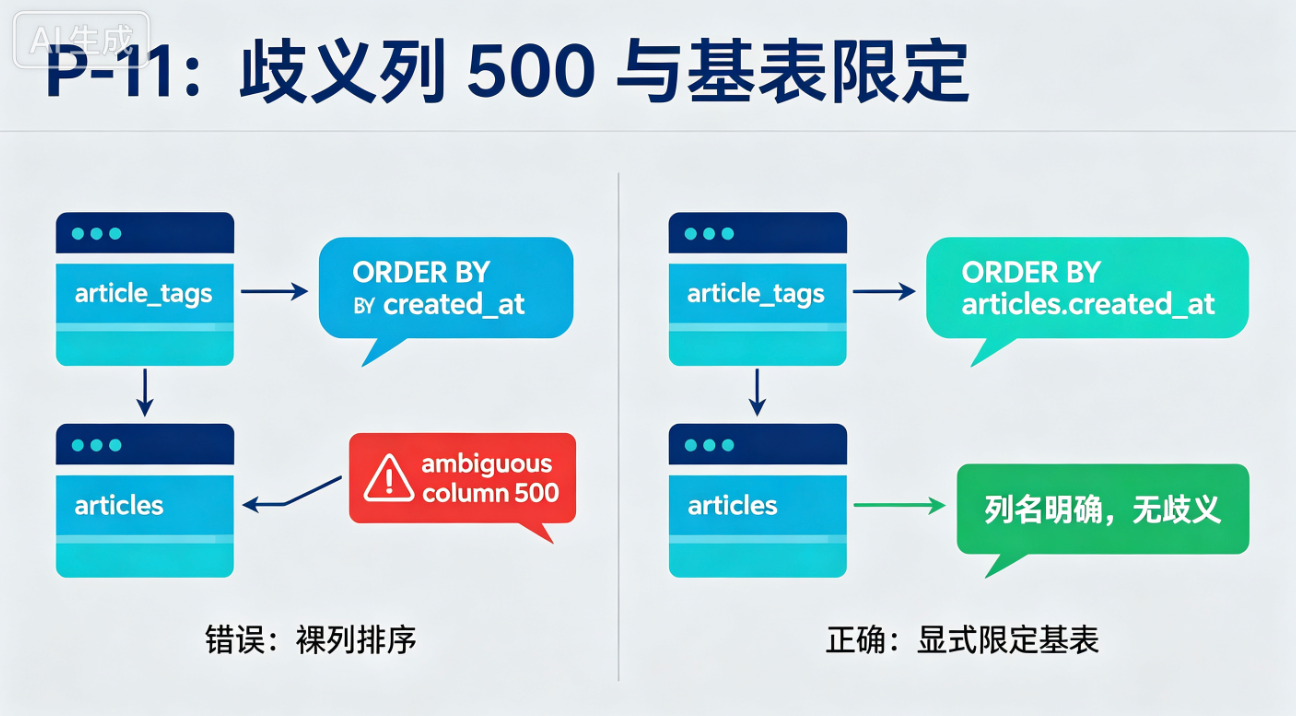
第二(P-11,曾经的真实 500),ORDER BY 必须显式限定基表。 注意白名单里写的都是 articles.xxx 全限定列名,不是裸的 published_at。为什么?因为列表查询在按标签筛选时会 INNER JOIN article_tags:
ts
if (q.tag) rowsQuery.innerJoin(articleTags, eq(articleTags.articleId, articles.id));JOIN 之后,created_at、id 这种两表都可能有的列就成了歧义列(ambiguous column) 。如果排序写的是裸 ORDER BY created_at,数据库不知道你指的是 articles.created_at 还是 article_tags.created_at,直接报 ambiguous column → 500。我们白名单里一律用 articles. 限定基表,从根上根除这个 500。这条坑是 M1-05 提过的 P-11 在列表场景的真实落地------JOIN 一上,裸列名就是雷。
另外 publishedAt 用了 COALESCE(articles.published_at, articles.created_at):草稿没有 published_at(为 NULL),排序时把它当成 created_at 兜底,避免 NULL 被排到诡异位置。
为什么用 -publishedAt 这种"带符号字段名"而不是 sortField=publishedAt&sortDir=desc 两个参数?因为单参数更 URL 友好、更短、也更好校验------一个字符串就能完整表达"排哪个字段、什么方向",白名单只需校验这一个字符串的裸字段部分。两个参数方案要分别校验字段和方向,攻击面更大。另外注意 meta() 在 buildSortSql 之外独立构造 Pagination 四件套,排序和分页元数据各司其职,路由里一行 paginate(result.list, result.pagination) 就包好信封,职责边界很清楚。排序字段白名单和分页 pageSize 上限一样,都是"用户能控制、但必须在我们划定的圈里控制"的典型例子------既要给人灵活,又不能让人把系统玩坏。
四、SCAN_LIMIT 封顶:LIKE 全表扫描的刹车(P-37 / P-35)
关键词搜索用的是 LIKE '%keyword%',这东西在小表上没问题,但本质上是全表扫描 ------它会逐行比对,数据量一大就拖死库。我们的应对是给扫描量封顶(SCAN_LIMIT = 2000):
ts
// article.ts --- queryArticles 计数分支
if (q.keyword) {
  const scanned = await scannedQuery.where(where).limit(SCAN_LIMIT).all();
  total = scanned.length;   // 命中超量就显示封顶值
}
当用户带 keyword 搜索时,计数不再 count(*) 全表数,而是最多扫 SCAN_LIMIT 行,扫到上限就显示封顶值(比如"结果 2000+")。这是搜索可用性和性能的取舍:用户得到"大概很多条"的反馈,数据库不会被一次恶意/手滑的全量 LIKE 拖垮。真要支撑大规模全文检索,得上升级到专用引擎(M1-19 专门讲)。
这里其实藏着一个产品判断:搜索的"精确总数"在大规模下是奢侈品。与其让用户等一个精确的 count(*),不如用封顶值快速返回、把真实计数留给"点进下一页"的懒加载或异步统计。列表接口的设计,很多时候不是"能不能算出来",而是"值不值得为这一次请求付出这个代价"------SCAN_LIMIT 就是把这个判断写进了代码。
顺带一提,limit(SCAN_LIMIT) 不只是为了保护用户体验------一次无上限的 LIKE 全表扫,在数据库层面会吃满 CPU、锁住大量行,进而拖慢同库的其他读写请求,是典型的"一个慢查询拖垮全站"。封顶扫描量,本质也是在保护数据库的"邻居"。
顺带,q.tag 的标签过滤现在切的是 article_tags 关联表精确 INNER JOIN(呼应 M1-16 的 P-35),不再像早期那样对 tags JSON 做 LIKE 子串匹配------既准又不会因为 JOIN 引入歧义(因为排序白名单已全限定基表)。
五、小结与前瞻
列表接口三件套,是后端的"日常基本功":
- 分页 :offset 分页,
parsePage钳制page≥1、pageSize∈[1,100];排序恒接articles.id DESC稳定键,翻页不重漏。 - 筛选 :白名单 DSL------允许字段写死、未知参数忽略;
base条件isNull(deletedAt)永远 AND;动态条件用and(...conds)参数化拼接,零注入;列表只投影摘要列,不取content。 - 排序 :带符号字段名(
-publishedAt倒序);白名单SORT_COLUMNS,未知回退默认;P-11 全限定基表列 ,根除 JOIN 后ambiguous column的 500。 - P-37 / P-35 :
SCAN_LIMIT=2000封顶 LIKE 扫描量,超量显示封顶值;标签过滤走article_tags精确 JOIN。
下一篇({{LINK:M1-18}})我们进"文件上传":为什么需要 R2 对象存储和本地磁盘双实现、上传接口怎么设计、以及"同图不同时间上传存几份"背后的内容寻址去重。
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer