我们组用 tri-checklist 做发版前审计快一年了。上周我头一回认真去读它的 diff 解析源码,结果有点尴尬:它给 Python 改动标的函数名,清一色是 def。
说白了这事儿挺反直觉。一个把"审计范围确认"当第一道门的 skill,自己解析 git diff 的时候,底层就悄悄给了错数据。我们现在的判断很直接------它的解析器在两类场景下会静默出错:Python 函数名提取,和文件重命名时的行数统计。两个都不会报错,但给你的审计范围就是错的。
tri-checklist 干的事不复杂:跑一条 git diff,把改动文件、函数、行数、类型扒出来,再喂给模板生成四维审计清单。核心解析逻辑全在 tri-checklist/scripts/parse_git_diff.py 里,零第三方依赖,纯标准库。问题就出在这几十行正则和路径合并上。
它前面还立着两道确认门:先复述审计范围,你点头了才往下走。理论上范围错了你能当场纠。可函数名和行数是机器算完直接填进清单的,门一过你就盯着勾选框了,没人会回头核底层数字------这正是静默出错最危险的地方。光有门不够,门里填的数据本身得是对的。
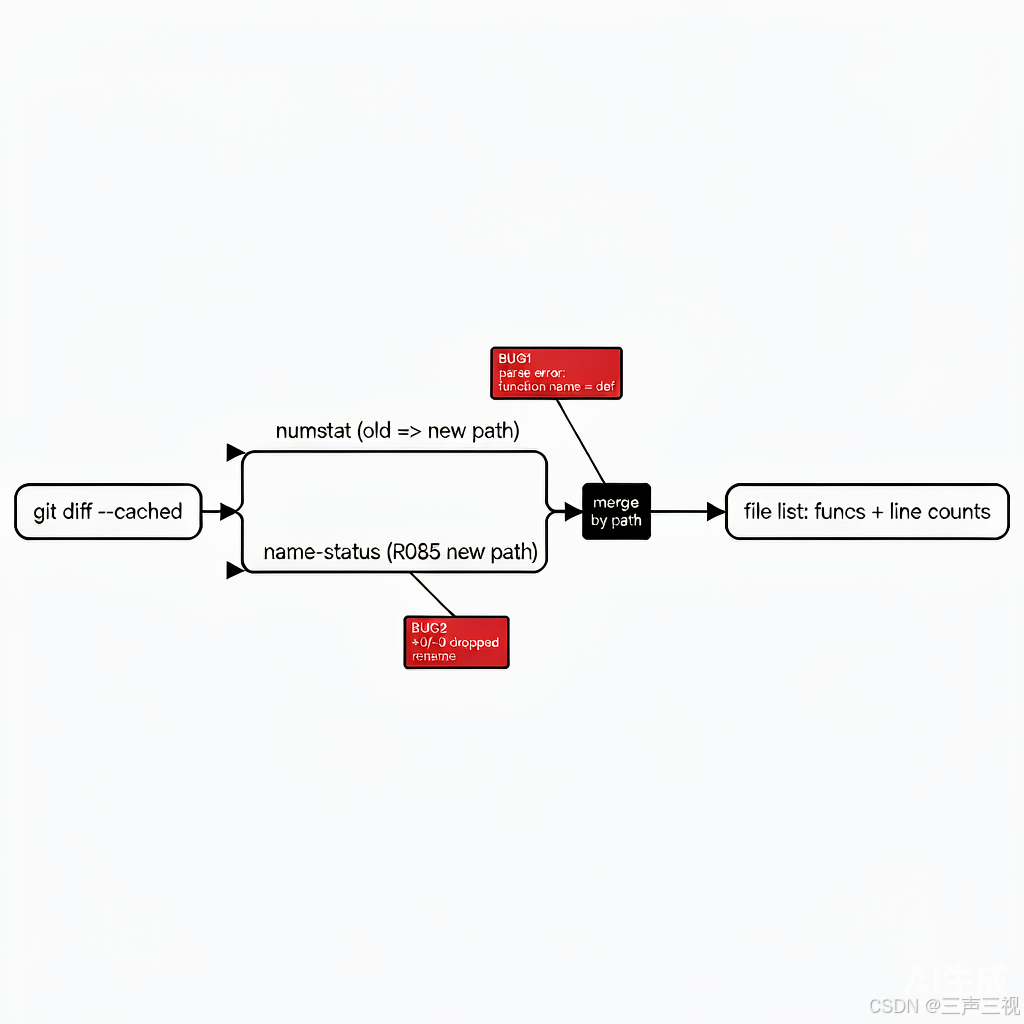
第一处:Python 的函数名,被它读成了 def
源码里提取函数名就靠这一段:
python
# tri-checklist/scripts/parse_git_diff.py(节选)
HUNK_FUNC_PATTERN = re.compile(r"^@@ -\d+(?:,\d+)? \+\d+(?:,\d+)? @@\s*(.*)$")

def extract_functions(mode, commit, file_path):
    # ... 跑 git diff 拿 hunk 头 ...
    for line in result.stdout.splitlines():
        m = HUNK_FUNC_PATTERN.match(line)
        if m:
            func_ctx = m.group(1).strip()
            if func_ctx and func_ctx not in seen:
                func_name = re.split(r"[\s\(\{]", func_ctx)[0]   # ← 出问题的地方
                if func_name and func_name not in seen:
                    seen.add(func_name)
                    functions.append(func_name)
git 给 Python 的 hunk 头长这样:@@ -2,10 +2,12 @@ def calc_total(items):。func_ctx 拿到的是 def calc_total(items):,接着 re.split(r"[\s\(\{]", ...)[0] 按空白切,第一个 token 就是 def。
你猜怎么着,清单里 order.py 的改动函数就真成了 def()。把改动函数改成 discount,照样是 def。一个 Python 项目里所有被改的函数,在审计清单的"改动函数清单"那一栏,全都叫 def。这坑我们躺了三天才发现------因为清单长得对,BLOCKER/MAJOR 标签一个不少,谁会去核对函数名对不对。
我个人特别讨厌这种设计。不报错,但你拿到的审计范围就是错的,发版前自检等于白检一半。
第二处:文件一改名,行数就蒸发了
这处更隐蔽。git 的 --numstat 和 --name-status 对重命名用的路径格式压根不一样:
bash
$ git diff --cached --numstat
2       1       order.py
3       0       legacy_parser.py => rules_engine.py

$ git diff --cached --name-status
M       order.py
R085    legacy_parser.py        rules_engine.py
numstat 里重命名文件写成 old => new,name-status 里取的是新路径 new。脚本两边各跑一次,再用路径当 key 去合并:
python
# tri-checklist/scripts/parse_git_diff.py(节选)
def parse_numstat(output, files):
    numstat_map = {}
    for line in output.splitlines():
        parts = line.split("\t")
        added, deleted, path = parts[0], parts[1], parts[2]
        numstat_map[path] = {"insertions": int(added), "deletions": int(deleted)}
    for f in files:
        stat = numstat_map.get(f["path"], {"insertions": 0, "deletions": 0})  # ← key 对不上
        f["insertions"] = stat["insertions"]
        f["deletions"] = stat["deletions"]
files 里重命名文件的 path 是 rules_engine.py,而 numstat_map 的 key 是 legacy_parser.py => rules_engine.py,get 直接落空,回退成 {0, 0}。结果就是:改了 3 行的新文件,清单里显示 +0/-0。
我们实测了一把。造个临时仓库,把 legacy_parser.py 改名成 rules_engine.py 又追了两行函数,暂存后跑原脚本:
| 文件 | 原始解析结果 | 真实改动 |
|---|---|---|
order.py 函数名 |
def |
calc_total |
rules_engine.py 增删行 |
+0 / -0 | +3 / -0 |
| 合计增删行 | +2 / -1 | +5 / -1 |
见鬼了吧。重命名那 3 行直接被吞掉,合计行数也对不上。审计清单上"改动行数统计"一栏,从根上就少了一截。我们平时的项目最爱干的事就是重构时顺手把模块改名,这种改动一多,清单里的行数统计基本就是个装饰。
顺带说一句,同一份解析里我还盯了另外两个检测:测试文件识别挺准,tests/test_order.py 被正确标成测试文件;但敏感文件用的是松散正则,碰到 keyboard.py 里含 key 也给打了敏感标。这条和前面两处不是一回事,算设计取舍,我就不展开,只补一句------拿正则去匹配路径名,误伤是常态,真要较真得换成词边界。
顺便一提,我们这套 tri-* 家族里每个 skill 都能当别人的零件使,tri-checklist 这个 diff 解析器就被 tri-review 直接当预处理用------所以这类底层 bug 的影响面,比单篇清单大得多。
我们重写了两处,跑通了
修第一处,把"取第一个 token"换成"命中 def/func/function 加可见性/返回类型之后的首个标识符":
python
KW = re.compile(r"(?:def|func|function|public|private|protected|static|final|"
                r"void|int|long|float|double|char|bool|class|struct|interface|"
                r"enum|fn|sub|method|property)\s+([A-Za-z_]\w*)")
# func_ctx 如 "def calc_total(items):" → 取 group(1) = calc_total
修第二处,numstat 里遇到 => 就取箭头后边的新路径再合并:
python
added, deleted, path = parts[0], parts[1], parts[2]
if " => " in path:
    path = path.split(" => ")[-1]   # old => new → new
numstat_map[path] = {"insertions": int(added), "deletions": int(deleted)}
同样的临时仓库,同样的暂存改动,跑修复版:
| 文件 | 修复后结果 | 核对 |
|---|---|---|
order.py 函数名 |
calc_total |
✓ 与 hunk 头一致 |
rules_engine.py 增删行 |
+3 / -0 | ✓ 与 numstat 原始值一致 |
| 合计增删行 | +5 / -1 | ✓ 不再丢行数 |
修复前后,清单到底长啥样?build_checklist.py 把 diff.json 套进模板,吐出一份带复选框的 Markdown。原脚本那版里,"改动函数清单"一行长这样:
markdown
- [ ] `src/order.py` → `def()`函数名错了,这一行基本等于没写。行数那处同理,重命名文件 +0/-0 时,"改动行数统计"一栏直接少算,四维审计的地基就歪了。修完再跑,函数名变成 calc_total,行数也对得上,审查范围才真和 git 输出一致。
真实的调用路径就一行,任何人都能复现:
bash
python tri-checklist/scripts/parse_git_diff.py --mode staged --out diff.json没有报错,没有异常栈,错数据就这么安静地进了清单。重来我们会直接把 numstat 和 name-status 用同一条 --stat 一次拉齐,而不是分两次再靠路径去拼------胶水代码能少写一处是一处,少一处拼接就少一处对不上的机会。
收个尾
所以下次有人拿一份自动生成的审计清单给我,我会先问两句:你那函数名,提取对了吗?改名的文件,行数算进去了吗?清单长得再标准,底层 diff 解析错了,上面勾得再认真,也是对着错误对象使劲。
个人介绍
我是老三,10 年软件开发老油条,软件设计师、注册人工智能工程师。平时搞 Web 前端,这两年也在啃鸿蒙 ArkTS 北向开发,顺手折腾 AI 自动化,不定期在 CSDN 写点实战踩坑。
本文遵循 MIT 协议,转载请注明出处。